
pgx
pgrundev
703étoiles+4in 24h
PGX — Un Postgres léger pour les agents d’IA. Écrit en Rust. Des milliers de bases de données isolées dans un seul environnement d’exécution🐘
Comparez bases de données, analyses, SQL et projets d’ingénierie des données.
pgrundev
PGX — Un Postgres léger pour les agents d’IA. Écrit en Rust. Des milliers de bases de données isolées dans un seul environnement d’exécution🐘

sysown
Proxy haute performance pour MySQL et PostgreSQL

tobymao
Analyseur syntaxique et transpileur SQL en Python

xiangyuecn

Données administratives sur trois ou quatre niveaux pour les provinces, villes, districts, comtés et cantons, avec annotations en pinyin, coordonnées et limites territoriales. La dernière collecte date du 3 avril 2026. Des fichiers CSV sont disponibles, et un outil en ligne permet de convertir les données en code JavaScript à niveaux liés ou au format JSON générique. Un logiciel permet également de les convertir en SHP, GeoJSON ou SQL et de les importer dans des bases de données. Le projet comprend le code source JavaScript de collecte, exécutable dans un navigateur. Il regroupe des données administratives du ministère des Affaires civiles de la République populaire de Chine, de la base nationale chinoise d’informations sur les noms de lieux, du Bureau national des statistiques, d’Amap et de Tencent Maps.

designcomputer
Un serveur Model Context Protocol (MCP) qui permet d’interagir en toute sécurité avec des bases de données MySQL

dhamaniasad
Une sélection de logiciels, bibliothèques, outils et ressources de qualité pour PostgreSQL, inspirée par awesome-mysql.

pingcap
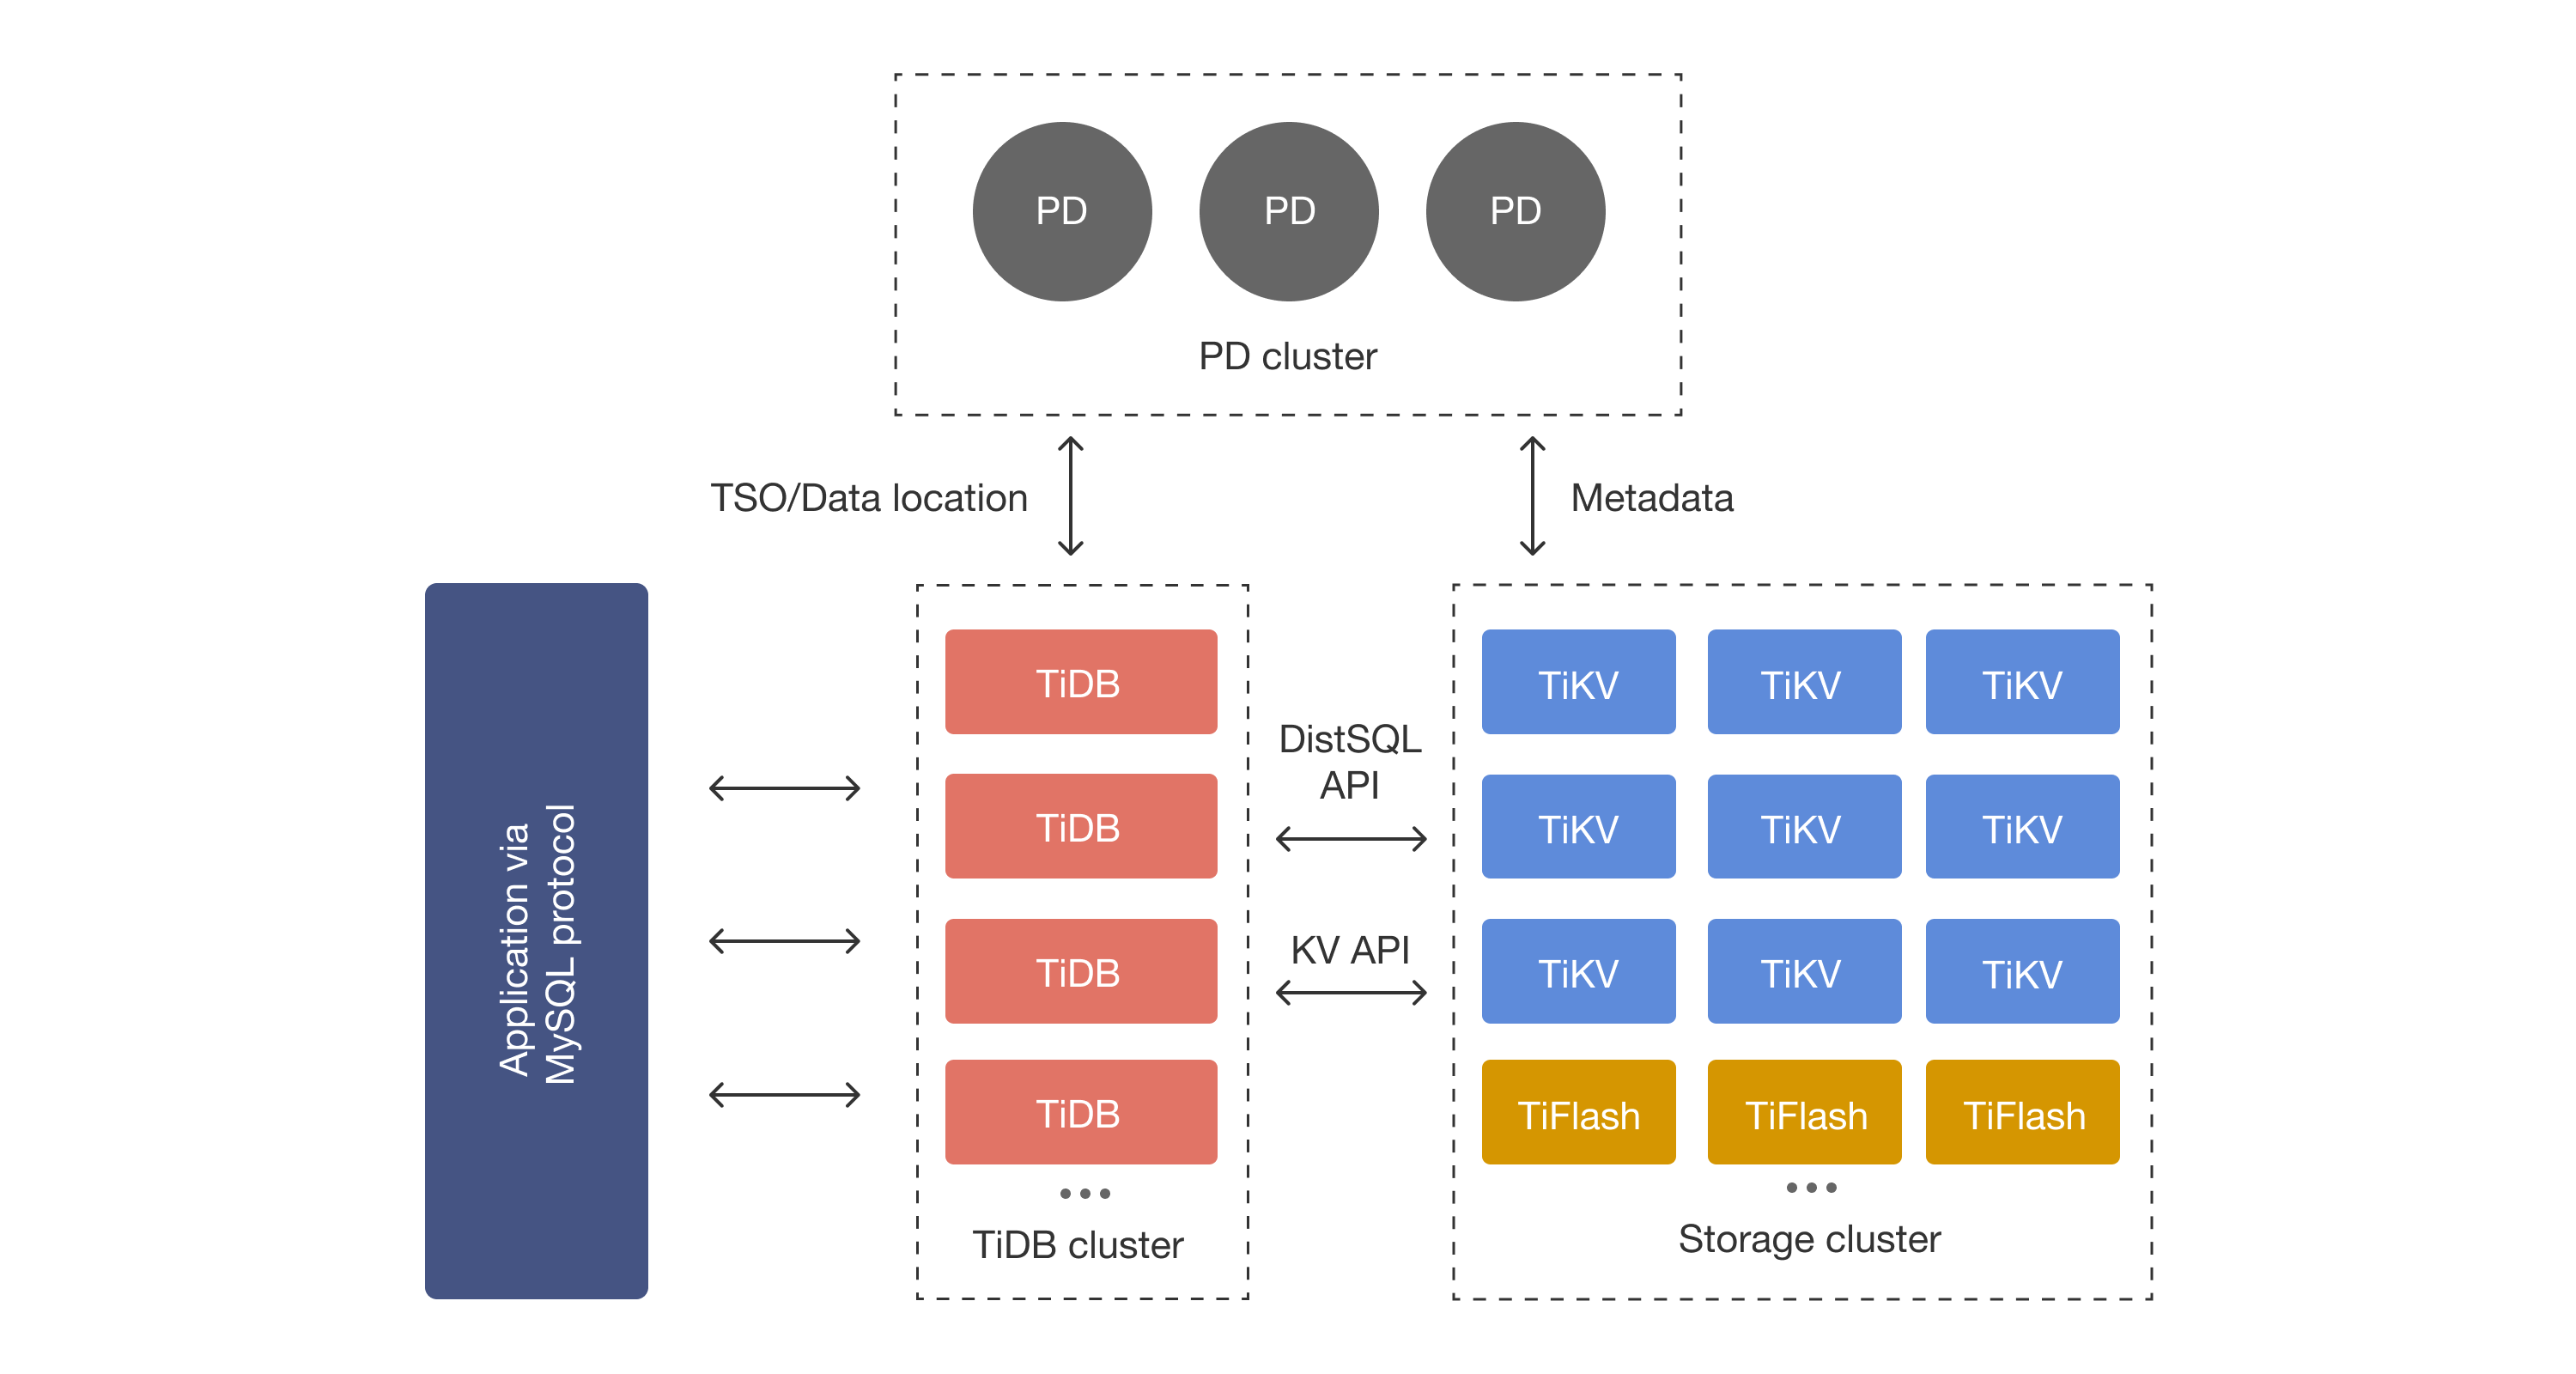
TiDB est conçu pour les charges de travail agentiques qui croissent de façon imprévisible, avec des garanties ACID et une prise en charge native des transactions, de l'analytique et de la recherche vectorielle. Pas de silos de données. Pas de voisins bruyants. Pas de plafond d'infrastructure.

unum-cloud
Moteur open source rapide pour rechercher et regrouper des vecteurs et des objets quelconques. Disponible en C++, C, Python, JavaScript, Rust, Java, Objective-C, Swift, C#, GoLang et Wolfram 🔍

2shady4u
Enveloppe GDExtension pour SQLite (Godot 4.x et versions ultérieures)

antvis

👾 Cadre d’analyse visuelle natif de l’IA, conçu pour les agents.

caioricciuti
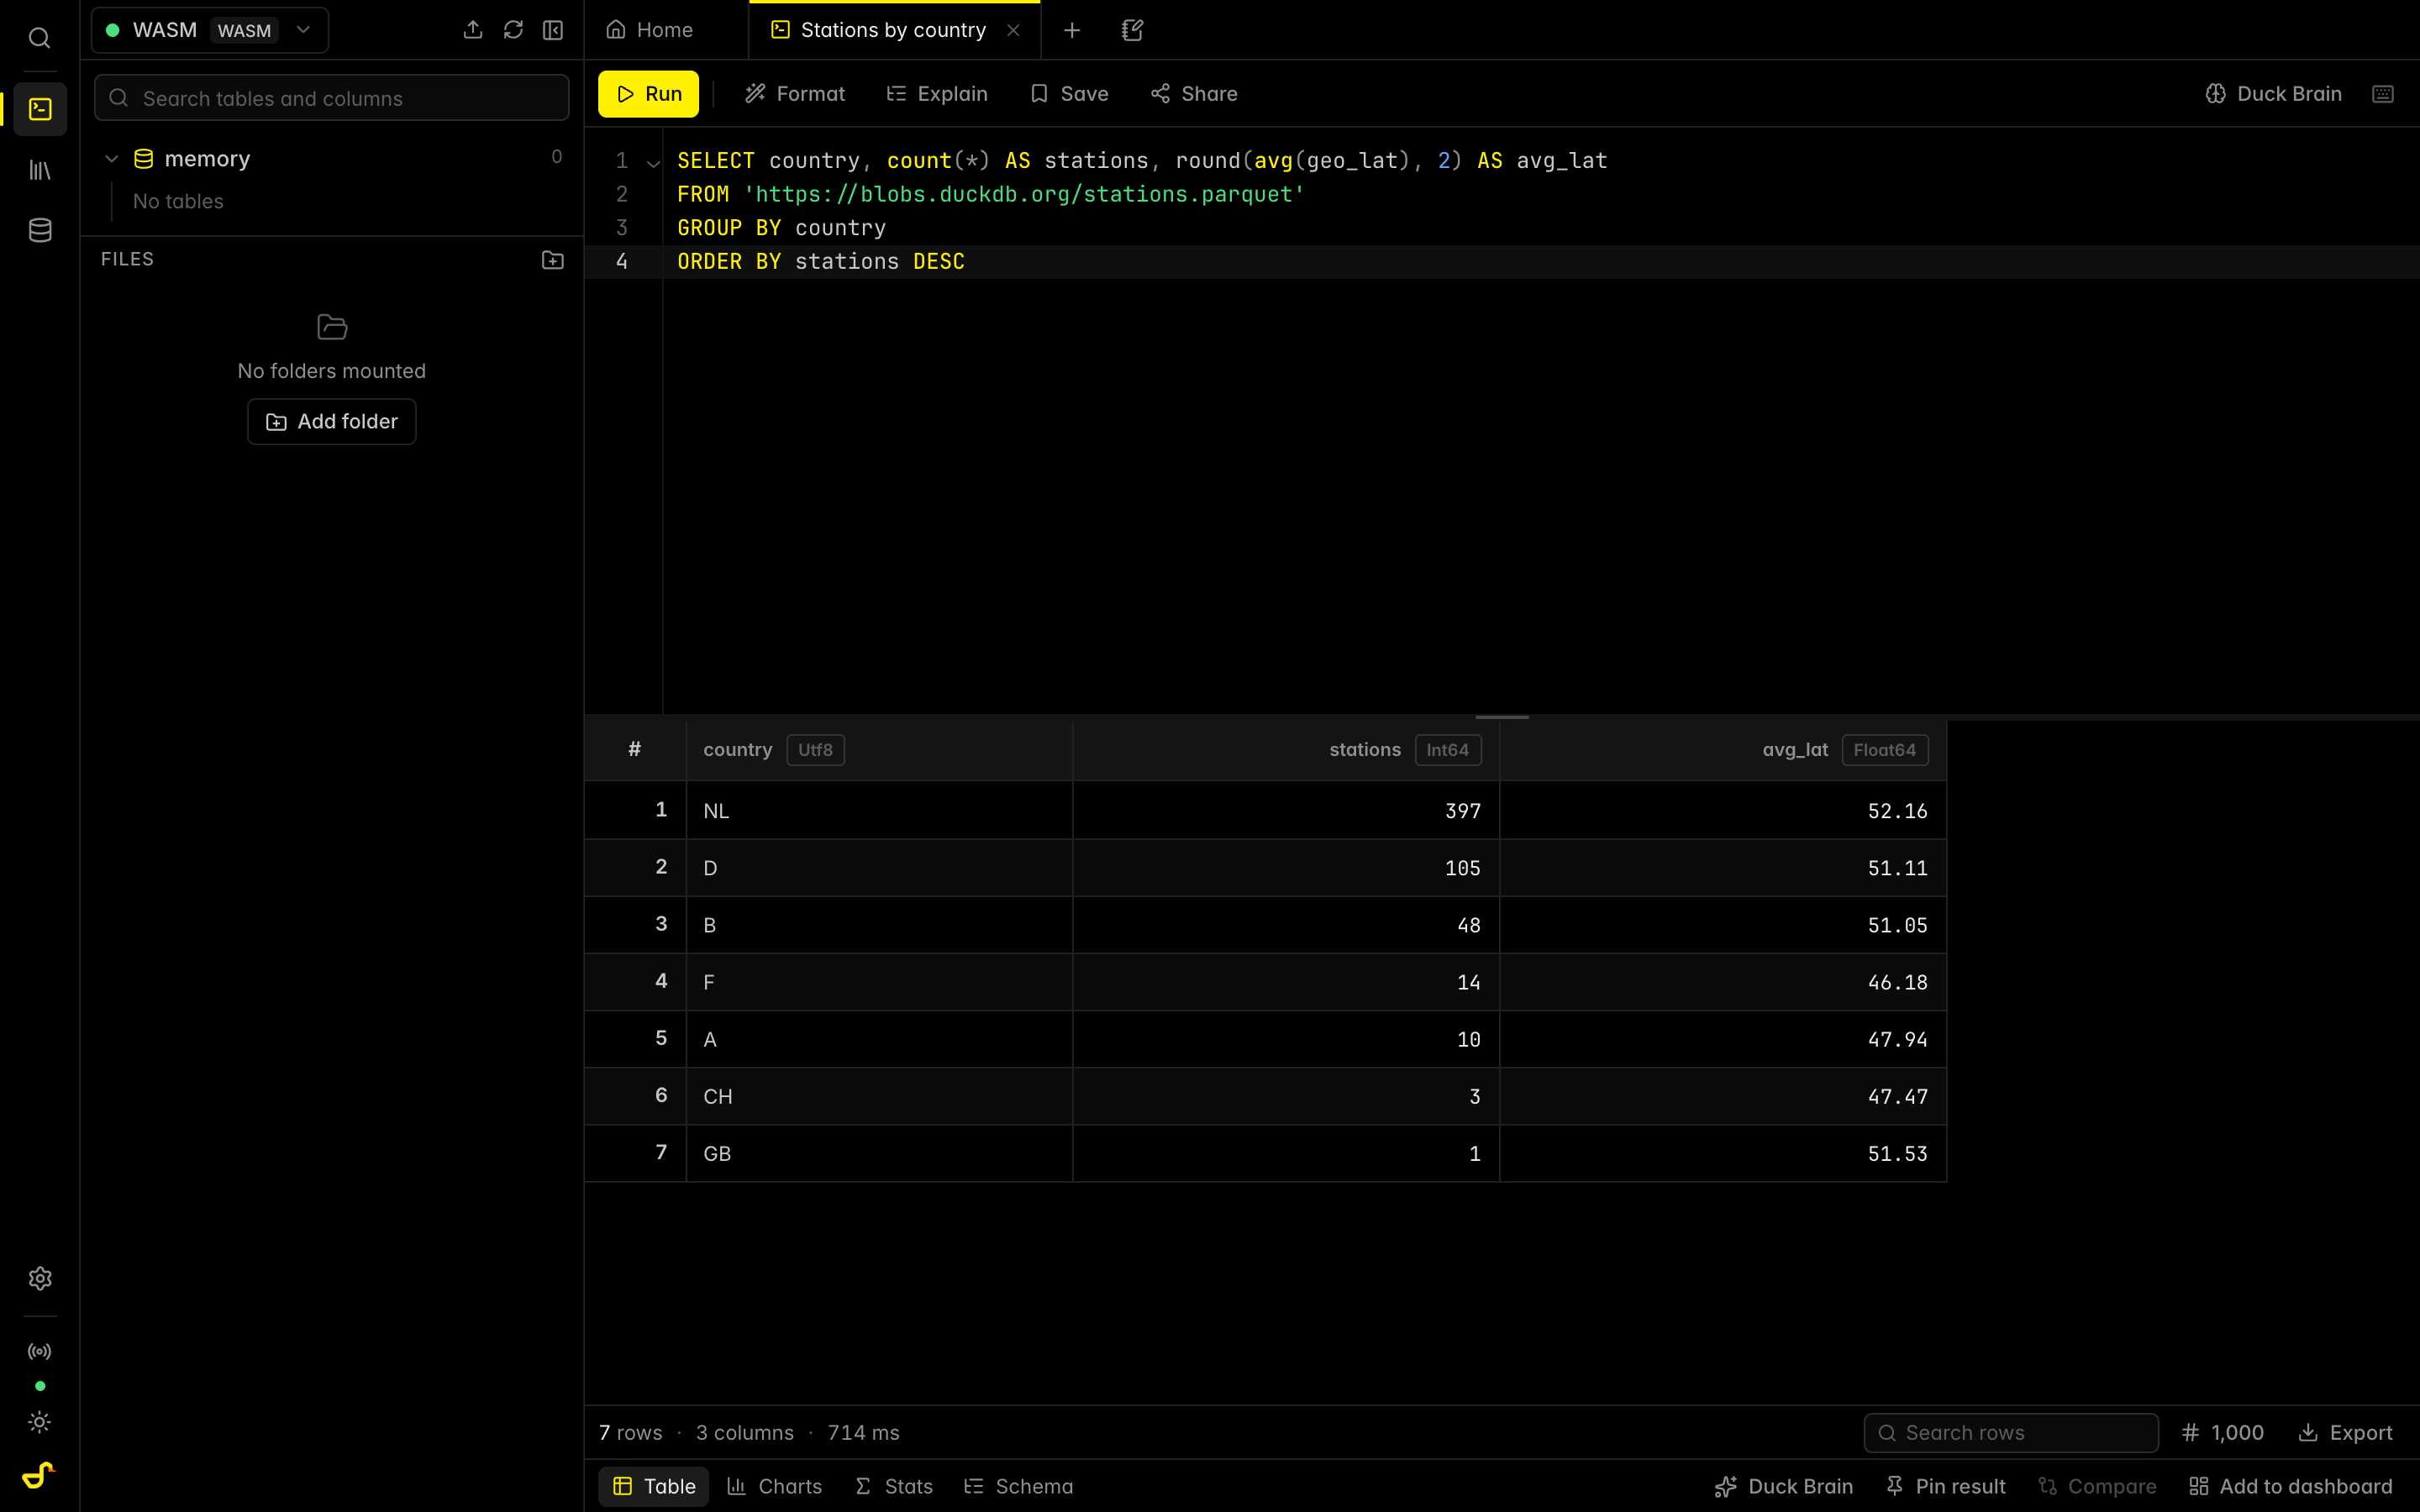
Un environnement de travail DuckDB entièrement open source qui s’exécute dans votre navigateur. Il comprend un éditeur SQL, des notebooks, des graphiques et un assistant IA. Aucune installation, inscription ou infrastructure serveur n’est nécessaire : vos données ne quittent jamais l’onglet.

henrydaum
Second Brain est un framework agentique qui sert de système d’exploitation. Il s’appuie sur le traitement intelligent des fichiers locaux, l’automatisation des flux de travail et des LLM pour accomplir des tâches et communiquer via différentes modalités et plateformes de messagerie.

jamezmca
Cours complet de développement backend | NodeJS, ExpressJS, PostgreSQL, Prisma et Docker, avec authentification JWT, opérations CRUD sur une base de données et points de terminaison d’API REST 🔥

joelgrus
Code du livre Data Science From Scratch

lookup-foundation

Outil interactif d’exploration de la base de données Revit

neondatabase
Neon : Postgres serverless. Nous avons séparé le stockage et le calcul afin de proposer une mise à l’échelle automatique, des branches de base de données comme dans le code et une mise à l’échelle jusqu’à zéro.

prisma
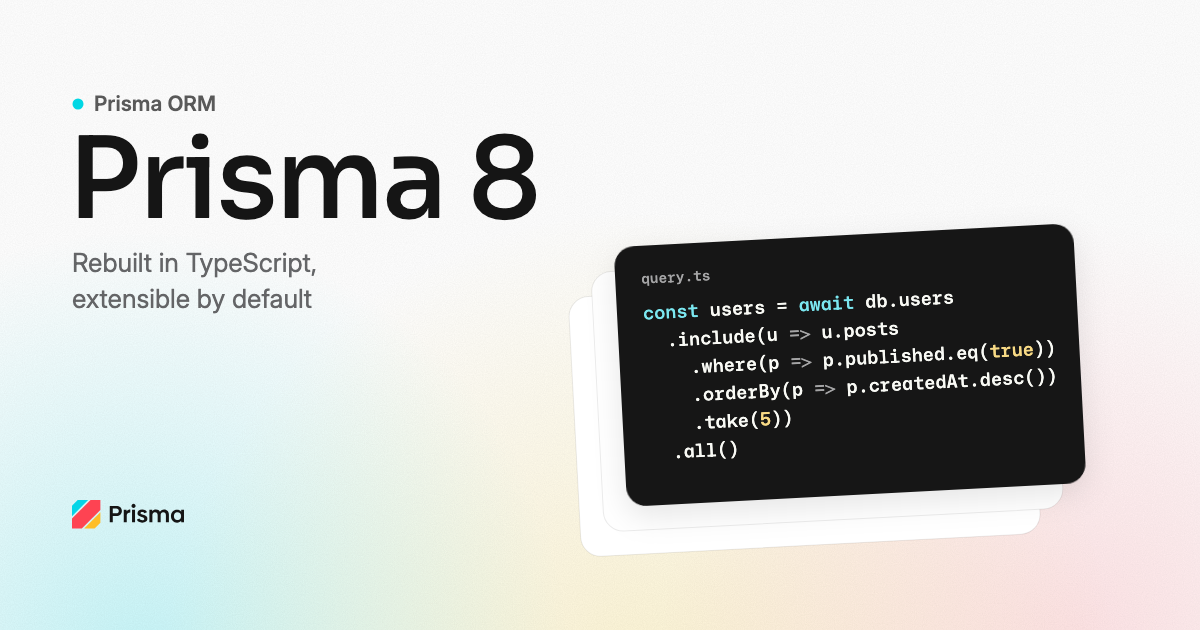
Prisma ORM : écrivez votre application en TypeScript avec des requêtes lisibles par l'humain au lieu de SQL. Hébergez votre base de données sur Prisma Postgres et votre application sur Prisma Compute.

sqldelight
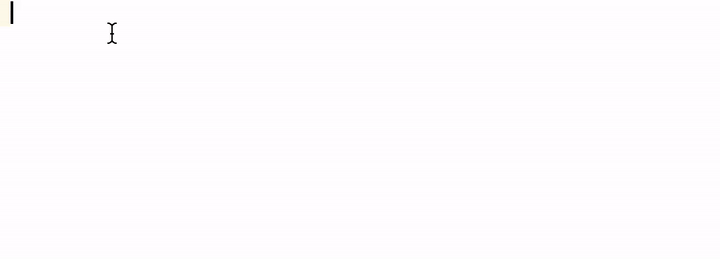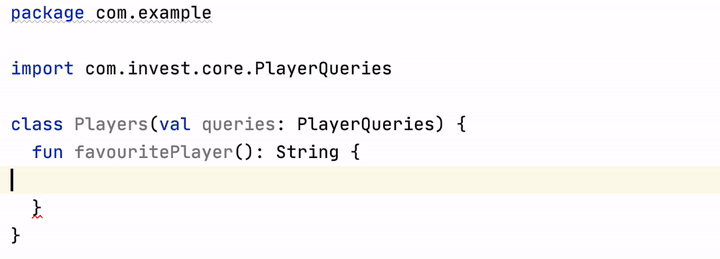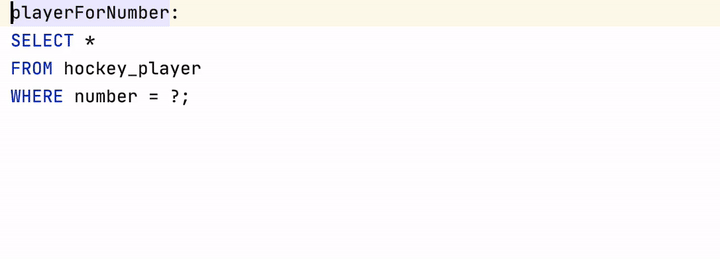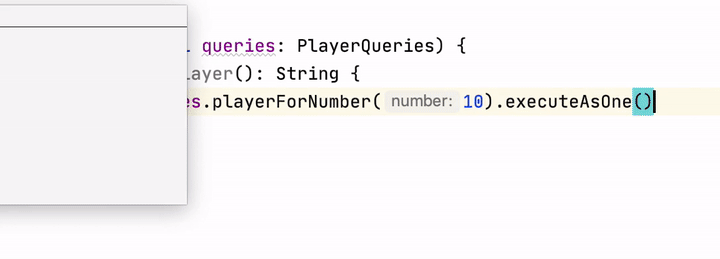
SQLDelight - Generates typesafe Kotlin APIs from SQL

Vonng

Traduction chinoise de la première et de la deuxième édition de 《Designing Data-Intensive Application》 (DDIA).

AkashSingh3031

Dive into this repository, a comprehensive resource covering Data Structures, Algorithms, 450 DSA by Love Babbar, Striver DSA sheet, Apna College DSA Sheet, and FAANG Questions! 🚀 That's not all! We've got Technical Subjects like Operating Systems, DBMS, SQL, Computer Networks, and Object-Oriented Programming, all waiting for you.

akvise

Python CLI for Google Trends analysis with advanced rate limiting, cookie auth, and beautiful terminal output. Built on pytrends with enterprise features.

ananas-analytics

A hackable data integration & analysis tool to enable non technical users to edit data processing jobs and visualise data on demand.

apache

Gluten is a middle layer responsible for offloading JVM-based SQL engines' execution to native engines.

arpanghosh8453
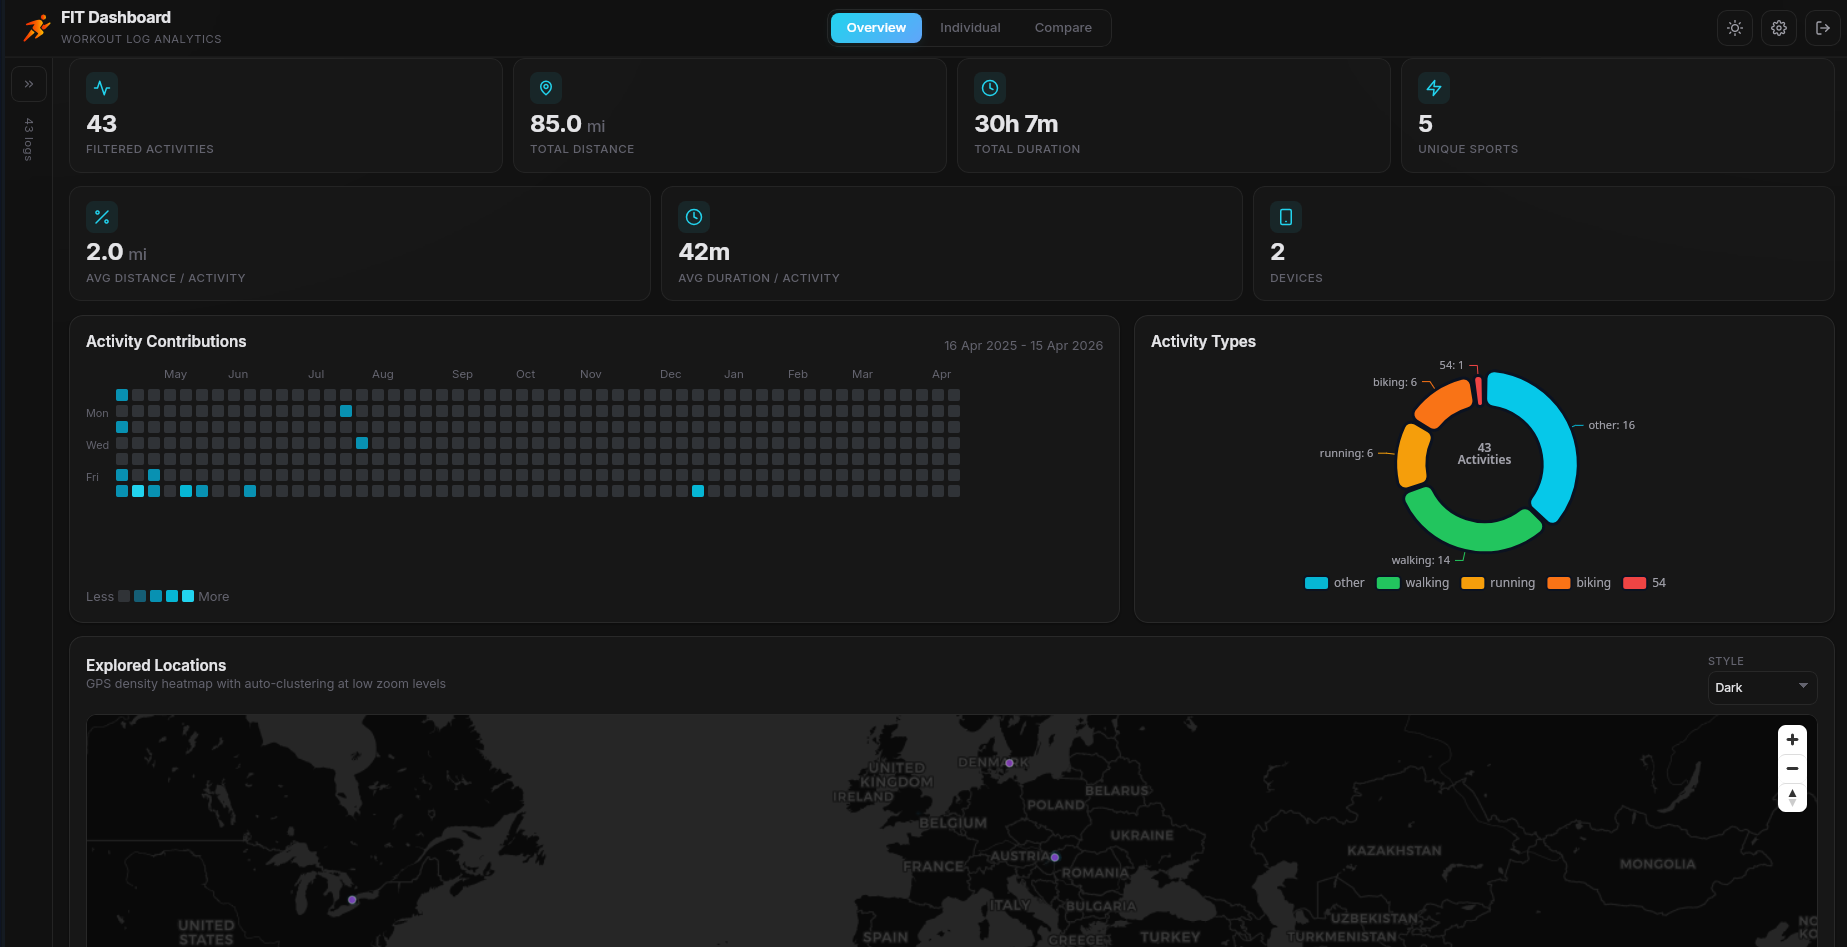
Standalone offline local desktop application to process, store, and visualize Garmin FIT file data in a comprehensive dashboard.