
QwenAudio/Fun-ASR
QwenAudio/Fun-ASR has 1,610 GitHub stars and 162 forks. GitHot measured +11 in 7 days and +16 in 15 days. Last checked 2026-11-15 19:45 UTC. Last push 2026-11-09.
What you can do
- Far-field High-noise Recognition: Deeply optimized for far-distance sound pickup and high-noise scenarios (such as conference rooms, in-vehicle environments, industrial sites, etc.), improving recognition accuracy to 93%.
- Supports 7 major dialects: Wu, Cantonese, Min, Hakka, Gan, Xiang, Jin
- Covers 26 regional accents: including Henan, Shaanxi, Hubei, Sichuan, Chongqing, Yunnan, Guizhou, Guangdong, Guangxi and more than 20 other regions
- Checkpoint-specific language coverage: Fun-ASR-Nano supports Chinese, English, Japanese, and Chinese dialects and accents. Fun-ASR-MLT-Nano supports 31 languages, with emphasis on East and Southeast Asian languages.
측정된 스타 증가
- in 24h
- 업데이트 지연
- in 7 days
- +11
- in 15 days
- +16
- in 1 month
- 업데이트 지연
서로 겹치는 기간의 순증가량이며 일별 합계가 아닙니다. 측정값이 없으면 비워 둡니다. 스타는 관심도를 나타내며 품질을 보장하지 않습니다.
소개
Fun-ASR speech recognition models, with native Hugging Face Transformers support for Fun-ASR-Nano and separate FunASR, vLLM and llama.cpp deployment paths.
머신러닝README_ko.md
OriginalFun-ASR
FunASR 1.4.15: 현재 Python 릴리스로 source install, MOSS 탐색 경로, realtime / industrial deployment를 제공합니다.
python -m pip install -U "funasr==1.4.15". Release -> · Runtime v0.2.6 ->
MOSS-Transcribe-Diarize: OpenMOSS의 서드파티 모델로 오프라인 장시간 전사, timestamp, 익명 speaker label을 한 번에 처리합니다. FunASR service, Docker, Kubernetes, vLLM, SGLang, LocalAI, FunClip 배포 경로를 사용할 수 있습니다. MOSS 배포 ->
Fun-ASR는 통의(Tongyi) 실험실에서 개발한 엔드투엔드 음성 인식 모델 제품군입니다. 체크포인트별 지원 범위가 다릅니다. Fun-ASR-Nano-2512는 중국어·영어·일본어와 중국어 방언·지역 억양을 지원하고, Fun-ASR-MLT-Nano-2512는 31개 언어를 지원합니다. 두 체크포인트 모두 FunASR에서 추론과 서빙에 사용할 수 있습니다.
홈페이지 | 주요 기능 | 성능 평가 | 환경 설정 | 사용법
모델 저장소: Fun-ASR-Nano(ModelScope, HF / Transformers · HF / FunASR, GGUF) · Fun-ASR-MLT-Nano(ModelScope, Hugging Face)
온라인 체험: ModelScope Space, HuggingFace Space

실행 가능한 예제는 quickstart 추론, 직접 추론, 화자 분리, vLLM 배치 추론, Streaming SDK를 다룹니다.
| 모델 | 지원 작업 | 학습 데이터 | 파라미터 |
|---|---|---|---|
| Fun-ASR-Nano (⭐ HF / Transformers · HF / FunASR) |
중국어·영어·일본어 음성 인식. 중국어 7개 방언 + 26개 지역 억양 지원. 영어·일본어도 다양한 억양 대응. 가사 인식·랩 음성 인식 탑재. | 수천만 시간 | 8억 |
| Fun-ASR-MLT-Nano (⭐ 🤗) |
중국어, 영어, 광둥어, 일본어, 한국어, 베트남어, 인도네시아어, 태국어, 말레이어, 필리핀어, 아랍어, 힌디어 등을 포함한 31개 언어 음성 인식. | 수십만 시간 | 8억 |
CPU/엣지 환경에서는 Fun-ASR-Nano를 llama.cpp / GGUF 런타임으로 단일 바이너리 실행할 수 있습니다(Python/GPU 불필요, FSMN-VAD 내장). 이 GGUF 경로는 Nano의 중국어·영어·일본어 및 중국어 방언 범위에 해당하며, 한국어 인식은 위의 MLT-Nano/FunASR GPU 경로를 사용하세요. funasr.com/llama-cpp · Nano GGUF · FSMN-VAD GGUF
Transformers 네이티브 빠른 시작
정식 Transformers 5.17.0으로 음성을 전사합니다. FunASR toolkit 설치나 원격 Python 코드가 필요 없습니다. 기본 Nano는 중국어·영어·일본어를 지원하며 31개 언어의 MLT는 별도 checkpoint입니다.
python -m pip install 'transformers==5.17.0' 'torch==2.10.0' 'torchaudio==2.10.0' 'librosa==0.11.0' 'soundfile==0.13.1'
Python 가이드 · 로컬 오디오·배치·키워드 · Notebook · Space
import torch
from transformers import AutoModelForSpeechSeq2Seq, AutoProcessor

torch.set_num_threads(4)
model_id = "FunAudioLLM/Fun-ASR-Nano-2512-hf"
revision = "d93b302ee7fd505e1b3576120fc142fc6f7820e1"
audio = "https://huggingface.co/FunAudioLLM/Fun-ASR-Nano-2512/resolve/272c57b82523ada6fd87095e955f8e29100979ab/example/en.mp3"

processor = AutoProcessor.from_pretrained(
    model_id, revision=revision, trust_remote_code=False, token=False
)
model = AutoModelForSpeechSeq2Seq.from_pretrained(
    model_id, revision=revision, trust_remote_code=False, token=False,
    dtype=torch.float32,
).to("cpu").eval()
inputs = processor.apply_transcription_request(
    audio=audio, language="en",
    processor_kwargs={
        "return_tensors": "pt",
        "audio_kwargs": {"sampling_rate": 16000},
        "text_kwargs": {"padding": True},
    },
)
with torch.inference_mode():
    generated = model.generate(**inputs, max_new_tokens=128, do_sample=False)
new_tokens = generated[:, inputs.input_ids.shape[1]:]
print(processor.batch_decode(new_tokens, skip_special_tokens=True)[0])
주요 기능 🎯
- 원거리·고소음 환경 대응: 회의실, 차량, 공장 등 고소음 환경에 최적화, 인식 정확도 93% 달성
- 31개 언어 다국어 지원(MLT-Nano): 동아시아·동남아시아 언어를 중심으로 31개 언어 인식
- 한국어 지원: Fun-ASR-MLT-Nano를 통한 한국어 음성 인식
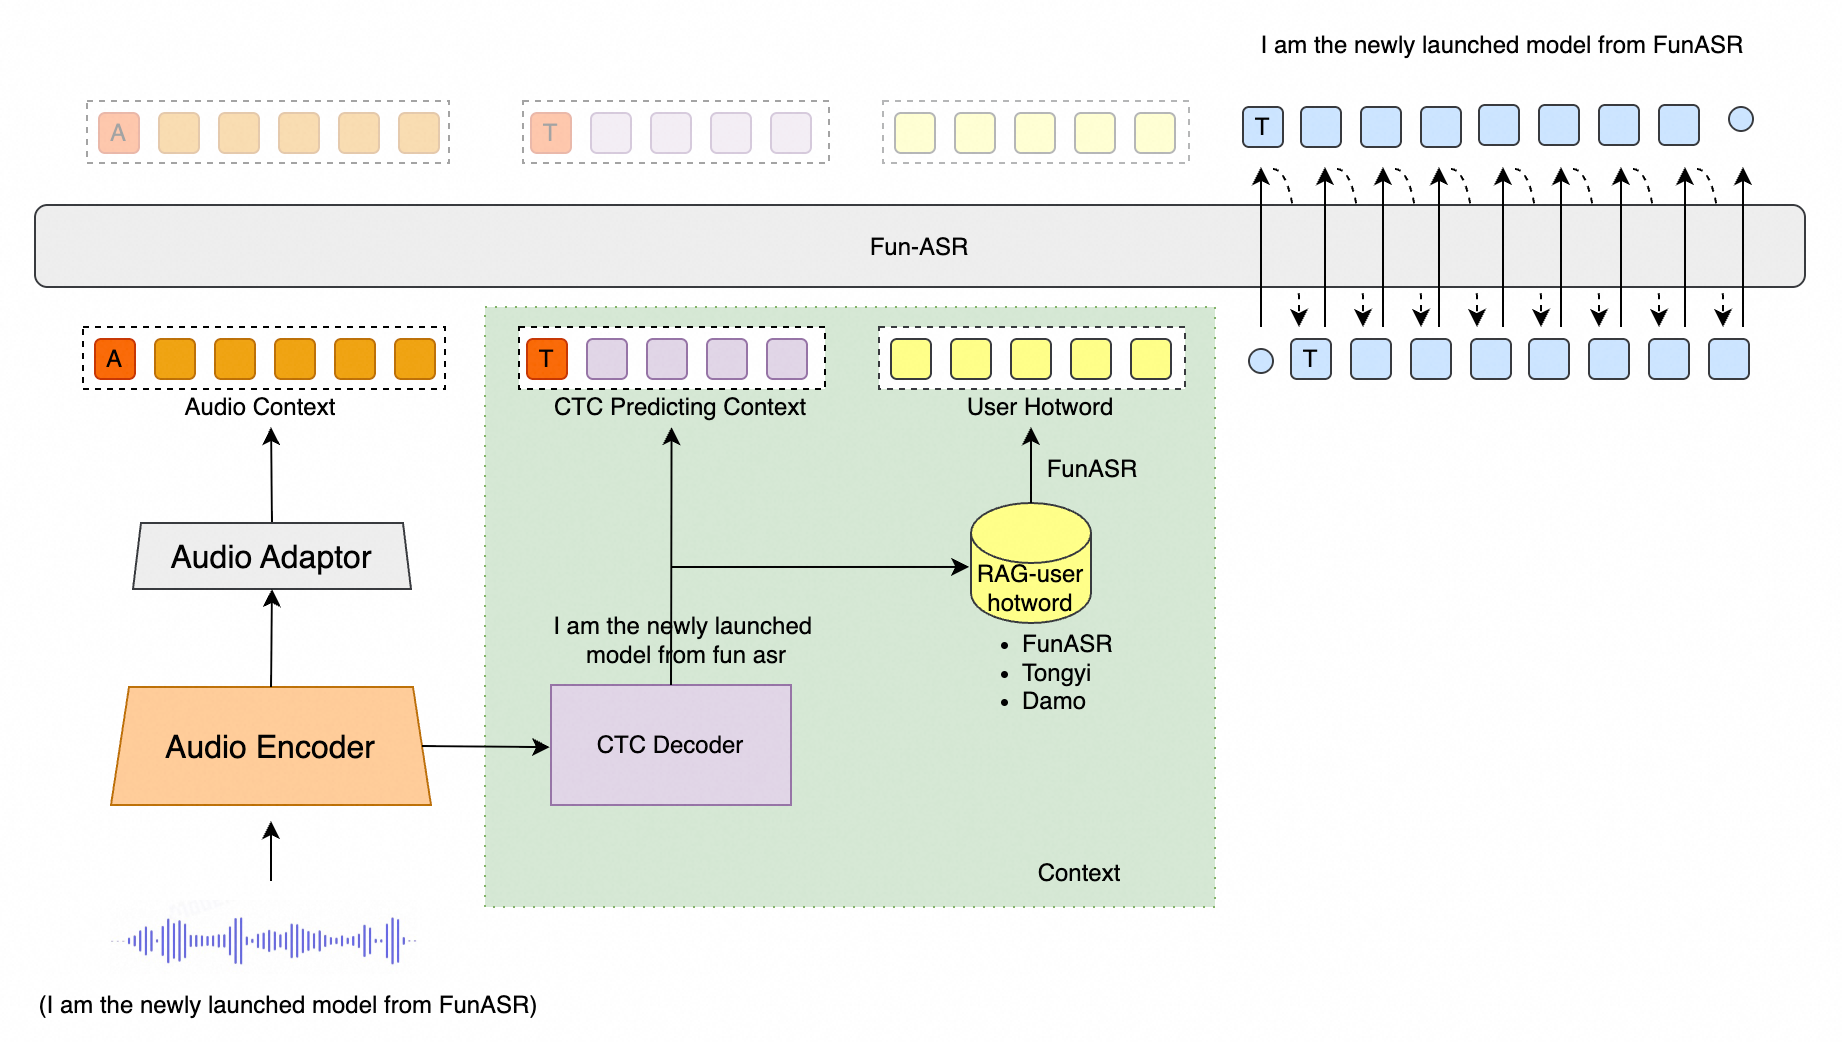
- 핫워드 기능: 도메인 특정 용어의 인식 정확도 향상
- FunASR 파이프라인 화자 분리: 별도의 FSMN-VAD와 CAM++를 조합해 화자 레이블 생성
- vLLM 추론 엔진: 배치 추론으로 최대 340배 실시간 속도
환경 설정 🐍
git clone https://github.com/QwenAudio/Fun-ASR.git
cd Fun-ASR
pip install -r requirements.txt
기능 범위
- 타임스탬프(호스팅 소스별 상태): 현재 ModelScope의
FunAudioLLM/Fun-ASR-Nano-2512체크포인트에는 학습된ctc_decoder.*/ctc.*텐서 86개가 모두 포함되어 있습니다(model.ptSHA-256:81fec8616083c69377f3ceef36aba3655660ee0ca69a5d4a1e9810cd340ca499). 반면 Hugging Face revision272c57b82523ada6fd87095e955f8e29100979ab는 CTC 텐서가 없는 이전 텍스트 전용 아티팩트입니다(SHA-256:55ae0d2fee369f0f11cce0795f6927934ad17cf11b278a7e56a51272074160bb). 이 저장소의 현재model.py를funasr>=1.3.26과 함께 사용하면 불완전한 체크포인트의 CTC를 비활성화하여 텍스트 전사는 유지하되 임의의 60 ms 타임스탬프는 반환하지 않습니다. Hugging Face 가중치와 remote code가 동기화되기 전에는 문자 단위 타임스탬프에hub="ms"를 사용하세요(issue #70, FunASR #3496). - 화자 분리: Nano/MLT 체크포인트 자체는 화자 레이블을 출력하지 않습니다. FunASR에서
fsmn-vad와cam++를 조합합니다.
사용법 🛠️
기본 추론
from funasr import AutoModel

model = AutoModel(
    model="FunAudioLLM/Fun-ASR-MLT-Nano-2512",  # 한국어는 MLT 모델 사용
    trust_remote_code=True,
    device="cuda:0",
    hub="hf"
)

result = model.generate(
    input=["audio.wav"],
    batch_size=1,
    language="韩文",
)
print(result[0]["text"])
FunASR 파이프라인을 사용한 화자 분리
이 예제에서는 FSMN-VAD가 오디오를 분할하고, Fun-ASR가 전사하며, CAM++가 화자 레이블을 지정합니다. sentence_info 구간은 VAD 세그먼트 경계이며 체크포인트 기반 문자 단위 타임스탬프가 아닙니다.
model = AutoModel(
    model="FunAudioLLM/Fun-ASR-MLT-Nano-2512",
    trust_remote_code=True,
    device="cuda:0",
    hub="hf",
    vad_model="fsmn-vad",
    spk_model="cam++",
    punc_model="ct-punc"
)

result = model.generate(input=["meeting.wav"], batch_size=1)
for item in result:
    if 'sentence_info' in item:
        for sent in item['sentence_info']:
            print(f"[화자{sent['spk']}] {sent['sentence']}")
성능 평가 📊
| 모델 | GPU 속도 | CPU 속도 | vs Whisper-large-v3 |
|---|---|---|---|
| Fun-ASR-Nano (vLLM) | 340x 실시간 | — | 🚀 26배 빠름 |
| SenseVoice-Small | 170x 실시간 | 17x 실시간 | 🚀 13배 빠름 |
| Whisper-large-v3 | 13x 실시간 | ❌ | 기준 |
에코시스템
Fun-ASR-Nano는 FunAudioLLM 패밀리의 일원입니다:
| 프로젝트 | 설명 | Stars |
|---|---|---|
| FunASR | 산업용 음성 인식 툴킷 — VAD, ASR, 구두점, 화자 분리 |  |
| SenseVoice | 초고속 ASR + 감정 인식 + 오디오 이벤트 감지 |  |
| CosyVoice | 자연 음성 생성 — 다국어, 제로샷 클로닝 |  |
| FunClip | AI 음성 인식 기반 비디오 클리핑 |  |