
yifanfeng97/Hyper-Extract
yifanfeng97/Hyper-Extract has 4,216 GitHub stars and 484 forks. GitHot measured +1 stars in 24 hours and +9 in 7 days. Last checked 2026-11-08 08:43 UTC. Last push 2026-10-29.
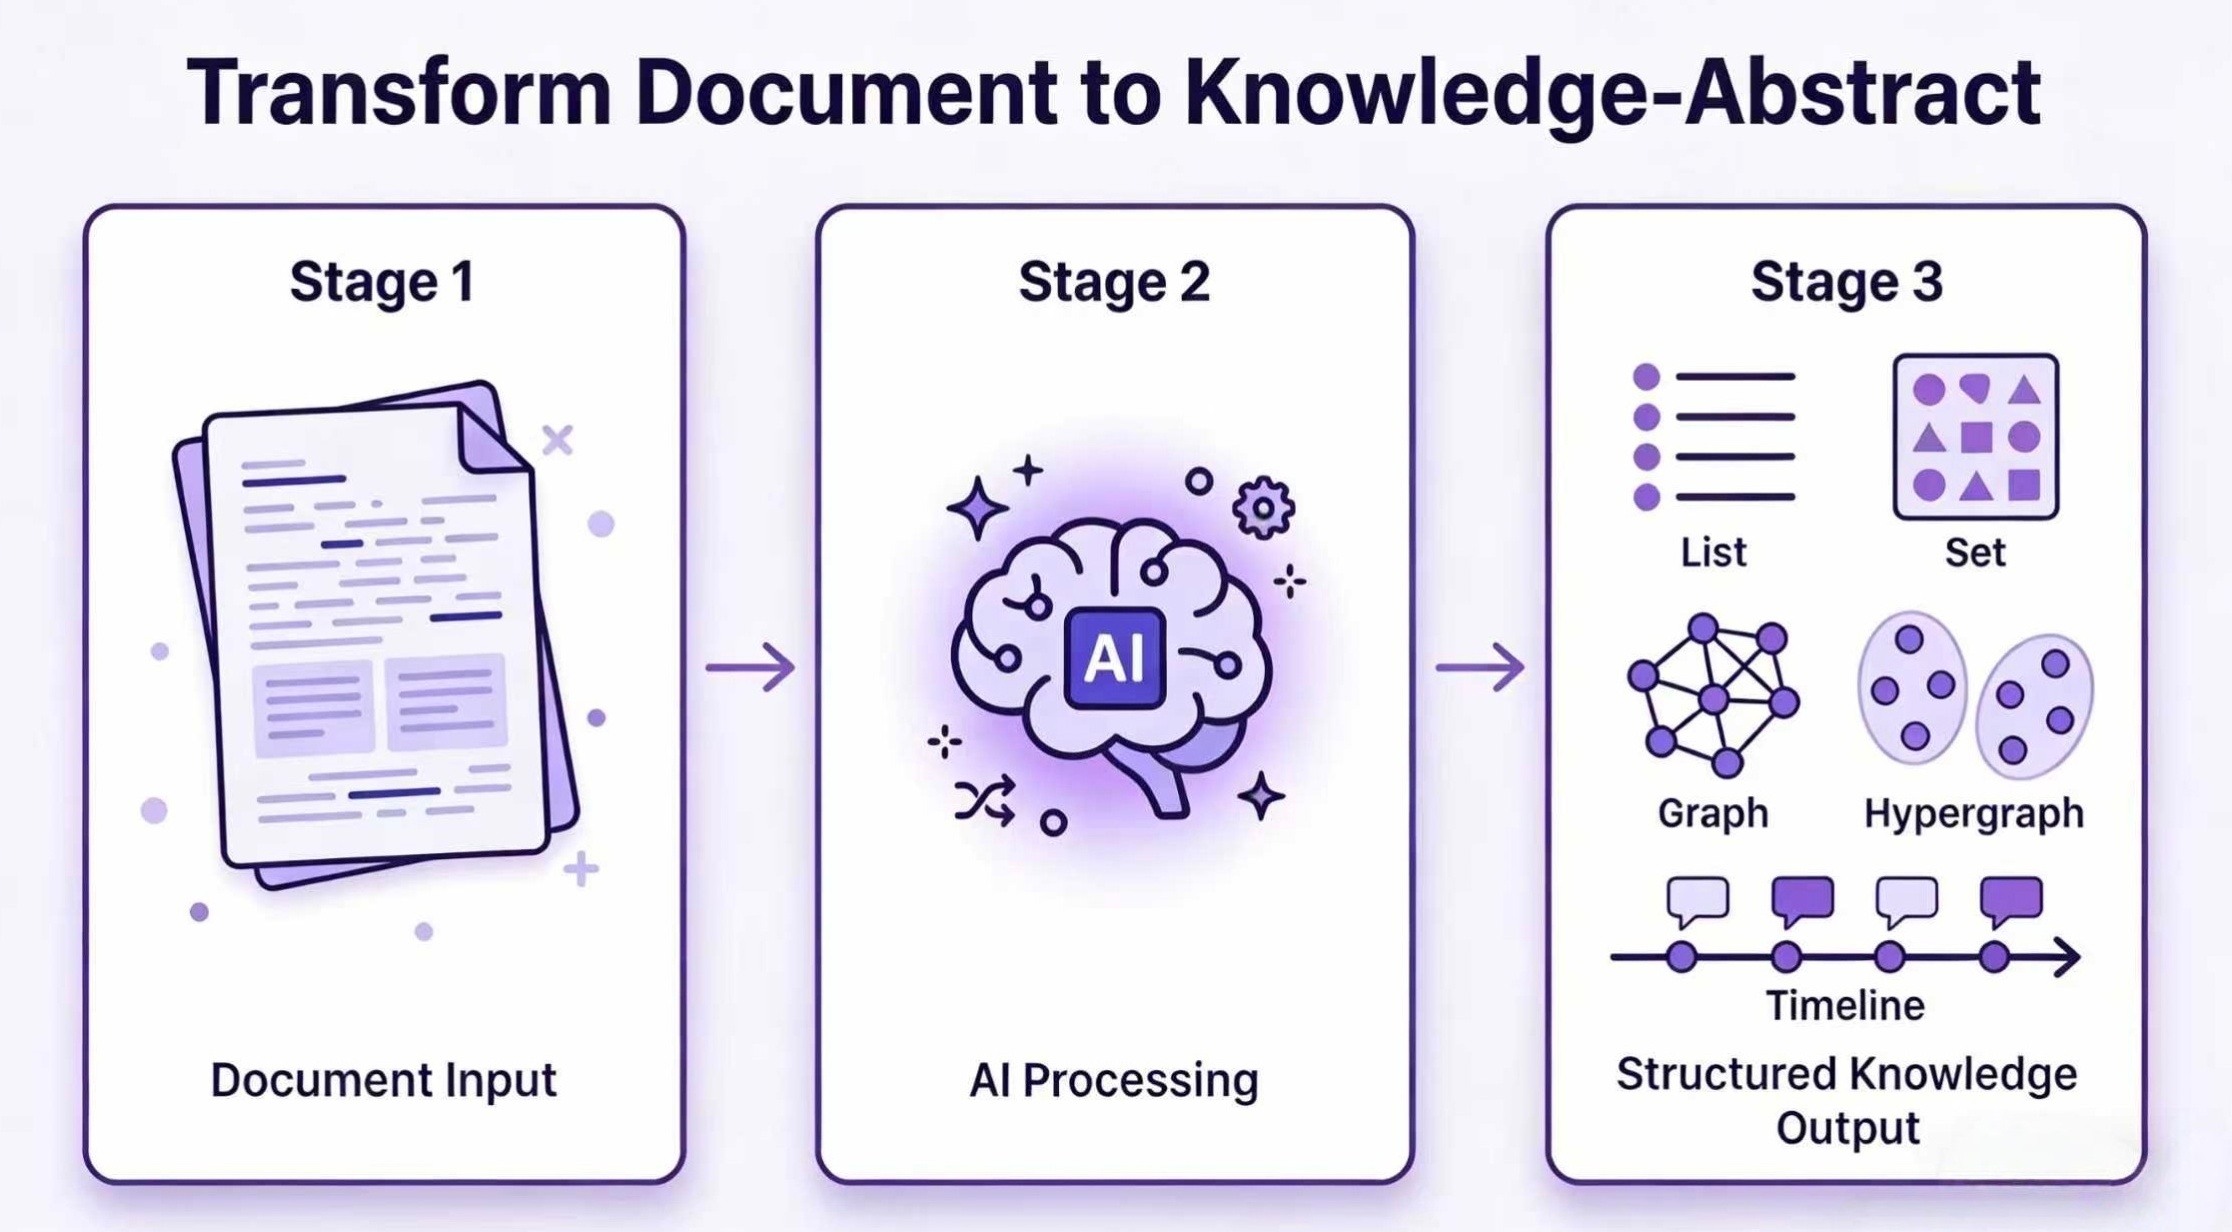
超图更强大。使用 LLM 将非结构化文本转化为结构化知识。只需一条命令,即可提取图、超图和时空信息。
可以做什么
- 📄 Rich Document Ingestion - Feed PDF, Word, PowerPoint, Excel, HTML, EPUB and more — not just .txt/.md (pip install "hyperextract[ingest]")
- 🔷 9 Knowledge Structures - From raw chunk corpora and simple Lists to advanced Graphs, Hypergraphs, and Spatio-Temporal Graphs
- 🧠 11+ Extraction Engines - chunk_rag (zero-cost baseline), GraphRAG, LightRAG, Hyper-RAG, KG-Gen, and more — ready to use
- 📝 80+ YAML Templates - Zero-code extraction across Finance, Legal, Medical, TCM, Industry, and General domains
实测星标增长
- 24小时
- +1
- 7天
- +9
- 15天
- 正在收集历史
- 1个月
- 正在收集历史
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
README_ZH.md
原文
智能知识提取 CLI
一行命令,将文档转化为结构化知识。




"Stop reading. Start understanding."
"告别文档焦虑,让信息一目了然"
⚡ 30 秒快速上手
1. 安装:
# 先安装 uv(如果还没有)
curl -LsSf https://astral.sh/uv/install.sh | sh

# 安装 Hyper-Extract CLI
uv tool install hyperextract
# 或:pipx install hyperextract
2. 配置你的 provider(任选其一):
# OpenAI(一个 key 同时提供 LLM 和 embedding)
he config init -p openai -k YOUR_OPENAI_API_KEY

# DeepSeek(仅 LLM——搭配 OpenAI embedder,最经济)
he config llm -p deepseek -k YOUR_DEEPSEEK_API_KEY
he config embedder -p openai -k YOUR_OPENAI_API_KEY

# 本地 vLLM(免费、数据不出本机)
he config llm -p vllm -u http://localhost:8000/v1 -k dummy -m Qwen/Qwen3.5-9B
he config embedder -p vllm -u http://localhost:8001/v1 -k dummy -m BAAI/bge-m3
更多 provider — Anthropic (Claude)、Google Gemini、阿里云百炼、OrcaRouter…
# Anthropic (Claude) —— 仅 LLM
he config llm -p anthropic -k YOUR_ANTHROPIC_API_KEY
he config embedder -p openai -k YOUR_OPENAI_API_KEY

# Google Gemini —— 仅 LLM(默认:gemini-3.8-flash)
he config llm -p google -k YOUR_GOOGLE_API_KEY
he config embedder -p openai -k YOUR_OPENAI_API_KEY

# 百炼(阿里云,Qwen,一个 key 同时提供 LLM 和 embedding)
he config init -p bailian -k YOUR_BAILIAN_API_KEY
OpenAI 和百炼同时提供 LLM 和 embedding 模型;Anthropic、Google Gemini 和 DeepSeek 仅提供 LLM(需搭配 OpenAI 兼容 embedder)。DeepSeek 最经济(约 $0.001-0.005/页)。
3. 提取、查询与可视化:
# 从文档提取知识
he parse examples/zh/sushi.md -t general/biography_graph -o ./output/ -l zh

# 查询
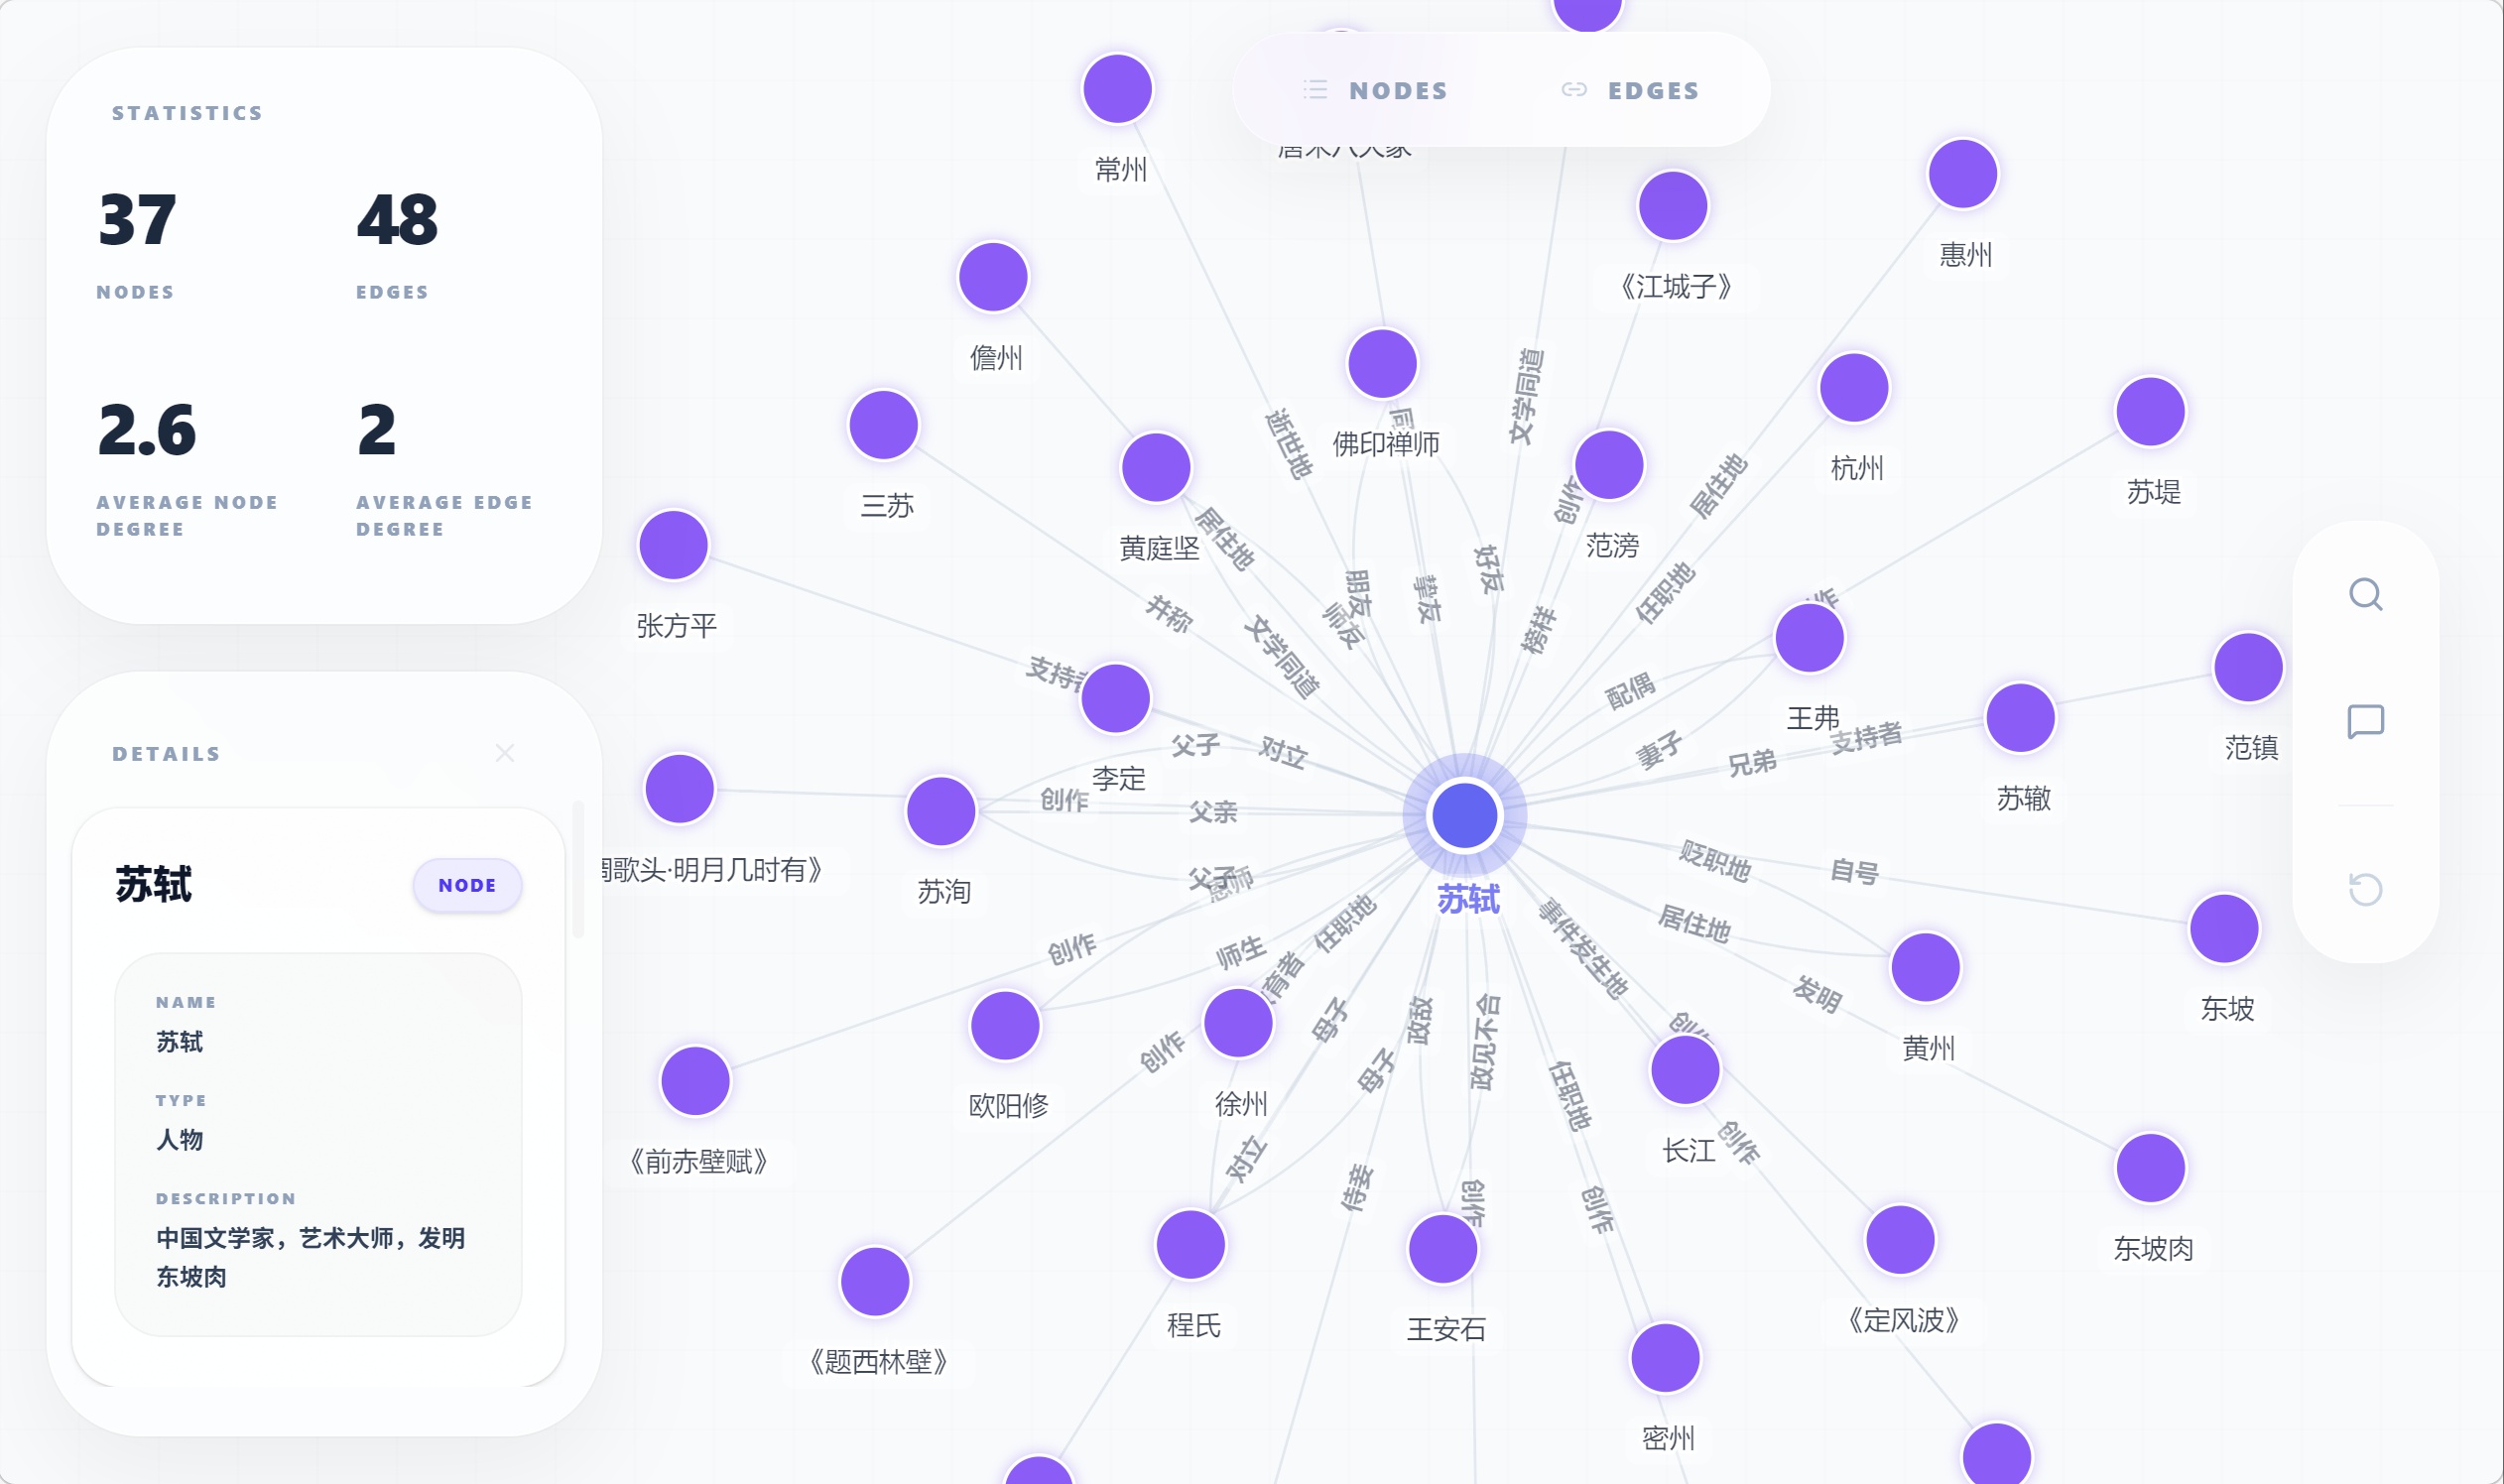
he search ./output/ "苏轼有哪些重要的作品?"

# 可视化
he show ./output/

# 导出为 Obsidian 知识库(Markdown 笔记 + [[双向链接]])
he export obsidian ./output/ -o ./vault/

# 来源文档变化了?同 source 重喂——旧事实自动回滚
he feed ./output/ updated-sushi.md --source sushi.md

# 打标签并范围检索
he tag ./output/ --source sushi.md --add biography
he search ./output/ "作品" --tag biography

# 审计:哪些文档贡献了什么?
he info ./output/ --sources
该用哪个 provider? OpenAI 和百炼同时提供 LLM 和 embedding 模型;Anthropic 和 DeepSeek 仅提供 LLM(需搭配 OpenAI 兼容 embedder);本地 vLLM 免费但需要 GPU。完整指南:Provider 系统。
🐍 Python API(点击展开)
uv pip install hyperextract
from hyperextract import Template

ka = Template.create("general/biography_graph")

with open("examples/zh/sushi.md") as f:
    result = ka.parse(f.read())

result.show()
🔗 更多示例:examples/zh
✨ 核心亮点
| 📄 丰富的文档输入 | 不止 .txt/.md——PDF、Word、PowerPoint、Excel、HTML、EPUB 等直接喂入(pip install "hyperextract[ingest]") |
| 🔷 9 种知识结构 | 从原始语料块、简单列表到复杂的图谱、超图、时空图谱 |
| 🧠 11+ 提取引擎 | chunk_rag(零成本基线)、GraphRAG、LightRAG、Hyper-RAG、KG-Gen 等开箱即用 |
| 📝 80+ YAML 模板 | 零代码提取,覆盖金融、法律、医疗、中医、工业、通用 6 大领域 |
| 🔄 增量演进与溯源 | 随时喂入新文档——每个来源自动标注、索引增量更新;可审计(he info --sources)、回滚(he remove --document)或以 upsert 方式更新文档 |
| 📤 Obsidian 导出 | 将提取的图谱导出为 Obsidian 知识库——以 [[双向链接]] 关联的 Markdown 笔记 |
🎯 它能做什么?
📄 科研人员 — 将论文转为知识图谱
丢进去一篇 20 页的学术论文,一键生成关键概念、作者、引用的交互式图谱。
he parse paper.pdf -t general/academic_graph -o ./paper_kb/
he show ./paper_kb/
🏦 金融分析师 — 从财报中提取实体关系
自动识别非结构化报告中的公司、高管、财务指标及其关系。
he parse earnings.md -t finance/earnings_graph -o ./finance_kb/
he search ./finance_kb/ "关键风险因素有哪些?"
🔒 本地部署 — vLLM 数据不出境
通过 vLLM 本地运行 Qwen3.5-9B + bge-m3,数据绝不离开本机。
from hyperextract import create_client
llm, emb = create_client(
    llm="vllm:Qwen3.5-9B@http://localhost:8000/v1",
    embedder="vllm:bge-m3@http://localhost:8001/v1",
    api_key="dummy",
)
📜 知识库管理员 — 让知识库与文档同步演化
文档会变。Hyper-Extract 追踪每个来源,让你可以更新、回滚或审计,而不用从头重建。
# 带来源标注摄取——每条知识可追溯到来源文档
he feed ./ka/ contract-v1.md --source contract-v1
he tag ./ka/ --source contract-v1 --add legal --add acme

# 文档更新了?同 source 重喂——旧事实自动回滚
he feed ./ka/ contract-v2.md --source contract-v1

# 文档过时了?回滚它贡献的全部知识
he remove ./ka/ --document contract-v1

# 删除单条错误事实(大模型辅助,支持 dry-run 预览)
he remove ./ka/ --edit-node Apple --fact "founded by Steve Jobs" --dry-run

# 只搜法律类文档
he search ./ka/ "termination clause" --tag legal

# 审计:哪些文档贡献了什么?
he info ./ka/ --sources
🚀 支持的平台与模型
Hyper-Extract 通过 LangChain 结构化输出的 function calling 方法工作。模型需支持 tool/function calling。
| 平台 | 已验证模型 |
|---|---|
| OpenAI | gpt-4o, gpt-4o-mini, gpt-5 |
| Anthropic | claude-opus-4-8, claude-sonnet-4-6, claude-haiku-4-5 |
| Google Gemini | gemini-3.8-flash |
| DeepSeek | deepseek-v4-flash, deepseek-v4-pro |
| 阿里云百炼 | qwen-plus, qwen-turbo, deepseek-r1 |
| 本地 vLLM | Qwen3.5-9B (GPTQ-Marlin) |
嵌入模型(语义搜索)支持任意 OpenAI 兼容端点:text-embedding-3-small、text-embedding-v4(百炼)、bge-m3(本地 vLLM)。
Provider 说明 — DeepSeek、Anthropic 与 Gemini 的搭配方式
DeepSeek: V4 模型默认开启 "thinking" 模式,Hyper-Extract 会自动关闭以保证结构化抽取可用。设置
DEEPSEEK_API_KEY。DeepSeek 没有嵌入接口:from hyperextract import create_client llm, emb = create_client(llm="deepseek", embedder="openai:text-embedding-3-small")
Anthropic: Claude 仅用于 LLM(设置
ANTHROPIC_API_KEY,额外依赖:pip install 'hyperextract[anthropic]')。没有嵌入接口:from hyperextract import create_client llm, emb = create_client(llm="anthropic", embedder="openai:text-embedding-3-small")
Google Gemini: Gemini 仅用于 LLM(设置
GOOGLE_API_KEY或GEMINI_API_KEY,额外依赖:pip install 'hyperextract[google]')。默认模型为gemini-3.8-flash。本仓库没有成熟的 embedder 路径:from hyperextract import create_client llm, emb = create_client(llm="google", embedder="openai:text-embedding-3-small")
📖 完整指南:Provider 系统与本地模型支持
📈 为什么选择 Hyper-Extract?
| 特性 | GraphRAG | LightRAG | KG-Gen | ATOM | Hyper-Extract |
|---|---|---|---|---|---|
| 知识图谱 | ✅ | ✅ | ✅ | ✅ | ✅ |
| 时序图谱 | ✅ | ❌ | ❌ | ✅ | ✅ |
| 空间图谱 | ❌ | ❌ | ❌ | ❌ | ✅ |
| 超图 | ❌ | ❌ | ❌ | ❌ | ✅ |
| 领域模板 | ❌ | ❌ | ❌ | ❌ | ✅ |
| 交互式 CLI | ✅ | ❌ | ❌ | ❌ | ✅ |
| 多语言 | ✅ | ❌ | ❌ | ❌ | ✅ |
🧩 支持的知识结构
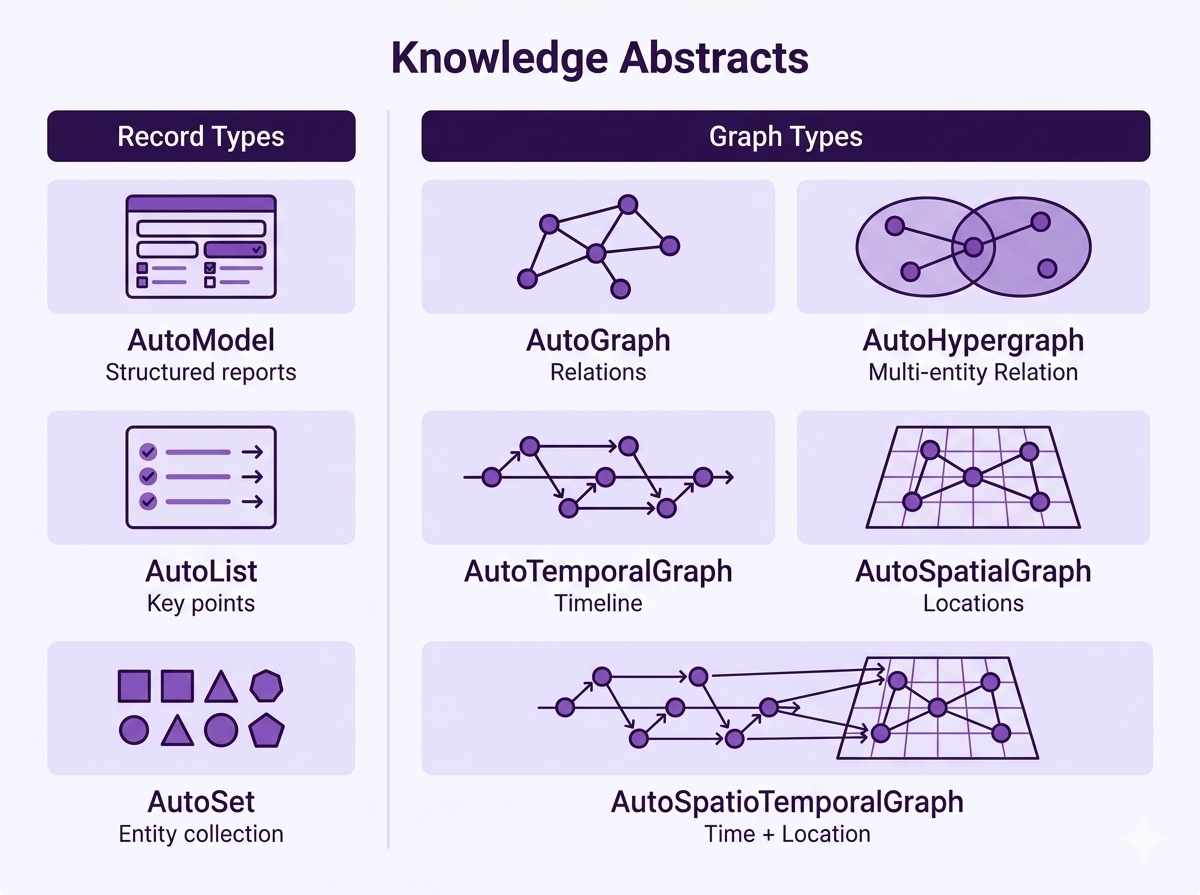
从简单到复杂 —— 为你的数据选择最合适的结构:
示例 — AutoGraph 可视化效果:
📋 底层架构与模板(点击展开)
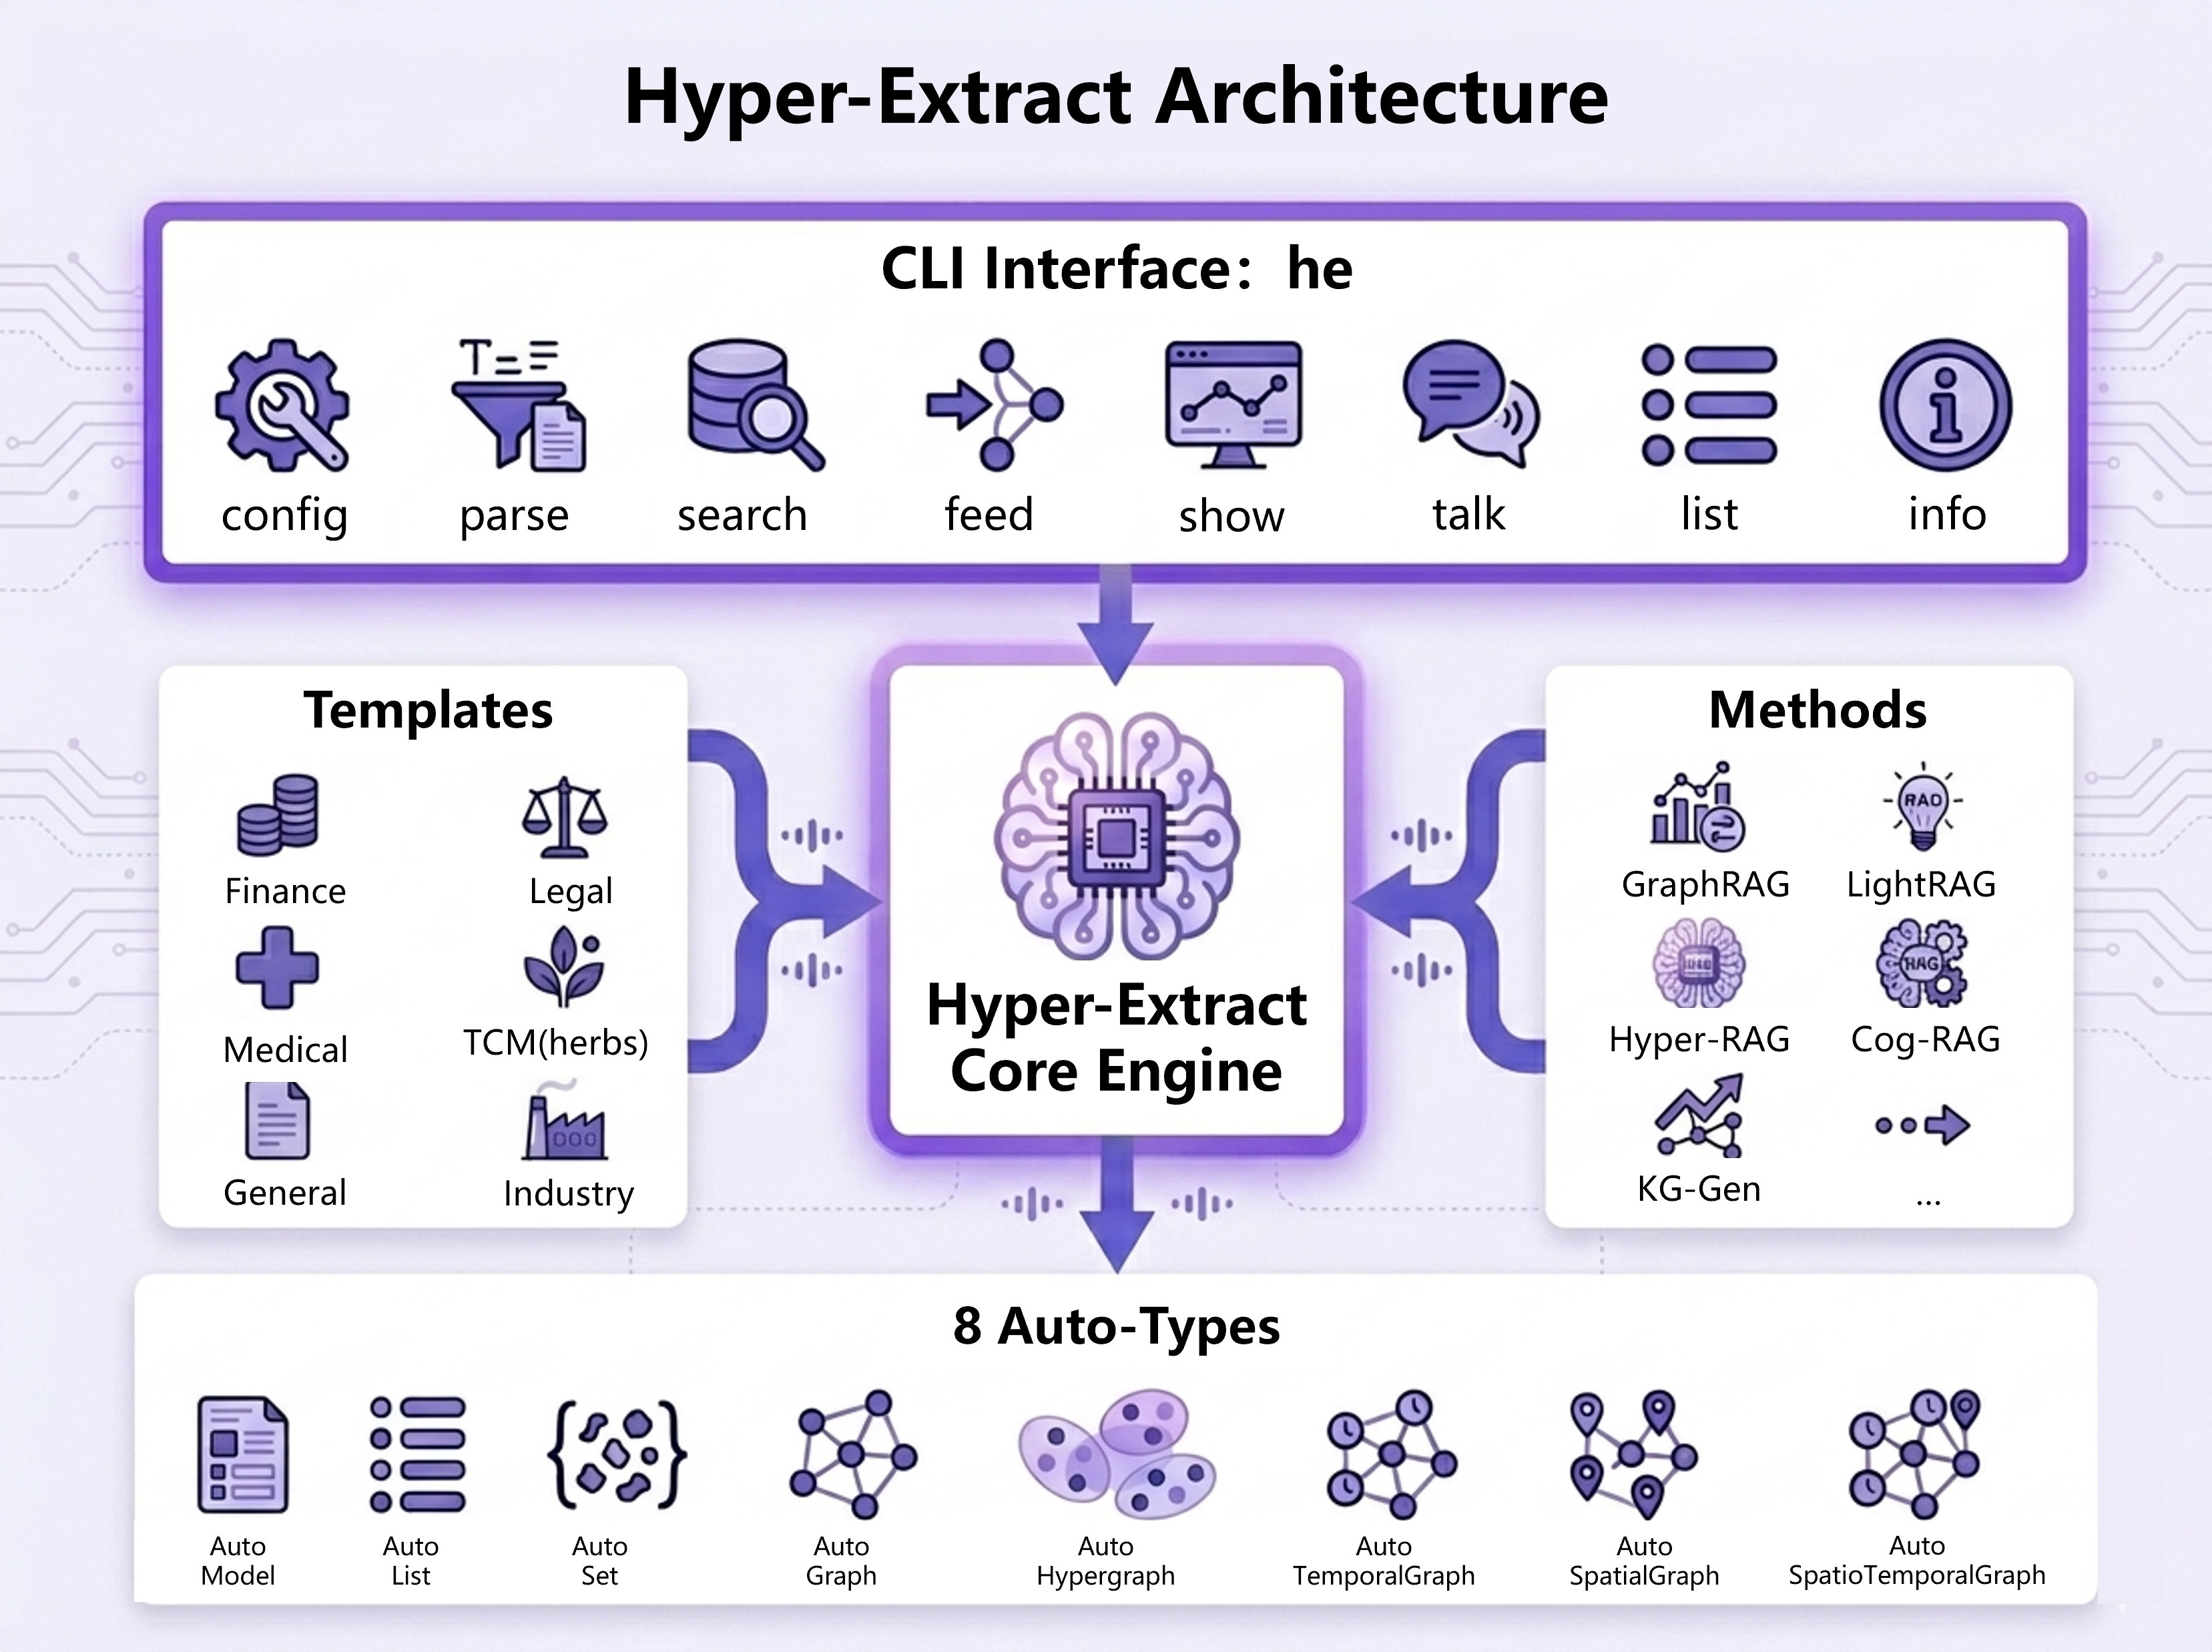
Hyper-Extract 采用三层架构:
- Auto-Types — 9 种强类型数据结构(模型、列表、集合、图谱、超图、时序图、空间图、时空图、文档语料)
- Methods — 提取与检索算法:chunk_rag 基线、KG-Gen、GraphRAG、LightRAG、Hyper-RAG、Cog-RAG 等
- Templates — 覆盖 6 大领域的 80+ 预设模板,零代码配置
模板示例(Graph 类型):
language: zh
name: 知识图谱
type: graph
tags: [general]
description: '从文本中提取实体及其关系。'
output:
  entities:
    fields:
    - name: name
      type: str
    - name: type
      type: str
    - name: description
      type: str
  relations:
    fields:
    - name: source
      type: str
    - name: target
      type: str
    - name: type
      type: str
identifiers:
  entity_id: name
  relation_id: '{source}|{type}|{target}'
📰 最新动态
v0.11.0 — 🛠️ 0.10.5 关键预设修复(7 个时空类模板)· 🔌 新增 API Route 与 Runcrate provider · 🛡️ 超图成员字段加载期校验。
📰 完整版本说明 · 全部 Releases
📚 文档与资源
| 资源 | 链接 |
|---|---|
| 完整文档 | yifanfeng97.github.io/Hyper-Extract |
| CLI 指南 | 命令行界面 |
| Provider 系统 | 模型兼容性与本地部署 |
| 新闻动态 | 版本说明与亮点 |
| 模板画廊 | 80+ 预设模板 |
| 示例代码 | 可运行示例 |
🔌 MCP 服务器
通过 Model Context Protocol 将知识摘要暴露给支持 MCP 的助手(Claude Desktop、IDE 智能体)——只读 + 导出。
pip install 'hyperextract[mcp]'
he-mcp        # stdio MCP 服务器
工具:list_templates、info、search、ask(RAG)、export_obsidian、export_graphml、export_csv、export_jsonld、export_cypher。完整指南:MCP 服务器文档。
🤝 参与贡献与协议
热烈欢迎社区提交 Issues 和 PRs。
项目基于 Apache-2.0 协议开源。
🔒 安全认证
本项目已通过 MseeP.ai 安全审计。
AtomGit 镜像
AtomGit镜像一Agent Reach的AtomGit同步镜像,便于国内访问与克隆。国内 AtomGit 托管:https://atomgit.com/yifanfeng97/Hyper-Extract
探索相关项目
affaan-m/ECC
智能体执行与控制框架的性能优化系统。面向 Claude Code、Codex、Opencode、Cursor 等,涵盖技能、本能、记忆、安全与研究优先的开发。
299,547 星标NousResearch/hermes-agent
与你一同成长的智能体
261,681 星标multica-ai/andrej-karpathy-skills
一个用于改进 Claude Code 行为的 CLAUDE.md 文件,源自 Andrej Karpathy 对 LLM 编程陷阱的观察。
230,848 星标firecrawl/firecrawl
借助来自网络及其他来源的数据,强化你的 AI 智能体。正在构建面向超级智能的资料库。🔥
199,551 星标