
wxhcore/bumblecore
wxhcore/bumblecore has 72 GitHub stars and 12 forks. GitHot measured 0 stars in 24 hours, 0 in 7 days, and 0 in 15 days. Last checked 2026-11-15 23:36 UTC. Last push 2026-08-24.
实测星标增长
- 24小时
- 0
- 7天
- 0
- 15天
- 0
- 1个月
- 更新延迟
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
关于
An LLM training framework built from the ground up, featuring a custom BumbleBee architecture and end-to-end support for multiple open-source models across Pretraining → SFT → RLHF/DPO.
人工智能README_zh.md
原文
小核心,大轰鸣 | Small Core, Big Buzz
一个从零手动实现的大语言模型训练框架,让你完全掌控训练的每一个细节;
模型架构到模型推理,从分布式训练到损失计算,一切都触手可及。


项目简介
核心特性
1️⃣ 完全手动实现的训练循环
BumbleCore 不依赖任何高层 Trainer 库,所有核心组件均从底层手动实现:
- 自定义数据加载器和预处理管道
- 手动配置分布式训练环境,深度集成 DeepSpeed
- 完全可控的前向传播、反向传播和参数更新流程
- 灵活的损失函数实现,支持多任务学习
- 手动实现的推理生成机制,包括 Top-p、Top-k 采样和 KV Cache
💡 为什么选择手动实现?
手动实现让你深入理解每一行代码的作用,便于调试、优化和创新。无论是研究新的训练策略,还是针对特定场景进行定制化优化,BumbleCore 都能提供最大的灵活性。
2️⃣ Bumblebee 模型架构:自由定制你的模型
内置的 Bumblebee 架构(参考 Qwen2.5 设计)提供高度灵活的配置能力:
- 支持从小型实验模型到大规模生产模型的参数量配置
- 可动态调整 Transformer 层数、注意力头数、隐藏层维度等架构参数
- 支持自定义激活函数、归一化方式、注意力机制等组件
- 涵盖完整训练流程:预训练(Pretraining)、监督微调(SFT)、直接偏好优化(DPO)
使用场景
想要快速验证一个新的模型设计?或者针对特定领域训练一个轻量级模型?Bumblebee 架构让你能够在几分钟内完成模型配置,开始训练。
3️⃣ 通用训练框架:支持主流开源模型
- 兼容 Qwen、LLaMA 等开源模型
- 深度集成 DeepSpeed,支持 ZeRO 优化、混合精度训练
- 支持预训练、增量预训练、指令微调、强化学习(RLHF/DPO)等全流程训练
- 内置梯度累积、梯度检查点、激活重计算等内存优化技术
- 模块化设计,便于扩展新的模型架构和训练策略
作者已验证的支持模型
以下模型系列已由作者测试验证,确认可与 BumbleCore 兼容:
| 模型系列 | 验证阶段 | 备注 |
|---|---|---|
| Qwen 系列 | 预训练、SFT、DPO | ✅ 全面测试 |
| LLaMA 系列 | 预训练、SFT、DPO | ✅ 全面测试 |
💡 说明:虽然其他架构相似的模型未经测试,但理论上基本兼容。欢迎用户自行测试并集成更多模型,如遇到不兼容问题,请在 Issues 中反馈。
设计理念
BumbleCore 的设计遵循三个核心原则:
- 透明性 - 每一行代码都清晰可见,没有黑盒操作
- 灵活性 - 从数据到模型,从训练到推理,一切都可定制
- 高效性 - 充分利用 DeepSpeed 等工具,确保训练效率
谁适合使用 BumbleCore?
- 深度学习研究者:需要深度定制训练流程,验证新算法和架构
- 算法工程师:希望完全掌控模型训练细节,进行性能优化
- 学习者:想要深入理解大语言模型训练的底层原理
- 企业团队:需要针对特定业务场景定制训练方案
安装
环境要求
- Python >= 3.10
- Linux 操作系统
安装步骤
1. 克隆仓库
git clone https://github.com/wxhcore/bumblecore.git
cd bumblecore
2. 创建虚拟环境
conda create -n bumblecore_env python=3.10 -y
conda activate bumblecore_env
3. 安装依赖
基础安装:
pip install -e .
可选安装 FlashAttention-2:
pip install -e ".[flash-attn]" --no-build-isolation
数据准备
BumbleCore 支持三种训练阶段的不同数据格式,所有格式均支持 JSON 和 JSONL,框架会自动识别。
支持的格式
| 训练阶段 | 数据格式 |
|---|---|
| 预训练 | {"text": "..."} |
| SFT | Alpaca / ShareGPT / Messages(OpenAI 风格,支持工具调用) |
| DPO | Alpaca / ShareGPT / Messages(with chosen/rejected,支持完整工具轨迹) |
数据示例
SFT Alpaca 格式:
{
  "instruction": "解释什么是机器学习",
  "input": "",
  "output": "机器学习是人工智能的一个分支..."
}
配置说明
Bumblebee 模型配置
BumbleCore 提供了从 0.5B 到 72B 的多种模型规模配置:
| 字段 | 0.5B | 1.5B | 3B | 7B | 14B | 32B | 72B |
|---|---|---|---|---|---|---|---|
| hidden_size | 896 | 1536 | 2048 | 3584 | 5120 | 5120 | 8192 |
| intermediate_size | 4864 | 8960 | 11008 | 18944 | 13824 | 27648 | 29568 |
| num_attention_heads | 14 | 12 | 16 | 28 | 40 | 40 | 64 |
| num_hidden_layers | 24 | 28 | 36 | 28 | 48 | 64 | 80 |
| num_key_value_heads | 2 | 2 | 2 | 4 | 8 | 8 | 8 |
| tie_word_embeddings | true | true | true | false | false | false | false |
| vocab_size | 151936 | 151936 | 151936 | 152064 | 152064 | 152064 | 152064 |
配置文件位置:./models/bumblebee/config.json/
训练参数配置
🚀 快速开始
BumbleCore 支持灵活的配置方式,以下以 SFT(监督微调)为例展示不同使用方式。
配置优先级:命令行参数 > YAML 配置文件 > TrainConfig 默认值
方式一:使用 YAML 配置文件
deepspeed --include localhost:0,1 src/train.py \
    --yaml_config ./configs/sft/sft_full.yaml
方式二:纯命令行执行
deepspeed --include localhost:0,1 src/train.py \
    --training_stage sft \
    --finetuning_type full \
    --model_name_or_path <your model path> \
    --dataset_path <your dataset path> \
    --output_dir <your save path> \
    --num_epochs 3.0 \
    --learning_rate 5e-5 \
    --train_micro_batch_size_per_gpu 4 \
    --gradient_accumulation_steps 4 \
    --train_model_precision bf16 \
    --deepspeed_config_path ./configs/deepspeed/ds_z2_config.json
方式三:命令行覆盖 YAML 配置
deepspeed --include localhost:0,1 src/train.py \
    --yaml_config ./configs/sft/sft_lora.yaml \
    --learning_rate 1e-4
使用 Shell 脚本
以上三种方式都可以写成 Shell 脚本来执行,便于管理和复用。
BumbleCore 在 scripts/ 目录下已提供预配置的训练脚本。
使用步骤:
- 编辑脚本,修改模型路径、数据集路径等参数
- 执行脚本开始训练
bash scripts/sft_full.sh
三阶段完整训练实验
提供了从零开始训练完整语言模型的实验教程,涵盖预训练、监督微调、偏好优化三个阶段。
实验配置
| 阶段 | 数据集 | 规模 | 输出 |
|---|---|---|---|
| 预训练 | mini_pretrain_dataset | 1B tokens | 基座模型 |
| 监督微调 | alpaca_gpt4_zh | 42.7K samples | 指令模型 |
| 偏好优化 | DPO-En-Zh-20k | 10K samples (zh) | 对齐模型 |
LoRA 权重合并
使用 LoRA 训练后,可以将 LoRA 权重合并回基座模型,生成完整的模型文件。
# 编辑 tools/run_merge_lora.sh 修改模型路径参数后执行
bash tools/run_merge_lora.sh
模型推理
训练完成后,BumbleCore 提供灵活的推理方式,支持 YAML 配置和命令行参数。
命令行交互式对话
配置文件:configs/inference/chat.yaml
bash scripts/chat.sh
Web 界面(BumbleChat)
配置文件:configs/inference/bumblechat.yaml
bash scripts/bumblechat.sh
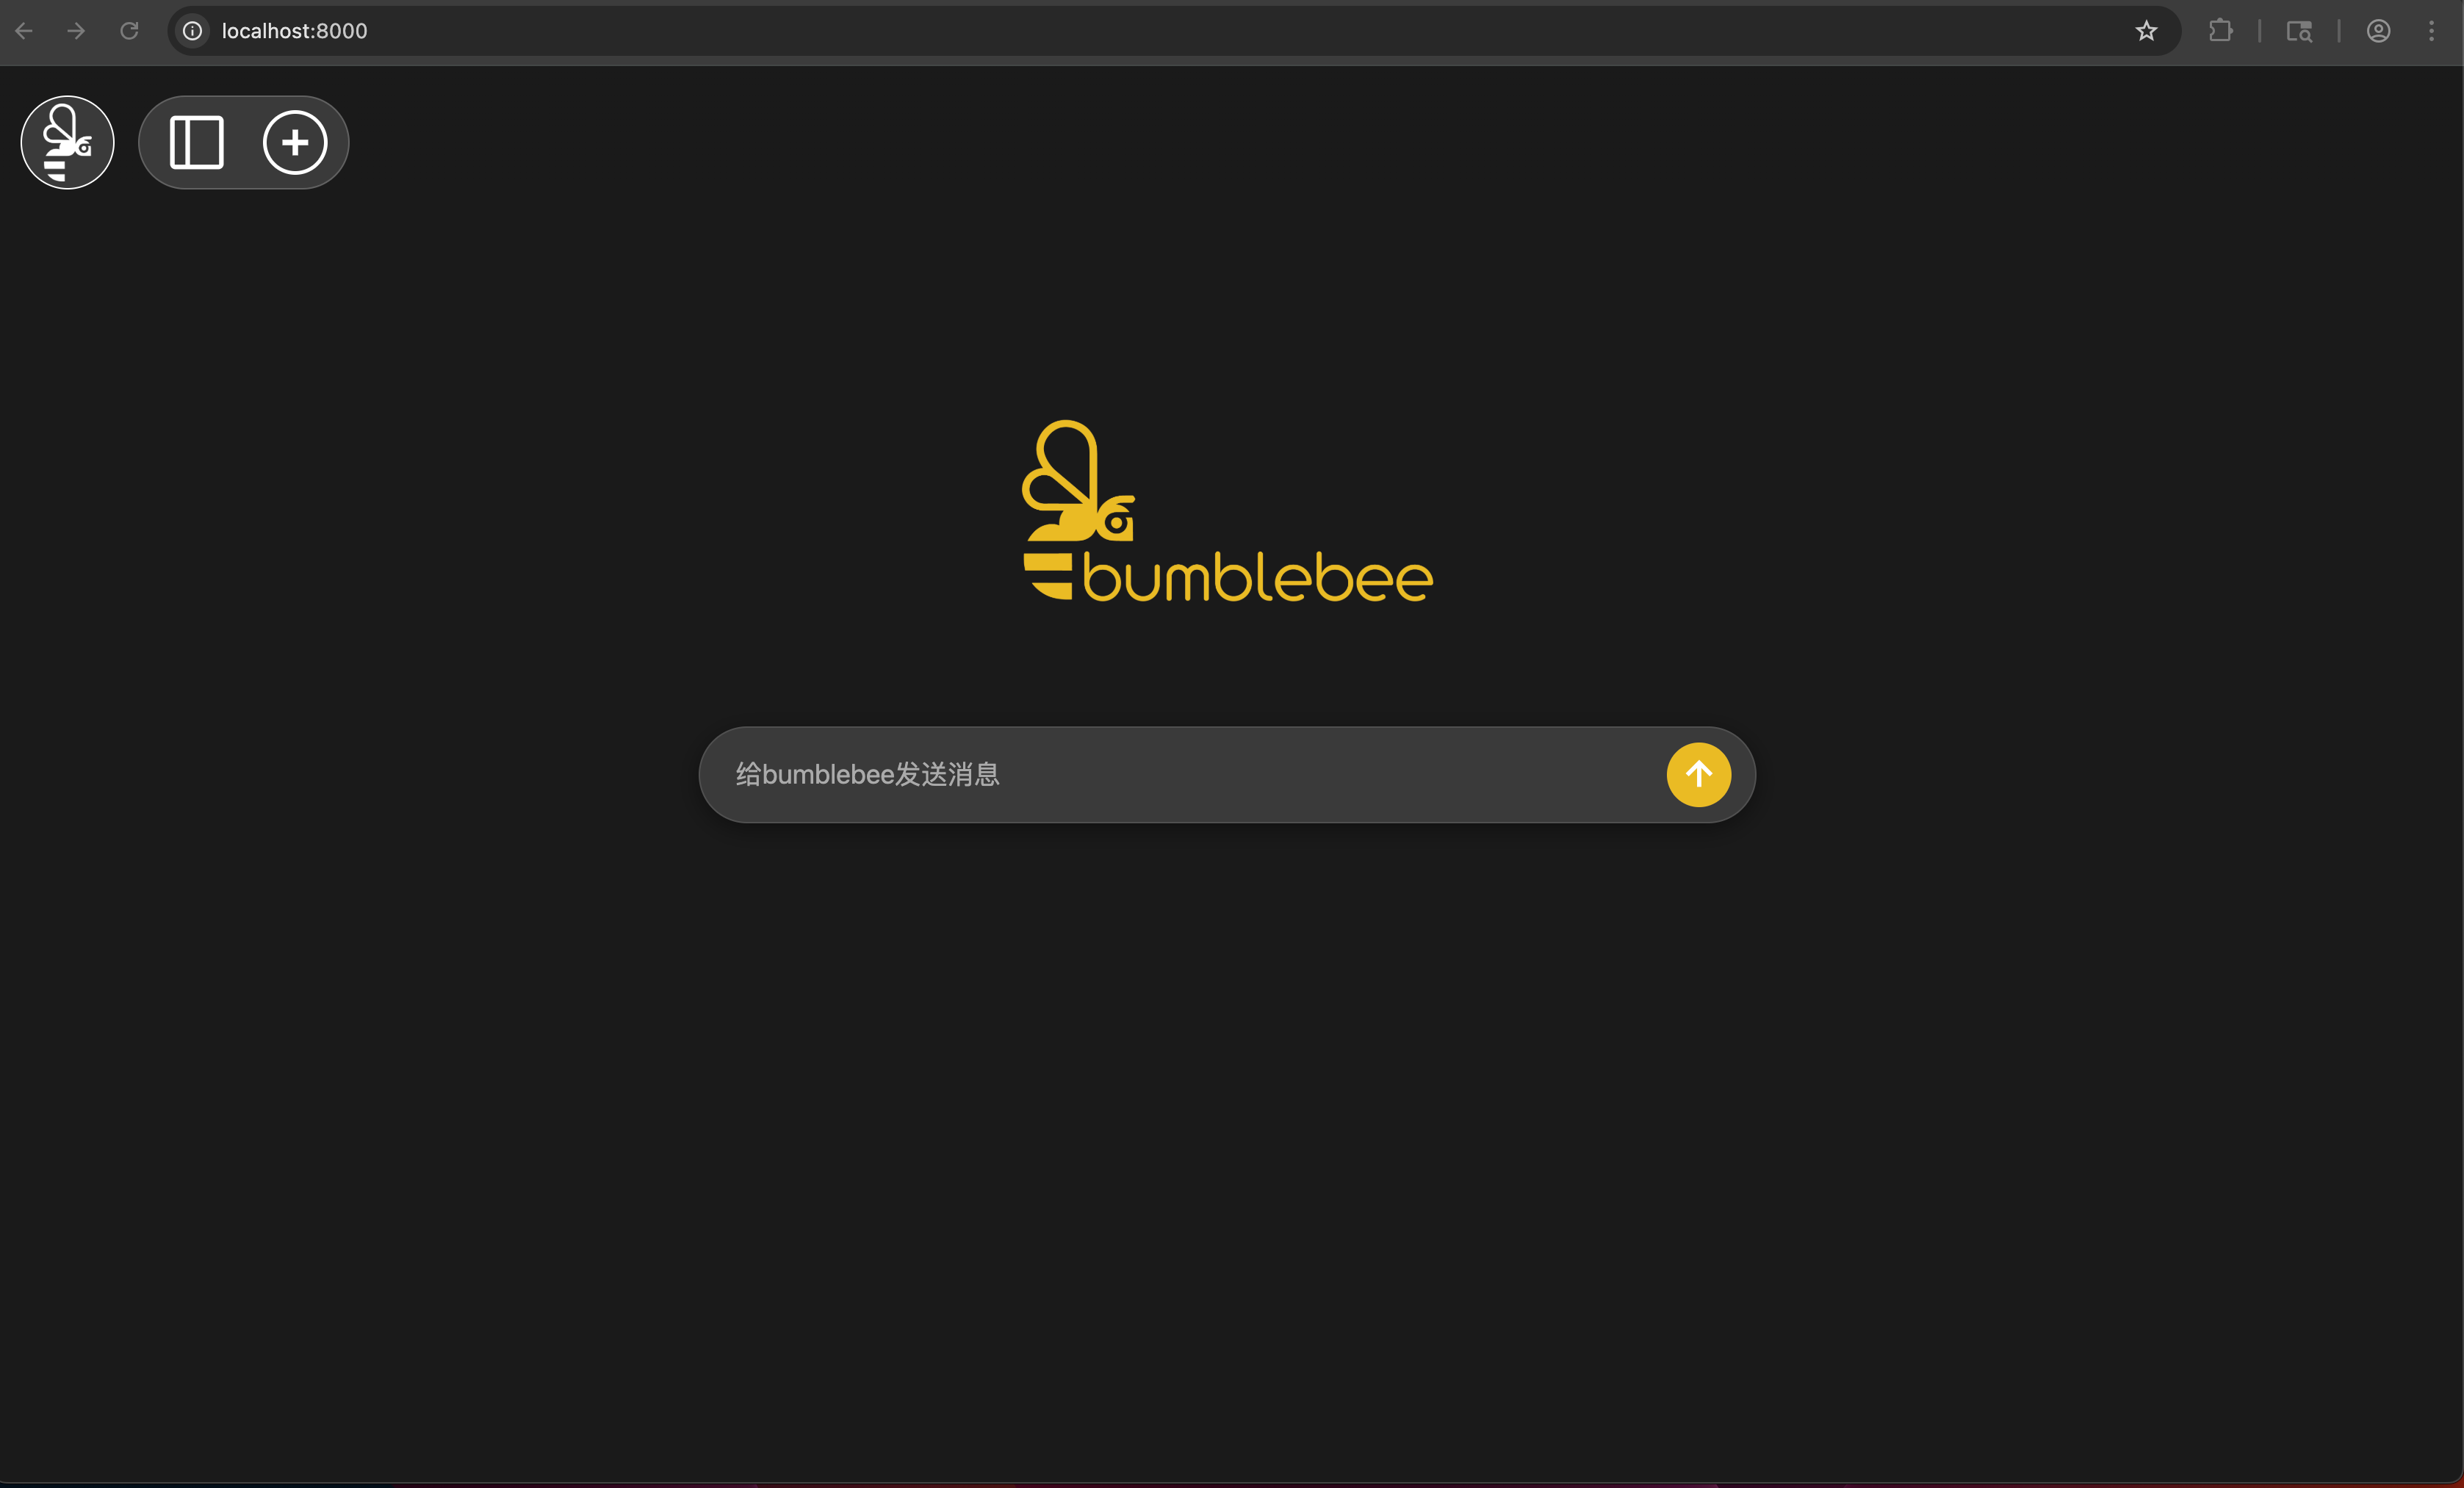
服务启动后支持 OpenAI 兼容的 API 调用:
from openai import OpenAI

client = OpenAI(
    base_url="<启动服务的api地址>/v1",
    api_key="dummy"
)

response = client.chat.completions.create(
    model="bumblebee",
    messages=[
        {"role": "user", "content": "你好,介绍一下你自己"}
    ],
    temperature=0.7,
    max_completion_tokens=2048
)

print(response.choices[0].message.content)