
wisupai/e2m has 1,294 GitHub stars and 76 forks. GitHot measured 0 stars in 24 hours and 0 in 7 days. Last checked 2026-11-10 20:19 UTC. Last push 2024-09-08.
E2M converts various file types (doc, docx, epub, html, htm, url, pdf, ppt, pptx, mp3, m4a) into Markdown. It’s easy to install, with dedicated parsers and converters, supporting custom configs. E2M offers an all-in-one, flexible, and open-source solution.
实测星标增长
- 24小时
- 0
- 7天
- 0
- 15天
- 更新延迟
- 1个月
- 更新延迟
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
README-zh.md
原文




🚀 E2M: Everything to Markdown
Everything to Markdown
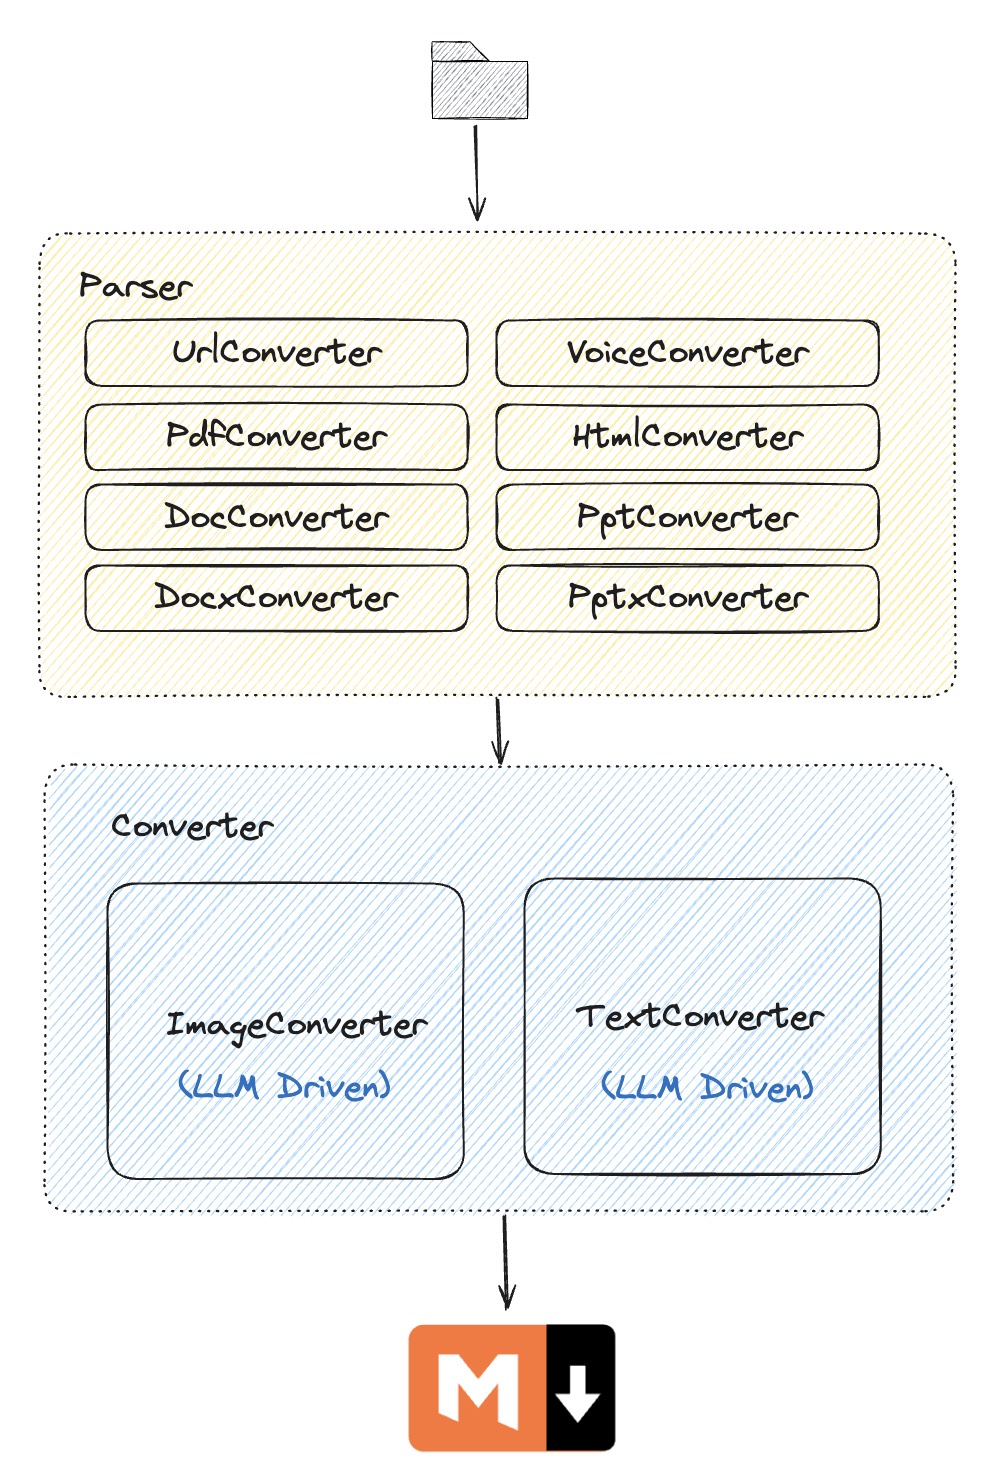
E2M 是一个能够把多种文件类型解析并转换成 Markdown 格式的 Python 库,通过解析器+转换器的架构,实现对 doc, docx, epub, html, htm, url, pdf, ppt, pptx, mp3, m4a 等多种文件格式的转换。
✨E2M 项目的终极目标是为了 RAG 和模型训练、微调,提供高质量的数据。
项目的核心架构:
- 解析器:负责将各种文件类型解析为文本或图片数据
- 转换器:负责将文本或图片数据转换为 Markdown 格式
一般来说,对于任意类型的文件,需要先运行解析器,获取文件内部的 text、image 等数据,然后再运行转换器,将数据转换为 Markdown 格式。
📹 视频介绍

📂 所有的 Parser 和 Converter
| Parser | ||
|---|---|---|
| Parser Type | Engine | Supported File Type |
| PdfParser | surya_layout, marker, unstructured | |
| DocParser | pandoc, xml | doc |
| DocxParser | pandoc, xml | docx |
| PptParser | unstructured | ppt |
| PptxParser | unstructured | pptx |
| UrlParser | unstructured, jina, firecrawl | url |
| EpubParser | unstructured | epub |
| HtmlParser | unstructured | html, htm |
| VoiceParser | openai_whisper_api, openai_whisper_local, SpeechRecognition | mp3, m4a |
| Converter | ||
|---|---|---|
| Converter Type | Engine | Strategy |
| ImageConverter | litellm, zhipuai (图像识别表现不佳,不推荐) | default |
| TextConverter | litellm, zhipuai | default |
转换器支持的模型:
📦 安装
创建环境:
conda create -n e2m python=3.10
conda activate e2m
更新 pip:
pip install --upgrade pip
使用 pip 安装 E2M:
# 选项 1: 通过git安装,最推荐
pip install git+https://github.com/wisupai/e2m.git --index-url https://pypi.org/simple
# 选项 2: 通过pip安装
pip install --upgrade wisup_e2m
# 选项 3: 手动安装
git clone https://github.com/wisupai/e2m.git
cd e2m
pip install poetry
poetry build
pip install dist/wisup_e2m-0.1.63-py3-none-any.whl
启动API服务
gunicorn wisup_e2m.api.main:app --workers 4 --worker-class uvicorn.workers.UvicornWorker --bind 0.0.0.0:8000
查看API文档:
CLI 命令行工具
使用marker转换pdf
转换单个pdf:
marker_single /path/to/file.pdf /path/to/output/folder --batch_multiplier 2 --max_pages 10
批量转换pdf:
marker /path/to/input/folder /path/to/output/folder --workers 4 --max 10 --min_length 10000
⚡️ 解析器: 快速开始
以下是使用 E2M 解析器的简单示例:
📄 PDF 解析器
[!NOTE]
如果没有科学上网,可能连接huggingface失败,可以使用设置以下镜像:import os os.environ['CURL_CA_BUNDLE'] = '' os.environ['HF_ENDPOINT'] = 'https://hf-mirror.com'
from wisup_e2m import PdfParser

pdf_path = "./test.pdf"
parser = PdfParser(engine="marker") # pdf 引擎: marker, unstructured, surya_layout
pdf_data = parser.parse(pdf_path)
print(pdf_data.text)
📝 DOC 解析器
from wisup_e2m import DocParser

doc_path = "./test.doc"
parser = DocParser(engine="pandoc") # doc 引擎: pandoc, xml
doc_data = parser.parse(doc_path)
print(doc_data.text)
📜 DOCX 解析器
from wisup_e2m import DocxParser

docx_path = "./test.docx"
parser = DocxParser(engine="pandoc") # docx 引擎: pandoc, xml
docx_data = parser.parse(docx_path)
print(docx_data.text)
📚 EPUB 解析器
from wisup_e2m import EpubParser

epub_path = "./test.epub"
parser = EpubParser(engine="unstructured") # epub 引擎: unstructured
epub_data = parser.parse(epub_path)
print(epub_data.text)
🌐 HTML 解析器
from wisup_e2m import HtmlParser

html_path = "./test.html"
parser = HtmlParser(engine="unstructured") # html 引擎: unstructured
html_data = parser.parse(html_path)
print(html_data.text)
🔗 URL 解析器
from wisup_e2m import UrlParser

url = "https://www.example.com"
parser = UrlParser(engine="jina") # url 引擎: jina, firecrawl, unstructured
url_data = parser.parse(url)
print(url_data.text)
🖼️ PPT 解析器
from wisup_e2m import PptParser

ppt_path = "./test.ppt"
parser = PptParser(engine="unstructured") # ppt 引擎: unstructured
ppt_data = parser.parse(ppt_path)
print(ppt_data.text)
🖼️ PPTX 解析器
from wisup_e2m import PptxParser

pptx_path = "./test.pptx"
parser = PptxParser(engine="unstructured") # pptx 引擎: unstructured
pptx_data = parser.parse(pptx_path)
print(pptx_data.text)
🎤 语音解析器
from wisup_e2m import VoiceParser

voice_path = "./test.mp3"
parser = VoiceParser(
  engine="openai_whisper_local", # 语音引擎: openai_whisper_api, openai_whisper_local
  model="large" # 可用模型: https://github.com/openai/whisper#available-models-and-languages
  )

voice_data = parser.parse(voice_path)
print(voice_data.text)
🔄 转换器: 快速开始
以下是使用 E2M 转换器的简单示例:
📝 文本转换器
from wisup_e2m import TextConverter

text = "从任何解析器解析的文本数据"
converter = TextConverter(
  engine="litellm", # 文本引擎: litellm
  model="deepseek/deepseek-chat",
  api_key="你的 API 密钥",
  base_url="你的基础 URL"
  )
text_data = converter.convert(text)
print(text_data)
🖼️ 图片转换器
from wisup_e2m import ImageConverter

images = ["./test1.png", "./test2.png"]
converter = ImageConverter(
  engine="litellm", # 图片引擎: litellm
  model="gpt-4o",
  api_key="你的 API 密钥",
  base_url="你的基础 URL"
  )
image_data = converter.convert(images)
print(image_data)
🆙 下一步
🛠️ E2MParser
E2MParser 是一个集成解析器,支持多种文件类型。可以将各种文件类型解析为 Markdown 格式。
from wisup_e2m import E2MParser

# 使用配置文件初始化解析器
ep = E2MParser.from_config("config.yaml")

# 解析指定文件
data = ep.parse(file_name="/path/to/file.pdf")

# 将解析的数据以字典格式打印
print(data.to_dict())
🛠️ E2MConverter
E2MConverter 是一个集成转换器,支持文本和图片转换。可以将文本和图片转换为 Markdown 格式。
from wisup_e2m import E2MConverter

ec = E2MConverter.from_config("./config.yaml")

text = "从任何解析器解析的文本数据"

ec.convert(text=text)

images = ["test.jpg", "test.png"]
ec.convert(images=images)
你可以使用 config.yaml 文件来指定要使用的解析器和转换器。以下是一个 config.yaml 文件的示例:
parsers:
    doc_parser:
        engine: "pandoc"
        langs: ["en", "zh"]
    docx_parser:
        engine: "pandoc"
        langs: ["en", "zh"]
    epub_parser:
        engine: "unstructured"
        langs: ["en", "zh"]
    html_parser:
        engine: "unstructured"
        langs: ["en", "zh"]
    url_parser:
        engine: "jina"
        langs: ["en", "zh"]
    pdf_parser:
        engine: "marker"
        langs: ["en", "zh"]
    pptx_parser:
        engine: "unstructured"
        langs: ["en", "zh"]
    voice_parser:
        # 选项1: 使用 openai whisper API
        # engine: "openai_whisper_api"
        # api_base: "https://api.openai.com/v1"
        # api_key: "你的 API 密钥"
        # model: "whisper"

        # 选项2: 使用本地 whisper 模型
        engine: "openai_whisper_local"
        model: "large" # 可用模型: https://github.com/openai/whisper#available-models-and-languages

converters:
    text_converter:
        engine: "litellm"
        model: "deepseek/deepseek-chat"
        api_key: "你的 API 密钥"
        # base_url: ""
    image_converter:
        engine: "litellm"
        model: "gpt-4o-mini"
        api_key: "你的 API 密钥"
        # base_url: ""
❓ 问答
📜 许可证
此项目基于 MIT 许可证。详情请参见 LICENSE 文件。
📧 联系我们
扫描以下二维码加入我们的微信群(备注来自 e2m 项目):

如有任何问题或疑问,请在 GitHub 上创建 issue 或通过 [email protected] 联系我们。
商业合作联系: [email protected]
💼 加入我们

Wisup是一家以数据和算法为核心的AI初创公司,我们专注于为企业提供高质量的数据和算法服务。我们采用线上工作的方式,欢迎全球各地的优秀人才加入我们。
我们的理念: 从信息到数据,从数据到知识,从知识到价值。
我们的理想: 用数据让世界变得更美好。
我们需要: 志同道合的联合创始人
- 不限学历、年龄、地域、种族、性别
- 关注AI前沿,了解AI以及相关垂直行业
- 对AI、数据充满热情,满怀理想
- 有个人强势专长、负责任、有团队合作精神
投递简历: [email protected]
您还需要在邮件中回答3个问题:
- 您的不可替代性在哪里?
- 您曾经遇到过最困难的事,以及您如何解决?
- 您如何看待AI的未来发展?
🌟 贡献
探索相关项目
affaan-m/ECC
智能体执行与控制框架的性能优化系统。面向 Claude Code、Codex、Opencode、Cursor 等,涵盖技能、本能、记忆、安全与研究优先的开发。
301,154 星标NousResearch/hermes-agent
与你一同成长的智能体
262,644 星标multica-ai/andrej-karpathy-skills
一个用于改进 Claude Code 行为的 CLAUDE.md 文件,源自 Andrej Karpathy 对 LLM 编程陷阱的观察。
232,131 星标firecrawl/firecrawl
借助来自网络及其他来源的数据,强化你的 AI 智能体。正在构建面向超级智能的资料库。🔥
200,444 星标