
tong-io/tongflow
tong-io/tongflow has 1,045 GitHub stars and 136 forks. GitHot measured 0 stars in 24 hours and -4 in 7 days. Last checked 2026-11-09 18:08 UTC. Last push 2026-10-28.
Modality-First GenAI Platform
实测星标增长
- 24小时
- 0
- 7天
- -4
- 15天
- 更新延迟
- 1个月
- 更新延迟
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
docs/README_ZH.md
原文
TongFlow:开源的 Modality-First GenAI 平台


https://github.com/user-attachments/assets/279e31ee-ebc9-4318-a672-c2292cef4851
把不同模态,接成工作流。
文字、图像、声音、视频、三维,都是你的材料。决定它们如何转换、组合,再为每一步选择模型。结果也是材料,可以继续连接。
开源内核 · 自选模型 · 支持自行部署 · tongflow.com · 打开画布
赞助商
|
MiniMax H3 视频生成 API|秘塔科技 秘塔科技提供高性价比的 MiniMax H3 视频生成服务:768P 仅 0.09 元/秒,2K 仅 0.15 元/秒。支持原生 2K、音画同步,API 兼容 OpenAI 协议,同时支持 ComfyUI,无需自行部署 GPU。 🎁 通过 TongFlow 专属链接注册,即可领取赠送额度及专属优惠。 |
|
一个 Key 跑通整块画布|无限星河AI(Infistar) 兼容 OpenAI 协议的聚合网关:一个 Key、一份余额覆盖画布上的文本、图像、视频与转写节点 —— GPT-6、Claude Opus 5、Gemini 3 Pro、Grok、DeepSeek,以及国产模型最全的一条线(通义千问、智谱 GLM、豆包、MiniMax、Kimi、阶跃星辰);出图有 GPT Image 2.5、Seedream 5、Qwen-Image,视频有 Wan、Seedance。图片低至 0.06 元/张。装上 tongflow-router-infistar 插件即可使用。🎁 通过 TongFlow 专属链接注册,领 5 美元体验额度。 |
Demo 示例
| 工作流截图 | 输出结果 |
|---|---|
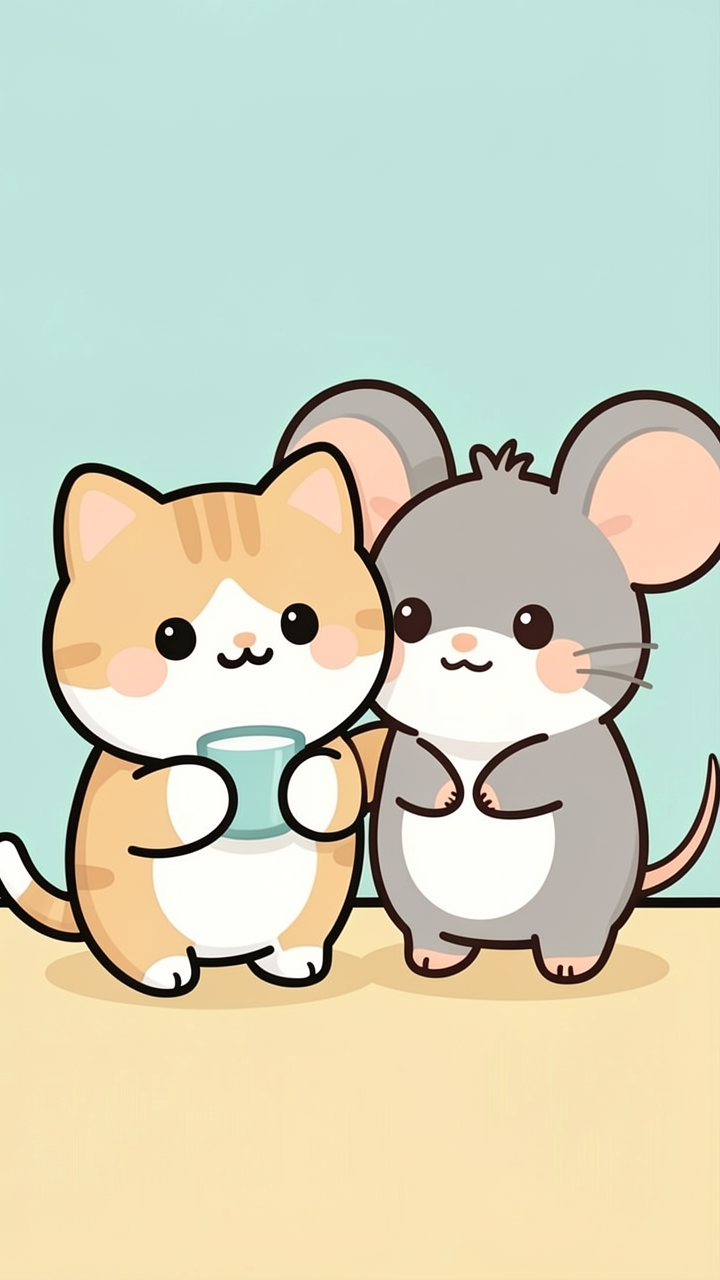
基本 — 输入文本(添加),生成图像(转换),再融合成一张(组合)。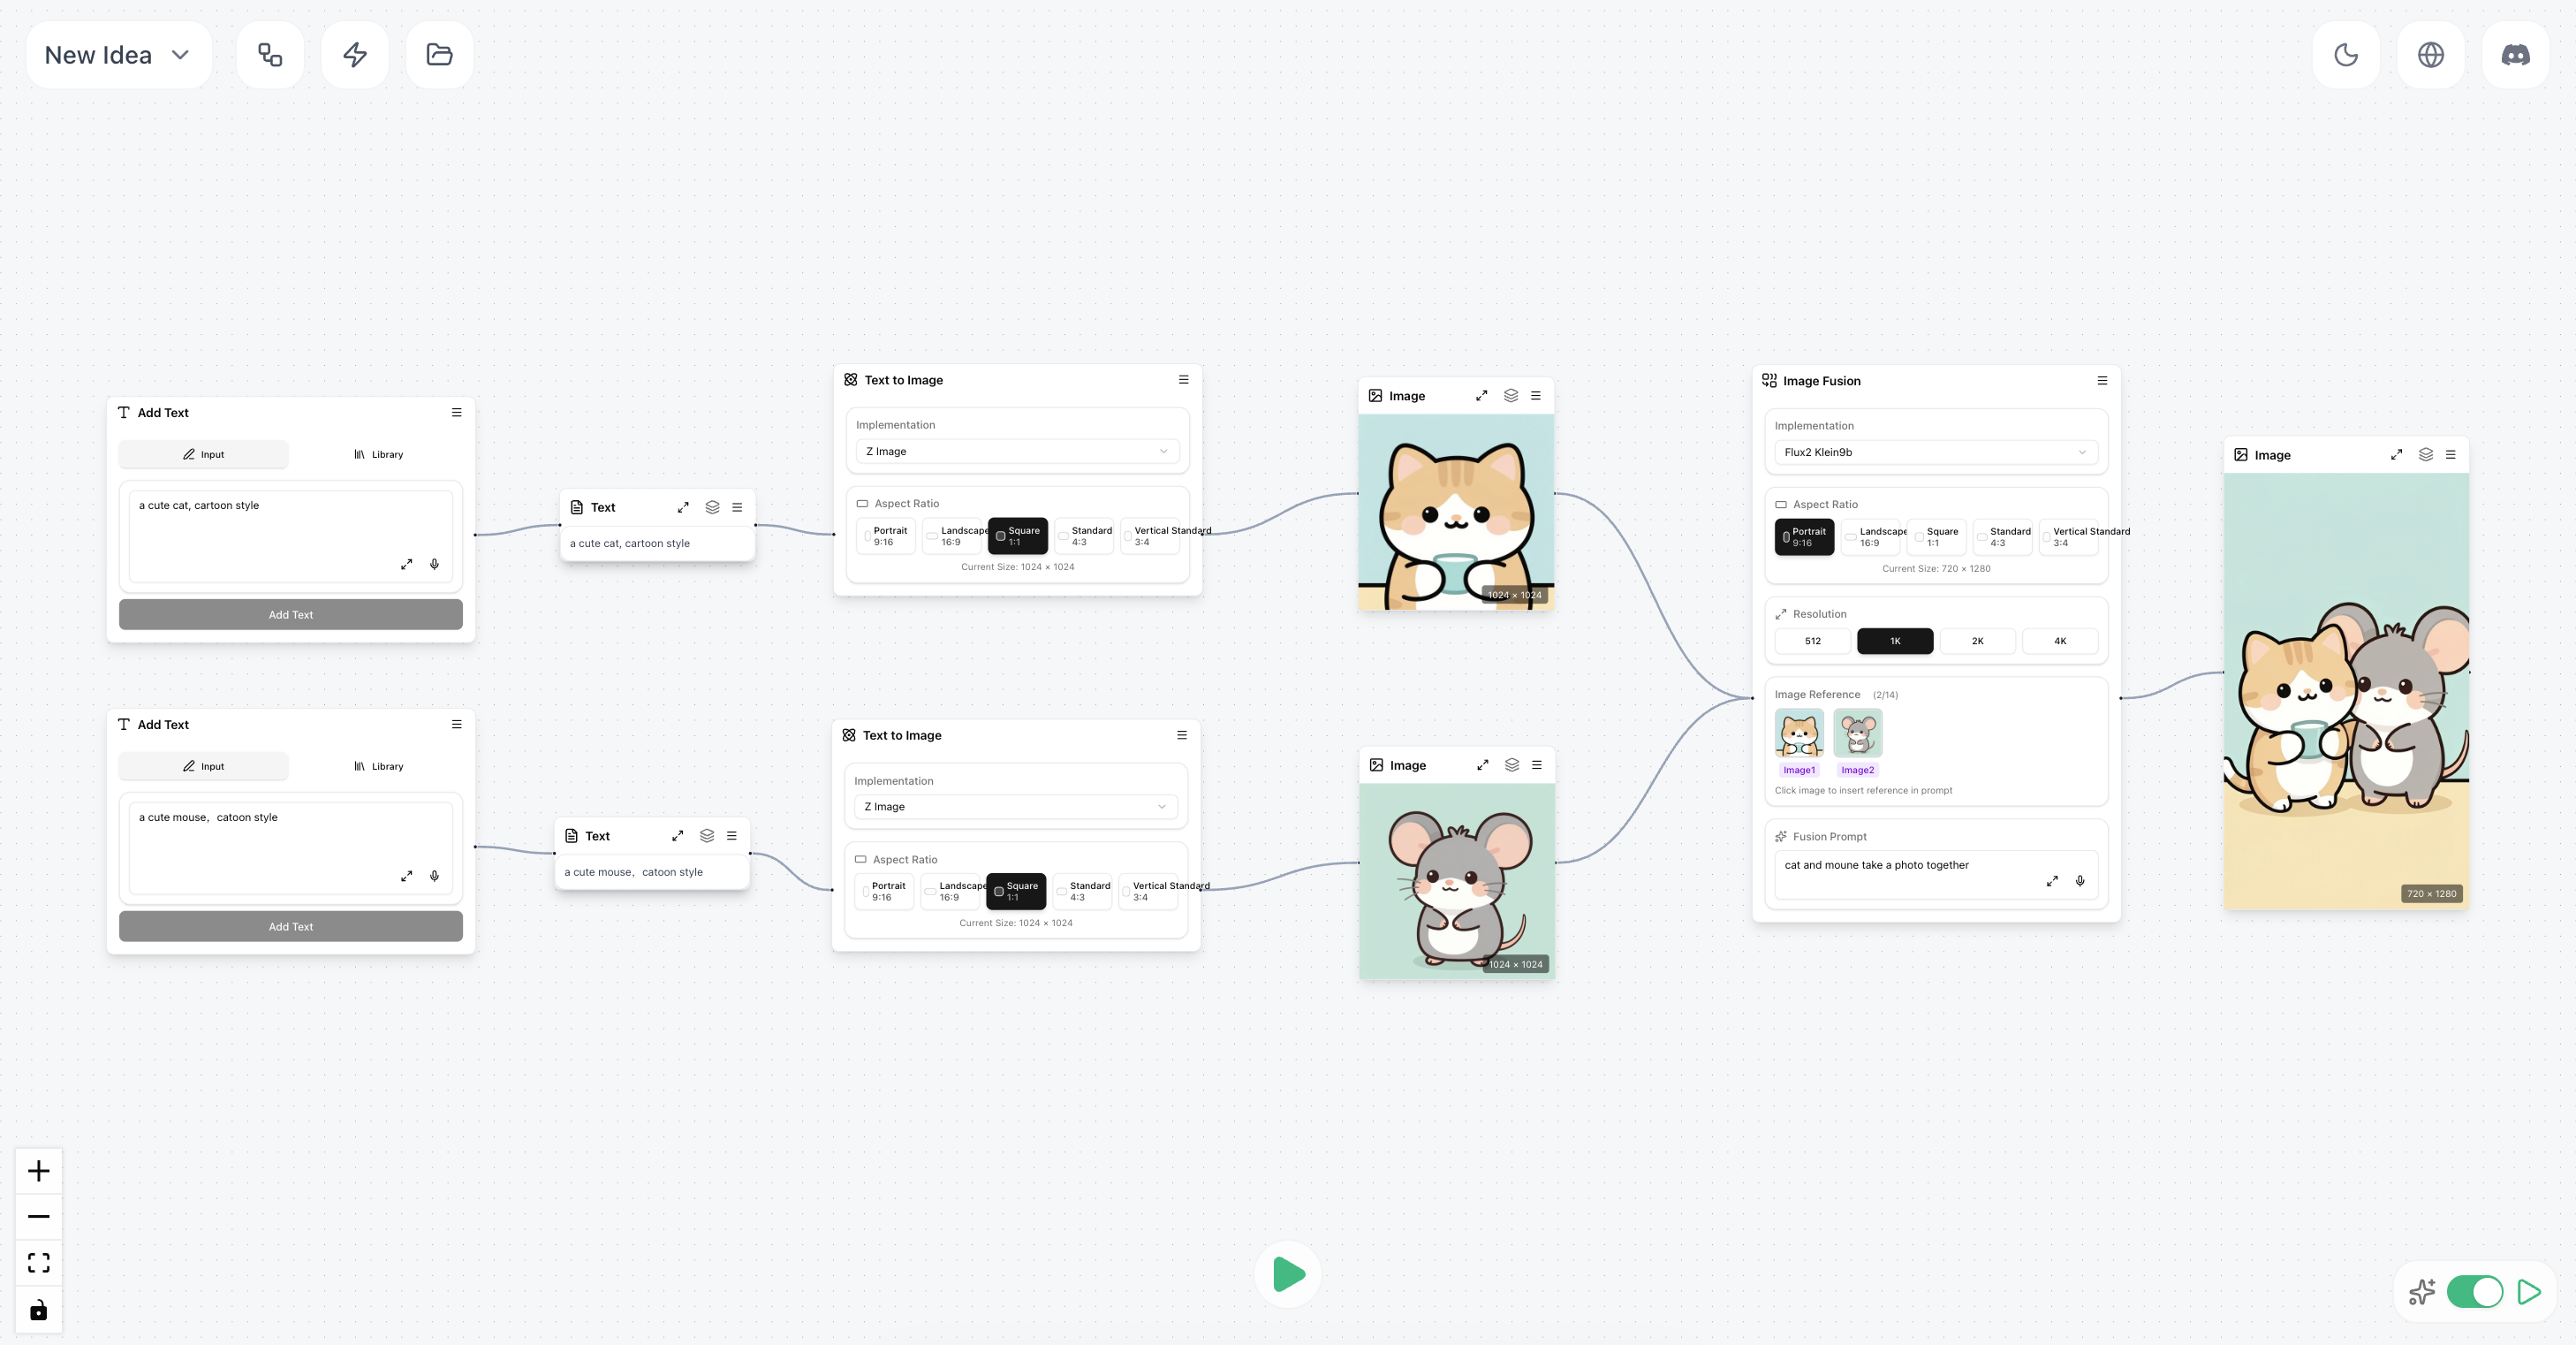 |
 |
中级 — (添加主题 → 生成文案 → 生成语音) + (人物描述 → 生成图像) → 生成对口型视频 = 数字人口播。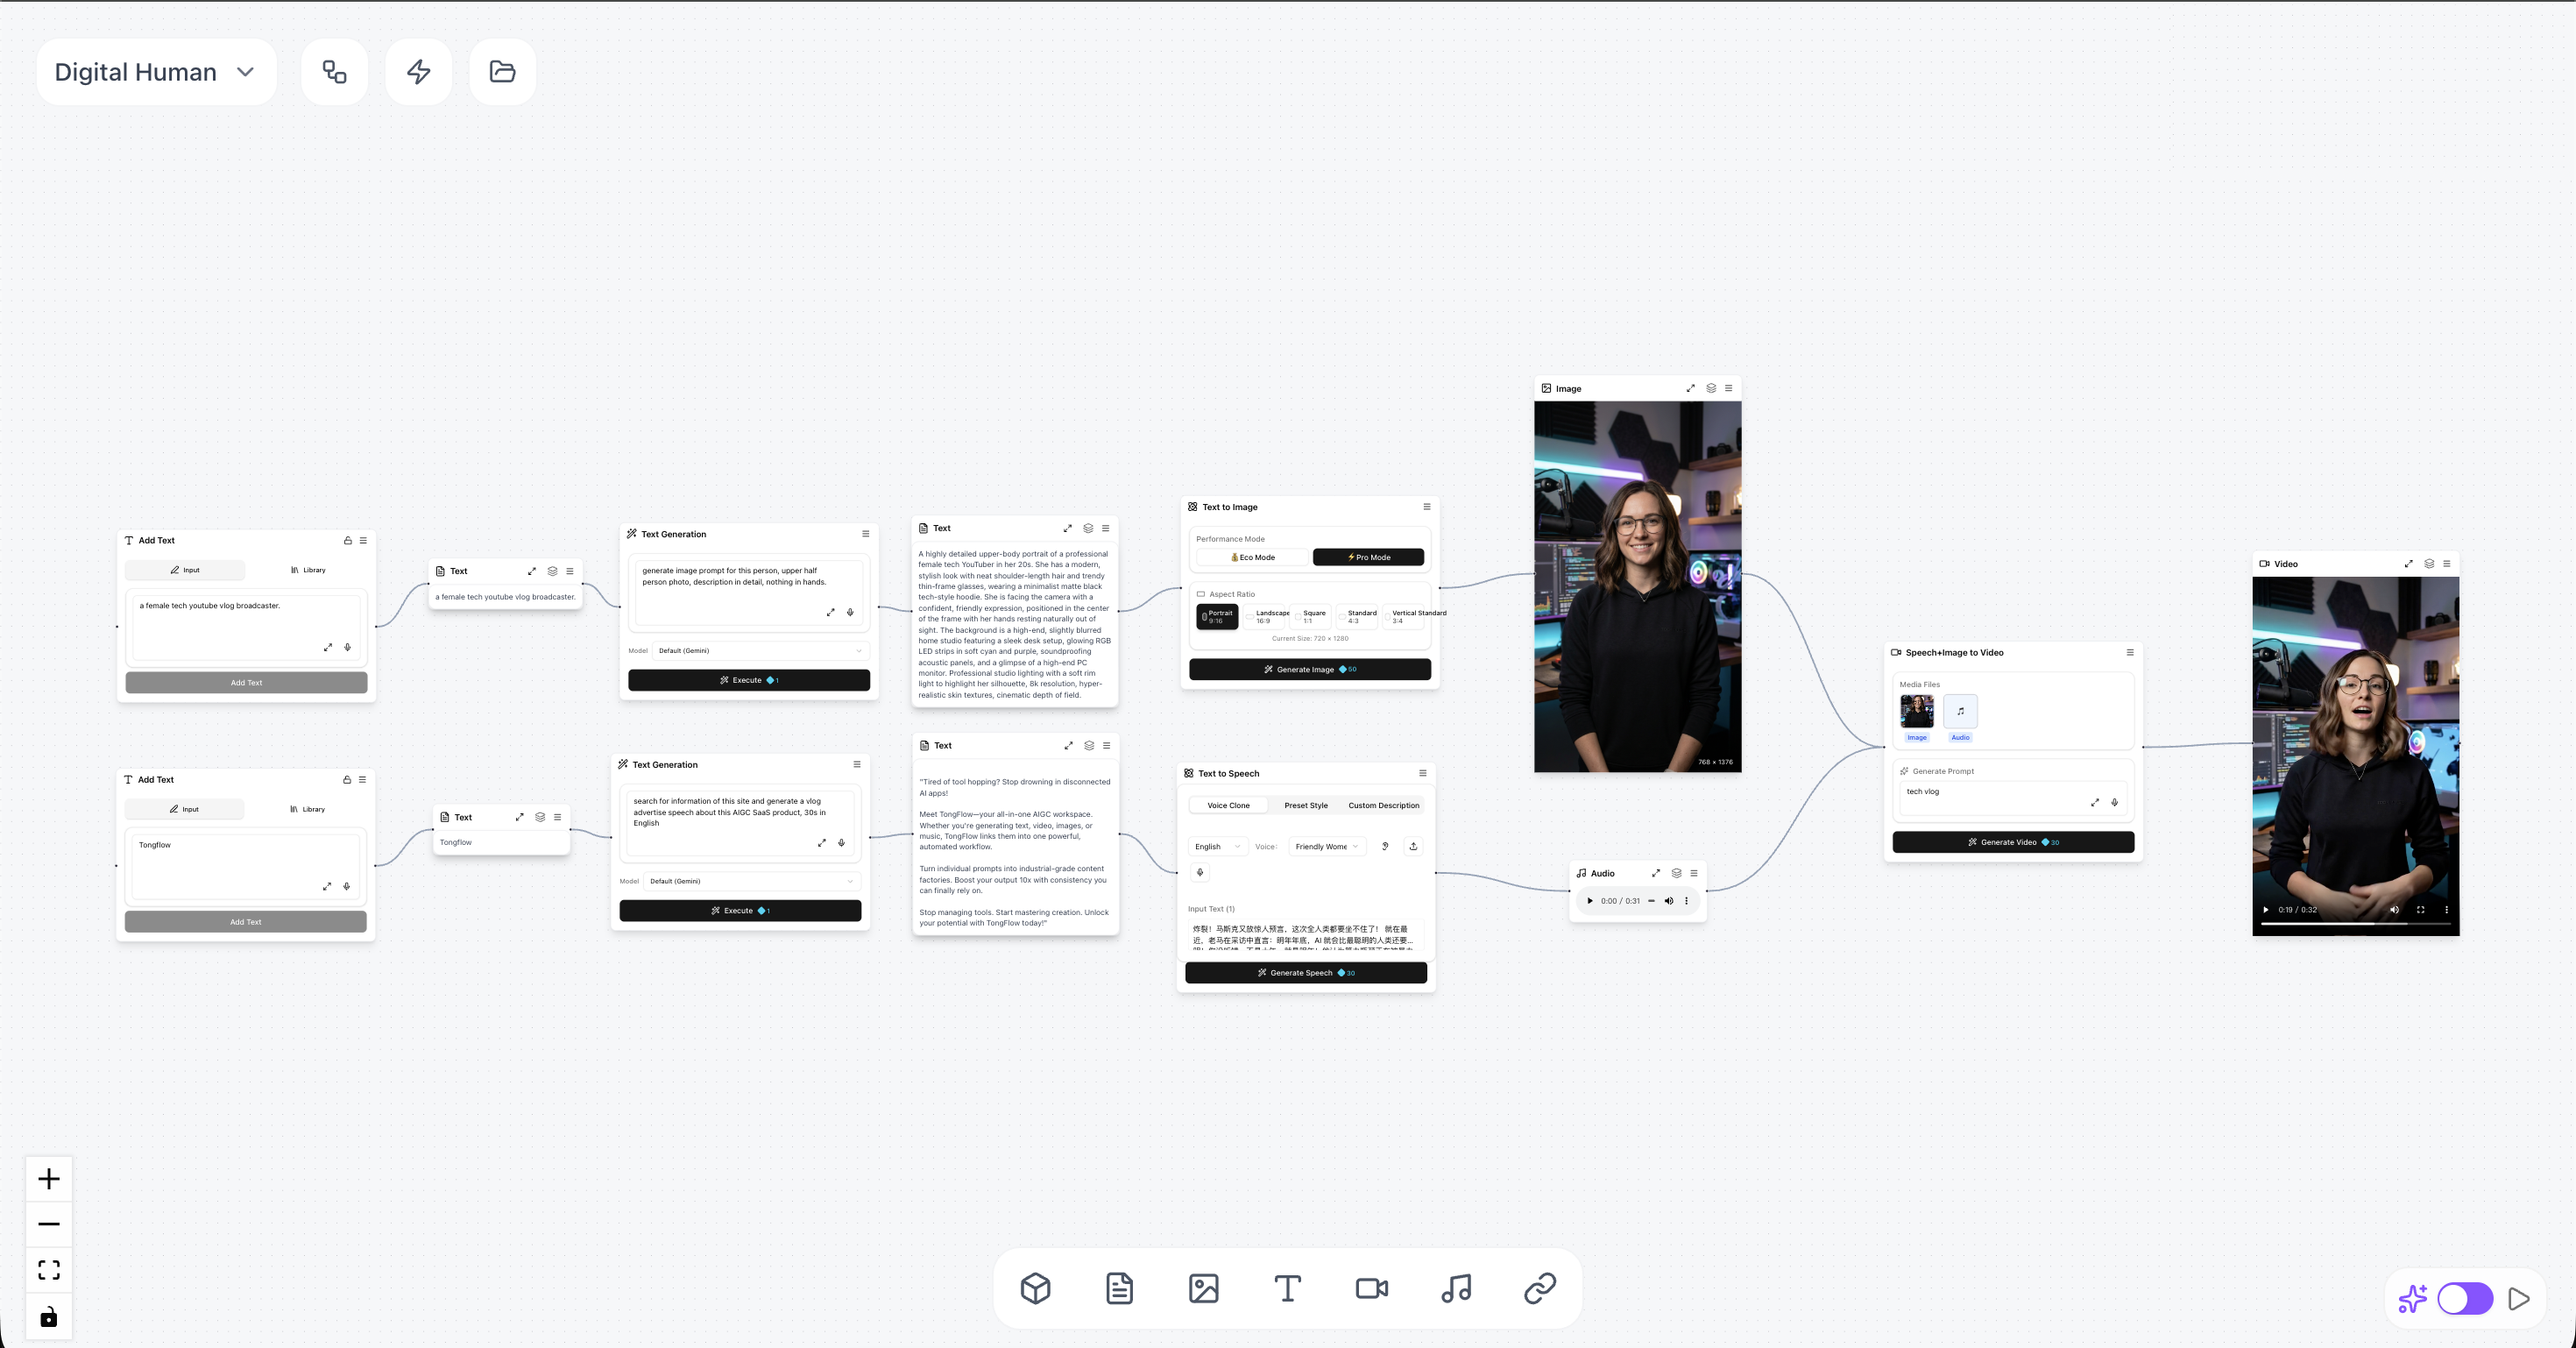 |
|
高级 — 生成歌词 + 生成歌曲 + 生成人物 + 生成场景 + 生成分镜 → 生成MV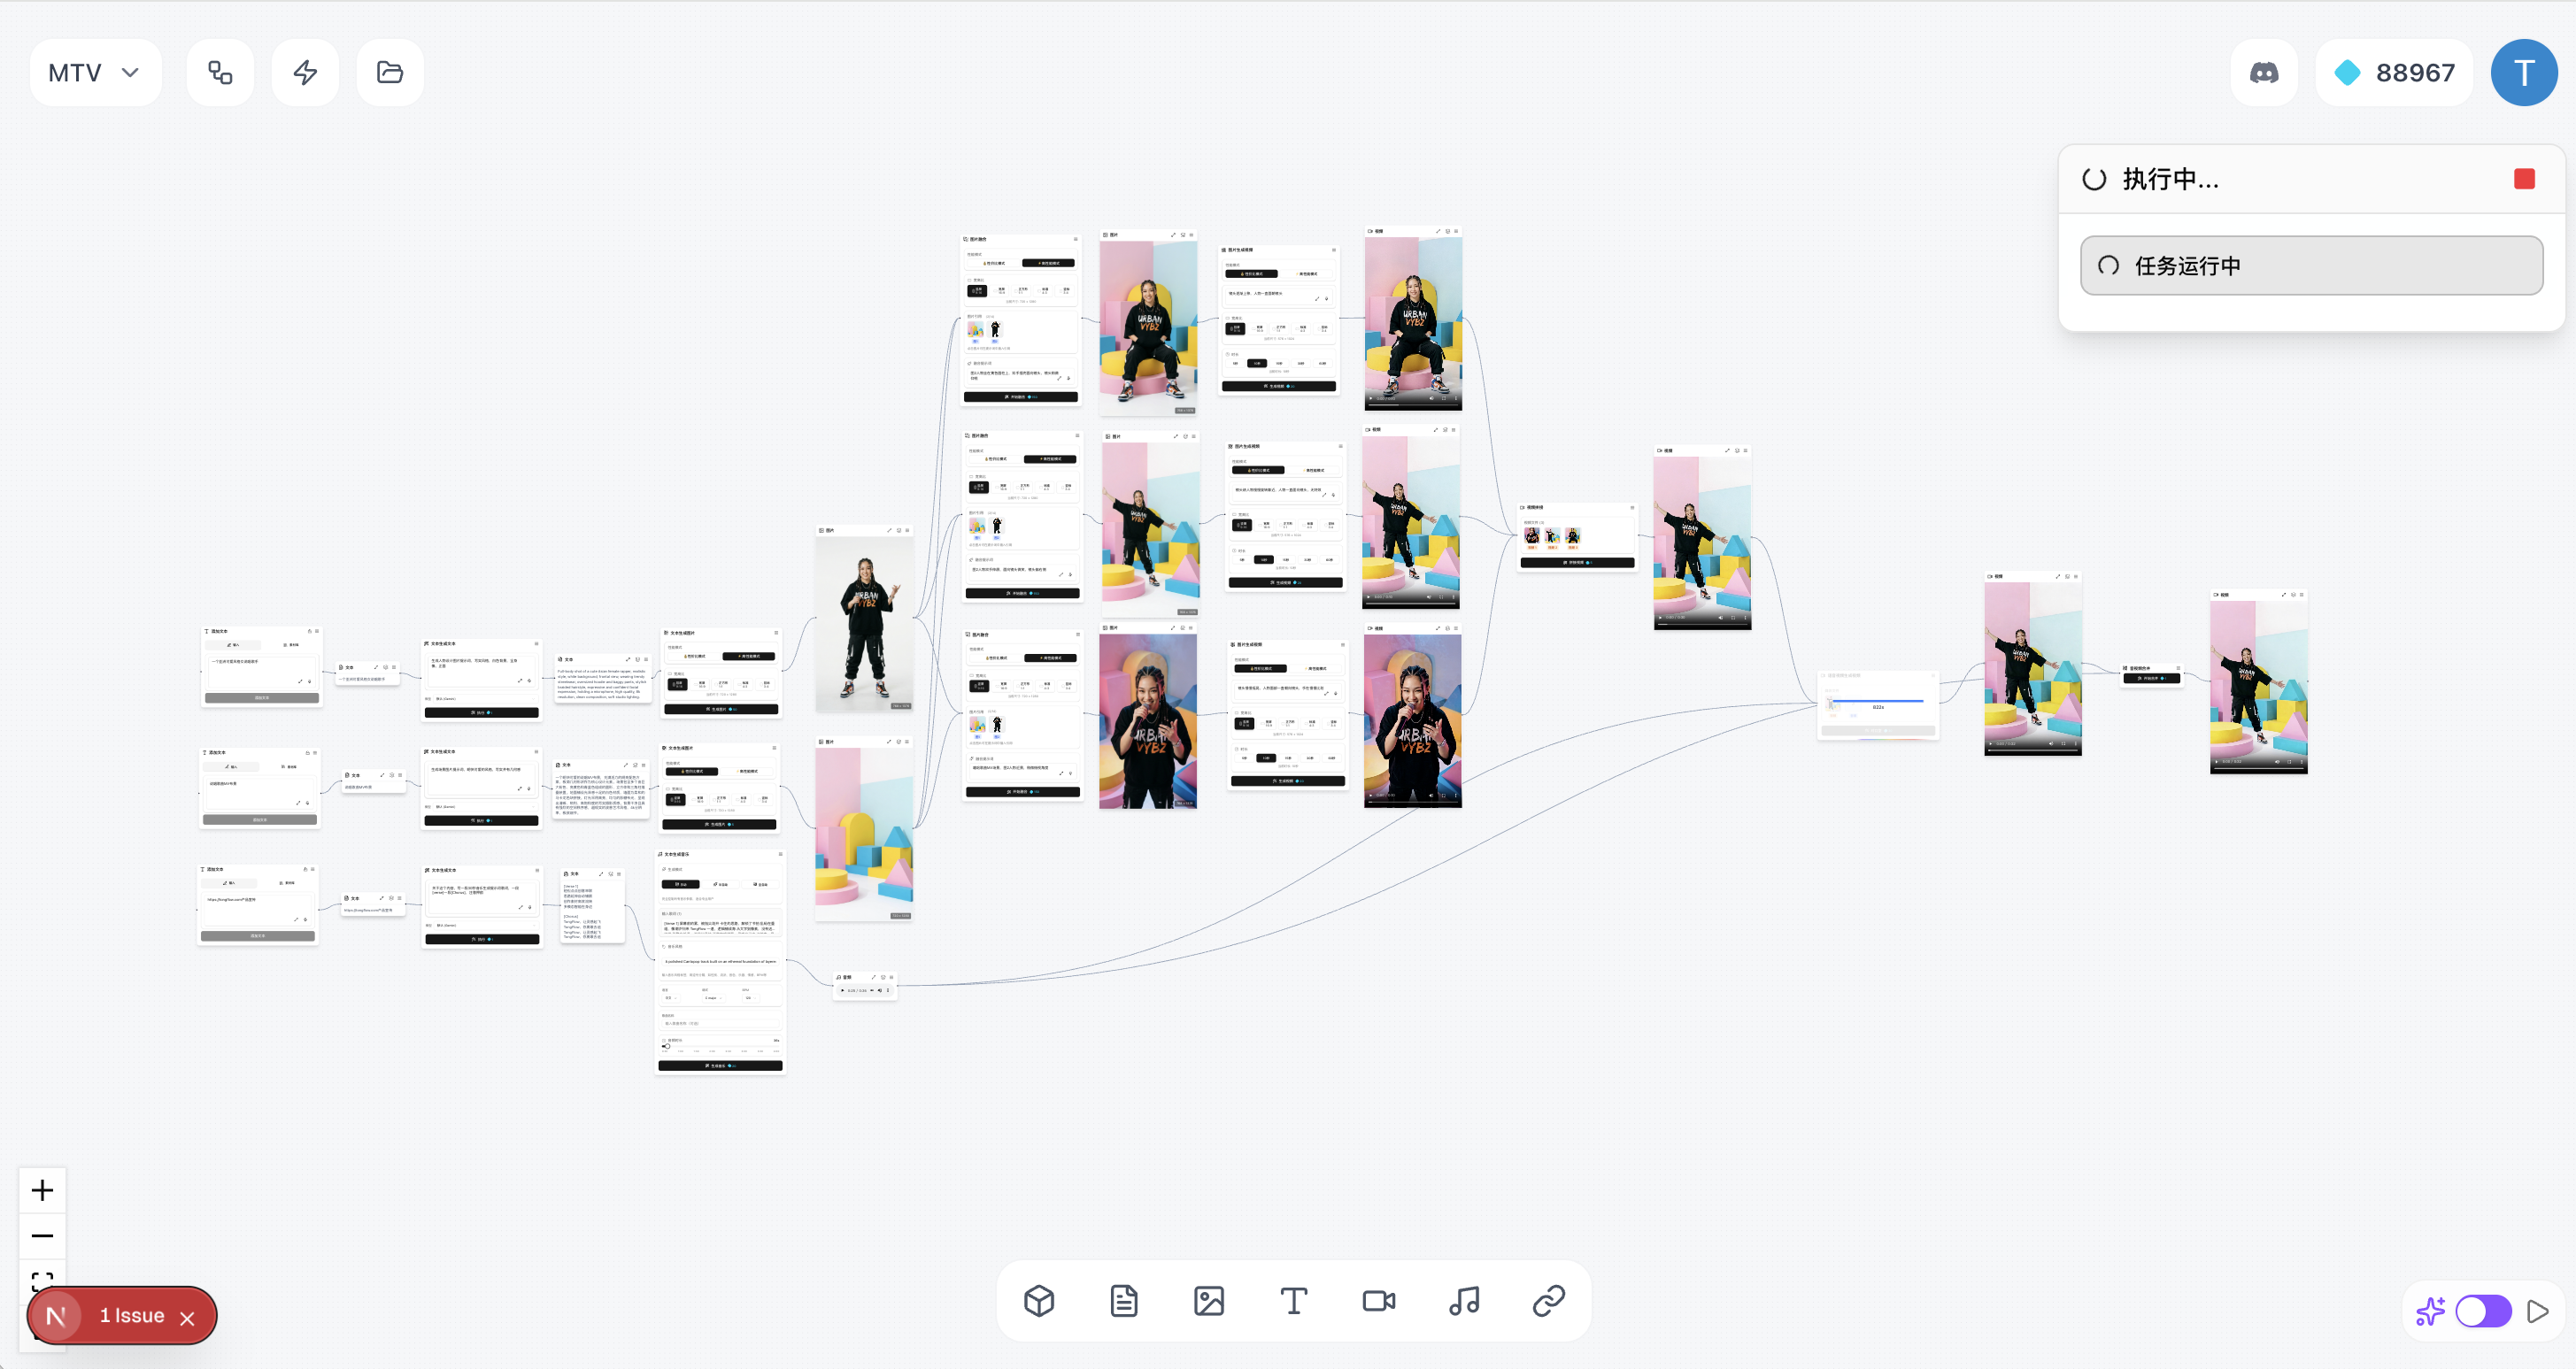 |
每一步的输出都留在画布上,作为下一步的材料:从生成的图接着分支,把转录文本送进下一步,或者只换掉某个节点背后的模型,其余流程原样保留。
快速开始
TongFlow 有三种用法,共用同一个开源内核:TongFlow 云版(桌面版,或在浏览器里打开 app.tongflow.com)、自行部署(从源代码或用 Docker),以及与 Agent 一起构建(tongflow npm 包或者把 TongFlow 装进 Claude Code、任何 MCP 客户端或 dsh)。
TongFlow 桌面版是一个轻量(约 10 MB)的壳应用,直接加载云端工作室 app.tongflow.com ——安装、登录,即可开始创作。云端工作室也可以直接在浏览器里打开。
Step 1 — 安装桌面版
下载对应平台的安装包,安装并打开。
- macOS(Universal — Apple Silicon 和 Intel 通用): TongFlow-mac-universal.dmg
- Windows: TongFlow-win-x64.msi
全部版本见 Releases 页面。
macOS 用户注意: 安装包暂未经过 Apple 公证,首次打开会被 Gatekeeper 拦截(提示"TongFlow 已损坏,无法打开")。把 app 拖入「应用程序」后,在终端执行一次以下命令即可正常打开:
xattr -cr /Applications/TongFlow.app请直接从本页面下载安装包——通过微信等聊天工具转发的安装包可能被改名或重新打上隔离标记。
Step 2 — 登录并开始创作
用 Google 或微信登录即可开始创作——插件与执行都由云端托管。
想要完全本地、无需账号的 TongFlow? 请使用自托管——参见从源代码启动或用 Docker 启动,然后按照自托管配置完成设置。(v0.1.13 及之前的桌面版内置了完整本地运行时,安装包仍保留在 Releases 页面。)
Modality-First:从模态出发
模态是信息的形态:文字、图像、声音、视频、三维、文档、链接。TongFlow 把它们当作工作流的基本材料。先想能做什么,再选用什么模型。搭一步流程,其实是三个分开的决定:
| 问题 | 举例 | |
|---|---|---|
| 材料 | 你拥有什么? | 一份文档、一张照片、一段录音、一个想法。 |
| 能力 | 它能成为什么? | 理解、生成、转换、组合,或拆成多个部分。 |
| 实现 | 交给谁来完成? | 为这一步选择兼容的插件和模型。 |
- 结果,也是新的起点。 材料拥有独立节点。上传的图和生成的图,都能进入下一个兼容的操作。从已有结果继续分支,不必从头再来。
- 能力在前,模型在后。 工作流分别记录「这一步做什么」和「由哪个插件执行」。切换兼容实现时,周围的流程结构原样保留。
- 四种基本操作。 添加、转换、组合、拆分与批量。理解、生成和处理用的是同一套节点和连接规则,生成只是其中一种操作。
- 人与 Agent,共用一种结构。 画布、导出器与 Agent 工具使用同一份节点注册表。可以在画布上搭,也可以通过
tongflow包构图;在 Claude Code、MCP 客户端或 dsh 里,Agent 生成的工作流都可以打开、编辑、再跑一遍。 - 开放生态。 ABI 只定义每个能力的输入输出契约,不关心由谁实现。任何平台都能用同样的方式发布插件;下方的官方插件几乎覆盖了功能表里的每个节点。
延伸阅读:把不同模态,接成工作流:TongFlow 的设计起点。
已实现功能
下面每个节点都对应 ABI 里的一项能力,按四种基本操作分组。材料(文本、图像、音频、视频、三维、文档、链接)是把它们连起来的节点。
✅ = 开箱即用(已有官方插件)· ⬜ = 画布中已有节点,但暂无官方插件(规划中)。
添加
- ✅ 文本输入: 输入文字并添加文本节点。
- ✅ 添加图片: 选择本地文件并添加图片节点。
- ✅ 拍照: 用设备摄像头拍摄并添加图片节点。
- ✅ 添加草图: 在画布上绘制并添加图片节点。
- ✅ 添加音频: 选择本地音频文件并添加音频节点。
- ✅ 录音: 用麦克风录音并添加音频节点。
- ✅ 添加视频: 选择本地视频文件并添加视频节点。
- ✅ 录制视频: 用摄像头录制并添加视频节点。
- ✅ 添加文档: 选择本地文件并添加文档节点。
- ✅ 添加链接: 从链接抓取页面,添加文本、图片、音频或视频节点。
- ✅ 添加 3D 模型: 选择本地模型文件并添加 3D 模型节点。
转换
文本
- ✅ 生成 / 改写: 根据提示创建或编辑文案。
图像
- ✅ 图像生成: 从文本生成图像。
- ✅ 图像编辑: 局部重绘、编辑或按指令重画。
- ✅ 图像理解: 从图像生成描述、问答或说明。
- ✅ 图像超分: 放大以获得更清晰的细节。
- ✅ 姿态检测: 308 关键点全身骨架叠加(身体、双手、脸部)。
- ✅ 人体部位分割: 29 类人体解析叠加图。
- ✅ 表面法线: 逐像素法线图——人物特写或整幅场景均可。
- ✅ 前景抠图: 将人物或显著主体抠为透明 PNG。
视频
- ✅ 视频生成: 从文本生成视频。
- ✅ 图生视频: 将静态图像动态化。
- ✅ 首尾帧视频: 用两张关键帧插值生成片段。
- ✅ 多图生视频: 多图参考融合——若干参考图加文本生成全新视频。
- ✅ 全模态参考生视频: 图、视频、音频参考混搭(加文本),一次生成自带立体声的视频。
- ✅ 视频理解: 从视频生成摘要或描述。
- ✅ 视频超分: 输出更高分辨率的视频。
- ✅ 提取首帧 / 尾帧: 将帧提取为图片。
- ✅ 视频编辑: 根据文本指令编辑视频。
- ✅ 去字幕: 从视频中清除字幕。
- ✅ 去水印: 从视频中去除水印。
音频
- ✅ 音乐生成: 从文本生成音乐,可选参考音频引导。
- ✅ 音频生成:一段描述一次生成人声、音效和环境声,可选参考音色。
- ✅ 音频理解: 用文字描述一段音频(音乐 / 语音 / 环境音)。
- ✅ 音乐重绘: 重新生成歌曲中指定的时间段。
- ✅ 音乐翻唱: 按描述或参考曲目改编歌曲风格。
- ✅ 加轨 / 补全编曲: 在现有音乐上生成新乐轨,或补全缺失的声部。
- ✅ 音乐企划: 一句话灵感 → 歌词、风格标签、BPM、调式、时长。
- ✅ 语音合成: 文字转语音——预设风格、声音克隆(参考音频)或指令驱动。
- ✅ 语音识别: 转录音频或视频中的语音。
- ✅ 降噪: 对音频降噪处理。
- ✅ 说话人分离: 按说话人分离音频。
- ✅ 音色转换: 把一段说话或歌声换成参考音频里的音色。
- ✅ 多轨 / 人声伴奏分离: 分离人声、鼓、贝斯、吉他等 12 种乐轨。
- ✅ 开放词汇声音分离: 用一句话描述任意声音(“狗叫”),把它和其余声音拆成两轨。
三维、文档与链接
- ✅ 图像 → 3D: 从单张图像生成 3D 模型。
- ✅ 视频 → 动作捕捉: 单目视频转骨骼动画(身体 + 手指 + 表情通道,GLB)。
- ✅ 文档 → 文本: 从文档中提取纯文本。
- ✅ 链接 → 文本: 将页面内容转换为文本。
组合
- ✅ 图像融合: 将多张参考图融合或编辑为一张图。
- ✅ 口型同步: 音频 + 视频 → 视频(口型同步);也支持音频 + 图片 → 视频、音频 + 文本 → 视频等变体。
- ✅ 情感语音: 文本 + 参考音色 → 用该音色朗读,支持情感控制。
- ✅ 换角色: 视频 + 参考(场景融合 / 角色替换)。
- ✅ 动作迁移: 角色图 + 驱动视频,端到端(免姿态提取)。
- ✅ 文本合并: 将多个文本节点合并为一个。
- ✅ 拼接片段: 将多个视频首尾相接。
- ✅ 音视频合并: 合并为单个文件。
拆分与批量
- ✅ 按镜头分割: 按场景将长视频切分。
- ✅ 拆分音视频: 将视频解封装为独立的视频轨和音频轨。
- ✅ 提取音轨: 将音频单独导出为资源。
- ✅ 分割长文本: 将长段落拆分为块。
- ✅ 合并 / 整理文本块: 合并片段(可使用自动合并选项)。
- ✅ 过滤 / 丢弃片段: 按规则或手动选择丢弃不需要的片段。
- ✅ 排列与批量分组: 对文本或片段批次进行分组排列,供下游处理使用。
官方插件
官方 GPU/CPU 插件目前运行在 Modal 上——每月最多 $30 免费 GPU 算力(H100/A100 等)。
MODAL_TOKEN_*的配置见自托管配置。任何其他平台都可以用同样方式发布自己的插件。
API 插件
一线厂商(各自发布自研模型):
- tongflow-api-gemini — Google Gemini,按节点模型选择:文本、视觉、图像(Nano Banana / Imagen 4)、Veo 视频、TTS 与转写
- tongflow-api-openai — OpenAI,按节点模型选择:
gen_text、图像生成/编辑/融合(gpt-image-2)、视觉、文档 OCR、Whisper 转写与 TTS - tongflow-api-deepseek — DeepSeek,节点上可切模型(V4.1 Flash / V4 Pro,带流式思考气泡):
gen_text及文本工具,Flash 还能看图 - tongflow-api-bytedance — 火山方舟,按节点模型选择:豆包文本与视觉、Seedream 图像生成/编辑/融合、Seedance 文 / 图 / 音 → 视频
- tongflow-api-xai — xAI Grok,按节点模型选择:
gen_text(Grok 4.x)、图像理解、Grok Imagine 文生图 - tongflow-api-runway — Runway Dev 统一 API,按节点模型选择:视频(Gen-4.5、Gen-4 Turbo、Aleph 编辑、Act-Two、Seedance、Veo)、图像(GPT Image 2、Seedream 5、Gemini image 3)与 ElevenLabs TTS
- tongflow-api-metaso — 秘塔科技托管的 MiniMax H3 视频生成:文/图生视频,768P 0.09 元/秒、2K 0.15 元/秒,走 OpenAI 兼容的 Videos 接口
- tongflow-api-qwen-audio — 阿里百炼上的千问 Qwen-Audio-3.1:TTS-Next 一次生成人声、音效和环境声(声音克隆、按描述定制音色、情感语音也走它),TTS-Flash 预设音色,ASR-Flash 语音识别(带时间戳和说话人标签)
中转 / 聚合插件
一个 key 转发多家厂商模型:
- tongflow-router-openrouter — OpenRouter,按节点模型选择:
gen_text(默认免费,另可选 GPT-5.5 / Claude / Gemini / Grok / DeepSeek)、视觉 / 音频理解、图像生成/编辑与转写 - tongflow-router-cometapi — CometAPI 聚合网关,按节点模型选择并实时拉取 CometAPI 模型目录:
gen_text/ 文本工具(GPT-5.5、Claude、Gemini、DeepSeek、Grok、Qwen、Kimi)、图像 / 视频 / 音频理解、图像生成/编辑/融合(GPT Image 2、Seedream)、文 / 图 → 视频(Sora 2、Veo 3.1、Seedance、Wan、MiniMax、HappyHorse、Vidu)、视频编辑(Omni)、TTS 与 Whisper 转写 - tongflow-router-toapis — ToAPIs 聚合网关,按节点模型选择:
gen_text/ 文本工具(GPT-5.6、Claude、Gemini、DeepSeek、Qwen、GLM、Kimi、MiniMax)、图像理解、图像生成/编辑/融合(GPT Image 2、Seedream 5、Gemini Image、Flux 2、Grok)、文 / 图 / 首尾帧 / 多模态参考 → 视频(Sora 2、Veo 3.1、Seedance 2、Kling、MiniMax H3、Wan、HappyHorse、Vidu)、视频编辑(HappyHorse),并实时拉取当前 key 的模型列表 - tongflow-router-apimart — APIMart 聚合网关,支持节点上按模型选择:图像生成 / 编辑(Z-Image、Seedream、Nano Banana、GPT-Image)、文 / 图 → 视频(可灵、VEO3、Sora2、Seedance)、
gen_text(GPT-5、Claude、Gemini)、Whisper 转录与 TTS - tongflow-router-replicate — Replicate,按节点模型选择覆盖全目录:文本、视觉、图像 生成/编辑/融合/放大/抠图、文 / 图 → 视频、转写、TTS / 声音克隆、音乐、图 → 3D(FLUX、Seedream、Veo、Kling、Whisper、Hunyuan3D…)
- tongflow-router-fal — fal.ai,按节点模型选择:图像(生成/编辑/融合/放大/抠图/姿态/法线/分割)、视频(文 / 图 → 视频、首尾帧、说话头、唇同步、放大)、音频(转写、TTS、声音克隆、音乐、声源分离)与 图 → 3D
- tongflow-router-infistar — 无限星河AI(Infistar)网关,按节点模型选择,下拉还会列出该 key 自己的模型清单:
gen_text与文本工具(GPT-5.6、Claude、Gemini、通义千问、DeepSeek、GLM、Kimi、豆包、MiniMax、Grok)、图像理解、图像生成/编辑/融合(GPT Image 2、Qwen-Image、Seedream、Wan)、文/图生视频(Wan 3.0、Seedance、MiniMax H3)与语音转写
GPU/CPU 插件
- tongflow-modal-ffmpeg — 转码、混流、媒体处理管线
- tongflow-modal-pyscenedetect — 镜头边界检测,用于分割片段
- tongflow-modal-z-image — Z-Image 文本生图
- tongflow-modal-ernie-image — ERNIE Image 文本生图(备选)
- tongflow-modal-krea2 — Krea 2 Turbo 文本生图(开源 12B,8 步蒸馏,最高 2K)
- tongflow-modal-moss-image — MOSS-Image(OpenMOSS)5B 文本生图:中英文密集文字渲染,提示词最长 4K token,支持用 JSON 布局按框摆放文字和物体(备选)
- tongflow-modal-flux2-klein9b — FLUX.2 Klein 9B 多参考融合与图像编辑
- tongflow-modal-qwen-image-edit — Qwen-Image 2.1:文生图、指令式图像编辑、多图融合(最多 10 张参考图)与透明背景抠图(无头 ComfyUI,int8;权重 Qwen Research License,仅限非商用)
- tongflow-modal-boogu — Boogu-Image-0.1(fp8)文本生图(密集中英文字)与单图编辑
- tongflow-modal-infinitetalk — InfiniteTalk 音频驱动口型同步(音频 + 图片 / 视频 → 数字人视频)
- tongflow-modal-longcat-avatar — LongCat-Video-Avatar 1.5(美团)音频驱动数字人:人像 + 语音 → 口型同步视频,Whisper 音频编码、8 步蒸馏,最长 60 秒(备选)
- tongflow-modal-wan-animate — Wan-Animate-2 端到端角色动画(角色图 + 驱动视频,免姿态提取)
- tongflow-modal-scail2 — SCAIL-2 可控角色动画(角色图 + 驱动视频),以及换角色
- tongflow-modal-minimax-h3 — MiniMax-H3 33B 视频生成,原生立体声(文生 / 首尾帧 / 多图 / 全模态参考)
- tongflow-modal-bernini — Bernini-R 1.3B 统一视频渲染器(文/图 → 图/视频、视频编辑、去字幕 / 去水印)
- tongflow-modal-sam3 — SAM 3 / SAM 3.1 文本引导抠像:按描述抠出图像中某概念的全部实例(透明 PNG),或在视频中全程跟踪(绿幕输出)
- tongflow-modal-triposplat — TripoSplat 单图生成 3D 高斯泼溅
- tongflow-modal-sam-3d-objects — SAM 3D Objects 单图重建前景物体 3D 高斯泼溅(自动抠前景,抗遮挡;备选)
- tongflow-modal-sam-3d-body — SAM 3D Body 单图重建全身人体 3D 网格 GLB(多人、MHR 骨骼;备选),以及视频动作捕捉(逐帧回归 MHR → 角色动画 GLB;备选)
- tongflow-modal-sapiens2 — Sapiens2(Meta)人体套件:姿态检测、人体部位分割、表面法线、人像抠图、图像 → 3D 点云,以及视频动作捕捉(几何引擎:关键点 + pointmap → MHR 角色动画 GLB)
- tongflow-modal-sensenova-vision — SenseNova-Vision(商汤)统一视觉模型:图像理解 / 看图问答、检测与 OCR 结构化文本、全场景表面法线、显著主体抠图、人体姿态叠加(备选)
- tongflow-modal-seedvr2 — SeedVR2 图像 / 视频超分辨率
- tongflow-modal-gemma4 — Gemma-4 多模态文本(图像 / 视频理解)
- tongflow-modal-qwen38 — Qwen3.8-27B 多模态文本(文本生成、图像 / 视频理解;备选)
- tongflow-modal-qwen3asr — Qwen3 语音识别
- tongflow-modal-qwen3tts — Qwen3 文字转语音
- tongflow-modal-indextts2 — IndexTTS-2.5 情感文字转语音:零样本声音克隆(备选)+ 参考音色的情感语音合成
- tongflow-modal-seed-vc — Seed-VC 零样本变声:用一小段参考音频,把说话或歌声换成那个人的音色(GPL-3.0)
- tongflow-modal-whisper — Whisper 语音识别(带时间戳,备选)
- tongflow-modal-moss-transcribe-diarize — MOSS-Transcribe-Diarize 0.9B:长音频多人转写,一次出时间戳与说话人标签,并按说话人切出独立音轨(50+ 语言,最长约 90 分钟)
- tongflow-modal-ace-step — ACE-Step 1.5 音乐全家桶:文本生音乐(sft / base / turbo 可选)、重绘、翻唱、分轨提取、加轨、补全编曲、音乐企划与音乐理解
- tongflow-modal-levo — LeVo 2 / SongGeneration 文本生音乐(多语言、商用级)
- tongflow-modal-minimax-music3 — MiniMax-Music3 11B 歌曲生成:歌词 + 描述 → 带人声完整歌曲(最长约 5 分钟,32 kHz 立体声)
- tongflow-modal-yue2 — YuE2 歌曲生成:风格 + 歌词 → 可编辑乐谱 → 带人声完整歌曲(48 kHz 立体声),也能做纯音乐,另可借 SheetSage2 扒谱做翻唱(权重 CC BY-NC 4.0;个人创作者可将作品变现,公司商用需另获授权)
- tongflow-modal-sam-audio — SAM-Audio 文本提示声音分离:降噪、人声分离、按自由描述提取任意声音(“背景里的钢琴”)
- tongflow-modal-docling — Docling 文档 → 文本
- tongflow-modal-paddle — PaddleOCR 文档 → 文本
- tongflow-modal-unlimited-ocr — Unlimited OCR 2 超长文档 / 上百页 PDF → 文本
- tongflow-modal-crawl4ai — Crawl4AI URL / 链接 → 文本
- tongflow-modal-scrapling — Scrapling 隐身浏览器 URL / 链接 → 文本
从源代码启动
pnpm install
pnpm plugins:install   # 克隆官方插件到 plugins/
pnpm start:prod        # 先构建一次,再启动于 http://localhost:3000
需要 Node(含 pnpm)以及 PATH 上有一个 Python 3.10+ 解释器(可用 PYTHON 指定具体的那个)。插件以本地 Python 进程运行;TongFlow 会自动为它们创建隔离的 venv,并在首次使用时安装各插件的 requirements.txt——无需手动配置 Python。
打开 http://localhost:3000,画布已就绪。服务默认只响应本机;想从别的机器访问,先设置 TONGFLOW_AUTH_TOKEN,用 -H 0.0.0.0 启动,再打开一次 http://<主机>:3000/?token=<token>。然后按照自托管配置完成设置(凭据填在 app 内的设置对话框,或用项目 .env)。
用 Docker 启动
GHCR 上已发布自托管镜像——无需配置 Node/Python/pnpm:
docker run -d -p 127.0.0.1:3000:3000 \
  -v tongflow-data:/data -v tongflow-plugins:/plugins \
  ghcr.io/tong-io/tongflow:latest
容器会在日志里打印一个登录链接(http://localhost:3000/?token=…),用 docker logs <容器> 找到后打开一次即可;token 自动生成并保存在数据卷里,也可以用 -e TONGFLOW_AUTH_TOKEN=… 自己指定。或者用 Compose(会克隆本仓库的 docker-compose.yml):
docker compose up -d
想自己构建镜像而不是拉取:docker build -t tongflow .
数据与凭据。 所有可写内容都存放在 /data 卷(SQLite 数据库、上传文件、设置)。API key 是可选的——在 app 内的设置对话框里填写,或在启动时传入(-e OPENROUTER_API_KEY=…);支持的 key:OPENROUTER_API_KEY、GEMINI_API_KEY、OPENAI_API_KEY、MODAL_TOKEN_ID / MODAL_TOKEN_SECRET。
插件。 镜像不自带任何插件——请从 app 内的插件管理器安装(首次安装需要访问 GitHub 的网络)。首次运行时,插件会在 /data/.tongflow/plugin-venv 下创建一个共享的 Python venv(从 PyPI 安装 SDK 以及该插件的 requirements.txt),因此首次运行较慢且需要网络。基于 Modal 的插件还需要一个 Modal token。
自托管配置(插件与凭据)
自托管的 TongFlow 默认不预装任何插件,画布已预加载一个示例工作流。三步即可跑起来:
1 — 安装插件
打开插件管理器(右上角的方块图标),按需安装。新装的插件即时可用,无需重启。
要运行预加载的示例工作流(文本 → 图像 → 融合 → 视频),需安装以下三个插件:
- tongflow-modal-z-image — 文本生图
- tongflow-modal-qwen-image-edit — 图像融合 / 混合
- tongflow-modal-minimax-h3 — 图生视频
这些插件运行在 Modal 上(每月最多 $30 免费 GPU 算力)。在设置里填入 MODAL_TOKEN_ID / MODAL_TOKEN_SECRET;可在 modal.com/settings/tokens 创建 token。任何其他平台都可以用同样方式发布自己的插件。
在插件管理器里可浏览完整目录——官方 API 插件(OpenAI / Gemini / OpenRouter)以及其他 GPU/CPU 插件。
2 — 配置凭据
打开设置(右上角齿轮图标),填入插件需要的环境变量——比如 API 插件用的 OPENAI_API_KEY,或 GPU/CPU 插件所需的凭据。
插件凭据都在「设置」里。 TongFlow 不绑定任何平台、不硬编码任何 provider:设置对话框是一个通用的环境变量 key/value 编辑器,传给插件使用。各插件需要哪些 key 由它自己的 README 说明。值保存在本地,改动即时生效、无需重启。
3 — 运行示例工作流
逐个节点执行预加载的示例,也可以切换到执行模式,点击运行按钮即可一键执行。
装进你自己的 agent
TongFlow 也可以跑在你自己的 agent 里——不用装桌面 app,也不用自己起服务。
分工是这么设计的:agent 负责搭项目、把计划、设定和提示词写成普通文件;TongFlow 负责生成,而每一个生成出来的东西都来自一个存好的 .tongflow.json 工作流,就放在它的产物旁边——所以你随时可以在画布上打开它、改一改、再跑一遍。这里没有「生成一张图」这种工具,也没有项目模板。
Claude Code
/plugin marketplace add tong-io/tongflow
/plugin install tongflow@tongflow
装好后直接说你想做什么。插件把 TongFlow 的工具和工作方法交给 Claude。说一句「打开 studio」,Claude 会给你一个本地网页:项目的文件树、预览、画布、运行记录,还有填插件密钥的地方。要花钱的运行,Claude 每次都会先问你。
任何支持 MCP 的客户端
{ "mcpServers": { "tongflow": { "command": "npx", "args": ["-y", "tongflow-studio", "mcp"] } } }
同一套工具、同一个 Studio 网页,凡是支持 MCP 的 agent 都能接。
DeepSeek Harness(dsh)
npx @deepseek-ai/dsh@next plugin --profile web add dsh-tongflow
npx @deepseek-ai/dsh@next web
然后开一个会话,第一条消息以 @tongflow 开头。这个会话就变成 Studio——聊天、项目的文件树、预览 / 编辑器 / 画布,加一个运行记录抽屉——agent 也就拿到了 TongFlow 的那套工具。其他会话还是原来的 dsh,不受影响。
三种方式首次使用时都会自己建 Python venv 并克隆官方插件,画布上的节点和插件目录跟线上版一样全。环境要求和配置项见 packages/tongflow-studio/README.md(Claude Code、MCP)和 packages/dsh-tongflow/README.md(dsh)。
自定义插件
画布上每一个能跑的节点都是一项能力,背后是一份契约——ABI(packages/tongflow/abi/tongflow.abi.json),它定义「有哪些能力」以及「每个能力的输入输出长什么样」,而与「由谁实现」无关。插件负责实现:一个小小的 Python 包,挑 ABI 里一个或多个槽,借助 tongflow Python SDK,用 ABI 生成的类型给出怎么做的那部分。换掉节点背后的插件,周围的工作流不用动。
完整的开发流程——ABI、@node_slot 装饰器、SDK、目录结构以及如何发布,请见 docs/plugins.md。
社区
加入 Discord 或扫描下方微信群二维码。
商务合作
商务合作请联系 [email protected]。
- 开源模型 owner:我可以集成你的模型,让用户流畅体验。
- 企业用户:我可以协助在本地 GPU 上部署、构建定制节点和插件等。
- 平台 / 路由:我可以接入你的 API。
- VCs:欢迎探讨围绕 TongFlow 云版(托管工作台)的合作。
开源
如果你喜欢这个项目,在 GitHub 上 Star 一下非常有帮助,感谢!
授权协议
TongFlow 采用 双授权(dual-licensing) 模式:
- AGPL-3.0 —— 对个人、研究、开源项目,以及愿意遵守 AGPL(含第 13 条 网络/源码公开义务)的使用者免费。
- 商业授权 —— 面向希望在闭源 / SaaS 产品中使用 TongFlow 且不愿公开源码,或需要保证条款与平台技术支持的组织。 价格面议,联系 [email protected]。
以上授权覆盖整个仓库,包括 sdk/ 目录(发布到 PyPI 的 tongflow 包)。
贡献代码受 CLA 约束。