
tocreator/tostore
tocreator/tostore has 67 GitHub stars and 11 forks. GitHot measured 0 stars in 24 hours and 0 in 7 days. Last checked 2026-11-15 13:36 UTC. Last push 2026-11-05.
可以做什么
- Declarative schema changes—automatic refactoring, no manual versioning
- Key rotation, schema migration, massive refactoring—all online, business-transparent
- Built-in status spec for automated O&M and Agent recognition
- Supports autonomous evolution and continuous iteration without interrupting service
实测星标增长
- 24小时
- 0
- 7天
- 0
- 15天
- 正在收集历史
- 1个月
- 正在收集历史
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
关于
Data engine: AI vector & SQL/NoSQL database. Key-value/KV, embeddings, BM25 full-text, hybrid & semantic search for RAG/LLM. Local storage, TTL/LRU cache, offline encrypted.
人工智能doc/translations/zh-CN/README.md
原文


English | 简体中文 | 日本語 | 한국어 | Español | Português (Brasil) | Русский | Deutsch | Français | Italiano | Türkçe
快速导航
- 为什么选择ToStore | 核心特性 | 安装指南 | KV模式 | 表模式 | 内存模式
- 表结构定义 | 分布式架构 | 级联外键 | 移动/桌面端 | 服务端/智能体 | 主键算法
- 高级查询 (JOIN) | 聚合与统计 | 复杂逻辑 (Condition) | 响应式监听 (watch) | 流式查询
- KV进阶 | 批量操作 | 恢复保障 | 混合检索(稠密 / 稀疏 / 文本) | 表级 TTL | 容量淘汰 | 高效分页 | 内存探针与同步检索 (peek) | 查询缓存 | 原子操作 | 事务
- 管理维护 | 安全配置 | 错误处理 | 性能与诊断 | 欢迎贡献 | AI 编程助手
为什么选择 ToStore?
ToStore 是面向 AGI 时代与边缘智能场景设计的现代化数据引擎。基于自寻径节点架构 (Self-Routing),节点高自治、可弹性水平扩展,性能与数据规模逻辑解耦——边缘与云端单机均设计支撑结构化表万亿级以上记录,向量与稀疏文本检索亦达百亿级以上规模。
运行态建模与非阻塞执行路径,架构演进全程在线、业务完全无感——表结构声明式变更、密钥轮换、海量数据重构均可在线无感完成。支撑智能体与自动化运维的运行时建表、动态记忆演化及其自主演进与持续迭代,服务不中断。
统一承载关系型结构化数据、稠密向量、神经稀疏向量与非结构化文本;内建词法文本检索、稠密向量检索、神经稀疏检索及多路召回融合。兼具 ACID 事务、复杂关系查询(JOIN、级联外键)、表级 TTL、容量淘汰(FIFO / LRU)、聚合计算,以及分布式主键算法、原子性表达式、加密保护、多空间隔离与故障自愈等工业级能力。
随着计算重心持续向端侧边缘智能偏移,终端不再只是"内容展示器",而是承担局部生成、环境感知、实时决策与数据协同的智能节点。ToStore 为边缘端提供海量数据与复杂 AI 局部生成所需的分布式能力,边云深度协同,为多模态交互、长期记忆、RAG 检索增强生成与本地知识库、混合检索、空间建模及边缘自主协同提供可靠数据基座。
核心特性
🤖 运行态演进与智能运维
- 表结构声明式变更——自动识别重构,无需手动维护版本
- 密钥轮换、表结构迁移、海量重构——全程在线,业务无感
- 内置状态规范,支撑自动化运维与智能体精准识别
- 支撑自主演进与持续迭代,服务不中断
🧠 自寻径分布式架构
- 自寻径节点架构,物理寻址与数据规模解耦
- 高自治节点互联协同,构建灵活的数据拓扑
- 弹性水平扩展;单机表万亿级、向量百亿级以上
🌐 统一的跨平台数据引擎
- 移动端、桌面端、Web 与服务端统一 API
- 覆盖关系型数据、稠密 / 神经稀疏向量与文本检索
- 从本地存储到边云协同的完整数据链路
🔍 结构化查询与混合检索
- 复杂条件、JOIN、聚合、表级 TTL 与容量淘汰(FIFO / LRU)
- 词法文本检索、稠密向量检索、神经稀疏检索同链组合
- 多路召回融合排序,分数与通道诊断随结果返回
⚡ 并行执行与资源调度
- 冷启动耗时恒定约 35 ms,与数据规模解耦
- 资源感知负载调度;多节点并行协同与任务拆分
- 时间切片机制,高负载下 UI 动画依然流畅
🔐 离线优先与隐私安全
- 数据可留存本端、离线可用,降低云端依赖与外泄面
- 多空间隔离与可选全局共享,天然适配多用户 / 多租户
- 内置 ChaCha20-Poly1305 与 AES-256-GCM 加密
- 经多重复杂灾难性场景恢复验证
安装
[!IMPORTANT] 从 v2.x 升级? 请阅读 v3.x 升级指南 以了解关键的迁移步骤和重大更改。
在 pubspec.yaml 中添加 tostore 依赖:
dependencies:
  tostore: any # 请使用最新版本
For AI Coding Assistants
使用 AI 助手生成 ToStore 客户端代码时,请向其提供单文件规范 llms-full.txt——例如在 IDE 中 @llms-full.txt、上传或粘贴该文件,或将其 raw URL 加入助手的文档索引。该文件包含 API 签名、约束与反模式,有助于模型对齐真实的公开接口。发现索引:llms.txt。
快速开始
[!TIP] 如何选择存储方式?
- 键值对模式 (KV):适用于配置存取、零散状态管理或 JSON 数据存储,主打快速上手。
- 结构化表 (Table):适用于核心业务,需复杂查询、约束校验或海量数据治理。通过将完整性逻辑下沉到引擎,可显著降低应用层开发与维护成本。
- 内存模式 (Memory):适用于临时计算、单元测试、有界内存缓存(支持 TTL 与 FIFO / LRU 容量淘汰等多种策略),或 作为极速全局状态管理使用 —— 无需定义繁琐变量,通过全局查询与 watch 监听即可重塑应用交互。
键值对存储 (KV)
适用于不需要定义结构化表的场景,简单实用,内置了高性能存储引擎。高效索引架构,确保在普通手机等边缘设备上,面对亿级数据规模,查询性能依然能维持极高的稳定性与极致的响应速度。 不同空间 (Space) 的数据天然隔离,同时也支持全局共享。
// 初始化数据库
final db = await ToStore.open();

// 设置键值对 (支持 String, int, bool, double, Map, List, Json 等)
await db.setValue('user_profile', {
  'name': 'John',
  'age': 25,
});

// 切换空间 - 隔离不同用户数据
await db.switchSpace(spaceName: 'user_123');

// 设置全局共享变量 (isGlobal: true 用于跨 Space 共享,如登录状态)
await db.setValue('current_user', 'John', isGlobal: true);

// 过期自动清理 (TTL)
// 支持设置生存时间 (ttl) 或 明确的过期时刻 (expiresAt)
await db.setValue('temp_config', 'value', ttl: Duration(hours: 2));
await db.setValue('session_token', 'abc', expiresAt: DateTime(2026, 2, 31));

// 获取数据
final profile = await db.getValue('user_profile'); // Map<String, dynamic>

// 数据变动实时监听 (用于刷新局部 UI,避免额外维护状态管理框架)
db.watchValue('current_user', isGlobal: true).listen((value) {
  print('登录用户已变更为: $value');
});

// 批量监听多个键
db.watchValues(['current_user', 'login_status']).listen((map) {
  print('多项配置已更新: $map');
});

// 删除数据
await db.removeValue('current_user');
[!TIP] 需要更多键值对功能? 诸如强类型读取(
getInt、getBool)、原子自增、前缀检索、链式分页查询记录(db.kv.query())等进阶操作,请参阅 键值对进阶操作 (db.kv)。
Flutter UI 自动监听刷新示例
在 Flutter 中,利用 StreamBuilder 配合 watchValue 可以实现极其简洁的响应式刷新:
StreamBuilder(
  // 监听全局变量时,务必指定 isGlobal: true
  stream: db.watchValue('current_user', isGlobal: true),
  builder: (context, snapshot) {
    // snapshot.data 即为 KV 中 'current_user' 的最新值
    final user = snapshot.data ?? '未登录';
    return Text('当前登录用户: $user');
  },
)
结构化表方式 (Table)
需预先创建表结构(详见 表结构定义)方可进行增删改查。针对不同场景的接入建议:
// 1. 初始化数据库
final db = await ToStore.open();

// 2. 插入数据 (准备基础数据)
final result = await db.insert('users', {
  'username': 'John',
  'email': '[email protected]',
  'age': 25,
});

// 统一操作模型 DbResult,推荐检查 hasErrors 判定结果
if (!result.hasErrors) {
  print('数据插入成功,生成的主键ID为: ${result.firstPrimaryKey}');
} else {
  print('插入失败: ${result.message}');
}

// 链式查询(详见[查询操作符](#查询操作符),支持 =, !=, >, <, LIKE, IN 等)
final users = await db.query('users')
    .where('age', '>', 20)
    .where('username', 'like', '%John%')
    .orderByDesc('age')
    .limit(20);

// 更新与删除
await db.update('users', {'age': 26}).where('username', '=', 'John');
await db.delete('users').where('username', '=', 'John');

// 实时监听 (更多详尽用法详见 [响应式查询](#reactive-query))
db.query('users').where('age', '>', 18).watch().listen((users) {
  print('符合条件的用户已更新: $users');
});

// 配合 Flutter StreamBuilder 实现局部 UI 自动刷新
StreamBuilder(
  stream: db.query('users').where('age', '>', 18).watch(),
  builder: (context, snapshot) {
    final users = snapshot.data ?? [];
    return ListView.builder(
      itemCount: users.length,
      itemBuilder: (context, index) => Text(users[index]['username']),
    );
  },
);
内存模式 (Memory Mode)
对于数据缓存、临时计算或不需要持久化到磁盘等场景,可以使用 ToStore.memory() 初始化一个纯内存数据库。在该模式下,所有数据(包括表结构、索引和键值对)均仅保存在内存中,读写性能达到极致。
内存模式同样支持多种淘汰策略:按时间的表级 TTL / KV TTL,以及按数量或体积的容量淘汰(FIFO / LRU),可单独或组合使用,让热数据按时过期或控住上限——尤其适合会话缓存、查询结果池等对内存敏感的场景。
💡 也可以作为全局状态管理
无需定义繁杂的全局变量或引入笨重的状态管理框架。通过内存模式配合 watchValue 或 watch() 监听,您可以实现跨组件、跨页面的全自动 UI 刷新。它既保留了数据库的强大检索能力,又获得了超越普通变量的响应式体验,非常适合管理登录状态、实时配置或全局消息计数。
[!CAUTION] 注意:纯内存模式下产生的数据在应用关闭或重启后将完全丢失,请勿用于存储核心业务数据。
// 纯内存库 — 按需启用 TTL 与/或 FIFO/LRU 容量淘汰
final memDb = await ToStore.memory(
  config: DataStoreConfig(
    kvCapacityConfig: CapacityConfig(
      maxEntries: 5000,
      policy: CapacityEvictionPolicy.lru,
    ),
  ),
);

// 设置一个全局状态(如:当前未读消息数)
await memDb.setValue('unread_count', 5, isGlobal: true);

// 在 UI 任何地方直接监听,无需传参
memDb.watchValue<int>('unread_count', isGlobal: true).listen((count) {
  print('UI 自动感知消息变动: $count');
});

// 所有的增删改查、KV 存取及向量搜索都将在内存中以极速完成
await memDb.insert('active_users', {'name': 'Marley', 'status': 'online'});
表结构定义
一次定义,换来引擎全链路自动化治理,长久免除应用维护繁重校验。
下文移动端、服务端与智能体示例都会复用这里的 appSchemas。
TableSchema 结构总览
const userSchema = TableSchema(
  name: 'users', // 表名,必填
  tableId: 'users', // 表的唯一标识,可选
  primaryKeyConfig: PrimaryKeyConfig(
    name: 'id', // 主键字段名,默认 id
    type: PrimaryKeyType.sequential, // 主键自动生成类型
    sequentialConfig: SequentialIdConfig(
      initialValue: 1000, // 顺序主键起始值
      increment: 1, // 顺序主键步长
      useRandomIncrement: false, // 是否启用随机步长
    ),
  ),
  fields: [
    FieldSchema(
      name: 'username', // 字段名,必填
      type: DataType.text, // 字段数据类型,必填
      nullable: false, // 是否允许为 null
      minLength: 3, // 最小长度
      maxLength: 32, // 最大长度
      unique: true, // 是否唯一
      fieldId: 'username', // 字段唯一标识,可选,用于识别字段重命名
      comment: '登录名', // 字段注释,可选,比如用于备注用途
    ),
    FieldSchema(
      name: 'status',
      type: DataType.integer,
      minValue: 0, // 数值下限
      maxValue: 150, // 数值上限
      defaultValue: 0, // 静态默认值
      createIndex: true,  // 快捷创建索引,提升检索性能
    ),
    FieldSchema(
      name: 'created_at',
      type: DataType.datetime,
      nullable: false,
      defaultValueType: DefaultValueType.currentTimestamp, // 自动填充当前时间
      createIndex: true,
    ),
  ],
  indexes: const [
    IndexSchema(
      indexName: 'idx_users_status_created_at', // 索引名,可选
      fields: ['status', 'created_at'], // 复合索引字段列表
      unique: false, // 是否唯一索引
      type: IndexType.btree, // 索引类型:btree/vector
    ),
  ],
  foreignKeys: const [], // 外键约束列表,可选;完整示例见下文“外键与级联约束”
  isGlobal: false, // 是否为全局表;true 时可跨 Space 全局共享
  ttlConfig: null, // 表级 TTL,可选;完整示例见下文“表级 TTL”
  capacityConfig: null, // 容量淘汰,可选;完整示例见下文“容量淘汰”
);

const appSchemas = [userSchema];
DataType常用数据类型对照表:类型 对应 Dart 类型 说明 integerint标准整数,适合 ID、计数等 bigIntBigInt/String大整数,超过 18 位数字建议使用,防止精度丢失 doubledouble浮点数,适合价格、坐标等 textString文本字符串,支持长度约束 blobUint8List二进制原始数据 booleanbool布尔值 datetimeDateTime/String日期时间,底层以 ISO8601 存储 arrayList列表/数组类型 jsonMap<String, dynamic>JSON 对象,适合存储动态结构化数据 vectorVectorData/List<num>稠密向量,用于语义近邻检索 (Embedding) sparseSparseVectorData神经稀疏向量,用于稀疏检索 PrimaryKeyType主键自动生成策略:策略 说明 特点 none不自动生成 需在插入时手动指定主键 sequential顺序递增 适合靓号,但分布式下性能较差 timestampBased基于时间戳 分布式推荐 datePrefixed日期前缀 业务需要日期可读性 shortCode短码主键 简短适合对外展示 所有主键默认以
text(String)类型存储。
约束与自动校验
通过 FieldSchema 将常见的校验规则直接下沉到引擎层,避免在应用层重复实现逻辑:
nullable: false:非空约束minLength/maxLength:文本长度约束minValue/maxValue:整数或浮点数范围约束defaultValue/defaultValueType:静态默认值与动态默认值unique:唯一约束createIndex:为高频查询过滤、排序或关联字段创建索引,提升检索性能fieldId/tableId:辅助识别字段或表重命名,便于迁移
其中,unique: true 会自动生成单字段唯一索引,createIndex: true 、外键会自动生成单字段普通索引;indexes 更适合定义组合索引、命名索引,以及文本 / 稀疏 / 向量检索索引。
表结构自动演进 (Schema Evolution)
引擎自动识别表结构变动(如表/字段的增删、重命名及属性调整、索引的增删改等)并完成数据迁移,无需开发者手动维护数据库版本或编写迁移脚本。声明式 schemas 在 ToStore.open() 时演进,运行时亦可 updateSchema 在线变更——业务无感知,读写不中断。
唯一字段升级为主键
可将已有唯一且非空字段升级为主键(可重命名;有数据亦可,业务无感知)。勿与 setPrimaryKeyConfig 同时变更。
- 移动端(声明式
schemas):ToStore.open()时自动识别。目标主键必须设为PrimaryKeyType.none(由原唯一字段取值,不支持其它自动生成类型);主键名与源字段相同即可按名称匹配,若需重命名则在fromFieldId填写源字段的fieldId。 - 服务端(运行时):调用
updateSchema(...).promoteFieldToPrimaryKey(sourceFieldName: ..., targetPrimaryKeyName: ...);targetPrimaryKeyName可选,省略则沿用源字段名。
选择接入方式
- 移动端/桌面端:适合在初始化实例直接把
appSchemas传入ToStore.open(...) - 服务端/智能体:适合在进程运行时动态创建 schema,调用
createTables(appSchemas)
移动、桌面等频繁启动场景集成
import 'package:path/path.dart' as p;
import 'package:path_provider/path_provider.dart';

// Android / iOS 需要先解析应用可写目录,再显式传入 dbPath
final docDir = await getApplicationDocumentsDirectory();
final dbRoot = p.join(docDir.path, 'common');

// 复用上文定义好的 appSchemas
final db = await ToStore.open(
  dbPath: dbRoot,
  schemas: appSchemas,
);

// 多空间架构 - 隔离不同用户数据
await db.switchSpace(spaceName: 'user_123');
追踪启动进度
正常表结构变更业务无感知并不阻塞启动;仅在移动端频繁关闭应用的少数特殊场景(如异常退出后的短暂数据校验与崩溃恢复)下才会出现启动耗时,此时可通过 onStartupProgress 展示闪屏或进度指示器:
final db = await ToStore.open(
  dbPath: dbRoot,
  schemas: appSchemas,
  onStartupProgress: (progress, stage) {
    // progress: 0.0 – 1.0  |  stage: opening → recovering → optimizing → ready
    print('启动进度 ${(progress * 100).toStringAsFixed(0)}% [$stage]');
    // 更新闪屏 / 进度条
  },
);
// 数据库完全就绪
各阶段说明:
opening— 加载配置,准备基础引擎recovering— 安全检查与崩溃恢复optimizing— 引擎参数调优、结构维护优化ready— 初始化完成,可以正常使用
保持登录状态与退出登录(活跃空间)
多空间适合按用户隔离数据:每用户一个空间,登录时切换。通过活跃空间与关闭选项,可保持当前用户到下次启动,并支持退出登录。
- 保持登录状态:用户切换到自己的空间后,将其记为活跃空间,下次启动时用 default 打开即可直接进入该空间,无需「先开 default 再切换」。
- 退出登录:用户退出时,使用
keepActiveSpace: false关闭数据库,下次启动不会自动进入上一用户空间。
// 登录后:切换到该用户空间并记为活跃空间(保持登录状态)
await db.switchSpace(spaceName: 'user_$userId', keepActive: true);

// 可选:仅需严格使用 default 时(如仅登录页)—— 不使用已保存的活跃空间
// final db = await ToStore.open(..., applyActiveSpaceOnDefault: false);

// 退出登录:关闭并清除活跃空间,下次启动使用 default 空间
await db.close(keepActiveSpace: false);
服务端/智能体(持续运行场景集成)
🖥️ 示例:server_quickstart.dart
final db = await ToStore.open();

// 进程运行时创建表结构
await db.createTables(appSchemas);

// 在线表结构更新
final result = await db.updateSchema('users')
  .renameTable('users_new')                // 修改表名
  .modifyField(
    'username',
    minLength: 5,
    maxLength: 20,
    unique: true
  )                                        // 修改字段属性
  .renameField('old_name', 'new_name')     // 修改字段名
  .removeField('deprecated_field')         // 删除字段
  .addField('created_at', type: DataType.datetime)  // 添加字段
  .removeIndex(fields: ['age'])            // 删除索引
  .setPrimaryKeyConfig(                    // 更改自动生成主键策略;表中已有数据时请避免
    const PrimaryKeyConfig(type: PrimaryKeyType.shortCode)
  );
// 服务端运行时:将唯一字段升级为主键(可重命名;勿与 setPrimaryKeyConfig 同链):
// await db.updateSchema('users').promoteFieldToPrimaryKey(
//   sourceFieldName: 'user_id',
//   targetPrimaryKeyName: 'uid', // 可选;省略则沿用源字段名
// );

// 监控迁移进度
final taskId = result.taskId;
if (taskId != null) {
  // 查看迁移元数据
  print('预估迁移耗时: ${result.estimateDuration?.inMilliseconds} 毫秒');
  print('涉及迁移数据重构模式: ${result.writeMode}'); // 例如 MigrationWriteMode.indexOnly

  final status = await db.queryMigrationTaskStatus(taskId);
  print('迁移进度: ${status?.progressPercentage}%');
}


// 纯服务端性能调优 (可选)
// yieldDurationMs 用于控制持续处理任务的时间片释放。
// 为了保障前端 UI 动画流畅,在非linux平台,默认适配为 8ms。
// 在不需要 UI 的场景,推荐手动调整为 50ms 以换取更高吞吐。
final dbServer = await ToStore.open(
  config: DataStoreConfig(yieldDurationMs: 50),
);
进阶用法
ToStore 提供了丰富的进阶功能,满足各种复杂业务场景需求:
键值对进阶操作 (db.kv)
对于更复杂的 Key-Value 场景,建议使用 db.kv 命名空间。它提供了完整的 API 集,支持空间隔离、全局共享、多种数据类型,以及链式复杂查询与过滤(如 db.kv.query().prefix(...).orderBy...().limit(...) 分页、排序、过期过滤等)。
基础存取 (Basic Access)
// 设置值 (支持 String, int, bool, double, Map, List 等)
await db.kv.set('key', 'value', ttl: Duration(hours: 1));

// 获取原始动态类型
dynamic val = await db.kv.get('key');

// 删除单个键
await db.kv.remove('key');
强类型获取 (Type-Safe Getters) 无需手动转换类型,直接获取目标格式数据:
String? name = await db.kv.getString('user_name');
int? age = await db.kv.getInt('user_age');
bool? isVip = await db.kv.getBool('is_vip');
Map<String, dynamic>? profile = await db.kv.getMap('profile');
List<String>? tags = await db.kv.getList<String>('tags');
批量操作 (Bulk Operations) 在单个操作中高效地处理多个键值对:
// 批量设置
await db.kv.setMany({
  'theme': 'dark',
  'language': 'zh_CN',
});

// 批量删除
await db.kv.removeKeys(['temp_1', 'temp_2']);
原子计数器 (Atomic Increment) 在高并发场景下安全地递增或递减数值:
// 自增 1 (默认值)
await db.kv.setIncrement('view_count');
// 自减 5 (传入负数实现递减)
await db.kv.setIncrement('stock_count', amount: -5);
链式查询记录 (db.kv.query) 类似
db.query()的链式 API,用于查询键值记录(含解码后的value),并支持分页。// 首页:按前缀过滤,按更新时间倒序,每页 20 条 final page = await db.kv.query() .prefix('setting_') .orderByUpdatedAtDesc() // 或 orderByKeyAsc / orderByKeyDesc / orderByUpdatedAtAsc .limit(20); for (final record in page.data) { // record 含: key, value, updated_at, expires_at print('${record['key']} = ${record['value']}'); } // 推荐:用 next() / prev() 翻页(与表查询一致,最简便) if (page.hasMore) { final page2 = await page.next(); print('下一页: ${page2.data.length}'); if (page2.hasPrev) { final back = await page2.prev(); print('上一页: ${back.data.length}'); } } // Offset 分页(与 cursor 互斥;深度翻页更推荐上面的 next()) final byOffset = await db.kv.query() .orderByKeyAsc() .limit(20) .offset(20); // 匹配条件的记录总数(无 prefix 时为 O(1) 元数据统计) final total = await db.kv.query().prefix('setting_').count(); // 取第一条匹配记录 final first = await db.kv.query().prefix('setting_').orderByKeyAsc().first(); // 全局 KV 空间 final globalPage = await db.kv.query(isGlobal: true).limit(50); // 默认会过滤已过期记录;需要包含未清理的过期项时: final withExpired = await db.kv.query() .includeExpired() .limit(20);常用链式方法:
方法 说明 prefix(String)按 key 前缀过滤 orderByKeyAsc/orderByKeyDesc按 key(主键)排序 orderByUpdatedAtAsc/orderByUpdatedAtDesc按 updated_at排序limit(n)本页最大条数(建议始终显式指定) offset(n)偏移分页(会清除 cursor) cursor(token)仅特殊场景:跨进程/网络传入分页 Token includeExpired([true])是否包含已过期但尚未清理的记录 count()统计匹配条数 first()返回第一条记录(不影响原 builder 的 limit) 查询结果
QueryResult:日常翻页用hasMore/hasPrev+next()/prev();nextCursorToken/prevCursorToken仅用于跨端传输等特殊场景(用法与表查询一致)。键名枚举与空间管理 (Discovery & Management)
// 仅枚举 key 名(不含 value);可选 prefix / limit / offset
final keys = await db.kv.getKeys(prefix: 'setting_');
final pageKeys = await db.kv.getKeys(
  prefix: 'setting_',
  limit: 100,
  offset: 0,
);

// 统计当前空间内的键值对总数
final count = await db.kv.count();

// 检查某个键是否存在且未过期
final exists = await db.kv.exists('config_cache');

// 内存探针(同步、仅内存命中 — 详见 [内存探针与同步检索 (peek)](#query-peek))
final theme = db.kv.peekGet('theme') ?? await db.kv.get('theme');
if (db.kv.peekExists('config_cache')) { /* ... */ }

// 清空当前空间的所有 KV 数据
await db.kv.clear();
生命周期管理 (TTL) 获取或动态更新现有键的过期时间:
// 获取剩余过期时长
Duration? ttl = await db.kv.getTtl('token');

// 为现有键更新过期时间(7天后过期)
await db.kv.setTtl('token', Duration(days: 7));
响应式监听 (Reactive Watch)
// 监听单个键
db.kv.watch<int>('unread_count').listen((count) => print(count));

// 监听多个键的变化快照
db.kv.watchValues(['theme', 'font_size']).listen((map) => print(map));
全局共享参数 (isGlobal) 以上所有方法均支持可选参数
isGlobal:true表示在全局空间操作(跨 Space 共享),false(默认)表示在当前隔离空间操作。
批量操作 (Bulk Operations)
ToStore 针对大规模数据吞吐提供了专门的批量处理接口。这些接口内置了并行任务分发与时间切片调度机制,在执行高吞吐写入时能有效降低对 UI 主线程的影响。
| 接口 | 核心用途 | 数据要求 | 特点 |
|---|---|---|---|
batchInsert |
批量插入新记录 | 必须包含所有非空字段 | 纯插入,效率最高 |
batchUpsert |
批量同步(插入或更新) | 必须包含所有非空字段 | 全量同步,基于主键或唯一字段自动判断 |
batchUpdate |
批量局部更新 | 主键或唯一字段 + 待更新字段 | 增量更新,专门用于修改已有记录 |
批量插入 (batchInsert)
await db.batchInsert('users', [
  {'username': 'user1', 'email': '[email protected]'},
  {'username': 'user2', 'email': '[email protected]'},
]);
智能批量同步 (batchUpsert) 基于主键或唯一字段自动识别“插入”或“更新”。常用于数据全量同步场景。
[!IMPORTANT] 数据要求:由于可能触发插入操作,
batchUpsert要求每条记录必须包含所有非空(nullable: false)字段。高效批量更新 (batchUpdate) 专门用于更新已有记录。每条记录需包含主键或唯一字段作为标识,以及需要修改的字段。
[!TIP] 局部更新:
batchUpdate仅更新提供的字段,不需要包含所有非空字段,适合增量修改场景。await db.batchUpdate('users', [ {'username': 'john', 'age': 27}, // 通过唯一字段 username 定位并更新 age {'id': '1002', 'status': 'active'}, // 也支持直接指定主键 ]);
[!TIP] 可以设置
allowPartialErrors: true来确保个别数据错误不会拒绝本次批量操作。
数据写入恢复保障 (Recovery Durability)
ToStore 支持在数据操作返回响应结果时,灵活控制写入数据所具备的崩溃自愈恢复能力级别:
| 级别 | 响应时恢复保障 | 适用场景与特性 |
|---|---|---|
RecoveryDurability.standard(默认推荐) |
返回前具备防崩溃自愈能力 | 抵御应用闪退、未捕获异常及系统 OOM 强杀。兼顾极高吞吐与日常业务安全。 |
RecoveryDurability.durable |
返回前具备防断电自愈能力 | 强制物理落盘,即使设备突发断电、内核宕机亦可完整自愈恢复。适用于关键交易等严苛场景。 |
RecoveryDurability.async |
极速吞吐(返回后异步保存) | 内存入队后立即返回响应结果;在返回响应结果后,小数据量下多数仅存在几毫秒极其短暂的数据丢失窗口期。适用于海量非核心数据。 |
1. 全局默认配置
在初始化数据库时,通过 DataStoreConfig 配置当前实例的默认恢复保障级别:
final db = await ToStore.open(
  config: DataStoreConfig(
    defaultRecoveryDurability: RecoveryDurability.standard, // 默认配置,返回前具备防闪退强杀能力
  ),
);
2. 单操作级灵活覆盖
所有结构化表写入、批量操作、链式更新/删除,以及键值对 (KV) 存储,均支持通过可选参数 durability 单独指定:
// 1. 结构化表操作覆盖
await db.insert('orders', orderData, durability: RecoveryDurability.durable); // 核心订单:防断电恢复
await db.batchInsert('logs', logList, durability: RecoveryDurability.async); // 海量日志:极速异步

// 2. 链式更新与删除覆盖
await db.update('users', {'status': 'active'})
  .where('id', '=', userId)
  .durability(RecoveryDurability.durable);

// 3. 键值对存储 (KV) 覆盖
await db.setValue('token', tokenVal, durability: RecoveryDurability.standard);
await db.kv.set('session_id', 'xyz', durability: RecoveryDurability.async);
await db.kv.setMany(settingsMap, durability: RecoveryDurability.durable);
向量、文本与混合检索
词法文本检索、稠密向量检索、神经稀疏检索走同一查询链(matchText / matchVector / matchSparse):可与结构化条件同链组合,也可多路融合;分数与通道诊断在 QueryResult.retrieval 中返回,与 data 行一一对应。若只需主键与评分,请优先 .select(['id'])(或你的主键字段名),引擎会跳过表侧完整行物化;否则混合检索会回表加载整行(含大体积 embedding),吞吐量可能大幅下降。纯 ANN、无需过滤/融合时,也可用顶层 db.vectorSearch(...),直接返回 List<VectorSearchResult>(主键 + 评分),核心检索路径相同。
检索可见性:插入/更新返回成功后,普通索引、文本索引与稀疏索引即可参与检索;向量索引为避免捆绑构建影响吞吐量,并不会立刻可搜。需要参与检索时,可在业务批量结束后执行 await db.flush()(可选便利),完成后才会进入 matchVector / vectorSearch。
await db.createTables([
  const TableSchema(
    name: 'documents',
    primaryKeyConfig: PrimaryKeyConfig(
      name: 'id',
      type: PrimaryKeyType.timestampBased,
    ),
    fields: [
      FieldSchema(name: 'content', type: DataType.text, nullable: false),
      FieldSchema(
        name: 'category',
        type: DataType.text,
        nullable: false,
        createIndex: true,
      ),
      FieldSchema(
        name: 'features',
        type: DataType.sparse, // 神经稀疏向量
        nullable: false,
      ),
      FieldSchema(
        name: 'embedding',
        type: DataType.vector, // 稠密向量
        nullable: false,
        vectorConfig: VectorFieldConfig(
          dimensions: 128, // 写入与查询向量长度必须一致
        ),
      ),
    ],
    indexes: [
      IndexSchema(fields: ['content'], type: IndexType.text), // 词法文本索引
      IndexSchema(fields: ['features'], type: IndexType.sparse), // 神经稀疏索引
      IndexSchema(
        fields: ['embedding'],
        type: IndexType.vector, // 稠密向量索引
        vectorConfig: VectorIndexConfig(
          indexType: VectorIndexType.ngh, // NGH:ToStore 自研稠密索引
          distanceMetric: VectorDistanceMetric.cosine,
        ),
      ),
    ],
  ),
]);

final queryVector =
    VectorData.fromList(List.generate(128, (i) => i * 0.01));
final querySparse = SparseVectorData.fromMap({12: 0.8, 45: 0.6, 90: 0.3});

// 1) 词法文本检索(TextQuery.text引擎自动分词;也可用预分词 TextQuery.terms / termsWeighted)
final textHits = await db
    .query('documents')
    .select(['id'])
    .matchText('content', TextQuery.text('分布式 存储 内核'))
    .limit(5);

// 2) 神经稀疏检索
final sparseHits = await db
    .query('documents')
    .select(['id'])
    .matchSparse('features', querySparse, minScore: 0.30)
    .limit(5);

// 3) 稠密向量近邻(默认 searchDepth = 50)
final result = await db
    .query('documents')
    .select(['id'])
    .matchVector('embedding', queryVector, minScore: 0.40)
    .limit(5);

for (var i = 0; i < result.data.length; i++) {
  final record = result.data[i];
  final entry = result.retrieval?.entries[i];
  print('pk=${record['id']}, score=${entry?.score}, '
      'rawScore=${entry?.rawScore}, distance=${entry?.meta?['distance']}');
}

// 4) 结构化过滤 + 向量(AND)
final filtered = await db
    .query('documents')
    .whereEqual('category', 'tech')
    .matchVector('embedding', queryVector, minScore: 0.40)
    .limit(5);

// 5) 多路融合:文本 + 稀疏 + 向量(默认 weightedScore)
final fused = await db
    .query('documents')
    .matchText('content', TextQuery.text('分布式 存储'), weight: 0.4)
    .matchSparse('features', querySparse, weight: 0.3, minScore: 0.20)
    .matchVector('embedding', queryVector, weight: 0.6, minScore: 0.40)
    .limit(10);
print('fusion=${fused.retrieval?.fusionMethod}'); // weightedScore

// 切换为排名融合(相对分,不适用绝对相关度门槛)
final fusedRrf = await db
    .query('documents')
    .matchText('content', TextQuery.text('分布式 存储'), weight: 0.4)
    .matchVector('embedding', queryVector, weight: 0.6, minScore: 0.40)
    .fusionMethod(RetrievalFusionMethod.rrf)
    .limit(10);
print('fusion=${fusedRrf.retrieval?.fusionMethod}'); // rrf

// 顶层专用 ANN(仅主键 + 评分,无查询链 / 融合)
final ann = await db.vectorSearch(
  'documents',
  fieldName: 'embedding',
  queryVector: queryVector,
  topK: 5,
  minScore: 0.40,
);
通道与表结构对照:
| 通道 | 字段类型 | 索引 | 查询 API | 查询值 |
|---|---|---|---|---|
| 词法文本 | DataType.text |
IndexType.text |
matchText / orMatchText |
TextQuery.text / terms / termsWeighted |
| 神经稀疏 | DataType.sparse |
IndexType.sparse |
matchSparse / orMatchSparse |
SparseVectorData |
| 稠密向量 | DataType.vector |
IndexType.vector |
matchVector / orMatchVector |
VectorData 等 |
稠密向量配置(VectorFieldConfig、VectorIndexConfig):
dimensions:向量维度,必须与实际写入的 embedding 长度一致。indexType:稠密向量算法标识;当前为ngh。distanceMetric:索引侧相似度度量(构建与检索共用);cosine常用于语义 embedding,l2适合欧氏距离场景,innerProduct适合点积检索。数据写入后若修改通常需要重建向量索引。
链式检索参数(各 match* / orMatch*,以及查询链上的 limit):
- 文本
TextQuery.text:原始查询文本(由引擎分词)TextQuery.terms/termsWeighted:预分词,自行传入词项(可选权重);拉丁词需与索引侧一致(一般为小写)operator:or(默认,命中任一词项)或and(须命中全部词项后再排序)- 不支持短语匹配
- 稀疏
SparseVectorData/SparseVectorData.fromMap(...):稀疏查询向量- 文档侧权重建议落在
(0, 1]
- 向量
field/vector:目标字段与查询向量searchDepth:>= 1,默认50;越大通常召回越高、耗时也越大;近似最近邻,不保证 recall@KdistanceThreshold:距离上限
- 共用
weight:多路融合权重,默认1.0minScore:相关度下限limit:返回条数(topK).fusionMethod(...):多路默认weightedScore,可切rrf
结果与评分说明(QueryResult / VectorSearchResult):
- 业务行在
data;检索分数与通道信息在retrieval.entries,与data一一对应。若只需主键与评分,优先.select(['id'])。 score(归一化相关度评分,0.0 ~ 1.0):文本 / 稀疏 / 向量统一的相关度(越大越相关)。向量精确自匹配为1.0。用minScore保留强命中、过滤弱命中。默认多路weightedScore融合会保留强单路命中;文本与稀疏保持在[0.0, 1.0)。rawScore:通道未归一化的物理量(余弦 / 点积 / L2 / 文本强度)。需要底层度量时读rawScore/distance。entry.meta['distance']:向量通道的 ANN 距离(越小越近)。retrieval.fusionMethod:单通道为null;多路默认weightedScore(可通过.fusionMethod(RetrievalFusionMethod.rrf)切换)。- 顶层
db.vectorSearch(...)返回List<VectorSearchResult>(primaryKey/score/rawScore/distance),适用于专用 ANN。可选minScore与matchVector使用同一相关度下限(结果条数可能少于topK)。
相关度评分(score)与门槛参考基线(单通道与多路 weightedScore;不适用于 rrf)。适用于常见 embedding 宽度(维度 ≥ 128);更低维时弱邻居也可能得高分,请酌情提高 minScore 或改用 rawScore:
相关度评分(score) |
基线含义与典型场景 |
|---|---|
>= 0.85 |
同实体匹配(人脸核验、生物特征、精确去重) |
>= 0.70 |
高置信语义匹配(核心事实、精确问答) |
>= 0.40 |
基础语义相关(通用 RAG、知识库防幻觉) |
>= 0.30 |
宽召回初筛(模糊发现、重排候选池) |
< 0.30 |
弱关联或背景噪声 |
按需配置通道 minScore 过滤低相关度评分命中。
表级 TTL(按时间自动过期清理)
对于日志、埋点、时序等按时间淘汰的数据,可以在表结构中通过 ttlConfig 定义表级 TTL,到期数据将由引擎在后台自动清理,无需业务端手动清理维护:
const TableSchema(
  name: 'event_logs',
  fields: [
    FieldSchema(
      name: 'created_at',
      type: DataType.datetime,
      nullable: false,
      createIndex: true,
      defaultValueType: DefaultValueType.currentTimestamp,
    ),
  ],
  ttlConfig: TableTtlConfig(
    ttlMs: 7 * 24 * 60 * 60 * 1000, // 保留 7 天
    // 新建表 / 首次启用 TTL 时必填:
    // 1)DataType.datetime
    // 2)nullable: false
    // 3)DefaultValueType.currentTimestamp
    sourceField: 'created_at',
  ),
);
容量淘汰(FIFO / LRU)
按条数和/或大致占用限制表内保留的数据量,可与表级 TTL 同时启用;超出上限后后台自动淘汰。
// FIFO(默认):按主键从旧到新淘汰;不要设置 sourceField(主键类型为 PrimaryKeyType.none 时除外)
capacityConfig: CapacityConfig(
  maxEntries: 10000,
  // maxBytes: 50 * 1024 * 1024, // 可选:按大致体积限制
  policy: CapacityEvictionPolicy.fifo,
),

// LRU:必须指定 sourceField(datetime、非空、currentTimestamp);
// 记录被再次使用时应更新该字段
capacityConfig: CapacityConfig(
  maxEntries: 10000,
  policy: CapacityEvictionPolicy.lru,
  sourceField: 'last_active_at',
),
maxEntries/maxBytes至少设置一个。- FIFO 且主键类型为
PrimaryKeyType.none时,同样需要sourceField(规则同上)。
对已有表,也可在运行时启用、调整或关闭容量淘汰(无需重开数据库):
// 启用 / 调整容量淘汰
await db.updateSchema('recent_events').setCapacityConfig(
  CapacityConfig(
    maxEntries: 10000,
    policy: CapacityEvictionPolicy.lru,
    sourceField: 'last_active_at',
  ),
);

// 关闭容量淘汰(保留现有数据,之后不再按容量删除)
await db.updateSchema('recent_events').disableCapacity();
KV 的容量上限在打开数据库时通过 DataStoreConfig 配置(不是每次 kv.set 单独传参):
kvCapacityConfig:限制当前空间的 KV 键数量 / 大致体积globalKvCapacityConfig:限制全局 KV- 参数形态与表级
CapacityConfig相同,但不要设置sourceField
final db = await ToStore.open(
  dbPath: '...',
  config: DataStoreConfig(
    kvCapacityConfig: CapacityConfig(
      maxEntries: 5000,
      policy: CapacityEvictionPolicy.lru,
    ),
    globalKvCapacityConfig: CapacityConfig(
      maxEntries: 2000,
      policy: CapacityEvictionPolicy.fifo,
    ),
  ),
);
智能存储 (Upsert)
根据 data 中的主键或唯一字段判断:存在则更新,不存在则插入。不支持 where,冲突目标由 data 决定。
// 按主键
final result = await db.upsert('users', {
  'id': 1,
  'username': 'john',
  'email': '[email protected]',
});

// 按唯一键(记录须包含参与唯一约束的所有字段及必填字段)
await db.upsert('users', {
  'username': 'john',
  'email': '[email protected]',
  'age': 26,
});

// 批量 upsert (支持原子性或部分成功模式)
// allowPartialErrors: true 表示允许部分失败(如某条记录因唯一性约束冲突,其他记录仍会正常处理)
final batchResult = await db.batchUpsert('users', [
  {'username': 'a', 'email': '[email protected]'},
  {'username': 'b', 'email': '[email protected]'},
], allowPartialErrors: true);
高级查询
ToStore 提供声明式的链式查询 API,支持灵活的字段处理与复杂的多表关联。
1. 字段选择 (select)
select 方法用于指定返回的字段列表。若不调用,默认返回全表字段。
- 字段别名 (Alias):支持
field as alias语法(不区分大小写),重命名结果集中的 Key。 - 表名限定:在多表关联时,使用
table.field格式可以明确指定字段归属,避免命名冲突。 - 聚合混用:可以在列表中直接传入
Agg聚合对象。
final results = await db.query('orders')
    .select([
      'orders.id',                       // 指定表名的字段
      'users.name as customer_name',     // 字段别名:结果集中 Key 将变为 customer_name
      'orders.amount',
      Agg.count('id', alias: 'total_items') // 可以在 select 中混入聚合统计
    ])
    .join('users', 'orders.user_id', '=', 'users.id')
    .where('orders.amount', '>', 1000)
    .limit(20);
2. 表连接 (join)
支持标准的 join (Inner Join)、leftJoin 和 rightJoin。
3. 基于外键的智能关联 (推荐)
如果您在 TableSchema 中正确定义了 foreignKeys,则无需手动编写连接条件。引擎会自动解析引用关系并生成最优的 JOIN 路径。
joinReferencedTable(tableName):自动连接“当前表引用”的父表。joinReferencingTable(tableName):自动连接“引用当前表”的子表。
// 假设 posts 表定义了指向 users 的外键
final posts = await db.query('posts')
    .joinReferencedTable('users') // 自动识别为 ON posts.user_id = users.id
    .select(['posts.title', 'users.username'])
    .limit(20);
数据聚合、分组与统计 (Agg & GroupBy)
1. 聚合计算 (Agg 工厂类)
聚合函数用于对数据集执行统计计算。配合 alias 参数,您可以自定义结果集中的字段名。
| 方法 | 功能 | 示例 |
|---|---|---|
Agg.count(field) |
统计非空记录数 | Agg.count('id', alias: 'total') |
Agg.sum(field) |
求和 | Agg.sum('amount', alias: 'total_price') |
Agg.avg(field) |
平均值 | Agg.avg('score', alias: 'average_score') |
Agg.max(field) |
最大值 | Agg.max('age') |
Agg.min(field) |
最小值 | Agg.min('price') |
[!TIP] 聚合统计的两种用法:
- 快捷统计方法 (推荐用于单一统计):直接在链式查询上调用,同步返回计算值。
num? totalAge = await db.query('users').sum('age');select嵌入模式 (用于多项统计或与分组配合):在select列表中传入Agg对象。final stats = await db.query('orders').select(['status', Agg.sum('amount')]).groupBy(['status']);
2. 分组统计与过滤 (groupBy / having)
使用 groupBy 对数据进行分类,结合 having 对聚合后的结果进行二次过滤(类似于 SQL 的 HAVING 触发场景)。
final stats = await db.query('orders')
    .select([
      'status',
      Agg.sum('amount', alias: 'sum_amount'),
      Agg.count('id', alias: 'order_count')
    ])
    .groupBy(['status'])
    // having 接受一个 QueryCondition,用于过滤聚合结果
    .having(QueryCondition().where(Agg.sum('amount'), '>', 5000))
    .limit(10);
3. 辅助查询方法
exists()(高性能):检查是否存在符合条件的记录。相比count() > 0,它在底层采用“短路”机制,只要发现一条匹配即立即返回,对于海量数据校验性能极佳。count():高效返回符合条件的记录总数。first():便捷方法,相当于limit(1)并直接返回第一条数据的 Map。distinct([fields]):去重查询。若提供fields,则根据指定字段的唯一性进行去重。
// 高效存在性检查
if (await db.query('users').whereEqual('email', '[email protected]').exists()) {
  print('邮箱已注册');
}

// 获取去重后的城市列表
final cities = await db.query('users').distinct(['city']);
4. 复杂逻辑构造:QueryCondition
QueryCondition 是 ToStore 处理复杂“括号层级”查询(Nested Logic)的核心工具。当简单的 where 链接无法满足多层嵌套 (A AND B) OR (C AND D) 逻辑时,需要用到它。
condition(QueryCondition sub):开启一个 AND 括号层级。orCondition(QueryCondition sub):开启一个 OR 括号层级。or():改变下一个条件的连接方式为 OR(默认为 AND)。
示例 1:混合 OR 条件
实现 SQL: WHERE is_active = true AND (role = 'admin' OR fans >= 1000)
final subGroup = QueryCondition()
    .whereEqual('role', 'admin')
    .or()
    .whereGreaterThanOrEqualTo('fans', 1000);

final results = await db.query('users')
    .whereEqual('is_active', true)
    .condition(subGroup); // 以 AND 方式嵌入括号
示例 2:条件复用
您可以预先定义一些通用的业务逻辑片段,在不同查询中动态组合:
final hotUser = QueryCondition().whereGreaterThan('fans', 5000);
final recentLogin = QueryCondition().whereGreaterThan('last_login', '2024-01-01');

// 在任意查询中自由拼装
final targetUsers = await db.query('users')
    .condition(hotUser)
    .condition(recentLogin);
5. 流式查询 (Streaming)
适用于海量数据且不需要一次性加载到内存的场景,支持边查询边处理。
db.streamQuery('users').listen((data) {
  print('处理单条记录: $data');
});
6. 响应式查询 (Reactive Query)
watch() 方法允许您对查询结果进行实时监控。返回一个 Stream,每当被查询的表数据发生符合条件的变更时,它会自动重新查询并推送最新结果。
- 自动去抖 (Debounce):内置智能防抖,避免极短时间内触发多次无效查询。
- UI 同步:配合 Flutter 的
StreamBuilder轻松实现即时刷新的列表。
// 简单监听
db.query('users').whereEqual('is_online', true).watch().listen((users) {
  print('当前在线人数变动: ${users.length}');
});

// Flutter StreamBuilder 接入示例
// 数据变动时,会自动刷新局部UI
StreamBuilder<List<Map<String, dynamic>>>(
  stream: db.query('messages').orderByDesc('id').limit(50).watch(),
  builder: (context, snapshot) {
    if (snapshot.hasData) {
      return ListView.builder(
        itemCount: snapshot.data!.length,
        itemBuilder: (context, index) => MessageTile(snapshot.data![index]),
      );
    }
    return CircularProgressIndicator();
  },
)
手动查询结果缓存 (可选)
[!IMPORTANT] ToStore 内部已具备高效的 LRU 多层级智能缓存。 不推荐常规使用。需要自行手动维护缓存,仅建议在以下特殊场景下开启:
- 无索引的耗时大扫描,且数据不常变动。
- 对非热点查询有持续极端响应要求(如要求冷门数据也要保持 1ms 访问)。
useQueryCache([Duration? expiry]):开启缓存,可选设置过期时间。noQueryCache():显式禁用缓存(覆盖全局设置)。clearQueryCache():手动使该查询条件的缓存失效。
final results = await db.query('heavy_table')
    .where('non_indexed_field', '=', 'value')
    .useQueryCache(const Duration(minutes: 10)); // 仅针对重型查询手动提速
查询与高效分页
[!TIP] 显式指定
limit作为每页显示数量:强烈建议在查询时始终指定limit。如果省略,引擎默认限制为 1000 条记录以避免一次性查询过多数据。
ToStore 提供双模式分页支持。对于列表滚动或无限加载,极力推荐使用内置的无缝游标分页;对于特定页码跳转,使用基础分页即可:
1. 基础分页 (Offset Mode)
适用于数据量较小(如万级以下)或需要精确跳转特定页码的场景。
final result = await db.query('users')
    .orderByDesc('created_at')
    .offset(40) // 跳过前 40 条
    .limit(20); // 取 20 条
[!TIP] 当
offset非常大时,数据库需要扫描并丢弃大量记录,性能会线性下降。建议深度翻页或数据量较大时使用 Cursor 模式。
2. 游标分页 (Cursor Mode - 推荐)
适合海量数据和无限滚动场景。它通过记录当前页数据流的起始位置,在翻页时直接定位到该位置读取,避免了扫描和丢弃历史数据,使得深度翻页的速度始终恒定。
- 自动管理:设置 limit 每页显示数量,后续调用
next()或prev()即可获得极佳的分页性能,简单快捷。 - 起点定位:支持在首次查询时配合
.offset(N)定位起始窗口,后续直接调用next()即可获得下一页数据。
// 1. 发起初始查询
final page1 = await db.query('users')
    .orderByDesc('id')
    .limit(20);

// 2. 获取下一页
if (page1.hasMore) {
  final page2 = await page1.next();
  print('下一页数据数量: ${page2.data.length}');

  // 3. 获取上一页
  if (page2.hasPrev) {
    final prevPage = await page2.prev();
    print('返回上一页的数据: ${prevPage.data}');
  }
}
高级场景:无状态令牌分页 (Token-based Cursor)
日常 App 内翻页请优先使用上方的 next() / prev()。仅在前后端分离、跨进程或需经网络序列化分页状态时,才使用游标 Token:
- 首次查询返回
nextCursorToken/prevCursorToken字符串。 - 下次查询通过
.cursor(token)传入 Token 进行 seek。 - 注意:
cursor与offset互斥;调用其一会清除另一个。
// 首次查询(例如在 API 服务端)
final page1 = await db.query('users')
    .orderByDesc('id')
    .limit(20);

final String? nextToken = page1.nextCursorToken; // 序列化此 Token 返回给客户端

// 客户端带上 Token 请求下一页时:
if (nextToken != null) {
  final page2 = await db.query('users')
      .orderByDesc('id')
      .limit(20)
      .cursor(nextToken); // 传入 Token,引擎将精确定位读取
}
| 特性 | Offset 模式 | Cursor 模式 |
|---|---|---|
| 查询性能 | 随页数增加而下降 | 深度翻页时始终恒定 |
| 适用范围 | 少量数据、精确页码跳转 | 海量数据、无限滚动 |
| 数据一致性 | 数据变动导致跳行/重复行 | 避免数据变动导致的重复或遗漏 |
内存探针与同步检索 (peek)
对吞吐和延迟有极端要求的场景,ToStore 提供 peek 纯同步内存检索系列,直接在进程内即可抗住爆发热点读流量:边缘端可承接百万级读请求,服务端更强硬件下单机可达千万级(详见 基准测试)。
[!NOTE] 仅从内存缓存检索:
peek属零调度纯内存旁路,未命中立即返回空/null,引擎不做同步文件 I/O(避免高并发下阻塞事件循环);需要完整持久化结果时由业务自行await query()回退。
peek系列方法
| 方法 | 返回类型 | 功能说明 |
|---|---|---|
peekFirst() |
Map<String, dynamic>? |
单条记录,未命中立即返回 null |
peek() |
QueryResult<T> |
返回 QueryResult(data 列表及 hasMore、游标等分页信息),仅内存命中时有数据 |
peekExists() |
bool |
同步检查内存缓存中是否存在匹配记录 |
peekCount() |
int |
同步统计内存缓存中的匹配记录数量 |
result.peekNext() |
QueryResult<T> |
分页缓存命中时的同步下一页翻页 |
result.peekPrev() |
QueryResult<T> |
分页缓存命中时的同步上一页翻页 |
最佳实践:内存探针优先 (Peek-Through)
// 单条探针:先走内存探针(极速削峰),未命中回退标准异步读盘
final q = db.query('users').where('id', '=', userId);
final user = q.peekFirst() ?? await q.first();

// 分页探针查询
final listQ = db.query('users').orderByDesc('id').limit(20);
var page = listQ.peek();
if (page.data.isEmpty) page = await listQ;

if (page.hasMore) {
  final next = page.peekNext(); // 缓存命中,同步翻页
  if (next.data.isEmpty) await page.next();
}
KV 探针 (db.kv)
| 方法 | 异步对应 | 说明 |
|---|---|---|
peekGet(key) |
get(key) |
同步内存点查;过期键返回 null |
peekExists(key) |
exists(key) |
同步内存存在性检查 |
db.kv.query().peek() |
await db.kv.query() |
分页列表同步探针(前缀 / 排序 / limit) |
db.kv.query().peekFirst() |
await db.kv.query().first() |
首条记录同步探针 |
// 点查:先探针,未命中再异步回退
final theme = db.kv.peekGet('theme', isGlobal: true) ?? await db.kv.get('theme', isGlobal: true);

// 分页 KV 探针
var page = db.kv.query().prefix('setting_').limit(20).peek();
if (page.data.isEmpty) page = await db.kv.query().prefix('setting_').limit(20);
[!TIP] 建议:标准异步查询(
await query())通过事件调度保障系统长效稳定与多任务公平,十万级 QPS 已完全满足绝大多数业务;peek系列则专为单机突破百万/千万级极端热点读削峰设计。
外键与级联约束
使用外键约束可以保证引用完整性,并配置级联更新、级联删除等行为。外键约束会在写入和更新时校验引用关系;如果启用了级联策略,关联记录变化时会同步处理引用数据,减少业务层手动维护的一致性逻辑。
await db.createTables([
  const TableSchema(
    name: 'users',
    primaryKeyConfig: PrimaryKeyConfig(name: 'id'),
    fields: [
      FieldSchema(name: 'username', type: DataType.text, nullable: false),
    ],
  ),
  TableSchema(
    name: 'posts',
    primaryKeyConfig: const PrimaryKeyConfig(name: 'id'),
    fields: [
      const FieldSchema(name: 'title', type: DataType.text, nullable: false),
      const FieldSchema(name: 'user_id', type: DataType.integer, nullable: false),
      const FieldSchema(name: 'content', type: DataType.text),
    ],
    foreignKeys: [
        ForeignKeySchema(
          name: 'fk_posts_user',
          fields: ['user_id'],              // 当前表的字段
          referencedTable: 'users',         // 引用的表
          referencedFields: ['id'],         // 引用的字段
          onDelete: ForeignKeyCascadeAction.cascade,  // 删除时级联删除,users表的记录删除后会自动删除posts表的数据
          onUpdate: ForeignKeyCascadeAction.cascade,  // 更新时级联更新
        ),
    ],
  ),
]);
查询操作符
所有 where(field, operator, value) 条件支持以下操作符(大小写不敏感):
| 操作符 | 说明 | 示例 / 性能 |
|---|---|---|
= |
等于 | where('status', '=', 'val') — [推荐] 索引 Seek |
!=, <> |
不等于 | where('role', '!=', 'val') — [注意] 全表扫描 |
> , >=, <, <= |
范围比较 | where('age', '>', 18) — [推荐] 索引 Scan |
IN |
包含 | where('id', 'IN', [...]) — [推荐] 索引 Seek |
NOT IN |
不包含 | where('status', 'NOT IN', [...]) — [注意] 全表扫描 |
BETWEEN |
范围 | where('age', 'BETWEEN', [18, 65]) — [推荐] 索引 Scan |
LIKE |
模式匹配 (% 匹配任意字符,_ 匹配单字符) |
where('name', 'LIKE', 'John%') — [注意] 见下文说明 |
NOT LIKE |
模式不匹配 | where('email', 'NOT LIKE', '...') — [注意] 全表扫描 |
IS |
为 null | where('deleted_at', 'IS', null) — [推荐] 索引 Seek |
IS NOT |
不为 null | where('email', 'IS NOT', null) — [注意] 全表扫描 |
语义化查询方法(推荐)
推荐使用语义化方法,避免手写操作符字符串并便于 IDE 提示:
1. 比较 (Comparison)
用于数值或字符串的直接比较关系。
db.query('users').whereEqual('username', 'John');           // 等于
db.query('users').whereNotEqual('role', 'guest');          // 不等于
db.query('users').whereGreaterThan('age', 18);             // 大于
db.query('users').whereGreaterThanOrEqualTo('score', 60);  // 大于等于
db.query('users').whereLessThan('price', 100);             // 小于
db.query('users').whereLessThanOrEqualTo('quantity', 10);  // 小于等于
db.query('users').whereTrue('is_active');                  // 为真 (true)
db.query('users').whereFalse('is_banned');                 // 为假 (false)
2. 集合与范围 (Collection & Range)
用于判断字段值是否落入指定的容器或区间。
db.query('users').whereIn('id', ['id1', 'id2']);           // 在列表中
db.query('users').whereNotIn('status', ['banned', 'pending']); // 不在列表中
db.query('users').whereBetween('age', 18, 65);             // 在范围内 (含边界)
3. 空值判断 (Null Check)
用于筛选字段是否存在值。
db.query('users').whereNull('deleted_at');               // 为空 (IS NULL)
db.query('users').whereNotNull('email');                 // 不为空 (IS NOT NULL)
db.query('users').whereEmpty('nickname');                // 为空或空字符串
db.query('users').whereNotEmpty('bio');                  // 不为空且不为双空
4. 模式匹配 (Pattern Matching)
支持 SQL 风格的通配符搜索(% 匹配任意字符,_ 匹配单个字符)。
db.query('users').whereLike('name', 'John%');             // SQL 风格匹配
db.query('users').whereContains('bio', 'flutter');   // 包含匹配 (LIKE '%value%')
db.query('users').whereStartsWith('name', 'Admin');  // 前缀匹配 (LIKE 'value%')
db.query('users').whereEndsWith('email', '.com');    // 后缀匹配 (LIKE '%value')
db.query('users').whereContainsAny('tags', ['dart', 'flutter']); // 模糊匹配列表中任意项
// 等价于:.where('age', '>', 18).where('name', 'like', '%John%')
final users = await db.query('users')
    .whereGreaterThan('age', 18)
    .whereLike('username', '%John%')
    .orderByDesc('age')
    .limit(20);
[!CAUTION] 查询性能指南 (Index vs Full-Scan)
在超大规模数据集(数百万级以上)场景下,为避免主线程卡顿和单次查询超时,请遵循以下原则:
索引友好 (Index Optimized - [推荐]):
- 语义化方法:
whereEqual、whereGreaterThan、whereLessThan、whereIn、whereBetween、whereNull、whereTrue、whereFalse、以及whereStartsWith(前缀匹配)。- 操作符:
=,>,<,>=,<=,IN,BETWEEN,IS null,LIKE 'prefix%'。- 说明:这些操作通过索引能够实现极速定位。对于
whereStartsWith/LIKE 'abc%',索引依然可以进行前缀范围扫描。触发全表扫描 (Full-Scan Risks - [慎重]):
- 模糊语义:
whereContains(LIKE '%val%')、whereEndsWith(LIKE '%val')、whereContainsAny。- 否定查询:
whereNotEqual(!=,<>)、whereNotIn(NOT IN)、whereNotNull(IS NOT null/whereNotEmpty)。- 模式不匹配:
NOT LIKE。- 说明:上述操作即使建立了索引,在大部分物理引擎下也需遍历整个数据存储区。在移动端及小规模数据场景影响不大,但在分布式/超大数据分析场景应尽量结合其它索引条件(如先通过 ID 或时间范围缩小数据量)以及limit使用。
分布式架构
// 配置分布式节点
final db = await ToStore.open(
  config: DataStoreConfig(
    distributedNodeConfig: const DistributedNodeConfig(
      enableDistributed: true,            // 启用分布式模式
      clusterId: 1,                       // 集群ID,配置集群归属
      centralServerUrl: 'https://127.0.0.1:8080',
      accessToken: 'b7628a4f9b4d269b98649129'
    )
  )
);

// 批量插入
await db.batchInsert('vector_data', [
  {'vector_name': 'face_2365', 'timestamp': DateTime.now()},
  {'vector_name': 'face_2366', 'timestamp': DateTime.now()},
  // ... 向量数据记录一次性高效插入
]);

// 流式处理大数据集
await for (final record in db.streamQuery('vector_data')
  .where('vector_name', '=', 'face_2366')
  .where('timestamp', '>=', DateTime.now().subtract(Duration(days: 30)))
  .stream) {
  // 逐条处理结果,避免一次性加载整批数据
  print(record);
}
主键类型示例
ToStore提供多种分布式主键算法,支持各种业务场景:
- 有序递增主键 (PrimaryKeyType.sequential):238978991
- 时间戳主键 (PrimaryKeyType.timestampBased):1306866018836946
- 日期前缀主键 (PrimaryKeyType.datePrefixed):20250530182215887631
- 短码主键 (PrimaryKeyType.shortCode):9eXrF0qeXZ
// 有序递增主键配置示例
await db.createTables([
  const TableSchema(
    name: 'users',
    primaryKeyConfig: PrimaryKeyConfig(
      type: PrimaryKeyType.sequential,           // 递增主键类型
      sequentialConfig: SequentialIdConfig(
        initialValue: 10000,                     // 起始值
        increment: 50,                           // 步长
        useRandomIncrement: true,                // 随机步长,隐藏业务量
      ),
    ),
    fields: [/* 字段定义 */]
  ),
]);
表达式原子操作
表达式系统提供类型安全的原子字段更新,所有计算在数据库层面原子执行,避免并发冲突:
// 简单增量:balance = balance + 100
await db.update('accounts', {
  'balance': Expr.field('balance') + Expr.value(100),
}).where('id', '=', accountId);

// 复杂计算:total = price * quantity + tax
await db.update('orders', {
  'total': Expr.field('price') * Expr.field('quantity') + Expr.field('tax'),
}).where('id', '=', orderId);

// 多层括号:finalPrice = ((price * quantity) + tax) * (1 - discount)
await db.update('orders', {
  'finalPrice': ((Expr.field('price') * Expr.field('quantity')) + Expr.field('tax')) *
                 (Expr.value(1) - Expr.field('discount')),
}).where('id', '=', orderId);

// 使用函数:price = min(price, maxPrice)
await db.update('products', {
  'price': Expr.min(Expr.field('price'), Expr.field('maxPrice')),
}).where('id', '=', productId);

// 时间戳:updatedAt = now()
await db.update('users', {
  'updatedAt': Expr.now(),
}).where('id', '=', userId);
条件判断(如 upsert 中区分更新/插入):使用 Expr.isUpdate() / Expr.isInsert() 配合 Expr.ifElse 或 Expr.when,使表达式仅在更新或仅在插入时执行:
// Upsert:更新时自增,插入时设为 1(插入分支用普通值即可,仅更新路径会求值表达式)
await db.upsert('counters', {
  'key': 'visits',
  'count': Expr.ifElse(
    Expr.isUpdate(),
    Expr.field('count') + Expr.value(1),
    1,  // 插入分支:字面量,insert 不会对其做表达式求值
  ),
});

// 使用 Expr.when(单分支,否则为 null)
await db.upsert('orders', {
  'id': orderId,
  'updatedAt': Expr.when(Expr.isUpdate(), Expr.now(), otherwise: Expr.now()),
});
事务操作
事务确保多个操作的原子性,要么全部成功,要么全部回滚,保证数据一致性:
事务特性:
- 多个操作要么全部成功,要么全部回滚,保证数据准确
- 崩溃后自动恢复未完成的操作
- 操作成功时数据已安全保存
// 基本事务 - 多个操作原子提交
final txResult = await db.transaction(() async {
  // 插入用户
  await db.insert('users', {
    'username': 'john',
    'email': '[email protected]',
    'fans': 100,
  });

  // 使用表达式原子更新
  await db.update('users', {
    'fans': Expr.field('fans') + Expr.value(50),
  }).where('username', '=', 'john');

  // 如果任何操作失败,所有更改都会自动回滚
});

if (!txResult.hasErrors) {
  print('事务提交成功');
} else {
  print('事务回滚,原因如下:');
  for (final status in txResult.statuses) {
    if (status.type != ResultType.success) {
      print(' - [${status.codeKey}] ${status.message}');
    }
  }
}

// 错误时自动回滚
final txResult2 = await db.transaction(() async {
  await db.insert('users', {
    'username': 'jane',
    'email': '[email protected]',
  });
  throw Exception('业务逻辑错误'); // 触发回滚
}, rollbackOnError: true);
管理与维护
接下来介绍数据库管理、诊断与维护相关的 API,方便在插件化开发、后台管理或运维场景下使用:
- 表维护 (Table Management)
createTable(schema):手动创建单张表。适合运行时按需建表或模块化加载场景。getTableSchema(tableName):获取已定义的表结构信息。常用于自动化校验或 UI 模型生成。getTableNames({isGlobal}):获取全局 schema 清单中的用户表名。可选isGlobal:true仅全局表,false仅非全局表,省略则全部。非全局表结构跨空间共享,仅数据按空间隔离。getTableInfo(tableName):获取表运行时统计(totalRecordCount、totalTableDataSizeBytes、totalIndexDataSizeBytes、indexCount、创建时间、是否全局表等)。clear(tableName):清空全表数据。此操作会重置数据,但会安全保留表结构、索引定义和内外键约束。dropTable(tableName):彻底销毁表。删除所有数据及对应的模式定义,不可撤销。
- 空间管理 (Space Management)
currentSpaceName:实时获取当前实例所处的活跃空间。listSpaces():获取当前数据库实例下所有已分配的空间列表。getSpaceInfo(useCache: true):查看当前空间的本地聚合统计(记录总数、表/索引数据体积)。useCache: false时可从元数据全量重算。deleteSpace(spaceName):销毁指定空间及其完整数据(default及当前活跃空间除外)。
- 实例元信息 (Instance Discovery)
config:查看当前实例最终生效的DataStoreConfig配置快照。instancePath:准确定位数据存储目录。getVersion()/setVersion(version):业务自定义版本控制。用于记录应用自身的数据库版本号(非引擎版本),方便业务进行手动逻辑迁移判定。
- 底线性维护 (Maintenance)
flush(mode: FlushMode.full):强制待写数据落盘。模式:recovery(最快,恢复日志仅写 OS 缓存,防应用中断、崩溃重启,断电可能丢数据)、recoveryDurable(恢复日志写物理文件,防断电)、full(默认;恢复日志 + 表数据 + 索引全量写物理文件)。deleteDatabase():全量清除。抹除当前实例的所有物理文件及其元数据,慎用。
- 一站式诊断 (Diagnostics)
db.status.memory():内存快照诊断。查看读写缓存命中率、索引页占用及整体堆内存分配。db.status.space()/db.status.table(tableName):空间与表的实时统计及健康状态。db.status.config():运行参数快照。db.status.migration(taskId):异步迁移进度实时跟踪。
final spaces = await db.listSpaces();
final tableNames = await db.getTableNames();
final spaceInfo = await db.getSpaceInfo(useCache: false);
final tableSchema = await db.getTableSchema('users');
final tableInfo = await db.getTableInfo('users');

print('spaces: $spaces');
print('tables: $tableNames');
print(spaceInfo.toJson());
print(tableSchema?.toJson());
print(tableInfo?.toJson());

await db.flush();

final memoryInfo = await db.status.memory();
final configInfo = await db.status.config();
print(memoryInfo.toJson());
print(configInfo.toJson());
备份与恢复
非常适用于单用户的本地导入导出、大规模数据离线迁移、系统故障回滚:
- 数据备份 (
backup)compress: 是否启用压缩。建议开启(默认 true),可显著减少文件体积。scope: 备份作用域控制:BackupScope.database: 备份整个数据库实例(含所有 Space 及全局表)。BackupScope.currentSpace: 仅备份当前活跃空间(不含全局表),适合单一数据。BackupScope.currentSpaceWithGlobal: 备份当前空间及其配套的全局表,适合单租户/单用户迁移。
- 数据恢复 (
restore)backupPath: 备份包物理路径。cleanupBeforeRestore: 恢复前是否先静默抹除当前相关数据,避免还原后出现逻辑混合错误(建议 true)。deleteAfterRestore: 恢复成功后自动删除备份源文件。
// 示例:导出当前用户完整数据包
final backupPath = await db.backup(
  compress: true,
  scope: BackupScope.currentSpaceWithGlobal,
);

// 示例:从数据包还原(并自动清理源文件)
final restored = await db.restore(
  backupPath,
  cleanupBeforeRestore: true,
  deleteAfterRestore: true,
);
状态码与错误处理
ToStore 引入了结构化的自动诊断体系,以保障在自动化运维、AI 智能体代理、自动化测试及客户端逻辑中精准捕获数据操作状态与异常。
[!NOTE] 统一诊断基石:无论是响应结果模型中的
statuses还是致命异常中的statuses,均统一基于结构化的ResultStatus体系,通用状态码规范,确保了数据诊断接口的高度一致性。
在 ToStore 的运维与数据处理中,存在以下两种错误与异常反馈渠道:
1. 响应结果模型(Result-based Response)
针对日常的插入、更新、删除、查询、事务以及运行时的表结构创建与更新等操作。这些操作即使在遭遇约束冲突、数据校验失败或参数错误时,也不会抛出异常中断数据操作。ToStore 采用 DbResult 或 QueryResult 包装返回结果,将所有诊断信息记录在状态列表中。这保证了普通业务逻辑的错误不会打断数据库的正常运作。
响应模型主要支持以下核心设计:
hasErrors:指示当前操作是否存在任何错误。在批量操作或事务中,只要包含至少一个错误,此属性即为true。statuses:包含本次操作的所有ResultStatus详细诊断列表。支持 1:1 的顺序匹配,对于批量操作非常友好。firstPrimaryKey:在单条插入/写入操作成功时,可快捷读取物理生成的主键,无需手动解析statuses。ResultType:细分状态类型枚举,支持便捷判断(如isBusinessError、isDeveloperError等)。
2. 异常抛出(Exception-based Throwing)
主要应对属于开发者失误或致命错误(如在 ToStore.open 初始化阶段发生的表结构规范校验失败、引擎版本不兼容、数据迁移时发现数据重大问题等)。在调试环境下,ToStore 会抛出 DbException 强制中断运行,提醒开发者纠正修复。
错误与异常处理示例
1. 单条写入操作的结果处理
final result = await db.insert('users', {
  'username': 'john',
  'email': '[email protected]',
});

if (result.hasErrors) {
  // 获取首个错误类型及其描述
  print('操作失败: [${result.firstType.codeKey}] ${result.message}');
} else {
  print('写入成功,主键为: ${result.firstPrimaryKey}');
}
2. 批量写入操作的精细化诊断
final batchResult = await db.batchInsert('users', [
  {'username': 'alice', 'email': '[email protected]'},
  {'username': 'bob', 'email': 'invalid-email-format'}, // 格式校验失败
]);

if (batchResult.hasErrors) {
  print('批量操作中存在部分失败:成功 ${batchResult.successCount},失败 ${batchResult.failedCount}');

  for (final status in batchResult.statuses) {
    final int idx = status.index;

    if (status is ConstraintStatus) {
      print('索引 [$idx] 约束冲突!表: ${status.tableName},字段: ${status.fields}');
    } else if (status is InvalidArgumentStatus) {
      print('索引 [$idx] 参数错误!参数名: ${status.parameterName},传入值: ${status.passedValue}');
    } else if (status.type != ResultType.success) {
      print('索引 [$idx] 发生错误: [${status.codeKey}] ${status.message}');
    }
  }
}
3. 致命错误与初始化异常捕获(DbException)
try {
  // 传入可能存在定义冲突或验证失败的 schemas 初始化数据库
  final db = await ToStore.open(schemas: appSchemas);
} on DbException catch (e) {
  print('❌ 致命数据库异常! 错误信息: \n${e.message}');

  // 遍历异常携带的详细状态列表以精确定位问题
  for (final status in e.statuses) {
    if (status is SchemaValidationStatus) {
      print('表结构校验失败! 表: ${status.tableName}, 字段: ${status.field}, 无效配置: ${status.wrongValue}');
    } else {
      print('错误诊断: [${status.codeKey}] ${status.message}');
    }
  }
}
具体的错误大类、叶子状态码、JSON 序列化格式规范以及字段对照,请参阅完整的:ToStore ResultStatus 自动诊断与状态解析规范。
日志回调与数据库诊断
ToStore 可以通过 ToStore.setLogConfig(...) 把数据库生命周期的日志统一回调给业务层。
onLog回调会收到所有通过当前enableLog与logLevel过滤后的日志记录LogRecord。- LogLevel.error:局部性发生错误,不影响正常运行。
- LogLevel.critical:全局性灾难级错误(如磁盘已满、内存不足、迁移重大失败等),需要人工介入解决,建议在此等级触发报警通知。
- 请在初始化之前调用
ToStore.setLogConfig(...),这样初始化和自动迁移阶段的日志也能被捕获。
  // 配置日志参数或回调
  ToStore.setLogConfig(
    enableLog: true,
    logLevel: debugMode ? LogLevel.debug : LogLevel.warn,
    logLabel: 'my_app_db', // 日志顶部浅灰标题,用于区分应用或数据库实例
    onLog: (log) {
      // 生产环境可以将 warn/error/critical 上报后端或日志平台
      // log.level 对应日志等级(LogLevel.debug, info, warn, error, critical)
      // log.message 对应处理后的日志文本
      // log.status 对应底层的 ResultStatus 诊断状态(包含 code 与 codeKey)
      if (!debugMode && (log.level == LogLevel.warn || log.level == LogLevel.error || log.level == LogLevel.critical)) {
        developer.log(log.message, name: 'my_app_db', time: log.timestamp);
      }
    },
  );

  final db = await ToStore.open();
安全配置
[!WARNING] 密钥管理
密钥 作用 如何变更 是否全量重写数据 encodingKey数据加密密钥 修改配置后重新 open是(耗时) encryptionKey安全密钥,保护 encodingKey运行时调用 db.rotateEncryptionKey否(快速) 请勿硬编码敏感密钥。若需与设备绑定,请将
encryptionKey存入系统 Keychain / Keystore / 安全芯片后再传入引擎。
final db = await ToStore.open(
  config: DataStoreConfig(
    encryptionConfig: EncryptionConfig(
      // 加密算法:none, xorObfuscation, chacha20Poly1305, aes256Gcm
      encryptionType: EncryptionType.chacha20Poly1305,

      // 数据加密密钥:加密表/索引/日志等数据;变更后引擎后台重写加密数据
      encodingKey: 'Your-Encoding-Key...',

      // 安全密钥:保护 encodingKey;可用 db.rotateEncryptionKey 在线轮换
      encryptionKey: 'Your-Secure-Encryption-Key...',

      // standard:加密范围涉及关键的表数据、B 树索引、日志载荷
      // full:全量加密,对整个引擎文件进行全方位加密
      encryptionScope: EncryptionScope.standard,
    ),
    // 启用崩溃恢复日志 (Write-Ahead Logging),默认开启
    enableJournal: true,
    // 事务提交时是否强制刷新数据到磁盘,如需降低同步刷新开销可设为 false(交由后台自动刷新)
    persistRecoveryOnCommit: true,
  ),
);
encodingKey 变更:在 EncryptionConfig 中设置新值并 open 即可,引擎检测到变更后会在后台自动迁移重写加密数据。
encryptionKey 轮换(安全合规定期更换):不重写数据,在线轮换。
// 若此前未显式配置 encryptionKey,可省略 oldKey
final result = await db.rotateEncryptionKey(newKey: 'new-secure-key');
// 或:await db.rotateEncryptionKey(oldKey: 'old-key', newKey: 'new-key');
if (result.hasErrors) {
  // 处理失败(如旧密钥不正确、encodingKey 迁移进行中)
  return;
}
// 成功:下次 ToStore.open 时传入当前最新 encryptionKey
价值级加密(ToCrypto)
上文的全库加密会加密所有表与索引数据,可能影响整体性能。若只需加密部分敏感字段,可使用 ToCrypto:与数据库解耦(无需 db 实例),在写入前或读取后自行对值进行编码/解码,密钥由应用完全管理。输出为 Base64,适合存入 JSON 或 TEXT 列。
- key(必填):
String或Uint8List。若非 32 字节,将用 SHA-256 派生为 32 字节。 - type(可选):加密类型 [ToCryptoType]: [ToCryptoType.chacha20Poly1305] 或 [ToCryptoType.aes256Gcm]。默认 [ToCryptoType.chacha20Poly1305]。不传则使用默认。
- aad(可选):附加认证数据,类型为
Uint8List。若在编码时传入,解码时必须传入相同字节(例如表名+字段名做上下文绑定);简单用法可不传。
const key = 'my-secret-key';
// 编码:明文 → Base64 密文(可存入 DB 或 JSON)
final cipher = ToCrypto.encode('sensitive data', key: key);
// 读取时解码
final plain = ToCrypto.decode(cipher, key: key);

// 可选:用 aad 绑定上下文(编码与解码须使用相同 aad)
final aad = Uint8List.fromList(utf8.encode('users:id_number'));
final cipher2 = ToCrypto.encode('secret', key: key, aad: aad);
final plain2 = ToCrypto.decode(cipher2, key: key, aad: aad);
高级配置详解 (DataStoreConfig)
[!TIP] 智能自适应 (Zero Config) ToStore 会自动感知运行平台、性能、内存总量及 I/O 特性自动优化各项参数(如并发度、分片大小、缓存预算等)。在 99% 的常见业务场景下,不需要手动微调
DataStoreConfig,直接默认开启即可获得当前平台的极佳性能。
| 参数 | 默认值 | 用途与建议 |
|---|---|---|
yieldDurationMs |
8ms | 【核心建议】 任务执行让步时长。8ms 契合 120fps/60fps 刷新率。它能确保在执行海量数据查询或迁移时,UI 线程依然能顺滑渲染,不掉帧。 |
maxQueryOffset |
10000 | 查询保护。当 offset 超过此阈值时将报错。这是为了防止由于深度分页导致的 pathological IO(深分页性能急剧退化)。 |
defaultQueryLimit |
1000 | 资源预检。当查询未指定 limit 时套用此默认值,防止开发者失误导致的一次性加载海量结果导致 OOM。 |
cacheMemoryBudgetMB |
(自动) | 内存精细化管理。各缓存总内存预算。引擎会根据此预算自动启用 LRU 回收。 |
enableJournal |
true | 崩溃自愈。开启后,遇到异常崩溃或断电,数据会在下次启动时自愈恢复。 |
defaultRecoveryDurability |
standard |
响应时恢复能力保障。定义数据操作在返回响应结果时所具备的自愈恢复级别: • standard(默认):返回响应结果前即具备防崩溃自愈能力。能抵御应用闪退、未捕获异常及进程被系统强杀(OOM),兼顾极高吞吐与日常安全。• durable:返回响应结果前即具备防断电自愈能力。数据强制物理落盘,即使突发断电、内核宕机亦可完整自愈恢复,适用于金融交易等核心场景。• async:极速吞吐。内存入队后立即返回响应结果并在后台触发保存;在返回响应结果后,小数据量下多数仅存在几毫秒极其短暂的数据丢失窗口期。 |
persistRecoveryOnCommit |
true | 强持久化保证。为 true 时,事务提交后会强制 Sync 到物理磁盘;为 false 则后台异步 Flush(极大提速,但极端崩溃下可能丢失极少量数据)。 |
ttlCleanupIntervalMs |
300000 | 全局 TTL 轮询。引擎后台会在非闲置时扫描过期数据的时间间隔(默认 5 分钟),调小后删除更及时,但开销稍大。 |
kvCapacityConfig |
null | 空间 KV 容量。对当前空间的 KV 做 FIFO/LRU 上限;不要设置 sourceField。详见容量淘汰。 |
globalKvCapacityConfig |
null | 全局 KV 容量。形态与 kvCapacityConfig 相同。 |
maxConcurrency |
(自动) | 并发算力控制。设置密集型任务(如向量计算、加解密)的最大并行线程数。通常推荐保持自动(基于核心数)。 |
final db = await ToStore.open(
  config: DataStoreConfig(
    yieldDurationMs: 8, // 对前端 UI 极其友好,后端建议调整50ms
    defaultQueryLimit: 50, // 强制限制查询最大结果集
    enableJournal: true, // 确保崩溃自愈
    defaultRecoveryDurability: RecoveryDurability.standard, // 响应前具备防闪退强杀自愈能力
  ),
);
性能与体验
基准测试
亮点——10 万条基准套件与十亿级边缘实测(3 轮,standard 持久性,2026-10-08):
| 指标 | 结果 |
|---|---|
| 冷启动 | 约 35 ms(与数据规模解耦) |
| PK Read(热缓存) | 454 万 ops/s |
| Batch Insert | 59 万 ops/s |
| Pagination(热缓存) | 58 万 ops/s |
| ANN @ depth 1(~91%) | 3.6 万 ops/s |
完整图表与全部操作项见 基准测试。
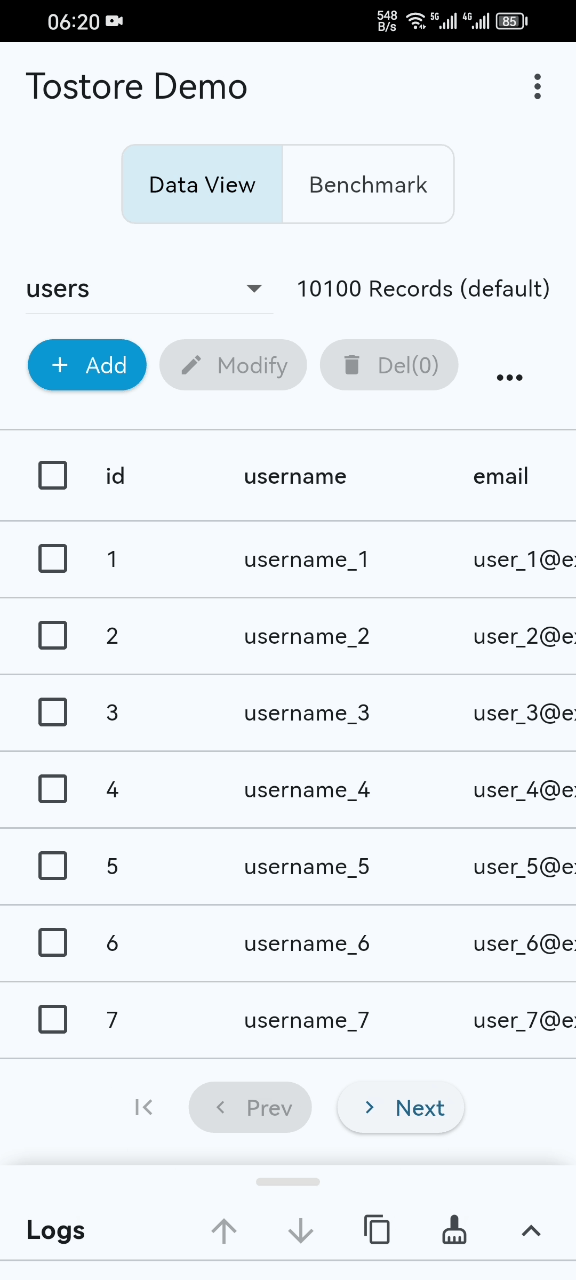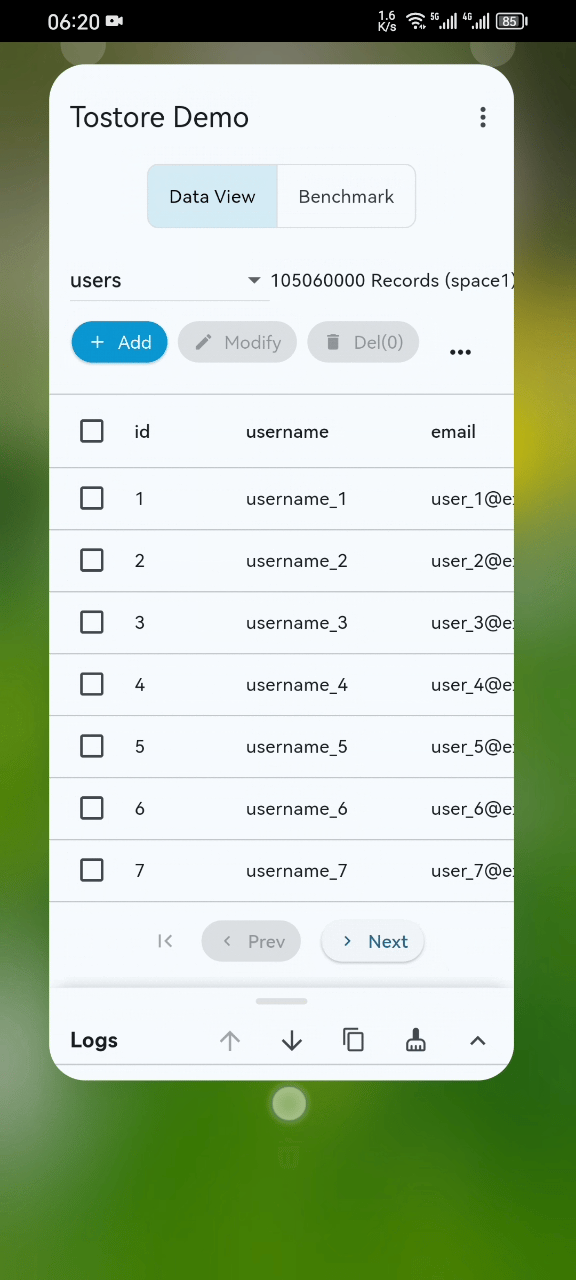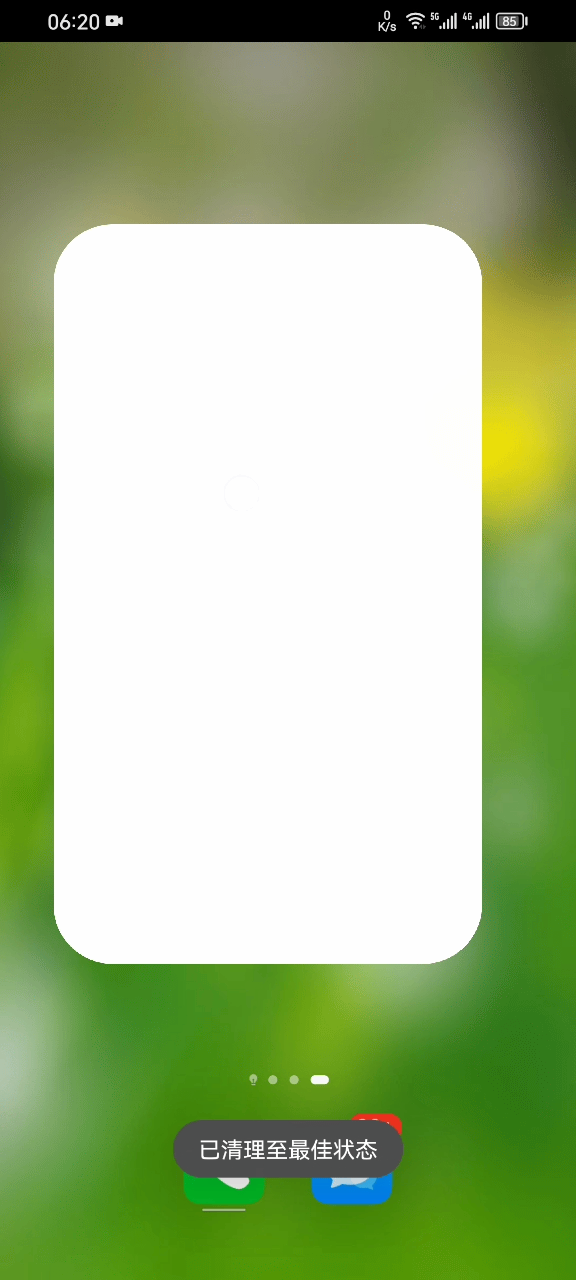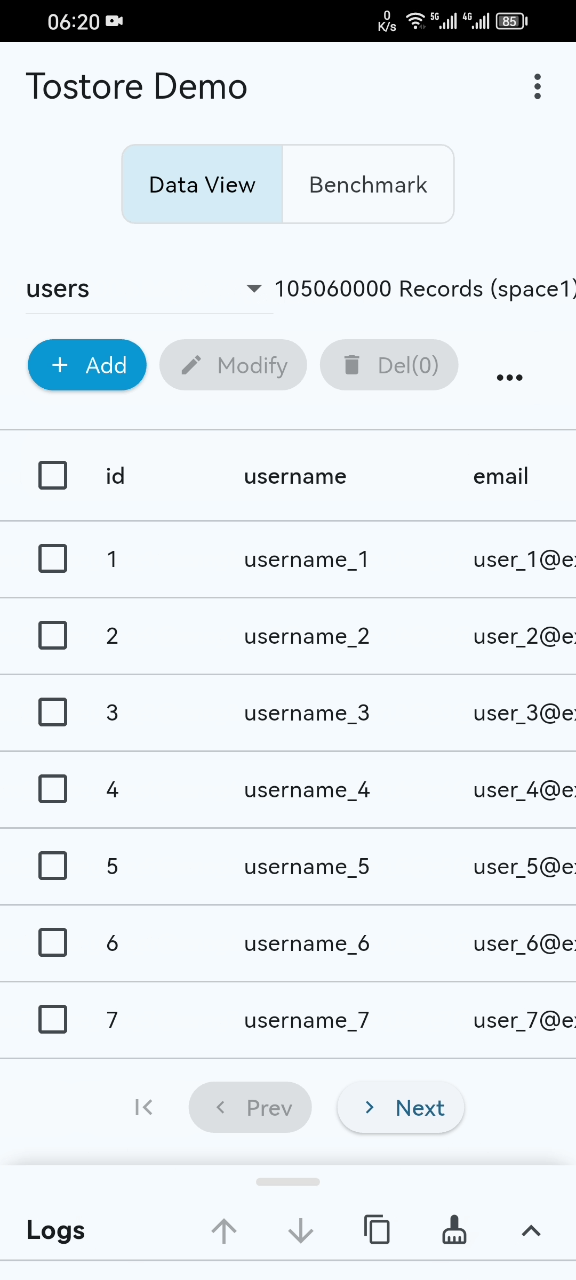
- 基础性能演示(basic-demo.mp4):普通手机上,数据量过亿时启动、翻页与检索仍保持稳定顺滑。
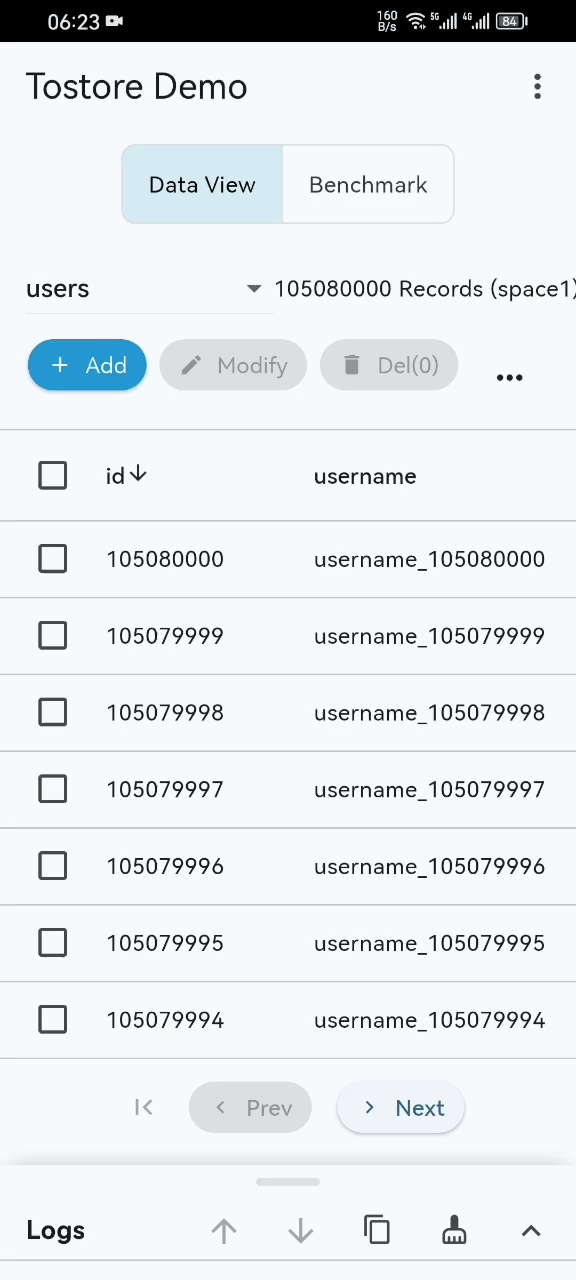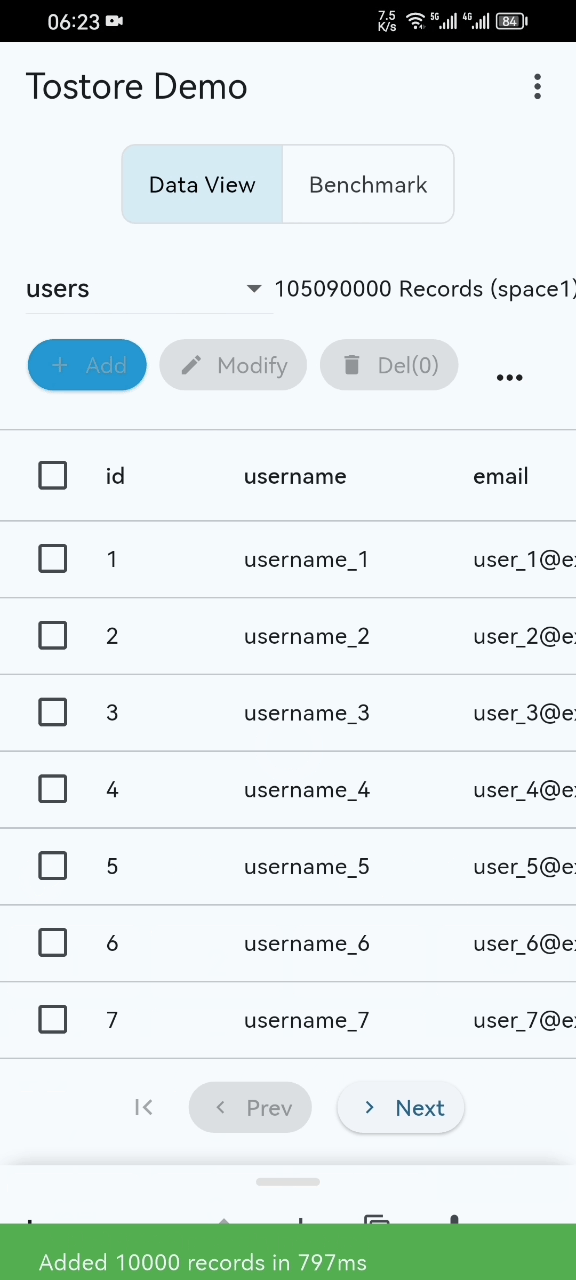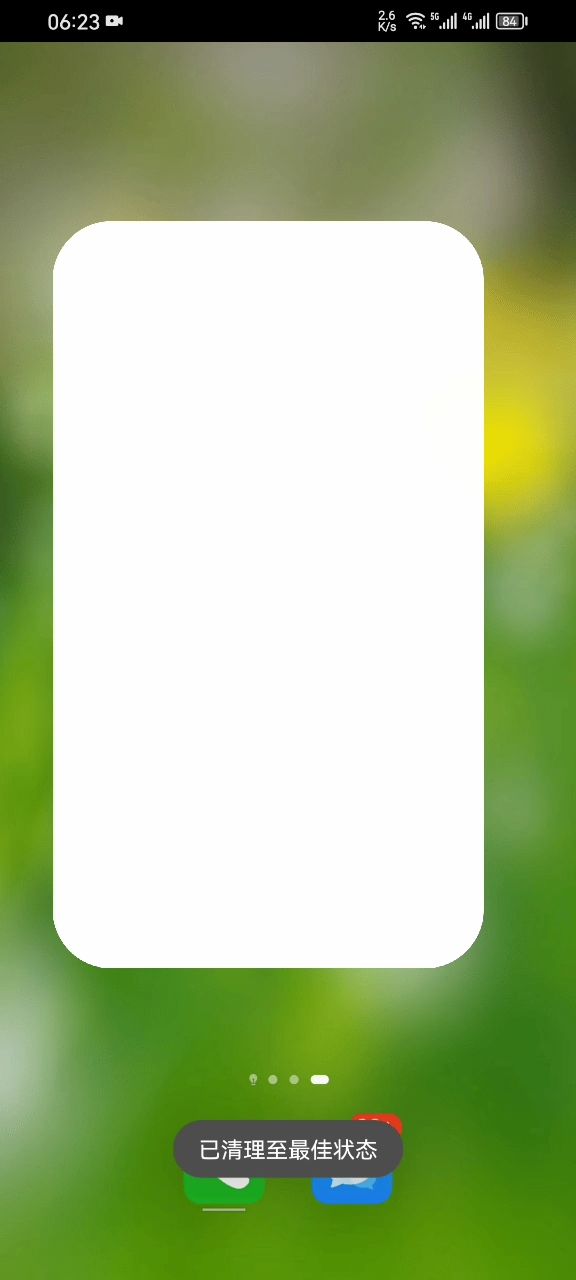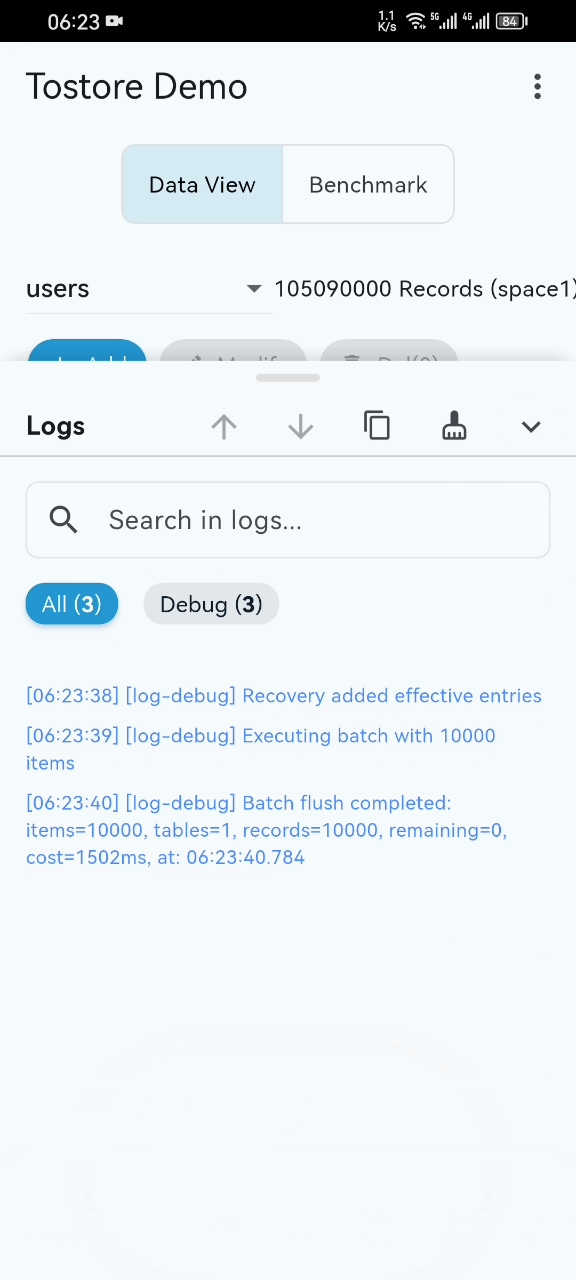
- 灾难恢复压力测试(disaster-recovery.mp4):高频写入下反复中断进程模拟崩溃/断电,仍可快速自恢复。
体验建议
- 📱 示例项目:
example目录下提供了完整的Flutter应用示例 - 🚀 生产环境:建议打包release版本,release模式下性能远超调试模式
- ✅ 标准测试:核心功能已覆盖标准化测试
如果 ToStore 对您有所帮助,请给我们一个 ⭐️,这是对开源的最大支持,非常感谢!
🤝 欢迎贡献
ToStore 是一个持续演进的现代数据引擎,我们非常欢迎社区参与贡献。 无论是修复 bug、优化文档、改进架构,还是提出新想法,都可以通过 PR 参与:
- 🔗 提交 PR:Pull Requests
- 📖 文档:Wiki
- 📢 问题反馈:GitHub Issues
- 💬 技术讨论:GitHub Discussions