
stepfun-ai/Step1X-3D
stepfun-ai/Step1X-3D has 902 GitHub stars and 64 forks. GitHot measured 0 stars in 24 hours. Last checked 2026-11-15 19:50 UTC. Last push 2025-09-08.
实测星标增长
- 24小时
- 0
- 7天
- 更新延迟
- 15天
- 更新延迟
- 1个月
- 更新延迟
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
关于
Step1X-3D: Towards High-Fidelity and Controllable Generation of Textured 3D Assets
创作与媒体README_CN.md
原文中文 | English
Step1X-3D:面向高保真和可控的
纹理化3D资产生成


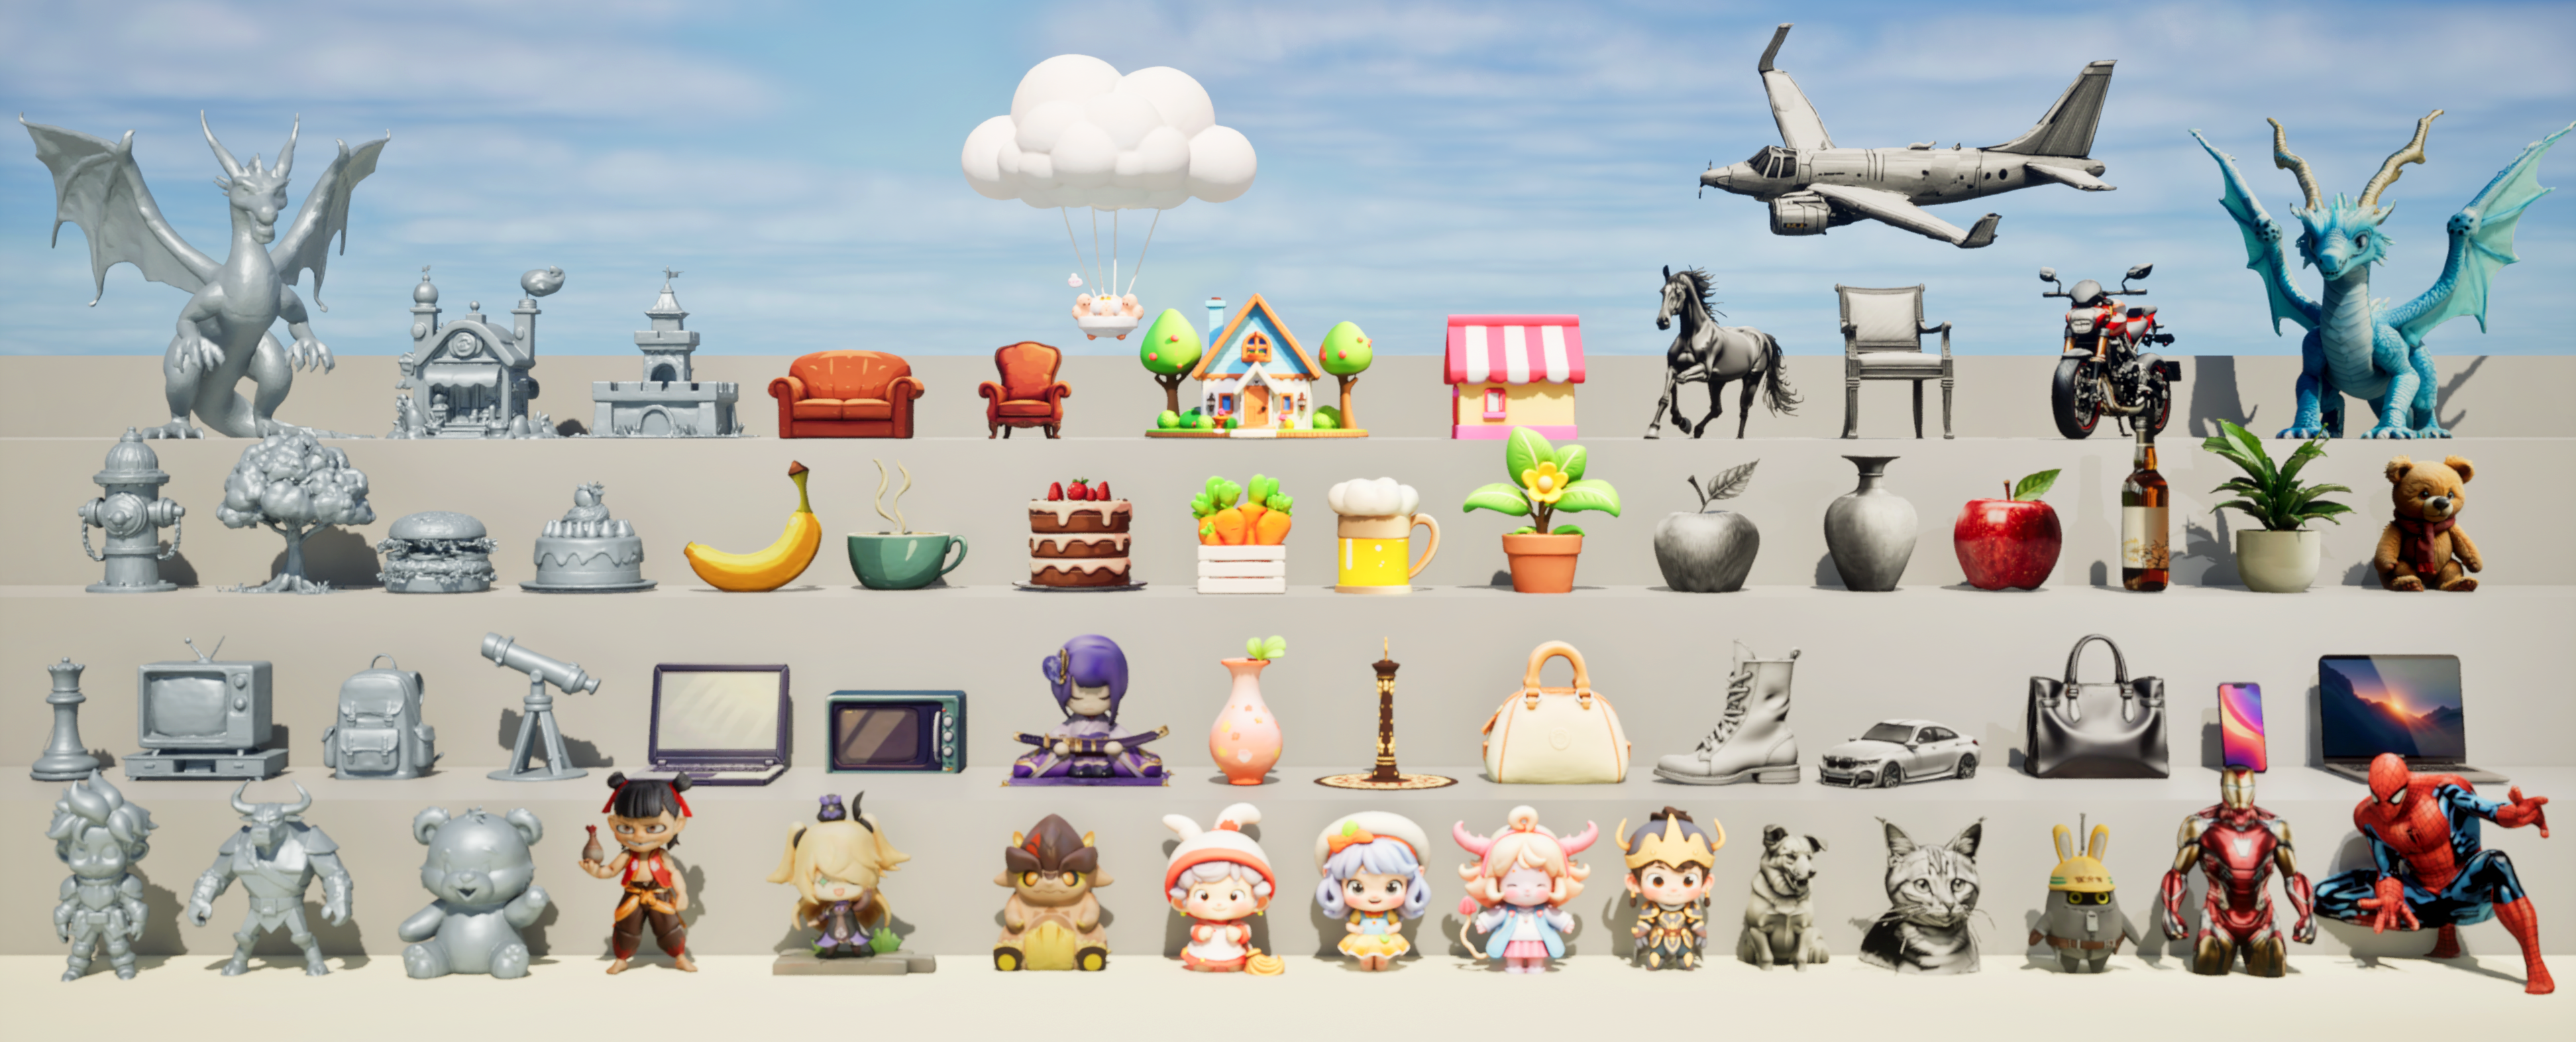
Step1X-3D展示了生成具有高保真几何和多样纹理映射的3D资产的能力,同时保持了表面几何和纹理映射之间的出色对齐。从左到右,我们依次展示了:基础几何(无纹理),以及卡通风格、素描风格和照片级真实感的3D资产生成结果。
🔥🔥🔥 最新消息!!
- 2025年6月26日: 👋 我们在“Step1X-3D/data/watertight_and_sampling.py”路径下发布了使用深度检测和winding number来获得水密mesh的数据处理代码!
- 2025年6月9日: 👋 我们在“Step1X-3D/data/ig2mv/render”路径下发布了用于纹理生成模型训练的多视图渲染代码!
- 2025年5月27日: 👋 我们发布了带有纹理同步模块的多视图生成模型!
- 2025年5月13日:👋 Step1X-3D在线演示现已在huggingface上可用,尽情享受生成的3D资产!Huggingface网页直播
- 2025年5月13日:👋 我们发布了通过严格数据整理流程获得的800K高质量3D资产(不包括自收集资产)的uid,用于3D几何训练和合成。 Huggingface数据集
- 2025年5月13日:👋 我们还发布了Step1X-3D几何生成和纹理合成的训练代码。
- 2025年5月13日:👋 我们已经发布了Step1X-3D几何和Step1X-3D纹理的推理代码和模型权重。
- 2025年5月13日:👋 我们已经发布了Step1X-3D 技术报告作为开源。
📑 开源计划
- 技术报告
- 推理代码 & 模型权重
- 训练代码
- 高质量3D资产的uid
- 在线演示(在huggingface上使用gradio部署)
- 几何数据处理(包括使用深度检测和winding number来获得水密mesh,点云采样)
- 更多可控模型,如多视角、边界框和骨架条件
- ComfyUI
1. 引言
虽然生成式人工智能在文本、图像、音频和视频领域取得了显著进展,但由于数据稀缺、算法限制和生态系统碎片化等根本挑战,3D生成相对滞后。
为此,我们提出了Step1X-3D,一个通过以下方式解决这些挑战的开放框架:
(1)通过处理>5M资产创建一个具有标准化几何和纹理属性的2M高质量数据集的严格数据整理流程;
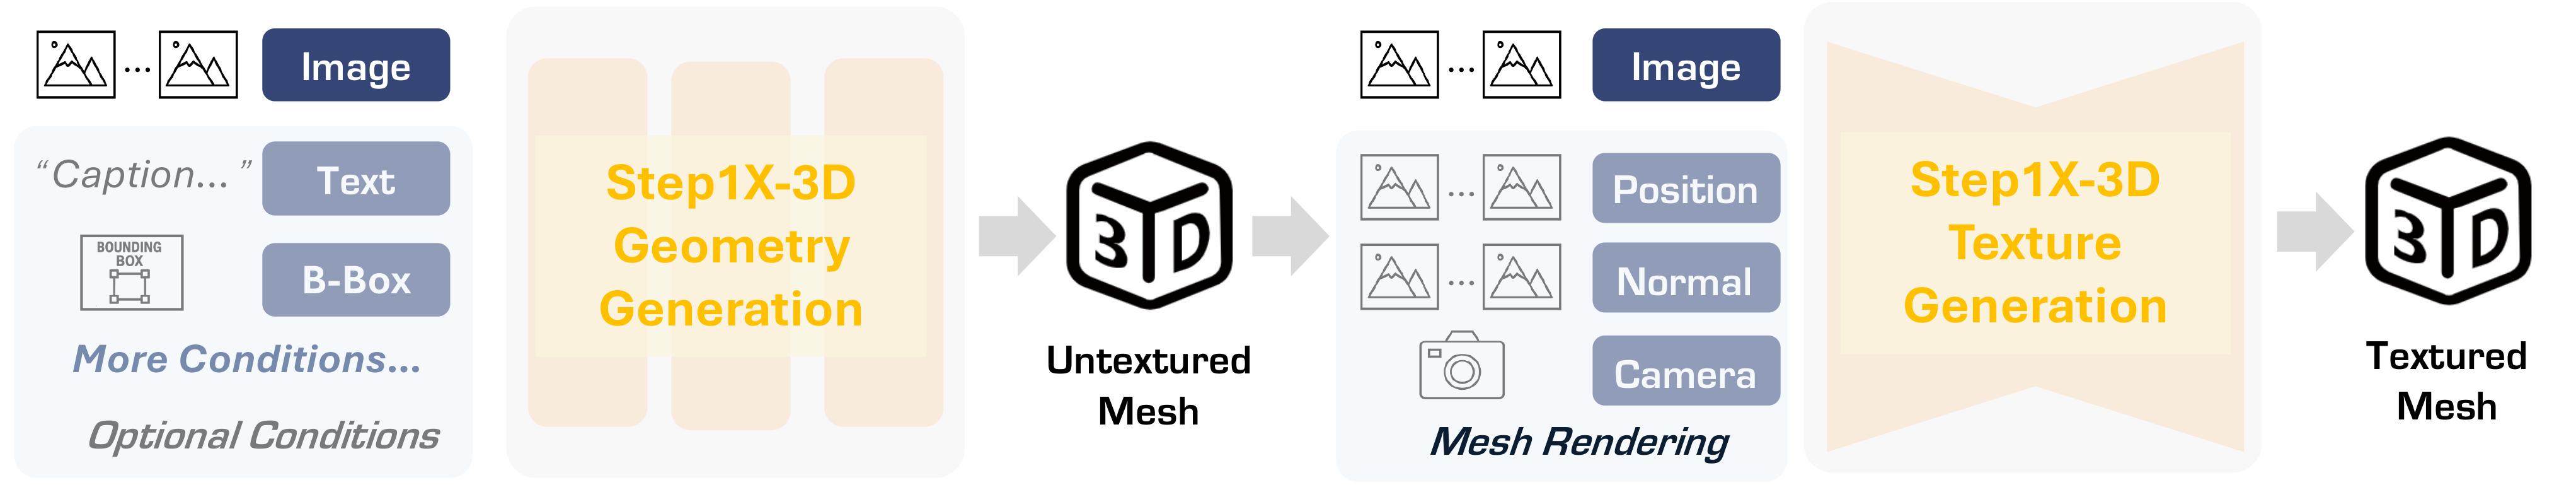
(2)结合混合VAE-DiT几何生成器和基于SD-XL的纹理合成模块的两阶段3D原生架构;以及(3)模型、训练代码和适应模块的完全开源发布。对于几何生成,混合VAE-DiT组件通过使用基于感知器的潜在编码和锐利边缘采样来生成水密TSDF表示,以保持细节。然后,基于SD-XL的纹理合成模块通过几何条件和潜在空间同步确保跨视角一致性。
基准测试结果显示,该框架在性能上超越了现有的开源方法,同时在质量上也达到了与专有解决方案相媲美的水平。
值得注意的是,该框架通过支持将2D控制技术(如LoRA)直接转移到3D合成,独特地连接了2D和3D生成范式。
通过同时提高数据质量、算法保真度和可重复性,Step1X-3D旨在为可控3D资产生成的开放研究树立新标准。
2. 模型下载
| 模型 | 下载链接 | 大小 | 更新日期 |
|---|---|---|---|
| Step1X-3D-geometry | 🤗 Huggingface | 1.3B | 2025-05-13 |
| Step1X-3D-geometry-label | 🤗 Huggingface | 1.3B | 2025-05-13 |
| Step1X-3D Texture | 🤗 Huggingface | 3.5B | 2025-05-13 |
| Models in ModelScope | 🤖 ModelScope | 6.1B | 2025-05-14 |
3. 开放过滤的高质量数据集
| 数据源 | 下载链接 | 大小 | 更新日期 |
|---|---|---|---|
| Objaverse | 🤗Huggingface | 320K | 2025-05-13 |
| Objaverse-XL | 🤗Huggingface | 480K | 2025-05-13 |
| 纹理合成的资产 | 🤗Huggingface | 30K | 2025-05-13 |
| Assets in ModelScope | 🤖ModelScope | 830K | 2025-05-14 |
基于上述高质量3D资产,您可以按照Dora中的方法预处理数据以进行VAE和3D DiT训练,并按照MV-Adapter进行ig2mv训练。
4. 依赖项和安装
根据以下说明配置的依赖项提供了一个适合训练和推理的环境
4.1 克隆仓库
git clone --depth 1 --branch main https://github.com/stepfun-ai/Step1X-3D.git
cd Step1X-3D
浅克隆的速度更快,且无需拉取gh-pages分支
使用
git fetch --unshallow命令可以将浅克隆转为完整克隆使用
git config remote.origin.fetch '+refs/heads/*:refs/remotes/origin/*'命令可以拉取全部分支
4.2 创建新的conda环境
conda create -n step1x-3d python=3.10
conda activate step1x-3d
4.3 安装要求
我们在cuda12.4下检查了环境,您可以通过以下CUDA Toolkit安装指南安装cuda12.4。
pip install torch==2.5.1 torchvision==0.20.1 torchaudio==2.5.1 --index-url https://download.pytorch.org/whl/cu124
pip install -r requirements.txt
pip install torch-cluster -f https://data.pyg.org/whl/torch-2.5.1+cu124.html
pip install "git+https://github.com/facebookresearch/pytorch3d.git@stable"
pip install kaolin==0.17.0 -f https://nvidia-kaolin.s3.us-east-2.amazonaws.com/torch-2.5.1_cu124.html

cd step1x3d_texture/custom_rasterizer
python setup.py install
cd ../differentiable_renderer
python setup.py install
cd ../../
我们在纹理烘焙中重用了Hunyuan3D 2.0中的custom_rasterizer和differentiable_renderer工具,感谢他们的开源贡献。
5. 推理脚本
| 显存占用 | 50 steps耗时 | |
|---|---|---|
| Step1X-3D-Geometry-1300m+Step1X-3D-Texture | 27G | 152秒 |
| Step1X-3D-Geometry-Label-1300m+Step1X-3D-Texture | 29G | 152秒 |
我们提供以下示例代码作为教程,以按顺序生成几何和纹理。
import torch
# 阶段1:3D几何生成
from step1x3d_geometry.models.pipelines.pipeline import Step1X3DGeometryPipeline

# 定义管道
geometry_pipeline = Step1X3DGeometryPipeline.from_pretrained("stepfun-ai/Step1X-3D", subfolder='Step1X-3D-Geometry-1300m'
).to("cuda")

# 输入图像
input_image_path = "examples/images/000.png"

# 运行管道并获取无纹理网格
generator = torch.Generator(device=geometry_pipeline.device).manual_seed(2025)
out = geometry_pipeline(input_image_path, guidance_scale=7.5, num_inference_steps=50)

# 以.glb格式导出无纹理网格
out.mesh[0].export("untexture_mesh.glb")


# 阶段2:3D纹理合成
from step1x3d_texture.pipelines.step1x_3d_texture_synthesis_pipeline import (
    Step1X3DTexturePipeline,
)
from step1x3d_geometry.models.pipelines.pipeline_utils import reduce_face, remove_degenerate_face
import trimesh

# 加载无纹理网格
untexture_mesh = trimesh.load("untexture_mesh.glb")

# 定义纹理管道
texture_pipeline = Step1X3DTexturePipeline.from_pretrained("stepfun-ai/Step1X-3D", subfolder="Step1X-3D-Texture")

# 减少面
untexture_mesh = remove_degenerate_face(untexture_mesh)
untexture_mesh = reduce_face(untexture_mesh)

# 纹理映射
textured_mesh = texture_pipeline(input_image_path, untexture_mesh)

# 以.glb格式导出纹理化网格
textured_mesh.export("textured_mesh.glb")
您还可以通过运行
python inference.py
来运行整个过程。
我们还提供了基于gradio的交互式生成,支持本地部署
python app.py
6. 训练脚本
您可以选择一个配置文件进行训练,并修改脚本以支持多GPU训练或更多训练设置。
6.1 训练 autoencoder
# 路径:Step1X-3D/configs/train-geometry-autoencoder中的VAE配置示例
CUDA_VISIBLE_DEVICES=0 python train.py --config $config --train --gpu 0
6.2 从头开始训练3D diffusion model
# 路径:Step1X-3D/configs/train-geometry-diffusiontrain-geometry-autoencoder中的3D扩散配置示例
CUDA_VISIBLE_DEVICES=0 python train.py --config $config --train --gpu 0
6.3 使用LoRA微调训练3D diffusion model
CUDA_VISIBLE_DEVICES=0 python train.py --config $config --train --gpu 0 system.use_lora=True
6.4 训练基于SD-XL的多视角生成
# 路径:Step1X-3D/configs/train-texture-ig2mv中的3D ig2mv配置示例
# 我们从MV-Adapter采用大多数多视角生成的训练代码,感谢他们的出色工作。
CUDA_VISIBLE_DEVICES=0 python train_ig2mv.py --config configs/train-texture-ig2mv/step1x3d_ig2mv_sdxl.yaml --train
7. 致谢
我们要感谢以下项目:FLUX,DINOv2,MV-Adapter,CLAY,Michelango,CraftsMan3D,TripoSG,Dora,Hunyuan3D 2.0,FlashVDM,diffusers和HuggingFace,感谢他们开放的探索和贡献。更具体地说,在纹理生成方面:我们基于MV-Adapter 的部分代码实现多视角生成,基于bpy-render的部分代码实现多视角渲染,基于Hunyuan 3D 2.0的部分代码实现纹理烘焙。
8. 许可
Step1X-3D根据Apache License 2.0许可。您可以在相应的github和HuggingFace存储库中找到许可文件。
9. 引用
如果您发现我们的工作有帮助,请引用我们
@article{li2025step1x,
  title={Step1X-3D: Towards High-Fidelity and Controllable Generation of Textured 3D Assets},
  author={Li, Weiyu and Zhang, Xuanyang and Sun, Zheng and Qi, Di and Li, Hao and Cheng, Wei and Cai, Weiwei and Wu, Shihao and Liu, Jiarui and Wang, Zihao and others},
  journal={arXiv preprint arXiv:2505.07747},
  year={2025}
}