
sjtuytc/ResearchMathAgent
sjtuytc/ResearchMathAgent has 37 GitHub stars and 4 forks. GitHot measured 0 stars in 24 hours and 0 in 7 days. Last checked 2026-11-09 09:14 UTC. Last push 2026-11-03.
Research Math Agents, Official code release for our paper RMA
可以做什么
- 7 research-level datasets - First Proof Rounds 1 & 2, Erdős Problems, Formal Conjectures, ResearchMath-14k, Unsolved Math, AIM Problem Lists — totalling 22,000+ problems
- Multi-agent pipeline - Initializer → Proposer → Verifier → Refiner, coordinated through shared structured memory
- State-of-the-art results - Solves 8 / 10 First Proof Round 1 problems; outperforms GPT-5.2R and Aletheia
- Two Claude backends - Anthropic Messages API (pay-per-token) or Claude Code local CLI (Pro/Max subscription)
实测星标增长
- 24小时
- 0
- 7天
- 0
- 15天
- 更新延迟
- 1个月
- 更新延迟
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
README_zh.md
原文RMA:面向研究级数学问题的智能体系统



COLM 2026 · 第二届终身智能体研讨会(The 2nd Workshop on Lifelong Agents: Learning, Aligning, and Evolving)
语言: English | 中文
核心亮点
RMA 是首个面向研究级数学证明的智能体框架——不是竞赛题,不是形式化定理证明——通过专门化智能体、结构化共享记忆与迭代验证反馈协同工作。
| 特性 | 说明 |
|---|---|
| 7 个研究级数学数据集 | First Proof 第 1、2 轮、Erdős 问题集、形式化猜想、ResearchMath-14k、未解数学问题、AIM 问题列表,共计 22,000+ 道问题 |
| 多智能体流水线 | 初始化器 → 提议器 → 验证器 → 精炼器,通过结构化共享记忆协调 |
| 领先实验结果 | 在 First Proof 第 1 轮基准上解决 8 / 10 道问题,超越 GPT-5.2R 与 Aletheia |
| 双 Claude 后端 | Anthropic Messages API(按 token 付费)或 Claude Code 本地 CLI(Pro/Max 订阅额度) |
| 实时 Web 界面 | 逐步流式输出、实时 PDF 预览、问题追踪器、token 费用显示(含来源归因与饼图) |
| 自主每日工作器 | 无需人工干预,定时运行求解器,将有日期的报告写入 documents/ |
| 基准公平沙箱 | 代码层面强制污染边界——求解器绝不读取历史解答 |
| 多智能体 GitHub Issues API | REST 接口 (/api/gh/issues) 让多个智能体在真实 GitHub Issues 上协作 |
⚡ 快速上手
三步即可用你自己的 Claude 订阅求解一道研究级数学问题——无需 API 密钥,不走 Google Cloud / Vertex,也没有按 token 计费:
git clone https://github.com/sjtuytc/ResearchMathAgent
cd ResearchMathAgent
./scripts/quick_install.sh     # 建立隔离环境 + `rma` 命令行 + Claude Code 后端
source .venv/bin/activate      # 激活环境(安装脚本会打印此行)
claude login                   # 用你自己的 Claude Pro/Max 订阅登录
rma solve q6                   # 求解一道问题——计费走你的订阅
rma solve <q> 默认使用 Claude Code 后端,因此每次运行都计费到你 claude login 的订阅账户,绝不会用到开发者的 API 账户或 Vertex AI。可选择任意 First Proof 问题 q1–q10(或用 --dataset <slug> 求解数据集问题)。想做不调用大模型的空跑?rma solve q6 --model-name rma-skeleton。
摘要
展开完整摘要
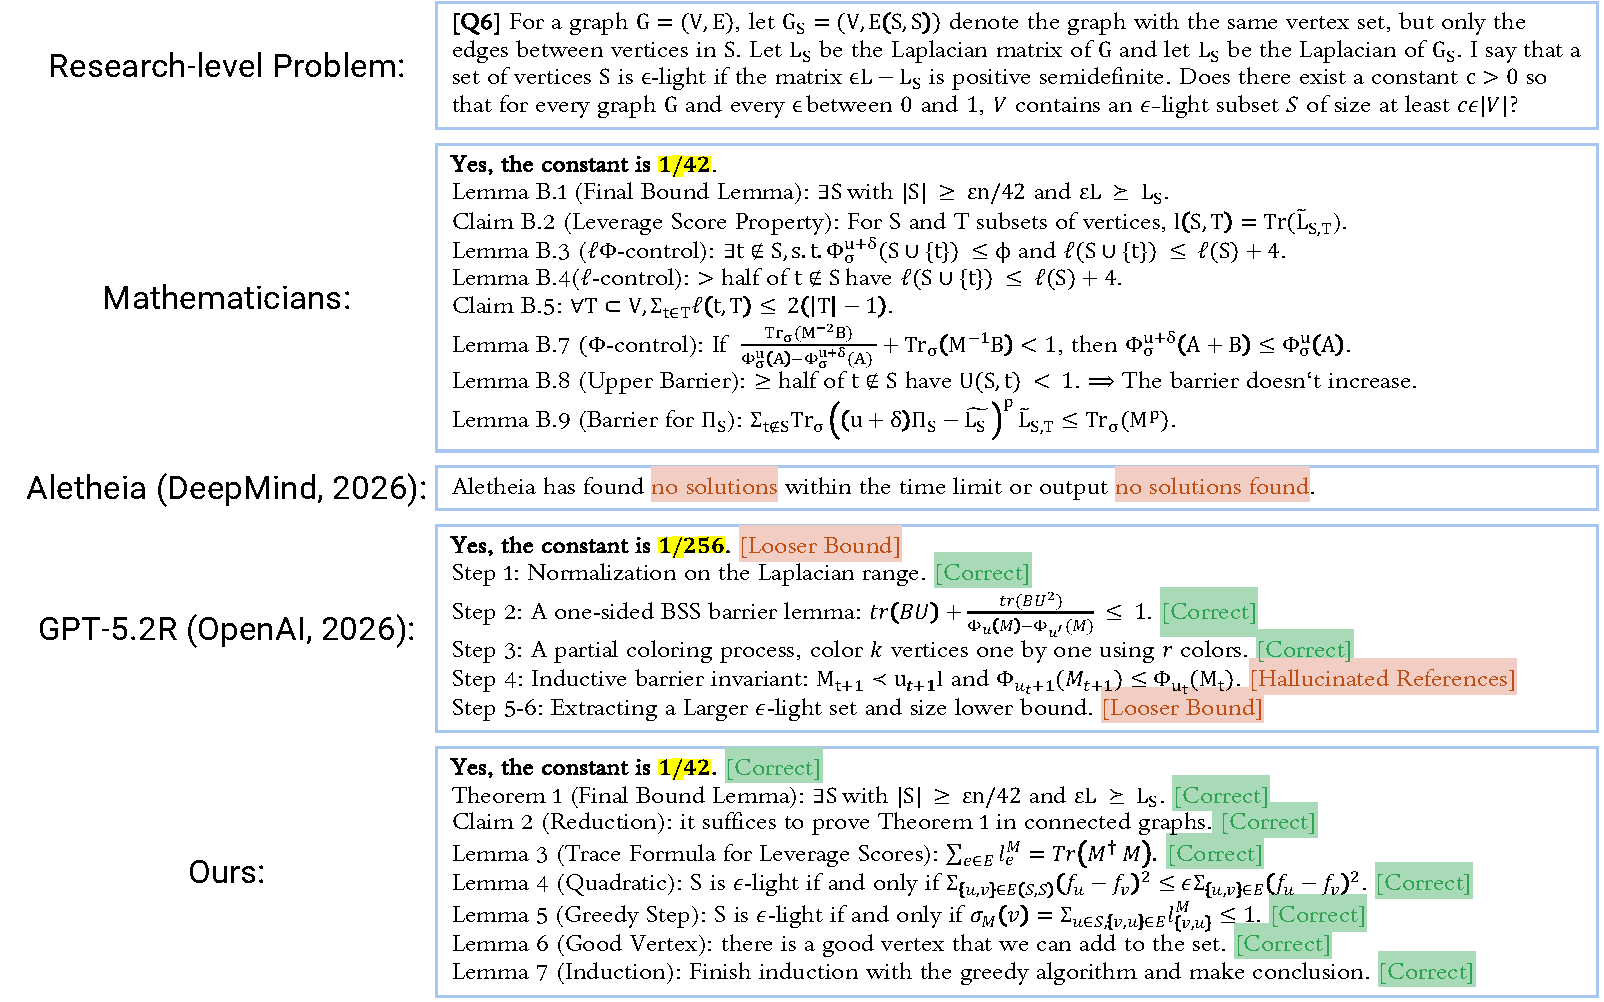
我们提出 Research Math Agents (RMA),一个面向研究级数学问题自动化推理的智能体框架。与以往聚焦于竞赛数学或形式化定理证明的研究不同,RMA 针对需要长程推理、文献溯源与迭代证明精炼的研究级数学问题。RMA 将研究级证明求解分解为若干专门模块:问题分析、文献检索与理解、公平比较、知识库构建以及证明验证,所有模块通过初始化器、提议器和验证器智能体经由共享结构化记忆统一协调。在这一统一框架内,各智能体以多角色、多轮次工作流协同运作,通过迭代反馈不断生成、精炼和验证候选证明。我们在 First Proof 基准上对 RMA 进行评估,该基准包含十位来自不同领域的数学专家贡献的十道研究级问题。经专家全面评估,RMA 在 First Proof 基准上超越了包括 GPT-5.2R 和 Aletheia 在内的强基线,解决了十道问题中的八道,并产出了逻辑更严谨、可读性更强的证明。全面的消融研究进一步表明,性能提升源于结构化推理模块、迭代精炼与验证器反馈的协同作用,而非单一组件。
系统概览
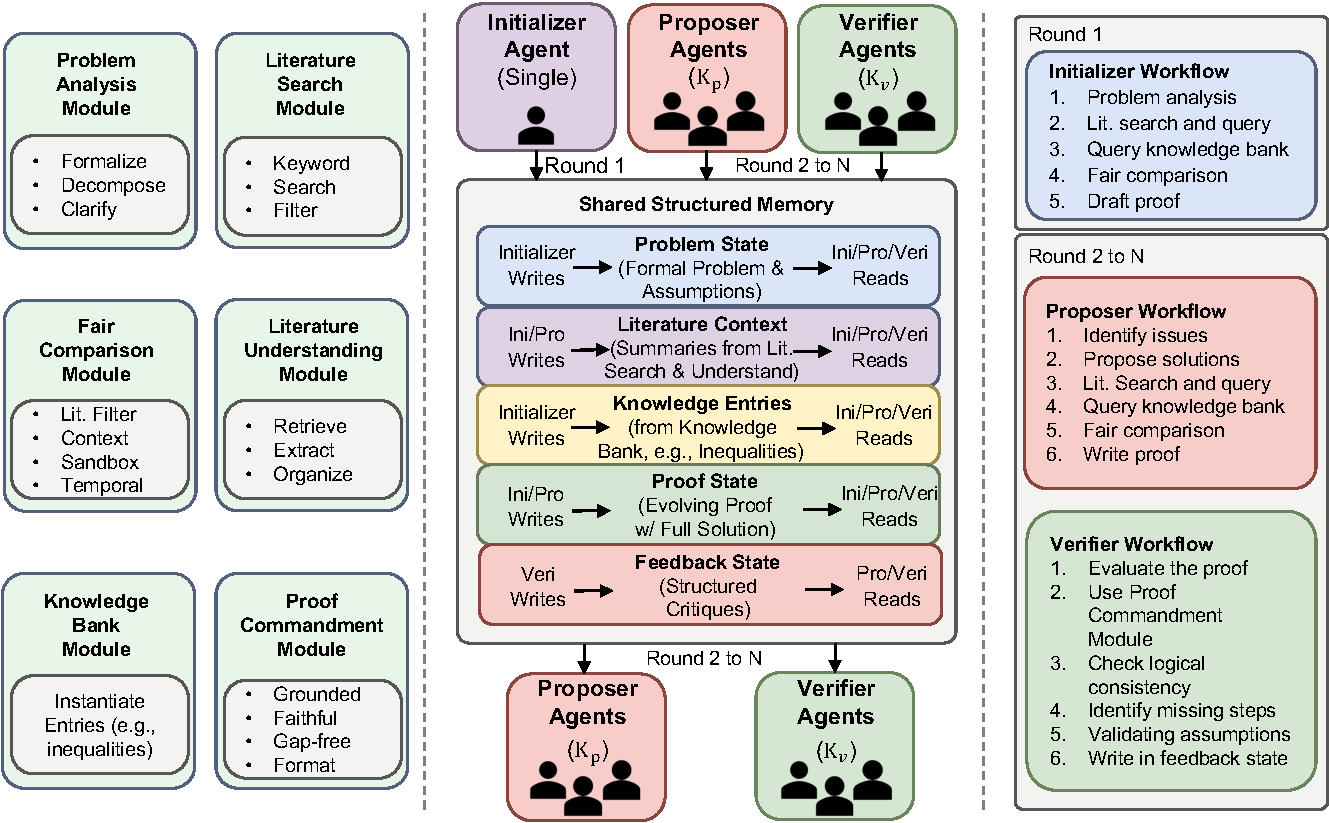
RMA 聚焦于研究级数学(而非竞赛数学或形式化定理证明),综合运用以下专门模块:问题分析、文献检索与理解、公平比较、知识库构建和证明验证。
在多角色、多轮次工作流中,初始化器/提议器/验证器智能体共享结构化记忆,迭代生成、精炼和验证候选证明。在 First Proof 基准上,RMA 通过结构化模块、迭代精炼和验证器反馈报告了优于强基线的结果。
支持的数据集
RMA 开箱即用地支持以下基准数据集。通过修改 config/default.yaml 中的路径指向 data/datasets/<slug>/problems/ 即可切换数据集。
| 数据集 | 题目数 | 说明 | 许可证 |
|---|---|---|---|
| First Proof — 第 1 轮 | 10 | 由顶尖数学家贡献的 10 道研究级开放问题,横跨 10 个不同领域(随机分析、表示论、谱图论等)。本项目主要评测基准。 | CC BY 4.0 |
| First Proof — 第 2 轮 | 10 | 2026 年 6 月发布的第二批问题,涵盖描述集合论、分段线性几何、概率论、黎曼几何、随机偏微分方程、组合学、群论、热带几何与算子代数。 | CC BY 4.0 |
| Erdős 问题集 | 1,217 | Paul Erdős 提出的 1,179 道开放问题,由 Terence Tao 维护,含悬赏金额、OEIS 链接及当前状态。 | Apache-2.0 |
| 形式化猜想 (Google DeepMind) | 4,557 | 2,571 条用 Lean 4 形式化表达的数学猜想,含 1,029 道标记为 sorry 的开放问题,覆盖数论、组合学、分析和代数。 |
Apache-2.0 / CC-BY-4.0 |
| ResearchMath-14k | 14,056 | 从 arXiv 论文与研讨会问题列表收集的 14k 道研究级问题,横跨 11 个数学领域,标注了开放/已解/部分解决状态。(arXiv:2605.28003) | CC BY 4.0 |
| 未解数学问题 | 2,084 | 来自 12 个精选集合的开放问题:千禧年大奖、希尔伯特 23 题、Erdős(632 题)、Ben Green 百题、DARPA 23 题、Smale、Landau、Hardy-Littlewood、Guy 素数问题、Kourovka 手册、Kirby 低维拓扑、OpenGarden。 | CC-BY-4.0 |
| AIM 问题列表 | 101 | 来自美国数学研究所(AIM)研讨会的开放问题列表,覆盖纯数学与应用数学 80+ 个主题。 | 学术/需署名 |
合计:7 个数据集,22,035 道问题。
快速开始
最快路径——用你的 Claude 订阅,无需 API 密钥(参见上方 ⚡ 快速上手):
./scripts/quick_install.sh     # 隔离环境 + `rma` 命令行 + Claude Code 后端
source .venv/bin/activate      # 激活环境(安装脚本会打印此行)
claude login                   # 你自己的 Claude Pro/Max 订阅
rma solve q6                   # 用订阅求解(默认后端)
其他方式:
# Web 界面——流式求解、实时 PDF 预览、按题目的 issue 追踪
pip install -e ".[webapp]"
python -m webapp               # → http://127.0.0.1:8000

# 改用按 token 计费的 Anthropic API(而非订阅)
export ANTHROPIC_API_KEY="<你的密钥>"
rma solve q6 --model-name claude-opus-4-8
仓库结构
展开目录树
ResearchMathAgent/
├── problems/             # 基准问题陈述(q1..q10 .tex 文件)
├── skills/               # 求解器使用的数学研究技能指令
├── final_solutions/      # 已发布/参考证明——不作为求解器输入
├── outputs/              # 求解器输出目录(写入目标,位于共享存储)
├── rma/                  # CLI 工具:parse / propose / verify / refine / solve
├── webapp/               # 实时 Web 应用(FastAPI + 原生 JS)
│   └── README.md         # Web 应用详细说明
├── documents/            # 自主工作器生成的每日报告
├── config/default.yaml   # 项目路径与执行层级预设
└── main.tex              # 论文源文件
problems/→final_solutions/的边界在代码层面强制执行;求解器绝不读取历史解答。outputs/(指向共享存储的符号链接)是所有rma solve运行的写入目标。- 剩余工程路线图见 TODO.md。
代码库架构
项目中每个 Python 模块的单句说明。
rma/ — CLI 入口
| 文件 | 功能 |
|---|---|
cli.py |
顶层 rma 参数解析器;分发至 solve、push、memory、doctor 子命令。 |
push.py |
rma push — 运行推进流程(issues + 会议 + 文档),刷新概念/洞察/证明评估,然后构建主上下文报告 PDF。 |
solve.py |
rma solve — 对一道题运行完整求解智能体:解析 → 提出 → 验证 → 精化 → 整合。 |
models.py |
CLI 标志和 API 调用中使用的模型名称常量与别名。 |
memory.py |
rma memory — 打印或清除推进状态文件。 |
doctor.py |
rma doctor — 环境健康检查:Python 版本、tectonic、Claude CLI / API 密钥。 |
__main__.py |
python -m rma 入口点;委托给 cli.py。 |
webapp/ — FastAPI 服务器
| 文件 | 功能 |
|---|---|
server.py |
研究 Web 应用的所有 API 端点(证明 CRUD、PDF 编译、issues、会议、洞察、上下文报告、文献)。 |
agent.py |
所有智能体类型(评论、求解、会议、文档)共享的基础智能体类与提示执行循环。 |
claude_code.py |
Claude Code CLI 驱动 — 通过 claude 二进制文件进行基于订阅(Pro/Max)的 LLM 调用,并提供一次性的 complete_via_cli() 辅助函数。 |
llm.py |
一次性补全辅助函数(complete()),经由 Claude 订阅 CLI 调用。 |
context_report.py |
为每道题构建书籍风格的 LaTeX 上下文报告(问题 → 评估 → 最佳证明 → 会议 → Issues → 洞察),并通过 tectonic 编译为 PDF;同时为 rma push 构建合并主 PDF。 |
proof_eval.py |
对最佳证明进行 LLM 评分:答案准确性、逻辑正确性、证明完整性、证明清晰度——存储于 documents/questions/<pid>/proof_eval.json。 |
insight_agents.py |
从当前项目状态生成系统级、数据集级和逐题洞察摘要的 LLM 智能体。 |
insight_loop.py |
定期重新生成洞察摘要的后台轮询循环。 |
insights.py |
从 webapp/insights/<level>/ 加载/保存洞察 JSON 文件。 |
issue_agents.py |
评论智能体(发现证明漏洞 → 开 issue)和求解智能体(通过 LLM 证明写作解决开放 issue)。 |
issue_loop.py |
服务器运行时自动对开放 issue 运行 issue 求解器的后台循环。 |
issue_pdf.py |
将单个 issue 线程或一道题的所有 issues 编译为 PDF。 |
issues.py |
webapp/issues/<dataset>/<pid>/ 下 issue JSON 文件的 CRUD 操作。 |
meet_agents.py |
运行多轮研究会议并生成行动计划的数学家角色讨论智能体。 |
meet.py |
documents/questions/<pid>/meets/ 下会议室的 CRUD 操作。 |
meet_pdf.py |
将会议室笔记(计划 + 讨论记录)编译为 PDF。 |
push_forward.py |
编排器:对每道题依次运行 issue 发现 → 求解 → 会议 → 文档更新;由 rma push 和夜间定时任务调用。 |
push_forward_cli.py |
CLI 封装,使 push_forward 可在 uvicorn 自动重载进程之外运行。 |
concepts.py |
从题目 LaTeX 加载/保存/生成逐题概念列表(核心 + 背景)。 |
concepts_pdf.py |
将一道题的概念列表编译为独立 PDF。 |
proofs.py |
加载/存储最佳证明记录;get_best_proof、consolidate_best、compile_best_pdf。 |
proof_history.py |
加载并汇总一道题证明尝试的版本历史。 |
problem_pdf.py |
将原始题目 .tex 文件(含共享前言)编译为独立 PDF。 |
problem_export.py |
以多种格式导出题目陈述(JSON、纯文本、LaTeX)。 |
latex.py |
tectonic/pdflatex 封装:compile_tex、compile_problem_pdf、safe_pdf_name、PDF 目录辅助函数。 |
dataset_store.py |
从 data/datasets/<slug>/ 读取/查询题目元数据(标题、陈述、解题状态)。 |
documents.py |
列出并读取 documents/questions/<pid>/ 下的文档文件(概述、策略、时间线等)。 |
rich_documents.py |
每次推进后用 AI 撰写的内容重新生成问题概述/进度文档。 |
doc_bundle.py |
为某道题或数据集构建合并 "bundle.pdf"。 |
literature.py |
搜索、下载并为问题所在领域的全局论文库播种。 |
hero.py |
生成一道题的概述/策略文档(Documents 标签页中显示的"核心"文档)。 |
runs.py |
追踪实验运行元数据:开始时间、模型名称、实验名称、完成状态。 |
smoke_pipeline.py |
外部评估流水线:POST /api/solve → 异步证明生成 + LLM 评分。 |
solvability_eval.py |
加载/保存过滤器应用生成的逐题可解性分数。 |
solve_finalize.py |
求解后清理:整合证明文件、更新最佳证明记录、写入摘要。 |
todos.py |
逐题 TODO 列表的 CRUD 操作(存储于 documents/questions/<pid>/todos.json)。 |
token_log.py |
按提供商归因追踪和显示每次会话的 LLM token 用量与成本。 |
tools.py |
claude_code 智能体求解时可用的工具定义(文件读/写/搜索/运行)。 |
github_issues.py |
用于智能体协调的真实 GitHub 仓库 issue 追踪的 GitHub Issues REST API 封装。 |
devlog.py |
向 documents/devlog.jsonl 追加带时间戳的条目,记录会话和事件历史。 |
daily.py |
计划性每日任务——当前将推进流程作为定时任务目标进行封装。 |
seed_fp2.py |
一次性导入器:从 GitHub 1stproof/batch-2 仓库播种 first_proof_2 数据集。 |
prefix.py |
生成绝对 API URL 的模块共享的 API_PREFIX 常量(/rmac/solve)。 |
__main__.py |
python -m webapp 入口点:以 HOST/PORT 环境变量启动 uvicorn。 |
根目录脚本
| 文件 | 功能 |
|---|---|
proxy_server.py |
轻量反向代理:将 /rmac/solve/* 路由至 :8011 的求解应用,将 /rmac/filter/* 路由至 :8012 的过滤应用。 |
run_fp2_init.py |
一次性脚本,播种 first_proof_2 数据集并初始化逐题 issue/洞察目录。 |
run_pf_standalone.py |
在 uvicorn 进程外运行推进流程的别名/封装(日志与服务器分离)。 |
命令行工具(CLI)
安装后即可使用 rma 命令:
pip install -e .
rma doctor        # 环境健康检查
或不安装直接运行:
python -m rma doctor
分阶段流水线(parse / propose / verify / refine)
流水线为:
parse → propose → verify → refine
每个阶段均可单独运行,后续阶段会自动初始化缺失的前置产物。
rma parse q6
rma propose q6
rma verify q6
rma refine q6
指定实验名称和模型:
rma parse q6    --exp-name proofs_v1_june13 --model-name rma-skeleton
rma propose q6  --exp-name proofs_v1_june13 --model-name rma-skeleton
rma verify q6   --exp-name proofs_v1_june13 --model-name rma-skeleton
rma refine q6   --exp-name proofs_v1_june13 --model-name rma-skeleton
各阶段输出:
| 阶段 | 写入文件 |
|---|---|
parse |
parsed_problem.json、problem_analysis.md |
propose |
qN_solution.tex、版本化提议产物 |
verify |
验证报告(JSON + Markdown),默认渲染 PDF |
refine |
根据最新报告重写 qN_solution.tex |
verify 检查 LaTeX/产物正确性以及数学完整性门控(证明长度、子命题结构、子证明、假设审计、引用或推导、边界情形证明)。
rma solve — 完整求解循环
rma solve 统筹 parse → propose → verify,验证失败时调用 refine,最多重复 --max-rounds 轮。只有当验证器所有门控均通过时,运行才标记为 verified。
# 求解单道问题
rma solve q6

# 求解全部 10 道问题
rma solve --all

# 指定实验名称 + 骨架模型(流水线测试)
rma solve --all --exp-name proofs_test_all_june13 --model-name rma-skeleton

# 执行层级(记录在元数据中)
rma solve q6 --tier budget      # 可选 standard / pro

# 限制精炼轮数
rma solve q6 --max-rounds 3

# 使用数学研究技能
rma solve q6 --skill-path skills/math-research/SKILL.md

# 仅写入 .tex(跳过 PDF 渲染)
rma solve q6 --no-render
输出目录结构:
outputs/first_proof_1/proofs_v1_june13_rma-skeleton/
  q6_solution.tex
  q6_solution.pdf
  q6/
    input/problem.tex
    artifacts/
      metadata.json
      status.json
      report.md
      parsed_problem.json
      problem_analysis.md
      proposals/proposal_001.tex
      verifications/verification_001.json
      refinements/
终端输出示例:
RMA solve
tier: standard
skill: skills/math-research/SKILL.md
status: needs_refinement
output: outputs/first_proof_1/proofs_v1_june13_rma-skeleton
solution: outputs/first_proof_1/proofs_v1_june13_rma-skeleton/q6_solution.tex
verification: .../verification_003.json
Claude 后端——API 密钥 vs 订阅额度
Anthropic Messages API(按 token 付费):
export ANTHROPIC_API_KEY="<你的密钥>"
rma solve q6 --model-name claude-opus-4-8
rma solve --all --model-name claude-sonnet-4-6 --max-rounds 3
macOS 用户可将密钥存入钥匙串,避免每次导出:
security add-generic-password -U -a "$USER" -s rma_anthropic_api_key -w "<密钥>"
rma solve q6 --model-name claude-sonnet-4-6    # 自动从钥匙串读取
显式指定 API 后端:
rma solve q6 --model-provider anthropic --model-name claude-opus-4-8
Claude Code(Pro/Max 订阅额度——不消耗 API 额度):
claude                  # 首次登录,完成浏览器授权
rma solve q6 --model-provider claude-code --model-name claude-code
rma solve --all --model-provider claude-code --model-name claude-code --max-rounds 3
claude-code 驱动本地 claude -p 无头 CLI。若希望使用订阅计费而非 API 计费,请取消设置 ANTHROPIC_API_KEY。
自动检测: --model-provider auto(默认)对 rma-skeleton 使用 Claude Code,对任意 claude-* 模型名称使用 Anthropic API。
Web 应用
pip install -e ".[webapp]"
python -m webapp          # → http://127.0.0.1:8000
在远程服务器上,转发端口到本地:
ssh -L 8000:localhost:8000 user@server
Web 应用功能列表
- 概览(Overview)标签页 — 三级层次结构(系统 → 数据集 → 问题);SVG 环形饼图按用途分类(证明研究 vs 网站开发)展示费用;所有图表与信息图标支持悬停提示
- 问题(Question)标签页 — 以 KaTeX 渲染
.tex问题陈述;支持原始/渲染切换 - 议题(Issue)标签页 — 类 GitHub 风格的每题议题追踪器(多智能体评论线程、状态、标签);支持完整 LaTeX / MathJax 渲染;同时暴露
/api/gh/issues用于直接控制 GitHub Issues - 智能体(Agent)标签页 — 实时流式运行求解器,显示推理过程 + 工具调用 + 渲染数学公式 + token 费用
- 文档(Documents)标签页 — 浏览有日期的每日报告;支持手动触发智能体运行;支持公式完整渲染
- 开发日志(Dev Log)标签页 — 网站更新历史,可通过命令面板快速访问(
Ctrl K → devlog) - 双 Claude 后端 — API 密钥或本地 Claude Code 订阅(
claudeCLI 无头模式,消耗 Pro/Max 订阅额度而非 API 额度) - 逐步实时流 — 推理块、助手文本、工具调用及结果实时显示
- 停止按钮 —
POST /api/cancel立即终止后端进程组,停止消耗订阅额度 - 活跃运行面板 — 列出所有进行中的运行,每个运行均有独立停止按钮,便于并行运行管理
- PDF 预览 — 在线编译
solution.tex(需服务器端 LaTeX);无 LaTeX 时优雅降级 - Token / 费用显示 — 每轮用量图表及每张卡片费用标注
- 自主每日工作器 —
python -m webapp.daily每晚自动运行求解器,写入documents/YYYY-MM-DD.md,并将每次运行记录到对应问题的议题线程
多智能体 GitHub Issues API
多个求解智能体可通过 Web 应用的 REST API 在真实 GitHub Issues 上协作。所有接口均在 /api/gh/ 下:
| 接口 | 方法 | 用途 |
|---|---|---|
/api/gh/status |
GET | 检查 token 状态与仓库名 |
/api/gh/issues?problem_id=q6 |
GET | 列出议题(按 problem:q6 标签筛选) |
/api/gh/issues |
POST | 创建议题 {problem_id, title, body, labels} |
/api/gh/issues/{n} |
GET | 获取议题及评论 |
/api/gh/issues/{n}/comment |
POST | 添加评论 {body} |
/api/gh/issues/{n} |
PATCH | 更新 {title, state, labels, body} |
/api/gh/issues/{n}/close |
POST | 关闭议题 |
/api/gh/issues/{n}/reopen |
POST | 重新打开议题 |
/api/gh/search?q=... |
GET | GitHub 搜索语法 |
写操作需要 GITHUB_TOKEN 环境变量(细粒度 PAT,Issues 读写权限)。读操作无需认证(60 次/小时)。
求解器污染边界
公平评估规则
求解器必须将 First Proof 官方解答和历史 AI 生成解答视为封锁输入。求解过程可以读取:
problems/— 基准问题陈述skills/— 数学研究技能指令- 同次运行的产物(由同一运行的前序阶段创建)
求解器绝不读取、grep、glob、摘要、渲染或以任何方式使用以下目录中的已有文件:
final_solutions/outputs/baselines/- First Proof 官方解答页面或衍生解答材料
outputs/ 仅允许作为写入目标。历史输出目录和无关现有解答产物仍属封锁范围。
主要求解器命令:
rma solve q6      # 仅读取 problems/q6.tex,写入全新产物
rma solve --all   # 在全部 10 道问题上进行公平基准评测
论文编译
latexmk -pdf -interaction=nonstopmode -halt-on-error main.tex
致谢
感谢 PoggioAI 开源 PoggioAI_MSc,其系统组织方向和 README 结构为本项目提供了启发。同时感谢 TheAgentCompany 团队开源其智能体循环框架和问题/议题工作区设计,这启发了 RMA Web 应用的架构。此外,我们还致谢 Andrej Karpathy 的 autoresearch 项目——该项目开创了全自动 AI 驱动科学发现的理念,为 RMA 自主求解流水线提供了重要的概念启发。
我们由衷感谢以下基准数据集的创建者与维护者:
- First Proof(第 1、2 轮)— firstproof.ai / github.com/1stproof/batch-2,由顶尖数学家贡献研究级开放问题,CC BY 4.0 许可证。
- Erdős 问题集 — Terence Tao 等人维护,github.com/teorth/erdosproblems,Apache-2.0 许可证。
- 形式化猜想 — Google DeepMind,github.com/google-deepmind/formal-conjectures,Apache-2.0 / CC-BY-4.0 许可证。
- ResearchMath-14k — arXiv:2605.28003,数据集见 Hugging Face,CC BY 4.0 许可证。
- 未解数学问题 — ulamai/UnsolvedMath,CC-BY-4.0 许可证。
- AIM 问题列表 — 美国数学研究所,学术使用需署名。
Star 历史
引用
@article{zhao2026rma,
  title={RMA: an Agentic System for Research-Level Mathematical Problems},
  author={Zhao, Zelin and Yuan, Bo and Choi, Jaemoo and Chen, Yongxin},
  journal={arXiv preprint arXiv:2605.22875},
  year={2026}
}
Lean proof reduction
rma reduce 在 RMA 的研究存储与编排之上做 Lean 证明压缩:Azure/OpenAI Responses 生成、内核验证后的候选选择、可续跑的预算控制。轮次循环之外还有三个可单独消融(--ablate)的搜索机制:已验证证明的 beam、对策略组合的 UCB1 bandit、跨题目的 playbook 记忆。预留额度会按实际用量结算,--probe 用一次廉价的真实调用先验证部署名与密钥,再开始编译。详见压缩指南。
.venv/bin/rma reduce --probe --model gpt-6-astra \
  --credentials-file /private/path/to/credentials.txt --out /path/to/preflight
探索相关项目
affaan-m/ECC
智能体执行与控制框架的性能优化系统。面向 Claude Code、Codex、Opencode、Cursor 等,涵盖技能、本能、记忆、安全与研究优先的开发。
300,313 星标NousResearch/hermes-agent
与你一同成长的智能体
262,134 星标multica-ai/andrej-karpathy-skills
一个用于改进 Claude Code 行为的 CLAUDE.md 文件,源自 Andrej Karpathy 对 LLM 编程陷阱的观察。
231,460 星标firecrawl/firecrawl
借助来自网络及其他来源的数据,强化你的 AI 智能体。正在构建面向超级智能的资料库。🔥
200,178 星标