
rzc156/dreamforge
rzc156/dreamforge has 130 GitHub stars and 3 forks. GitHot measured 0 stars in 24 hours and 0 in 7 days. Last checked 2026-11-17 22:44 UTC. Last push 2026-10-12.
实测星标增长
- 24小时
- 0
- 7天
- 0
- 15天
- 更新延迟
- 1个月
- 更新延迟
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
关于
Turn world-model imagination into corrective training data for robot policies — a single-GPU, falsifiable pipeline (SmolVLA · LIBERO · CEM · paired simulator replays).
机器学习README_zh.md
原文
dreamforge
把世界模型的"想象"变成机器人策略的纠错训练数据。
单卡可跑、端到端、可证伪:每一条想象出来的动作,都会先在真实仿真器里回放验证,再决定是否值得用作训练数据。





为什么做这个
前一项受控研究证明:对一个已经很强的 flow-matching VLA,测试时动作选择(采样多个候选动作块、让世界模型挑一个)几乎没有余量,且世界模型的离线打分不能代理决策质量。
于是自然的问题:
如果想象不能用于选择,那能不能用于教?
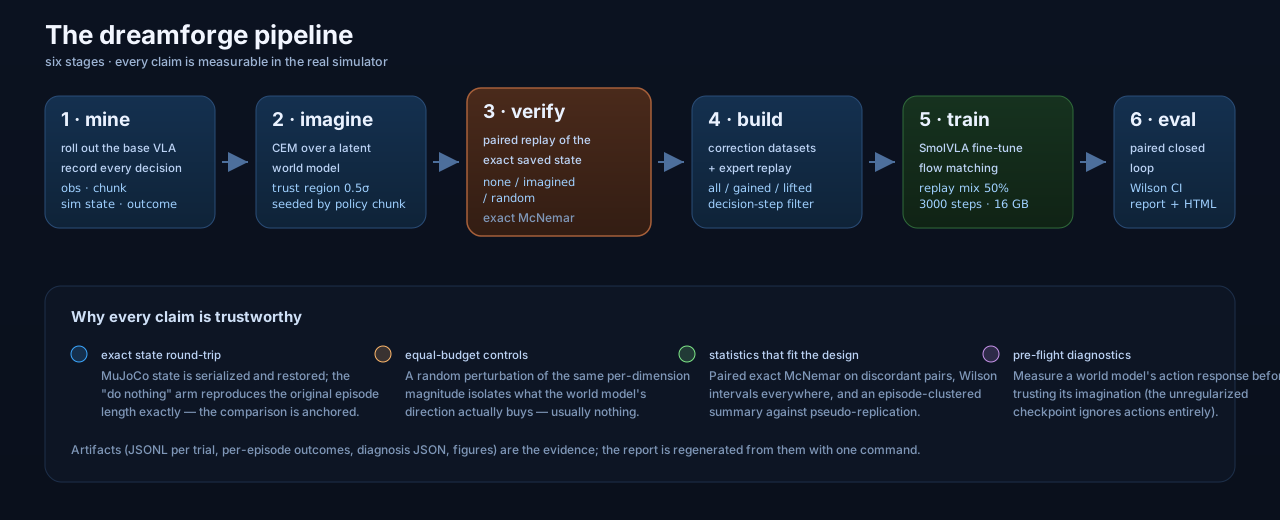
dreamforge 端到端回答它:挖掘策略自身的失败状态 → 用潜空间世界模型 CEM 搜索纠错动作块 → 把精确仿真状态回放一遍做验证 → 再决定是否值得拿去做微调数据。
主要结果
LIBERO-Spatial · SmolVLA-450M · 150 回合采矿 → 360 个失败状态 · 1080+ 次配对仿真回放 · 单张 RTX 5080。完整记录见 docs/results.md。
| 实验 | 结果 |
|---|---|
世界模型预检(diagnose) |
未正则化 WM 动作响应 0.0003 vs 动作敏感版 0.0163(~50×) |
| 想象进度(CEM) | 0.480 → 0.500(+0.020) |
| 纠错的真实价值(360 配对状态) | none 9.4% · imagined 13.6% · random 14.7% |
| imagined vs none | +4.2pp,exact McNemar p = 0.032 |
| imagined vs 等预算随机 | −1.1pp,p = 0.61 —— 世界模型的"方向"没有价值 |
用纠错数据微调(ft_all) |
57.0% vs 基线 61.0% vs 对照 58.0%(p = 1.0) |
把纠错集中在"指标最看好"的开局(ft_early) |
45.0% —— 比对照还低 13pp(p = 0.041) |
这说明什么(展开)
世界模型想象确实能改变结果,但与同尺度的随机扰动没有差别,训练侧也不优于"只用专家数据回放"的对照。更反直觉的是:把纠错数据集中到决策点指标最看好的位置,反而显著变差——因为那些状态并非必然失败(策略在同一初始状态上多数是成功的),在这些状态上模仿"扰动"会覆盖本来正确的行为。
由此得到的可操作准则,也是本仓库的重点: 上线世界模型前,先(1)测它的动作响应,(2)与等预算随机扰动做对照,(3)不要把决策点指标当训练信号。
交互式仪表盘
每次运行都能从工件生成一个自包含 HTML 仪表盘(无 CDN、无 JS),适合当报告、贴 PR 或挂 GitHub Pages。 页面内置纯 CSS 的中英切换(隐藏单选按钮 + 兄弟选择器),因此始终保持零脚本。
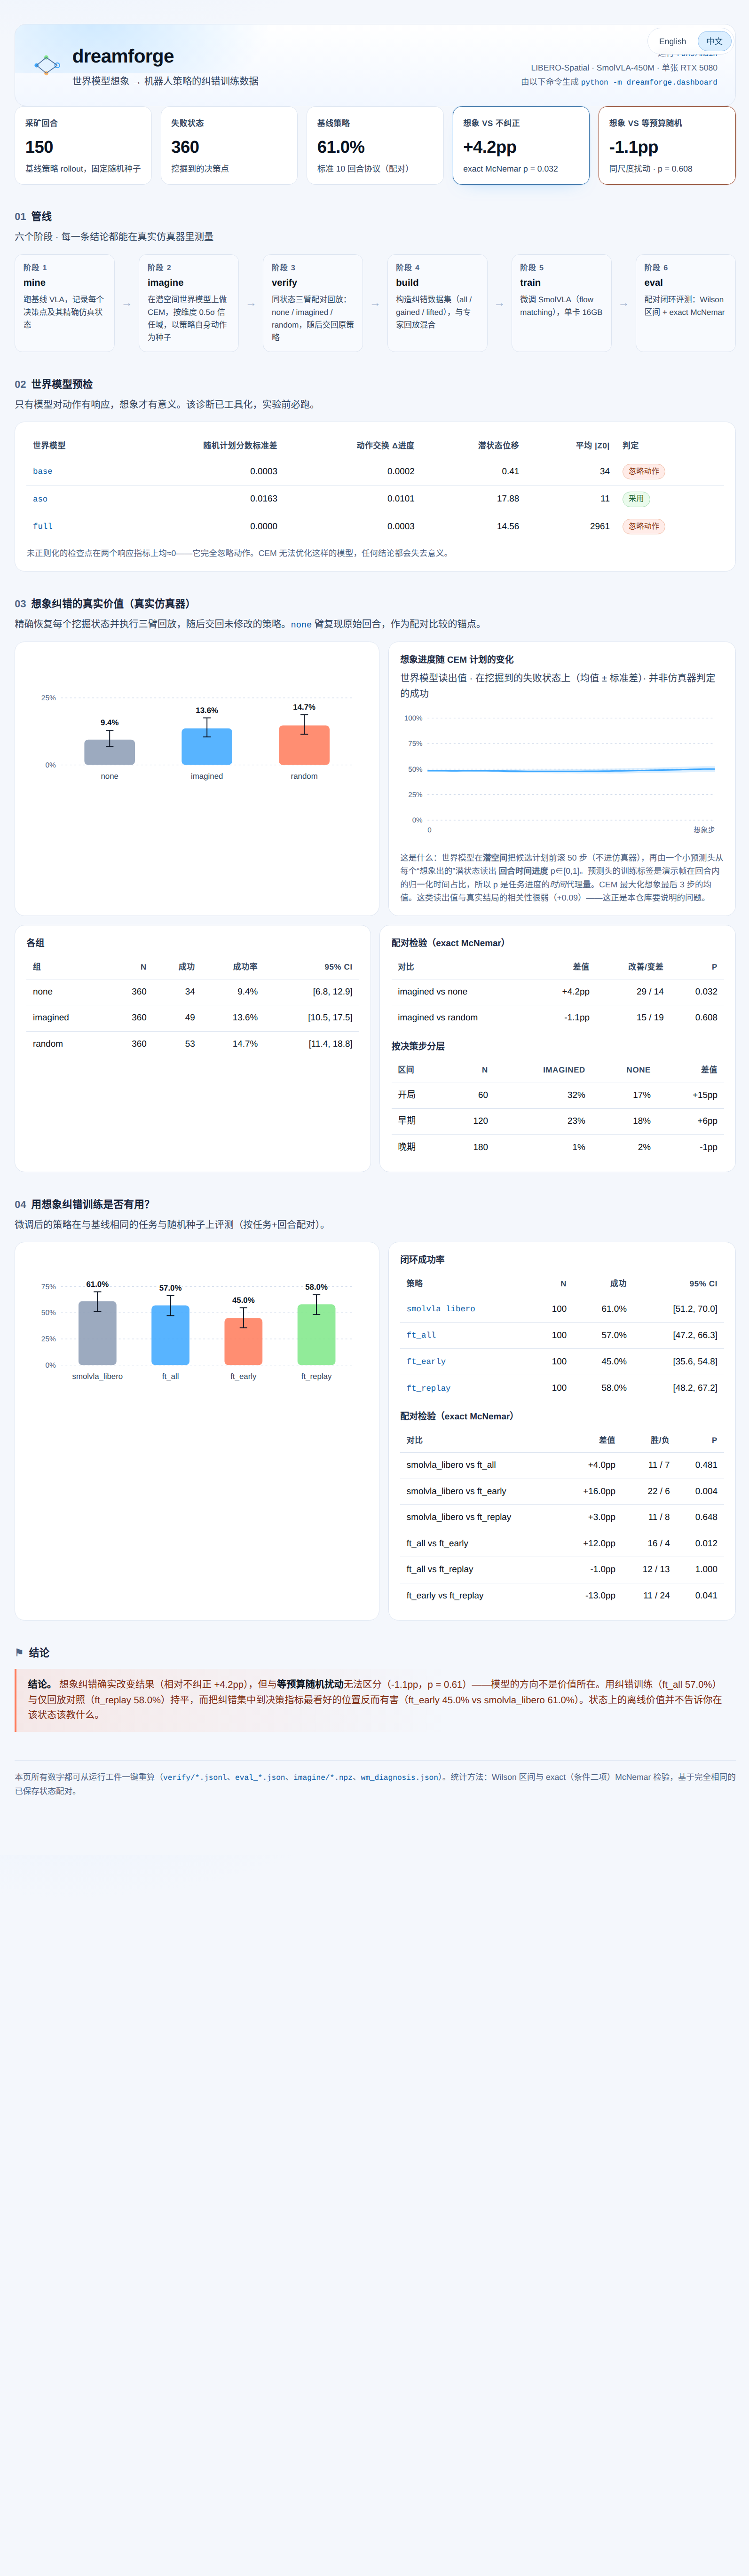
python -m dreamforge.dashboard --run runs/main --out results/dashboard.html
仓库内的成品见 results/dashboard.html(英文视图见
assets/dashboard.png)。
快速开始
pip install -e . --no-deps     # 本包只依赖 numpy + torch
pytest tests -q                # 10 项测试,纯 CPU

RUN=runs/main
python -m dreamforge.mine     --task libero_spatial --episodes 15 --out $RUN/mine
python -m dreamforge.diagnose --mine $RUN/mine --wms base aso --out $RUN/wm_diagnosis.json
python -m dreamforge.imagine  --mine $RUN/mine --out $RUN/imagine --wm aso --delta-sigma 0.5
python -m dreamforge.verify   --mine $RUN/mine --imagine $RUN/imagine --out $RUN/verify \
                              --arms none imagined random --exec-horizon 16
python -m dreamforge.build    --mine $RUN/mine --imagine $RUN/imagine --out $RUN/build_all --filter all
python -m dreamforge.train    --samples $RUN/build_all --out $RUN/ft_all --steps 3000
python -m dreamforge.eval     --policy-path $RUN/ft_all --task libero_spatial --episodes 10 \
                              --out $RUN/eval_ft_all.json
python -m dreamforge.report   --run $RUN            # Markdown + 图表
python -m dreamforge.dashboard --run $RUN           # HTML 仪表盘
命令一览
| 命令 | 作用 |
|---|---|
mine |
跑基线策略,记录每个决策点(观测、动作块、精确仿真状态、结局) |
imagine |
潜空间世界模型上的 CEM;按维度 0.5σ 信任域,以策略自身的动作为种子 |
verify |
同状态三臂配对回放:none / imagined / random,随后交回原策略 |
build |
纠错数据集:all / gained(世界模型打分)/ lifted(仿真验证),支持按决策步过滤 |
train |
用纠错数据 + 专家回放微调 SmolVLA(flow matching) |
eval |
配对闭环评测(Wilson 区间 + exact McNemar) |
report / dashboard |
Markdown 报告 + 自包含 HTML 仪表盘 |
diagnose |
世界模型预检:它到底会不会对动作做出响应? |
figures |
论文风格图表 |
目录结构
src/dreamforge/
  wm.py         潜空间世界模型 + 进度头
  cem.py        CEM 规划器(信任域、数据集原始动作空间)
  envs.py       LIBERO 环境封装 —— 精确 MuJoCo 状态存取
  policy.py     SmolVLA 加载与观测/动作管线
  mining.py     阶段1  ·  imagine.py 阶段2  ·  verify.py 阶段3
  dataset.py    阶段4  ·  finetune.py 阶段5  ·  evaluate.py 阶段6
  report.py     配对统计   ·  dashboard.py  HTML 界面
  figures.py    绘图       ·  diagnose.py   世界模型预检
  stats.py      Wilson / exact McNemar
assets/         横幅、管线图、仪表盘截图
docs/           protocol.md · results.md · resume.md(求职材料)
results/        精选可查证工件(报告、图表、配对记录、评测)
scripts/        run_main.sh · run_training.sh · run_ladder.sh · probe_env.py
tests/          统计 · CEM(含信任域)· 数据过滤
设计原则
- 先测量再下结论:纠错动作必须在仿真器回放;
none组复现原回合,作为配对比较的锚点。 - 控制预算:任何"模型指导"的结果都与同尺度随机扰动对照。
- 统计匹配设计:配对 exact McNemar、Wilson 区间、按 episode 聚合(防伪重复)。
- 让静默 bug 大声暴露:靠这套纪律抓出并修复了三个真实问题——无约束 CEM 产生的 OOD 动作(归一化目标 ×6)、状态双重归一化、checkpoint 未随处理器管线保存。
路线图
- 用多个训练种子复现"定向纠错导致下降"
- 大偏差预算扫描(大随机扰动有害;大的模型指导偏差是否有效?—— 未解机理问题)
- 第二个任务套件 / 基策略,以及视频世界模型
-
verify多进程并行(trial 是 CPU 瓶颈)
引用与致谢
潜空间世界模型、CEM 接口与评测协议改编自作者此前的科研项目(near-zero-headroom,论文在审),已获授权复用。使用本仓库请参考 CITATION.cff。
许可
MIT —— 见 LICENSE。