
purecodework/bookllm
purecodework/bookllm has 44 GitHub stars and 1 forks. GitHot measured 0 stars in 24 hours. Last checked 2026-11-09 23:19 UTC. Last push 2026-10-11.
Translate books and documents with LLMs, featuring glossary extraction, review, and polishing pipelines.
可以做什么
- OpenAI-compatible Works with OpenAI-compatible providers and runtimes, including OpenAI, DeepSeek, OpenRouter, Ollama, LM Studio, and OMLX. - Live Reader Stream translations directly into a bilingual long-form reading interface. - Multi-stage Pipeline Translate with optional glossary extraction, review, and polishing stages.
- Sidekick Model Use Sidekick as an optional second model for review, polishing, or quality-focused stages. - Glossary Support Maintain per-page glossary context, with optional whole-book extraction. - PDF / OCR Support Extract text from PDFs and use bundled OCR for scanned pages.
实测星标增长
- 24小时
- 0
- 7天
- 正在收集历史
- 15天
- 正在收集历史
- 1个月
- 正在收集历史
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
README_ZH.md
原文BookLLM


BookLLM 是一个面向长文本阅读和迭代式翻译流程的文档与图书翻译应用。
支持 OpenAI兼容的 API 和本地LLM平台,并提供多阶段翻译流水线,包括术语表提取、翻译、校对和润色。
当前语言选项支持中文、英文、日文、韩文、法文、德文、西班牙文、俄文之间互译;原文语言也可以选择自动识别。
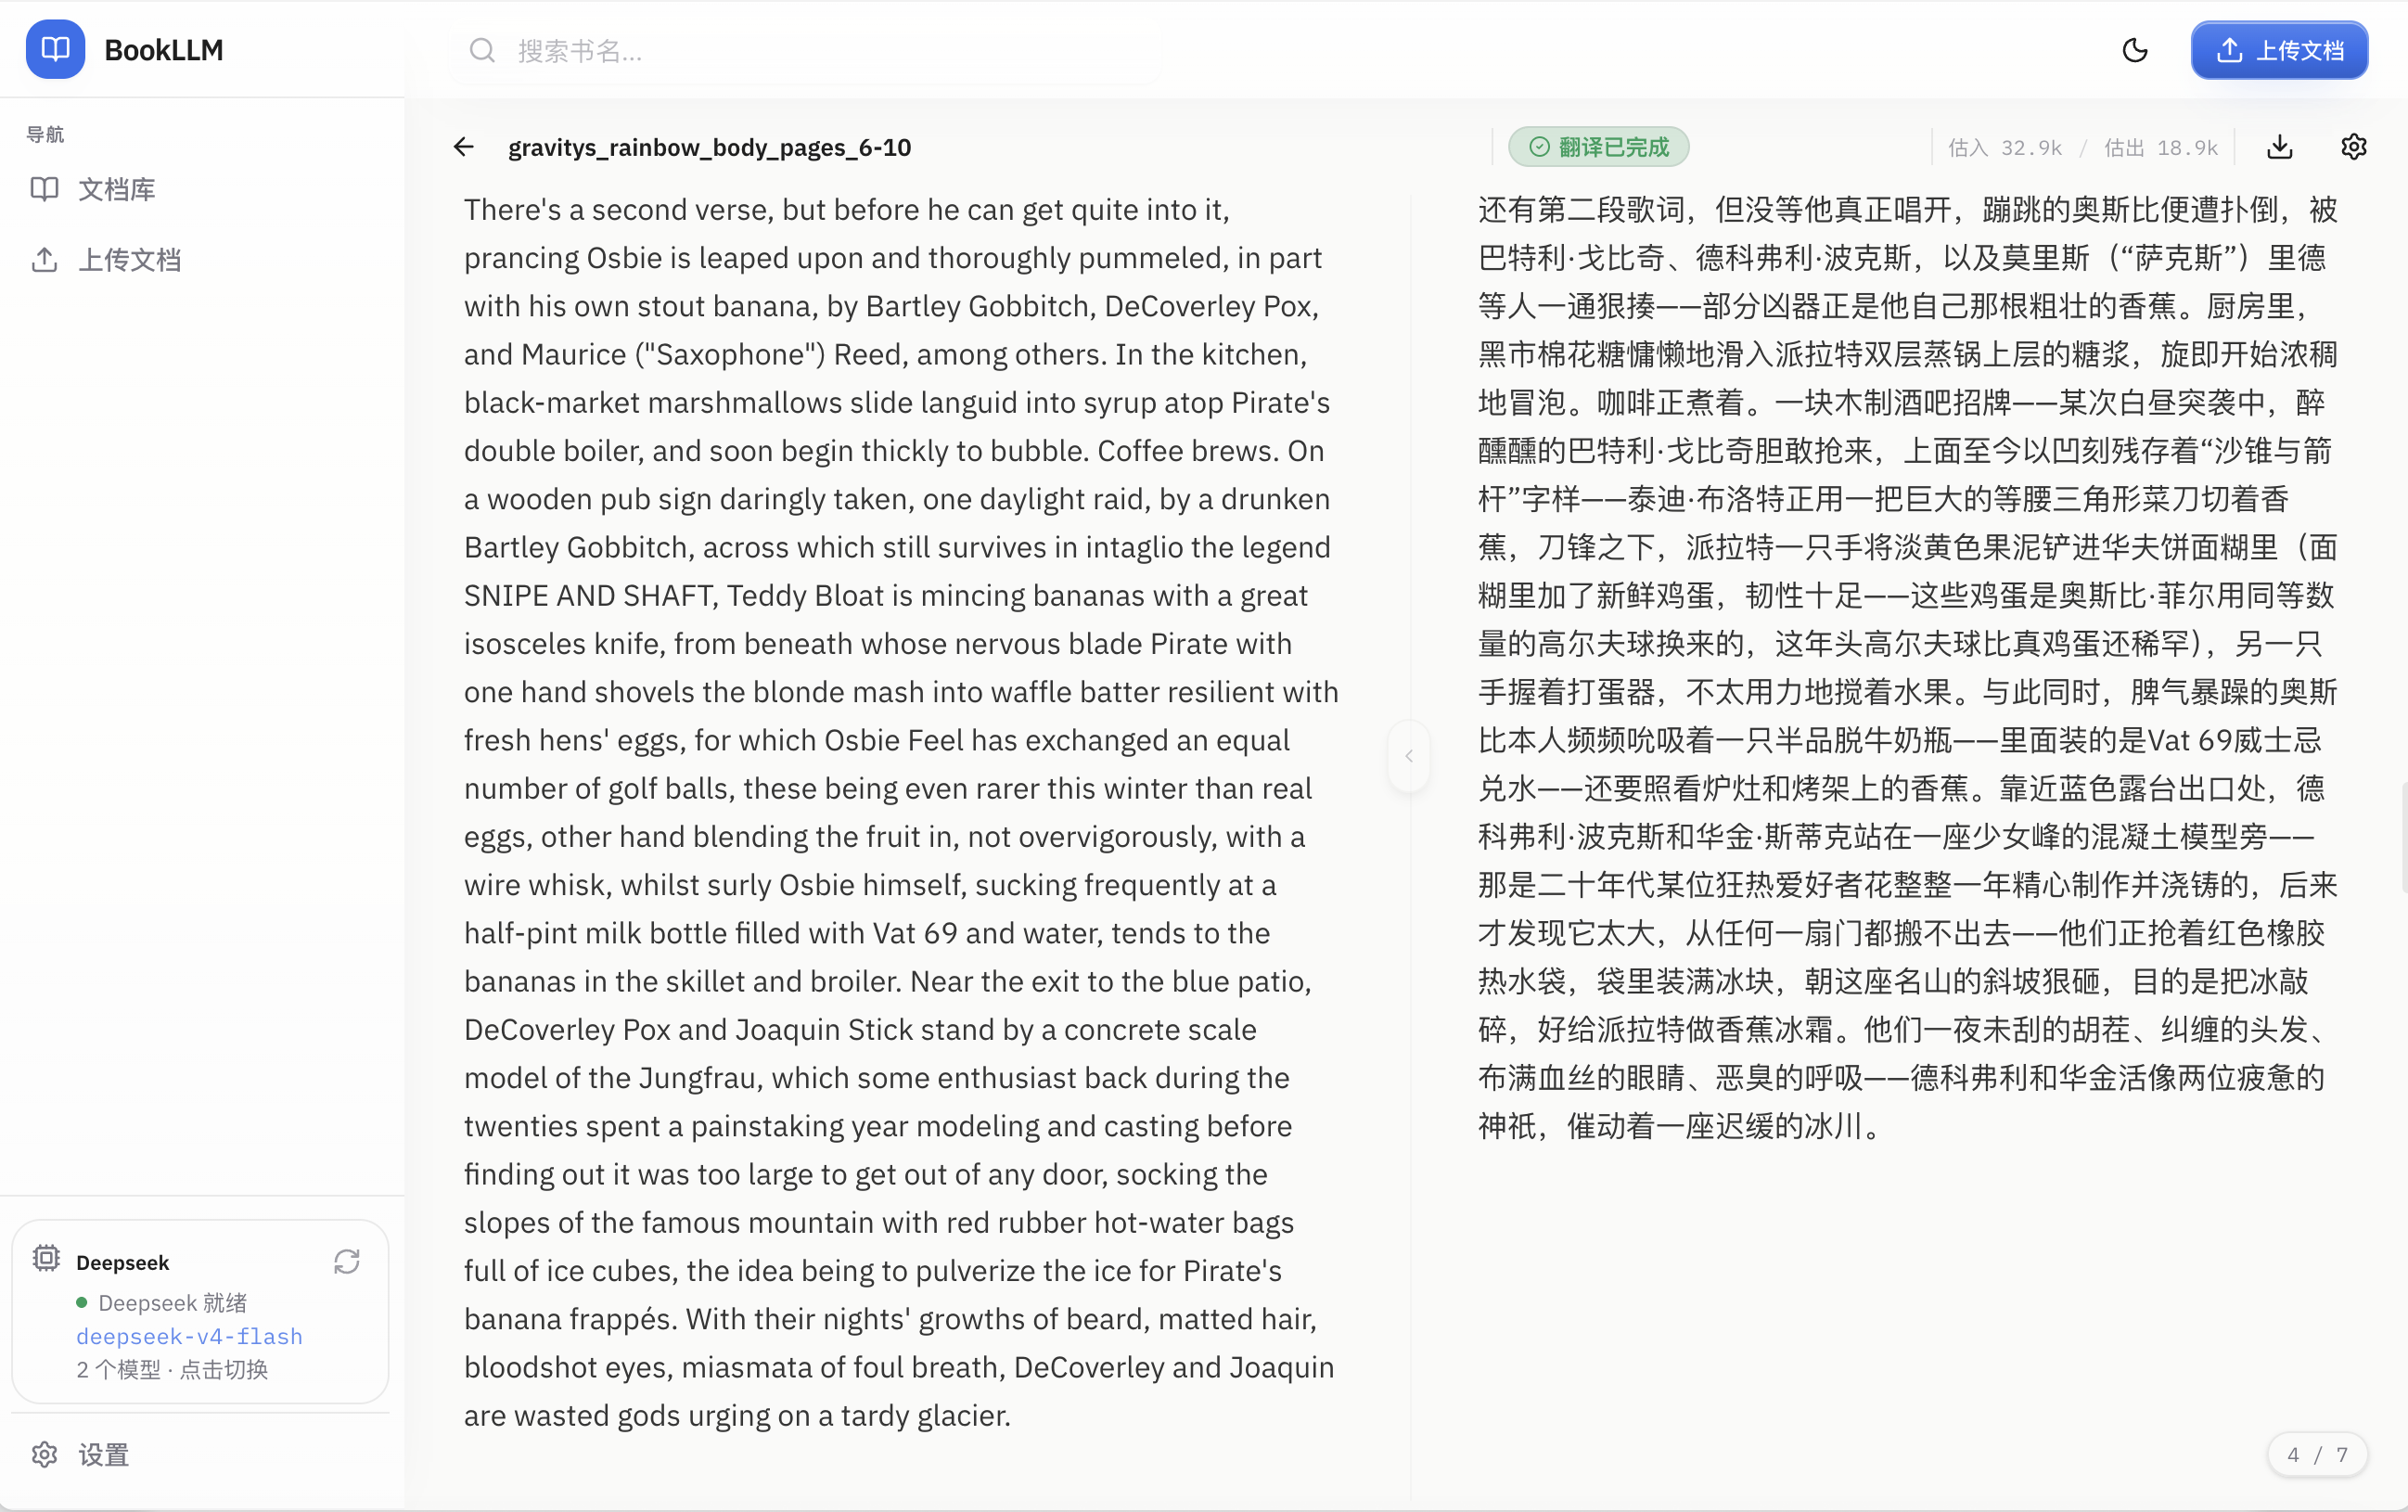
支持双语长文本阅读,并可实时显示翻译输出。
功能特性
|
OpenAI-compatible 支持 支持 OpenAI兼容的 服务商与本地运行环境,例如 OpenAI、DeepSeek、OpenRouter、OMLX 等。 |
实时阅读器 翻译生成过程中,内容可以直接流式写入双语长文本阅读界面。 |
多阶段翻译流水线 支持翻译流程中可选启用术语表提取、校对和润色阶段。 |
|
第二模型 可选为第二模型,用于校对、润色或其他质量增强阶段。 |
术语表支持 默认维护分页级累计术语上下文,也可选择进行整本书术语表提取。 |
PDF / OCR 支持 支持从 PDF 中提取文本,并可通过内置 OCR 处理扫描页。 |
截图
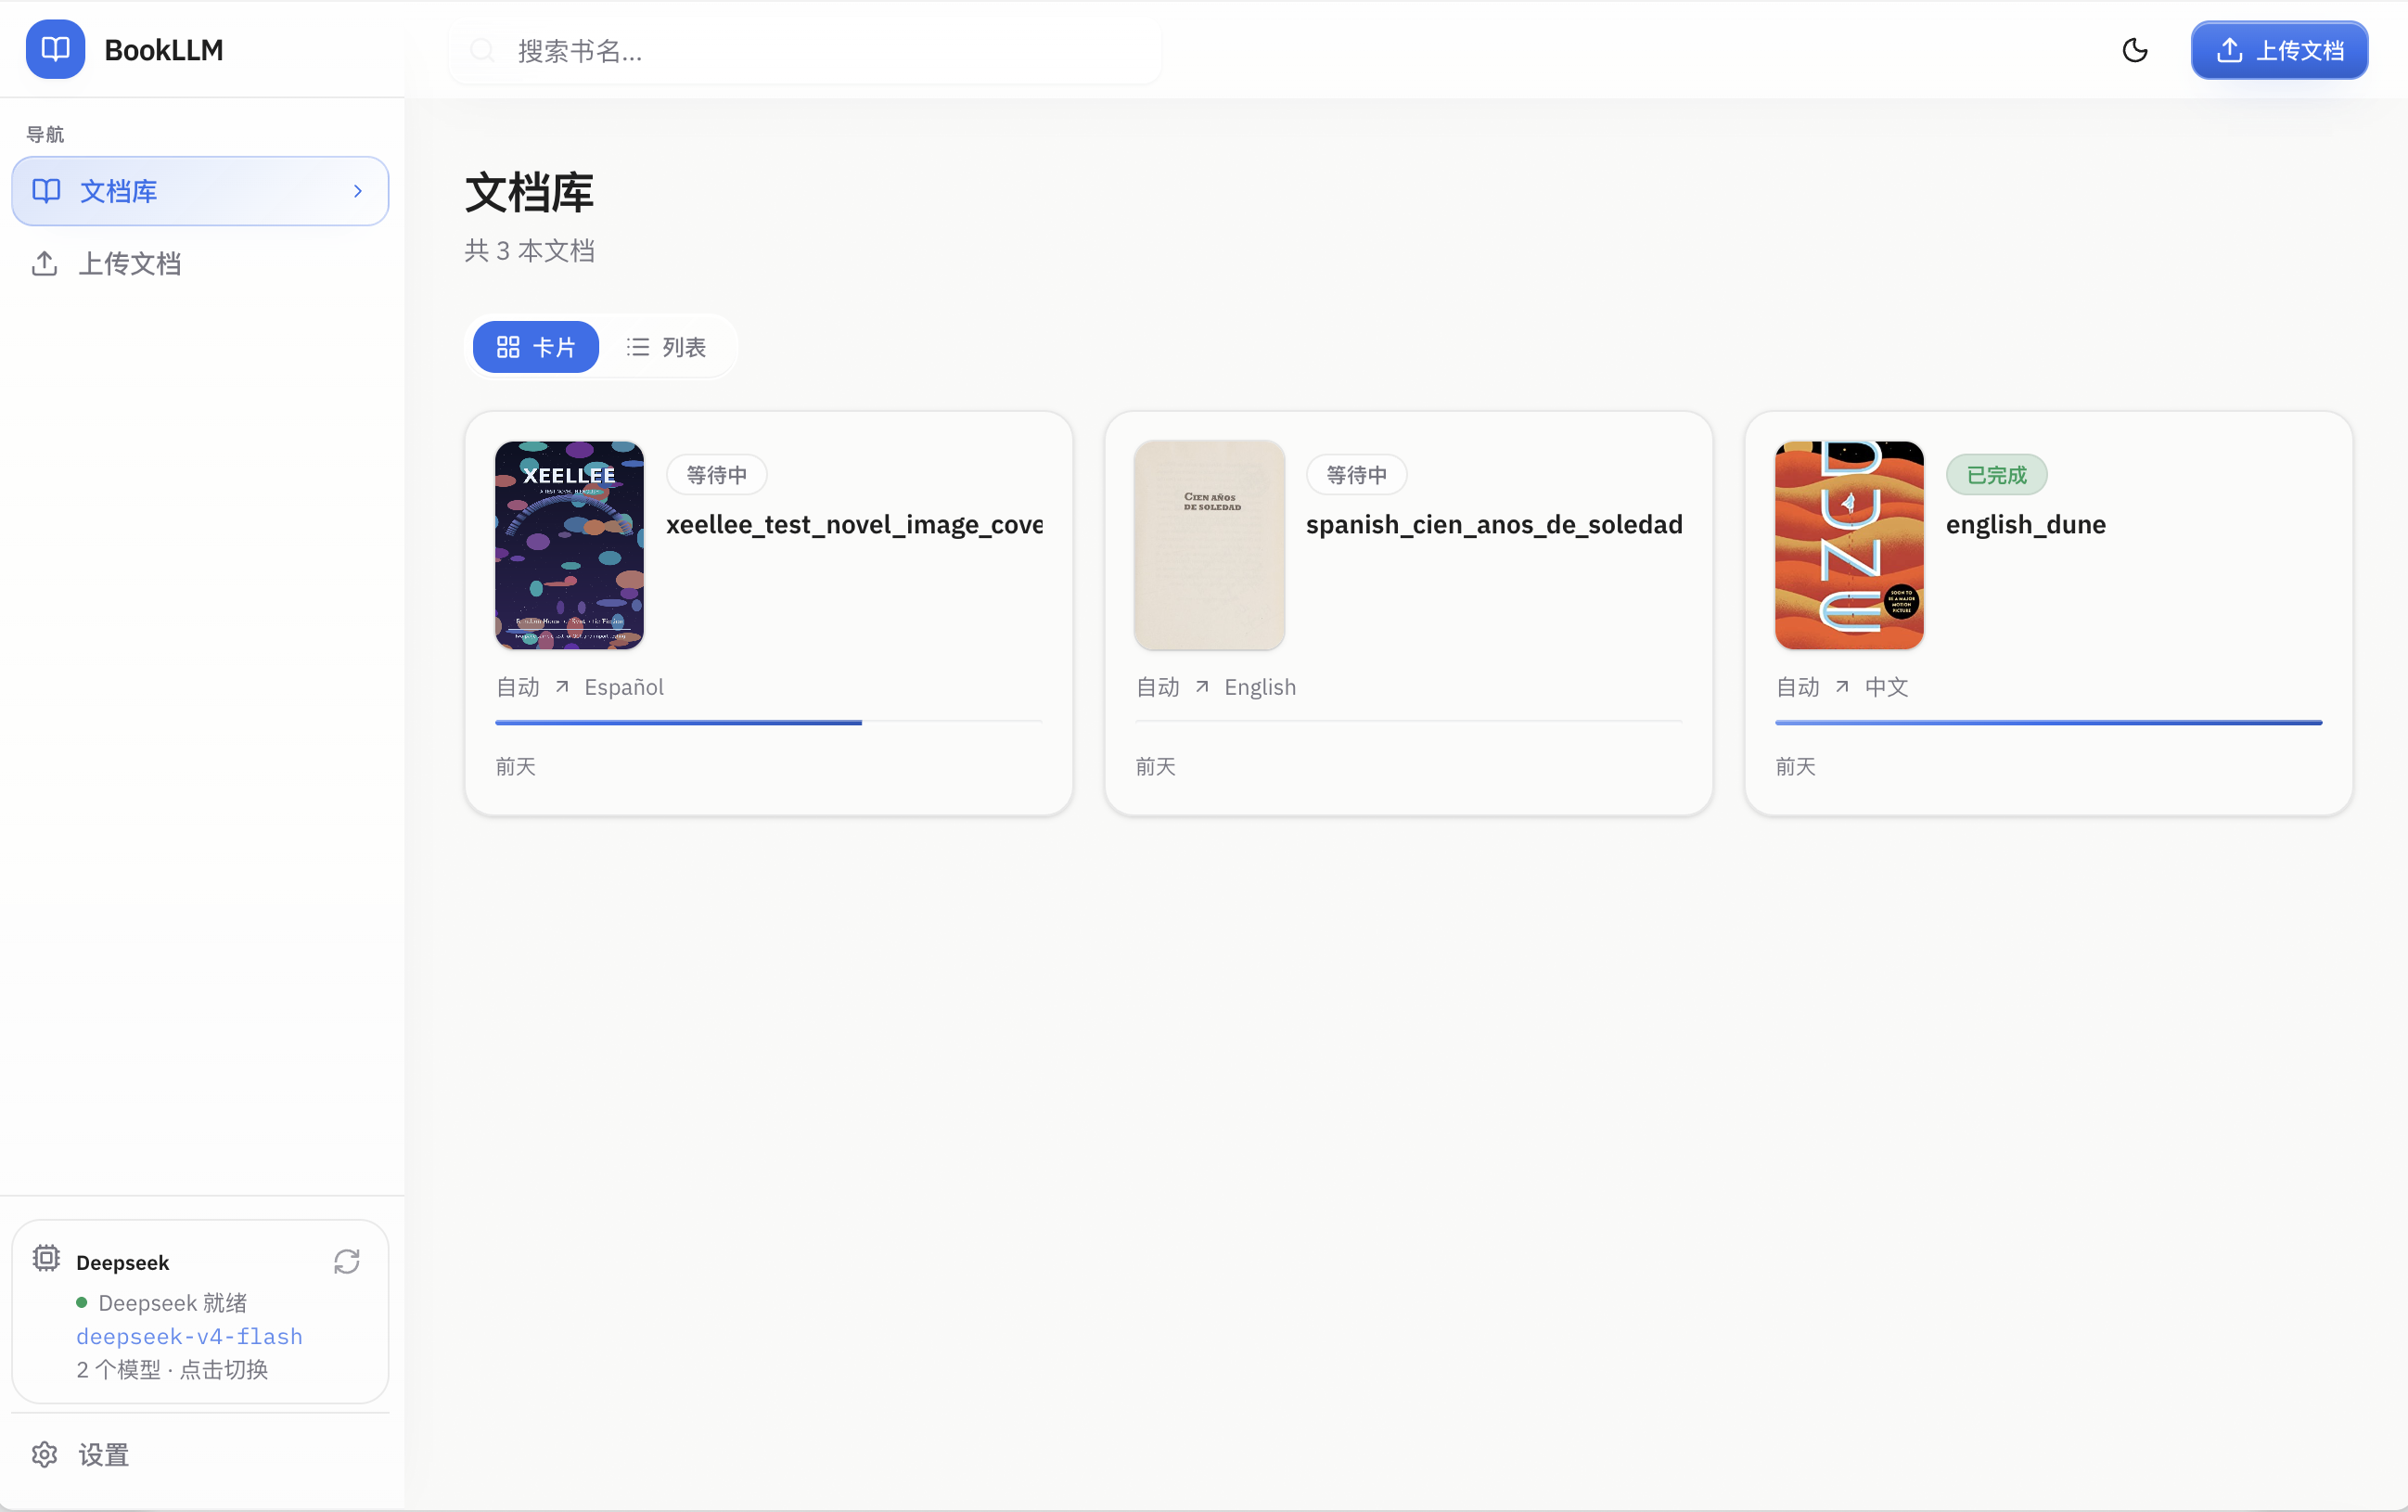
书库 管理书籍、翻译进度与翻译任务。 |
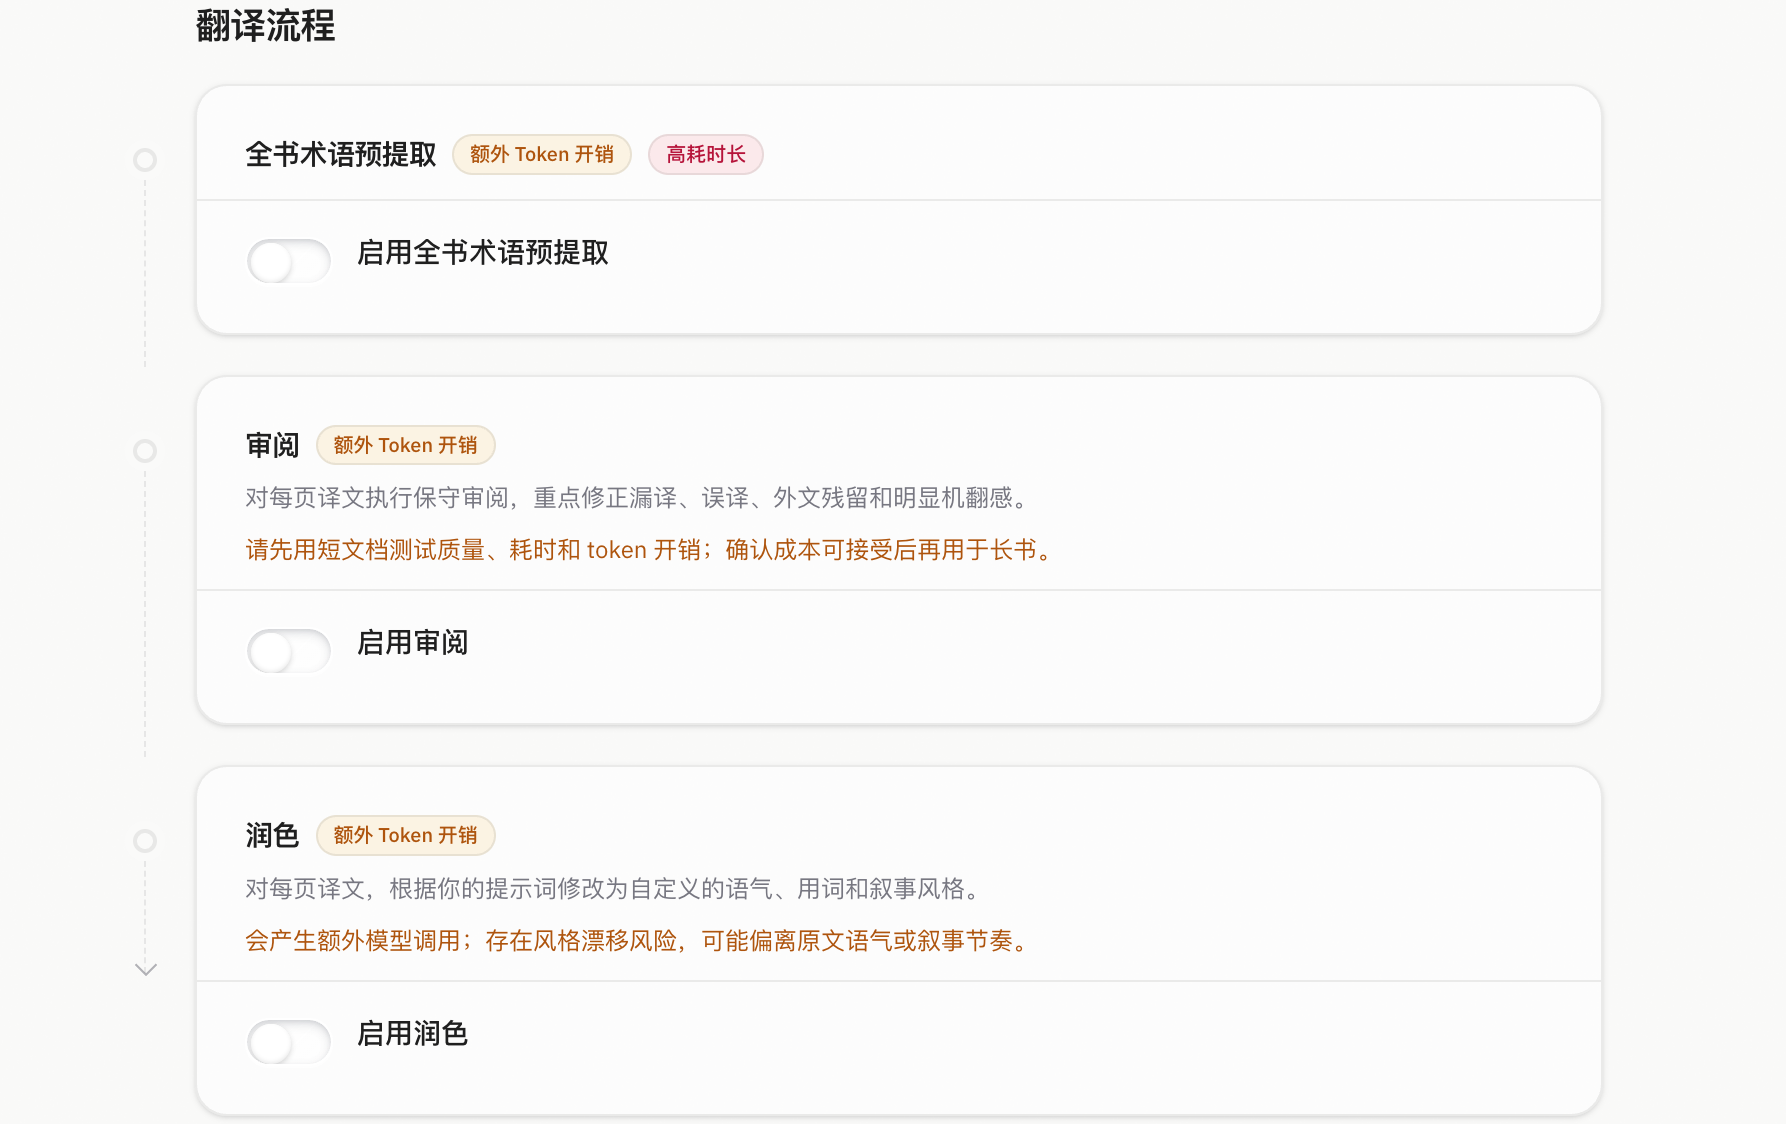
翻译流水线 配置术语表、校对和润色阶段。 |
Pipeline 成本提醒
[!IMPORTANT]
启用可选的 Pipeline 选项会显著增加 token 消耗、API 成本和处理时间。
这些阶段可能提升翻译质量,但边际收益不一定足以抵消额外成本和延迟,通常不建议开启。
在对长文档启用完整 Pipeline 之前,建议先使用短文本或小段摘录进行测试。请比较输出质量、处理时间和 token 使用量。
快速开始
使用 Docker Compose 在本地运行 BookLLM。
git clone https://github.com/purecodework/bookllm.git
cd BookLLM
docker compose up -d --build
然后打开:
http://localhost:3000
初始设置
- 从侧边栏打开 Model Connection。
- 配置你的 OpenAI-compatible endpoint:
- 基础 URL:需要兼容OpenAI API协议,期待
/v1端点,比如:https://api.deepseek.com/v1 - API 密钥
- 模型
- 基础 URL:需要兼容OpenAI API协议,期待
- 可选:如果你使用的是托管 API 服务商,而不是本地模型运行环境,可以在 Settings 中调整输入 token 上限和并发数,以提升吞吐速度。
- 上传 EPUB、PDF 或 TXT 文件,开始翻译。
架构
Next.js frontend
  -> NestJS API + SSE
     -> PostgreSQL: books, pages, settings, glossary/context, token usage
     -> Redis: BullMQ queues, job state, event fanout
     -> Translation workers: chunking, glossary/context, translation, review, polish, export
     -> FastAPI OCR service: PyMuPDF + Tesseract
     -> Local asset storage: originals, covers, extracted images
     -> OpenAI-compatible LLM endpoints: primary + optional Sidekick
已知限制
- UI 中显示的 token 使用量为近似值,实际计费请以服务商后台为准。
- OCR 不会保留原始版面布局。
License
MIT
探索相关项目
affaan-m/ECC
智能体执行与控制框架的性能优化系统。面向 Claude Code、Codex、Opencode、Cursor 等,涵盖技能、本能、记忆、安全与研究优先的开发。
300,226 星标NousResearch/hermes-agent
与你一同成长的智能体
262,069 星标multica-ai/andrej-karpathy-skills
一个用于改进 Claude Code 行为的 CLAUDE.md 文件,源自 Andrej Karpathy 对 LLM 编程陷阱的观察。
231,356 星标firecrawl/firecrawl
借助来自网络及其他来源的数据,强化你的 AI 智能体。正在构建面向超级智能的资料库。🔥
199,847 星标