
pablocaeg/sloptotal
pablocaeg/sloptotal has 121 GitHub stars and 44 forks. GitHot measured +2 stars in 24 hours, +17 in 7 days, and +36 in 15 days. Last checked 2026-11-17 02:29 UTC. Last push 2026-11-03.
可以做什么
- 23 detection engines, one calibrated score. DeBERTa and RoBERTa classifiers, Binoculars, Fast-DetectGPT, GLTR, perplexity and burstiness tests, and stock-phrase heuristics. Results stream in as each engine finishes.
- Text, URLs and documents. Paste text, scan a web page (main content is extracted automatically), or upload .pdf, .docx, .txt or .md.
- Site check: was this website vibe-coded? Finds the fingerprints that Lovable, v0, Bolt, Base44, Replit, Same and Emergent leave in the sites they deploy, and shows the evidence for each one. How it works
- Per-paragraph heat map through the API, to see which parts read as AI.
实测星标增长
- 24小时
- +2
- 7天
- +17
- 15天
- +36
- 1个月
- 正在收集历史
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
关于
Open-source AI text detector and ChatGPT detector: 23 engines, one calibrated score, every number measured on a public benchmark. Self-hosted, runs on CPU.
人工智能README.zh-CN.md
原文




English · 简体中文 · Русский · Español
SlopTotal
AI 生成文本的 VirusTotal。 粘贴一段文字、上传 PDF 或 Word 文件,或者给出一个网址。23 个相互独立的 AI 检测器(神经网络分类器、统计检验和语言学启发式规则)会同时给它打分,再由一个经过校准的集成模型把这些投票合成一个结论,而且每个引擎的结果你都能逐一查看。它在你自己的 CPU 上运行,扫描的内容不会离开你的机器。
它是 GPTZero、Originality.ai、Copyleaks、ZeroGPT 等在线 AI 检测服务的免费、可自托管的开源替代品。它给你的不是某一个模型的一个数字,而是每个模型的判断,并且公开自己的准确率,包括失败的地方。
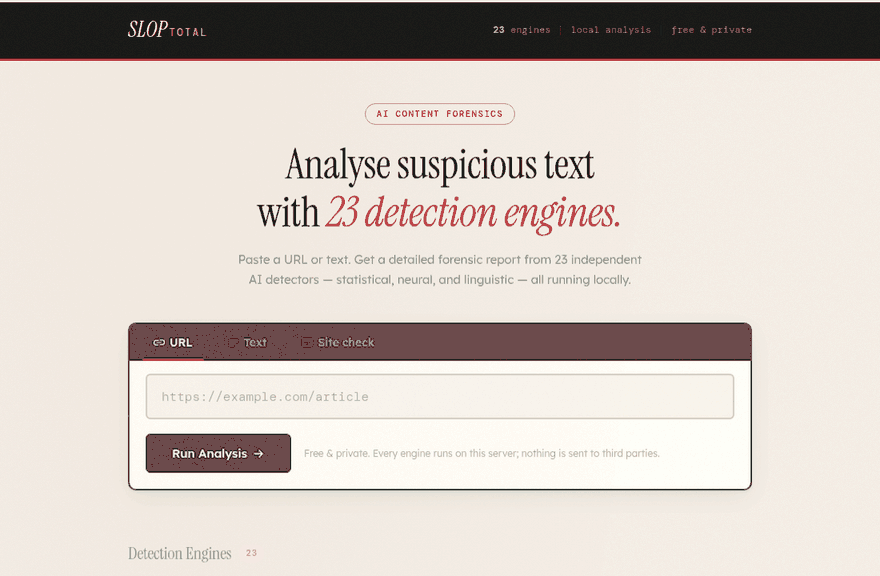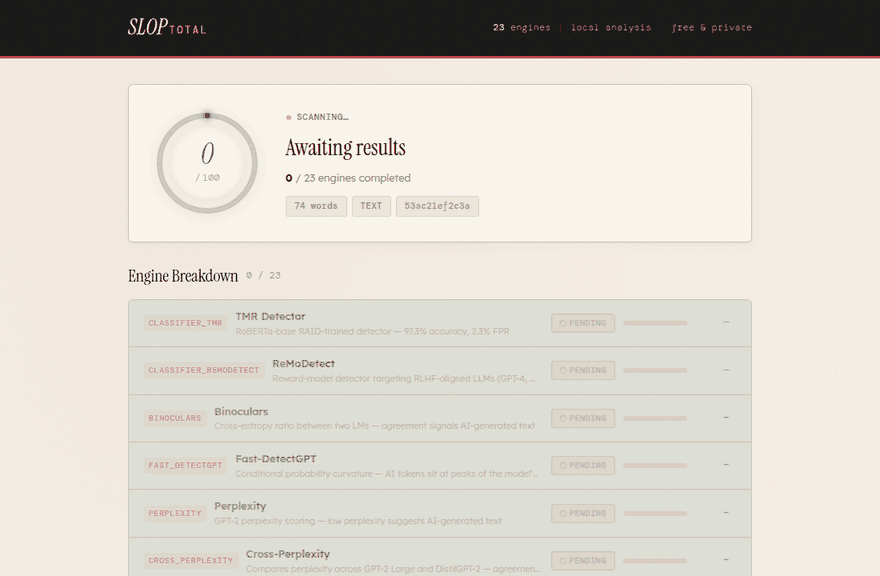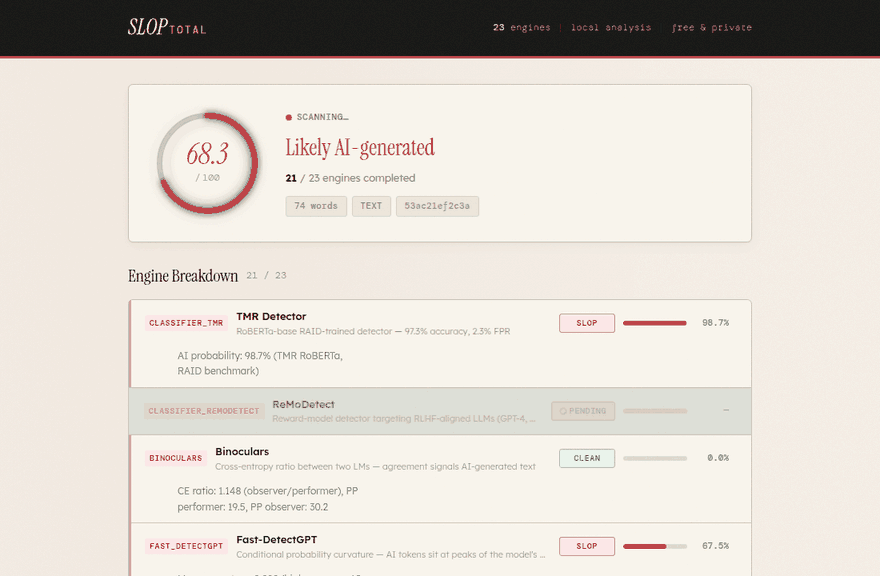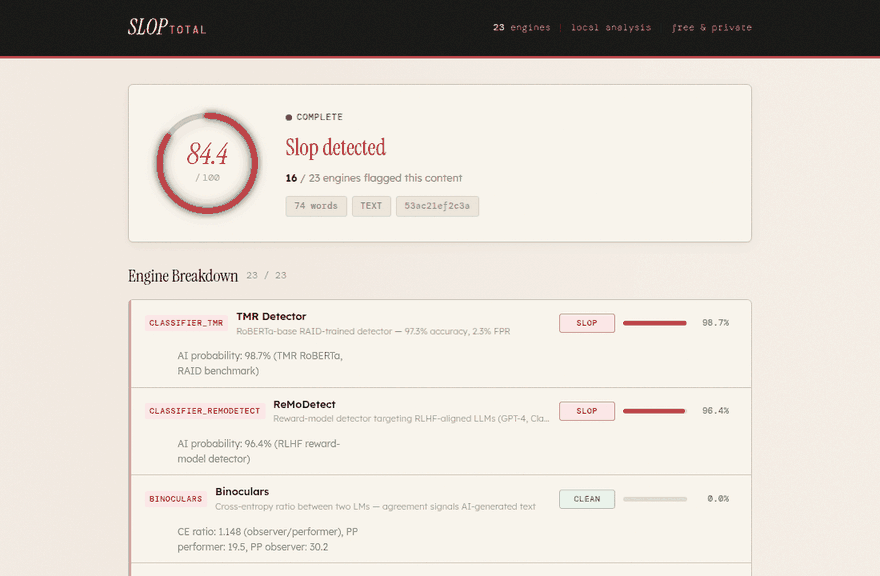
在线试用: sloptotal.com/zh · 本地运行: docker run -p 8000:8000 ghcr.io/pablocaeg/sloptotal
本文是 英文 README 的中文版。如有出入,以英文版为准。
功能
- 23 个检测引擎,一个校准后的分数。 DeBERTa 和 RoBERTa 分类器、Binoculars、Fast-DetectGPT、GLTR、困惑度与突发性(burstiness)检验,以及套话识别。每个引擎完成后,结果会实时显示。
- 文本、网址和文档。 粘贴文字,扫描网页(自动提取正文),或上传
.pdf、.docx、.txt、.md文件。 - 网站检查:这个网站是 AI 搭的吗? 识别 Lovable、v0、Bolt、Base44、Replit、Same 和 Emergent 在它们部署的网站里留下的痕迹,并列出每一条证据。原理
- 按段落的热力图(通过 API),看出哪些部分像 AI 写的。
- 实测,而不是宣称。 下面每个准确率数字都附带语料、测试代码和每个样本的原始分数。
- 默认保护隐私。 自托管,不调用任何第三方 AI API,没有跟踪,报告 30 天后删除。
- 只有 CPU 也可以。 自动识别硬件,GPU 可选。
- JSON API 和 Chrome 扩展,在 Google 搜索和 LinkedIn 上标出疑似 AI 写的结果。
实测准确率
大多数检测器公布一个准确率,却不说是在什么数据上测的。SlopTotal 在 SlopBench 上测试:1,626 篇人类文本(全部写于 ChatGPT 出现之前),以及 1,626 篇同主题、同长度、由 14 个当前模型生成的 AI 文本,覆盖 15 种文体(新闻、维基百科、arXiv、Stack Exchange、Reddit、评论、学生作文、非母语英语写作、小说,以及 1532 至 1915 年间出版的文学作品)。下面每个数字都是在模型没有调过参的文体上测得的。
| AUC | 0.942 |
| AI 文本被判为“很可能是 AI”(55 分以上) | 67% |
| 人类文本被判为“很可能是 AI”(55 分以上) | 1.7% |
| 人类文本被标记(45 分以上) | 3.9% |
| 1532 至 1915 年出版的文学作品被标记 | 87 篇中 0 篇 |
分数区间以人类文本为基准:45 分是人类写作中前 5% 的起点,55 分是前 2%,80 分是前 0.5%。所以“很可能是 AI”意味着 100 篇人类文本里不到 2 篇会得到这么高的分。
其他语言。 西班牙语、法语、德语、意大利语、葡萄牙语、荷兰语、波兰语、俄语和日语已经支持(AUC 0.91 到 0.997);阿拉伯语和韩语处于实验阶段。中文目前还不可靠,报告里会明确标出这一点。我们宁愿说清楚,也不愿给出一个看似精确的数字。如果你有中文的人类和 AI 文本语料,欢迎一起改进。
做不到的事。 非英语母语者写的英语作文仍然比母语者更容易被标记(15% 的 TOEFL 作文被判为“很可能是 AI”,而 88 篇美国学校作文一篇都没有)。少于约 80 个词时,分数只是弱信号。经过“人性化改写”(humanizer)的 AI 文本大约只有一半能被识别。源代码不在这些引擎的能力范围内。按来源、按模型、按引擎的全部结果都在 findings 里,包括一个发现:在 RAID 基准上名列前茅的分类器,在当前模型上会掉到 AUC 0.75。
快速开始
Docker(最快)
docker run -p 8000:8000 -v sloptotal-models:/app/models ghcr.io/pablocaeg/sloptotal
打开 http://localhost:8000。第一次扫描会把模型(约 9 GB,见 docs/MODELS.md)下载到 sloptotal-models 卷里,之后启动就很快了。
在中国大陆: Hugging Face 无法直接访问,可以用镜像下载模型:
docker run -p 8000:8000 -e HF_ENDPOINT=https://hf-mirror.com \
  -v sloptotal-models:/app/models ghcr.io/pablocaeg/sloptotal
从源码运行时同样设置 export HF_ENDPOINT=https://hf-mirror.com 即可。
从源码运行
需要 Python 3.10+。
git clone https://github.com/pablocaeg/sloptotal.git
cd sloptotal
python3.11 -m venv venv && source venv/bin/activate
pip install -r requirements.txt
./scripts/start.sh    # 或者:uvicorn app.main:app --port 8000
端到端检查每个引擎都能加载并打分:
python scripts/smoke_test.py # 默认连接 http://localhost:8000
网站检查:识别 AI 建站工具做的网站
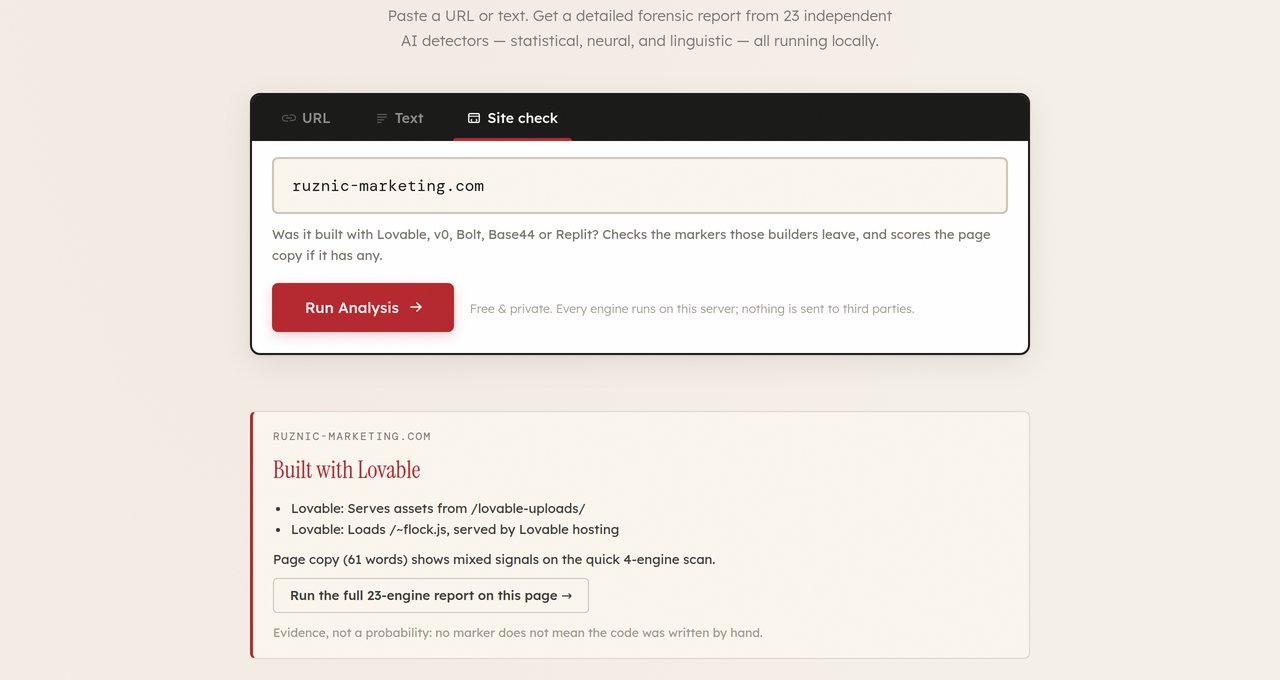
“这个网站是 vibe coding 出来的吗?”这类检查工具大多是给风格打分(Tailwind 类名数量、缺少安全响应头、流行词),再换算成一个百分比。可手写的网站同样具备这些特征。SlopTotal 只找建站工具自己在部署的网站里留下的标记,每一个都在线上网站或工具自带的模板里确认过:
| 建站工具 | 指纹 |
|---|---|
| Lovable | gptengineer.js 运行时、/lovable-uploads/ 资源、Lovable 徽标、/~flock.js、*.lovable.app |
| v0 (Vercel) | v0 布局模板中的 <meta name="generator" content="v0.app">、*.vusercontent.net |
| Bolt | X-Powered-By: Bolt.new 响应头、bolt.new/badge.js、*.bolt.host |
| Base44 | app.base44.com 平台调用、base44_access_token、*.base44.app |
| Replit | Replit Agent 开发横幅、Replit 徽标、*.replit.app |
| Same | 来自 same-assets.com 的资源 |
| Emergent | __emg_sid 和 __emg_vid Cookie、emergent-main.js 脚本、*.emergent.host |
没有标记的网站仍然可能是用 AI 写的:从这些工具导出、托管在别处的代码,或者在 AI 编辑器里写的代码,都不会留下指纹。所以结果是证据,而不是概率。页面上的文字会另外由文本引擎打分。
curl -X POST http://localhost:8000/api/scan/site \
  -H "Content-Type: application/json" -d '{"url": "example.com"}'
API
curl -X POST http://localhost:8000/api/analyze \
  -H "Content-Type: application/json" \
  -d '{"text": "要检测的文本..."}'
返回结果列出每个引擎的分数、结论和一句通俗的说明,以及 overall_score(0 到 100)和 overall_verdict。另外还有快速评分、按段落评分、批量扫描、文档提取等接口,完整列表见英文 README 的 API 部分。examples/ 里有 Python 和 Node.js 客户端示例。
sloptotal.com 上的公共服务面向网页和浏览器扩展。如果需要大量调用,请自己部署一个实例:它开源、免费,而且没有调用次数限制。
检测引擎
23 个引擎分为三类:
- 神经网络分类器(9 个): Desklib DeBERTa、SuperAnnotate、E5-Small、TMR、BERT-tiny RAID、ReMoDetect、ChatGPT Detector、Fakespot、OpenAI Detector。
- 统计方法(7 个): Log-Rank、GLTR、困惑度、交叉困惑度、Fast-DetectGPT、Binoculars、DivEye。
- 语言学启发式规则(7 个): 结构分析、语言标记(“delve”“tapestry”这类 AI 偏爱的词)、套路化表达、词汇丰富度、可读性一致性、突发性、情感与模糊措辞。
每个引擎的模型、AUC 和说明见英文 README 的引擎表,每个引擎在 sloptotal.com 上也有自己的页面和实测分数。启发式规则单独看很弱,保留它们是因为它们和神经网络分类器的失败方式相互独立,适合用来打破平局,而不是当作证据。
打分方式
总分来自一个在 SlopBench 上拟合的逻辑回归模型,参数在 app/calibration.json,每个字段的含义和重新生成方法见 docs/CALIBRATION.md。
- 权重来自拟合,而不是手调。 每个引擎的分数先转成对数几率再加权,权重不为负。一个引擎只有在其他引擎已知的情况下还能带来新信息,才会得到权重,所以一起出错的引擎不会被重复计算。
- 区间按人类文本设定。 45、55、80 分分别是人类文本前 5%、前 2%、前 0.5% 的起点。
- 短文本会被拉向中性。 文本越短,分数越向中性值靠拢,因为短文本的证据更弱。不用空格分词的文字(中文、日文、泰文等)跳过这一步,字数按字符计算。
- 置信度来自分数。 少于 80 个词、语言尚不可靠、或分数在 35 到 65 之间时为低。
常见问题
AI 检测器可信吗? 不能盲信。任何检测器(包括这个)都不应该成为指控的唯一证据。所以 SlopTotal 会展示全部 23 个投票、它们的一致程度,以及实测的误报率。短文本(少于约 80 个词)和经过大量修改的 AI 文本,对所有检测器来说都不可靠。
能检测 ChatGPT、Claude、DeepSeek、通义千问、Kimi 吗? SlopBench 的 AI 文本来自 14 个当前模型,其中包括 DeepSeek、通义千问(Qwen)、Kimi、智谱 GLM、Claude、GPT、Gemma、Llama、Mistral 和 Grok。新模型只要和这些模型有共同的特征,就能被覆盖;用评测工具可以测量任何你关心的模型。
会把经典文学或正式文体误判吗? 在我们的测试里不会:87 篇 1532 至 1915 年出版的文学作品,一篇都没有被标记。
我的文本会被保存或分享吗? 它只在你运行的服务器上处理。报告保留 30 天(可配置),以便报告链接可用,不会发送到任何外部服务。
能检测 AI 写的代码吗? 不能,我们也不这么宣称。网站检查回答的是另一个问题:这个网站是哪个 AI 建站工具做的。
参与贡献
欢迎贡献,尤其是附带实测数据的新引擎,以及中文语料和中文校准方面的改进。请先看 CONTRIBUTING.md 和 AGENTS.md。Issue 和 PR 用英文或中文都可以。
- 适合新手的 issue:会写明要改哪些文件
- 报告 bug
- 提出功能建议
- 提议新的检测引擎
- 提问或分享结果
如果 SlopTotal 对你有用,点一个 ⭐ Star 能帮助更多人找到它。