
openmemind/memind
openmemind/memind has 905 GitHub stars and 95 forks. GitHot measured -1 stars in 24 hours. Last checked 2026-11-09 23:10 UTC. Last push 2026-08-13.
Self-evolving cognitive memory and context engine for AI agents in Java. Empowering 24/7 proactive agents like OpenClaw with understanding and SOTA performance.
可以做什么
- ☕ The first Java-native SOTA memory and context engine for AI agents: built natively in Java, memind brings benchmark-leading long-memory performance into the Java ecosystem.
- 🌳 Insight Tree turns memory into evolving intelligence: instead of storing isolated facts, memind continuously distills raw memories into Leaf → Branch → Root insights, revealing patterns, preferences, causal signals, and high-level understanding that flat memory cannot capture. See docs.openmemind.com.
- 🔎 Multi-layer retrieval recalls the right context: memind retrieves across Insight Trees, Memory Items, raw source data, Memory Graphs, Memory Threads, vector search, BM25 keyword search, temporal signals, and optional Deep Retrieval with query expansion, sufficiency checking, and reranking.
- 📥 Memory for every kind of context: memind can ingest conversations, documents, images, audio, tool calls, and agent timelines, then uses typed processors, parsers, chunkers, captioners, and plugin-specific extraction strategies to turn them into searchable memory.
实测星标增长
- 24小时
- -1
- 7天
- 更新延迟
- 15天
- 更新延迟
- 1个月
- 更新延迟
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
README_zh.md
原文

Memind
让记忆形成理解,让上下文持续进化。
让 AI 系统从每一次对话、工具调用、文档和已解决任务中持续学习的记忆层。
Memind 将原始上下文沉淀为结构化记忆和可复用经验, 持续组织成 Memory Graph、Memory Thread 和不断演化的 Insight Tree, 再通过 REST、MCP、多语言 SDK,以及面向主流 Agent 的官方插件, 召回正确上下文。


🏆 亮点
Memind 在三项主流长记忆基准测试上都取得了 SOTA 结果:LoCoMo、LongMemEval 和 PersonaMem。
- ☕ 首个达到 SOTA 水平的 Java 原生记忆与上下文引擎: memind 基于 Java 原生构建,让 Java 生态也拥有可验证、可落地的长记忆能力。
- 🚀 三项 benchmark 的已公开最高结果: 在与 MemOS / EverMemOS 对齐的评测口径下,memind 在 LoCoMo、LongMemEval 和 PersonaMem 的已列出基线中均排名 #1,其中在 LoCoMo 和 LongMemEval 上超过 EverMemOS,在 PersonaMem 上超过 MemOS。完整分数、分项对比、上下文 Token 和评测协议见 基准测试。
- 🧩 一套引擎,同时记住用户和 Agent: memind 区分 USER memory 和 AGENT memory,既能记住用户画像、偏好与生活上下文,也能沉淀 Agent 指令、工具经验、可复用 playbook 和已解决任务知识,可覆盖 coding agent、本地 harness agent、chatbot、陪伴型应用、copilot 和工作流 Agent 等场景。
- 🌳 Insight Tree 让记忆进化成理解: memind 不只是保存孤立事实,而是持续将原始记忆提炼为 Leaf → Branch → Root 洞察,发现扁平记忆无法捕捉的模式、偏好、因果信号和高层理解。详见 docs.openmemind.com。
- 🔎 多层检索召回正确上下文: memind 会跨 Insight Tree、Memory Item、原始 source data、Memory Graph、Memory Thread、向量检索、BM25 关键词检索、时间信号,以及可选的 Deep Retrieval 查询扩展、充分性检查和重排序来召回上下文。
- 📥 记住各种类型的上下文: memind 不只支持对话,还可以摄取文档、图片、音频、工具调用和 Agent 时间线,并通过类型化 processor、parser、chunker、captioner 和插件专属提取策略,将它们转化为可检索记忆。
- 🕸️ Memory Graph 连接分散上下文: memind 会从提取出的记忆中构建实体、mention、语义链接、时间链接、因果链接、别名和共现信号,并在检索时通过 graph expansion 找回单纯向量相似度可能漏掉的相关上下文。
- 🧵 Memory Thread 保留持续演化的任务与事件脉络: memind 会把相关 memory items 组织成持久线程,维护时间线事件、成员关系、生命周期状态、线程 enrichment 和 retrieval-time thread assist,帮助 Agent 延续未完成工作并复用已解决任务历史。
概览
Memind 是什么?
Memind 是一个开源的自进化记忆与上下文引擎,面向各种 AI 应用和 Agent。
它不是向量库封装。Memind 可以从对话、文档、图片、音频、工具调用、Agent 时间线和已解决任务中捕获原始上下文,并将其转化为结构化用户记忆、可复用 Agent 经验、持续演化的 Insight、互相关联的 Memory Graph,以及具备任务脉络的 Memory Thread。
在检索阶段,Memind 会跨这些记忆层编排正确上下文,并通过 REST API、HTTP MCP tools、SDK、Java runtime API 和官方 Agent 集成暴露给上层 AI 系统。
Memind 如何工作?
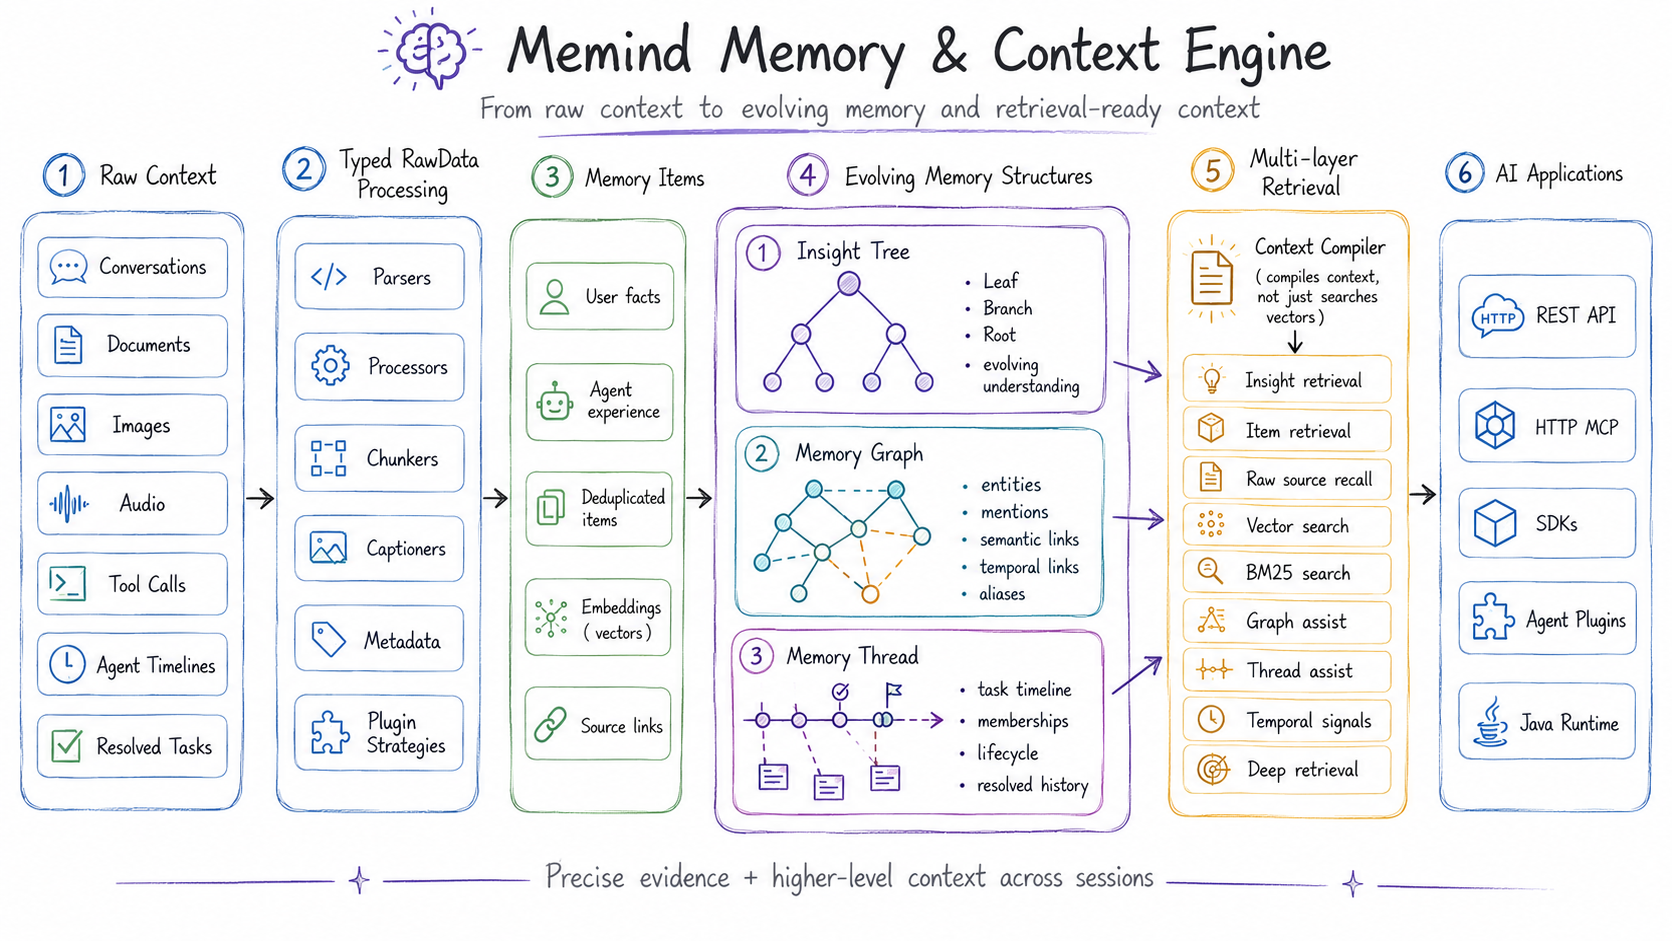
Memind 会把原始来源、提取出的记忆、结构化理解、图关系和任务时间线连接起来。这样 AI 系统召回的不只是扁平片段,而是同时包含精确证据和高层上下文。
Memind 适合用来做什么?
Memind 是一层通用的长期记忆与上下文引擎,几乎适用于任何需要长期上下文的 AI 系统。常见场景包括:
| 场景 | Memind 记住什么 |
|---|---|
| Coding Agent | 项目上下文、工具经验、已解决任务、持久指令 |
| 本地个人 Agent | 用户偏好、长期时间线、本地工作流 |
| Chatbot 与陪伴型应用 | 用户画像、关系、行为模式、生活事件 |
| 工作流 Agent | 指令、playbook、业务上下文、任务历史 |
这些只是典型示例。Memind 同样可以用于 copilot、企业助手、客服自动化、研究工具、知识工作助手,以及任何需要跨会话记住用户、任务、文档、决策、工具、时间线和历史结果的 AI 应用。
更深入的架构、配置、rawdata 插件、MCP tools、SDK 和 Agent 集成说明,请查看 docs.openmemind.com。
快速开始
根据你希望使用 Memind 的方式,选择对应路径:
- Docker Compose(推荐): 一条命令启动
memind-server和管理 UI。 - 本地开发启动: 从源码分别启动
memind-server和memind-ui。 - Java 进程内运行时: 在你自己的 Java 或 Spring Boot 应用中直接运行 Memind。
方式一:Docker Compose(推荐)
前置要求
- Docker,并已启用 Compose 插件
- 你准备使用的 chat 和 embedding 模型凭据
配置 .env
创建本地 .env 文件:
cp .env.example .env
默认配置下,优先修改这些值:
OPENAI_API_KEY=your-api-key
OPENAI_BASE_URL=https://openrouter.ai/api
OPENAI_CHAT_MODEL=openai/gpt-4o-mini
OPENAI_EMBEDDING_MODEL=openai/text-embedding-3-small
默认的 openai client 不只可以连接 OpenAI,也可以连接任何兼容 OpenAI 协议的 endpoint。
例如 OpenRouter、DeepSeek、GLM、SiliconFlow 等 provider,只要提供兼容 OpenAI 的 API,
就可以通过修改 OPENAI_BASE_URL 和模型名称接入。
模型名称由 provider 决定。默认值使用的是 OpenRouter 风格的模型名。如果你直接使用 OpenAI,
请使用 OpenAI 的模型名,例如 gpt-4o-mini 和 text-embedding-3-small。
启动 Memind
docker compose up -d --build
容器启动后可以访问:
- 管理 UI:
http://localhost:8080 - 服务健康检查:
http://localhost:8366/open/v1/health - Open API 基础路径:
http://localhost:8366/open/v1 - Admin API 基础路径:
http://localhost:8366/admin/v1 - HTTP MCP 端点:
http://localhost:8366/mcp
验证服务
curl http://localhost:8366/open/v1/health
健康检查只验证服务已经启动。模型凭据会在 Memind 执行 extraction、retrieval、embedding 或 rerank 调用时被真正验证。
UI 容器会把 /open/* 和 /admin/* 代理到 memind-server,因此浏览器可以把 UI
当作同源的本地管理控制台使用。
常用命令
# 查看日志
docker compose logs -f memind-server
docker compose logs -f memind-ui

# 停止容器,但保留已持久化的记忆数据
docker compose down

# 停止容器,并删除已持久化的记忆数据
docker compose down -v
默认情况下,memind-server 会把 SQLite 数据和 fallback file vector store 存放在 Docker volume
memind-data 中,容器内挂载路径为 /app/data。
这套 Compose 配置面向本地开发和数据检查。管理 UI 没有内置认证能力,请不要直接暴露到公网。
高级配置:配置模型路由
Memind 使用 Spring AI 初始化 provider,memind.ai.* 只保留 memory pipeline 的路由选择:
| 配置层 | 作用 |
|---|---|
spring.ai.* |
provider 默认参数、API key、base URL 和模型 options |
memind.ai.* |
选择已有 Spring AI bean 作为默认 chat/embedding model,并配置 slot routing |
默认服务配置会让 Memind 指向 Spring AI OpenAI 自动配置出来的 bean:
memind:
  ai:
    chat:
      default: openAiChatModel
    embedding:
      default: openAiEmbeddingModel
如果需要更细粒度的模型路由,先用 Spring AI 定义 provider-specific 的 ChatModel、
ChatClient 或 EmbeddingModel bean,再在
application.yml 中引用这些 bean name:
memind:
  ai:
    chat:
      default: defaultChatClient
      slots:
        ITEM_EXTRACTION: extractionChatClient
        INSIGHT_GENERATOR: reasoningChatClient
        THREAD_ENRICHMENT: threadEnrichmentChatClient
    embedding:
      default: openAiEmbeddingModel
没有单独配置的 slot 会自动使用 chat.default。
如果使用 Docker Compose,修改 application.yml 后需要重新构建镜像:
docker compose up -d --build
完整配置说明见 docs.openmemind.com。
方式二:本地开发启动
如果你要开发 Memind 本身,或者希望直接从源码启动 Server 和 UI,使用这种方式。
前置要求
- Java 21
- Maven
- Node.js 20.19+ 或 22+
- pnpm
- 可用的模型 provider key
启动 memind-server
OPENAI_API_KEY=your-key \
mvn -pl memind-server -am spring-boot:run
Server 启动后可以访问:
- 服务健康检查:
http://localhost:8366/open/v1/health - Open API 基础路径:
http://localhost:8366/open/v1 - Admin API 基础路径:
http://localhost:8366/admin/v1 - HTTP MCP 端点:
http://localhost:8366/mcp
启动 memind-ui
另开一个终端:
cd memind-ui
pnpm install
pnpm dev
Vite dev server 默认启动在 http://localhost:5173,并会把 /admin/* 请求代理到
8366 端口上的 memind-server。
方式三:Java 进程内运行时
如果你希望把 Memind 作为 Java 进程内的记忆引擎使用,而不是调用独立部署的 memind-server,可以使用这种方式。
| 运行方式 | 适合场景 |
|---|---|
| Spring Boot starter | 在 Boot 应用中使用 Spring 配置和自动配置的 AI/JDBC beans |
| 纯 Java | 希望完全控制 Memory.builder()、模型客户端、存储、向量检索和运行时选项 |
添加依赖
先导入 Memind BOM,再引入 core runtime、Spring AI 插件以及一个 JDBC 方言插件。
下面的依赖片段展示的是纯 Java 接入方式。如果使用 Spring Boot,请使用
memind-plugin-ai-spring-ai-starter、memind-plugin-jdbc-starter 和 Spring 配置。
默认 SQLite 配置如下:
<dependencyManagement>
  <dependencies>
    <dependency>
      <groupId>com.openmemind.ai</groupId>
      <artifactId>memind-dependencies</artifactId>
      <version>0.2.0</version>
      <type>pom</type>
      <scope>import</scope>
    </dependency>
  </dependencies>
</dependencyManagement>

<dependencies>
  <dependency>
    <groupId>com.openmemind.ai</groupId>
    <artifactId>memind-core</artifactId>
  </dependency>
  <dependency>
    <groupId>com.openmemind.ai</groupId>
    <artifactId>memind-plugin-ai-spring-ai</artifactId>
  </dependency>
  <dependency>
    <groupId>com.openmemind.ai</groupId>
    <artifactId>memind-plugin-jdbc-sqlite</artifactId>
  </dependency>
</dependencies>
如果使用 MySQL 或 PostgreSQL,把 memind-plugin-jdbc-sqlite 替换为
memind-plugin-jdbc-mysql 或 memind-plugin-jdbc-postgresql。
最小使用方式
Memory runtime 组装完成后,核心 API 很小:
var memoryId = DefaultMemoryId.of("user-1", "my-agent");

// messages = 你的对话历史
memory.addMessages(memoryId, messages).block();

var retrieval = memory.retrieve(
        memoryId,
        "What does the user prefer?",
        RetrievalConfig.Strategy.SIMPLE).block();
如果你想看一个配置集中、默认值清晰的纯 Java 运行时组装方式,可以从
ExampleSettings.java
开始。
完整可运行 Java 示例
当前维护中的 Java 示例位于
memind-examples/memind-example-java。
| 示例 | 展示内容 |
|---|---|
quickstart |
基础 addMessages 和检索流程 |
agent |
Agent 作用域记忆、可复用任务经验和 Agent 检索 |
insight |
多批次提取与 Insight Tree 检索 |
document |
Document rawdata 摄取与可检索文档记忆 |
foresight |
Foresight 提取与面向未来的上下文检索 |
tool |
工具调用上报、工具记忆和工具统计 |
运行默认 quickstart 示例:
OPENAI_API_KEY=your-key \
mvn -pl memind-examples/memind-example-java -am -DskipTests \
  -Dexec.mainClass=com.openmemind.ai.memory.example.java.quickstart.QuickStartExample \
  exec:java
集成
Memind 可以通过官方 Agent 插件、SDK、REST API 或内置 HTTP MCP Server 接入。 你可以根据 AI 系统运行的位置选择合适的集成方式。
将 Memind 接入任意 Agent
如果你希望 Memind 自动召回上下文、注入记忆,并跨会话捕获 Agent 活动,优先使用官方 Agent 集成。
Memind 为主流 Agent 提供官方集成:
Claude Code:项目长期记忆、SessionStart 连续性上下文、tool-aware 上下文注入,以及 coding-agent timeline 自动写入。Codex:项目长期记忆、prompt/tool 上下文注入、带重试的 timeline 写入,以及 Codex 会话 source tagging。OpenClaw:prompt 前自动召回 Memind 记忆,并把完成后的 OpenClaw agent 活动写成agent_timelineraw data。Hermes:原生 Hermes memory provider,在每轮前召回相关上下文,并在响应后捕获完成的 Hermes 活动。
SDK 与 REST API
如果你要把 Memind 接入应用、后端服务、chatbot、工作流系统或自定义 Agent,可以使用 REST API 或官方 SDK。
Open API 基础路径:
http://localhost:8366/open/v1
官方 API clients:
- TypeScript:
memind-clients/typescript - Python:
memind-clients/python - Java:
memind-clients/java - Go:
github.com/openmemind/memind/memind-clients/go - Rust:
memind-clients/rust
当你的系统已经有自己的应用进程,并希望把 Memind 作为独立 memory service 使用时,优先选择 REST API 或 SDK。
Open API 写入语义
默认写入端点(/open/v1/memory/extract、/open/v1/memory/add-message 和 /open/v1/memory/commit)
是 fire-and-forget:HTTP 成功响应表示 Memind 已接受并派发任务,不表示 extraction 已完成。
需要重试语义的客户端应该使用 /open/v1/memory/sync/extract,传入调用方自己持有的 raw-content payload,
并且只在返回的 extraction status 为 SUCCESS 时清除本地重试状态。
/open/v1/memory/sync/add-message 和 /open/v1/memory/sync/commit 会返回即时的 server-buffer 成功或失败,
但它们不是 durable replay boundary,因为 buffered conversation state 由 server 持有。
HTTP MCP Server
如果你的 Agent 支持 Model Context Protocol,可以通过 MCP 将 Memind 作为工具服务接入。
memind-server 内置了一个无状态 HTTP MCP server,默认路径为 /mcp,默认启用。
它会把 Memind 记忆能力暴露给兼容 MCP 的 Agent,并复用同一套运行时、数据库、配置和日志。
Claude Code 可以这样连接本地服务:
claude mcp add --transport http memind http://localhost:8366/mcp
默认 MCP tools:
- 检索与上下文:
memind_compile_context、memind_retrieve、memind_recent。 - 写入流程:
memind_extract_text、memind_extract_rawdata、memind_add_message、memind_commit。 - Memory item 检查:
memind_items_search、memind_items_get、memind_items_sources。 - Rawdata 检查:
memind_rawdata_search、memind_rawdata_get。
当 Agent 需要一段精简、分组后的上下文时,优先使用 memind_compile_context;当它需要结构化检索结果时,使用
memind_retrieve。memind_extract_text 适合一次性的文本记忆,memind_extract_rawdata 适合 typed rawdata,
memind_add_message 加 memind_commit 适合对话流式记忆。
可选治理工具 memind_forget 默认关闭。设置 MEMIND_MCP_GOVERNANCE_ENABLED=true 后启用;它默认 dry-run,
要求填写非空 reason,并且只会删除匹配传入 userId 和 agentId 的 ITEM 或 RAWDATA 记录。
如果要关闭 MCP 端点,在启动 memind-server 前设置 MEMIND_MCP_ENABLED=false。
不要在没有鉴权网关或等价网络控制的情况下把 /mcp 直接暴露到公网。MCP tools 可以读写对应作用域下的记忆。
基准测试
Memind 在三项主流长记忆 benchmark 上进行了评测:LoCoMo、LongMemEval 和 PersonaMem。
评测协议: 回答结果使用 GPT-4o-mini,并按照 MemOS 与 EverMemOS 所采用的 LLM-as-a-Judge 方式进行评估。基线结果在条件允许时采用对齐设置下的复现结果或公开结果。
总览
| Benchmark | 评测重点 | Memind 结果 | 排名 | 最强已列出基线 | Context Tokens |
|---|---|---|---|---|---|
| LoCoMo | 多轮多会话对话记忆 | 86.88% | #1 | EverMemOS 86.76% | 1616.68 |
| LongMemEval | 长期 assistant memory | 84.20% | #1 | EverMemOS 83.00% | 1615.11 |
| PersonaMem | 用户画像与偏好记忆 | 67.91% | #1 | MemOS 61.17% | 1665.33 |
在对齐 MemOS / EverMemOS 风格的评测口径下,Memind 在三项 benchmark 的已列出基线中均排名 #1,同时保持了适合生产 Agent 工作流的上下文召回规模。
Memind 行中的括号表示相对同一指标列里最强非 Memind 分数的变化。Context Tokens 表示每个已回答问题平均召回的上下文 Token 数。
详细结果
LoCoMo
| Model | Single Hop | Multi Hop | Temporal | Open Domain | Overall | Context Tokens |
|---|---|---|---|---|---|---|
| MIRIX | 68.22% | 54.26% | 68.54% | 46.88% | 64.33% | - |
| Mem0 | 73.33% | 58.75% | 52.34% | 45.83% | 64.57% | 1.17k |
| Zep | 66.23% | 52.12% | 54.82% | 33.33% | 59.22% | 2.7k |
| MemoBase | 73.12% | 64.65% | 81.20% | 53.12% | 72.01% | 2102 |
| Supermemory | 67.30% | 51.12% | 31.77% | 42.67% | 55.34% | 500 |
| MemU | 66.34% | 63.12% | 27.10% | 50.00% | 56.55% | 617 |
| MemOS | 81.09% | 67.49% | 75.18% | 55.90% | 75.80% | 2640 |
| ReMe | 89.89% | 82.98% | 83.80% | 71.88% | 86.23% | - |
| EverMemOS | 91.08% | 86.17% | 81.93% | 66.67% | 86.76% | 2.5k |
| Memind | 91.56% (+0.48%) | 83.33% (-2.84%) | 82.24% (-1.56%) | 71.88% (+0.00%) | 86.88% (+0.12%) | 1616.68 |
结论: Memind 在这组对比中取得了最高 LoCoMo 总分,open-domain QA 表现突出,并且 Context Tokens 低于 EverMemOS。
LongMemEval
| Model | single-session-preference | single-session-assistant | temporal-reasoning | multi-session | knowledge-update | single-session-user | overall | Context Tokens |
|---|---|---|---|---|---|---|---|---|
| MIRIX | 53.33% | 63.63% | 25.56% | 30.07% | 52.56% | 72.85% | 43.49% | - |
| Mem0 | 90.00% | 26.78% | 72.18% | 63.15% | 66.67% | 82.86% | 66.40% | 1066 |
| Zep | 53.30% | 75.00% | 54.10% | 47.40% | 74.40% | 92.90% | 63.80% | 1.6k |
| MemoBase | 80.00% | 23.21% | 75.93% | 66.91% | 89.74% | 92.85% | 72.40% | 1541 |
| Supermemory | 90.00% | 58.92% | 44.36% | 52.63% | 55.12% | 85.71% | 58.40% | 428 |
| MemU | 76.67% | 19.64% | 17.29% | 42.10% | 41.02% | 67.14% | 38.40% | 523 |
| MemOS | 96.67% | 67.86% | 77.44% | 70.67% | 74.26% | 95.71% | 77.80% | 1432 |
| EverMemOS | 93.33% | 85.71% | 77.44% | 73.68% | 89.74% | 97.14% | 83.00% | 2.8k |
| Memind | 95.56% (-1.11%) | 87.50% (+1.79%) | 79.45% (+2.01%) | 77.44% (+3.76%) | 88.46% (-1.28%) | 93.81% (-3.33%) | 84.20% (+1.20%) | 1615.11 |
结论: Memind 在这组对比中取得了最高 LongMemEval 总分,其中 multi-session 和 temporal-reasoning 两类任务提升最明显。
PersonaMem
| Model | 4-Option Accuracy | Context Tokens |
|---|---|---|
| MIRIX | 38.30% | - |
| Mem0 | 43.12% | 140 |
| Zep | 57.83% | 1657 |
| MemoBase | 58.89% | 2092 |
| MemU | 56.83% | 496 |
| Supermemory | 53.88% | 204 |
| MemOS | 61.17% | 1423.93 |
| Memind | 67.91% (+6.74%) | 1665.33 |
Memind 在 PersonaMem 上的分项结果
| Metric | Score | Correct / Total |
|---|---|---|
| generalizing_to_new_scenarios | 75.44% | 43 / 57 |
| provide_preference_aligned_recommendations | 80.00% | 44 / 55 |
| recall_user_shared_facts | 71.32% | 92 / 129 |
| recalling_facts_mentioned_by_the_user | 76.47% | 13 / 17 |
| recalling_the_reasons_behind_previous_updates | 88.89% | 88 / 99 |
| suggest_new_ideas | 38.71% | 36 / 93 |
| track_full_preference_evolution | 60.43% | 84 / 139 |
结论: Memind 在这组对比中取得了最高 PersonaMem 成绩,在 preference-aligned recommendations、user-shared facts recall 和对历史更新原因的推理上表现尤其突出。
复现 benchmark 结果
1. 先准备数据集
这些 benchmark 的原始数据集 不随仓库一起分发。请先下载,并按下面的默认路径放好文件。
| Benchmark | 下载地址 | 默认本地路径 |
|---|---|---|
| LoCoMo | LoCoMo 官方仓库 | memind-evaluation/data/locomo/locomo10.json |
| LongMemEval | LongMemEval cleaned dataset | memind-evaluation/data/longmemeval/longmemeval_s_cleaned.json |
| PersonaMem | PersonaMem dataset | memind-evaluation/data/personamem/questions_32k.csv 和 memind-evaluation/data/personamem/shared_contexts_32k.jsonl |
LongMemEval 和 PersonaMem 会在运行时自动转换为内部评测格式。
2. 导出环境变量
export OPENAI_API_KEY=your-key
export OPENAI_BASE_URL=your-base-url
export OPENAI_CHAT_MODEL=openai/gpt-4o-mini

export EMBEDDING_API_KEY=your-key
export EMBEDDING_BASE_URL=your-base-url
export OPENAI_EMBEDDING_MODEL=openai/text-embedding-3-small

export RERANK_BASE_URL=your-rerank-base-url
export RERANK_API_KEY=your-rerank-key
export RERANK_MODEL=jina-reranker-v3
如果你只是想先跑通最小链路,可以在下面的命令后面追加 --evaluation.system.memind.retrieval.rerank.enabled=false。这适合做 dry run,但不会与 README 中展示的结果完全一致。
3. 运行完整 benchmark
mvn -pl memind-evaluation -am -DskipTests spring-boot:run \
  -Dspring-boot.run.profiles=locomo \
  -Dspring-boot.run.arguments="--evaluation.run-name=locomo-readme --evaluation.stages=add,search,answer,evaluate --evaluation.clean-groups=true"

mvn -pl memind-evaluation -am -DskipTests spring-boot:run \
  -Dspring-boot.run.profiles=longmemeval \
  -Dspring-boot.run.arguments="--evaluation.run-name=longmemeval-readme --evaluation.stages=add,search,answer,evaluate --evaluation.clean-groups=true"

mvn -pl memind-evaluation -am -DskipTests spring-boot:run \
  -Dspring-boot.run.profiles=personamem \
  -Dspring-boot.run.arguments="--evaluation.run-name=personamem-readme --evaluation.stages=add,search,answer,evaluate --evaluation.clean-groups=true"
4. 先跑一次 smoke check
mvn -pl memind-evaluation -am -DskipTests spring-boot:run \
  -Dspring-boot.run.profiles=locomo \
  -Dspring-boot.run.arguments="--evaluation.run-name=locomo-smoke --evaluation.stages=add,search,answer,evaluate --evaluation.smoke=true --evaluation.from-conv=0 --evaluation.to-conv=1 --evaluation.clean-groups=true"
5. 查看输出结果
每次运行都会把产物写到 eval-data/results/<dataset>-<run-name>/:
report.txtsearch_results.jsonanswer_results.jsoneval_results.json
如果重复使用同一个 run-name,评测会从 checkpoint 恢复。想要重新跑一轮独立实验,请换一个新的 run-name。
贡献
欢迎贡献。你可以随时提交 issue 或发起 pull request。
社区支持
许可证
探索相关项目
affaan-m/ECC
智能体执行与控制框架的性能优化系统。面向 Claude Code、Codex、Opencode、Cursor 等,涵盖技能、本能、记忆、安全与研究优先的开发。
300,759 星标NousResearch/hermes-agent
与你一同成长的智能体
262,426 星标multica-ai/andrej-karpathy-skills
一个用于改进 Claude Code 行为的 CLAUDE.md 文件,源自 Andrej Karpathy 对 LLM 编程陷阱的观察。
231,843 星标firecrawl/firecrawl
借助来自网络及其他来源的数据,强化你的 AI 智能体。正在构建面向超级智能的资料库。🔥
200,444 星标