
oomol-lab/pdf-craft
oomol-lab/pdf-craft has 6,495 GitHub stars and 475 forks. Star changes are not measured yet. Last checked 2026-11-08 15:06 UTC. Last push 2026-11-07.
PDF craft can convert PDF files into various other formats. This project will focus on processing PDF files of scanned books.
可以做什么
- Edit scanned books - PDF → Markdown, with text and image assets
- Read in an ebook reader - PDF → EPUB, with book metadata and table of contents
- Read books in another language - Translate during conversion or translate an existing EPUB; translation-only and bilingual output modes
- Create a translated PDF - Translate extracted text and write it back onto the source pages
实测星标增长
- 24小时
- 更新延迟
- 7天
- 更新延迟
- 15天
- 更新延迟
- 1个月
- 更新延迟
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
docs/readmes/README-zh-CN.md
原文
English | 简体中文 | 繁體中文 | 日本語 | 한국어 | Русский | Français | Español | Deutsch | Italiano


在线转换 PDF · Python 快速开始 · 使用文档
PDF Craft 是一个面向扫描书籍、论文和技术文档的 Python 库,可将扫描版 PDF 转换为便于编辑的 Markdown 或适合阅读的 EPUB。还可以将 PDF 或 EPUB 中的内容翻译成其他语言,生成译文或双语 EPUB,也能将译文写回原始 PDF 页面。转换时会识别正文、章节、目录、脚注、表格、公式和图片,让扫描页面中的内容可以继续检索、编辑和阅读。
直接在线转换,无需安装
只想把手头的扫描 PDF 转成可编辑的 Markdown 或适合阅读的 EPUB?使用 PDF Craft Online · pdfcraft.ai,在浏览器中上传文件、提交转换任务,完成后下载结果。无需安装 Python、配置 CUDA,也无需自行寻找 OCR 服务或填写 API 密钥。
PDF Craft Online 是本开源项目的官方在线服务。需要处理文件时可以直接使用在线版;需要接入自己的程序或在本机运行 OCR 时,可以使用下面的 Python 库。
转换效果
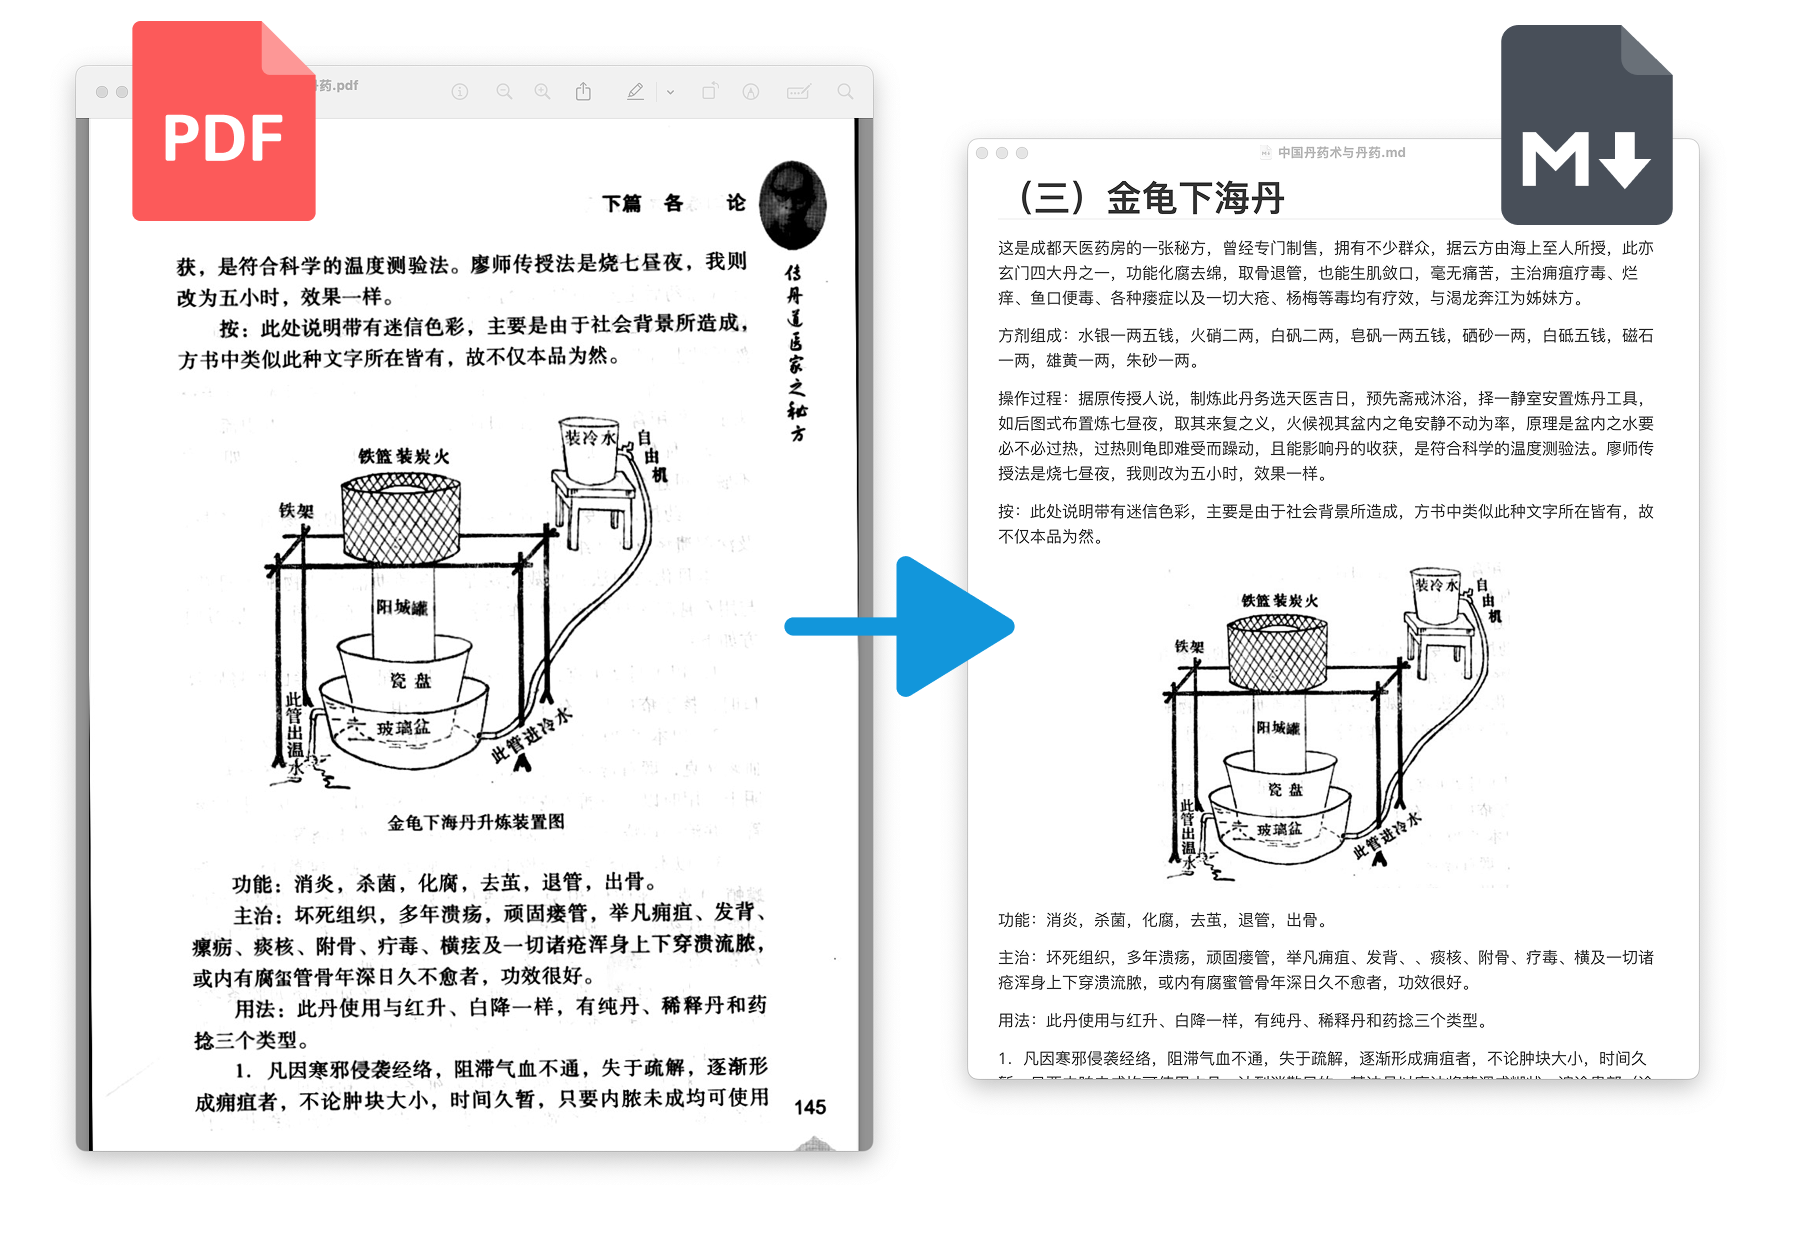
Markdown:用于编辑、检索和后续内容处理。
EPUB:用于在电子书阅读器中阅读。
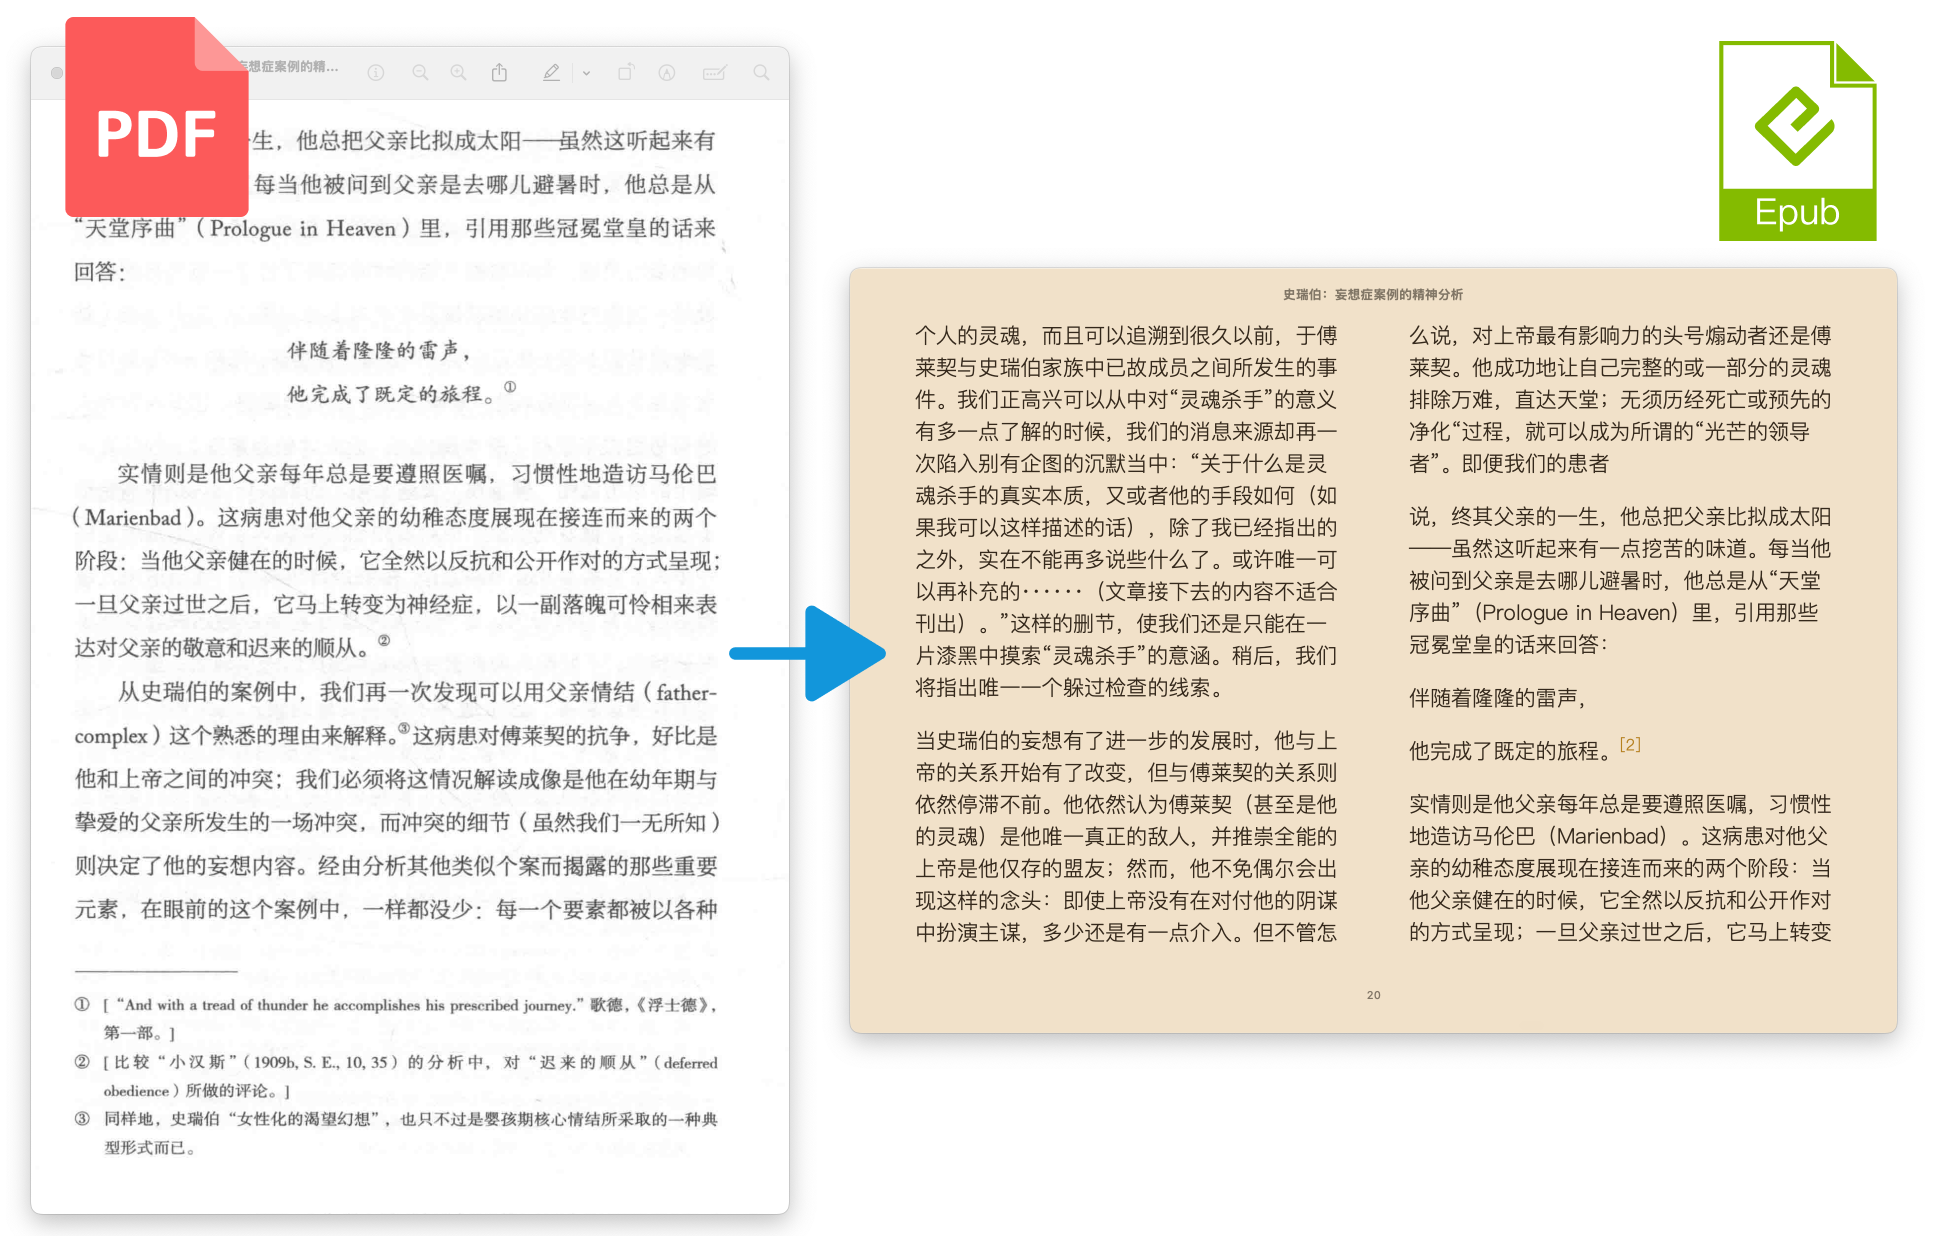
转换效果取决于原稿清晰度、页面排版和所选 OCR 模型。建议先用有代表性的文档检查输出,再处理整批文件。
想看看自己的文件转换后是什么样?上传 PDF,在线转换为 Markdown 或 EPUB →
你可以用它做什么
| 你的目标 | PDF Craft 提供的能力 |
|---|---|
| 把扫描书籍整理成可编辑文档 | PDF → Markdown,提取文字并输出图片等资源 |
| 在电子书阅读器中阅读扫描书籍 | PDF → EPUB,支持书名、作者和目录等书籍信息 |
| 阅读其他语言的书籍 | 转换时翻译内容,或直接翻译已有 EPUB;支持仅译文和双语输出方式 |
| 获得译文版 PDF | 翻译识别出的内容,将译文写回原始 PDF 页面 |
| 将转换接入自己的应用 | 通过 Python API 调用;保存提取结果,复用于后续渲染或翻译 |
选择你的使用方式
| 使用方式 | 适合谁 | 需要准备 |
|---|---|---|
| 在线转换 | 直接上传文件,下载 Markdown 或 EPUB | 浏览器,无需安装 Python 或配置 OCR 服务 |
| Python + 远程 OCR | 希望接入代码、不在本机运行 OCR 模型的开发者 | Python、Poppler、兼容 OCR 服务的地址与凭据 |
| Python + 本地 OCR | 希望在自己的 NVIDIA GPU 上运行识别的开发者 | Python、Poppler、CUDA 环境、显存与模型文件 |
远程 OCR 会将页面发送给所配置的服务,本机无需 CUDA。本地 OCR 使用本机算力;如果另外配置远程 LLM 进行翻译或目录分析,相应内容仍会发送给该服务。
Python 快速开始
下面使用远程 OCR,将一个 PDF 转换为 Markdown。开始前请准备 Python 3.11–3.13、Poppler,以及可用的 DeepSeek OCR 兼容服务配置。Poppler 的安装方式见安装指南。
只想转换文件、不想配置开发环境或 OCR 服务?直接使用 PDF Craft Online,在浏览器中上传 PDF 即可开始。
1. 安装
python -m pip install pdf-craft
2. 转换 PDF
将待转换文件命名为 input.pdf,放在运行脚本的目录下。替换下面的服务地址、密钥和模型名后运行:
from pdf_craft import DeepSeekOCRVendorConfig, PDFCraft, PDFOptions

craft = PDFCraft(
    pdf=PDFOptions(
        ocr=DeepSeekOCRVendorConfig(
            base_url="https://example.com/v1",
            api_key="your-api-key",
            model="deepseek-ocr",
        ),
    ),
)

craft.convert_pdf_to_markdown("input.pdf", "output.md")
https://example.com/v1 是占位地址,不能直接调用;请使用实际提供相应 OCR 模型的兼容服务。其他模型的配置见 OCR 配置指南。如果还没有 OCR 服务,可以先通过 PDF Craft Online 完成文件转换。
转换完成后,打开 output.md 查看结果。包含图片的文档还会生成相关资源文件,移动或分享 Markdown 时请一并保留。
3. 生成 EPUB
沿用上面的 craft 实例,将最后一行替换为:
craft.convert_pdf_to_epub("input.pdf", "output.epub")
转换完成后,即可用 EPUB 阅读器打开 output.epub。设置书名、作者及其他输出选项,见 PDF 转换与翻译指南。
遇到安装或运行问题?查看故障排查指南。
如果需要 EPUB 的书目信息,可显式开启“前页 OCR 元信息抽取”并提供独立的 metadata LLM。PDF Craft 只接受能在 OCR 页中验证的字段;PDF 文件自身的属性仅用于补充缺失字段,绝不会覆盖书页印刷信息。
可选输入断言
转换不会自动执行整份输入门禁。需要提前检查时,可从 pdf_craft 导入
assert_pdf_readable、assert_pdf_renderable、assert_pdf_editable 或
assert_epub_readable,按需要选择调用。成功返回 None,失败抛原异常;不修改或
修复输入。通过不保证后续 OCR 或翻译成功。详见能力边界和用法。
翻译与提取结果复用
翻译书籍。 可以在 PDF 转换为 Markdown 或 EPUB 时传入 XMLTranslator,也可以直接翻译已有 EPUB。翻译需要独立的文本 LLM 调用;OCR 服务负责页面识别,两者使用各自的配置。已有 EPUB 的翻译支持仅保留译文,或追加译文以便双语阅读。
生成译文 PDF。 如果你需要 PDF 输出,可以先提取内容,再将翻译后的文字写回原始页面。此流程还需要 可用的本机字体;排版效果需要结合原稿与译文检查。
一次提取,多次使用。 将提取结果保存为 .pcex 文件,可以在后续渲染、翻译或跨机器处理时复用:
craft.convert_pdf_to_markdown(
    "input.pdf",
    "output.md",
    extraction_path="book.pcex",
)
处理过程中提前预览。 PDF 提取、EPUB 翻译、PCEX 翻译与渲染支持可选回调。完整文件生成前,即可获取带来源坐标的自然段、EPUB 原子译文片段、PDF 最终排版数据和一次性书籍元信息。用法见增量回调指南。
具体步骤见 PDF 转换与翻译、EPUB 翻译和 .pcex 格式参考。
OCR 与运行要求
PDF Craft 支持 DeepSeek OCR、DeepSeek OCR 2 和 Unlimited OCR,每个模型系列都有本地和远程配置。
远程 OCR 使用标准安装包。如果你明确需要本地 OCR,请安装额外依赖:
python -m pip install "pdf-craft[local]"
本地运行还需要匹配的 CUDA 版 PyTorch、足够显存和模型文件。模型默认从 Hugging Face 下载,也可以预先下载后从本地加载。各模型的预设和要求不同,请按 OCR 配置指南选择。
语言支持取决于处理环节。 README 的语言版本表示文档可用语言;文字识别取决于 OCR 模型,翻译取决于翻译器与文本 LLM。EPUB 的 label_language 仅选择固定文案,支持 zh / en,默认及其他值均用英文;不会限制正文或翻译语言,具体见 API 参考。
文档导航
| 我想了解 | 文档 |
|---|---|
| 提前查询任务规模、查看远程资源消耗 | 规模与用量 |
| 升级到 2.6.4:进度 API 迁移与并发优化 | 发布说明 · 迁移指南 |
| 安装系统依赖、配置本地 GPU | 安装指南 |
| 选择 OCR 模型、配置远程服务或模型缓存 | OCR 配置指南 |
| 转换 PDF、生成 EPUB、翻译并写回 PDF | PDF 转换与翻译 |
| 翻译已有 EPUB,设置双语输出 | EPUB 翻译指南 |
| 提前展示内容,获取来源页与坐标 | 增量回调指南 |
| 理解流式提取的产品目标与工程取舍 | PDF → PCEX 设计文章 |
| 查询参数、类型和调用方式 | API 参考 |
| 存储或交换提取结果 | .pcex 格式参考 |
| 解决安装、识别与输出问题 | 故障排查 |
| 升级到 2.6.0:重试与错误降级策略 | 迁移指南 |
| 查看 2.6.0 版本更新 | 更新日志 |
反馈与贡献
欢迎通过 Issues报告问题或提出建议。转换问题请尽量附上项目版本、OCR 配置类型、错误日志,以及可公开分享的最小复现文件;提交前移除密钥和私人内容。
也欢迎通过 Pull Requests改进代码、文档和翻译。贡献新语言版本时,请以本中文版为内容基准,用对应语言自然表达在线转换、翻译能力等重点,并保持 API 示例准确。
如果 PDF Craft 对你有帮助,欢迎给项目一颗 Star,让更多需要处理扫描书籍的人发现它。
相关项目
Wiki Graph 可以继续处理转换后的 EPUB 或 Markdown,生成结构化摘要、章节拓扑和知识图谱。
许可证与致谢
PDF Craft 使用 MIT 许可证。第三方依赖及所选 OCR 模型适用各自的许可证。
感谢 DeepSeek OCR、DeepSeek OCR 2、Unlimited OCR、doc-page-extractor 和 pyahocorasick 等开源项目。
贡献者
感谢每一位为 PDF Craft 作出贡献的人。欢迎参与代码、文档和翻译的改进。
Star History
翻译进度统一使用原文 words(汉字一字一 word,长词按 20 字符折算),预统计完整总量并在每轮处理后更新。详见翻译进度。
提取和翻译共用工作单元进度事件,提供预统计数量、整数 stage 和原文 words。