
nokia-applied-research/AnyJev has 1,602 GitHub stars and 180 forks. GitHot measured +2 stars in 24 hours and +18 in 7 days. Last checked 2026-11-11 18:11 UTC. Last push 2026-10-21.
Turn any LLM into a Jev-style decision model: typed decisions, real probabilities, no training. (continue updating, welcome any issue and PR request)
实测星标增长
- 24小时
- +2
- 7天
- +18
- 15天
- 正在收集历史
- 1个月
- 正在收集历史
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
README.zh-CN.md
原文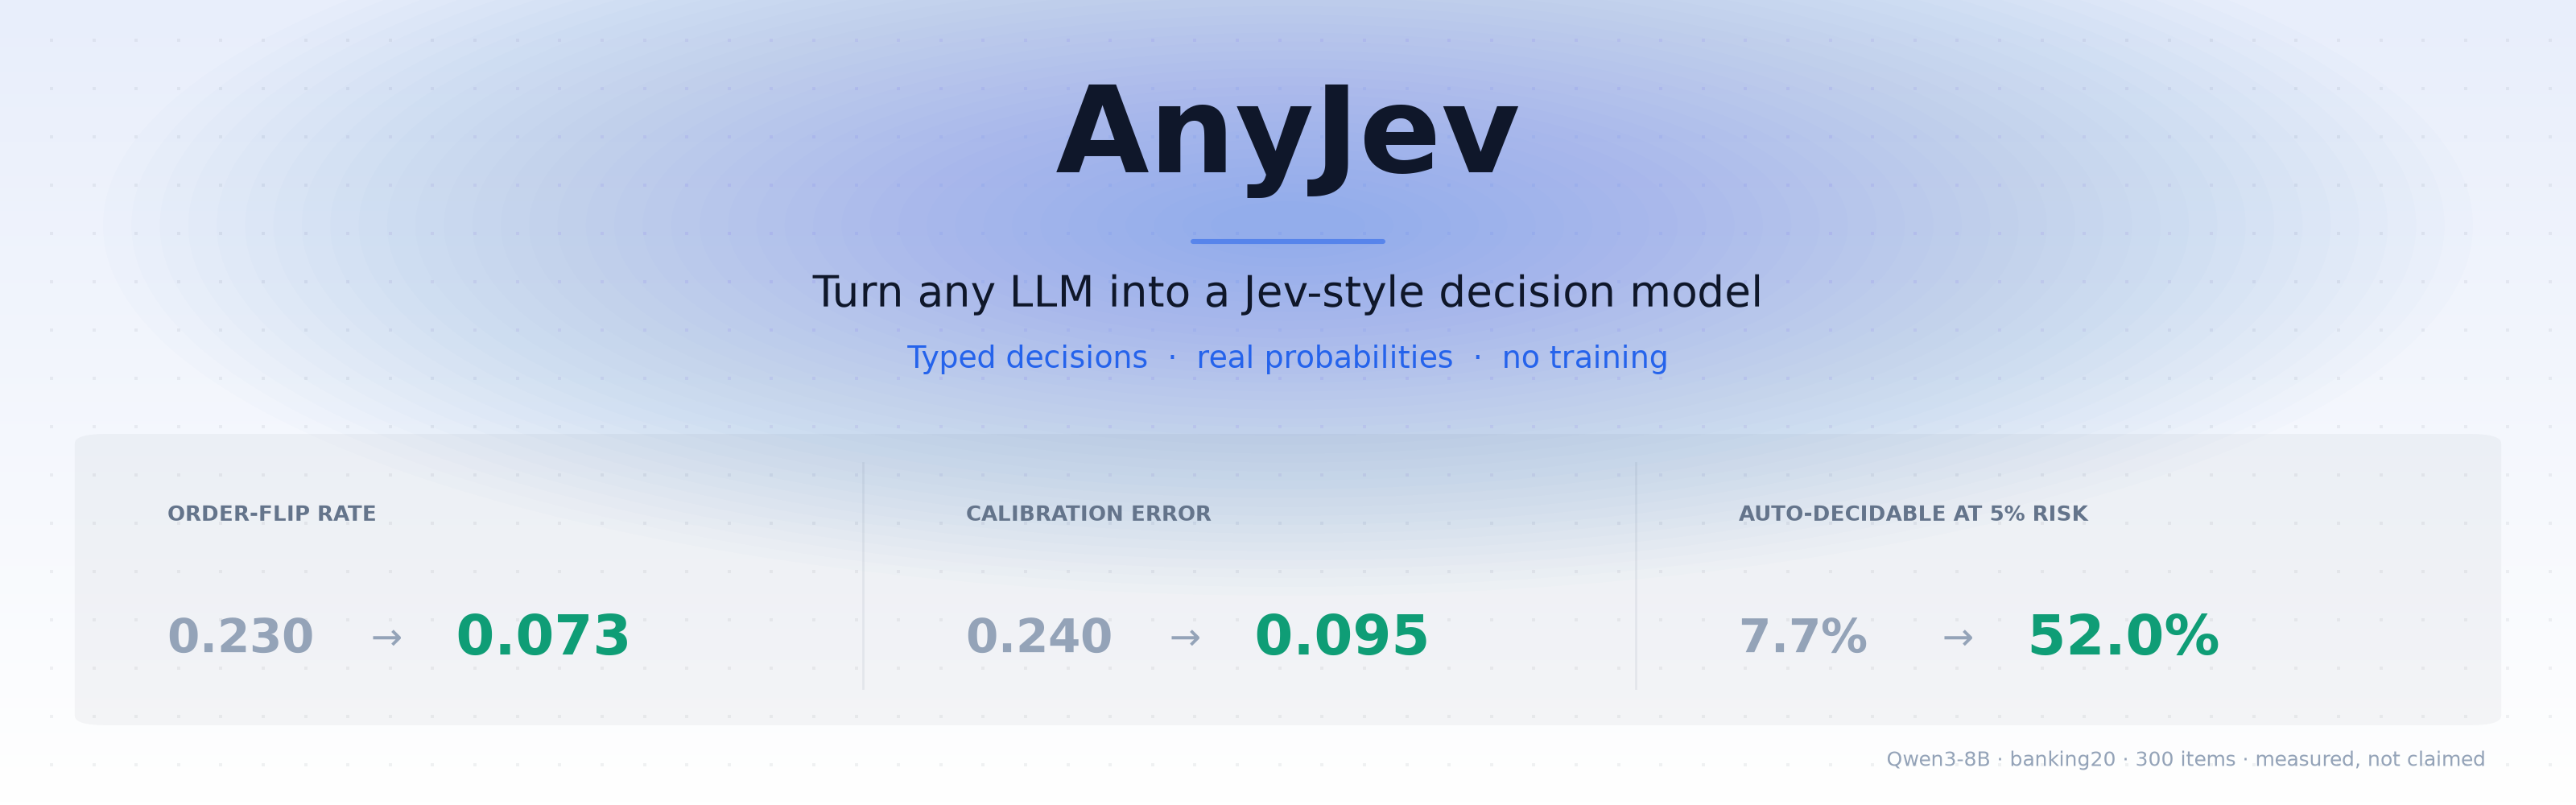





Jiamu Zhang1 Tianze Yang1 Yucheng Shi2 Evan Chen1
Zixiang Nie1 Kelly Wan1 Liangjie Hong1 Ninghao Liu3 Liang Wu1
1 Nokia, Sunnyvale, CA, USA 2 Tencent Hunyuan 3 The Hong Kong Polytechnic University
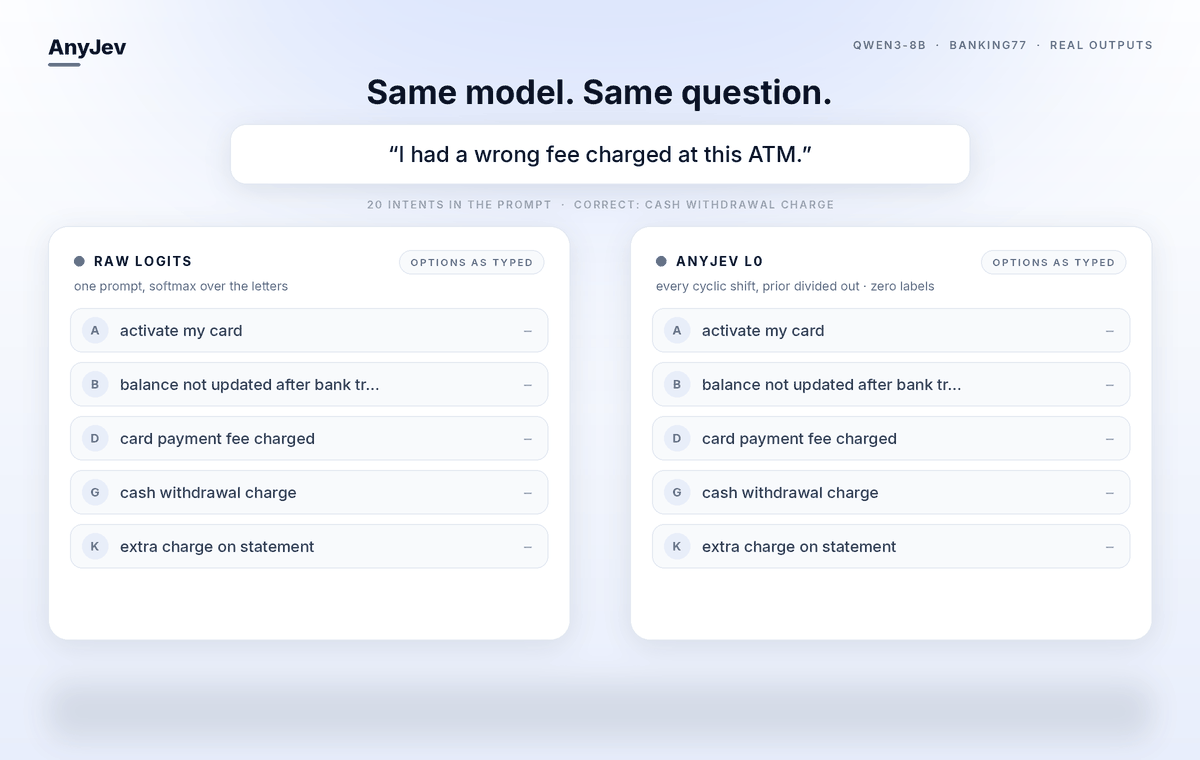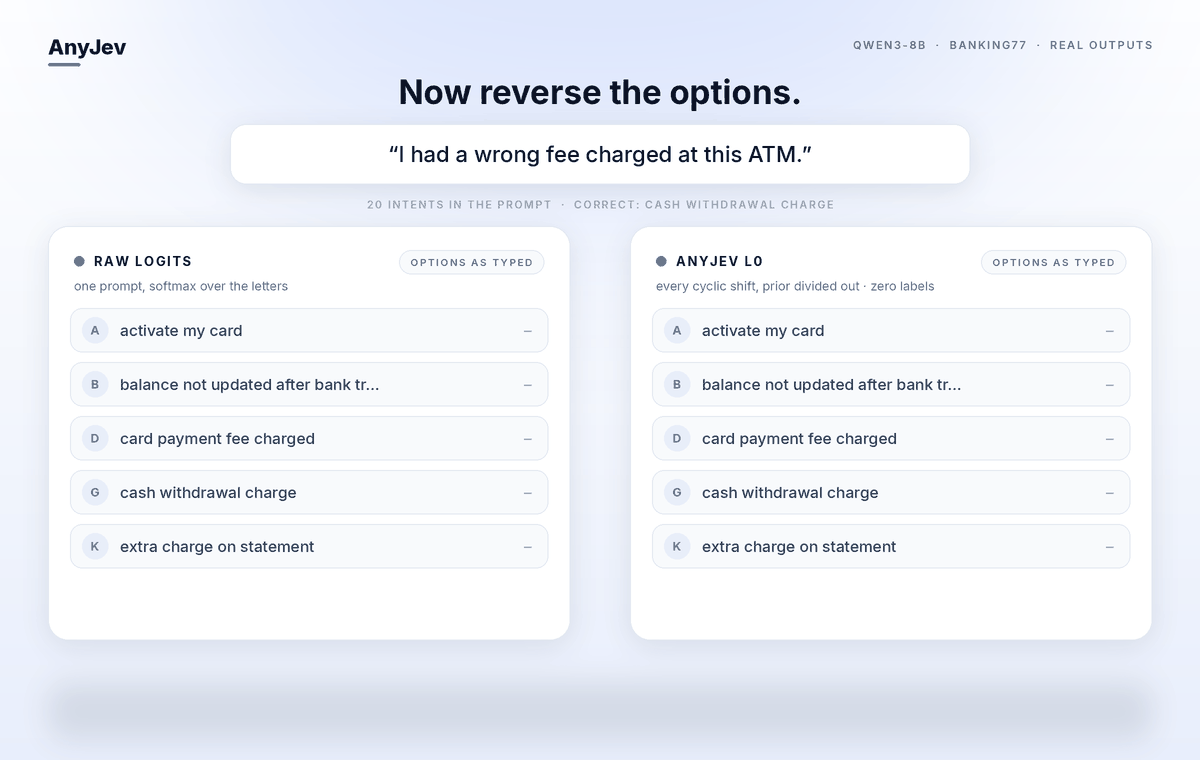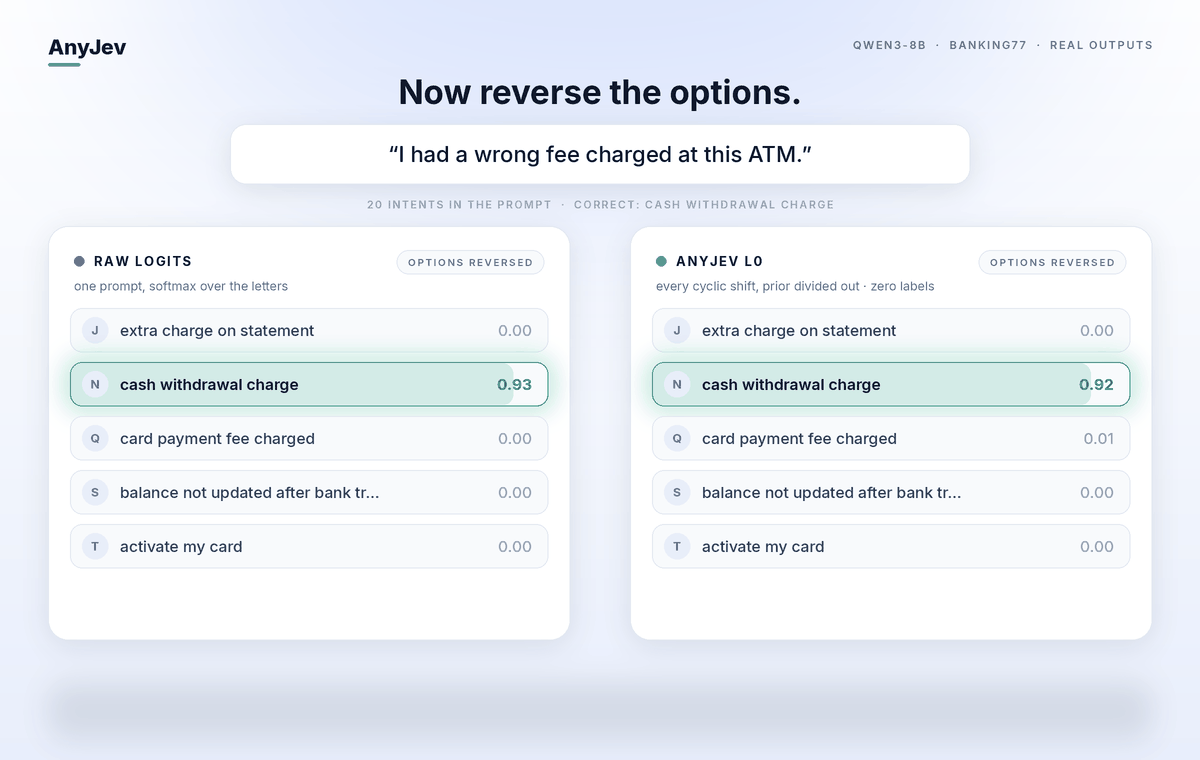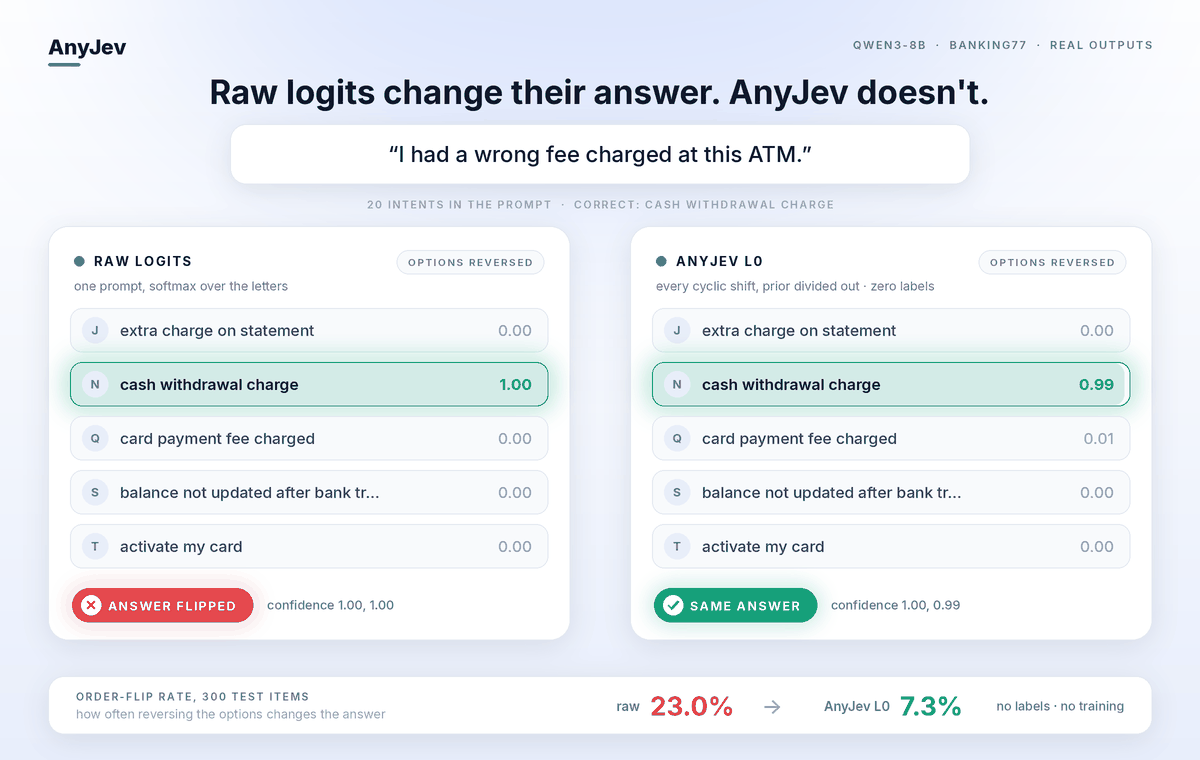
Qwen3-8B,一条真实的 BANKING77 样本。图中每个数字都是模型的真实输出。
[!TIP] 🆕 Tacit:AnyJev 的自蒸馏模型,1.7B 到 9B,已发布在 Hugging Face。 每个决策一次前向。打开
adaptive=True后,一部分低置信度的决策会交给模型自己推理,这部分的比例有上限。 支持 transformers、进程内 vLLM 和原版vllm serve。pip install "anyjev[hf]",然后Tacit.from_pretrained("morriszjm/Tacit-9B")。 从这里开始 ↓
[!NOTE] 🏆 Decision Index 0.4.1 上的 AnyJev Tacitus。 AnyJev Tacitus 31B 从 Gemma-4-31B 微调、用 AnyJev 读出,总分(Full score)66.47,2026-10-21 在排行榜上并列第 3。 详情 ↓
[!NOTE] 🏆 不训练,上公开排行榜。 免训练的
Decider(L0,两次轮换)用原版 Gemma-4-31B,在 Decision Index 0.3 上的总分(Full score)是 60.22,2026-10-12 在 149 个条目中排第 5。 详情 ↓
⚡ 跑起来
在 Python 里用 Tacit 模型。
from anyjev import Tacit

tacit = Tacit.from_pretrained("morriszjm/Tacit-9B")          # transformers,一张 GPU
d = tacit.decide(state="Customer: my package was due last Monday and it still has not arrived.",
                 question="What does the customer want?",
                 options=["track_order", "cancel_order", "refund", "change_address"])
d["answer"], d["probs"], d["route"]    # 一个选项、{选项: 概率}、"one_forward" 或 "cot"
kind 可以是 "choice"(默认)、"yes_no" 或 "score"(这时 options 是从低到高排好的档位,从 1 开始编号;first_level=0 则从 0 开始)。
decide_batch([...]) 接收由这样的 dict 组成的列表。
把最难的决策交给推理,并设上限。
tacit = Tacit.from_pretrained("morriszjm/Tacit-9B", adaptive=True, tau=0.5, max_cot_share=0.2, cot_window=1000)
如果一个决策排前两名的选项在 log-probability 上相差不到 tau,它会打开 thinking 重新回答一次。
推理结束后,答案读的是选项标签上的概率分布,所以它同样带概率,也不会出现解析失败。
无论流量多难,最近 cot_window 个决策里最多只有 max_cot_share 会转去推理。
每次转推理都会如实标出(route == "cot",并保留第一遍的结果),tacit.stats 里有计数。
在 vLLM 上跑。 服务端用原版 vLLM,客户端只需要 tokenizer。
pip install "anyjev[client]"
vllm serve morriszjm/Tacit-9B --host 127.0.0.1 --port 8000
tacit = Tacit.from_pretrained("morriszjm/Tacit-9B", engine="server",
                              base_url="http://127.0.0.1:8000", adaptive=True)
engine="vllm"(pip install "anyjev[vllm]")会在同一个进程里直接起 vLLM。
给多个客户端共用一个上限的 HTTP 端点。
python -m anyjev.serve --model morriszjm/Tacit-9B --upstream http://127.0.0.1:8000 --adaptive --port 8100
curl -s 127.0.0.1:8100/v1/decide -H 'Content-Type: application/json' \
  -d '{"state": "Customer: my package has not arrived.", "question": "What does the customer want?", "options": ["track_order", "refund"]}'
POST /v1/decide 接收单个决策,或者 {"items": [...]};GET /v1/stats 返回转推理的比例。
网关默认只监听 127.0.0.1,本身不带鉴权。
| 参数 | 默认值 | 含义 |
|---|---|---|
adaptive |
False |
把低置信度的决策交给模型自己推理 |
tau |
0.5 |
低置信度的判定:排前两名的选项 log-probability 之差小于 tau |
max_cot_share |
0.2 |
最近 cot_window 个决策里最多这个比例转去推理;None 表示不设上限 |
cot_window |
1000 |
上限统计最近多少个决策;None 表示从加载起累计 |
cot_max_tokens |
8192 |
单个决策的推理预算 |
engine |
"transformers" |
"vllm" 在本进程里起 vLLM;"server" 连接 base_url 上已经在跑的 vllm serve |
其他任何模型,免训练。 Decider 能从任意开源因果语言模型里读出同样的类型化决策,不需要训练,也不需要标签。
from anyjev import Decider, Question
from anyjev.backends.hf import HFBackend          # 或 anyjev.backends 里的 VLLMBackend / SGLangBackend(url, model)、LlamaCppBackend(gguf)

d = Decider(HFBackend("Qwen/Qwen3-8B"))           # 默认 level="L0"
route = Question.choice("这条工单该由哪个团队处理?",
                        ["账单", "技术", "销售", "其他"], name="route")
r = d.decide("同一笔订单我的卡被扣了两次钱。", [route])["route"]
r.distribution, r.level                           # {选项: 概率}、"L0"
对于有 K 个选项的 choice,L0 会把选项的每一种轮换各问一次。打开旋转预算后,一个决策需要几次就只读几次:
d = Decider(backend, adaptive_shifts=True, canonical_order=True)
d.calibrate_adaptive(route, unlabelled_tickets, target=0.01)   # 几百条状态,不需要标签
停止门槛对照的是我们自己读满所有轮换得到的答案,所以不需要标签。在经过证明的 1% 分歧率下,平均读 7.2 次轮换而不是 18 次。 vLLM 上每秒决策数是原来的 2.2×,transformers 上是 2.3×–2.7×,准确率不变 (docs/rotation_budget.zh-CN.md)。
✨ 这是什么
给模型一个状态和一个类型化的问题(单选、是/否或打分), 得到一个带选项概率的决策,直接从模型的下一个 token 分布里读出来,不解析任何文本。有两种用法:
- AnyJev 免训练(
Decider) 适用于任意开源 LLM,不需要训练。直接读标签 logits 时,换个选项顺序答案就会变, 而且结果带着模型对某些标签的偏好。L0 不用一条标签就能把这两样都去掉。 - AnyJev 自蒸馏(
Tacit) 用的是 Tacit 模型。它们通过自蒸馏训练:模型学会在一次前向里给出它推理之后才会得出的答案。 不用人工标签,也不用其他模型。每个决策一次 prefill;打开adaptive=True后,一部分决策会转去推理,比例有上限。
| ⚪ 直接读 logits | 🔵 L0 零标签 |
|
|---|---|---|
| 需要的标签 | 无 | 无 |
| 选项倒序后答案翻转率 | 0.230 | 0.073 |
| 准确率 | 0.747 | 0.803 |
| 校准误差(ECE) | 0.240 | 0.184 |
| ≤5% 错误率下可自动决策的比例 | 7.7% | 46.3% |
Qwen3-8B,BANKING77 20 类,300 条测试样本 · bench/results_v01/2026-09-22/Qwen__Qwen3-8B.json
最后一行最要紧。准确率只涨了六个点,但置信度足以在 ≤5% 错误率下自动处理的决策,从 7.7% 涨到 46.3%,而且一条标签都没用。
📊 Tacit 结果
| 模型 | 基座 | JevBench 公开集(231) | 分流 | bev-decision 测试集(46,320) | 分流 |
|---|---|---|---|---|---|
| Tacit-9B | Qwen3.5-9B | 0.823 | 0.887 15.2% | 0.727 | 0.755 18.1% |
| Tacit-8B | Qwen3-8B | 0.736 | — | 0.663 | — |
| Tacit-4B | Qwen3-4B | 0.723 | 0.758 14.3% | 0.663 | 0.704 17.8% |
| Tacit-2B | Qwen3.5-2B | 0.671 | — | 0.626 | — |
| Tacit-1.7B | Qwen3-1.7B | 0.619 | — | 0.598 | — |
两个测试集全部样本上的准确率(JevBench 公开集;
bev-decision 测试集),按数据集存储顺序。第一列:每个决策一次前向
(adaptive=False)。分流:adaptive=True,默认参数(tau=0.5,每 1,000 个决策里最多 20% 转去推理),小字是转去推理的比例。
用 vllm serve(vLLM 0.17.1)服务,scripts/eval_tacit.py 运行 · bench/results_tacit/2026-10-06/
打开转推理后,平均每个决策多生成的 token:Tacit-9B 在 JevBench 上 567 个、bev-decision 上 458 个;Tacit-4B 分别是 305 和 187 个。Tacit-8B、2B、1.7B 打开转推理的结果随后补上。
🏆 Decision Index 上的 AnyJev Tacitus
AnyJev Tacitus 31B 是从 google/gemma-4-31B-it
微调出来的决策模型,推理技术和训练一起设计。每个决策都用 AnyJev 的读出方式一次 prefill 读出,不生成 token。在
Decision Index 0.4.1 排行榜上,按总分(Full score)并列第 3(2026-10-21);
从 0.4 版起,总分只计私有部分。
| 总分 | 同技能私有测试 60% | 新领域私有测试 40% | 公开部分 不计分 | 延迟 中位数 / 平均 / p95 |
|---|---|---|---|---|
| 66.47 | 62.48 | 56.93 | 65.52 | 95 / 265 / 1,000 ms |
两个私有部分和延迟由排行榜维护者测量(单进程,一张 RTX PRO 6000)。用 vLLM 0.29.0 加载时转 FP8,加上模型自带的 vLLM 插件,
anyjev 0.3.0。引擎、插件和运行设置:MorrisZJ/anyjev-tacitus;结果:decision-index-results ·
bench/results_decision_index/2026-10-21/anyjev-tacitus-31b.json
🏆 Decision Index 上的免训练结果
L0 档的 Decider,用未改动的 google/gemma-4-31B-it:不训练、不用标签,
每个决策读两次轮换。在 Decision Index 0.3 排行榜上,按总分(Full score)在 149 个条目中排第 5(2026-10-12)。
| 总分 | 公开部分 20% | 同技能私有测试 50% | 新领域私有测试 30% | 延迟 中位数 / 平均 / p95 |
|---|---|---|---|---|
| 60.22 | 59.79 | 59.13 | 52.98 | 98 / 260 / 1,080 ms |
两个私有部分和延迟由排行榜维护者测量(单进程,一张 RTX PRO 6000)。用 vllm serve --quantization fp8(vLLM 0.29.0)
服务,anyjev 0.3.0。引擎和运行设置:examples/decision_index(提交时用的是
anyjev-l0-gemma);模型卡:
AnyJev-L0-Gemma-4-31B ·
bench/results_decision_index/2026-10-12/anyjev-l0-gemma-4-31b.json
🧠 怎么读出一个决策
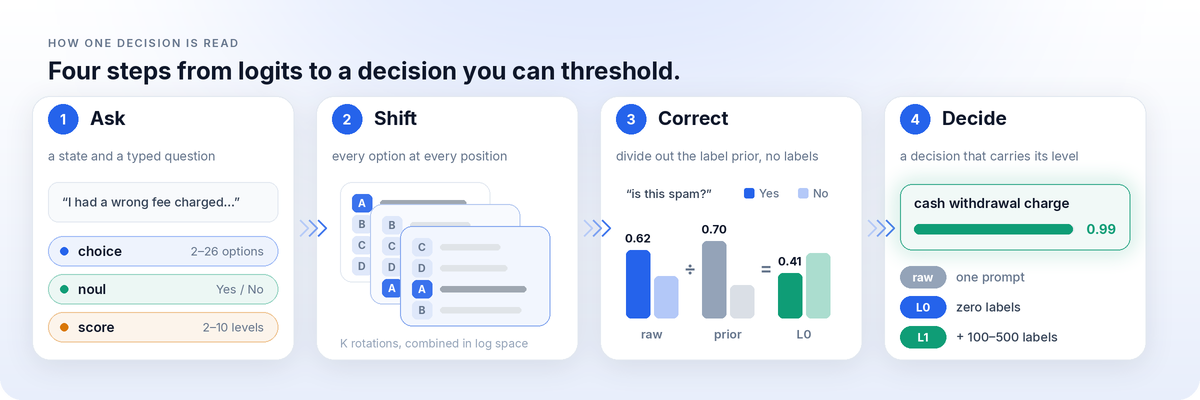
| 需要 | 做什么 | 不做什么 | |
|---|---|---|---|
raw |
无 | 一个 prompt,softmax 只在选项标签上做 | 修正顺序偏差或标签偏好 |
L0 |
无 | 在 K 种轮换上平均掉位置偏差,再除掉标签先验 | 用标签校准 |
Tacit one_forward |
一个 Tacit 模型 | 一个 prompt,读法同 raw,读的是一个被训练成一次就答的模型 |
修正顺序偏差 |
Tacit cot |
adaptive=True |
先推理,推理结束后再读标签分布 | 超出上限 |
每个 Decision 都带着它的 level,require="L0" 让下游代码拒绝更弱的档位。每个 Tacit 决策都带着它的 route。
完整约定 →
本页每个数字都读自仓库里提交的 JSON。与 TypeSafe AI 或 Jev 没有任何关联。
🧭 路线图
-
choice、noul、score一次 prefill 读出;零标签的 L0 - 旋转预算:L0 平均读 18 次轮换里的 7 次左右,停止门槛不用标签就能证明
- Tacit-1.7B、2B、4B、8B、9B 发布在 Hugging Face;库里的
Tacit支持 transformers、vLLM 和vllm serve,带有上限的转推理和 HTTP 网关 - 评测代码(
scripts/eval_tacit.py);Tacit-9B 和 Tacit-4B 打开转推理的结果 - 免训练路线上了公开的 Decision Index 0.3 排行榜(Gemma-4-31B 上的 L0)
- AnyJev Tacitus 31B 上了 Decision Index 0.4.1 排行榜,并列第 3(详情)
- 🚧 Tacit-8B、2B、1.7B 打开转推理的结果
- 🚧 无标签的提前退出:只用模型的一部分层读出决策,层数按与完整模型的一致率来选
- Agent 循环里的评测:把同样的决策放进真实的 agent 里
- SGLang 后端(
anyjev.backends.sglang),由 @shentonyan 贡献 - 支持 GGUF 模型的 llama.cpp 后端(
anyjev.backends.llamacpp),由 @Tusm11 贡献 - 更多 log-prob 后端(MLX、Ollama),以及超过 26 个选项的 span 读法
带日期的计划和 help-wanted 文件:ROADMAP.md。已知局限:docs/limitations.zh-CN.md。
🤝 贡献与引用
每个后端是一个文件,其中好几个是 help wanted(ROADMAP.md、CONTRIBUTING.md)。变更记录:CHANGELOG.md。致谢:CREDITS.md。
技术报告:
@misc{zhang2026anyjevtechnicalreport,
      title={AnyJev Technical Report},
      author={Jiamu Zhang and Tianze Yang and Yucheng Shi and Evan Chen and Zixiang Nie and Kelly Wan and Liangjie Hong and Ninghao Liu and Liang Wu},
      year={2026},
      eprint={2610.00831},
      archivePrefix={arXiv},
      primaryClass={cs.LG},
      url={https://arxiv.org/abs/2610.00831},
}
Apache-2.0,见 LICENSE。Tacit 模型沿用其基座模型的 Apache-2.0 许可。数据集各有自己的许可,见 THIRD_PARTY.md。
探索相关项目
affaan-m/ECC
智能体执行与控制框架的性能优化系统。面向 Claude Code、Codex、Opencode、Cursor 等,涵盖技能、本能、记忆、安全与研究优先的开发。
301,331 星标NousResearch/hermes-agent
与你一同成长的智能体
262,724 星标multica-ai/andrej-karpathy-skills
一个用于改进 Claude Code 行为的 CLAUDE.md 文件,源自 Andrej Karpathy 对 LLM 编程陷阱的观察。
232,200 星标firecrawl/firecrawl
借助来自网络及其他来源的数据,强化你的 AI 智能体。正在构建面向超级智能的资料库。🔥
200,932 星标