
mizorewww/laya-coreml
mizorewww/laya-coreml has 1,633 GitHub stars and 140 forks. GitHot measured +2 stars in 24 hours and +1 in 7 days. Last checked 2026-11-11 17:21 UTC. Last push 2026-10-29.
Local Laya typed decisions on Apple Core ML and Neural Engine. Validated ports, ~5 ms short decisions on M3 Max, reproducible speed and energy benchmarks.
实测星标增长
- 24小时
- +2
- 7天
- +1
- 15天
- 更新延迟
- 1个月
- 更新延迟
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
README.zh-CN.md
原文Laya-CoreML
开放权重的类型化决策模型,跑在 Apple Silicon 上:Core ML、神经网络引擎,不生成任何 token。
English · 使用参考 · 基准测试 · PyPI · Hugging Face 权重 · 更新日志
Laya 专门回答有固定答案范围的问题:从几个选项里挑一个、按评分标准打分、判断一句话真不真。 它只做一次双向前向计算,直接给出校准后的概率,不逐个生成 token,也不需要解析输出的 JSON。 本项目把 Laya 原版权重转成 Core ML 程序,可在 CPU、GPU 或神经网络引擎(ANE)上运行;推理不依赖 PyTorch、Transformers 或 MLX。
在 M3 Max 的神经网络引擎上,一个简短的多语言问题中位延迟 4.98 ms, 系统能耗比编译后的 MLX 低 2.78 倍。
快速开始
需要 Apple Silicon、macOS 15+ 和 Python 3.11–3.13。
pip install laya-coreml
import laya_coreml as laya

agent = laya.load("aac6fef/laya-multilingual-coreml-adaptive-fp16")
result = agent.predict(
    "I was billed twice. Please refund the duplicate.",
    {
        "department": {
            "type": "choice",
            "instructions": "Which department should handle this request?",
            "criteria": {
                "billing": "Payments, invoices, refunds, and duplicate charges.",
                "technical": "Broken features, errors, and product troubleshooting.",
                "sales": "Pricing, upgrades, and new purchases.",
            },
        },
        "refund": {
            "type": "noul",
            "instructions": "Does the customer ask for money back?",
        },
    },
)
print(result["answers"]["department"]["choice"])  # billing
像上面这样给每个选项写上说明,效果远好于只给标签名。首次使用前会下载模型包,之后的预测都在本地完成。传入 local_files_only=True 可禁止联网。
问题类型
| 类型 | 你提供 | 你得到 |
|---|---|---|
choice |
若干选项:列表,或「标签 → 说明」字典 | 每个选项的概率 |
score |
有序的评分档位 | 每档的概率和期望档位 |
noul |
一个是非命题 | 为真的概率 |
输入状态可以是文本、类 JSON 字典或对话列表。每个答案都附带校准概率和置信度; 在新任务上,置信度高不代表一定答对。
模型包
所有模型包都在 Hugging Face 的 aac6fef/ 下。
| 模型包 | 计算单元 | 容量 | 用途 |
|---|---|---|---|
laya-multilingual-coreml-adaptive-fp16(另有 -fp32) |
CPU + GPU | 1,024 token,原生批量 1/2/4/16 | 推荐的通用多语言模型 |
laya-coreml-adaptive-fp16 / -fp32 |
CPU + GPU | 512 token,原生批量 1/2/4/16 | 英文,421M |
laya-typed-decisions-coreml-adaptive-fp16 / -fp32 |
CPU + GPU | 1,024 token,原生批量 1/2/4/16 | 上游 typed-decisions 工作流 |
laya-coreml、laya-multilingual-coreml、laya-typed-decisions-coreml |
CPU + GPU | 512 / 1,024 token,批量 1 | 原始单图模型包,Router() 默认使用 |
laya-multilingual-coreml-ane |
CPU + 神经网络引擎 | 总共 96 token,批量 1 | 短问题最快,FP16 |
laya-multilingual-coreml-ane-w8 |
CPU + 神经网络引擎 | 总共 96 token,批量 1 | 近似 8 位调色板压缩权重 |
laya-multilingual-coreml-snake |
CPU + GPU | 64 token,批量 3 | 贪吃蛇演示的三个问题 |
ANE 模型包的 96 token 上限把问题、选项和状态算在一起:状态过长会被截断,问题或选项超长则直接报错。 每个模型包都带有分词器、模型卡、来源说明、校验和与验证结果。 如何选择模型包、固定版本与离线使用。
其他功能
详见使用参考:
- 语言路由:
Router()自动识别语言、选择模型包,默认最多常驻两个;也可以注册自己的模型包。 - 批量与长文档:
predict_batch与predict_long,长文本扫描会保留答案出自哪一段。 - 置信度门槛:
min_confidence=把低置信度答案标记出来供人工复核,答案本身不变。 - 超多选项:
predict_tournament(分组淘汰,不需要嵌入模型),或配合自备嵌入函数使用predict_shortlist。 - 计算单元:
compute_units="cpu_gpu" | "cpu_ne" | "cpu" | "all"可覆盖模型包的默认设置。 - 工具与服务:命令行(
laya-coreml predict)、HTTP(laya-coreml-serve)、MCP(laya-coreml-mcp-server)、评估与校准,以及 LangChain/LlamaIndex/CrewAI/Agno 集成,按需安装 extras。 - 转换:
pip install 'laya-coreml[convert]'后用laya-coreml convert导出自己的模型包。
性能
M3 Max(40 核 GPU,128 GiB)。单个 91 token 的问题补齐到 96,端到端计时, 数据来自交替进行的 20 秒测试块,共 65,598 次稳定调用:
| 编译后的 MLX FP16 | Core ML ANE FP16 | Core ML ANE W8 | |
|---|---|---|---|
| P50 / P95 | 6.94 / 7.39 ms | 4.98 / 5.31 ms | 4.88 / 5.23 ms |
| 每次决策的系统能耗 | 0.4288 J | 0.1540 J | 0.1344 J |
| 相对 MLX 的速度 / 能效 | 1× / 1× | 1.39× / 2.78× | 1.42× / 3.19× |
计时包含提示词构造、分词、推理、校准和结果格式化,不含加载与预热。能耗来自 SMC 功率传感器读数, 属于估算。ANE 的优势仅限短输入:1,024 token 的 ANE 图一次约 91.7 ms,完整的贪吃蛇游戏也不稳定地快于编译后的 MLX。 速度、能耗与硬件证据 · CPU/GPU 基准。
移植忠实度:通用模型包在 FP32 和 FP16 下,每个模型的 63 道验证题都与上游选出相同答案, 每种组合重复调用 100 次结果稳定。ANE FP16 模型包在能放进 96 token 的 59 道题上全部一致。 这些检验衡量的是转换是否忠实,不是任务准确率。
贪吃蛇演示
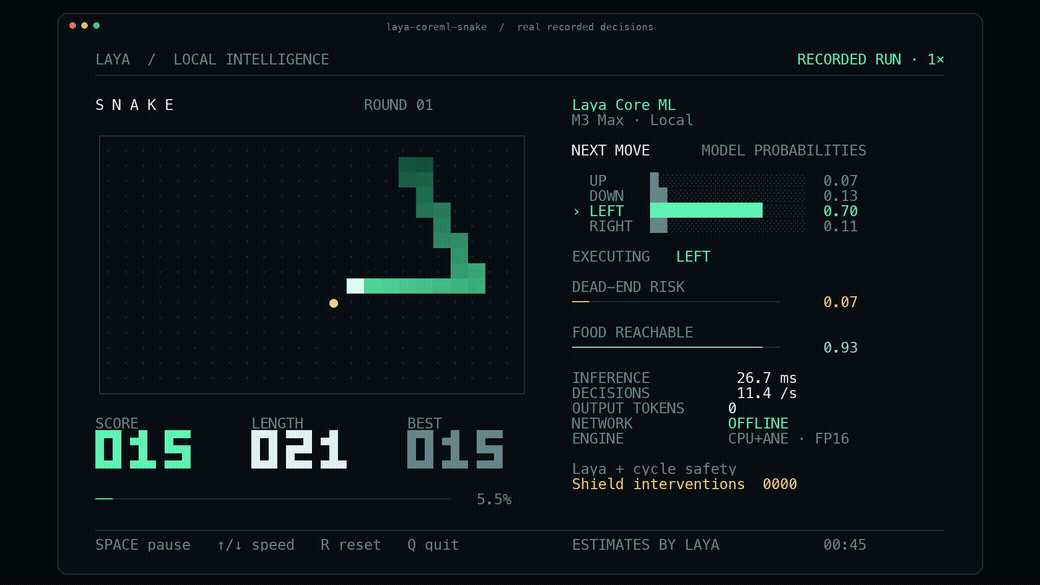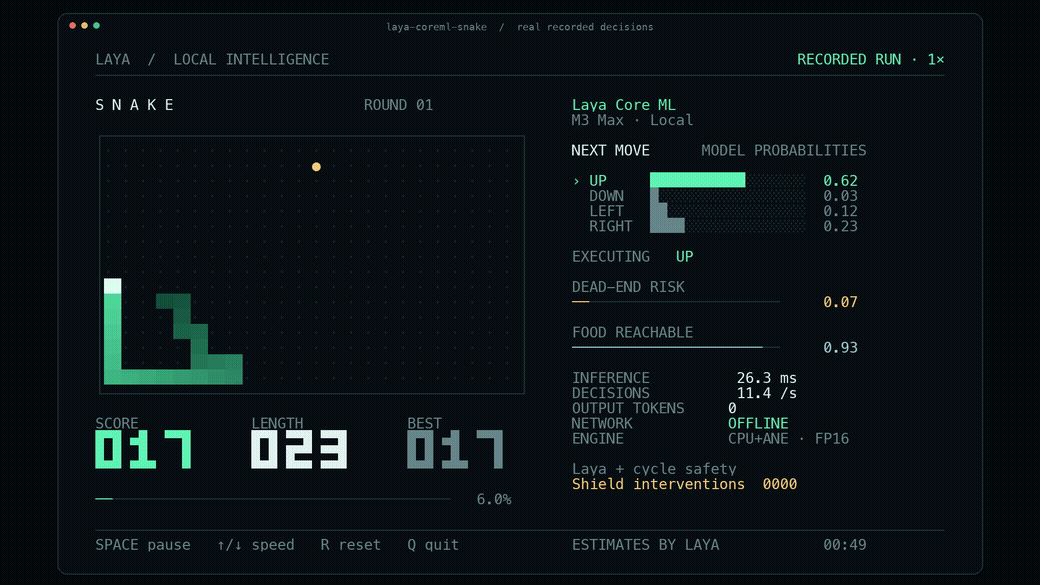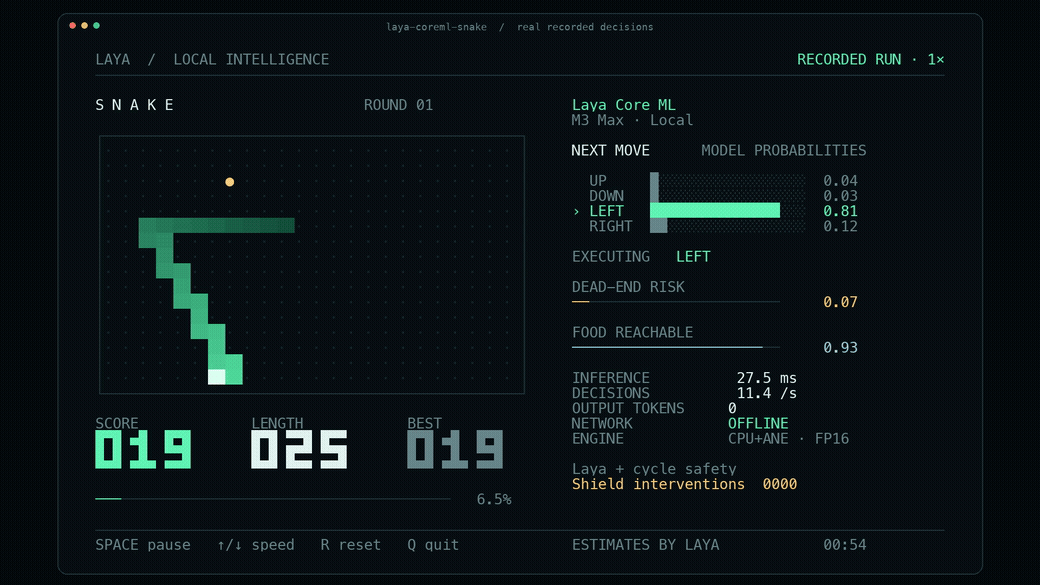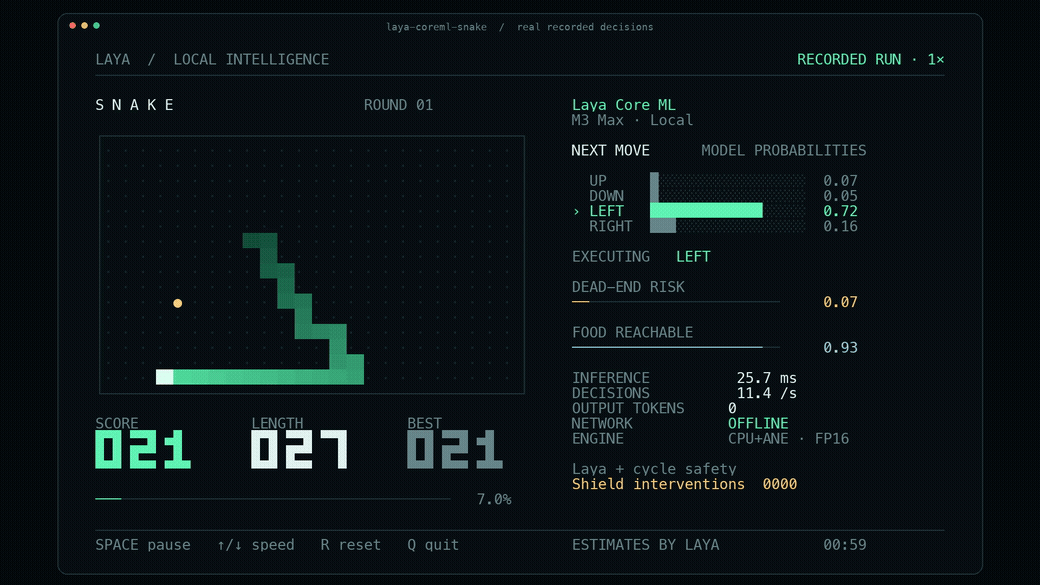
上面的 GIF 以 1 倍速回放一次真实的 Core ML 运行,画面上能看到实时概率、延迟和安全层的干预。
pip install 'laya-coreml[demo]'
hf download aac6fef/laya-multilingual-coreml-ane --local-dir models/snake
laya-coreml-snake --model ./models/snake
终端至少 104 × 35。空格暂停,↑/↓ 调速,R 重开,Q 退出。Core ML 首次初始化可能要几十秒。 完整游戏循环在三局不限速的 600 步对局中保持 每秒 49.1–50.0 次决策,零死亡。 演示说明 · 实测速率。
与上游的关系
这是独立移植,不是 Convai Innovations 或 Apple 的官方发布。提示词格式、校准、路由、输出结构和主机侧 API 跟随 NandhaKishorM/laya v0.4.17,只有张量、模型包、 设备和资源这几层是 Core ML 专有的。Core ML 模型包不提供编码器嵌入,训练请使用上游项目。 MLX 版本见姊妹项目 laya-mlx。 原生边界 · v0.4.17 迁移记录 · 全部文档。
参与贡献
欢迎提 issue 和 PR。主机侧行为必须能追溯到上游。开发环境、测试、转换和发版流程见 CONTRIBUTING.md。
许可证
Apache-2.0,见 LICENSE 与 NOTICE。Laya 及其预训练权重归 Convai Innovations 和上游贡献者所有。