
maximilianfeix/proxy-scraper
maximilianfeix/proxy-scraper has 94 GitHub stars and 22 forks. GitHot measured +2 stars in 24 hours. Last checked 2026-11-15 16:31 UTC. Last push 2026-11-15.
实测星标增长
- 24小时
- +2
- 7天
- 更新延迟
- 15天
- 更新延迟
- 1个月
- 更新延迟
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
关于
Free HTTP/SOCKS proxy list, rebuilt every hour, with the result of every check on record. CLI, Python API, rotating proxy server, MCP server.
开发工具README.zh-CN.md
原文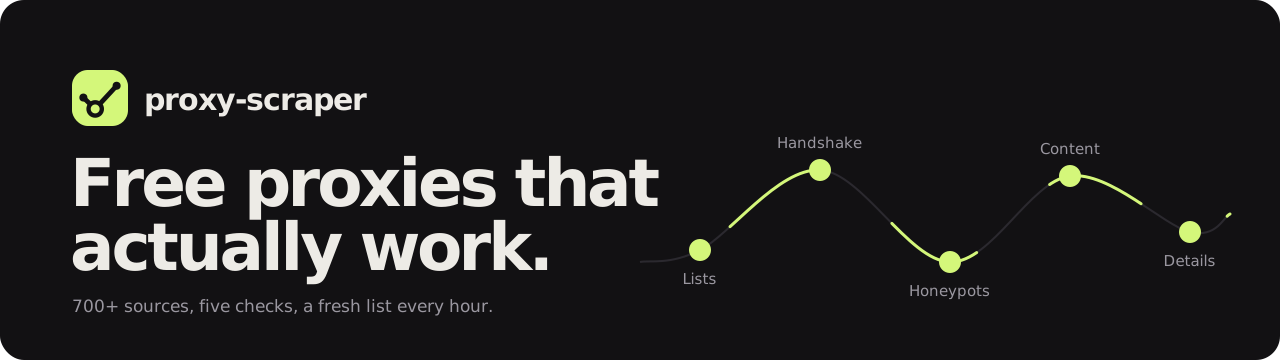





English · 简体中文 · Español · Deutsch · Русский · Português (Brasil) · Français
安装 · 每小时更新的代理列表 · 代理池 API(兼容 proxy_pool) · 轮换代理服务器 · Python · AI 智能体(MCP) · 常见问题
每一项代理检测都查得到:哪些通过了,哪些没通过,什么时候测的。 proxy-scraper 从数百个列表收集公开的 HTTP、SOCKS4 和 SOCKS5 代理,对每个代理最多做四项检测,并为列入列表的代理保留每一项检测的结果(其余代理只统计每项检测的结局)。这样,「可用」就是你能亲眼查看的东西,而不是一个只能选择相信的标签。
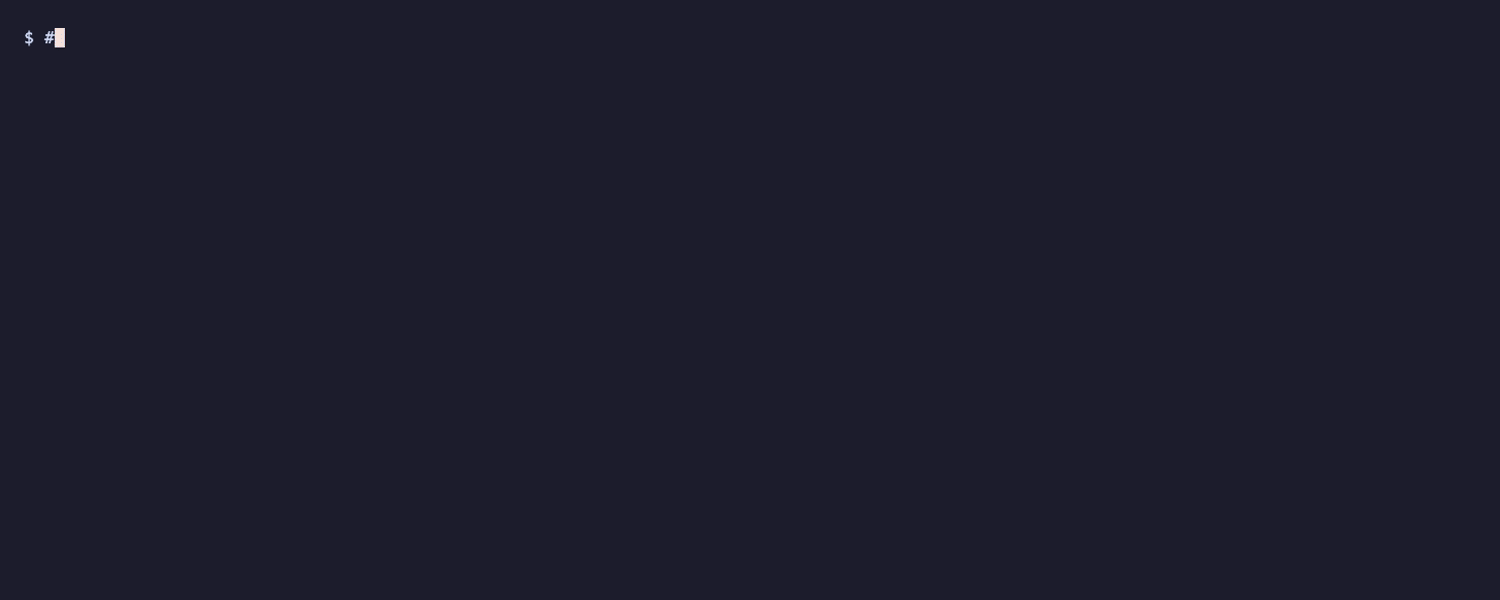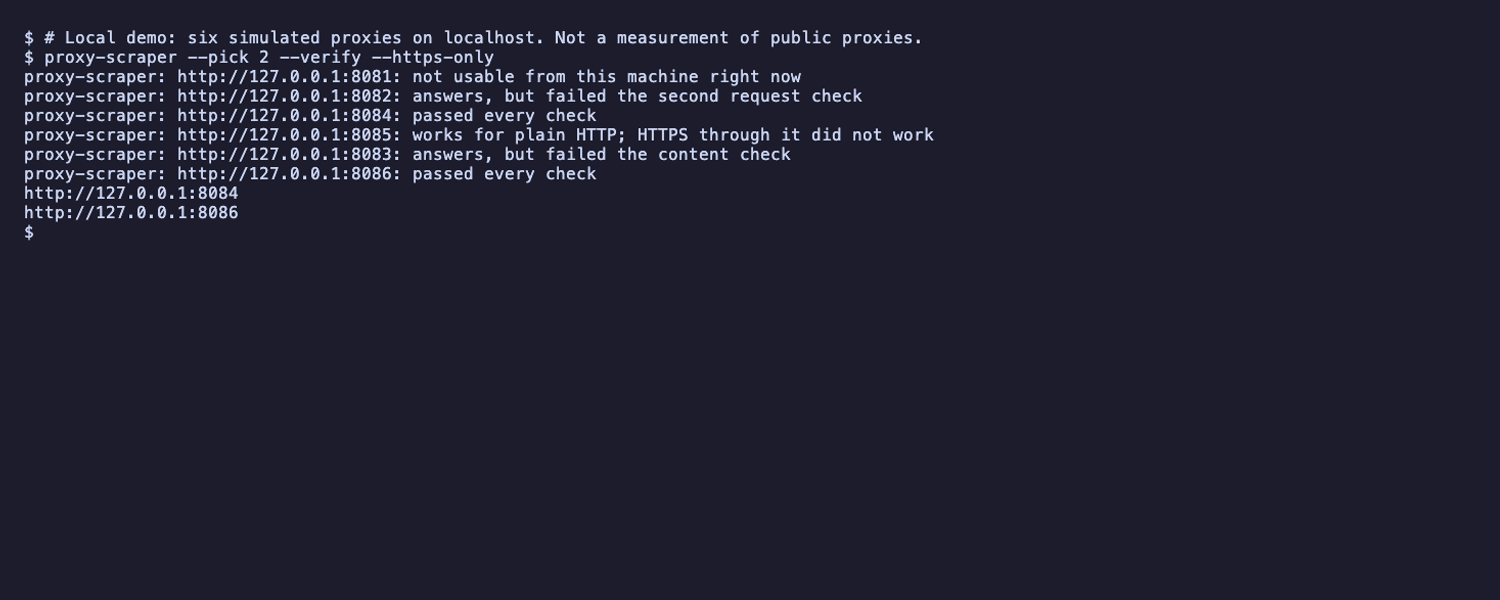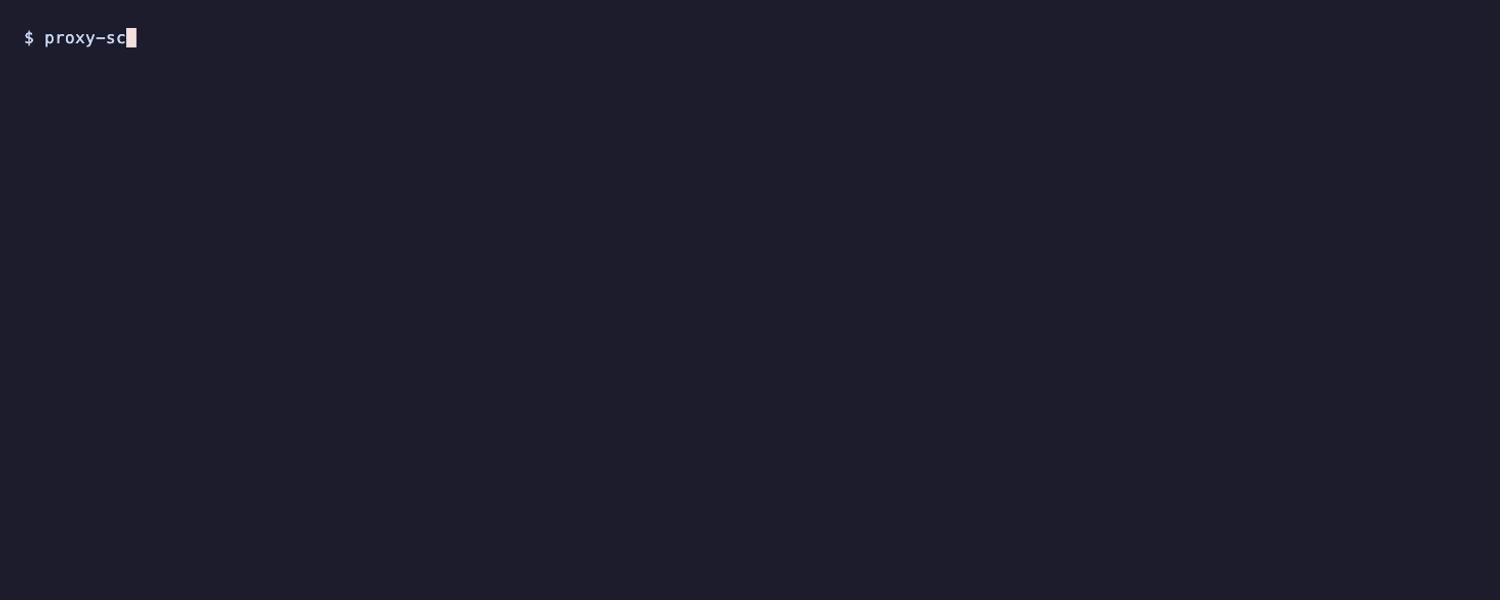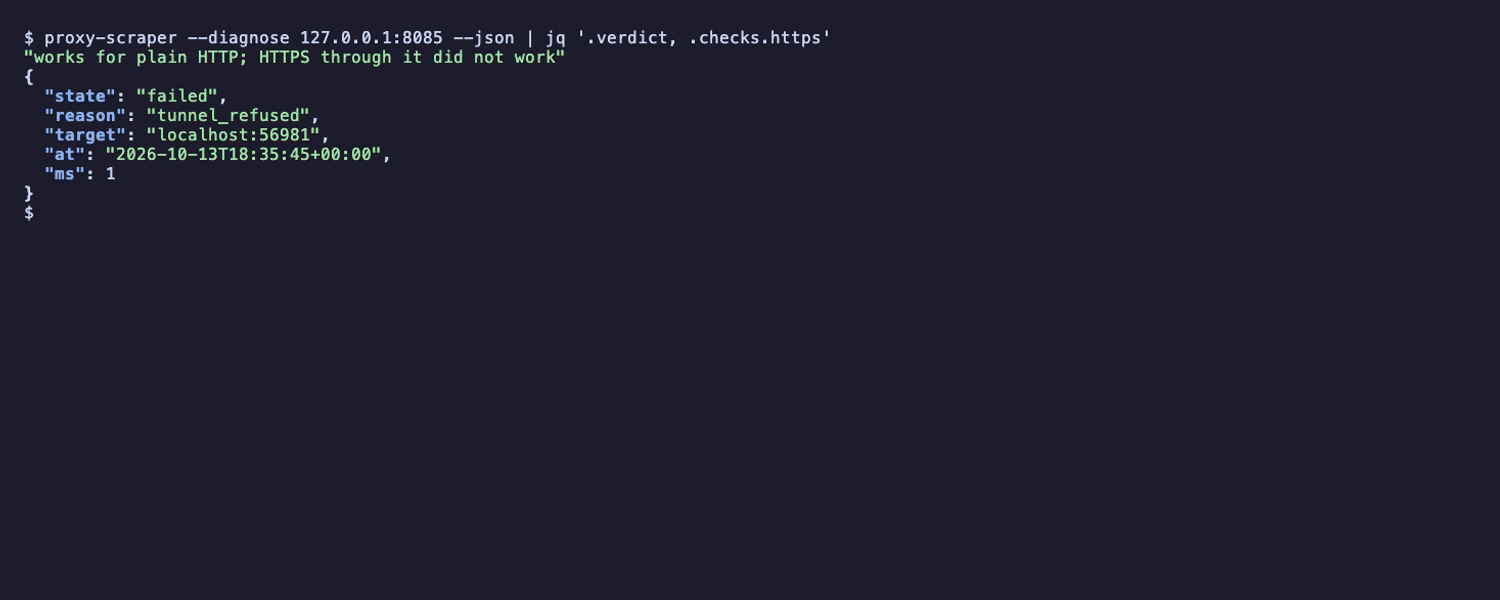
这是一段真实的终端录屏,检测对象是 localhost 上的六个模拟代理(复现方法)。它展示的是结果如何呈现,并不测量公开代理的任何情况。
试一试——无需安装,uvx 随 uv 提供(pipx run 效果相同):
uvx proxy-scraper-cli --pick 3 --verify               # 从每小时列表最多取 3 个此刻从你的网络能通过检测的代理
uvx proxy-scraper-cli --diagnose socks5://HOST:PORT   # 单个代理,逐项检测:哪些做到了,哪些没做到
PyPI 上的包名是 proxy-scraper-cli(不带后缀的名字已被占用)。安装之后,命令是 proxy-scraper。--verify 和 --diagnose 需要 1.30 或更高版本。
获取代理的三种方式,以及每种方式下「已检测」的含义:
| 命令 | 代理来源 | 检测时间和位置 | 耗时 |
|---|---|---|---|
proxy-scraper --pick 5 |
已发布的列表 | 列表生成时从 GitHub 的服务器检测,大约每小时一次 | 不到一秒 |
proxy-scraper --pick 5 --verify |
已发布的列表 | 现在,从你的网络 | 几秒;检测最多 90 秒,另加几秒加载列表 |
proxy-scraper -y |
工具已知的所有列表 | 现在,从你的网络 | 几分钟(每小时的运行大约三分钟) |
你能得到什么
- 每项检测都有一个看得懂的结果。
passed、failed、unavailable或skipped(通过、未通过、无法检测、已跳过),附带原因代码、检测目标和时间,在终端、JSON 和 Python 中都能看到。没有运行的检测绝不会显示为通过;检测目标自身宕机时,用它检测的代理也不会被记为未通过。→ 检测状态(英文) - 需要时拿到最新结果。
--pick --verify从你自己的网络检测几个代理,通常只要几秒。--recheck对你自己的列表做同样的事,--diagnose告诉你某个代理为什么不能用。 - 不只是一份列表。 本地轮换代理服务器、Python API、面向 AI 智能体的 MCP 服务器、Docker,以及 curl、proxychains、Clash 和 sing-box 的导出格式。
它做不到的事。 免费代理由陌生人运营;某一小时的列表里,一天后仍在列表上的只有大约四分之一。一次通过只是一次测量:来自一个网络,针对的是测试目标。它不保证下一个小时仍然可用,也不保证能访问你关心的网站。HTTPS 检测只是与一个测试主机建立经过验证的 TLS 连接,不是安全评级。免费代理只适合公开数据和测试,绝不要用于登录、支付或任何涉及个人信息的操作。→ 这些数字说明了什么,没说明什么(英文) · 与其他项目的对比(英文) · 谁在运行免费代理
只想要列表? 那你不需要这个工具:free-proxy-list 按协议和国家提供纯文本文件,大约每小时重新生成一次。也可以直接从这里下载:all.txt · http.txt · socks4.txt · socks5.txt · proxies.json · 更多格式
谁在用: 每小时更新的列表是 monosans/proxy-scraper-checker 和 gfpcom/free-proxy-list 的内置数据源。
每个代理都要通过的检测
| 检测 | 说明 |
|---|---|
| 真实握手 | 代理必须真正完成 HTTP / SOCKS4 / SOCKS5 协议握手 |
| 第二次请求,同一出口 IP | 发往另一个站点的第二次请求必须显示同一个出口 IP。只应答第一次检测的代理、不稳定的代理和出口会变的代理都会在这里被淘汰 |
| 内容未改变 | 一个静态测试页面必须逐字节到达。内容不一致的原因不做判断 |
| HTTPS 证书验证通过 | 只有经代理隧道收到的 TLS 证书对测试主机验证通过,代理才会被标记为支持 HTTPS |
| 详细信息 | 匿名级别(elite / anonymous / transparent)、国家、ASN 和运营商、是否为数据中心、延迟、下载速度 |
安装
pipx install proxy-scraper-cli
proxy-scraper
PyPI 上的包名是 proxy-scraper-cli,命令是 proxy-scraper。支持 Python 3.9–3.14,macOS、Linux 和 Windows 均可运行,只依赖 rich 和 certifi。
macOS 和 Linux 也可以用 Homebrew 安装:
brew install maximilianfeix/tap/proxy-scraper
在国内下载较慢时,可以使用 PyPI 镜像:
pip install -i https://pypi.tuna.tsinghua.edu.cn/simple proxy-scraper-cli
也可以用 Docker(linux/amd64 和 linux/arm64):
docker run --rm ghcr.io/maximilianfeix/proxy-scraper --want 50 --https-only
不带参数运行时会出现一个设置向导,用方向键选择预设(全部协议、网页浏览、最高匿名、快速稳定……),最后会显示对应的命令行。
每小时更新的代理列表
不想自己扫描?GitHub Actions 大约每小时运行一次本工具并发布结果。列表中的每个代理在上一次运行中都通过了第一次请求、第二次请求和内容检测(HTTPS 测试的结果按条目记录,但不是入选条件),按「最优优先」排序:加载网页快、并且很可能仍然在线的排在最前面。
- 网页版(可按协议、国家、HTTPS、运营商、延迟筛选):https://proxy-scraper.de/
- 纯列表仓库(按协议、按国家、按网站分类的 TXT,以及 JSON / CSV):maximilianfeix/free-proxy-list
| 列表 | 格式 | 地址 |
|---|---|---|
| 全部 | socks5://1.2.3.4:1080 |
https://proxy-scraper.de/all.txt |
| HTTP · SOCKS4 · SOCKS5 | 1.2.3.4:8080 |
…/http.txt · …/socks4.txt · …/socks5.txt |
| 支持 HTTPS | type://ip:port |
…/https.txt |
| 高匿(elite) | type://ip:port |
…/elite.txt |
| 稳定(本周 90% 以上的运行中都在列表里) | type://ip:port |
…/stable.txt |
| 完整信息 | 延迟、国家、HTTPS、匿名级别、出口 IP、在线率 | …/proxies.json · …/proxies.csv |
curl -s https://proxy-scraper.de/socks5.txt | head
[!TIP] 如果
raw.githubusercontent.com访问不稳定,优先使用上面的 proxy-scraper.de 地址(没有 raw.githubusercontent 那样的速率限制,支持 CORS)。也可以用 jsDelivr:https://cdn.jsdelivr.net/gh/maximilianfeix/proxy-scraper@proxy-list/socks5.txt(可能会延迟几个小时)。
这些代理是从 GitHub 托管的运行器(runner)上检测的。proxy-scraper --recheck live 会下载列表并从你自己的网络重新检测一遍,远不到一分钟,不必完整扫描。从你的网络还能用的数量,和列表自己的数字相差很大,这正是重新检测的意义。
代理池 API:兼容 jhao104/proxy_pool
用过 jhao104/proxy_pool?proxy-scraper 的接口、type=https 参数和大部分 JSON 字段(proxy、https、region、check_count、fail_count 等)与它相同,把代码指向 8899 端口,大部分都能继续使用(有三处不同:没有 last_time 字段,anonymous 是 true/false 而不是字符串,source 始终是 proxy-scraper)——不需要 Redis,而且每个代理都通过了第二次请求检测和内容检测,标记为支持 HTTPS 的代理还通过了 TLS 检测。
proxy-scraper --recheck live --serve # 从每小时列表开始,约 30 秒后可用
curl http://127.0.0.1:8899/get                                    # 一个代理(JSON)
curl "http://127.0.0.1:8899/get?country=DE&https=1&format=txt"    # → http://203.0.113.7:8080
curl "http://127.0.0.1:8899/all?protocol=socks5&limit=20"         # 最优的 20 个 SOCKS5 代理
curl "http://127.0.0.1:8899/report?proxy=203.0.113.7:8080&ok=0"   # 反馈失败,连续三次后移出代理池
| 接口 | 作用 |
|---|---|
/get |
按 --rotate 策略选一个代理 |
/pop |
同 /get,并把该代理移出代理池 |
/all |
所有可用代理,最优优先(limit=N) |
/count |
按类型和国家统计 |
/delete?proxy=IP:PORT |
移除一个代理 |
/report?proxy=IP:PORT&ok=0 |
反馈你自己请求的结果 |
/get、/pop 和 /all 支持筛选:country=DE,AT、protocol=socks5、https=1、anonymity=elite、max_latency=1500,以及 format=txt 返回纯文本 URL。
import requests
proxy = requests.get("http://127.0.0.1:8899/get?type=https").json()["url"]   # 例如 socks5://…,已包含类型
requests.get("https://example.com", proxies={"http": proxy, "https": proxy})
轮换代理服务器
同一个端口也是一个本地代理:每个连接都会走不同的代理,失败时自动切换到下一个。
curl -x http://127.0.0.1:8899 https://api.ipify.org                  # 每次都是不同的 IP
curl -x socks5h://127.0.0.1:8899 https://api.ipify.org               # 同一端口也支持 SOCKS5
curl -x http://country-us:[email protected]:8899 https://api.ipify.org     # 只用美国出口
curl -x http://session-cart42:[email protected]:8899 https://shop.example  # 同一会话保持同一个代理
和商业轮换代理一样,通过用户名指定需求:country-XX、type-http|socks4|socks5、session-名称,可以组合使用。HTTPS 优先使用 TLS 验证通过的代理;如果当前没有合适的已验证代理(没有符合需求的,例如 country-de,或者它们都已被移出轮换),则使用其他代理——客户端自己的证书校验仍然有效,请不要关闭;连续失败三次的代理会被移出轮换,之后定期重新检测。默认只监听 127.0.0.1;如需对外开放,请用 PROXY_SCRAPER_SERVE_PASSWORD 设置密码。更多选项见英文文档。
在 Python 中使用
from proxyscraper import ProxyRotator, live_proxies

# 每小时列表,不做检测,约一秒返回
proxies = live_proxies(types=["socks5"], https=True, min_uptime=90)

# 自动重试和切换代理
with ProxyRotator(country="US") as rotator:
    r = rotator.get("https://httpbin.org/ip")
    print(r.status, r.text, "via", r.via)

# 给 requests / httpx / Playwright / Scrapy 用的本地轮换代理地址
with ProxyRotator() as rotator:
    proxy = rotator.proxy_url()
需要从自己的网络重新检测时,使用 find_proxies() 和 check_proxies()。完整说明见英文文档。
常用命令
proxy-scraper --want 50 --https-only                   # 找到 50 个支持 HTTPS 的代理后停止
proxy-scraper --types socks5 --anonymity elite         # 高匿 SOCKS5
proxy-scraper --country US,JP,SG --max-latency 1500    # 指定国家和最大延迟
proxy-scraper --target www.google.com --want 20        # 只保留能访问目标网站的代理
proxy-scraper --pick 5 --types socks5                  # 直接从每小时列表取 5 个,不扫描
proxy-scraper --export clash                           # 导出 Clash 配置(也支持 proxychains、sing-box、curl、PAC 和 Proxifier)
全部选项:proxy-scraper --help,或查看英文文档。
AI 智能体(MCP)
proxy-scraper-mcp 是一个 MCP 服务器:Claude Code、Claude Desktop、Cursor、VS Code 等客户端可以获取可用代理,并通过它们加载网页。

{
  "mcpServers": {
    "proxy-scraper": {
      "command": "uvx",
      "args": ["--python", ">=3.10", "--from", "proxy-scraper-cli[mcp]", "proxy-scraper-mcp"]
    }
  }
}
不想装 Python?用 Docker 镜像(已包含所有依赖):"command": "docker","args": ["run", "-i", "--rm", "ghcr.io/maximilianfeix/proxy-scraper", "--mcp"]。
常见问题
谁在运行免费代理?可以放心使用吗? 几乎没有人是专门为你提供的。公开列表上的代理通常是:配置错误、端口意外开放的服务器;少数有意开放的代理;被感染而主人并不知情的电脑和物联网设备;以及陷阱:有意记录流量的代理和改写网页的代理。以上是一般性的背景,并不是本项目测量出来的结论:检测看不出代理由谁运行、出于什么目的。proxy-scraper 无法区分被感染的家用路由器和开放的办公代理,但会过滤它能测量的部分:两次独立请求必须显示相同的出口 IP,已知页面必须逐字节一致,HTTPS 只在证书对测试主机验证通过时才算数。适合公开数据、查看其他国家的网站效果、测试自己的封禁规则和科研;绝不要通过免费代理发送密码、Cookie、支付或个人信息。
为什么比其他列表的代理少? 因为只保留通过全部检测的代理:两次独立请求显示同一个外部出口 IP,测试页面原样到达。在每小时的运行中,这远低于所检测的 15 万个候选代理的 1%(2026 年 11 月 3 日至 10 日,每次运行在 0.2% 到 1.3% 之间)。它们是在那个时刻、从执行检测的那个网络通过的。
几乎什么都检测不通过? 很多公司、学校和部分网络环境会拦截代理连接。工具在命中率低于 0.2% 时会给出提示,换一个网络(例如手机热点)通常有帮助。
免费代理安全吗? 免费代理由陌生人运营,请视为不可信。不要通过它们发送密码或个人信息。列表中的代理都通过了内容检测(测试页面逐字节到达),标记为支持 HTTPS 的代理其证书对测试主机验证通过,适合抓取公开页面或查看其他国家的网站,不适合网银等敏感操作。
列表多久更新一次?
大约每小时一次。免费代理变化很快,重要场景请在使用前运行 proxy-scraper --recheck。
参与贡献
欢迎提交 Issue 和 Pull Request(中文或英文都可以)。Hacktoberfest 期间有一些适合新手的 Issue。如果这个项目对你有帮助,欢迎点一个 ⭐。
免责声明
本工具只使用公开的代理列表。请遵守当地法律法规以及你所访问网站的使用条款,仅将代理用于合法用途。项目采用 MIT 许可证。