
loomax-labs/InferrLM
loomax-labs/InferrLM has 115 GitHub stars and 24 forks. GitHot measured +1 stars in 24 hours and +1 in 7 days. Last checked 2026-11-15 15:53 UTC. Last push 2026-09-26.
实测星标增长
- 24小时
- +1
- 7天
- +1
- 15天
- 更新延迟
- 1个月
- 更新延迟
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
关于
InferrLM - On-device AI for iOS & Android
人工智能README.zh-CN.md
原文English | 简体中文 | 繁體中文 | 日本語 | 한국어 | Deutsch | Français | Nederlands
InferrLM(以前叫 Inferra)


InferrLM 是一款手机软件,能把大模型和小模型直接放到你的 Android 和 iOS 手机上,也能让手机当本地服务器。Claude、Gemini、ChatGPT 这类云端模型也能用。本地模型还可以附带文件,并用 RAG(先找出文档里相关的内容,再让模型回答)。


目录
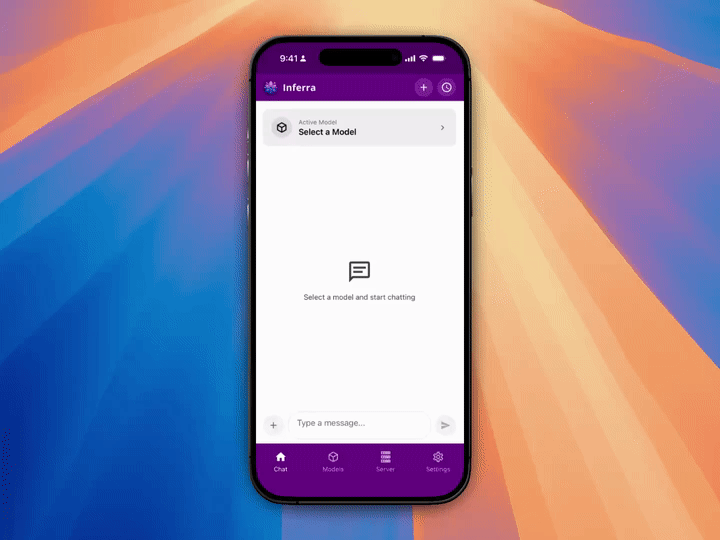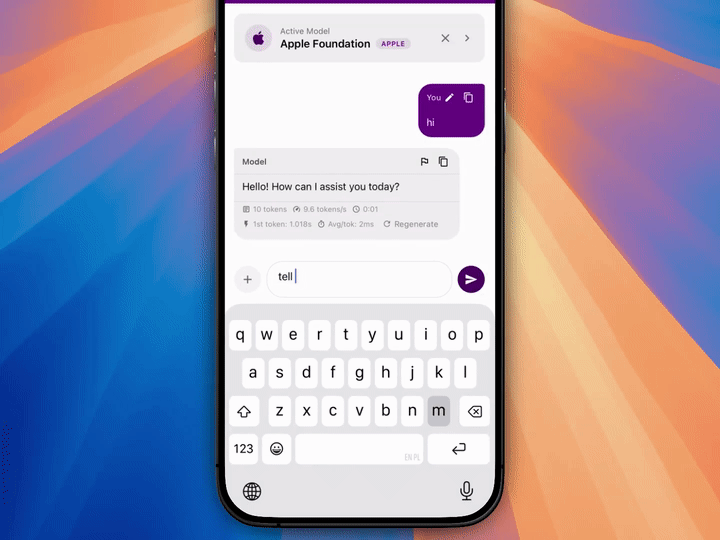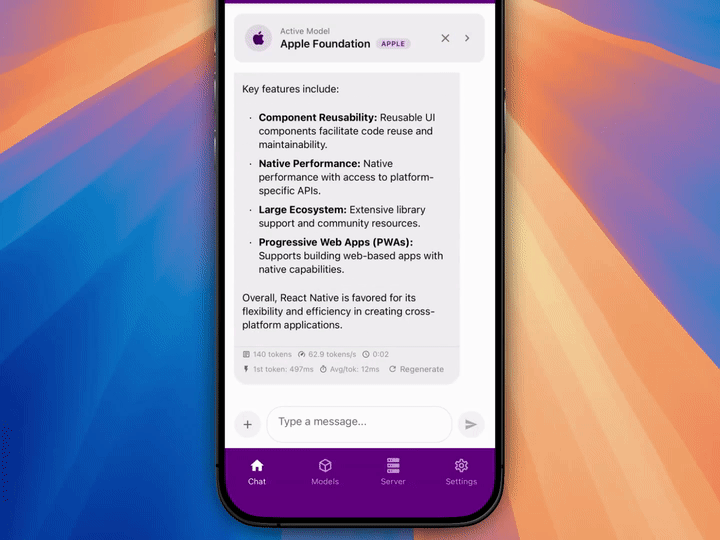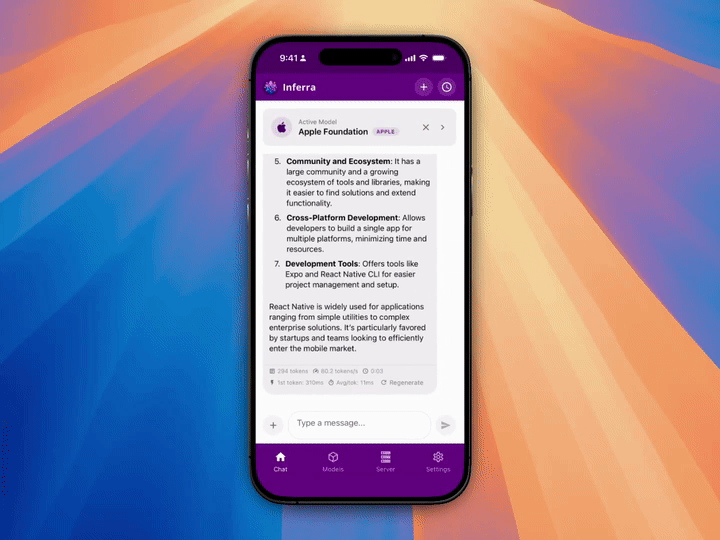
演示
演示里会用到 Apple Foundation Model,也会从 HuggingFace 下载 MLX 模型,然后在手机上运行。
功能
在手机上运行
- 通过 llama.cpp 在 Android 和 iOS 上运行本地 GGUF(一种模型文件格式)。
- Apple Silicon 设备可以在本地跑 MLX。
- 可以接上 OpenAI、Gemini、Anthropic 的云端模型。远程模型需要你自己的 API(调用接口用的密钥)和 InferrLM 注册账号。不用远程模型也完全可以。
- 可以为兼容 OpenAI 的服务改基础网址,比如 OpenRouter、Groq、Ollama、LM Studio、Together AI。这样你就能在软件里换成别的接口地址。
- 支持 Apple Intelligence 的设备可以用 Apple Foundation 模型。
看图,以及文字和图片
- 能看文字和图片的模型,配上对应的 projector(mmproj)文件,就可以看图。更多说明见 这里。
- 软件里自带相机,可以直接拍照,再发给模型。
文档处理和 RAG
- 支持 RAG,让模型更好地看懂文档,回答时能用上相关内容。
- 可以附加文件。内置的文档提取会在本地对每一页做 OCR,把文字抽出来发给本地模型。
- 文档入库会处理文件并建立索引,聊天时能更快找到内容。
- 远程模型支持直接上传文件。
本地服务器
- 内置 HTTP 服务器,用 REST API(通过网络请求调用的接口)让同一网络里的设备访问你的模型。在「服务器」页就能启动。用一个网址,就能把 InferrLM 的聊天界面分享给电脑、平板或其他设备。
- 完整 API 文档在 这里,服务器首页也能看到。
- 命令行工具在 github.com/sbhjt-gr/InferrLM-CLI,里面演示了怎样用这个 API 做自己的程序。
模型管理
- 下载管理器直接从 HuggingFace 拉模型。适合在手机上运行的精选列表在「模型」里的「下载模型」。
- 下载好的模型会出现在聊天页的模型选择里,也会出现在「模型」里的「已保存的模型」。
- 可以从手机存储导入,也可以直接用网址下载。
聊天
- 消息可以编辑、重新生成、复制,也支持 Markdown 显示。
- 用
react-native-nitro-markdown快速显示 Markdown,数学公式也能显示。它是基于 Nitro Modules 桥接的 C++ 渲染器。 - 每条聊天气泡都能分叉:从任意一条消息另开一段对话,原来的记录还在。你可以换个方向聊,以前的内容不会丢。
- 模型写出的代码会放在代码块里,可以复制。
- 可以管理聊天记录,也能把对话置顶。
如果你想参与,或者只是想在自己电脑上跑起来,按下面的指南来。你的改动需要遵守我们的 LICENSE。
准备
- Node.js(>= 16.0.0,< 23.0.0)
- npm 或 yarn
- Expo CLI
- Android Studio(做 Android 开发)
- Xcode(做 iOS 开发)
安装
克隆仓库
git clone https://github.com/sbhjt-gr/InferrLM
cd InferrLM
安装依赖
yarn install设置环境变量 配置你的 API 密钥和后端设置。变量列表在 app.config.json
在真机或模拟器上运行
# For Android
npx expo run:android

# For iOS
npx expo run:ios
REST API
InferrLM 自带 HTTP 服务器,按 OpenAI API 的方式把模型开放出去,同一网络里的设备都能访问你手机上的模型。这样你就能把 InferrLM 接到别的软件、脚本或服务上。
启动服务器
- 打开 InferrLM
- 进入「服务器」页
- 打开服务器开关
- 会显示服务器网址(一般是
http://YOUR_DEVICE_IP:8889)
命令行界面
InferrLM-CLI 是一个终端客户端,连上你的 InferrLM 服务器,直接在命令行里聊天。它本身能用,也给想用 InferrLM REST API 做程序的人当参考。
CLI 用 React 和 Ink 做了一个基本的终端界面,支持一边生成一边返回、保留对话记录,还有交互式的初始设置。完整源码和安装说明在 github.com/sbhjt-gr/InferrLM-CLI。
要用 CLI,先让手机上的 InferrLM 服务器跑起来,再安装这个工具,按仓库里的说明完成设置。
API 文档
服务器跑起来之后,用任意浏览器打开服务器网址,就能看到完整的 API 文档。文档包括:
- 聊天和补全接口
- 模型管理操作
- RAG 和 embedding(把文字变成一组数字,方便查找)接口
- 服务器配置和状态
详细说明见 REST API 文档。
许可证
本项目按 AGPL-3.0 许可证发布。请在 这里 阅读。任何修改都要遵守这份 LICENSE 的规则。
参与贡献
欢迎参与!你可以在 issues 里找问题,也可以新建问题然后开始做。
阅读 贡献指南,里面有贡献说明、代码要求和常见做法。
技术栈
- 框架:React Native 0.81,Expo 54(新架构)
- 软件语言:TypeScript、JavaScript
- iOS 原生模块:Swift
- Android 原生模块:Kotlin
- 运行引擎:C、C++
- 导航:React Navigation
- 数据库:OP-SQLite、Expo SQLite
致谢
- llama.cpp — 在 Android 和 iOS 上运行本地 GGUF 模型的底层引擎。
- mlx-swift-lm — 在 Apple Silicon 上运行 MLX 语言模型的 Swift 库,iOS 上的 MLX 后端靠它。
- inferrlm-llama.rn — 定制的 React Native 适配层,用来接上 llama.cpp。最初从 llama.rn 分叉并自行维护,以便更频繁地更新 llama.cpp。
- @inferrlm/react-native-mlx — iOS 上的 Apple Silicon MLX 引擎,通过 Nitro Modules 桥接在手机上跑得更快。从 react-native-nitro-mlx 分叉并继续维护。
- react-native-nitro-markdown — React Native 的原生 C++ Markdown 渲染器,用来快速显示聊天消息。
- react-native-rag + @langchain/textsplitters — React Native 上的 RAG 实现,用 LangChain 支持文档查找和入库。
- react-native-ai — 通过 Swift API 接入 Apple Foundation 模型的适配层。
- 如果你觉得这里也应该写上你,请告诉我。
Star 记录
觉得有用的话,给这个仓库点个 Star 吧!