
kydlikebtc/awesome-jev
kydlikebtc/awesome-jev has 602 GitHub stars and 34 forks. GitHot measured 0 stars in 24 hours and +4 in 7 days. Last checked 2026-11-12 13:05 UTC. Last push 2026-11-04.
1207 public resources for Jev, TypeSafe AI's System One decision model, indexed by decision pattern. Source citations, dated link checks and scheduled call-site text checks; runtime and performance are not independently tested here. EN/中文, JSON schema and platform compatibility.
实测星标增长
- 24小时
- 0
- 7天
- +4
- 15天
- 正在收集历史
- 1个月
- 正在收集历史
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
README.zh-CN.md
原文
浏览资源目录 ↗ 第一次调用 改造现有项目 独立测量报告 English
数字统计已保存的链接与证据记录,不代表当前 CI 通过数或运行测试结果。 统计口径
阅读导航 · 完整目录
这是什么
- Jev 是 TypeSafe AI 的决策模型。它不生成文本 —— 你给它状态和类型化问题,它返回带校准置信度的类型化答案,快且便宜到可以放进智能体的内层循环。
- 本仓库收集它的公开使用例子,按所做的决策组织。你这周读的那篇资料是一次性的,决策模式不是。
- **如何判断可信度:**每一行都写明来源;有依据时记录调用点、原语声明和注意事项,方便你查看读过什么,以及哪些部分仍未实测。
[!NOTE] 不是产品本身,不是 SDK,与 TypeSafe AI 无隶属关系,也不构成推荐。收录是一份来源记录,不代表运行验证或性能背书。详见哪些经过核实。
Jev 返回什么
三个核心原语:Choice、Score 和 Noul。下面的模式使用它们;Noul 返回概率,没有单独的 confidence 字段。Jev 1.14 还新增了实验性 Box:每个问题返回一个边界框和置信度,没有「未找到」答案。Box 需要图像,并须按下文显式启用图像功能。 (机翻)
每个原语下方有两个互不相加的数:先是 question_types 记录了有人读过代码、确认调用该原语的行数;再是只有文本信号的行数 —— 每周刷新在该行所引的那一个文件中找到了它的请求或回答结构(primitives_seen),这并不表明代码调用了它。见哪些经过核实。 (机翻)
默认输入为文本或结构化 JSON。原生 API 的 Jev 1.13 和 1.14 也支持实验性 PNG/JPEG 图像,须发送 TypeSafe-Danger-Zone-Images: true;不支持音频和视频。默认每次请求 64k token,其中 state 加最长问题最多 32k。实验性请求头 TypeSafe-Danger-Zone-Long-Context: true 将两项限制均提高到 262k,但速度和准确率会降低(见模型文档)。输出 token 免费。截至 2026-10-15,原生 jev-preview 指向 jev-1.14.0,jev-latest 仍指向 jev-1.13.0;两个固定版本 ID 均可用。10 月 14 日公告称 latest 约一周后切换,未给出确切切换日期。权重未公开,因此无法本地运行。跨平台差异全表见 docs/compatibility.md。 (机翻)
某个决策该用哪个原语?下图把 TypeSafe 官方的指引排成一张判断清单:自上而下,遇到第一个「是」即停。顺序与措辞出自本仓库;每一步都注明所依据的页面,列在图下。这是厂商附有来源的设计指引,不是对本目录任何条目的推荐。 (机翻)
每个原语旁是归入所列模式的行数,计法同上图:人读确认,或仅文本信号。这些步骤存于 picker.json,网站的原语页也读取它。来源(编号同图中):[1] docs.typesafe.ai/model-jaggedness/jev-1.13#generation · [2] docs.typesafe.ai/concepts/how-to-build-with-system-one#use-code-when-you-can · [3] docs.typesafe.ai/primitives#split-a-complex-judgment-into-several-questions · [4] docs.typesafe.ai/primitives/noul#good-practice-ask-more-than-one-question-per-call · [5] docs.typesafe.ai/model-jaggedness/jev-1.13#common-sense-structural-invariants · [6] docs.typesafe.ai/primitives#choose-a-question-type · [7] docs.typesafe.ai/primitives/score#writing-good-levels · [8] docs.typesafe.ai/primitives/noul#writing-a-noul-question · [9] docs.typesafe.ai/primitives#ask-for-one-snap-judgment-per-question。 (机翻)
从这里开始
六条,按阅读顺序。手工挑选 —— 因为「star 最多」和「该先读哪个」不是一回事。
-
官方第一课:一条工单,一次请求里同时问一个 Choice、一个 Score 和一个 Noul,给了 Python / JS / cURL 三种写法。
-
该页明确针对 Jev 1.13,不能据此判断哪些局限仍存在于 Jev 1.14。它解释了为什么对选项做一个 Choice,与每个选项各问一个 Noul,回答的是不同问题。
Example: three primitives in one request
按官方 API 参考编写并逐字段对照核实,但未针对线上 API 实际执行过。
-
每次工具调用恰好两个 noul:知道这次调用发生过是否还有意义、以及是否还需要完整原文输出。尽管它自己的描述里用了「打分」,实际并未使用 score 原语。
-
找到的最好的结构化教程。它明确指出类型化输出不保证决策正确、列出了官方记录的弱项,并且对自己给出的成本示例做了限定而不是拿来营销。
Hermes Agent: Jev compaction evaluation
本目录可信度最高的一条。召回率低于他们现有的摘要器,在相同上下文预算下与「按时间倒序」打平。成本确实低得多。在一个被热炒的模型上公开负面结果,非常少见。
覆盖度
全部决策模式,按本目录的收录数量排列长度。图表下方的场景索引可跳转到对应章节。数字为 0 的是待补的研究缺口,不是渲染 bug。
全部 18 个模式均已收录条目。覆盖不代表已运行验证或各模式成熟度相同。 详见 docs/status.md。
场景索引 · 点击跳转到条目
| 场景 | 场景 |
|---|---|
| 工具选择 · 253 | 意图路由 · 48 |
| 上下文压缩 · 41 | 安全闸门 · 156 |
| 输出校验 · 150 | 重试控制 · 8 |
| 人工升级 · 79 | 模型路由 · 62 |
| 并行扇出 · 38 | 检索与排序 · 82 |
| 结构化抽取 · 21 | 分类 · 146 |
| 机器学习特征抽取 · 9 | 文档分拣 · 22 |
| 工单分拣 · 12 | 内容评分 · 177 |
| 实时推荐 · 3 | 总览 · 505 |
实测,而非宣称
本目录收录的独立测量报告,包括有助于理解适用边界的负面结果。这些是原作者的测量,本仓库没有独立复现。比较结果前,请分别查看数据集、测试方法和模型版本。
作者结论是基准测试作者本人对 Jev 在其所测任务上给出的结论方向(measurement.direction:有利、好坏参半、不利或无定论),按作者的报告索引:属作者自述,未经本仓库复现;作者没有用文字说明结论的则不标。docs/benchmarks.zh-CN.md 把每条基准测试的测量字段并列展示。 (机翻)
负面结果优先
作者本人针对这一用途测量过 Jev 并得出不采用结论的行:基准测试的测量结论为不利,或其他行带有实测后未采用标记。作者自述,未经本仓库复现。请先读它们,再看正面例子;站点也列出了它们。 (机翻)
Hermes Agent: Jev compaction evaluation
把 Jev 压缩方案移植过来,与自家在用的摘要器对比实测,最后公开结论:不采用。
基准测试· ★100k+ ·Py·noul· 调用点,2026-09-22 阅读 · 作者结论:不利(作者自述,未经本仓库复现)本目录可信度最高的一条。召回率低于他们现有的摘要器,在相同上下文预算下与「按时间倒序」打平。成本确实低得多。在一个被热炒的模型上公开负面结果,非常少见。
worldmonitor: news threat classification
用两个 Choice 判断威胁等级与类别;盲测发现 Jev 只是与原有模型打平,于是一直保持影子运行。
基准测试· ★10k+ ·TS·choice· 调用点,2026-09-22 阅读 · 作者结论:不利(作者自述,未经本仓库复现)注意:
仅影子运行接进去了但故意不生效:按他们自己的说法,Jev 返回的任何东西都不会进入标签、缓存行或告警。带黄金测试集。想在不拿生产环境下注的前提下试新模型,这是值得照抄的做法。
hermes-jev-skills
九个 agent 技能加一个 CLI,覆盖模型路由、记忆过滤、对话轮保留、多选一技能选择和下一步动作决策。
插件· ★1k+ ·Py·choice·score·noul· 调用点,2026-09-22 阅读注意:
实测后未采用值得一提的是它公开了一个被放弃的用法:用 Jev 做交接摘要的召回率,反而不如原始对话记录。
no-mistakes: Jev review pre-brief, measured and retired
为代码审查预选上下文:每个候选文件问一个 Score —— 测了两次后被移除:计费输入明显增加、耗时几乎没有收益;离线回放还表明,候选列表根本够不到审查发现实际所在的位置。
基准测试· ★1k+ ·Go·score· 作者结论:不利(作者自述,未经本仓库复现)已在 PR #1165(2026-09-22)中移除。他们的离线测量发现:候选生成器从构造上就排除了被改动的文件,而几乎所有审查发现都落在被改动的文件上;按文件附带摘录反而让列表更不精确、token 成本更高。代码已不在默认分支上,所以这一行引用的是移除它的那次改动。
jev-skill-router
Claude Code 钩子:每条提示都问 Jev 哪个已安装的技能合适。先用一个 choice 给全部技能排序,同时用三个 noul 判断提示本身;再用 choice 和逐个技能的 noul 评判前三名,低于 0.30 就不推荐。影子模式只记日志;作者用了一周,539 次推荐中只有 28 次随后调用了该技能。 (模型撰写) (机翻)
插件· ★10+ · shimo4228 ·Py· 调用点,2026-09-22 阅读注意:
实测后未采用作者于 2026-09-21 运行后得出结论:作为路由器,它不太可能帮到本来就能看到全部技能描述的强模型。其 README 记录:0.2.0 版上 6 条脚本化请求全部处理得当,0.1.0 版在一次真实会话的 6 条提示中有 3 条出错,作者称这只是个例,不是比率。它一直停留在影子模式。https://dev.to/shimo4228/i-added-jevs-skill-router-to-claude-code-and-turned-back-just-before-rewriting-the-skill-listing-34in 本条中文备注由模型撰写。
其他独立测量报告
An early-access test of TypeSafe's Jev: calibrated judgments for half a cent
找到的最好的独立实测:固定单一模型版本、24 份挪威语文档,开篇就展示了一个模型答错、但同时正确报出低置信度的案例。
基准测试· Lindfors方法论交代干净,并诚实限定为「单日快照」。开篇就摆失败案例,这才让它成为真正的校准检验,而不是一篇软文。
Testing TypeSafe Jev, Mistral and Gemini for local event validation
找到的唯一三方横评,每个模型分别调过提示词,且明确把范围限定在单一任务上、不做通用排名。
基准测试· Near Here自我限定很规范:这是用例研究,不是模型排行榜。这种克制比数字本身更少见。
Convex Coding Evals
Convex 的编程基准新增了决策模型赛道:108 道关于 Convex 知识的选择题,每题四个选项,覆盖其 112 个编程评测中的 90 个。Jev 通过 OpenRouter 的决策端点,以一个choice回答每道题;语言模型则通过聊天补全接口回答同样的问题。 (模型撰写) (机翻)
基准测试· ★100+ · convex ·TS·choice· 调用点,2026-10-29 模型阅读决策赛道有独立的分数和排行榜;README 说明,选对答案并不代表模型能写出可用的 Convex 代码。托管运行固定使用 typesafe/jev-1.13,并采用三种选项排列。本条目由 AI 助手根据发现队列(issue #14)起草,于 2026-10-29 阅读了 README 和所引文件;维护者尚未亲自阅读调用点。
hippo-memory
受生物启发的智能体记忆:衰减、检索强化与巩固。零运行时依赖,基于 SQLite。 (机翻)
基准测试· ★100+ · kitfunso ·TS· 调用点,2026-09-22 阅读 · 作者结论:好坏参半(作者自述,未经本仓库复现)jev-arena
Jev 模型介绍与实测:通过 Choice / Score / Noul 将自然语言转为带类型的判断与概率,用于分类、评分和路由;支持与 DeepSeek 等模型对比评论打标、速度与结果,含 CSV/Excel 导入、原速回放与离线报告。
基准测试· ★100+ · nanmicoder ·JS· 调用点,2026-09-24 阅读
已显示 10 / 80 条:先是负面结果,再是精选路径独立测量报告选出的条目,按该路径的顺序,再按列表顺序补上其余条目中靠前的几条 · 在单独页面查看全部 80 条及全部备注 → · 在站点上筛选 (机翻)
按决策模式
主索引。每个标题是智能体必须做的一个决策;下面的行是做这个决策的例子。警示以短标记呈现 —— 每行的完整备注在 catalog.json 和站点里。
★ 以区间给出仓库的 GitHub star 数 —— ★10+、★100+、★1k+、★10k+、★100k+;没有仓库或不足 10 星的行不标区间。排序:官方优先,其次是含代码的,再按区间,最后按标题。区间只反映热度,不代表质量;最近一次从 GitHub 读到的精确数字在 catalog.json 和站点上。 (机翻)
调用点链接打开该行引用的那一个文件(evidence.path)在仓库默认分支 HEAD 上的版本;其后的日期是有人最近一次阅读该文件的日期(evidence.read_on);注明“模型阅读”的,则是模型阅读该文件的日期(evidence.model_read_on):这是阅读记录,不是运行过代码。引用文件链接同理,只是该文件表明项目采用了 Jev 的请求结构、并非基于 Jev 构建,或只是项目附带的示例(evidence.kind)。两种链接都没有固定到某个提交,打开的是文件的当前版本,可能与当时读到的不同;文件移动后链接就会失效,每周的 claims 检查会报告这种情况。 (机翻)
工具选择
智能体下一步该调用哪个工具或动作。
Cookbook: Function calling ⭐
把自然语言的交易请求映射到普通的类型化函数:函数名和有限取值的参数各自变成一个带置信度的问题。
官方文档·Py·choiceCookbook: Skill suggestion ⭐
为智能体的一轮对话从 182 个技能里最多挑一个:第一次请求给所有技能排序并顺便问「这轮到底需不需要技能」,第二次细读前三名。
官方文档·Py·choice·noulDemo: Smart home assistant ⭐
一个可运行的智能家居助手示例,用类型化决策来解析用户请求。
官方文档·Pyagent-desktop
桌面自动化。读系统无障碍树,判断下一步该点哪个按钮、菜单或输入框。
开源项目· ★10k+ ·Rs·choice·noul· 调用点,2026-09-24 阅读ai-hedge-fund
教学用的模拟交易与回测应用:每个“投资者人格”智能体把一份财务快照变成看涨、看跌或中性信号。选 TypeSafe 作为模型提供方时,每个智能体发一次 Jev 请求:用 choice 选方向,再用五级 score 分别评估看涨和看跌理由的强度,换算成与 LLM 智能体相同的 JSON。 (模型撰写) (机翻)
平台集成· ★10k+ · virattt ·Py· 调用点,2026-09-24 阅读claude-code-templates: three Jev plugins
三个可独立安装的 Claude Code 插件 —— 护栏、模型路由、技能推荐 —— 各自带 hook 和测试。
插件· ★10k+ ·Py·TS·choice·score·noul· 调用点,2026-09-22 阅读Composio TypeSafe provider
把工具目录编译成问题,再从答案还原出 tool call,并为「弃权」和「需确认」两种情况定义了专门的错误类型。
开源项目· ★10k+ ·Py·choice· 调用点,2026-09-22 阅读Cua driver: jev-use example
Python 与 TypeScript 双实现的 computer-use 动作选择:Jev 从不可变候选集里挑下一个浏览器动作,保留 reobserve 和 abstain 两个特殊选项。
开源项目· ★10k+ ·Py·TS·choice· 调用点,2026-09-22 阅读FastMCP jev_search transform
两段式 MCP 工具检索:先用一个宽 Choice 对整个目录粗排,再给候选短名单配完整描述,每个候选各配一个 Noul 判断它到底是否胜任。
开源项目· ★10k+ ·Py·choice·noul· 调用点,2026-09-22 阅读jev-ultrafast
Browser Use 做的高速浏览器 Agent。Jev 每一步只判断「做什么、点哪个元素」,要打字才叫小模型。
开源项目· ★10k+ · Browser Use ·Py·choice· 调用点,2026-09-22 阅读注意:
厂商自报数据
已显示 10 / 253 条 · 在单独页面查看全部 253 条 → · 在站点上筛选
意图路由
判断用户意图,把请求分流到正确的分支。
TypeSafe AI n8n node ⭐
TypeSafe 官方的 n8n 社区节点。Evaluate 就每个条目向 Jev 提出类型化问题并写入答案;Route 按一个答案把条目送往对应输出,低置信度的选择题可走后备输出,两个是非题阈值之间的可走“不确定”输出。AI Agent 可把它当作工具使用。 (模型撰写) (机翻)
插件· ★10+ · typesafe-ai ·TS·choice·noul·score· 调用点,2026-11-04 模型阅读Demo: Smart home assistant ⭐
一个可运行的智能家居助手示例,用类型化决策来解析用户请求。
官方文档·PyPattern: Confidence-gated routing ⭐
把 confidence 当作第二个维度:答案告诉你「是什么」,置信度告诉你「该不该照它执行」。
官方文档·PyPattern: Intent routing ⭐
对进来的请求做分类,路由到足够用的最便宜那个处理方:确定性代码、专用 LLM、或人。
官方文档·Py·choiceAutoGPT TypeSafe blocks
七个生产级 block(choice/score/yes-no/ask-many/route/pick-best/filter),带 UTF-8 字节预算、逐字报文留存和十一个测试文件。
开源项目· ★100k+ ·Py·choice·score·noul· 调用点,2026-09-22 阅读Airflow LLMBranchOperator with Jev
把下游任务 id 变成 choice 的选项集,并用最小置信度闸门把不确定的运行转给人处理。
平台集成· ★10k+ ·Py·choiceInbox Zero: seven email decisions
七个互不相同的邮件决策,每个都有自己单独设定的阈值,任何出错都回落到普通 LLM。
开源项目· ★10k+ ·TS·choice·noul· 调用点,2026-09-22 阅读ai-cookbook: Jev track
一套循序渐进的课程:从第一次调用、逐个原语、state 形状与 criteria,一直到工单分拣和多步工作流,并对应了全部四个官方模式。
教程· ★1k+ ·Py·choice·score·noul· 调用点,2026-09-22 阅读jev-chat-jarvis
一个 Android 回复副驾:从屏幕文本判断意图、时机和风险,OCR 与文案起草交给另外的模型。
开源项目· ★1k+ ·Java·choice·score·noul· 调用点,2026-09-22 阅读Real Python: hello-jev
带对照组的教学示例:同一个问询台任务,一份是只认 Y/N 的纯 Python 写法,旁边是一个能读出意图的 Noul。
教程· ★1k+ · Real Python ·Py·noul· 调用点,2026-09-22 阅读
已显示 10 / 48 条 · 在单独页面查看全部 48 条 → · 在站点上筛选
上下文压缩
判断哪些工具调用和结果仍然相关,从而丢弃过期上下文。
Hermes Agent: Jev compaction evaluation
把 Jev 压缩方案移植过来,与自家在用的摘要器对比实测,最后公开结论:不采用。
基准测试· ★100k+ ·Py·noul· 调用点,2026-09-22 阅读 · 作者结论:不利(作者自述,未经本仓库复现)jcode: memory recall without embeddings
把记忆召回的整套检索栈替换掉 —— 不用 embedding、不用 BM25、不用重排器 —— 改为对每条候选记忆批量问一个 Noul。
开源项目· ★10k+ ·Rs·noul· 调用点,2026-09-22 阅读fast-jev-compaction
一个 Claude Code 插件,用逐条决策取代压缩式摘要:过期的工具调用被丢弃或截断,保留下来的全部逐字不变。
插件· ★1k+ · tamaratran ·TS·noul· 调用点,2026-09-22 阅读hermes-jev-skills
九个 agent 技能加一个 CLI,覆盖模型路由、记忆过滤、对话轮保留、多选一技能选择和下一步动作决策。
插件· ★1k+ ·Py·choice·score·noul· 调用点,2026-09-22 阅读注意:
实测后未采用jevgrep (dzhng)
一个命令行工具和 Agent 技能,用“这段代码做什么”来找代码:jg "遥测事件是如何记录的?" ./repo让 Jev 在目录、文件和声明层面判断相关性,返回相关文件、阅读线索和原文摘录。作者报告在 10 个 SWE-bench 任务上同样解决 8 个,成本约低 30%。 (模型撰写) (机翻)
开源项目· ★1k+ · dzhng ·TS·noul· 调用点,2026-10-24 模型阅读注意:
厂商自报数据compact-adviser
只回答一个问题的插件:现在该不该 /compact。一次 Jev 请求问两个 choice(最近一段工作是否已完成;是亲手干活还是在协调他人),由代码合成一个分数,随着上下文变满,门槛从 0.90 放宽到 0.50。它给出提示;在 Pi 和 Claude Code 上若你开启,也可以自动压缩。 (模型撰写) (机翻)
开源项目· ★100+ · kunchenguid ·TS· 调用点,2026-09-22 阅读deepseek-harness-jev (luobosibing2)
DeepSeek Harness 插件,提供 12 项需手动开启的功能,用 Jev 作为判断模型:技能选择和 glob 结果排序(每个候选一个noul)、完成度与目标检查、偏离提醒、插话路由、工具输出和测试日志过滤,以及对单个工作区操作的审批。 (模型撰写) (机翻)
插件· ★100+ · luobosibing2 ·TS·noul· 调用点,2026-10-28 模型阅读jev-pruner
在模型看到之前先修剪冗长的 shell 输出,每个片段问一个 Noul。
插件· ★100+ · tamaratran ·TS·noul· 调用点,2026-09-22 阅读mu
基于 pi 的编程 Agent(命令行和桌面端),在 40 个决策点上问 Jev:工具输出的哪些片段进上下文、哪些过期的工具结果可以丢掉、被规则拦下的命令是不是用户要的、抓取的网页和 MCP 输出里有没有注入的指令。 (机翻)
开源项目· ★100+ · qybaihe ·TS·choice·noul·score· 调用点注意:
作者自荐Quicksilver
一个 Claude Code 技能,把“是否相关”的判断交给 Jev:对每个文件、每行日志或每张工单问一个 noul(例如“这些文件里哪些处理鉴权?”),并行询问并按概率排序,于是 Claude 拿到的是带置信度的候选清单,而不必通读全部内容。 (模型撰写) (机翻)
插件· ★100+ · uditakhourii ·JS·noul· 调用点,2026-10-24 模型阅读
已显示 10 / 41 条 · 在单独页面查看全部 41 条 → · 在站点上筛选
安全闸门
在执行前判断一个动作是否安全。属纵深防御,绝不是安全边界。
Cookbook: Classifying RAG passages ⭐
给每条召回的段落打分,再由代码决定哪些能进入回答模型 —— 矛盾的标记保留,夹带提示注入的直接丢弃。
官方文档·PyCookbook: Guardrails for LLMs ⭐
用一次请求筛查 LLM 应用的每一条进出消息,既点明风险类型、又给「照做会造成多大危害」打分。
官方文档·Py·noul·score@langchain/typesafe
LangChain 集成的 JavaScript 对应版本,分类器与 middleware 形状一致。
平台集成· ★10k+ ·TS·choice·score·noul· 调用点,2026-09-22 阅读claude-code-templates: three Jev plugins
三个可独立安装的 Claude Code 插件 —— 护栏、模型路由、技能推荐 —— 各自带 hook 和测试。
插件· ★10k+ ·Py·TS·choice·score·noul· 调用点,2026-09-22 阅读sub2api: Jev as a moderation endpoint
作为审核 API 的直接替代:一次请求并行问多个 Noul,每个危害类别一个,且每条指令都带反注入前缀。
开源项目· ★10k+ ·Go·noul· 调用点,2026-09-22 阅读agentgateway: CI-validated LLM guardrail
三个共用同一严重度量表的 Score 问题,两项以上越线即拦截请求,并且失败时默认关闭。
开源项目· ★1k+ ·Rs·score· 调用点,2026-09-22 阅读DeepChat: agent tool-permission review
从三个维度审查每次工具调用:风险等级、用户是否授权、以及一个显式的提示注入压力检查。
开源项目· ★1k+ ·TS·choice·noul· 调用点,2026-09-22 阅读atomic
编程智能体运行时:工作流是带版本的 TypeScript 阶段,包含可执行检查、评审关卡和人工审批。其 AI 包从 models.dev 收录 Jev,作为 5 家提供方上的 System One 决策模型,与聊天模型分开列出;README 没有说明工作流在哪里调用它。 (模型撰写) (机翻)
开源项目· ★100+ · bastani-inc ·TS· 调用点,2026-09-24 阅读deepseek-harness-jev (luobosibing2)
DeepSeek Harness 插件,提供 12 项需手动开启的功能,用 Jev 作为判断模型:技能选择和 glob 结果排序(每个候选一个noul)、完成度与目标检查、偏离提醒、插话路由、工具输出和测试日志过滤,以及对单个工作区操作的审批。 (模型撰写) (机翻)
插件· ★100+ · luobosibing2 ·TS·noul· 调用点,2026-10-28 模型阅读grok-bot-jev
Grok Bot 的路由器:在调研、浏览、重试或启动子智能体之前,先问 Jev 这个请求需要哪种动作:复用已缓存的产物、停止失败的重试、运行确定性代码、限制调研规模、允许子智能体,或请人决定。影子模式只记日志;主动模式要靠粘贴进去的技能来执行。 (模型撰写) (机翻)
插件· ★100+ · bodila51 ·Py· 调用点,2026-09-22 阅读
已显示 10 / 156 条 · 在单独页面查看全部 156 条 → · 在站点上筛选
输出校验
在输出到达用户前,按评分标准检查模型产出。
Cookbook: Double-checking citations ⭐
用一个 Choice 对着原文核查引用是否错误或凭空编造,并用它的置信度把边缘情况标出来送审。
官方文档·Py·choiceCookbook: Guardrails for LLMs ⭐
用一次请求筛查 LLM 应用的每一条进出消息,既点明风险类型、又给「照做会造成多大危害」打分。
官方文档·Py·noul·scorelatitude-llm
面向 AI 智能体的开源可观测性平台,在调用轨迹里标出智能体出错的地方。其中一个影子提供方问 Jev 每个标记维度一个 noul,一次调用最多 11 个;所引文件看不出这些答案是否会改变任何标记,README 也没有提到 Jev。 (模型撰写) (机翻)
开源项目· ★1k+ · latitude-dev ·TS· 调用点,2026-09-22 阅读reticle
通过实际操作正在运行的应用来核实 AI 智能体说的“完成”,给出通过、失败或无法判断。其基准测试框架就采集到的证据用一次调用问 Jev:五个 noul(预期结果是否发生、采集是否干净、应用是否报错等)、一个通过/失败/未知的 choice,以及一个严重程度 score。 (模型撰写) (机翻)
开源项目· ★1k+ · reticlehq ·TS· 调用点,2026-09-24 阅读abide
接入 Claude Code、Codex、OpenCode 和 Pi,在每次编辑或每一轮,就 AGENTS.md 或 CLAUDE.md 中的每条规则问 Jev 一个是非题,只给它看规则和 diff;违反的规则会退回给智能体修改。在 93 个回放的会话中,Jev 标出了 39 次编辑,其中 10 次经审阅者确认。 (模型撰写) (机翻)
插件· ★100+ · coldteadotai ·TS· 调用点,2026-09-24 阅读arc-cua
面向计算机操作智能体的 macOS 动作循环:规划方交出一个有边界的桌面子任务,Jev 以choice问题从窗口实际提供的元素中选出下一步界面操作及其目标,并对每条成功标准再问一个choice;字面文本只来自规划方。 (模型撰写) (机翻)
开源项目· ★100+ · shhivv ·Py·choice· 调用点,2026-10-29 模型阅读atomic
编程智能体运行时:工作流是带版本的 TypeScript 阶段,包含可执行检查、评审关卡和人工审批。其 AI 包从 models.dev 收录 Jev,作为 5 家提供方上的 System One 决策模型,与聊天模型分开列出;README 没有说明工作流在哪里调用它。 (模型撰写) (机翻)
开源项目· ★100+ · bastani-inc ·TS· 调用点,2026-09-24 阅读Canny
防 Coding Agent 嘴硬说自己做完了。看工具输出、代码 diff 和测试结果,再判断完成声明靠不靠谱。
开源项目· ★100+ ·TS·noul·score· 调用点,2026-09-22 阅读deepseek-harness-jev (luobosibing2)
DeepSeek Harness 插件,提供 12 项需手动开启的功能,用 Jev 作为判断模型:技能选择和 glob 结果排序(每个候选一个noul)、完成度与目标检查、偏离提醒、插话路由、工具输出和测试日志过滤,以及对单个工作区操作的审批。 (模型撰写) (机翻)
插件· ★100+ · luobosibing2 ·TS·noul· 调用点,2026-10-28 模型阅读fastbrowse
浏览器智能体:每个页面被索引成候选控件,由 Jev 选出下一步,因此不会点击页面上没有的东西;规划和阅读由 Gemini Flash 负责,答案引用页面原文。维护者记录的 46 个任务中成功率为 99.2%,托管版 Browser Use 为 97.8%,而成本不到其十分之一。 (模型撰写) (机翻)
开源项目· ★100+ · agent-labs-dev ·Py· 调用点,2026-09-22 阅读
已显示 10 / 150 条 · 在单独页面查看全部 150 条 → · 在站点上筛选
重试控制
判断失败的步骤是否值得重试。
DuoMind
一个 OpenAI 兼容的本地服务器,把 llama.cpp 上的小模型与 Jev 搭配:在生成之前、之中和之后共 18 个决策点(是否需要推理、是否安全、输出格式、是否该停、是否重试)引导本地模型。提示词会发送给 TypeSafe,生成过程留在本地。 (模型撰写) (机翻)
开源项目· ★10+ · j1s4nn ·Py·noul·choice· 调用点,2026-10-24 模型阅读注意:
厂商自报数据jev-harness
面向 AI 编码智能体的决策关卡,提供 CLI、MCP 服务器、CI 钩子以及 Python、TypeScript 和 Rust SDK:先用离线启发式规则,再可选地交给 Jev 判断:失败的测试日志是否需要动用 LLM、是否中止反复修改的循环、该用哪个模型档位和推理力度、某一步是否已完成。 (模型撰写) (机翻)
插件· ★10+ · ismaelsoilet ·Py· 调用点,2026-09-24 阅读harnessjudge
面向智能体开发者的网页应用:粘贴某一步的执行轨迹,由 Jev 判定为通过、重试、升级或停止。没有 TYPESAFE_API_KEY 时,本地启发式规则返回同样结构的答案,并标为演示模式。 (模型撰写) (机翻)
开源项目· ndolinschi ·TS· 调用点,2026-09-22 阅读注意:
仅一次提交·无许可证Jev by Example
十个可运行的 JavaScript 智能体决策,一个文件一个:新记忆与旧记忆冲突时该改还是该留、工具返回 200 是否真的完成了任务、写入超时后该重试还是该对账、上下文分块在预算内如何取舍、压缩后的交接是否丢掉了某条禁令。Jev 只回答带类型的问题,阈值和最终提案由普通代码决定。
开源项目· Really Artificial ·JS·choice·score·noul· 调用点,2026-09-22 阅读注意:
疑似 AI 生成jev-reasoning-navigator
JEV 推理导航器:面向自主 LLM 智能体的认知监督、防止循环与反幻觉引擎。 (机翻)
开源项目· andreuvm ·Py· 调用点,2026-09-24 阅读注意:
无许可证jev-resilience
面向 WebFlux 的 Spring Boot Starter:标注了 @SemanticCircuitBreaker 的方法会把每个响应体发给 Jev,用一个 noul 判断这个 HTTP 200 是否掩盖了错误、堆栈信息或维护通知;超过阈值(示例中为 0.85)就抛出熔断器可以计数的异常。失败即放行。 (模型撰写) (机翻)
插件· vicente-md ·Java· 调用点,2026-09-22 阅读注意:
无许可证jevswiftsdk
独立、非官方、零依赖的 System One API Swift SDK:choice、noul 和 score 问题都映射为 Swift 类型(比如对枚举的 choice),具名批量问题一次调用作答并逐个校验答案,支持按策略重试和取消。支持 iOS 15+、macOS 12+ 和 Linux。 (模型撰写) (机翻)
SDK· nsstudent ·Swift· 调用点,2026-09-22 阅读XavierJev
Jev 形状的本地决策层:是非、选择和量表问题都从本地模型单个 token 的 logprob 读出答案;附带一个在留出命令集上测量过的 Claude Code 权限闸门。 (机翻)
Jev 替代实现· Xinyu Liu ·TS·noul·choice·score· 引用文件,2026-09-25 阅读注意:
并非 Jev 本身·疑似 AI 生成
人工升级
用校准置信度决定哪些情况必须由人来看。
TypeSafe AI n8n node ⭐
TypeSafe 官方的 n8n 社区节点。Evaluate 就每个条目向 Jev 提出类型化问题并写入答案;Route 按一个答案把条目送往对应输出,低置信度的选择题可走后备输出,两个是非题阈值之间的可走“不确定”输出。AI Agent 可把它当作工具使用。 (模型撰写) (机翻)
插件· ★10+ · typesafe-ai ·TS·choice·noul·score· 调用点,2026-11-04 模型阅读Cookbook: Classification using confidence ⭐
把年报分入 75 个行业组,再根据答案自身的置信度决定:报这个细分组,还是退回上一层的大类。
官方文档·Py·choiceCookbook: Double-checking citations ⭐
用一个 Choice 对着原文核查引用是否错误或凭空编造,并用它的置信度把边缘情况标出来送审。
官方文档·Py·choiceCookbook: Knowledge graph entity alignment ⭐
判断两份商品目录间 450 个候选配对里哪些指的是同一个东西 —— 一个 Score 就够,它的三级正好对应三种可执行动作。
官方文档·Py·scoreCookbook: Self-consistency with choices ⭐
在内容审核决策里显式加入「不确定」这个选项,并衡量标签一致率与自动处置比例之间的取舍。
官方文档·Py·choiceCookbook: Self-consistency with nouls ⭐
把不确定的概率转人工复核,同时保留底层的 noul 数值本身,而不是压成一个标签了事。
官方文档·Py·noulPattern: Confidence-gated routing ⭐
把 confidence 当作第二个维度:答案告诉你「是什么」,置信度告诉你「该不该照它执行」。
官方文档·PyConfidence ⭐
Choice 和 Score 的 confidence 如何从概率推导、Noul 有何不同,以及如何针对问题与应用调节阈值。 (机翻)
官方文档Airflow LLMBranchOperator with Jev
把下游任务 id 变成 choice 的选项集,并用最小置信度闸门把不确定的运行转给人处理。
平台集成· ★10k+ ·Py·choiceComposio TypeSafe provider
把工具目录编译成问题,再从答案还原出 tool call,并为「弃权」和「需确认」两种情况定义了专门的错误类型。
开源项目· ★10k+ ·Py·choice· 调用点,2026-09-22 阅读
已显示 10 / 79 条 · 在单独页面查看全部 79 条 → · 在站点上筛选
模型路由
选择由哪个下游模型或档位处理请求。
Cookbook: Structured data extraction cascade ⭐
「小模型 → 校验 → 推理模型」的两段级联,用一小部分成本拿到接近大推理模型的质量。
官方文档·PyPattern: Intent routing ⭐
对进来的请求做分类,路由到足够用的最便宜那个处理方:确定性代码、专用 LLM、或人。
官方文档·Py·choice@langchain/typesafe
LangChain 集成的 JavaScript 对应版本,分类器与 middleware 形状一致。
平台集成· ★10k+ ·TS·choice·score·noul· 调用点,2026-09-22 阅读claude-code-templates: three Jev plugins
三个可独立安装的 Claude Code 插件 —— 护栏、模型路由、技能推荐 —— 各自带 hook 和测试。
插件· ★10k+ ·Py·TS·choice·score·noul· 调用点,2026-09-22 阅读hermes-jev-skills
九个 agent 技能加一个 CLI,覆盖模型路由、记忆过滤、对话轮保留、多选一技能选择和下一步动作决策。
插件· ★1k+ ·Py·choice·score·noul· 调用点,2026-09-22 阅读注意:
实测后未采用Astra-Ares
运行一个打过补丁的 Codex CLI:Jev 读取有限的任务上下文,用两个 choice 选出 GPT-6 下一次回复的推理力度,以及这个力度持续几次回复(1、2、5 或 10);GPT-6 改变推理力度不会破坏提示缓存。属于实验性的参考实现。 (模型撰写) (机翻)
插件· ★100+ · miuuyy ·JS· 调用点,2026-09-24 阅读jev-codex-router
先让 Jev 判断这一轮编程任务有多难,再决定模型档位、推理深度和速度模式。
插件· ★100+ ·JS·choice·score· 调用点,2026-09-22 阅读注意:
已归档jev-eval-agent
一个把评测工作通过类型化决策来路由的智能体。
开源项目· ★100+ · vinilana ·TS· 调用点,2026-09-22 阅读注意:
无许可证jev-review
代码审查前先过一遍 Jev,把高风险改动挑出来,再交给更贵的大模型或人。带本地看板。
开源项目· ★100+ ·TS·choice·score·noul· 调用点,2026-09-22 阅读jevrouter
面向模型、工具和子智能体的路由器。
开源项目· ★100+ · billionsbobby ·TS· 调用点,2026-09-22 阅读
已显示 10 / 62 条 · 在单独页面查看全部 62 条 → · 在站点上筛选
并行扇出
把大量问题(包括推测性的)打包进一次请求,再由代码挑出真正用得上的答案。
Cookbook: Parallel questions ⭐
对一篇长文提 13 个合规问题,证明全部打包进一次调用便宜得多、也快得多,而答案不变。
官方文档·PyPattern: Speculative fan-out ⭐
把大量问题(包括可能用不上的)打包进一次请求,之后再由代码决定哪些答案真的用得上。
官方文档·PyQuickstart ⭐
官方第一课:一条工单,一次请求里同时问一个 Choice、一个 Score 和一个 Noul,给了 Python / JS / cURL 三种写法。
官方文档·Py·TS·sh·choice·score·noulAutoGPT TypeSafe blocks
七个生产级 block(choice/score/yes-no/ask-many/route/pick-best/filter),带 UTF-8 字节预算、逐字报文留存和十一个测试文件。
开源项目· ★100k+ ·Py·choice·score·noul· 调用点,2026-09-22 阅读jev-ultrafast
Browser Use 做的高速浏览器 Agent。Jev 每一步只判断「做什么、点哪个元素」,要打字才叫小模型。
开源项目· ★10k+ · Browser Use ·Py·choice· 调用点,2026-09-22 阅读注意:
厂商自报数据sub2api: Jev as a moderation endpoint
作为审核 API 的直接替代:一次请求并行问多个 Noul,每个危害类别一个,且每条指令都带反注入前缀。
开源项目· ★10k+ ·Go·noul· 调用点,2026-09-22 阅读ai-cookbook: Jev track
一套循序渐进的课程:从第一次调用、逐个原语、state 形状与 criteria,一直到工单分拣和多步工作流,并对应了全部四个官方模式。
教程· ★1k+ ·Py·choice·score·noul· 调用点,2026-09-22 阅读Hey Jev
macOS 语音助手:本地 Whisper 转写指令后,一次 Jev 请求同时问完所有问题(请求类别、是否复合、目标、应用、动作、音量级别),题型有choice、noul和score;代码通过 AppleScript 执行动作,只有常识性问题才交给 LLM。 (模型撰写) (机翻)
开源项目· ★100+ · henryklunaris ·Py·choice·noul·score· 调用点,2026-10-29 模型阅读注意:
无许可证·需第三方密钥jev-chat: a tool-calling chatbot with no LLM
一个完全不含语言模型的 tool calling 聊天机器人:一次请求同时问清请求类型、该调哪个工具、以及每个工具的参数。
开源项目· ★100+ ·TS·choice·noul· 调用点,2026-09-22 阅读jev-forge
并非 Jev:一套合成决策数据、训练并校准小型候选打分模型(JevForge-0.8B)、再通过兼容 Jev 的 API 提供服务的工具链,首个场景是在网页上挑选下一次点击或表单控件。其基准脚本把同一批留出的 choice、noul 和 score 问题发给真正的 Jev 作对比。 (模型撰写) (机翻)
Jev 替代实现· ★100+ · zwlijay ·Py· 引用文件,2026-09-22 阅读注意:
并非 Jev 本身
已显示 10 / 38 条 · 在单独页面查看全部 38 条 → · 在站点上筛选
检索与排序
对来自廉价检索步骤的候选做打分或重排。
Cookbook: Classifying RAG passages ⭐
给每条召回的段落打分,再由代码决定哪些能进入回答模型 —— 矛盾的标记保留,夹带提示注入的直接丢弃。
官方文档·PyCookbook: Line-by-line search ⭐
对一份服务条款做语义检索:一次请求用 Choice 给 218 个行号打分,同时用 Noul 判断文档里到底有没有答案。
官方文档·Py·choice·noulCookbook: Re-ranking ⭐
对 40 个法律检索问题各取 30 条 BM25 候选,按「问题-候选」逐对提问重排,top-1 与 top-10 准确率均大幅提升。
官方文档·PyAutoGPT TypeSafe blocks
七个生产级 block(choice/score/yes-no/ask-many/route/pick-best/filter),带 UTF-8 字节预算、逐字报文留存和十一个测试文件。
开源项目· ★100k+ ·Py·choice·score·noul· 调用点,2026-09-22 阅读FastMCP jev_search transform
两段式 MCP 工具检索:先用一个宽 Choice 对整个目录粗排,再给候选短名单配完整描述,每个候选各配一个 Noul 判断它到底是否胜任。
开源项目· ★10k+ ·Py·choice·noul· 调用点,2026-09-22 阅读jcode: memory recall without embeddings
把记忆召回的整套检索栈替换掉 —— 不用 embedding、不用 BM25、不用重排器 —— 改为对每条候选记忆批量问一个 Noul。
开源项目· ★10k+ ·Rs·noul· 调用点,2026-09-22 阅读LanceDB TypeSafeReranker
向量数据库的重排器:对每条结果问一个 Noul,把「是」的概率当作绝对相关性分数 —— 可以跨查询比较。
开源项目· ★10k+ ·Py·noul· 调用点,2026-09-22 阅读OpenViking: retrieval reranking
单次批量请求里对每个候选文档问一个 Noul,直接把「是」的概率当相关性分数。
开源项目· ★10k+ ·Py·noul· 调用点,2026-09-22 阅读XERJ
一个本地优先的搜索引擎兼 MCP 服务器,打包为单个 Rust 二进制文件。可选的rerank阶段对每条靠前结果向 Jev 提一个noul(document是否回答了 state 中的查询?),再按概率重新排序。作者报告 FiQA 上的 nDCG@10 从 0.24 升至 0.36,总共 648 次搜索花费约 0.64 美元。 (模型撰写) (机翻)
开源项目· ★10k+ · xerj-org ·Rs·noul· 调用点,2026-10-26 模型阅读注意:
厂商自报数据jev-chat-jarvis
一个 Android 回复副驾:从屏幕文本判断意图、时机和风险,OCR 与文案起草交给另外的模型。
开源项目· ★1k+ ·Java·choice·score·noul· 调用点,2026-09-22 阅读
已显示 10 / 82 条 · 在单独页面查看全部 82 条 → · 在站点上筛选
结构化抽取
从杂乱文本中取出类型化字段 —— 靠在候选中选择,而不是生成。
Cookbook: Date extraction ⭐
抽取绝对与相对日期:先问文档里点明了哪些部分,再在代码里做解析与校验,并按置信度决定是否送审。
官方文档·PyCookbook: Pre-parsed value extraction ⭐
先用正则找出候选的邮箱、电话、金额,再让模型挑出被问到的那一段,于是代码拿到的是逐字原值。
官方文档·Py·choiceCookbook: Structure recovery ⭐
用两次请求把丢了格式的纯文本还原成 Markdown:一次把硬换行的段落重新接起来,一次给每个块分类。
官方文档·PyCookbook: Structured data extraction cascade ⭐
「小模型 → 校验 → 推理模型」的两段级联,用一小部分成本拿到接近大推理模型的质量。
官方文档·Pyjev4pg
为 PostgreSQL 提供自然语言 SQL 和 41 个语义算子。过滤、抽取、排序、匹配和核验以有上限的批次交给 Jev,答案须先通过校验;choice 选项需达 0.55、noul 需达 0.8 才算成立。作者报告其准确率为 98%,pg-jev 的请求路径为 92%。 (模型撰写) (机翻)
开源项目· ★100+ · Sheltercosmo ·Py·choice·noul· 调用点,2026-10-26 模型阅读注意:
厂商自报数据jev playground (deepdave98)
每周一个的市场销售(GTM)实验,均用 Jev 完成并与 Claude 对比:线索分拣和路由、交易风险、回复分拣、从通话摘要中提取 MEDDPICC 字段、重复账户识别、已流失交易的重新激活,另有一个 MCP 服务器。共享客户端在取整前减去实测的 0.30 分数偏差。 (模型撰写) (机翻)
基准测试· ★10+ · deepdave98 ·Py·noul·choice·score· 调用点,2026-10-31 模型阅读注意:
无许可证jev-apply
面向命令行智能体的求职申请技能,会记住你的答案:Jev 为 Greenhouse、Ashby 或 Lever 表单的每个字段挑选合适的已存答案,并始终提供“都不合适”的出口;置信度低于阈值时,该字段交回给你,而不是去猜。 (模型撰写) (机翻)
插件· ★10+ · theadaply ·JS·choice·noul· 调用点,2026-11-03 模型阅读jev-design
让 Jev 设计仪表盘的实验:根据一句话的设计要求(例如“一本 18 世纪的印刷书”),分两轮发出 choice、score 和是非题,从人工编写的目录中选出每一个视觉参数(颜色、字体、圆角、图标),再由引擎把它们应用到一个 Next.js 控制台上。 (模型撰写) (机翻)
开源项目· ★10+ · bilune ·TS·choice·score·noul· 调用点,2026-10-30 模型阅读注意:
无许可证jev-macos-loop
面向 Apple 芯片上原生 macOS 应用的 computer use 智能体:由 OmniParser CoreML、Apple Vision OCR 和辅助功能标签在本机找出窗口里的控件,再由 Jev 根据观察到的文字(从不看像素)用 choice 选下一步动作。输入前有防护检查,基准测试核对的是实际结果,而不是 Jev 的 DONE 判断。 (模型撰写) (机翻)
开源项目· ★10+ · jcpsimmons ·JS· 调用点,2026-09-22 阅读jeveryword
用 Jev 做文本抽取:字段抽取、PII 检测与逐字引文。 (项目自述) (机翻)
开源项目· ★10+ · jkrup ·JS· 调用点,2026-09-22 阅读
已显示 10 / 21 条 · 在单独页面查看全部 21 条 → · 在站点上筛选
分类
把条目归入分类体系,包括用概率遍历的深层层级。
WorkflowEvals ⭐
TypeSafe 用于复现其 WorkflowEvals 评测网站的代码:四个业务流程(发票审批与欺诈分拣、客服路由与处置、智能体运行中的动作选择、安全告警分拣),共 705 个案例,以 OpenAI、Anthropic 及共识结果为参考来评分。 (模型撰写) (机翻)
基准测试· ★10+ · typesafe-ai ·Py·noul·choice·score· 调用点,2026-11-02 模型阅读注意:
仅一次提交·厂商自报数据Cookbook: Classification using confidence ⭐
把年报分入 75 个行业组,再根据答案自身的置信度决定:报这个细分组,还是退回上一层的大类。
官方文档·Py·choiceCookbook: Hierarchical classification ⭐
用对 Choice 概率做并行 beam search 的方式,遍历专利、零售、生物医学、源码这几套很深的分类体系。
官方文档·Py·choiceCookbook: Knowledge graph entity alignment ⭐
判断两份商品目录间 450 个候选配对里哪些指的是同一个东西 —— 一个 Score 就够,它的三级正好对应三种可执行动作。
官方文档·Py·scoreCookbook: Structure recovery ⭐
用两次请求把丢了格式的纯文本还原成 Markdown:一次把硬换行的段落重新接起来,一次给每个块分类。
官方文档·PyInbox Zero: seven email decisions
七个互不相同的邮件决策,每个都有自己单独设定的阈值,任何出错都回落到普通 LLM。
开源项目· ★10k+ ·TS·choice·noul· 调用点,2026-09-22 阅读json-render
Vercel Labs 的生成式 UI 框架。实验里 Jev 不逐 token 写 JSON,只负责选组件、属性和布局。
开源项目· ★10k+ · Vercel Labs ·TS·choice· 调用点,2026-09-22 阅读worldmonitor: news threat classification
用两个 Choice 判断威胁等级与类别;盲测发现 Jev 只是与原有模型打平,于是一直保持影子运行。
基准测试· ★10k+ ·TS·choice· 调用点,2026-09-22 阅读 · 作者结论:不利(作者自述,未经本仓库复现)注意:
仅影子运行pg-jev
一个真正的 PostgreSQL 扩展,把三个原语暴露成 SQL 函数 —— 语义判断可以直接写进任意行类型的 WHERE 子句。
开源项目· ★1k+ ·Py·sh·choice·score·noul· 调用点,2026-09-22 阅读332_lab-jev-chat
电脑版微信助手:由 Jev 判断每条消息的意图,DeepSeek 给出建议回复。 (机翻)
开源项目· ★100+ · liyucheng1997 ·Kt· 调用点,2026-09-24 阅读
已显示 10 / 146 条 · 在单独页面查看全部 146 条 → · 在站点上筛选
机器学习特征抽取
把自由文本转成数值特征,喂给下游的传统模型。
Cookbook: Autoresearch feature discovery ⭐
一个自动研究循环:自己提出问题、把自由文本转成数值特征、再用误差反过来改进下游的梯度提升回归模型。
官方文档·Pynimble
Bespoke-Nimble-9B 的数据、训练方法和推理代码:一个受 Jev 启发的开放决策模型,基于 Qwen3.5-9B 的 LoRA,对文本回答带概率的 choice 和是非题。在 324 条留出样本上,它与参考标注的一致率为 90.1%;按同样方式评分,Jev 1.13.0 为 93.2%。 (模型撰写) (机翻)
开源项目· ★1k+ · bespokelabsai ·Py· 调用点,2026-09-22 阅读注意:
无许可证jev-align
从人类反馈出发,构建经过校准的决策函数。
开源项目· ★100+ · sutro-sh ·Py· 调用点,2026-09-22 阅读Prism
不直接让 Jev 下单。它判断 toxic flow、市场压力、均值回归之类的状态,再交给原来的策略。
开源项目· ★100+ ·TS·choice·score· 调用点,2026-09-22 阅读JEV Sees
让 Jev“看见”:本地的 Florence-2 和 CLIP 模型在图像、视频或 RGB-D 画面中找出物体,并在帧之间保持物体 ID 一致,然后由 Jev 针对每个相关物体回答 choice、noul 或 score 问题(如公交车颜色、行人风险、动物运动状态)。 (模型撰写) (机翻)
开源项目· ★10+ · charlesfeng0314 ·Py·choice·noul·score· 调用点,2026-10-24 模型阅读Truffler
面向 Rails 应用的意图搜索:每当记录被保存,Truffler 就向 Jev 提出为它声明的是非题、choice 和 score 问题,并把每个答案存成数值,使记录形成按名称分维的嵌入,搜索时按意图加权。用户需要时,Jev 还会把靠前结果重排为“很可能”“可能”“不太可能”三档。 (模型撰写) (机翻)
平台集成· ★10+ · kieranklaassen ·Rb·noul·choice·score· 调用点,2026-10-30 模型阅读jev-board-lab
带密码保护的浏览器工作台,把 CSV 行变成 Jev 的判断:你写最多 20 个 noul、choice 或 score 问题,在最多 25 行选中的数据上运行,每行作为一个 state,经由保管密钥的 Cloudflare Worker 发送。CSV 文件留在浏览器里。 (模型撰写) (机翻)
开源项目· webgrga ·JS· 调用点,2026-09-22 阅读注意:
无许可证jev-calibrated-narrative-coding
一篇论文的代码、问题模式和汇总结果:论文把 5,018,080 份得州警方交通事故叙述(2017–2025)以 noul、choice 和 score 问题交给 Jev,对照已编码字段和人工金标准集检验概率是否校准,并把校准结果换算成人需要复核多少被标记的记录。 (模型撰写) (机翻)
开源项目· pozapas ·Py· 调用点,2026-09-24 阅读tiershift
模型路由器:每个请求都从最便宜的档位开始,只有当 Jev 给出的信号(多步推理、难度、风险高低、安全)越过 YAML 策略时才往上升。在作者的 120 条提示上,它以低 40% 的成本达到旗舰模型的质量;而单用快速模型也得到同样的分数,成本只有 3%。 (模型撰写) (机翻)
开源项目· iamvatsalpatel ·TS· 调用点,2026-09-22 阅读
文档分拣
对进来的文档、发票、表单做分类和路由。
docjev
对 PDF、DOCX 和 PPTX 文件做分类和切分:LiteParse 在本地提取每页文字,然后 Jev 用一个 choice 按你的规则选出文档类别;对多文档合订本则逐页回答一个类别 choice 和一个“新文档是否从这里开始”的 noul。其报告涵盖 40 份真实 PDF。 (模型撰写) (机翻)
开源项目· ★100+ · jerryjliu ·Py· 调用点,2026-09-22 阅读formanator
从命令行或 MCP 客户端提交 Forma 福利报销。使用 --category-provider jev 时,Jev 用一个 choice 从 Forma 允许的“福利加类别”组合(另加 no_match)中挑一个,只看商家和描述;置信度低于 0.5 或无匹配时,回退到配置好的 LLM。 (模型撰写) (机翻)
插件· ★100+ · timrogers ·Rs· 调用点,2026-09-22 阅读Quicksilver
一个 Claude Code 技能,把“是否相关”的判断交给 Jev:对每个文件、每行日志或每张工单问一个 noul(例如“这些文件里哪些处理鉴权?”),并行询问并按概率排序,于是 Claude 拿到的是带置信度的候选清单,而不必通读全部内容。 (模型撰写) (机翻)
插件· ★100+ · uditakhourii ·JS·noul· 调用点,2026-10-24 模型阅读tax-doc-classifier
税务文档分页分类器:每页一次请求,问 Jev 两个 choice:页面类型(7 个选项)和 IRS 表单(230 个另加“不在列表中”),五种表单的附表再用一个后续 choice 细分;选项描述由 IRS 官方 PDF 生成,代码以 0.95 为门槛。作者在 314 页已填写表单上测得严格错误为零。 (模型撰写) (机翻)
开源项目· ★100+ · kyotofin ·TS· 调用点,2026-09-22 阅读doc-router
逐页判断 PDF 是否需要 OCR 的 Rust 库:由 Jev(默认是内置的启发式规则)根据文字层证据对每页回答一个 noul;有文字的页面在本地提取,只有其余页面经 LiteLLM 交给 OCR 模型。在作者的测试中,155 页里只有 87 页计费。 (模型撰写) (机翻)
开源项目· ★10+ · misbahsy ·Rs· 调用点,2026-09-22 阅读jev-capability-atlas
独立的社区地图,以中文为主,说明哪些任务适合交给 Jev 以及原因,依据是附带真实 API 调用记录的测试集,而不是排行榜:答案就在给定文字里时很准,比如该点击哪个 DOM 元素;别处则可能失准(DAIR Emotion 上平均置信度 0.819,实际只对 48%)。 (模型撰写) (机翻)
基准测试· ★10+ · zaious ·Py· 调用点,2026-09-22 阅读 · 作者结论:好坏参半(作者自述,未经本仓库复现)jevmory
编程智能体的本地记忆:钩子把会话中真正说过的话按原文引语保存;jevmory audit 针对 MEMORY.md 的每一行问 Jev:已保存的证据是支持还是反驳它,并把各行标为保留、过时、错误或无依据。只用 Python 标准库和 SQLite;评分须主动开启。 (模型撰写) (机翻)
开源项目· ★10+ · romiluz13 ·Py· 调用点,2026-09-22 阅读pdf-race
让三条流水线在 12 篇 arXiv 论文上比赛:Docling 加 Jev、Docling 加 Gemini 3.8 Flash,以及 Gemini 直接读 PDF,每篇回答四个问题,按 arXiv 自己的元数据评分。三条都答对了 12 篇中全部的类别和标题;Jev 这条的成本是 $0.0022,另两条为 $0.036 和 $0.088。 (模型撰写) (机翻)
基准测试· ★10+ · goodrahstar ·JS· 调用点,2026-09-24 阅读decision-first
适用于 Claude Code、Codex、Cursor 等的智能体技能:当某一步工作是有界判断(分类、分诊、排序、路由、筛选、核验、把关)时,智能体先通过附带的脚本向 Jev 发送 noul、choice 或 score 问题,再考虑写正则或 LLM 提示,并记录每次尝试,无论是否采用。 (模型撰写) (机翻)
插件· harrymunro ·Py· 调用点,2026-09-22 阅读Jev Playwright
一个 Playwright 报告器:在启动任何浏览器之前,询问 Jev 某次代码改动可能影响哪些现有端到端测试,并跳过明显无关的测试。默认会发送改动路径、补丁和测试代码;README 提醒它可能漏掉受影响的测试。 (模型撰写) (机翻)
开源项目· arthurfiorette ·TS· 调用点,2026-10-24 模型阅读
已显示 10 / 22 条 · 在单独页面查看全部 22 条 → · 在站点上筛选
工单分拣
按意图和紧急度路由支持工单与会话。
WorkflowEvals ⭐
TypeSafe 用于复现其 WorkflowEvals 评测网站的代码:四个业务流程(发票审批与欺诈分拣、客服路由与处置、智能体运行中的动作选择、安全告警分拣),共 705 个案例,以 OpenAI、Anthropic 及共识结果为参考来评分。 (模型撰写) (机翻)
基准测试· ★10+ · typesafe-ai ·Py·noul·choice·score· 调用点,2026-11-02 模型阅读注意:
仅一次提交·厂商自报数据Quickstart ⭐
官方第一课:一条工单,一次请求里同时问一个 Choice、一个 Score 和一个 Noul,给了 Python / JS / cURL 三种写法。
官方文档·Py·TS·sh·choice·score·noulai-cookbook: Jev track
一套循序渐进的课程:从第一次调用、逐个原语、state 形状与 criteria,一直到工单分拣和多步工作流,并对应了全部四个官方模式。
教程· ★1k+ ·Py·choice·score·noul· 调用点,2026-09-22 阅读jev-demo
三个西班牙语演示,展示同一模式:Jev 决策、代码执行。Jira 工单分诊,按结果直接应用、标记复核或升级;预检扫描先标出有问题的函数,再只让 Claude 解释这些函数;PR 路由把每个 pull request 分给规则、Haiku 或 Sonnet。 (模型撰写) (机翻)
开源项目· ★10+ · soyjorgepilo ·TS·choice·noul·score· 调用点,2026-11-04 模型阅读注意:
仅一次提交·无许可证·需第三方密钥jevelry
命令行、终端界面和库,把给 Jev 的问题写成名为 jevel 的小文件;自带十七个,覆盖工单、issue、pull request、日志、告警和失败的测试。每个答案的确定程度被转换为执行、标记给人看或回退,所有决策都会记录,以便按实际结果调整阈值。 (模型撰写) (机翻)
开源项目· ★10+ · backant-io ·TS·choice·noul·score· 调用点,2026-11-04 模型阅读spring-ai-typesafe
社区维护的 Spring AI starter,把类型化决策带到 Java,用 builder API 封装三种问题类型。
平台集成· ★10+ ·Java·choice·score·noul· 调用点,2026-09-22 阅读Example: three primitives in one request
最小化的第一次调用:同时问一个 choice、一个 score 和一个 noul,并标注了容易踩的那几处不对称。
代码片段·Py·choice·score·noul· 调用点,2026-09-22 阅读注意:
代码未实测Jev AI Use Cases
逐个用例走一遍 —— 智能体路由、智能体内部的决策层、工单分拣 —— 每个都给出具体的选项集和示例响应。
教程· Mehul Gupta ·Py·choice注意:
付费墙Jev on AI/ML API
又一个网关接入路径,值得记一笔是因为它的端点路径和请求外壳跟原生 API、跟 Cloudflare 都不一样。
平台集成·Py·noul·choice·scoreJev on Cloudflare Workers AI
Workers AI binding 与 REST 示例:一次调用同时问 noul、choice、score,并给出含逐答案置信度的完整响应。
平台集成·TS·sh·noul·choice·score
已显示 10 / 12 条 · 在单独页面查看全部 12 条 → · 在站点上筛选
内容评分
在有序量表上给质量、风险或相关性打分。
Cookbook: Self-consistency with choices ⭐
在内容审核决策里显式加入「不确定」这个选项,并衡量标签一致率与自动处置比例之间的取舍。
官方文档·Py·choicePattern: Composite scoring ⭐
把一个笼统的判断拆成若干原子评分,再用你自己代码里的权重(而不是提示词里的)组合起来。
官方文档·Py·scoreAutoGPT TypeSafe blocks
七个生产级 block(choice/score/yes-no/ask-many/route/pick-best/filter),带 UTF-8 字节预算、逐字报文留存和十一个测试文件。
开源项目· ★100k+ ·Py·choice·score·noul· 调用点,2026-09-22 阅读worldmonitor: news threat classification
用两个 Choice 判断威胁等级与类别;盲测发现 Jev 只是与原有模型打平,于是一直保持影子运行。
基准测试· ★10k+ ·TS·choice· 调用点,2026-09-22 阅读 · 作者结论:不利(作者自述,未经本仓库复现)注意:
仅影子运行ai-cookbook: Jev track
一套循序渐进的课程:从第一次调用、逐个原语、state 形状与 criteria,一直到工单分拣和多步工作流,并对应了全部四个官方模式。
教程· ★1k+ ·Py·choice·score·noul· 调用点,2026-09-22 阅读gptcache
面向 LLM 调用的语义缓存。其 Jev 评估器针对一条缓存答案和一个新请求问若干 noul:任务和上下文是否一致、格式是否合适、是否缺少内容、答案是否仍然新鲜;只有最低的一项也超过阈值(示例中为 0.70)才复用答案。 (模型撰写) (机翻)
开源项目· ★1k+ · zilliztech ·Py· 调用点,2026-09-22 阅读jev-chat-jarvis
一个 Android 回复副驾:从屏幕文本判断意图、时机和风险,OCR 与文案起草交给另外的模型。
开源项目· ★1k+ ·Java·choice·score·noul· 调用点,2026-09-22 阅读pg-jev
一个真正的 PostgreSQL 扩展,把三个原语暴露成 SQL 函数 —— 语义判断可以直接写进任意行类型的 WHERE 子句。
开源项目· ★1k+ ·Py·sh·choice·score·noul· 调用点,2026-09-22 阅读beebots
三个交易机器人在 OKX 永续合约上比赛,默认是模拟盘:每一步由 Jev(或 Gemini)用 choice 从合法动作中选出,再用 score 给出信心;另有确定性的备用选择器、纯代码写的风控层,以及显示每个决策由谁做出的实时面板。 (模型撰写) (机翻)
开源项目· ★100+ · imikerussell ·TS·choice·score· 调用点,2026-10-24 模型阅读jev-as-a-judge
把 Jev 当作智能体评测的评委,与 GPT-5.6 Luna、GPT-5.6 Terra 和 Claude Sonnet 4.6 比较:一个天气智能体的五次固定运行,每次评 100 遍,给出质量分和通过与否。Jev 在全部 500 次判定中都与人工标注一致,其他三者为 99.8%、96.4% 和 80.0%;只有一位审阅者、五次运行。 (模型撰写) (机翻)
开源项目· ★100+ · danielgshea ·Py· 调用点,2026-09-22 阅读注意:
无许可证
已显示 10 / 177 条 · 在单独页面查看全部 177 条 → · 在站点上筛选
实时推荐
选择下一步呈现什么,快到能用在实时会话里。
jev-linkmap
重建网站的内部链接:代码抓取整站,为每个页面挑出 15 个相似页面以及正文中现成可用作锚文本的短语,然后每个页面向 Jev 发一次请求,针对每个目标询问是否应该链接(是非题)以及用哪个短语作锚文本(choice)。 (模型撰写) (机翻)
开源项目· ★10+ · stas4000 ·Py·noul·choice· 调用点,2026-11-01 模型阅读1 Million Emojis
一块 1,000 × 1,000 的共享表情画布,Jev 和人一起作画:每一笔之后发一次请求,用 choice 从“表情加位置”的选项里挑一个,再用 noul 判断这一笔是否还没画完;先走 Vercel AI Gateway,TypeSafe 直连作为后备。 (模型撰写) (机翻)
开源项目· cwdx ·TS·choice·noul· 调用点,2026-10-24 模型阅读注意:
作者自荐Jevflix
电影推荐器:FAISS 与 BM25 检索把 4,800 部电影缩成短名单,Jev 读出请求里的约束(片长、不要血腥画面)供代码过滤,再由一次覆盖最多 250 个候选的 Jev choice 选出一部影片。没有把握时,由 LLM 权衡前五名或追问一个问题。 (模型撰写) (机翻)
开源项目· arielbubis ·Py· 调用点,2026-09-24 阅读
总览
介绍模型或整个领域,而非单一模式。
Official agent skill for Claude Code ⭐
把 TypeSafe 官方技能装进 Claude Code,让智能体自己写出正确的 Jev 调用,不必每次手动贴 API 结构。
官方文档· ★1k+ ·sh@typesafe-ai/sdk (TypeScript / JavaScript) ⭐
官方 TypeScript 客户端。同时提供 ESM、CJS 和类型声明,辅助函数是小写的 choice()/score()/noul()。
SDK· ★100+ ·TS·JS·choice·score·noul· 调用点,2026-09-22 阅读system-one-adapter-python ⭐
一个可直接替换 TypeSafeClient 的适配器,底层走普通 LLM API —— 没有 Jev 权限也能跑 Jev 形状的代码。
SDK· ★100+ ·Py· 引用文件typesafe-sdk (Python) ⭐
官方 Python 客户端。含同步与异步客户端、支持 retry-after 的重试策略,以及 Choice/Score/Noul 辅助类。
SDK· ★100+ ·Py·choice·score·noul· 调用点,2026-09-22 阅读API reference ⭐
POST /v1/systemone 的核心 Choice、Score、Noul 问题请求与应答结构,以及请求校验和 HTTP 错误处理。 (机翻)
官方文档·sh·Py·TSModels, pricing and limits ⭐
原生 Jev 1.14/1.13 的 ID、别名、价格与限制:输入 $0.042/Mtok,输出免费,默认每次请求 64k token、每个问题 32k。默认输入为文本;图像和 262k 长上下文需显式开启实验功能。 (机翻)
官方文档·sh·Py·TSPrimitives: Choice, Score, Noul ⭐
核心 Choice、Score、Noul 问题类型的选择、组合与 criteria 写法;Choice 最多 255 个选项,Score 支持 2–10 级。 (机翻)
官方文档·Py·TS·choice·score·noulIntroducing System One models and Jev ⭐
发布博文:什么是 System One 模型、为什么要把决策从生成里拆出来,以及厂商自报的延迟与成本数字。
文章· Diogo Almeida注意:
厂商自报数据Jev 1.13 known limitations ⭐
厂商列出的 Jev 1.13 局限:字面化理解、算术与计数、日期比较、间接指代、夹杂无关细节的长 state,以及对抗性内容。 (机翻)
官方文档Use case map ⭐
厂商自己的分类体系:五大类、十九个行业方向、十种决策形态(从分类一直到结构化数据抽取)。
官方文档
已显示 10 / 505 条 · 在单独页面查看全部 505 条 → · 在站点上筛选
尚未按模式索引
其中 253 行是带代码的项目或插件。overview 也是关键词规则无法归类时给出的默认值,而这些行没有任何人对照决策模式阅读过的记录(patterns_reviewed),因此单独列出:见 Overview 页面末尾、站点,以及附有规则建议的复核队列。 (机翻)
按资源形态
同样这些行,按你点开链接后会看到什么来分组。
| 形态 | 例子数 | 点开会看到 |
|---|---|---|
| 官方文档 | 31 | 厂商文档、cookbook 与模式页。 |
| SDK | 102 | 客户端库,官方与社区。 |
| 平台集成 | 38 | 接入模型的网关、框架或平台路径。 |
| 代码片段 | 4 | 本仓库内的小型可运行样例。 |
| 开源项目 | 714 | 真正在调用 Jev 的应用或库。 |
| 插件 | 270 | 可安装的编辑器、智能体、MCP 集成。 |
| 教程 | 16 | 带代码的分步教学材料。 |
| 基准测试 | 79 | 实测。注意区分独立实测与厂商自报。 |
| 文章 | 14 | 讲解、分析与发布报道。 |
| 视频 | 3 | 演示与评测。 |
| 讨论 | 2 | 值得读的讨论,包括质疑的声音。 |
| Jev 替代实现 | 97 | 独立复现实现。它们不调用 Jev。 |
本仓库还有什么
除目录数据之外的部分。
查看可搜索站点预览
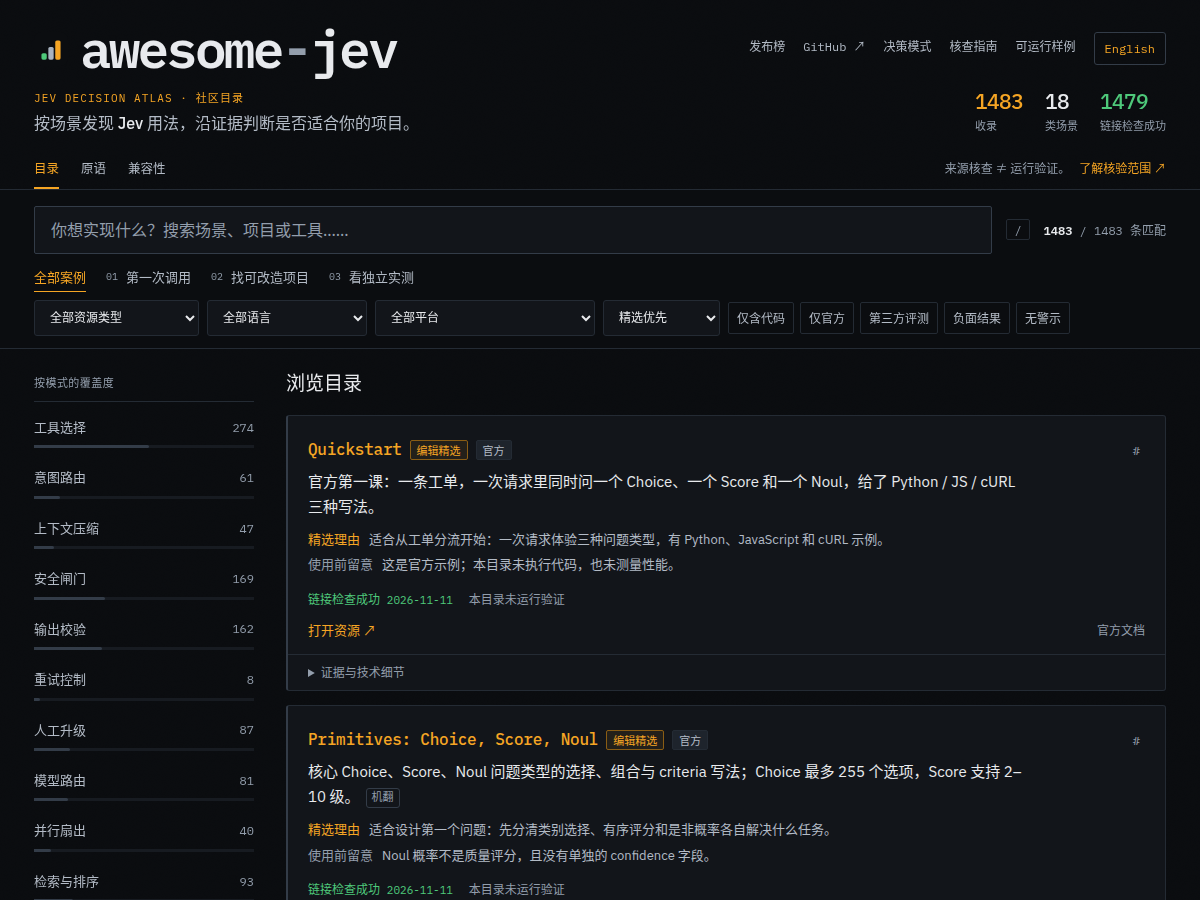
点击条形即可筛选。另有两个视图:三个原语 · 兼容性矩阵。每个筛选条件和每个条目都是可分享的 URL。也有静态页面:每个模式一页 · 每周新增与退役(Atom 订阅)。有代码的产品还可以上每周发布榜(规则说明)。
| 文件 | 是什么 |
|---|---|
docs/patterns.zh-CN.md |
逐个定义每个模式,并明确写出什么时候不该用它。 |
docs/compatibility.md |
模型串、字段名、请求结构、端点、环境变量 —— 每个平台都不一样。这就是那张对照表。 |
docs/vetting.md |
信任一个条目之前该检查什么,以及大多数人会犯的那一个错。 |
docs/status.md |
这个生态第一周的真实样貌,包括缺口。 |
docs/shape.zh-CN.md |
把目录当作数据集来看:语言、如何接入 Jev、各类型的 star 区间、各模式用的语言。 (机翻) |
docs/method.md |
目录是如何建起来的、排除了什么、以及它最弱的地方在哪。 |
docs/sources.md |
每一行的来源,以及许可状况。 |
examples/ |
四个可运行样例。其中一个刻意把阈值策略留给你写。 |
schema/entry.schema.json |
一条目录记录允许包含什么。 |
.claude-plugin/ |
在 Claude Code 里一次装好技能和 MCP server:先 /plugin marketplace add kydlikebtc/awesome-jev,再 /plugin install awesome-jev@awesome-jev。 |
src/awesome_jev_mcp/ |
一个 MCP server —— 让智能体可以查询目录而不是阅读它。每条结果都带着它的警示,也带着数据有多新。 |
skills/awesome-jev/ |
一份 agent 技能:生成的 Jev 代码最常搞错的那些事实,以及值得遵循的设计规则。 |
scripts/verify_claims.py |
每周重读每一处被引用的调用点 —— 让原语声明可核实,而不只是被断言。 |
scripts/refresh_metadata.py |
从 GitHub API 重新读取 star、许可证与归档状态,并开 PR。 |
skills/awesome-jev/ 是对 TypeSafe 官方智能体技能 typesafe-ai/skills(目录条目)的补充,而非替代:API 契约与问题设计以官方技能及其所读的实时文档为准;本技能补充公开生态里能看到的东西——实际示例及其警示、各平台差异,以及独立测量与负面结果。 (机翻)
哪些经过核实,哪些没有
链接检查 —— 有 1367 行记录了 HTTP 2xx 响应和
checked日期,另有 3 行没有带日期的成功记录。检查日期因条目而异,过去成功不保证今天仍可访问。star 数和许可证也是仓库元数据的快照。来源与代码阅读 ——
evidence.path指向所读文件,evidence.read_on记录声明的阅读日期,evidence.model_read_on记录模型的阅读、单独显示,evidence_none解释缺少文件证据的原因。阅读调用点与运行代码是两件事。摘要包含源项目描述与机翻,详见方法与局限。 (机翻)摘要是谁的文字 —— 750 条摘要的英文原文就是被链接项目自己在 GitHub 上的描述,逐字相同,这些行标为 (项目自述);29 条标为 (项目旧自述):英文取自项目描述,但两者已不再相同。这些文字出自项目作者,中文摘要是其译文。11 条摘要标明由人为本目录撰写,263 条由模型为本目录撰写并标为 (模型撰写),317 条未作记录。每周刷新会把每条英文摘要与其仓库描述比对并标出相同者;只有人才能把摘要标为人写的。 (机翻)
中文是谁写的 —— 1370 行中有 192 行的中文摘要由人撰写;其余 1178 行由模型翻译,带有
zh_machine,并在中文 README、中文模式页面和站点的中文视图中逐条标为 (机翻)。翻译队列列出等待有人替换的机翻:先是星标最高各行的全部机翻,再按星标从高到低列出被脚本计算的三项文本信号(比英文短得多、缺少英文里的数字、大部分是 ASCII 字符)中至少一项标出的其他机翻。信号只是对照比较,不是对译文的结论,README、模式页面和站点上的各行都不显示信号。认领方法见认领翻译;只有你自己写的译文才能去掉zh_machine。 (机翻)调用点文本复查 —— 有 1192 行通过
evidence记录了项目调用 Jev 的文件及其中匹配的字符串。另有 93 行记录的文件只表明项目采用了 Jev 的请求结构、并非基于 Jev 构建(所有alternative——无论是自己提供这种结构,还是向 Jev 发送同样的请求作对比——以及由其他模型支撑的适配器),0 行记录的只是项目附带的示例;evidence.kind标明属于哪一种。每周 claims 任务 检查这些字符串是否仍在默认分支,发现文本或文件缺失时报告。这些数字是已记录的证据数量,不是最新 CI 通过数。文本匹配不能证明调用实际执行、API 兼容或结果正确。脚本标出、需要人重读的引用列在复核队列。 (机翻)用了哪些原语 —— 有 111 行在
question_types中记录了有人读代码时确认调用的原语;另有 112 行记录的是模型读代码时确认的原语,这些行的调用点只有模型读过(evidence.model_read_on)。此外还有 749 行带primitives_seen,这是机器文本信号:每周刷新在该行所引的那一个文件中找到了某个原语的请求或回答结构("type": "choice"、Noul(、.noul)。文件里出现这种结构不等于调用;其中 618 行没有question_types,这个信号就是关于它们所用原语的全部记录。本目录的筛选、计数和规则都不会把它当作原语声明。 (机翻)本仓库未独立验证运行与性能 —— 所有目录条目默认都未经本仓库实测,没有
code-untested标签也不代表已测试。被收录的基准是原作者的测量,本目录没有独立复现。仓库构建检查与安装包冒烟测试不运行这些集成,也不调用 Jev 在线 API;收录亦不代表安全审计。
这些标记是什么意思
| 标记 | 含义 |
|---|---|
并非 Jev 本身 |
完全不调用 Jev。协议兼容不等于校准兼容,所以阈值不能迁移。 |
仅影子运行 |
接进去了但故意不生效 —— 它返回的东西不会进入任何对用户可见的决策。 |
需早期访问 |
需要通过等候名单才能运行。 |
代码未实测 |
代码是读过的,没有实际运行。 |
仅一次提交 |
每周刷新上次询问 GitHub 时,默认分支只有一次提交;此标记由每周刷新自动添加和移除。 |
无许可证 |
没有 LICENSE 文件,不管 README 徽章怎么写。复用时这是硬障碍。 |
需第三方密钥 |
需要 TypeSafe 之外某个服务的密钥。 |
厂商自报数据 |
照搬厂商自测数据,不是独立实测。 |
宣称未核实 |
做出了无法核实的量化宣称。 |
疑似 AI 生成 |
读起来像机器生成的内容。 |
营销内容 |
发布目的既是讲解也是推销。 |
付费墙 |
有付费墙或阅读次数限制。 |
已归档 |
开发明显已经停止。 |
作者自荐 |
由项目作者或维护者本人提交。这是对关系的披露,不是质量评判。 |
实测后未采用 |
项目作者本人针对这一用途测量过 Jev,结论是不采用或已将其移除。这是作者的结论,未经本仓库复现;请先读它,再看正面例子。基准测试行改用 measurement.direction(不利)记录同一件事。 |
已退休的链接
已无法访问的链接。保留下来,让失效的引用仍可被搜索到,而不是凭空消失。
| 例子 | 原因 |
|---|---|
| datajev | 2026-10-24 退役:自 2026-09-29 起每周刷新都无法访问该仓库(最近一次为 2026-10-21)—— 已删除、改名且无跳转,或转为私有。保留于此,以便这条引用仍可检索。 HTTP 404 |
| jev-atlas | 2026-09-24 退役:仓库在 API 和网页上都返回 404,而作者账号仍然存在 —— 已删除或转为私有。保留于此,以便这条引用仍可检索。 HTTP 404 |
| jev-curate | 2026-10-24 退役:自 2026-10-13 起每周刷新都无法访问该仓库(最近一次为 2026-10-21)—— 已删除、改名且无跳转,或转为私有。保留于此,以便这条引用仍可检索。 HTTP 404 |
| jev-git | 2026-10-24 退役:自 2026-10-13 起每周刷新都无法访问该仓库(最近一次为 2026-10-21)—— 已删除、改名且无跳转,或转为私有。保留于此,以便这条引用仍可检索。 HTTP 404 |
| jev-mac-voice | 2026-09-24 退役:仓库在 API 和网页上都返回 404,而作者账号仍然存在 —— 已删除或转为私有。保留于此,以便这条引用仍可检索。 HTTP 404 |
| jev-reviewer | 2026-10-29 退役:自 2026-10-19 起每周检查都无法访问该仓库(最近一次为 2026-10-28)—— 已删除、改名且无跳转,或转为私有。保留于此,以便这条引用仍可检索。 HTTP 404 |
| jev-scout | 2026-10-24 退役:自 2026-10-13 起每周刷新都无法访问该仓库(最近一次为 2026-10-21)—— 已删除、改名且无跳转,或转为私有。保留于此,以便这条引用仍可检索。 HTTP 404 |
| jev-screen-mcp | 2026-10-24 退役:自 2026-09-29 起每周刷新都无法访问该仓库(最近一次为 2026-10-21)—— 已删除、改名且无跳转,或转为私有。保留于此,以便这条引用仍可检索。 HTTP 404 |
| jev-seo | 2026-10-24 退役:自 2026-10-13 起每周刷新都无法访问该仓库(最近一次为 2026-10-21)—— 已删除、改名且无跳转,或转为私有。保留于此,以便这条引用仍可检索。 HTTP 404 |
| jev-skills | 2026-10-24 退役:自 2026-10-06 起每周刷新都无法访问该仓库(最近一次为 2026-10-21)—— 已删除、改名且无跳转,或转为私有。保留于此,以便这条引用仍可检索。 HTTP 404 |
| jev-superpowers | 2026-10-24 退役:自 2026-10-13 起每周刷新都无法访问该仓库(最近一次为 2026-10-21)—— 已删除、改名且无跳转,或转为私有。保留于此,以便这条引用仍可检索。 HTTP 404 |
| JevRev | 2026-10-24 退役:自 2026-10-13 起每周刷新都无法访问该仓库(最近一次为 2026-10-21)—— 已删除、改名且无跳转,或转为私有。保留于此,以便这条引用仍可检索。 HTTP 404 |
| rh-guard | 2026-10-24 退役:自 2026-10-13 起每周刷新都无法访问该仓库(最近一次为 2026-10-21)—— 已删除、改名且无跳转,或转为私有。保留于此,以便这条引用仍可检索。 HTTP 404 |
| typesafe-oracles | 2026-10-24 退役:自 2026-09-29 起每周刷新都无法访问该仓库(最近一次为 2026-10-21)—— 已删除、改名且无跳转,或转为私有。保留于此,以便这条引用仍可检索。 HTTP 404 |
| zerosweep | 2026-10-24 退役:自 2026-09-29 起每周刷新都无法访问该仓库(最近一次为 2026-10-21)—— 已删除、改名且无跳转,或转为私有。保留于此,以便这条引用仍可检索。 HTTP 404 |
机器可读数据
每个例子一条记录,每次推送都按 JSON Schema 校验。
| 文件 | 是什么 |
|---|---|
catalog.json |
1370 条目 |
retired.json |
15 已退休 |
compat.json |
docs/compatibility.md 使用的平台兼容性数据 |
patterns.json |
生成器与 MCP server 共用的决策模式分类 |
collections.json |
双语精选路径、推荐理由与使用限制 |
schema/entry.schema.json |
每条目录记录的字段规范 |
llms.txt |
供智能体读取的目录说明,明确附带限制 |
参与贡献与许可
纠错优先于新增 —— 一个错的条目比一个缺失的条目代价更大。详见 CONTRIBUTING.md;收录标准是:读者不点开链接,能否据此行动?
scripts/、site/、examples/ 中的代码采用 MIT。目录元数据采用 CC0-1.0,并带逐行 license 字段。被链接的作品各自保留原许可 —— repo_license 记录了各自声明的内容。标有 (项目自述) 或 (项目旧自述) 的摘要是被链接项目自己的文字(中文为其译文),不在上述 CC0 声明之内(见来源与许可)。 (机翻)

探索相关项目
affaan-m/ECC
智能体执行与控制框架的性能优化系统。面向 Claude Code、Codex、Opencode、Cursor 等,涵盖技能、本能、记忆、安全与研究优先的开发。
301,796 星标NousResearch/hermes-agent
与你一同成长的智能体
262,906 星标multica-ai/andrej-karpathy-skills
一个用于改进 Claude Code 行为的 CLAUDE.md 文件,源自 Andrej Karpathy 对 LLM 编程陷阱的观察。
232,459 星标firecrawl/firecrawl
借助来自网络及其他来源的数据,强化你的 AI 智能体。正在构建面向超级智能的资料库。🔥
200,932 星标