
inclusionAI/ASpec
inclusionAI/ASpec has 53 GitHub stars and 7 forks. GitHot measured 0 stars in 24 hours. Last checked 2026-11-15 21:36 UTC. Last push 2026-11-06.
实测星标增长
- 24小时
- 0
- 7天
- 更新延迟
- 15天
- 更新延迟
- 1个月
- 更新延迟
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
关于
A high-throughput training framework for Speculative decoding models.
人工智能README_zh-CN.md
原文ASpec
让 Draft 训练更快,让算法探索更轻松。
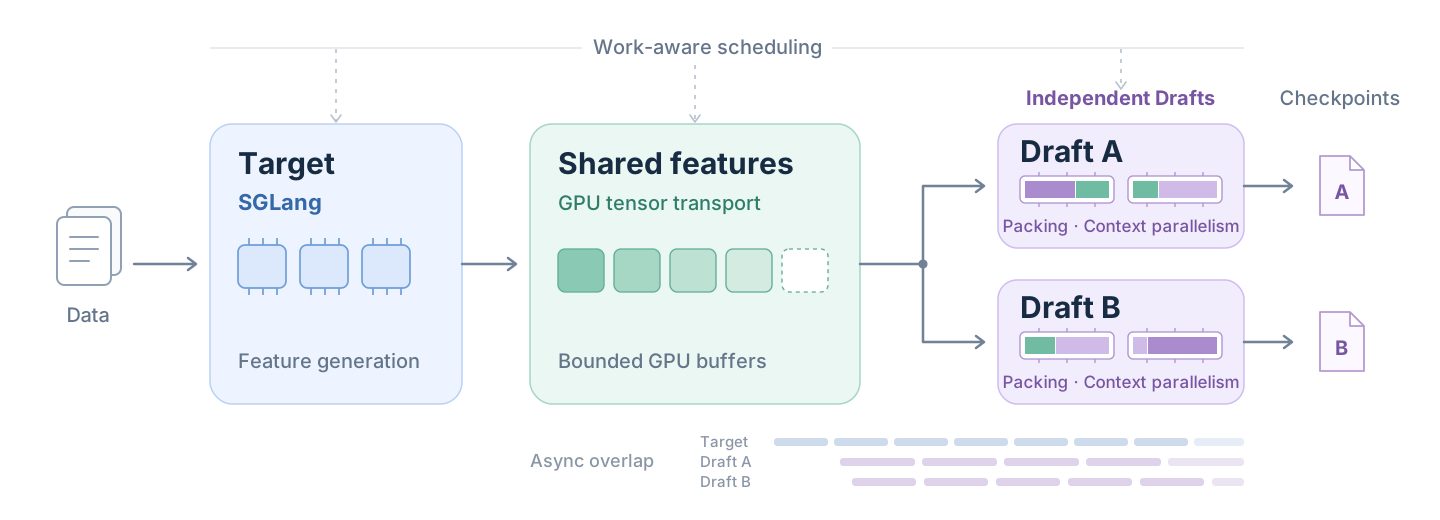
ASpec 是面向推测解码的高吞吐 Draft 训练框架。它优化 Draft 前向、反向和参数更新,让训练与 Target 特征生成异步重叠,也让多个独立实验复用兼容的 Target 特征。
ASpec 基于 TorchSpec 源码开发,在其训练基础设施之上, 进一步优化训练执行与工作流。
从算法与模型结构探索,到长上下文训练、多实验对比,再到评估、恢复和导出,使用同一套工作流。
为什么选择 ASpec?
- 让 Draft 训练本身更快。 优化注意力、融合算子,并按有效监督位置执行 head 和 loss, 减少前后向中的计算与显存读写。
- 让流水线持续运转。 Target 生成与 Draft 训练重叠执行,特征通过 GPU tensor 数据面传输, 按有效工作量组织训练,减少两端等待。
- 一个 Target,多个 Draft 并行实验。 比较算法、结构或超参数时,兼容的 Target 特征只生成 一次。各 Draft 独立维护权重、优化器、进度和 checkpoint,无需每次更新都相互等待。 当前单机用法见共享训练指南。
- 高效处理长上下文。 结合序列打包、上下文并行与优化的注意力执行,减少 padding 浪费, 将长序列训练分布到多张 GPU。
- 换算法,不重搭工作流。 通过 recipe 选择算法与结构,沿用一致的配置、报告、恢复、评估和 导出入口。
选择适合你的 Draft
围绕实际 workload 选择算法与结构,Draft 与 Target 可以使用不同架构:
| 维度 | 已实现选择 |
|---|---|
| Draft 算法 | DSpark、DFlash、EAGLE3、EAGLE4、原生 MTP;实验性 DFlash2 |
| FFN 与路由 | Dense、Qwen MoE、Ling MoE |
| 注意力结构 | MHA/GQA、materialized MLA、滑动窗口注意力(SWA)、CSA、QSA、DSA |
| 执行方式 | 序列打包、上下文并行、Target 特征共享、静态多机训练 |
算法说明和结构与阶段给出具体支持组合、 训练阶段与导出格式。 Qwen、Ling 上的 DSpark/DFlash 是主要优化方向和 recipe 维护重点;其他已实现路径有各自的 支持边界,DFlash2 仍为实验能力。
从首次多卡运行扩展到静态多机训练,支持 NVLink、TCP 和 RDMA 数据路径。 先查看支持范围与已知限制,再从 recipe 导航选择起点。
开始使用
- 按安装指南一键创建源码环境,也可选择容器;
- 在快速上手中选择 Qwen3-8B 或 Ling tiny,用两张 GPU 完成 相同的 Plan、训练、报告、恢复和导出流程;
- 根据recipe 导航选择算法/结构并准备实际数据。
bash setup.sh
source .venv/bin/activate
CUDA_VISIBLE_DEVICES=0,1 aspec quickstart ling-tiny --output outputs/ling-tiny-001
# 或选择 Qwen3-8B:
CUDA_VISIBLE_DEVICES=0,1 aspec quickstart qwen3-8b --output outputs/qwen3-8b-001
两个入口都使用内置原始对话和各自的 tokenizer/template,完成 8 步训练、精确恢复和 native 导出加载。
使用已有模型时添加 --target /absolute/path/to/model。使用 Target 生成的数据开展训练与
独立评估,可继续阅读 Qwen3-8B DSpark recipe。
性能
ASpec 同时优化 Draft 执行和完整在线训练流水线。DSpark 对照 覆盖 Hopper GPU 上 Qwen3-8B、Qwen3.8-27B 的短文档与长上下文。以 Qwen3-8B / 4K 为例:
| 测量范围 | ASpec 输入吞吐(tokens/s) | 相对 TorchSpec | 相对 SpecForge | 相对 AngelSpec |
|---|---|---|---|---|
| 单卡 Draft 独立训练 | 15,256.44 | 1.96× | 2.07× | 2.48× |
| 八卡在线训练稳态窗口 | 77,721.37 | 2.28× | 2.50× | 2.68× |
各框架统一采用每张 Draft 卡每个 microstep 处理一篇原始文档的 MBS1,按文档对齐采样预算和 逻辑 batch,正常启用互联并配足 buffer。单卡测量不含 Target 执行、传输和特征加载;在线稳态 窗口包含这些开销,从第八次更新完成后开始。这些数字衡量训练输入处理效率,不代表推理加速 或达到指定质量的训练加速;完整矩阵另列运行栈、资源配比和完整训练循环吞吐。
另有固定训练序列的 Qwen3-8B / CP1 对照检查训练质量: BSHD 的验证 CE 与 TorchSpec 接近;实际平均接受长度(tokens/round,含 Target bonus token) 分别为 TorchSpec 3.665717、ASpec BSHD 3.691665、ASpec THD 3.746300。在启用确定性推理的 256 道题、三次重复评估中,三者输出 token 均与 Target-only greedy 一致。结论限于该训练序列和评估配置。
实际训练可参考 DSpark 性能设置启用 cuDNN 注意力与直接 prefill;Target/Draft 配比应结合 workload 选择。
Benchmark 指南提供测试条件、结果和复现依据。训练所得 Draft 的 held-out 指标、实际接受长度和下游验证方式,见评估与导出。
进一步了解
引用
如果 ASpec 对你有所帮助,欢迎引用:
@misc{aspec2026,
  author = {Zhou, Aihui and Long, Lingkun and Yu, Chaofan and
            Yang, Zhe and Peng, Cunyin and Zhang, Zhiqiang and Zhou, Jun},
  title = {{ASpec}: A High-Throughput Training Framework for Speculative Decoding},
  year = {2026},
  url = {https://github.com/inclusionAI/ASpec}
}
引用元数据见 CITATION.cff。
许可证
项目使用 Apache 2.0。第三方源码保留各自的许可与声明,见源码文件头和 licenses/;模型和数据各自的许可仍适用。