
he-yufeng/CoreCoder
he-yufeng/CoreCoder has 1,889 GitHub stars and 461 forks. GitHot measured 0 stars in 24 hours. Last checked 2026-11-05 08:18 UTC. Last push 2026-10-19.
Minimal AI coding agent (~1,000 lines of Python) inspired by Claude Code. Works with any LLM. Think NanoGPT for coding agents. Formerly NanoCoder.
实测星标增长
- 24小时
- 0
- 7天
- 更新延迟
- 15天
- 更新延迟
- 1个月
- 更新延迟
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
README_CN.md
原文CoreCoder
编程 agent 里的 nanoGPT。1.3k 行引擎、整包 2816 行纯 Python 全部一口气可读,读懂一个 coding agent 到底怎么运作,再 fork 出你自己的。
learn from it · fork it · ship something better
中文 | English | 配套源码导读 · 八篇双语


- 读得完。 一个下午读完整个引擎,没有一处藏着你看不懂的魔法。
- 改得动。 每一行都能在你自己机器上下断点、改了再跑。它真能干活,所以这份参考是活的,不是示意图。
- 留白即起点。 刻意只留最小核心,没做的那些不是半成品,是留给你 fork 出更好东西的地方。
和谁比
| CoreCoder | Claude Code | aider | nanoGPT | |
|---|---|---|---|---|
| 代码量 | 引擎约 1322 行 / 整包 2816 行 | 几十万行(闭源) | 数万行 Python | 约 600 行(两个文件) |
| 读完要多久 | 一个下午 | 读不了(闭源) | 得啃几天 | 一个下午 |
| 能不能下断点改了再跑 | 能,每一行 | 不能 | 能,但量大 | 能 |
| 定位 | 读懂并 fork 出你自己的 agent | 生产级编程助手 | 终端结对编程 | 教学用最小 GPT |
nanoGPT 那一列是拿来对照的:它最小、可读,但教的是训一个 GPT。CoreCoder 想干的是同一件事,只是把对象换成一个能真正改代码的 agent。和 Claude Code、aider 摆在一起,不是要跟它们抢用户,CoreCoder 是借它们来学、来起步的那块地基,根本不在一个赛道。
这是什么
我一直觉得 coding agent 被讲得太玄了。把 Claude Code、Cursor 这类工具扒到底,核心是一个 while 循环套着一个大模型,外加七八个让它能真正动手的工具。难的从来不是这个循环,而是循环跑进真实世界以后要兜的那些底。CoreCoder 就是把这个核心老老实实写出来的最小版本。
引擎部分(循环、模型接口、上下文、工具、会话)去掉空行和注释是 1322 行。连最外层的 CLI、配置、打包一起算,整个包 25 个文件、物理 2816 行、净 2276 行,每个文件都短到能一口气读完。自 1161 行快照之后的增长都花在了看得见的功能上:plan mode、hooks、checkpoints,下文各有交代。
它真能跑:读写文件、执行 shell、派子 agent、分三层压上下文,还能随时把这趟烧掉的 token 和美元数报给你。任何要动你磁盘、要跑命令的调用,都会先停下来等你点头,227 个测试是绿的。但能跑不是为了劝你拿去日用,而是为了让这份「注释」不撒谎:一个解释 agent 怎么运作的范例,自己得真能运作。
代码来自一次公开拆解。公开的源码分析里,Claude Code 这类生产级 agent 暴露出不少关键架构,我挑出最核心的一层,用尽量少的代码诚实地复写了一遍。所以读 CoreCoder,约等于读一份基于公开源码分析的「可运行注释版」:讲的是这类 agent 的核心思路,而它本身只是最小复写,就摆在你机器上,随你拆、随你改。
这一千行真能跑通一个完整回合:让它修 buggy.py,它自己读文件、改代码、跑一遍确认、再给结论。看完就回来读代码。
这份 README 也就按这条线铺开:上半带你读懂(代码地图、主循环、八篇导读),下半带你 fork 它、再指几个能往更好里做的方向。
先跑一次(读之前的五分钟)
读源码之前,先让它在你机器上活一次,建立点体感。它是个拿来 fork 的地基,所以推荐直接 clone 下来、可编辑安装,边读边改:
git clone https://github.com/he-yufeng/CoreCoder
cd CoreCoder
pip install -e .
只想先跑起来找找感觉,直接 pip install corecoder 也行。
给它一个模型加一把 key 就能动。默认走 OpenAI 兼容接口,换 provider 通常只是改两个环境变量:
| Provider | 环境变量示例 |
|---|---|
OpenAI(默认 gpt-5.5) |
OPENAI_API_KEY=sk-... |
| DeepSeek | OPENAI_API_KEY=sk-... OPENAI_BASE_URL=https://api.deepseek.com CORECODER_MODEL=deepseek-chat |
| OmniRoute | OPENAI_API_KEY=your-key OPENAI_BASE_URL=http://localhost:20128/v1 CORECODER_MODEL=auto |
| 本地 Ollama | OPENAI_API_KEY=ollama OPENAI_BASE_URL=http://localhost:11434/v1 CORECODER_MODEL=qwen2.5-coder |
Kimi、Qwen 这些同样是改这两个变量;连 OpenAI 兼容接口都不给的 provider,装上可选的 LiteLLM 后端(pip install "corecoder[litellm]")能路由一百多家。第三篇文章把这块讲得更细。思考模型也是一等公民:deepseek-reasoner、kimi-k3 这类模型的思考过程会实时流出来,CoreCoder 把它用暗色显示出来,但不进对话历史,provider 永远不会在回包里看到它。key 可以直接 export,也可以在项目根目录扔个 .env,启动时自动加载。然后:
端到端真机冒烟过三家(读文件、改代码、跑一次确认、自己报告):DeepSeek、Qwen3、Kimi K2,走同一个 OpenRouter 兼容端点,各自完整跑完全循环。写脚本用 one-shot 的留意:-p 默认拒绝一切改动类工具,要加 --yes,这是设计如此。
corecoder                                  # 交互式 REPL
corecoder -p "给 parse_config() 加错误处理"   # 一次性模式,干完就退
读懂它:代码地图
整个项目摊开就这么大,clone 之前扫一眼,心里就有数了。这也是它和 Claude Code 几十万行最实在的区别:你能把它当一本书的目录来读。建议从 agent.py 的主循环读起,那是整个 agent 的心脏。
corecoder/
├── agent.py        agent 主循环 + 并行工具执行       240 行   ← 从这里开始读
├── llm.py          流式客户端 + 重试 + 成本统计       349 行
├── context.py      三层上下文压缩                     220 行
├── session.py      会话存盘 / 续聊 + 路径穿越防护      97 行
├── permissions.py  改动类工具的用户授权                75 行
├── hooks.py        工具调用前后的用户 shell 钩子        87 行
├── shell.py        POSIX shell 路由(Windows 走 Git Bash) 61 行
├── mcp.py          MCP stdio 客户端,接外部工具       237 行
├── prompt.py       系统提示词                          41 行
├── cli.py          REPL + 斜杠命令 + 一次性模式        393 行
├── config.py       环境变量配置                        55 行
├── checkpoints.py  /undo 快照与回滚                      93 行
├── demo.py         离线端到端演示                       101 行
└── tools/
    ├── bash.py       shell + 危险命令闸 + cd 追踪      203 行
    ├── edit.py       唯一匹配搜索替换 + diff            99 行
    ├── grep.py       内容搜索                           93 行
    ├── glob_tool.py  文件名匹配                         52 行
    ├── read.py       文件读取                           56 行
    ├── write.py      文件写入                           46 行
    ├── todo.py       agent 自维护的任务清单             79 行
    ├── agent.py      子 agent 派生                      72 行
    └── base.py       工具基类                           32 行
examples/
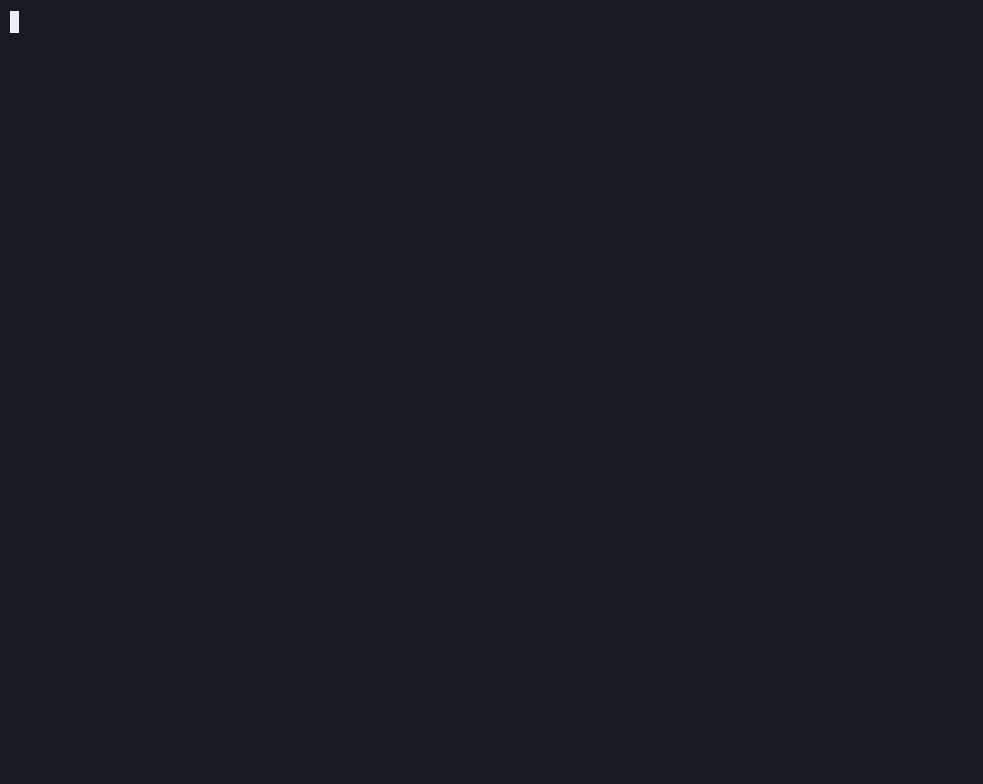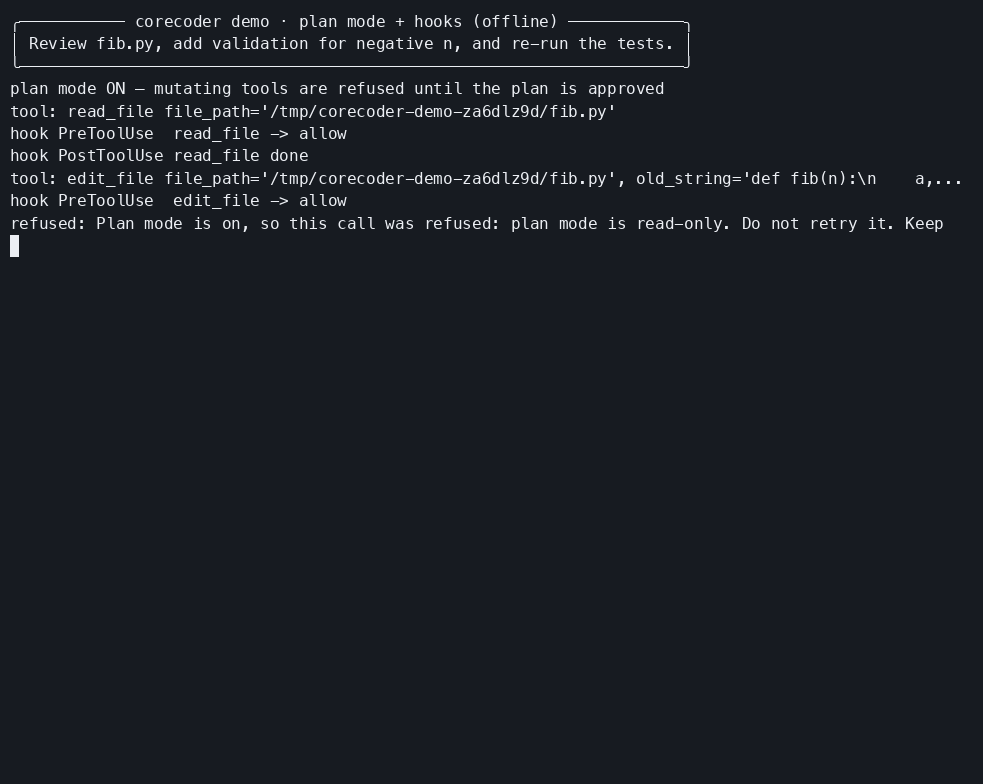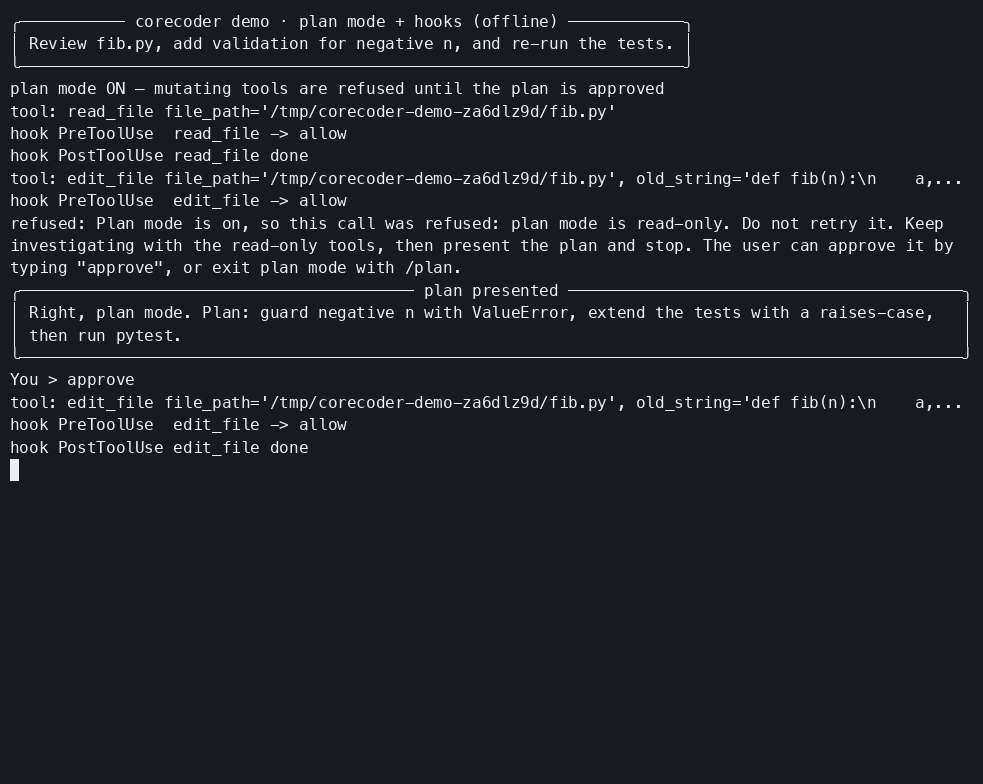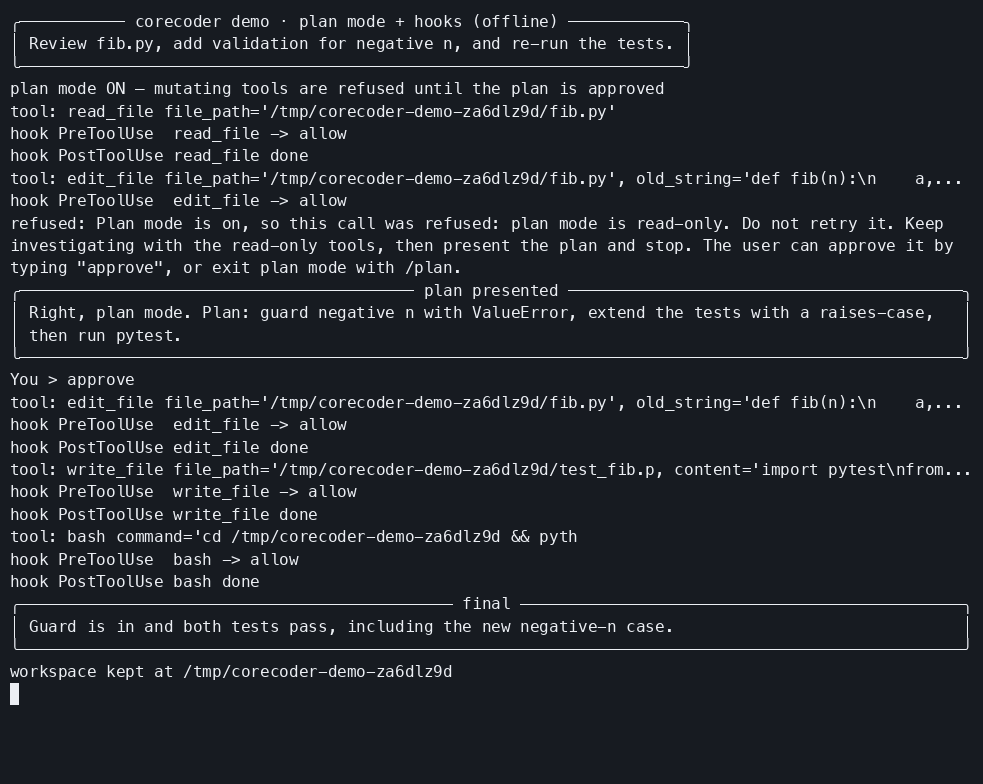
└── plan_hooks_demo.py  离线 plan mode + hooks 演示(免 API key)
八个工具:bash、read_file、write_file、edit_file、glob、grep、todo_write(agent 自己维护的任务清单)、agent(派子 agent)。其余都是包在引擎核心外面的 CLI 外壳、配置和打包。存在 ~/.corecoder/mcp.json 时,里面的 MCP 服务器会以 mcp__* 工具的身份并进这八件里,下面有专门一节讲。
一个 while 循环就是 agent 的本体
一个 agent 的本体,一句话就能讲清:把用户的话交给模型,模型想调工具就执行,把结果塞回上下文,再问模型,直到它不再要工具、给出回答。落到代码,也就十来行:
# corecoder/agent.py · 主循环(精简骨架)
def chat(self, user_input):
    self.messages.append(user_input)

    for _ in range(self.max_rounds):                   # 循环有上限,跑不飞
        reply = self.llm.chat(self.messages, self.tools)   # 交给模型规划下一步
        if not reply.tool_calls:                       # 模型不再要工具
            return reply.text                          #   → 收工,把回答给用户
        results = run_parallel(reply.tool_calls)       # 要工具就并发执行
        self.messages += results                       # 结果回灌,进入下一轮

    return "(已达轮次上限)"
就这么点。这个循环的核心骨架就二十来行,把并行执行和被 Ctrl+C 打断后的回填都算上,也才四十多行。CoreCoder 一千多行里剩下的,几乎全在收拾它真跑起来之后冒出来的岔子。llm.py 最后成了引擎里最大的文件,不是因为调模型有多难,而是流式返回里一个工具调用的参数会被切成好几段先后送到、得按顺序拼回去,provider 偶尔吐半截 JSON 或把 usage 填成 null,限流(429)、超时、连接中断和 5xx 都得退避重试,其余 4xx 该直接抛就别硬试。已经开始出字的流也可能半路断掉,所以重试包住的是整个请求,不只是建连。这些不起眼的脏活,而不是那个循环,才是一个 agent 从能演示走到能交付真正吃工程功夫的地方;第三篇文章顺着它拆到每一行。
有三个决定值得单独看,因为它们是「先读懂别人怎么做」之后才做得出的取舍,也是你 fork 自己 agent 时可以直接抄走的判断。
edit_file 用唯一匹配的搜索替换,不靠行号。 行号这东西,模型只要数偏一行,就会悄悄改错地方;锚定一段唯一的原文:匹配不到,就把文件开头甩回去让模型照着重新锚定;匹配到多处,就让它多带几行上下文再来,而不是赌一个。改成功了,连一段 diff 一起返回。失败能复位、成功能复核,闭环都收在工具自己手里。
上下文不是满了才一刀切,而是按代价从轻到重分三档退让。 先在半满(50%)时把超长的工具输出就地截短,这一档纯机械、不花一次模型调用;到 70% 还压不下去,就把较早的轮次交给模型总结成一段摘要,最近几轮原文原样留着;逼到 90% 才进应急档,连摘要带最近几轮一起收到最紧。粗暴截断往往恰好丢掉一个长任务最依赖的早期决定;分层退让,是让它按重要性从低到高一档档地让,而不是一上来就把最老的决定整段切掉。
约束子 agent 能干什么,靠的是不给它那把工具,而不是写一堆规则求它听话。 派出去的子 agent 拿到的是隔离的上下文、自己独立的一份历史,工具集只比父 agent 少一样:agent 工具本身,于是它没法再往下递归派子 agent。少给一件工具,比事后立一条规矩干净得多。它还复用父 agent 同一个模型连接(花销一并算进总账),输出一过 5000 字就截短、只留开头一段,轮次上限也压得比父 agent 更短。同一套克制,从头贯到尾。
每一个「为什么」,下面的文章系列都拆到了具体代码行。
配套源码导读 · 八篇双语
我还写了一套双语源码导读,一篇导言加八篇正文,每篇都配英文镜像(_EN.md)。它对着 CoreCoder 的真实代码,讲 Claude Code 这类 agent 的内部构造。有一条给自己立的硬规矩:每一处行数、每一段代码都从仓库里现读现核,绝不凭印象编。前六篇带你读懂,第七篇带你 fork,第八篇讲怎么不动主循环地扩展它,哪篇先读都行。
- 导言 · 用 CoreCoder 读懂 Claude Code,再造一个你自己的
- 01 一个 agent 的本体,是一个 while 循环 —
agent.py的主循环、打断与轮次上限 - 02 工具系统:让模型安全地动手 —
tools/八个工具与 bash 安全闸 - 03 接入任意大模型,顺便把账算清楚 —
llm.py的 provider 包装、重试与成本统计 - 04 用有限的窗口扛住一个长任务 —
context.py的三层压缩与孤儿 tool 消息 - 05 并行执行与子 agent — 线程池并发与子 agent 隔离
- 06 把它跑成一个真正的命令行工具 —
session.py与路径穿越防护 - 07 Fork CoreCoder,搭一个你自己的 coding agent — 从 fork 到加自定义工具到换模型
- 08 不动主循环的三种加法:MCP、钩子与计划模式 — v0.6.0 扩展三件套,以及让它们成立的那条契约
Fork 它,造个更好的
读懂之后,最自然的下一步就是 fork。起手不用伤筋动骨:
- 换个你常用的模型。 就是上面那两个环境变量,
llm.py(349 行)是所有 provider 适配的入口。 - 加一件你自己的工具。 照
tools/base.py(32 行)的工具基类写个新文件,跑测试、抓网页、调 LSP 都行,第二篇文章末尾手把手带你写第一个。 - 改系统提示词。
prompt.py才 41 行,改一句就能看到 agent 的脾气变了,是门槛最低的「改一处就有反馈」。 - 直接当库 import。 顶层导出了
Agent、LLM、Config,能嵌进你自己的程序:
from corecoder import Agent, LLM

llm = LLM(model="deepseek-chat", api_key="sk-...", base_url="https://api.deepseek.com")
print(Agent(llm=llm).chat("找出项目里所有 TODO 注释并列出来"))
往深里做,方向也都摆在明处。下面这些 CoreCoder 都没做,是设计取舍,不是没做完;换个角度,每一条都是你能接着往下做、把它推向更强的入口:
- bash 的危险命令拦截只是正则黑名单。 防手滑,不是安全沙箱。要面对不可信输入,就得上 seccomp 或容器隔离。这条最硬,要一路走到系统调用和隔离那一层。
- 重试只做了指数退避。 没有 fallback 模型,也没有美元硬预算。顺着
llm.py往下,加一条 fallback 模型链和超预算自动停的闸,改动基本就集中在这一个文件。 - 子 agent 只有最朴素的同步执行。 做成异步或流式执行器,正好补上第五篇点名的、相对生产级 agent 流式执行的那段差距。
- 不做 RAG,MCP 客户端也只讲工具这一小片。 给大仓加检索式代码定位还空着,
mcp.py也特意没实现 resources 和 prompts。随便挑一个,都是从最小核心往你自己的更强 agent 扩的真实方向。
README 只给方向,每条的代码细节第七篇接着讲。挑一个动手,就是把它做得更好的开始。
命令
进了 REPL,/help 列全部,常用的这几个:
/model <名称>    切换模型
/compact         手动压缩上下文
/tokens          查看 token 用量和费用估算
/diff            查看本次会话改过的文件
/undo            撤销最近一次文件改动
/plan            开关计划模式(只读摸底,再交出待批准的计划)
/save  /sessions 保存 / 列出会话
/mcp             MCP 服务器状态;/mcp reconnect <名字> 拉起挂掉的一台
quit / exit      退出(Ctrl+C 取消当前回合)
会话 ID 会先清洗成安全字符再拿去当文件名,存档统统落在 ~/.corecoder/sessions 里,恶意会话名穿越不出去。undo 历史也一样落盘:快照写在 ~/.corecoder/checkpoints.json,重启之后 /undo 照样能往回撤。/tokens 的费用估算读的是内置价目表,在 ~/.corecoder/pricing.json 里写自己的价格就会盖掉对应条目,新模型、调价都不用等发版。
权限
只读工具(read_file、glob、grep、todo_write)模型一调就跑。会动手的那些(edit_file、write_file、bash,以及派生子 agent)先停下来等你点头,REPL 启动横幅里能看到当前是哪种模式:
- REPL 里每次调用问一次:允许这一次、本工具一直允许、或者拒绝。「一直允许」按工具记下,写进
~/.corecoder/permissions.json,重启也有效;子 agent 继承同一层授权,活走到哪,许可跟到哪。 - 一次性模式(
-p)没人可问,改动类调用当场被拒,拒绝理由作为普通工具结果回给模型:循环绝不会卡在等一个永远不会来的输入上。要全部预授权就加--yes(脚本、CI 场景)。 - 判断本身是
permissions.py里的纯逻辑,终端只是塞进来一个提问回调。不用 TTY 也能单测授权逻辑,或者直接搬进你自己的嵌入场景。
计划模式
REPL 里 /plan 开关计划模式。开着的时候,提示符变成 (plan),一切改动类调用(写文件、编辑、bash、MCP 工具、子 agent)当场被拒:拒绝理由作为普通工具结果回给模型,让它用只读工具继续摸底,给出一份编号计划。计划看着没问题,敲 approve(或再敲一次 /plan)就把执行权交回去,agent 接着干活。机制上就是 Agent 身上的一个开关,加授权闸前面多出来的一支拒绝分支,授权闸本身一行没动;不落盘计划文件,会话之间也不记任何东西。
钩子
在 ~/.corecoder 下放一个 hooks.json,就能让你自己的 shell 命令在每次工具调用前后跑起来,思路和 Claude Code 的 hooks 一致:
{
  "PreToolUse":  [{"matcher": "bash", "command": "cat >> ~/.corecoder/audit.jsonl"}],
  "PostToolUse": [{"matcher": "*",    "command": "cat >> ~/.corecoder/trace.jsonl"}]
}
每个钩子从 stdin 拿到这次调用的 JSON(tool_name、tool_input,post 钩子还带 tool_response)。matcher 是精确的工具名,留空或写 * 表示对所有工具生效。pre 钩子可以否决这次调用:退出码 2,它的 stderr 会作为理由回给模型,让它换条路走。post 钩子只观察,永远拦不住。钩子报错或超过十秒会被跳过并记一条警告:钩子是来帮忙的,没权力弄死循环。整个机制就是 hooks.py 一个文件,REPL 启动横幅会显示加载了几条。
两个能直接抄走的(命令里用了 jq,装一下就有):
# 1. lint 门:每次 edit/write 之后立刻对改动的文件跑快速 lint。
#    模型同一回合就能看到输出,自己把低级错误修了,不用等 CI 回来。
{
  "PostToolUse": [{
    "matcher": "edit_file",
    "command": "f=$(jq -r .tool_input.file_path); ruff check \"$f\" 2>&1 | head -20"
  }]
}

# 2. 写保护:指定路径一律不让 agent 碰。退出码 2 当场否决,
#    拒绝原因会送到模型那边。
{
  "PreToolUse": [{
    "matcher": "edit_file",
    "command": "case \"$(jq -r .tool_input.file_path)\" in .env*|*/secrets/*|*.pem) echo 'that path is off-limits' >&2; exit 2;; esac"
  }]
}
两个例子都是纯 shell;除了 JSON 形状和退出码 2 否决这两个约定,没有任何 CoreCoder 特有的语法。
MCP 服务器
在 ~/.corecoder 下放一个 mcp.json,任何 MCP 服务器的工具就能通过 stdio 接进 agent,配置形状和 Claude Code 的一样:
{
  "mcpServers": {
    "filesystem": {"command": "npx", "args": ["-y", "@modelcontextprotocol/server-filesystem", "/tmp"]}
  }
}
每个配好的服务器在启动时拉起一个子进程,握手、列出工具;每件工具都注册成 mcp__<服务器>__<工具>,钩子匹配和授权闸对它和内建工具一视同仁。MCP 工具不在只读名单里,模型要调,得先问过你。握手给十五秒,一次调用给六十秒;服务器挂了或者迟迟不应,那一次调用就以普通工具结果的形式报错,循环照常往下走。REPL 里的 /mcp 列出每台服务器的状态,/mcp reconnect <名字> 把挂掉的重新拉起:新进程、重新握手,agent 手里已有的工具不用重启就恢复可用。客户端只实现协议里工具那一小片(initialize、tools/list、tools/call),别的一概不碰,所以整块实现收在 mcp.py 一个文件里,两百四十行上下。没有 mcp.json 就没有 MCP,一切照旧。想直接跑起来的话,examples/mcp_filesystem.md 给了一个最小配置:MCP 官方的参考文件系统服务器,只暴露一个目录,照样过授权闸。
相关项目
如果你读 CoreCoder 读得还顺,下面几个我做的 agent / LLM 系统方向的工具也许用得上:
- RepoWiki — 被丢进一个陌生代码库?它给你一份带「从哪读起」路径的 wiki,一个可自托管的 DeepWiki 替代。
- FindJobs-Agent — 别再手动刷招聘网站:它按你的简历给岗位排序,还能跑模拟面试。
- ContractGuard — 签字前先把有风险的条款挑出来:它读合同、标出危险点。
- GitSense — 想给开源做贡献?它帮你找到值得做的 issue,还能估你的 PR 多大概率被合。
- CodeABC — 不会写代码也能看懂一个项目,专给小白做的。
贡献 / License
动手之前先跑一遍 pytest tests/ -q(227 个测试)、ruff check 和 compileall,绿了再提。MIT License,欢迎 fork 拿去造更好的东西,能在 README 里留一句出处就更好。
作者 何宇峰,曾任职 Moonshot AI (Kimi)。早前写过一篇相当完整的 Claude Code 源码分析,这个项目是它的动手版:那篇带你读懂,这个带你重建。
CoreCoder 原名 NanoCoder,为避免和 Nano-Collective/nanocoder 混淆而改名,旧链接会自动跳到这里。
探索相关项目
affaan-m/ECC
智能体执行与控制框架的性能优化系统。面向 Claude Code、Codex、Opencode、Cursor 等,涵盖技能、本能、记忆、安全与研究优先的开发。
297,933 星标NousResearch/hermes-agent
与你一同成长的智能体
260,920 星标multica-ai/andrej-karpathy-skills
一个用于改进 Claude Code 行为的 CLAUDE.md 文件,源自 Andrej Karpathy 对 LLM 编程陷阱的观察。
229,921 星标firecrawl/firecrawl
借助来自网络及其他来源的数据,强化你的 AI 智能体。正在构建面向超级智能的资料库。🔥
198,759 星标