
fastcrw/crw has 1,239 GitHub stars and 96 forks. GitHot measured +2 stars in 24 hours and +30 in 7 days. Last checked 2026-11-09 22:18 UTC. Last push 2026-10-31.
Fast, lightweight Firecrawl/Tavily alternative in Rust. Web scraper, crawler & search API with MCP server for AI agents. Drop-in Firecrawl-compatible API (/scrape, /crawl, /search). 2.3x faster than Tavily, 1.5x faster than Firecrawl in 1K-URL benchmarks. 6 MB RAM, single binary. Self-host or use managed cloud.
实测星标增长
- 24小时
- +2
- 7天
- +30
- 15天
- 更新延迟
- 1个月
- 更新延迟
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
README.zh-CN.md
原文
fastCRW
使用同一个引擎完成搜索、抓取、URL 发现、整站爬取和结构化提取, 将网页转换为干净的 Markdown 或结构化 JSON。
本地运行 ↓ · 使用托管 API · 文档 · English
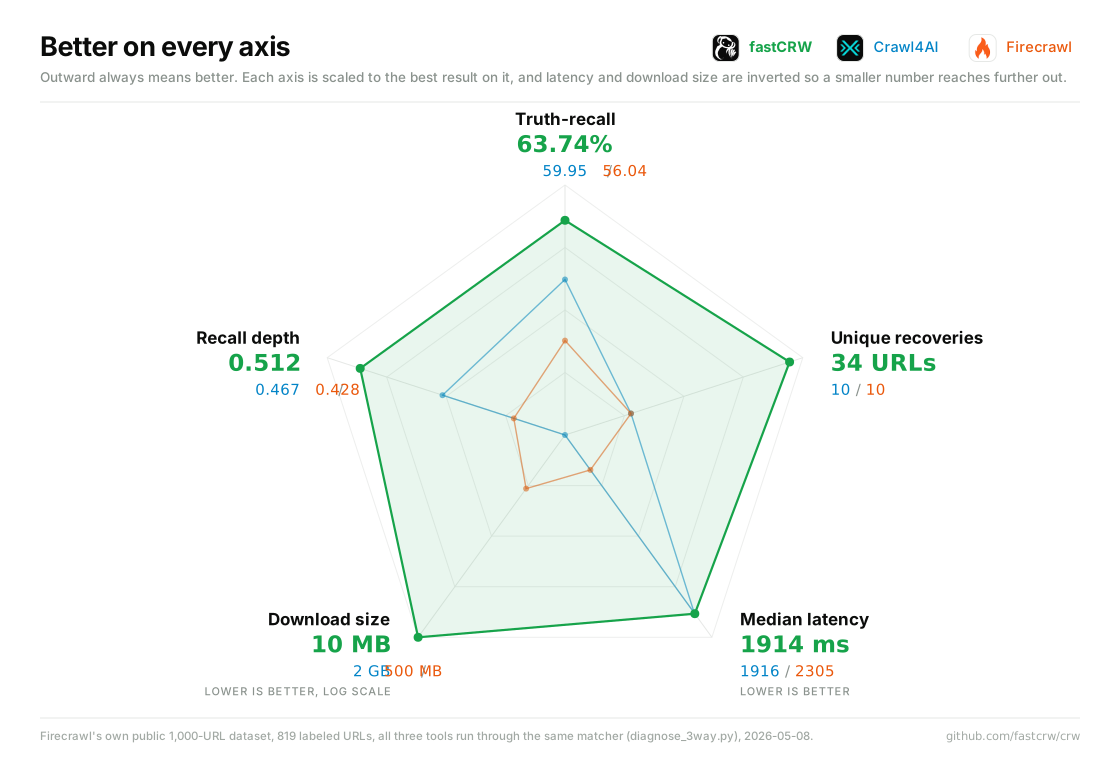
在 Firecrawl 的公开数据集上,fastCRW 的 truth-recall 为 63.74%, Crawl4AI 为 59.95%,Firecrawl 为 56.04%;p50 延迟为 1,914 ms, 空闲内存约 14 MB。完整方法和复现命令见 BENCHMARKS.md。
安装
curl -fsSL https://fastcrw.com/install | sh
安装后即可开始抓取;基础本地使用无需账号、API Key 或 setup。其他安装方式见 安装指南。
五个核心操作
| 操作 | 结果 |
|---|---|
| Scrape | 将单个 URL 转换为 Markdown、HTML、链接、截图或结构化 JSON |
| Crawl | 在设定范围内爬取网站并收集页面 |
| Map | 快速发现网站中的 URL |
| Search | 搜索网页,并按需抓取搜索结果 |
| Extract | 按 JSON Schema 从一个或多个 URL 提取字段 |
完整请求和响应格式请查看 API 参考。
选择使用方式
CLI
crw https://example.com
crw search "rust async runtime"
REST 与 SDK
请查看 REST API 参考、 Python SDK 和 Node.js SDK。
MCP / AI Agent
npx -y crw-mcp@latest install
该命令会为检测到的受支持 Agent 注册 CRW skill 和 MCP server。 未提供 API Key 时使用本地嵌入式引擎。各客户端的手动配置见 MCP 客户端文档。
可选 Setup
crw setup
仅在连接 Cloud API Key,或添加本地浏览器渲染和网页搜索时运行 setup。
只有首次使用 --summary 或 --extract 时才会询问 LLM provider。
托管与自托管
托管和自托管都提供核心引擎操作,但可用能力、计费字段及部分响应封装
可能不同。不要假设只修改 base URL 就能让所有部署完全一致;请检查
/v1/capabilities 和
响应格式指南。
部署、认证、容器及生产环境加固请查看 自托管指南。
贡献
项目需要 Rust 1.85 或更高版本:
git clone https://github.com/fastcrw/crw
cd crw
make check-fast
详细说明见 CONTRIBUTING.md。fastCRW 引擎采用 AGPL-3.0;通过网络调用托管或自托管 API 不会把该许可证应用到 你的客户端代码。
Star History
用户应自行遵守目标网站的政策。fastCRW 默认遵守 robots.txt。
探索相关项目
affaan-m/ECC
智能体执行与控制框架的性能优化系统。面向 Claude Code、Codex、Opencode、Cursor 等,涵盖技能、本能、记忆、安全与研究优先的开发。
300,715 星标NousResearch/hermes-agent
与你一同成长的智能体
262,411 星标multica-ai/andrej-karpathy-skills
一个用于改进 Claude Code 行为的 CLAUDE.md 文件,源自 Andrej Karpathy 对 LLM 编程陷阱的观察。
231,818 星标firecrawl/firecrawl
借助来自网络及其他来源的数据,强化你的 AI 智能体。正在构建面向超级智能的资料库。🔥
200,444 星标