
duixcom/Duix-Avatar
duixcom/Duix-Avatar has 16,262 GitHub stars and 2,770 forks. GitHot measured +5 stars in 24 hours. Last checked 2026-11-08 05:33 UTC. Last push 2026-04-21.
🚀 Truly open-source AI avatar(digital human) toolkit for offline video generation and digital human cloning.
实测星标增长
- 24小时
- +5
- 7天
- 更新延迟
- 15天
- 更新延迟
- 1个月
- 更新延迟
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
README_zh.md
原文Duix.Avatar 【Switch to English】
【项目介绍】
Duix.Avatar是一款支持本地部署/API调用的数字人开源项目。
仅需提交一段10秒左右的视频,即可快速完成数字人形象和声音克隆,输入文案或上传音频即可驱动数字人口型,自动生成口播播报视频。
【官方网站】
登录网站体验更多数字人能力: https://duix.com/
技术交流 & 商务合作联系邮箱: [email protected]
【NVIDIA 50系列显卡版本通知】
- 基于5090显卡测试通过
- 安装方法见Nvidia 50系列显卡服务端部署方案
【新增Ubuntu版本通知】
Ubuntu版本正式发布
- 目前已完成 Ubuntu 22.04 Desktop 版本(内核 6.8.0-52-generic)的适配验证工作。其他 Linux 版本暂未进行兼容性测试。
- 补充客户端程序界面国际化(英文)。
- 修复一些已知问题
- #304
- #292
- Ubuntu22.04 安装文档
【致开发者伙伴】
亲爱的Duix.Avatar开源社区成员:
衷心感谢各位对Duix.Avatar数字人开源项目的热情关注与积极参与!我们注意到部分开发者在本地部署环节遇到挑战,为更好地满足不同场景需求,现同步告知两项并行服务方案:
| 项目 | Duix.Avatar开源本地部署 | 数字人/克隆音API接口服务 |
|---|---|---|
| 使用方式 | 开源本地部署 | 极速克隆API服务 |
| 推荐 | 技术型用户 | 业务型用户 |
| 技术门槛 | 具备深度学习框架经验/追求深度定制化/希望参与社区共建的开发者 | 快速业务集成/专注上层应用开发/需企业级SLA保障的商用场景 |
| 硬件要求 | 需要购买GPU服务器 | 无需购买GPU服务器 |
| 定制化 | 可以根据自己的需求对代码进行修改和扩展,完全掌控软件的功能和行为 | 无法直接修改源代码,只能通过API提供的接口进行功能扩展,灵活性不如开源项目 |
| 技术支持 | 社区支持 | 动态扩容支持 + 专业技术响应团队 |
| 维护成本 | 维护成本高 | 维护简单 |
| 口形效果 | 效果可用 | 效果惊艳且更高清 |
| 商用授权 | 支持全球免费商用(用户量超过10万或年营收达1000万美元以上的企业需签署商业许可协议) | 可商用 |
| 迭代速度 | 更新慢,Bug修复依赖社区 | 最新模型/算法优先适用,问题修复快 |
我们始终秉持开源初心,API服务的推出旨在为不同需求的开发者提供更完整的解决方案矩阵。无论您选择哪种方式,都可随时通过 duix.com 获取技术支持文档。期待与各位共同推动数字人技术的普惠发展!
【Duix.Avatar数字人技术交流】
扫码加入技术交流群
【上线Coze平台】
Duix.Avatar 数字人克隆智能体和插件已成功上线至Coze 平台 ,无需复杂部署,即使是小白用户也能轻松上手直接使用。
扫码观看操作视频
【开源共创·荣耀共享】
自从我们开源了Duix.Avatar,全球极客已在代码宇宙中点亮数字分身矩阵,每个commit都在重构未来!但独乐乐不如众乐乐——现在诚邀各路大神加入「开源共创计划」,让AI创意赋能每个人,一起推动中国AI舰队驶向星辰大海!
共创内容方向
分享Duix.Avatar部署教程、优化指南、实战案例等高质量视频或文章(B站、抖音、小红书、公众号、知乎等)
开源共创特供奖励池(真金白银奉上!)
(1)基础奖励
内容获得 20-100 点赞,获评【Duix.Avatar 大师奖】及 20 元现金大师🧧

内容获得 100+ 点赞,获评【Duix.Avatar 之神奖】及 50 元现金大神🧧
(2)特殊成就:
月度MVP将解锁开源名人堂数字勋章(永久上链)
共创优秀作品展
Duix.Avatar数字人一键启动,8G显存可用,模型体积10G,不需要100G硬盘空间,不需要d盘,基于Docker单镜像
Ai数字人16-本地部署!最火爆开源数字人Duix.Avatar零基础手把手教学搭建教程,20%生成卡住解决方法,全套简化流程配套文件分享-T8 comfyui教程
最火爆免费AI数字人,Duix.Avatar V1.0.3,最新更新,一键整合包!口型效果超强,速度飞起,支持长视频、批量生成,8G显存可用!
【Duix.Avatar】一键包 windows直接运行 无需docker 开源数字人
【部署流程】
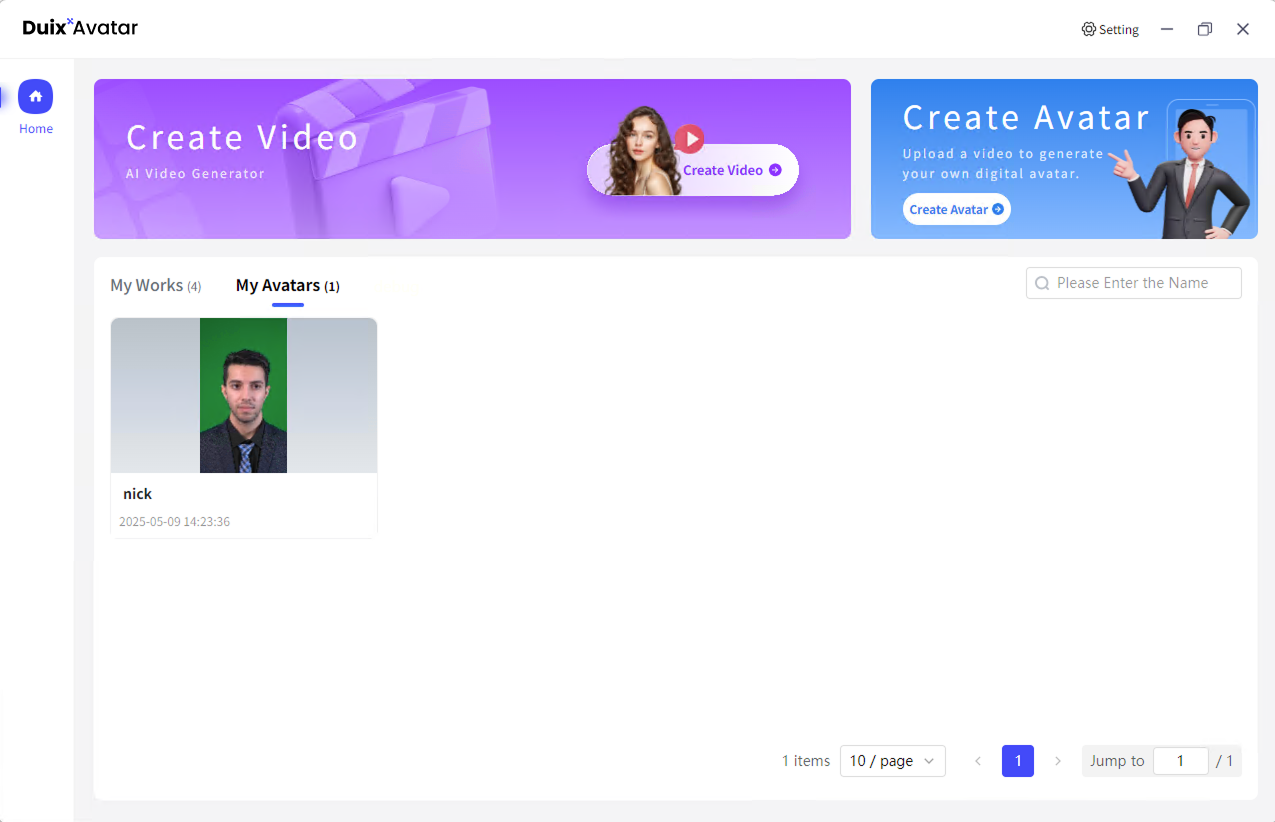
Duix.Avatar是一款专为Windows系统设计的全离线视频合成工具,它能够精确克隆您的外貌和声音,让您的形象数字化。您可以通过文字和语音驱动虚拟形象,进行视频制作。无需联网,保护隐私的同时,也能享受到便捷和高效的数字体验。
- 核心功能
- 精确外貌与声音克隆:运用先进的 AI 算法,高精度捕捉真人外貌特征,包括五官形状、面部轮廓等,构建逼真虚拟模型。同时,能精准克隆声音,捕捉并还原人声的细微特征,支持多种声音参数设置,可创造与原声高度相似的克隆效果。
- 文字和语音驱动虚拟形象:通过自然语言处理技术理解文本内容,将文字转换为自然流畅的语音,实现文字驱动虚拟形象。也可直接使用语音输入,让虚拟形象根据语音的节奏、语调等进行相应的动作和表情变化,使虚拟形象的表现更加自然、生动。
- 高效视频合成:将数字人的视频画面与声音高度同步,实现自然流畅的口型匹配,智能优化音视频同步效果。
- 多语言:脚本支持八种语言,英语、日语、韩语、中文、法语、德语、阿拉伯语和西班牙语。
- 显著优势
- 全离线操作:无需联网即可使用,有效保护用户隐私,让用户在安全、独立的环境中进行创作,避免数据在网络传输过程中可能存在的泄露风险。
- 简单易用:操作界面简洁直观,即使是没有任何技术背景的小白也能轻松上手,快速掌握软件的使用方法,轻松开启数字人创作之旅。
- 多模型支持:支持导入多个模型,并通过一键启动包进行管理,方便用户根据不同的创作需求和应用场景选择合适的模型。
- 技术支持
- 声音克隆技术:利用人工智能等先进技术,根据给定的声音样本生成与之相似或相同声音的技术,涵盖语音中的语境、语调、语速等。
- 自动语音识别:一种能将人类语音中的词汇内容转换为计算机可读输入,也就是转换为文本格式的技术,让计算机能够 “听懂” 人们说的话。
- 计算机视觉技术:用于视频合成中的视觉处理,包括面部识别、口型分析等,确保虚拟形象的口型与声音和文字内容相匹配。
依赖
- Nodejs 18
- Docker Image
- docker pull guiji2025/fun-asr
- docker pull guiji2025/fish-speech-ziming
- docker pull guiji2025/duix.avatar
Windows 安装
前置条件
必须有 D 盘:主要用于后续数字人、作品等数据存储
- 空闲空间要求:大于30G
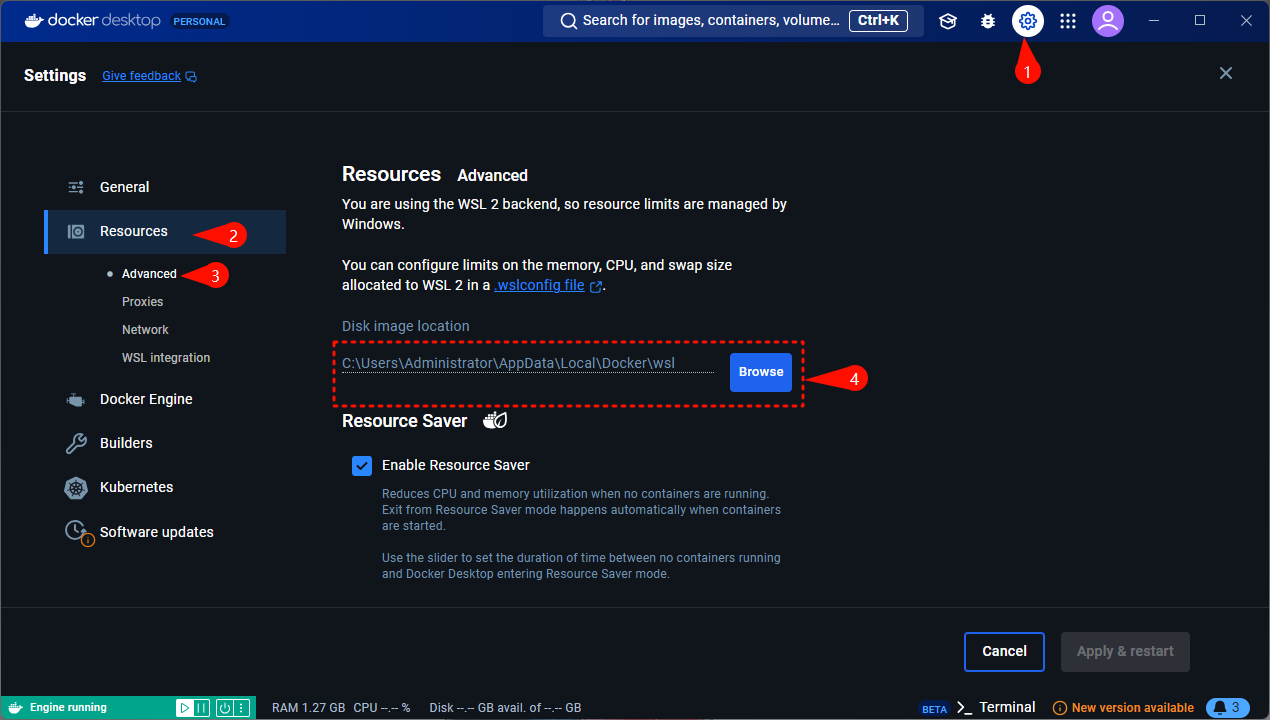
C 盘:用于存储服务镜像文件
空闲空间要求:大于 100G
如果不足 100G,可以在安装完成docker后,在下图的位置重新选一个剩余空间大于 100G 的磁盘文件夹。
系统要求:
- 目前支持 Windows 10 19042.1526 或更高版本
推荐配置:
- CPU:第13代英特尔酷睿 i5-13400F
- 内存:32G及以上(必要)
- 显卡:rtx-4070
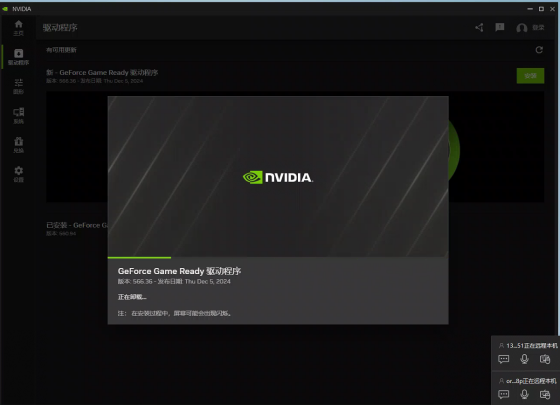
确保有英伟达显卡,并正确安装显卡驱动(必要)
英伟达驱动下载地址 https://www.nvidia.cn/drivers/lookup/
安装 Windows Docker
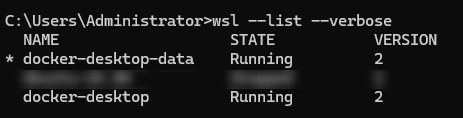
用wsl --list --verbose命令可以查看本机有没有安装过wsl,如下图就是已经安装过,无需再安装
- 安装wsl的命令:
wsl --install- 由于网络原因,可能失败,多试几次
- 安装过程中需要设置新的用户名和密码,设置并记住
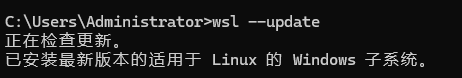
用wsl --update更新wsl。
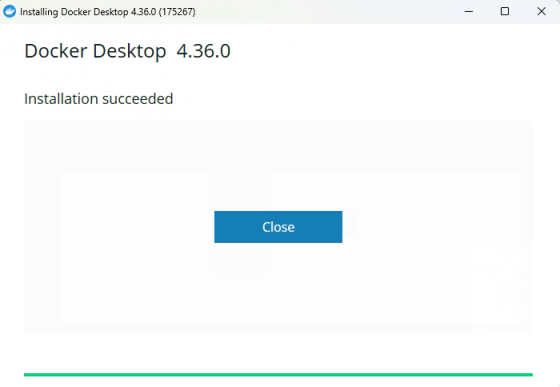
下载 Docker Windows 版,根据机器 CPU 架构选择不同的安装包。
出现这个界面表示安装成功。
运行 Docker
首次运行接受协议和跳过登录
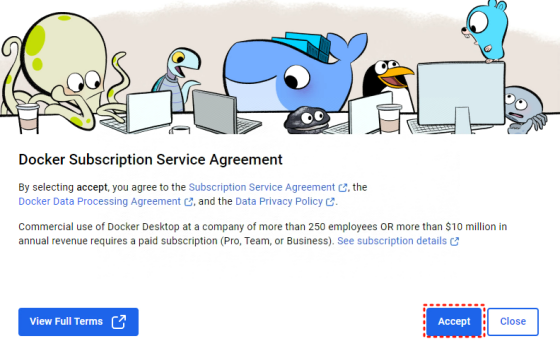
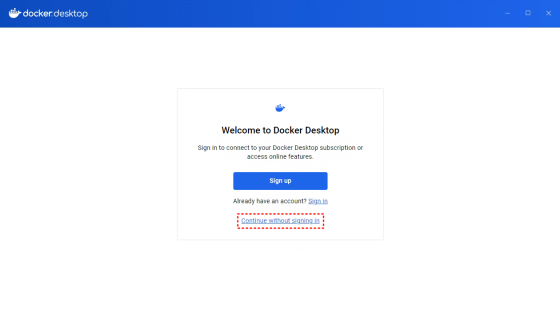
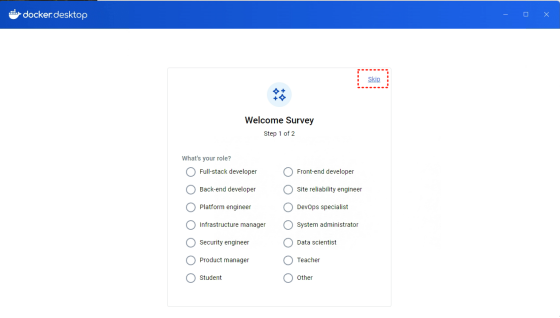
安装服务端
采用Docker方式安装,docker-compose如下:
docker-compose.yml文件在/deploy目录下。在
/deploy目录执行docker-compose up -d,如果您想使用lite版本,请执行docker-compose -f docker-compose-lite.yml up -d耐心等待一段时间(半小时左右,速度取决于网速),下载会消耗70G左右流量,注意连WIFI
看到Dokcer 中出现三个服务,表示成功了(lite版本只有一个服务
Duix.Avatar-gen-video)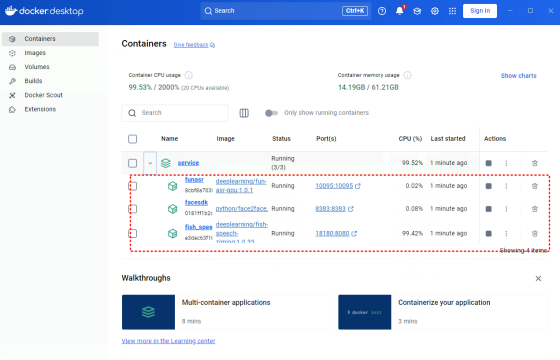
Nvidia 50系列显卡服务端部署方案
针对50系列显卡(经测试30,40系列cuda12.8用户也可以采用这个方案) 使用了torch官方的预览版本
cd /deploy
docker-compose -f docker-compose-5090.yml up -d
客户端
- 直接下载官方构建的安装包
- 双击
Duix.Avatar-x.x.x-setup.exe即可安装
Ubuntu22.04 安装
推荐配置
- CPU:第13代英特尔酷睿 i5-13400F
- 内存:32G及以上(必要)
- 显卡:rtx-4070(确保有英伟达显卡,并正确安装显卡驱动)
- 硬盘:空闲空间大于 100G
安装 Docker
先用
docker --version检查是否安装了docker,如果安装了,则跳过以下步骤
sudo apt update
sudo apt install docker.io
sudo apt install docker-compose
安装显卡驱动
参考官方文档安装显卡驱动https://www.nvidia.cn/drivers/lookup/
安装后执行
nvidia-smi命令,如果显示显卡信息,则安装成功安装 NVIDIA Container Toolkit
NVIDIA Container Toolkit 是 Docker 使用 NVIDIA GPU 的必要工具。安装步骤如下:
- 添加 NVIDIA 包仓库:
distribution=$(. /etc/os-release;echo $ID$VERSION_ID) \ && curl -s -L https://nvidia.github.io/libnvidia-container/gpgkey | sudo apt-key add - \ && curl -s -L https://nvidia.github.io/libnvidia-container/$distribution/libnvidia-container.list | sudo tee /etc/apt/sources.list.d/nvidia-container-toolkit.list - 更新包列表并安装工具包:
sudo apt-get update sudo apt-get install -y nvidia-container-toolkit - 配置 Docker 使用 NVIDIA 运行时:
sudo nvidia-ctk runtime configure --runtime=docker - 重启 Docker 服务:
sudo systemctl restart docker
- 添加 NVIDIA 包仓库:
安装服务端
cd /deploy
docker-compose -f docker-compose-linux.yml up -d
与windows上拉镜像一样,如果下载太慢,需要指定国内镜像源方法是在
/etc/docker/daemon.json文件中添加:{ "registry-mirrors": [ "https://hub.fast360.xyz", "https://hub.littlediary.cn", "https://docker.kejilion.pro", "https://docker.1panelproxy.com" ] }上面四个镜像源,随着时间推移,可能会有变化,请自行搜索最新的镜像源
客户端
- 直接下载官方构建的安装包的Linux版本
- 双击
Duix.Avatar-x.x.x.AppImage即可启动,无需安装
提醒:在Ubuntu系统中,如果您使用
root用户进入桌面,直接双击Duix.Avatar-x.x.x.AppImage可能运行不了,需要在命令行终端中执行./Duix.Avatar-x.x.x.AppImage --no-sandbox,加上--no-sandbox参数即可。
开放 API
我们开放了模特训练和视频合成的API,Docker 启动后会在本地暴露几个端口,通过http://127.0.0.1可以调用。
具体代码可以参考
- src/main/service/model.js
- src/main/service/video.js
- src/main/service/voice.js
模特训练
- 将视频分离为静音视频 + 音频
- 音频放到
D:\duix_avatar_data\voice\data下D:\duix_avatar_data\voice\data是与guiji2025/fish-speech-ziming服务约定的,可以在docker-compose中修改 - 调用
http://127.0.0.1:18180/v1/preprocess_and_tran接口参数示例:
{
  "format": ".wav",
  "reference_audio": "xxxxxx/xxxxx.wav",
  "lang": "zh"
}
返回示例:
{
  "asr_format_audio_url": "xxxx/x/xxx/xxx.wav",
  "reference_audio_text": "xxxxxxxxxxxx"
}
记录下返回结果后续音频合成需要用到
音频合成
接口:http://127.0.0.1:18180/v1/invoke
// 请求参数
{
  "speaker": "{uuid}", // 一个UUID保持唯一即可
  "text": "xxxxxxxxxx", // 需要合成的文本内容
  "format": "wav", // 固定传参
  "topP": 0.7, // 固定传参
  "max_new_tokens": 1024, // 固定传参
  "chunk_length": 100, // 固定传参
  "repetition_penalty": 1.2, // 固定传
  "temperature": 0.7, // 固定传参
  "need_asr": false, // 固定传参
  "streaming": false, // 固定传参
  "is_fixed_seed": 0, // 固定传参
  "is_norm": 0, // 固定传参
  "reference_audio": "{voice.asr_format_audio_url}", // 上一步“模特训练”的返回值
  "reference_text": "{voice.reference_audio_text}" // 上一步“模特训练”的返回值
}
视频合成
合成接口:
http://127.0.0.1:8383/easy/submit// 请求参数 { "audio_url": "{audioPath}", // 音频路径 "video_url": "{videoPath}", // 视频路径 "code": "{uuid}", // 唯一key "chaofen": 0, // 固定值 "watermark_switch": 0, // 固定值 "pn": 1 // 固定值 }进度查询:
http://127.0.0.1:8383/easy/query?code=${taskCode}get 请求,参数
taskCode是上面合成接口入参中的code
常见问题
提问前自查步骤
三个服务是否都是Running状态
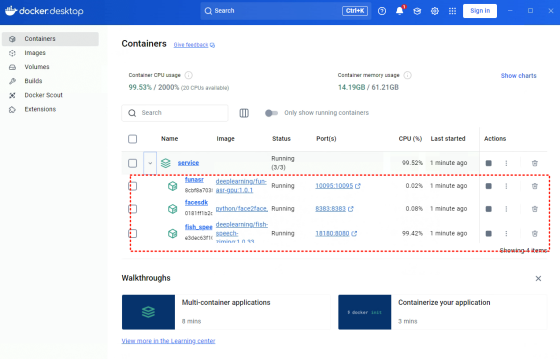
确认机器上是有英伟达显卡且正确安装了驱动程序。
本项目所有算力都在本地,没有英伟达显卡或没有驱动程序,以上三个服务是启动不了的。
确保服务端和客户端都更新到了最新版本,项目刚开源,社区很活跃,更新也比较频繁,说不定你的问题已经在新版中解决了。
- 服务端:到
/deploy目录下重新执行docker-compose up -d - 客户端:
pull代码后重新build
- 服务端:到
GitHub Issuse持续更新,每天都在解决和关闭问题单,经常看看,也许你的问题已经解决了。
提问模板
问题描述
详细描述一下复现步骤,如有截图最好。
提供报错日志
客户端日志获取方式
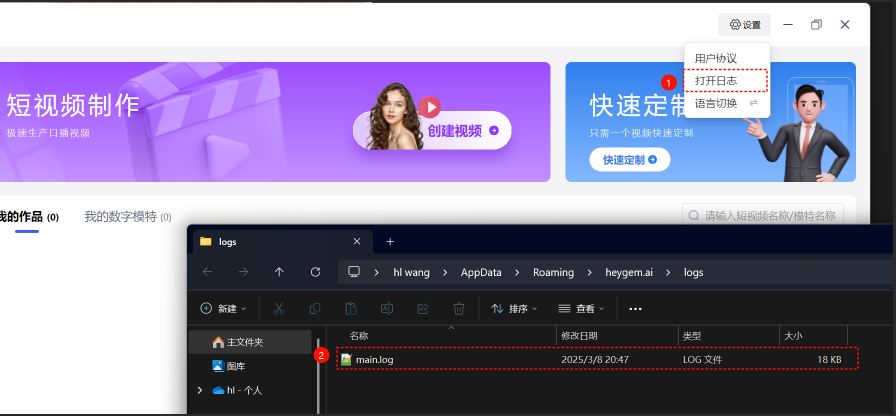
服务端日志
找到关键位置,或点开我们的三个Docker服务,如下图操作“复制”。
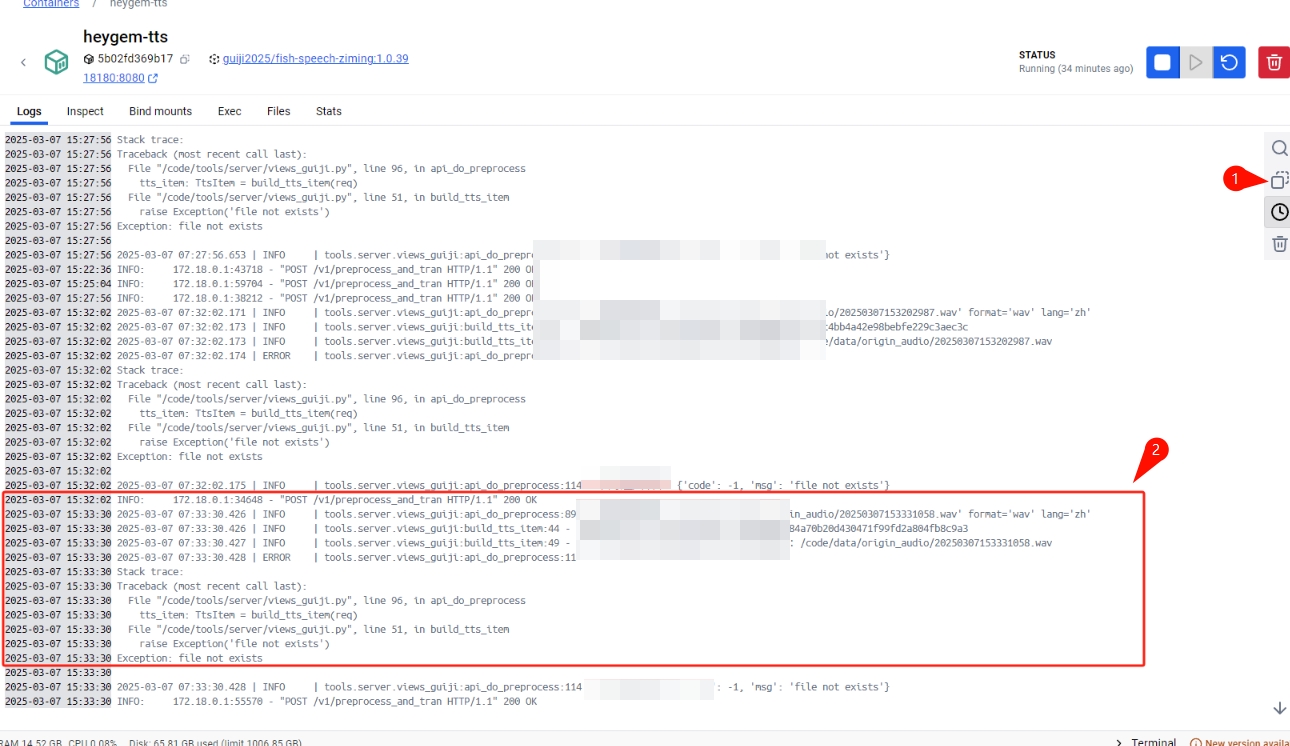
联系我们
技术交流 & 商务合作联系邮箱: [email protected]
协议
致谢
- ASR 基于 fun-asr
- TTS 基于 fish-speech-ziming