
blackwell-systems/gcf has 61 GitHub stars and 3 forks. GitHot measured 0 stars in 24 hours and 0 in 7 days. Last checked 2026-11-15 20:15 UTC. Last push 2026-11-07.
实测星标增长
- 24小时
- 0
- 7天
- 0
- 15天
- 更新延迟
- 1个月
- 更新延迟
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
关于
The AI-native wire format for structured data. 100% comprehension on every frontier model. 50-92% fewer tokens than JSON. 43B+ lossless round-trips across 17 formats. Spec v3.5.1 Stable.
人工智能docs/i18n/README.zh-CN.md
原文English · 简体中文 · Русский · हिन्दी · العربية


面向结构化数据的 AI 原生传输格式。为智能体循环而生。
[!IMPORTANT] 由原创注意力研究逆向推导而来。 Dayna Blackwell 撰写的四篇论文(2026 年,审稿中):
- GCF: A Token-Optimized Wire Format for Structured LLM Interactions
- Tokenizer-Attention Coupling: How BPE Merge Decisions Permanently Shape Transformer Internal Organization
- Stranded Attention: BPE Tokenization Permanently Constrains Transformer Structural Capacity
- Developmental Atlas of Attention Head Specialization: Spacing, Stranding, and the Capacity Tax of BPE Tokenization

GCF 为智能体循环而构建,在这种循环中同一份结构化上下文会一轮又一轮地穿越模型边界。 单个载荷就已经比 JSON 小 50-92%。但 GCF 还会跨轮次对重复结构去重,仅在上下文变化时发送增量,因此到第 5 次重叠调用时,每个响应比等价的 JSON 少花 99% 的 token,而一次完整的 10 次调用会话比每轮都重新发送 JSON 便宜 94.4%。会话去重与增量都需要本地 ID 和多轮设计:JSON 和 TOON 都完全做不到这一点。
- 在每个前沿模型上都实现 100% 理解率,无需任何训练。在结构复杂的代码图上达到 91.2%,而 TOON 跌至 68.8%,JSON 跌至 54.1%。
- 已证明无损。 对每一个结构化值都满足
decode(encode(value)) == value,在 5 种格式和 6 种语言上经过 43,000,000,000+ 次往返验证,并在 17 种序列化格式之间验证了互操作性。零运行时依赖,所有七个 SDK 皆然。 - 一套编解码器通吃所有格式。 将 JSON、YAML、TOML、CSV 或 MessagePack 编码为 GCF;模型无需任何格式说明即可原生读取;
decode()可将其转换回其中任意一种。你现有的 schema 和校验器在解码后的输出上照常工作,无需改动。
没有其他单一格式能同时具备这四点:免 schema(无需 .proto)、无损、token 紧凑(相对 JSON 节省 50-92%),以及零训练即可被模型读取。JSON 冗长,Protobuf 需要 schema,MessagePack 是二进制,而 TOON 会悄然损坏数据(7.54% 的往返失败率,每 1000 万次产生 176,487 次静默损坏),并在结构化数据上崩溃(68.8% 的理解率,而 GCF 保持 91.2%、JSON 为 54.1%)。GCF 是在分词器层面设计的:它的竖线分隔符与字段名的合并率为 0%,而 JSON 的语法符号和 TOON 的制表符在 BPE 分词器中被硬编码为已合并的词表条目(TOON 的制表符在 32.91% 的边界上与相邻内容合并,是所有常见分隔符中最差的,JSON 的引号则为 8.17%),从而制造出模型无法恢复的结构边界。
pip install gcf-python                    # Python
npm install @blackwell-systems/gcf        # TypeScript
go get github.com/blackwell-systems/gcf-go  # Go
cargo add gcf                             # Rust
dotnet add package BlackwellSystems.Gcf   # .NET
或者零代码改动地包装任意现有 MCP server:
pip install gcf-proxy
基准测试
跨 11 个模型、4 家供应商、50+ 次独立测试运行的 2,500+ 次 LLM 评估。
| 通用画像(500 条订单) | 图画像(500 个符号) | |
|---|---|---|
| GCF | 每个前沿模型上均达 100% | 91.2%(10 个模型) |
| TOON | 一贯是最弱的格式 | 68.8% |
| JSON | GCF 平均值在每个模型上 >= JSON | 54.1% |
| GCF | TOON | JSON | |
|---|---|---|---|
| Token 效率(16 个数据集) | 15/16 胜出 | 1/16 胜出 | 0/16 胜出 |
| 生成(28 次运行,11 个模型) | 5/5 | 1.0/5 | 5.0/5 |
| Token 节省 | 相对 JSON 50-92% | 相对 JSON 30-60% | 基准 |
| 43,000,000,000+ 次往返 | 0 次失败 |
完整结果:gcformat.com/guide/benchmarks
编码任意结构化数据(通用画像)
from gcf import encode_generic

output = encode_generic({
    "employees": [
        {"id": 1, "name": "Alice", "department": "Engineering", "salary": 95000},
        {"id": 2, "name": "Bob", "department": "Sales", "salary": 72000},
        {"id": 3, "name": "Carol", "department": "Marketing", "salary": 85000},
    ],
})
GCF profile=generic
## employees [3]{id,name,department,salary}
1|Alice|Engineering|95000
2|Bob|Sales|72000
3|Carol|Marketing|85000
一个表头声明字段名。行只是按位置排列的值。每条记录都不重复字段名。无损:对每一个结构化值都满足 decode(encode(value)) == value,在 5 种格式和 6 种语言上经过 43,000,000,000+ 次随机往返验证。
图画像(代码智能、知识图谱、MCP 工具)
面向包含节点、边和距离分组的数据:
from gcf import encode, Payload, Symbol, Edge

output = encode(Payload(
    tool="context_for_task", token_budget=5000, tokens_used=1847,
    symbols=[
        Symbol(qualified_name="github.com/org/repo/pkg.AuthMiddleware", kind="function", score=0.78, provenance="lsp_resolved", distance=0),
        Symbol(qualified_name="github.com/org/repo/pkg.NewServer", kind="function", score=0.54, provenance="lsp_resolved", distance=1),
    ],
    edges=[Edge(source="github.com/org/repo/pkg.NewServer", target="github.com/org/repo/pkg.AuthMiddleware", edge_type="calls")],
))
GCF profile=graph tool=context_for_task budget=5000 tokens=1847 symbols=2 edges=1
## targets
@0 fn github.com/org/repo/pkg.AuthMiddleware 0.78 lsp_resolved
## related
@1 fn github.com/org/repo/pkg.NewServer 0.54 lsp_resolved
## edges [1]
@0<@1 calls
本地 ID(@0、@1)在边中取代完整名称。81 个 token,而 JSON 需要 191 个。
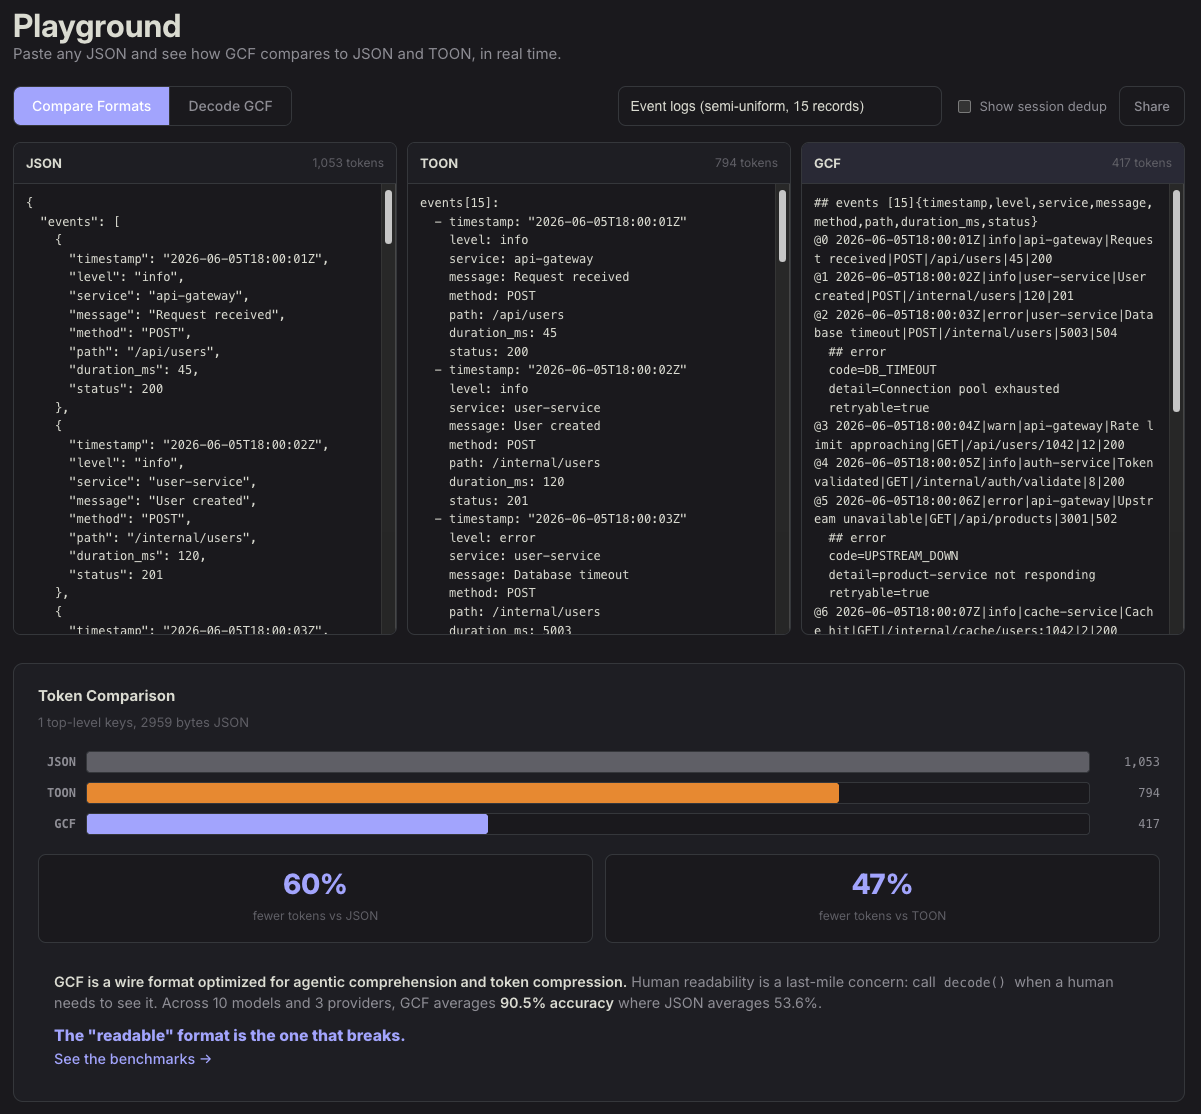
在 playground 中实时试用,进行实时多格式对比。粘贴 JSON、YAML 或 TOML。可从 JSON、YAML、TOML、CSV 和 MessagePack 编码,并解码回这些格式。
工作原理
通用画像
无损结构化数据编码。数组、嵌套对象、混合类型、原语、根标量。适用于任何可反序列化为对象和数组的数据,无论其源格式为何。
- 对象数组。
## name [count]{field1,field2}一次性声明字段名。行是竖线分隔的值。缺失字段用~,null 用-。 - 嵌套对象。 固定形状的嵌套对象被扁平化为
>路径列:"customer>name"成为一列,值直接放入行中。在深度嵌套的 API 数据上减少 20-48% 的 token。可变长度数组和不规则形状使用^附着回退方案。 - 原语数组。 内联:
tags[2]: admin,user。含逗号的字符串加引号。 - 标量。 顶层用
key=value。与类型化字面量冲突的字符串("true"、"123"、"-")会自动加引号。 - 根值。 文档根部的对象、数组和标量。每个 JSON 值都有对应的 GCF 表示。
图画像
- 按位置字段。 一个表头声明字段名。行只是值。
- 本地 ID。
@0、@1。边通过 ID 引用,而不重复完整标识符。 - 层级分组。 分节表头(
## targets、## related)取代每条记录的元数据。
两种画像共享同一套语法(通用标量语法、键语法、表头格式)。节省是结构性的,并随载荷大小增长。
流式传输
无需缓冲即可增量发出载荷,适用于数据库游标、分页,以及大到无法在内存中容纳的图遍历。
- 延迟计数。 当尺寸尚未可知时,表头发出
[?](## edges [?]),行随生成随流出。 - 摘要尾部。 收尾的
##! summary symbols=8 edges=6 counts=2,1,3在流结束后回填真实计数,使模型仍能获得精确总数。 - O(1) 内存。 编码器一次只持有一行;一个 10,000 行的游标以常量内存流式传输,而非将整个响应物化。
TOON 的表格式表头要求先给出行数,因此必须在输出第一个字节前缓冲整个数组;GCF 则延迟计数并在最后填补。
它会越用越便宜
会话去重: 在先前响应中发送过的符号会变为裸引用(@7 = 2 个 token,而完整声明需 19 个)。在生产规模(500 个符号)下,仅会话去重就在第 5 次调用时削减 86.3%;与增量结合后,每次调用达 99.0%。一次 10 次调用的会话相对 JSON 累计节省 94.4%(每个响应花 171 个 token,而 JSON 为 29,072 个)。
增量编码: 当查询之间上下文略有变化时,只发送差异。在重复查询上额外节省 81.2%。
没有其他格式具备这些能力。它们在多轮智能体交互中会不断累加复利。
研究
GCF 并非靠反复试错调出来的。它的语法是从注意力层面的研究中逆向推导而来,该研究探讨 BPE 分词如何塑造 transformer 能够表示的内容,随后通过受控的从零训练加以事后验证。
其机理:分词器的合并决策会永久性地约束模型的内部组织。被 BPE 折叠进周围文本的语法符号(JSON 的引号和大括号、TOON 的制表符)制造出模型无法干净恢复的结构边界;而一个与字段名合并率为 0% 的分隔符(GCF 的竖线)则不会。该设计源自这一测量,而非源自 token 计数。
Dayna Blackwell 撰写的四篇论文(2026 年,当前审稿中)确立了这一点:GCF 格式论文、Tokenizer-Attention Coupling、Stranded Attention 以及 Developmental Atlas of Attention Head Specialization。这些效应是从注意力结构以及 1.3B 规模的受控训练中,以内在且因果的方式测得的,而非由 LLM 评判打分,因此不能被搪塞为「基准测试只是在衡量训练暴露度」:GCF 在从未见过它的模型上依然胜出。
在 Tokenizer Analysis 和白皮书中阅读完整论证。
实现
| 语言 | 包 | 仓库 |
|---|---|---|
| Go | go get github.com/blackwell-systems/gcf-go |
gcf-go |
| TypeScript | npm install @blackwell-systems/gcf |
gcf-typescript |
| Python | pip install gcf-python |
gcf-python |
| Rust | cargo add gcf |
gcf-rust |
| Swift | Swift Package Manager | gcf-swift |
| Kotlin | JitPack | gcf-kotlin |
| .NET | dotnet add package BlackwellSystems.Gcf |
gcf-dotnet |
| MCP Proxy | pip install gcf-proxy |
gcf-proxy(双向、会话去重、HTTP 前端) |
| Claude Code Plugin | /plugin install |
gcf-claude-plugin(一条命令安装、会话统计钩子) |
| Codex Plugin | codex plugin add |
gcf-codex-plugin(一条命令安装、会话统计钩子) |
| VS Code | ext install blackwell-systems.gcf-vscode |
gcf-vscode(语法高亮) |
| n8n | npm install n8n-nodes-gcf |
gcf-n8n-nodes(工作流编码/解码) |
| JetBrains | 在 Plugins 中搜索 "GCF" | gcf-jetbrains(IntelliJ、PyCharm、WebStorm、GoLand) |
| Zed | 在 Extensions 中搜索 "GCF" | gcf-zed(tree-sitter 语法高亮) |
| Tree-sitter | npm install tree-sitter-gcf |
tree-sitter-gcf |
零运行时依赖。永久如此。 所有七个实现都只依赖各自语言的标准库。无传递依赖。无供应链风险。这是一项永久承诺:GCF 永远不会引入外部运行时依赖。采用 Apache-2.0 许可。所有实现都同时支持通用画像(encodeGeneric)和图画像(encode)。最初的六个语言 SDK 均内置 CLI。通过 tree-sitter 提供语法高亮(Neovim、Helix、Zed)。
规范: SPEC v3.5.1 Stable,含 265 个一致性测试夹具,在 5 种格式和 6 种语言上验证了 43,000,000,000+ 次无损往返。七个实现(Go v1.6.2、Swift v2.6.1、.NET v0.1.0,其余为 v2.5.2)。已验证跨语言一致性。
文档
- Getting Started
- Benchmarks
- Benchmarks (Full Data)
- GCF vs TOON
- Schema Validation
- FAQ
- Tokenizer Analysis(为何 JSON 的语法在 BPE 层面崩坏)
- GCF on Small Models(理解率差距究竟出现在哪里:廉价、本地、开放权重的模型)
- Playground
- Specification
采用者
| 项目 | |
|---|---|
| Chrome DevTools MCP | 47K★ · Google Chrome DevTools 团队的 MCP server;向 AI 编码智能体暴露实时浏览器状态(DOM、网络、控制台、性能) |
| Speakeasy | OpenAPI 工具链(客户包括 Google、Verizon、Mistral AI、DocuSign、Vercel);GCF 是其 oq CLI 中的原生输出格式 |
| OmniRoute | 17K★ · AI 客户端与模型供应商之间的 AI 网关、注册表和代理;GCF 已内联至其压缩引擎 |
| NetClaw | 610★ · AI 驱动的网络自动化(113 项技能、66 个 MCP 集成);在每个 MCP server 上都以 GCF 取代了 TOON |
| ctx | 552★ · Claude Code 的实时上下文选择器;从一个 103K 节点的知识图谱中仅呈现相关工具 |
| Lynkr | 531★ · 面向 AI 编码客户端的本地 LLM 网关;将 GCF 作为可直接替换的工具结果压缩器,与 TOON 并列 |
| Open Data Products SDK | Linux Foundation · 面向数据产品标准的 Python 工具包和 MCP server;GCF 作为智能体上下文的边车 |
| NeuroNest | 智能体优先的 IDE;首个商用 GCF 采用者,横跨四个编码面,配合会话去重与增量 |
| Raycast | Raycast Store 中的 JSON-to-GCF Converter 扩展,面向 macOS 生产力启动器 |
使用场景
- MCP 工具响应。 任何返回结构化数据的 MCP server。减少 50-92% 的 token,理解准确率达 100%。
- 智能体间通信。 每次交接减少 63% 的 token。在每个前沿模型上生成有效性达 5/5。
- LLM 结构化输出。 LLM 只需 3 行引导即可生成有效的 GCF。无需训练。
- 代码智能。 图画像,配合本地 ID、边和距离分组。
- 多格式互操作。 在 17 种序列化格式(JSON、XML、MessagePack、YAML、BSON、TOML、CBOR、Protobuf、CSV、JSON5、Avro、Arrow、Parquet、Pickle、INI、NDJSON、Plist)之间验证无损。
许可
Apache-2.0 - Dayna Blackwell