
arcships/light-ocr
arcships/light-ocr has 660 GitHub stars and 59 forks. GitHot measured +6 in 7 days. Last checked 2026-11-10 23:08 UTC. Last push 2026-10-08.
Fast, offline OCR for Node.js & C++. PP-OCRv6 with Core ML / WebGPU hardware acceleration — recognize text in images with confidence scores & coordinates. npm: @arcships/light-ocr
实测星标增长
- 24小时
- 更新延迟
- 7天
- +6
- 15天
- 正在收集历史
- 1个月
- 正在收集历史
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
README.zh-CN.md
原文light-ocr



English | 简体中文
面向 Node.js 与 C++ 的快速离线 OCR。
直接在本机识别 PDF、JPEG、PNG 或像素数据,返回按阅读顺序排列的 文字、置信度和四边形坐标。Node.js 用户安装的 npm 包内置 PP-OCRv6 Small 模型、PDFium、中文 fallback 字体,以及 macOS、Linux 和 Windows 的预编译组件;安装后或首次运行时无需二次下载。
| 适合场景 | Node.js 应用、CLI、桌面软件与原生 C++ 集成中的本地 OCR |
| 输入 | JPEG、PNG、PDF、编码后的字节或解码后的像素 |
| 输出 | 文字、置信度、四边形坐标、页面元数据与耗时 |
| 分发方式 | 一次 npm 安装;同时提供 CommonJS、ESM、TypeScript 与八个平台预编译包 |
快速开始
支持 Node.js 22 及以上;22/24 LTS 为 Tier 1 完整测试版本,Node-API 稳定 ABI 保证更新的 Node 版本无需等待库发版即可加载同一份预编译产物。
npm install @arcships/light-ocr
import { createEngine } from "@arcships/light-ocr";
import { readFile } from "node:fs/promises";

const engine = await createEngine();

try {
  const result = await engine.recognizeEncoded(
    await readFile("image.jpg"),
  );

  for (const line of result.lines) {
    console.log(line.text, line.confidence, line.box);
  }
} finally {
  await engine.close();
}
createEngine() 会根据当前平台自动选择合适的执行方式。如果应用已经
完成图片解码,recognize()
也可以直接接收 GRAY8、RGB8、BGR8 和 RGBA8 像素数据。
PDF 页面使用同一个包:
import { recognizeDocument } from "@arcships/light-ocr";

for await (const page of recognizeDocument("report.pdf", { dpi: 200 })) {
  console.log(page.index, page.lines.map((line) => line.text));
}
CommonJS 可以通过 require("@arcships/light-ocr") 使用同一组导出。
CLI
安装后即可使用 light-ocr 命令,无需额外配置:
# 识别文字 + 坐标
light-ocr image.png --format json

# 只要文字
light-ocr image.png --format text

# PDF;渲染器已经包含在 npm 安装产物中
light-ocr report.pdf --pages 1-10 --format text

# 只检测文字区域(不识别)
light-ocr detect image.png

# 区域识别
light-ocr recognize image.png --region 100,80,640,320 --format json

# 引擎信息
light-ocr info --version

# 系统诊断(硬件与加速器)
light-ocr doctor --json
图片命令包括 recognize(默认)、detect(只检测框)、info(版本诊断)和
doctor(系统诊断)。传入 .pdf 路径会直接进入文档 OCR;显式
document 命令用于多输入任务。输出遵循版本化的 schemaVersion: 1
契约,EXIF 方向自动修正。完整参考见 CLI 设计 和
npm package README。
PDF 和多页文档
PDF 和多页 OCR 已直接内置于 @arcships/light-ocr。匹配当前平台的
PDFium 二进制、校验锁定的 Noto Sans SC fallback 字体与 OCR
原生运行时位于同一个平台 npm 包中。引用常见非嵌入中文字体的 PDF
可在 OCR 前正确渲染;没有 postinstall 脚本、运行时下载、系统字体
要求、编译器要求,也不需要另装文档包。
# 单个 PDF,默认 150 DPI
light-ocr report.pdf

# 指定页码范围,流式 JSONL 输出
light-ocr report.pdf --pages 1-10 --format jsonl

# 多张图片作为一个文档
light-ocr document scan1.png scan2.png scan3.png --format text
编程 API:
import { recognizeDocument } from "@arcships/light-ocr";

// 从 PDF 流式获取页面
for await (const page of recognizeDocument("report.pdf", { dpi: 200 })) {
  console.log(page.index, page.lines.length, page.source.kind);
}

// 多张图片
for await (const page of recognizeDocument([buf1, buf2, buf3])) {
  console.log(page.index, page.lines);
}
主要能力
- **本地处理。**图片、PDF 和 OCR 结果始终留在本机。
- **只需安装一个包。**模型、OCR 运行时、PDF 渲染器和中文 fallback 字体会通过 npm 的当前平台依赖一起安装。
- **没有二次下载。**安装和运行都不需要 postinstall 拉取、编译器、模型下载、PDF 引擎下载或字体下载。
- **直接得到可用结果。**每一行都包含识别文字、置信度和原图位置。
- **默认使用硬件加速。**Auto 在 macOS 15+ Apple Silicon 上优先使用 Core ML,在下表的 Linux 和 Windows 版本中优先使用 WebGPU。
- **适合应用内调用。**识别任务在 JavaScript 主线程之外执行,并支持队列、取消和明确释放资源。
- **识别大图中的小字。**可选的
tiled模式可以保留高分辨率图片中的小字和密集文字。
**macOS 重新签名。**下游 macOS 打包方可以用自己的 Developer ID(或 ad-hoc)身份重新签名原生二进制,例如在公证分发的应用时。加载器在 macOS 上接受重新签名过的 Mach-O,前提是其代码签名校验通过且签名身份与宿主应用一致(TeamIdentifier 相同,或双方均为 ad-hoc 签名);其他平台与未经签名的篡改仍保持严格的字节数 + SHA-256 校验。
⭐ 觉得 light-ocr 有用? 点个 Star,让更多人发现这个项目!
平台加速
npm 包提供以下八个平台版本。默认的 createEngine() 使用 Auto 模式:
| 平台 | Auto 模式 |
|---|---|
| macOS / Apple Silicon | macOS 15+ 优先使用 Core ML,然后使用 CPU |
| macOS / Intel | CPU |
| Linux x64 glibc | 通过 Vulkan 使用 WebGPU,然后使用 CPU |
| Linux arm64 glibc | CPU |
| Linux x64 musl(Alpine) | CPU |
| Linux arm64 musl(Alpine) | CPU |
| Windows x64 | 通过 D3D12 使用 WebGPU,然后使用 CPU |
| Windows arm64 | CPU |
需要明确控制时,可以通过
execution 选项
选择 auto、cpu、apple 或 webgpu。
模型档位
Small 继续作为稳定默认。Tiny 和 Medium 是 next tag 下的可选 preview
包。三档使用完全相同的 API、类型、结果 schema 和错误模型,每次安装
只携带所选的一份模型。
| 档位 | Package / 命令 | 模型 payload | 状态 |
|---|---|---|---|
| Small | @arcships/light-ocr / light-ocr |
约 30 MB | 稳定默认 |
| Tiny | @arcships/light-ocr-tiny@next / light-ocr-tiny |
约 6.3 MB | Preview;49 种语言,不含日语 |
| Medium | @arcships/light-ocr-medium@next / light-ocr-medium |
约 139 MB | Preview;精度优先 |
NPU 支持通过单独安装的 @arcships/light-ocr-openvino-linux-x64-gnu / @arcships/light-ocr-amdnpu-linux-x64-gnu 提供,均需显式配置 provider。普通安装不含它们的运行库或编译模型,Small 模型制品保持不变。见 NPU 安装说明。
Tiny/Medium 保持在 next;它们不会改变
npm install @arcships/light-ocr 的安装内容。
实测性能
0.3.0 在三台真实设备上完成了同机对比:
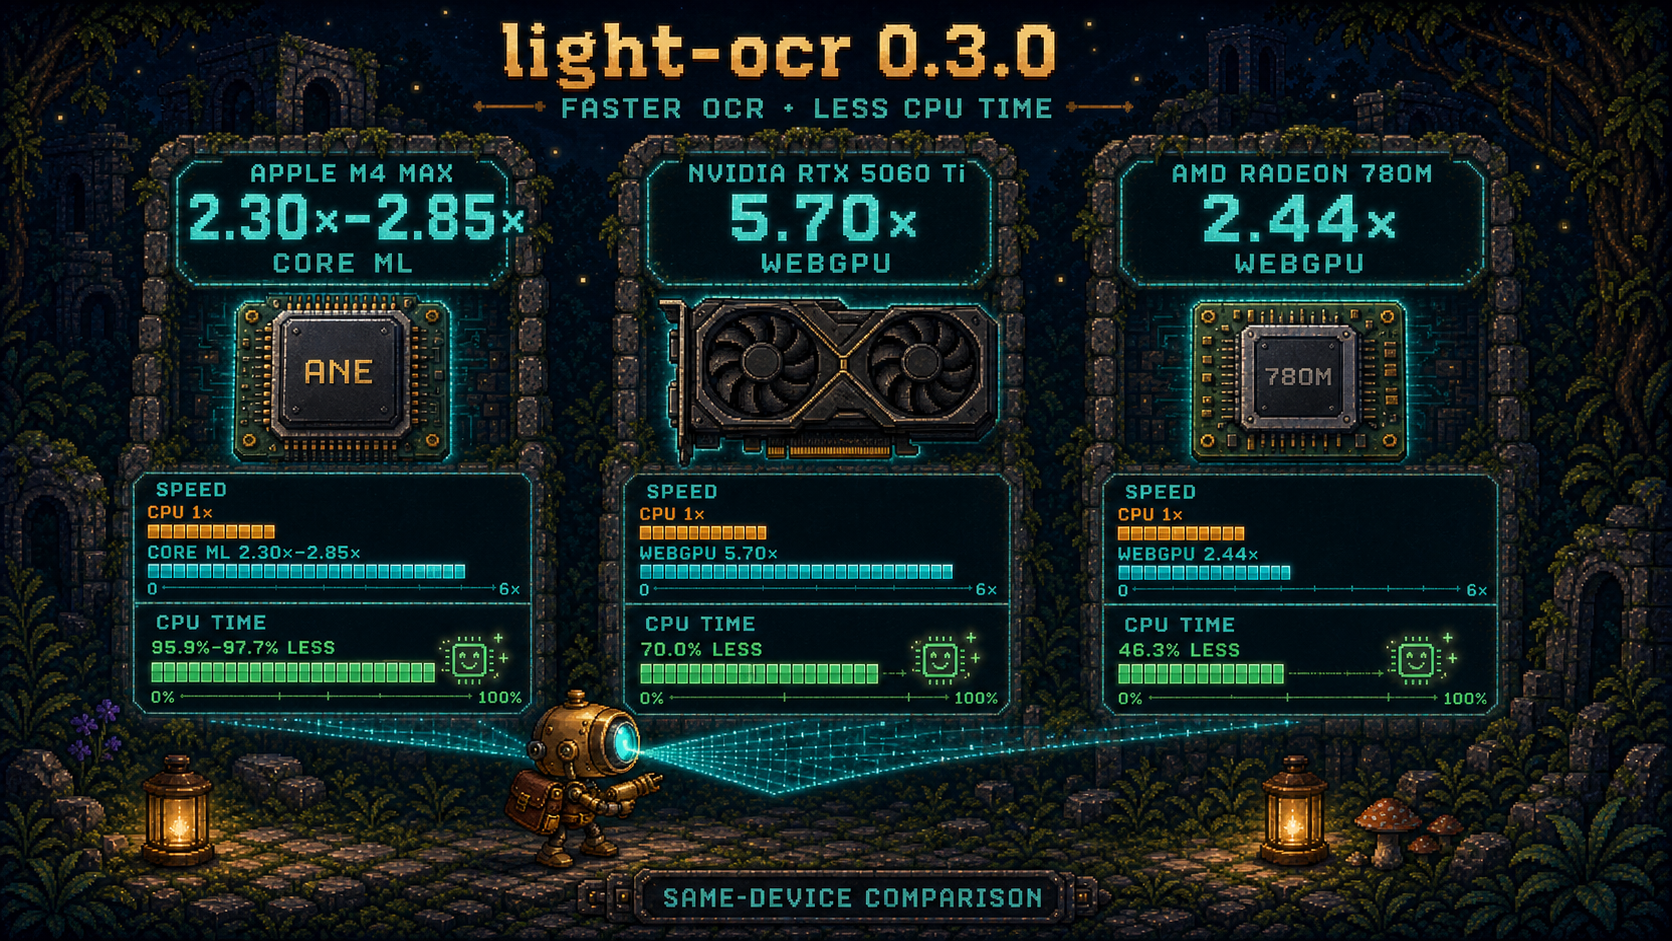
| 设备 | 加速方式 | 端到端加速 | OCR 进程 CPU time |
|---|---|---|---|
| Apple M4 Max | Core ML | HELLO 123 2.30×;密集表单 2.85× |
降低 95.91%–97.67% |
| Linux / NVIDIA RTX 5060 Ti | WebGPU / Vulkan | 14 张测试图片整体 5.70× | 降低 69.97% |
| Windows / AMD Radeon 780M | WebGPU / D3D12 | 14 张测试图片整体 2.44× | 降低 46.33% |
以上数字均为表中设备相对本机 CPU 路径的结果,并会随任务和硬件变化。14 张图片的整体加速比,是各图片 CPU 中位耗时之和除以 WebGPU 中位耗时之和。CPU 列统计同一批任务的 OCR 进程累计 CPU time,而不是某一瞬间的系统利用率;更低的累计 CPU time 意味着 OCR 运行期间能给前台应用留出更多 CPU 资源。Apple 测试通过了锁定的 CPU 一致性门槛;两组 WebGPU 测试的 14 张图片均与 CPU FP32 输出逐字节一致。完整测量和测试方法见 0.3.0 发布报告。
C++
C++ 项目从源码构建静态库,并链接 light_ocr::core CMake target。API 可以直接识别解码后的 GRAY8、RGB8、BGR8 或 RGBA8 像素;接入方式见 C++ API,各平台准备方式见 构建说明。
Agent Skill
内置 Agent Skill,供可调用本地命令的 AI Agent 使用。它提供场景驱动的工作流、命令选择建议和退出码参考:
- 何时使用 OCR 而非多模态模型
- 大图先 detect 再 recognize 的工作流
- 票据/表单的 ROI 字段提取
- 用确定性 OCR 验证多模态模型输出
文档
- npm package README
- CLI 参考
- Node.js 图片引擎与 CLI 细节
- Agent Skill
- C++ API
- Apple Silicon 加速
- Linux WebGPU 加速
- Windows WebGPU 加速
- 模型包
- 构建与发布
- 路线图
- 更新日志
- npm 0.5.9 release preparation — English
- npm 0.5.9 发布准备 — 中文
- npm 0.5.8 release record — English
- npm 0.5.8 发布记录 — 中文
- npm 0.5.7 release record — English
- npm 0.5.7 发布记录 — 中文
- npm 0.5.6 release record — English
- npm 0.5.6 发布记录 — 中文
- npm 0.3.0 发布报告
社区与协议
欢迎提交 issue 和 pull request — 请先阅读 CONTRIBUTING.md 了解贡献指南。所有参与者须遵守行为准则。
light-ocr 使用 Apache License 2.0。