
alexgreensh/token-optimizer
alexgreensh/token-optimizer has 2,963 GitHub stars and 234 forks. GitHot measured +5 stars in 24 hours and +69 in 7 days. Last checked 2026-11-12 13:39 UTC. Last push 2026-11-01.
Find the ghost tokens. Fix them. Survive compaction. Avoid context quality decay.
实测星标增长
- 24小时
- +5
- 7天
- +69
- 15天
- 更新延迟
- 1个月
- 更新延迟
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
README.zh-CN.md
原文








砍掉你浪费的 token。留住你本会丢失的工作。
它在后台自动运行。你照常工作。想要全貌时运行审计即可。

30 秒版本
Token Optimizer 砍掉你的 AI 编程助手浪费的 token,让你的工作在会话和压缩(compaction)之间存活,并在实时仪表盘上展示每一美元去了哪里。大部分自动运行。你安装它,运行一次审计,剩下的交给 hook。
为什么不直接用 Headroom 或 RTK? 它们压缩命令输出,只覆盖你上下文的 15-25%。Token Optimizer 覆盖这部分加上另外 75%:臃肿的配置、未使用的 skill、陈旧的记忆、压缩损失、模型误路由、行为浪费。每一项节省都对缓存安全且经过测量。仪表盘在每个会话后自动更新。

Devin 是路线图的下一站。
你得到什么
每个会话自动运行,你什么都不用做:
- 🔄 智能压缩(Smart Compaction):自动压缩前检查点,之后恢复
- 🗄️ 会话连续性(Session Continuity):跨会话提示、冷恢复、检查点评分
- 📦 主动压缩(Active Compression):9 项功能,全部默认开启(delta diff、骨架、bash/搜索压缩、精简输出提示、质量提示、循环检测、活动模式、决策提取)
- 📊 质量评分(Quality Scoring):7 个信号,实时,S–F 字母等级
- 🗃️ 会话数据库(Session Database):SQLite,15 张表,完整审计追踪,零网络
- 🔍 渐进式披露(Progressive Disclosure):大输出归档,按需展开
- 🧠 上下文情报摘要(Context Intel Digest):压缩后无需重读的重新定位
- 🔀 模型路由提示(Model Routing Nudges):引导到适合任务的层级
你主动要求时:
- 🩺
/token-optimizer:带引导修复的完整审计 - 📈
/token-coach:带具体修复的 30 天趋势分析 - ⚡
quick:10 秒健康检查 - 🎯
route:在你花钱之前,这个任务实际需要的模型和力度 - 🔧
doctor:安装检查 - 💰
savings:美元节省报告 - 📋
report:按组件的 token 分解 - 🌐
dashboard:打开完整仪表盘 - 📝
memory-review:MEMORY.md 结构审计 - 📂
expand:检索归档的工具结果 - 🔙
resume-lean:重开一个冷会话
安装,运行一次 /token-optimizer,其余全部自动运行。
Claude 桌面应用里的状态栏
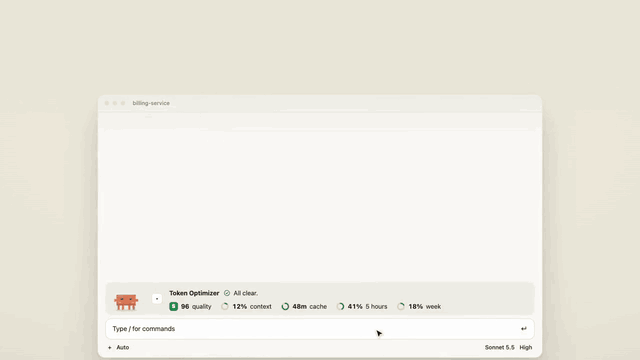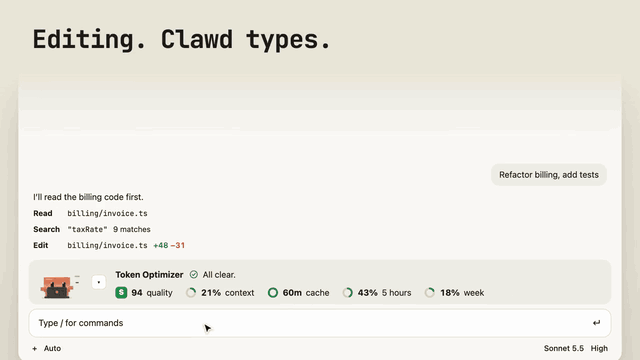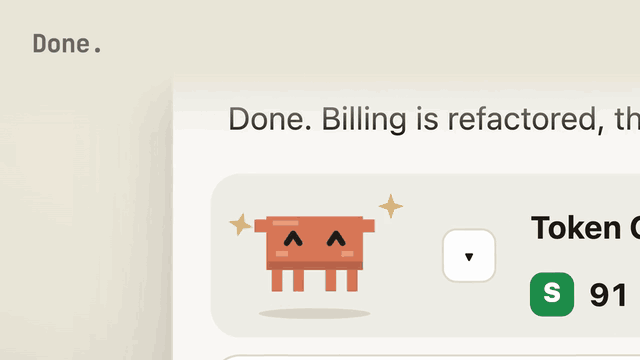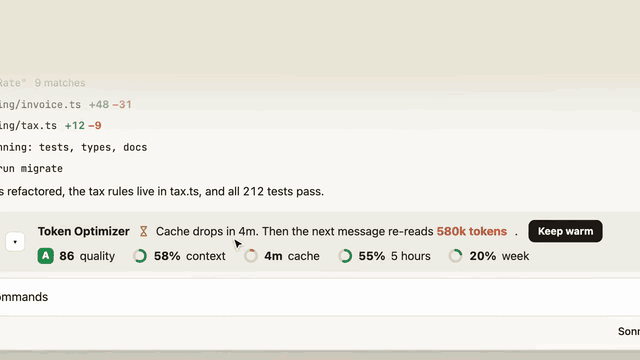
30 秒预览。 观看带声音的完整影片(50 秒)。
Claude Code 现在允许插件添加自己的界面元素,称为 mod。Token Optimizer 用它把会话的健康状况放在输入框正上方:质量等级、上下文已用多少、缓存还能保持多久,以及两项用量限额。一句话告诉你现在需要注意什么,一个按钮就能解决。橙色的小吉祥物 Clawd 会演出会话正在做的事,让你一眼看出 Claude 是在阅读、编辑、等待你的许可,还是已经完成。
它随插件一起提供,无需额外安装。了解详情。
安装
Claude Code(推荐):
/plugin marketplace add alexgreensh/token-optimizer
/plugin install token-optimizer@alexgreensh-token-optimizer
然后在 Claude Code 中:/token-optimizer
安装后请启用自动更新。 Claude Code 默认以自动更新关闭来分发第三方市场。
/plugin→ Marketplaces 标签 → 选择alexgreensh-token-optimizer→ Enable auto-update。一次性,10 秒。安装后,运行一次
/token-optimizer来设置 hook。此后一切自动运行:压缩、检查点、质量评分、仪表盘更新。除非你想要审计,否则无需再运行任何命令。
其他平台和安装方法
Codex:
codex plugin marketplace add alexgreensh/token-optimizer
然后在 Codex TUI 中:/plugins 并安装 Token Optimizer。参见 docs/codex.md。
OpenCode: 将 token-optimizer-opencode 添加到你的 opencode.json 的 plugin 数组:
{ "$schema": "https://opencode.ai/config.json", "plugin": ["token-optimizer-opencode"] }
OpenClaw:
openclaw plugins install github:alexgreensh/token-optimizer
Hermes:
git clone https://github.com/alexgreensh/token-optimizer.git
token-optimizer/install.sh --hermes
参见 hermes/README.md。
GitHub Copilot:
git clone --depth 1 https://github.com/alexgreensh/token-optimizer.git
cd token-optimizer
bash install.sh --copilot
参见 docs/copilot.md。
Cursor:
git clone --depth 1 https://github.com/alexgreensh/token-optimizer.git
cd token-optimizer
bash install.sh --cursor
参见 docs/cursor.md。
macOS/Linux 脚本安装(插件的替代):
tmp="$(mktemp -d)"
release_json="$(curl -fsSL https://api.github.com/repos/alexgreensh/token-optimizer/releases/latest)"
tag="$(python3 -c 'import json,sys; print(json.load(sys.stdin)["tag_name"])' <<<"$release_json")"
git clone --branch "$tag" --depth 1 https://github.com/alexgreensh/token-optimizer.git ~/.claude/token-optimizer
bash ~/.claude/token-optimizer/install.sh
rm -rf "$tmp"
Windows 用户: 仅使用插件安装。不要在 Windows 上运行 install.sh。如果遇到 EBUSY 错误,关闭所有 Claude Code 和 Git Bash 窗口,杀掉残留的 git.exe 进程,删除 C:\Users\<you>\.claude\token-optimizer 和 C:\Users\<you>\.claude\plugins\marketplaces\alexgreensh-token-optimizer,然后重试。
如果 install.sh 因 $'\r': command not found 失败(在强制 LF 换行之前的克隆把脚本转成了 CRLF),剥离一次回车符再重新运行,仓库现在附带一个 .gitattributes 在新克隆上防止此问题:
sed -i 's/\r$//' ~/.claude/token-optimizer/install.sh
# 已经有仓库了?就地重新规范化换行:
git -C ~/.claude/token-optimizer add --renormalize . && git -C ~/.claude/token-optimizer checkout -- .
卸载
Token Optimizer 是附加且可逆的。每个运行时都有干净的卸载,只移除我们安装的内容,保留你自己的 hook、配置和会话数据。每个运行时的完整步骤见 docs/uninstall.md。
最快路径(Claude Code 插件安装):
/plugin uninstall token-optimizer@alexgreensh-token-optimizer
不同之处
大多数 token 工具压缩命令输出。那覆盖你上下文的 15-25%。另外 75% 无人触及。
压缩覆盖面。 Headroom、RTK 和 JFrog Boost 压缩 bash 和命令输出。Token Optimizer 压缩输出栈的八个面。状态:🟢 支持,🟡 部分,🔴 不支持。
| 压缩面 | Token Optimizer | Headroom | RTK | Boost |
|---|---|---|---|---|
| Bash / 命令输出(git、测试、lint、构建、日志) | 🟢 跨 22 个模式家族的 111 个命令,凭证安全;pytest 运行 564 → 115 token | 🟢 SmartCrusher、CodeCompressor、Kompress-v2 | 🟢 100+ 过滤器 | 🟢 命令感知过滤器 |
| 搜索 / grep 输出 | 🟢 命中顶部加计数;500 行 → 20 | 🔴 | 🔴 | — |
| 表格 / JSON 输出(jq、yq、csvtool、mlr) | 🟢 保值的列式 | 🟢 SmartCrusher | 🔴 | — |
| 文件重读,delta 模式 | 🟢 仅 diff;2,000 token 重读 → ~50 | 🔴 | 🔴 | — |
| 文件重读,结构图 | 🟢 签名和 import 的骨架;720KB → 250 token | 🔴 | 🔴 | — |
| 大型工具结果(超过 4K 字符) | 🟢 归档到磁盘,按需可展开 | 🔴 | 🔴 | — |
| 模型输出冗长 | 🟢 精简输出提示,缓存安全(节省为估算,非计量) | 🔴 | 🔴 | 🔴 |
| 结构性上下文(配置、skill、MCP、记忆) | 🟢 按组件审计,每个来源评分 | 🔴 | 🔴 | 🔴 |
RTK 和 Boost 到达第一个面。Headroom 到达第一个和第三个。Token Optimizer 覆盖全部八个,然后继续深入压缩周围发生的事:
- 三种浪费,不是一种。 结构性(臃肿配置、未用 skill、陈旧记忆)、运行时(冗长输出、重读)和行为性(模型误路由、缓存过期、重试循环)。各自如何工作 →
- 节省在压缩中存活。 自动压缩前检查点,之后恢复。没有这个,压缩节省在压缩触发的瞬间消失。
- 测量是否有帮助。 前后 token 差值、跨四个定价层级的美元节省、追踪退化的质量评分。不只是"我们压缩了东西"。
- 零基线开销。 外部进程,上下文中没有常开指令,没有 MCP 服务器,没有依赖,没有遥测。

这十行是 Token Optimizer 是该行唯一 🟢 的行:在压缩之外存活的东西,以及没有压缩器去寻找的浪费。压缩机制、成本和安全,以及我们输的两行在折叠部分之后。
| Token Optimizer | Headroom | RTK | Boost | context-mode | /context |
|
|---|---|---|---|---|---|---|
| 压缩存活 | 🟢 渐进检查点、恢复、工具输出摘要 | 🔴 | 🔴 | — | 🟡 仅会话指南 | 🔴 |
| 会话连续性 | 🟢 跨会话提示、冷恢复、检查点评分 | 🔴 | 🔴 | — | 🟡 会话指南 | 🔴 |
| 结构性浪费审计 | 🟢 按组件深入(CLAUDE.md、skill、MCP、记忆) | 🔴 | 🔴 | 🔴 | 🔴 | 🟡 仅摘要 |
| CLAUDE.md 和 MEMORY.md 健康 | 🟢 8 个审计器 + 注意力曲线评分 | 🔴 | 🔴 | 🔴 | 🔴 | 🔴 |
| 模型路由和行为辅导 | 🟢 12 个检测器、子代理成本分解、反模式 | 🔴 | 🔴 | — | 🔴 | 🟡 基本建议 |
| 历史趋势分析 | 🟢 30 天趋势、质量/成本/缓存/时长相关、模型切换检测 | 🔴 | 🔴 | — | 🔴 | 🔴 |
| 上下文质量评分 | 🟢 带等级的 7 信号质量评分 | 🔴 | 🔴 | — | 🔴 | 🟡 仅容量百分比 |
| 循环和空转检测 | 🟢 在烧 token 前捕捉行为循环 | 🔴 | 🔴 | — | 🔴 | 🔴 |
| 测量压缩是否有效 | 🟢 本地遥测、前后 token、美元节省 | 🔴 | 🟡 rtk gain(仅 token 计数) |
🟡 boost report,厂商侧 |
🔴 | 🔴 |
| 舰队级跨代理分析 | 🟢 | 🔴 | 🔴 | — | 🔴 | 🔴 |
显示其余 13 行(压缩机制;成本、安全和覆盖;调优、证明和安装)
| Token Optimizer | Headroom | RTK | Boost | context-mode | /context |
|
|---|---|---|---|---|---|---|
| 无需命令重写 | 🟢 hook 接线,自动触发 | 🟢 透明代理 | 🟢 基于 hook 的重写 | 🟢 boost init 接线支持的代理;终端使用可加前缀 |
🟡 在支持 hook 的平台上自动 | N/A 原生命令 |
| 完整原始可恢复 | 🟢 压缩前原始归档,expand 检索;失败从不压缩 |
🟢 可逆检索 | 🟡 命令失败时保存完整输出 | 🟢 厂商文档化命令输出恢复 | — | N/A 不压缩 |
| 注册自定义命令过滤器 | 🔴 内置命令集;无用户过滤器 API | — | 🟢 自定义 TOML 过滤器 | 🟢 TOML 过滤器 | — | N/A |
| 用户可调配置 | 🟢 137 个代码引用的 TOKEN_OPTIMIZER_* 名称,显式拆分为面向用户和内部控制;附加式允许列表;.contextignore |
🟢 文档化配置 | 🟢 config.toml 和环境控制 |
🟢 过滤器 TOML | 🟢 文档化配置 | N/A |
| 缓存安全 | 🟢 从不修改现有上下文前缀 | 🟡 代理模式重写进行中的 | 🟢 仅 pre-shell | 🟢 仅 pre-shell | 🟡 MCP 开销 | 🟢 |
| 零基线上下文开销 | 🟢 外部进程,无上下文注入 | 🔴 注入指令 | 🟢 仅 shell 级 | 🟢 仅 shell 级 | 🔴 MCP 服务器开销 | 🟢 原生 |
| 零运行时依赖 | 🟢 纯标准库(Python/TypeScript) | 🟡 Python + Rust + 可选模型 | 🟢 单个 Rust 二进制 | 🟢 单个二进制 | 🟡 需要 SQLite 适配器 | 🟢 N/A |
| 零遥测 | 🟢 不离开机器 | 🟡 HEADROOM_TELEMETRY opt-in,默认关 |
🟡 opt-in | 🔴 收集调用的命令、命令参数、退出码、时长、CI 属性、IP | 🟡 各异 | 🟢 |
| 多平台 | 🟢 Claude Code、VS Code、Codex、OpenClaw、OpenCode、Hermes、Copilot、Cursor | 🟢 Claude Code、Cursor、Codex、Aider、Copilot | 🟢 15 个集成 | 🟡 Cursor、Claude Code、Copilot、Codex CLI | 🟢 17 个集成 | 🔴 仅 Claude Code |
| 按任务的模型和力度建议 | 🟢 route 在你花钱前衡量任务 |
— | — | — | — | — |
| Keep-Warm(缓存 TTL 刷新) | 🟢 缓存过期前 opt-in ping,绊线自动关 | 🔴 | 🔴 | — | 🔴 | 🔴 |
| 端到端任务结果基准 | 🔴 仅输出 token A/B | — | — | 🟢 厂商报告 Terminal-Bench 2.0 相同通过率和约 12% 更低成本 | — | N/A |
| 签名和校验和验证安装 | 🟢 每个发布 CHECKSUMS.sha256,安装时验证,CI 强制 |
— | — | 🔴 安装器既不验证校验和也不验证签名 | — | N/A |

仪表盘
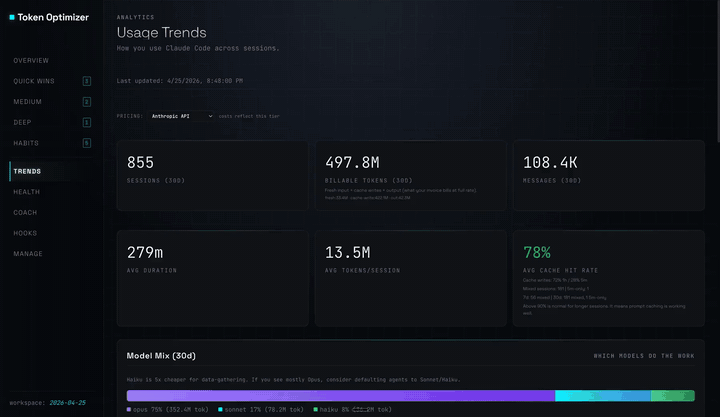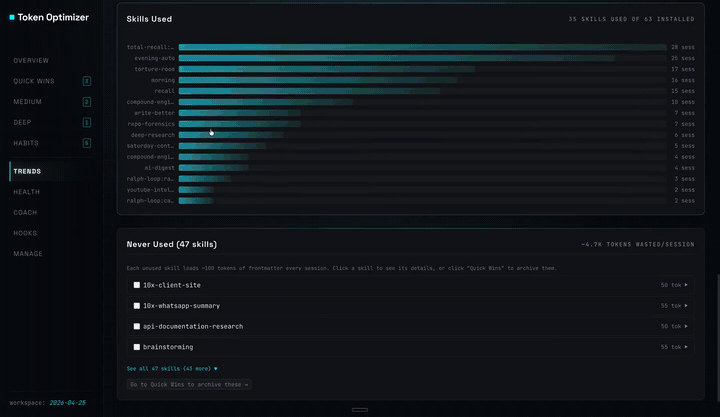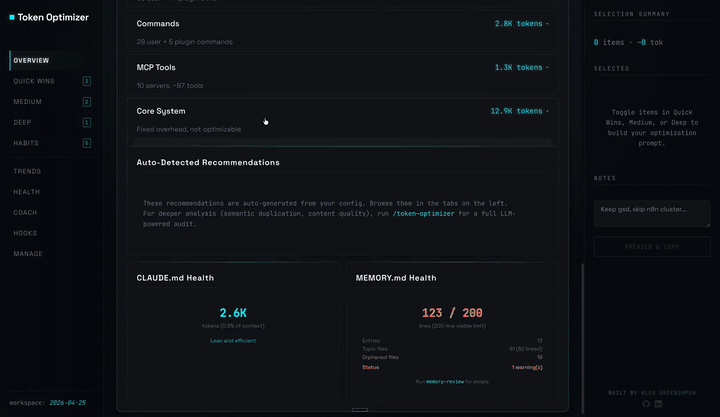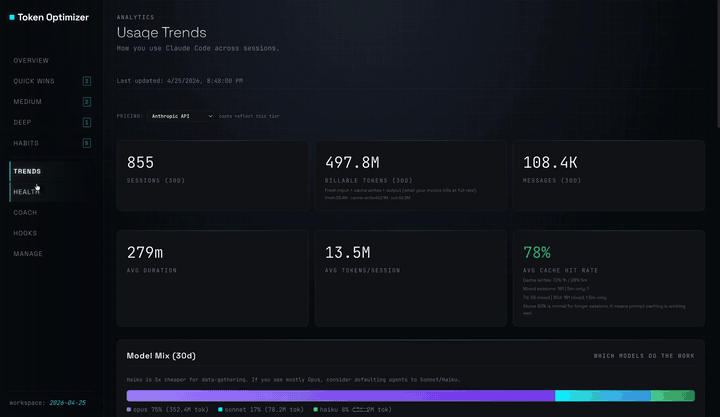
一个 HTML 页面,通过 SessionEnd hook 在每个会话后自动重新生成,无需手动触发。可书签的 URL http://localhost:24842/token-optimizer 是 opt-in:只有在运行 python3 skills/token-optimizer/scripts/measure.py setup-daemon 启动本地服务器后才工作。在那之前,打开 measure.py dashboard 在 Dashboard: 行打印的文件路径。
每轮 token 分解、跨四个定价层级的成本、带 TTL 混合和命中率的缓存分析、叠加在每个会话上的质量评分、子代理成本分解、已计量与估算分开的节省追踪器。安装后零设置。完整仪表盘文档 →
节省什么
截至 2026-11-01 的30天快照,按API价格换算的合计价值约为 $597.72。这是可定价部分的小计。 各组成部分分别标明依据。
- 已记录的动作:$78.59。 4,945 个事件中计量的token变化,按API价格换算。
- 模型路由:$422.88。 使用固定的启用前模型组合和固定参照模型价格表进行估算比较。
- 避免的重复读取:$60.69。 根据实际观测的轮次建模,止于下一次真实压缩,并使用已知的逐轮费率。
- 其他估算:$35.56。 方法学列出全部8个估算类别,包括值为零的类别。
定价覆盖不完整。 未定价的重复读取收益与扣减均未计入,无法确定完整净值。四个组成部分之和与合计一致。
同一快照的token卡显示 节省 24,797,356 个token,其中计量 9,831,072、估算 14,966,284。已用 286,218,848 + 节省 24,797,356 = 311,016,204,节省部分占 约 8%。范围为已记录的token,加上MCP上限、提示引导读取、精简输出和精简恢复的估算(快照基于 v5.13.63 规则生成;检查点恢复此后已移至估算层级)。建模的重复读取与模型路由不计入此token总数;美元小计的范围更广。

基于 1,644 个主要工作会话和 3 个委派会话。仪表盘使用你自己的历史记录计算,结果会有所不同。方法学 →

主动压缩
九项主动减少上下文的功能,全部默认开启,全部自动,全部可从仪表盘或 CLI 切换。
底层,PreToolUse hook 在每次 Read 和 Bash 调用进入你的上下文之前拦截。如果文件已被读取,只返回 diff。如果是代码文件重读,结构骨架替换完整内容。如果是 CLI 命令,输出被压缩。PostToolUse hook 把完整原始归档到磁盘并记录压缩事件到 SQLite。没有东西丢失,一切可检索。你什么都不用做。hook 处理一切。

| 功能 | 做什么 | 节省 |
|---|---|---|
| Delta 模式 | 重读只返回变化的部分 | 重读时 ~20% |
| 结构图 | 未变文件重读返回结构骨架 | ~30%(每文件最高 99%) |
| Bash 压缩 | CLI 输出精简为要点 | ~10% |
| 搜索压缩 | grep/web 结果精简为命中顶部 + 计数 | ~15% |
| 精简输出提示 | 上下文填满时引导模型精简输出 | 估算 10-15%;非反事实计量 |
| 质量提示 | 上下文质量下降时警告 | 防止压缩损失 |
| 循环检测 | 在烧 token 前捕捉重试循环 | 按循环计量 |
| 活动模式 | 按你的会话阶段适配压缩 | 防止决策损失 |
| 决策提取 | 跨压缩保留决策 | 防止决策漂移 |
从仪表盘 Manage 标签、CLI(measure.py v5 enable|disable <feature>)或环境变量切换。v5 动词是控制当前功能的遗留命令名。
每项功能详情
Delta 模式
当 AI 在编辑后重读文件,Read 调用只返回 diff。真实会话中 65%+ 的 Read 调用是重读。一个 2,000 token 的文件重读变成 50 token 的 diff。

禁用:TOKEN_OPTIMIZER_READ_CACHE_DELTA=0
结构图
当 Claude 重读它已看过的代码文件,Read 调用被阻断并替换为结构摘要:函数签名、类层次、import。一个 720KB Python 文件(180,000 token)变成 250 token 骨架。
禁用:TOKEN_OPTIMIZER_READ_CACHE_MODE=shadow
首读骨架
在历史验证的队列中,大型代码文件(Python 或 TypeScript,16KB–256KB)的首次读取,Read 返回结构骨架(签名/import)而非完整文件,带一行提示,完整内容始终一步之遥:expand <key>、范围 Read(offset/limit)或直接 Edit。原始在任何替换前归档,失败开放,如果归档无法发生,提供完整文件。
这仅适用于代码。Markdown 和其他散文在首读时不骨架化(v5.11.27 起):仅标题大纲会丢掉承重的散文,所以文档始终完整返回。运行时绊线在实时编辑率上升时把代码队列自动降级为仅测量。
禁用提供(保留测量):TOKEN_OPTIMIZER_FIRST_READ_ACTIVE=0。完全禁用:TOKEN_OPTIMIZER_FIRST_READ_SHADOW=0。两者也可通过 measure.py v5 status 和仪表盘 Manage 标签查看和切换。
Bash 输出压缩
重写常见 CLI 命令以返回压缩摘要。覆盖 lint、日志尾部、tree、docker pull、长列表、构建输出和测试运行器。一个 564 token 的 pytest 输出变成 115 token。

禁用:TOKEN_OPTIMIZER_BASH_COMPRESS=0
搜索结果压缩
当 AI 运行 grep、rg 或返回长结果列表的 web 搜索,输出被精简为命中顶部加计数。一个 500 行 grep 结果变成 20 行加摘要。
禁用:TOKEN_OPTIMIZER_BASH_COMPRESS=0(搜索压缩是 bash 压缩的一部分;没有单独开关)
精简输出提示
当上下文填过 25%,一段简短提示告诉模型深度推理但保持可见输出精简。填充是唯一条件,质量不再门控它,所以一个普通健康会话也得到提示,不只是漫长的退化会话。节省估算为 10-15%,未计量:反事实(没有提示模型会写什么)无法观察,所以 Token Optimizer 在估算层级报告它,从不折入计量节省。缓存安全:作为 additionalContext 注入,从不修改现有前缀。
今天没有开关(不是 v5 功能)。用 TOKEN_OPTIMIZER_VERBOSITY_MIN_FILL(默认 25)调整触发点。
质量提示
实时监视上下文质量。当评分下降超过 15 分或跌破 60,一条内联备注进入上下文。Claude 在下一轮看到它并浮现警告或调整行为。5 分钟冷却,每会话最多 3 次。
禁用:TOKEN_OPTIMIZER_QUALITY_NUDGES=0
循环检测
捕捉 AI 卡在重试循环。比较最近 4 条用户消息和最近 5 个工具结果的相似度。在置信度 ≥0.7 触发,每会话上限 2 条备注。节省从实际循环轮内容计量。
禁用:TOKEN_OPTIMIZER_LOOP_DETECTION=0
活动模式检测
用最近 10 次工具调用把你的会话分类为五种模式之一(代码、调试、审查、基础设施、通用)。该模式进入压缩指导,使 PRESERVE/DROP 优先级适配你正在做的事。
决策提取
实时从工具输出检测决策语句并存入会话数据库。压缩时,这些决策作为 CRITICAL DECISIONS 注入,摘要必须逐字保留。每会话上限 10 条。
测量真实节省
所有压缩功能记录到本地 SQLite 表。没有东西离开你的机器。
python3 measure.py compression-stats --days 30
会话数据库
Token Optimizer 所做的一切由两个本地 SQLite 数据库支撑。没有东西离开你的机器。零网络调用。

每会话 DB(~/.claude/token-optimizer/snapshots/session-store/<session>.db)持有 8 张表,追踪文件读取、工具输出、命令输出、缓存内容、上下文情报事件、活动日志、决策日志和提示服务。WAL 模式用于 hook 进程的并发读/写。每会话 50MB 上限。
趋势 DB(~/.claude/token-optimizer/snapshots/trends.db)持有 7 张表,追踪会话历史、每日聚合、skill/模型/子代理使用、节省事件和压缩事件。按会话 UUID 索引以实现 O(log n) 连接。这就是仪表盘、coach 模式和 30 天趋势分析的驱动力。
每个压缩事件、每笔节省、每次质量测量都是一行你可查询的数据。仪表盘是此数据的只读视图。measure.py compression-stats 是一条 SQL 查询。你的数据是你的。
渐进式披露
大型工具结果(>4KB)归档到磁盘并替换为简短预览加检索指针。完整输出在压缩中存活。当模型需要它,通过 expand 拉取原始,无需命令重跑,无丢失输出。
这不只是存储。系统追踪多少结果被归档 vs 重新展开,这样你能看到保持折叠的净 token。重新展开从节省总额中扣除,所以你只算实际保持压缩的。
python3 measure.py expand --list          # 列出归档的工具结果
python3 measure.py expand <tool-use-id>   # 检索特定结果
一些 MCP 工具被文档化为返回大型逐字载荷(来源抓取器、文档检索器),其中元数据预览会破坏要点。把它们加入允许列表,使完整结果到达上下文而非被替换(仍然归档,所以 expand 工作)。设置一个针对完整工具名匹配的 fnmatch glob 的逗号分隔列表:
TOKEN_OPTIMIZER_ARCHIVE_EXEMPT_TOOLS="mcp__context7__*,*github_repository_file"
默认为空,除非你 opt-in 一个工具,否则没有东西被豁免。
会话连续性
压缩很重要,但 Token Optimizer 做的最重要的事是自动让你的工作在会话和压缩之间存活。
当你结束一个会话,Token Optimizer 把你的状态检查点到 SQLite:活动任务、关键决策、修改的文件、git 分支、最近读取。当你开始新会话,它针对你的提示给所有最近检查点评分,并浮现最相关的一个作为提示。你带着上下文恢复,而非从零开始。
自动发生什么:
- 跨会话提示:相关性评分的检查点在你开始新会话时浮现。提示包括前一个会话的任务、决策、文件和分支。全部以 RECOVERED DATA 围栏,绝非指令。
- 冷恢复精简:无需支付完整转录成本重开一个陈旧会话。Token Optimizer 从其检查点重建精简上下文。无 LLM 调用,无完整转录冷恢复。从 SQLite 免 token 重建。
- 提示跟随估算:当连续性提示浮现文件路径而模型随后读取其中一个,Token Optimizer 估算一笔避免的探索性搜索。提示→读取配对是观测到的;回避的探索性搜索规模是固定估算,报告在估算层级,不计入计量合计。
python3 measure.py resume-lean                    # 列出可重开的冷会话
python3 measure.py resume-lean <#|session_id> --print  # 输出精简上下文块
压缩节省只有在你的会话在压缩中存活时才粘住。会话连续性使之发生。
智能压缩
当自动压缩触发,60-70% 的对话消失。决策、错误修复序列、代理状态,全部消失。
Token Optimizer 在压缩前检查点你的会话,并通过 hook 自动恢复摘要丢掉的内容。它还注入一个上下文情报摘要:模型已处理的大型工具输出的启发式摘要(触及的文件路径、见到的错误、行数)。压缩后,模型知道它看过什么而无需重读一切。
活动模式检测用最近 10 次工具调用实时分类你的会话(代码、调试、审查、基础设施、通用)。该模式进入压缩指导,使 PRESERVE/DROP 优先级适配你现在正在做的事,而非通用启发式。
决策提取在决策语句从工具输出发生时捕捉并存入会话 DB。压缩时,这些作为 CRITICAL DECISIONS 注入,摘要必须逐字保留。每会话上限 10 条。
压缩节省只有在你的会话在压缩中存活时才粘住。在 git status 上节省 token,如果下一次自动压缩抹掉让你运行它的决策,就毫无帮助。

智能压缩如何工作
渐进检查点
在多个阈值捕捉会话状态:20%、35%、50%、65%、80% 上下文填充,加上质量跌破 80、70、50 和 40。还在代理扇出前和大编辑批次后快照。恢复时,选择最丰富的合格检查点。
上下文情报摘要
压缩后,Token Optimizer 注入会话最大工具输出的摘要:触及的文件路径、检测到的错误、行数。在 <30ms 内启发式生成,无 LLM 调用。模型无需重读一切即可重新定位。
python3 measure.py setup-smart-compact # 检查点 + 恢复 hook
输出 token:精简 vs 冗长
输出 token 是你会话中最昂贵的部分。在 Opus 上它们比输入 token 贵 5 倍,按生成计费而非按缓存读取。对简单问题的冗长回答烧掉你从不需要花的美元。
Token Optimizer 用精简输出提示自动处理这个。当你的上下文填过 25%,一段简短提示告诉模型深度推理但保持可见输出精简。填充是唯一触发;上下文质量不是条件。减少估算为 10-15% 且非反事实计量,所以在估算层级报告,与计量节省分开。
如何工作:
- 提示作为
additionalContext注入,从不修改现有前缀,所以你的缓存保持完整 - 只在上下文填满时触发,而非你有大量空间时
- 模型仍然思考问题;它只是产生更精简的可见答案
- 今天没有开关;用
TOKEN_OPTIMIZER_VERBOSITY_MIN_FILL(默认25)调整触发点
这是 9 项主动压缩功能之一,也是节省输出侧的那项,token 在那里最贵。
质量评分
质量评分追踪两件事:资源健康(你离退化悬崖多近)和会话效率(你的 token 是否在做有用的工作)。从 S 到 F 的字母等级让分诊即时。
随着上下文填充,质量下降。MRCR 在 256K 和 1M 上下文之间从 93% 降到 76%。你的 AI 随窗口填充可测量地变笨。质量评分向你展示那何时发生。

状态栏随质量退化变色:绿、黄、橙、红。当质量跌破 75,会话时长作为警告出现。运行的子代理显示其模型和经过时间。

python3 measure.py setup-quality-bar # 一次性安装
质量评分详情
| 评分 | 信号 | 含义 |
|---|---|---|
| 资源健康 | 上下文填充、压缩深度、绝对浪费 token | 你离退化悬崖多近 |
| 会话效率 | 陈旧读取、臃肿结果、决策密度、代理效率 | 会话现在是否在好好使用 token |
| 等级 | 范围 | 含义 |
|---|---|---|
| S | 90-100 | 峰值效率 |
| A | 80-89 | 健康,可小幅优化 |
| B | 70-79 | 退化开始 |
| C | 55-69 | 显著浪费 |
| D | 40-54 | 严重问题 |
| F | 0-39 | 上下文正在腐烂,需要立即行动 |
质量栏消失了? 运行 Claude Code 的 /statusline 会覆盖 Token Optimizer 的条目。SessionStart 自动恢复。只要开始一个新会话它就回来。
想永久关掉?
python3 measure.py setup-quality-bar --uninstall
Coach 模式
> /token-coach
告诉它你的目标。拿回具体的、带优先级的修复,附精确 token 节省。它读取你 30 天的会话数据并浮现单个会话无法展示的:质量向下漂移、会话变长、缓存命中率下降、每会话成本攀升。
每个洞察都基于你的真实数字。"你的短会话得分 68 对长会话 60"比"考虑更短的会话"更扎心。Coach 模式还识别项目级优化机会(你从不使用的 skill、急切加载的 MCP 服务器、破坏你缓存的 CLAUDE.md 模式)并教你如何修复,使未来会话从更精简开始。
Coach 模式详情
检测到的历史模式
| 模式 | 检测什么 |
|---|---|
| 质量漂移 | 平均质量逐周下降 |
| 会话时长爬升 | 会话变长,更快填满上下文 |
| 缓存退化 | 缓存命中率下降(以及模型切换是否导致) |
| 等级分布 | 太多 D 级会话堆积 |
| 成本意识 | 每会话成本攀升,附路由建议 |
| 时长-质量相关 | 短会话得分更高,建议你拆分长的 |
| 压缩差距 | 仅 shadow 的节省远超主动压缩 |
| 模型切换 | 频繁的会话中途模型切换使提示缓存失效 |
浪费检测器
11 个自动化检测器分析你的会话模式:
| 检测器 | 捕捉什么 |
|---|---|
| PDF/二进制摄取 | 消耗上下文的大文件 |
| Web 搜索开销 | 太多 web 结果倾倒进上下文 |
| 重试搅动 | 同一工具带错误重试 3+ 次 |
| 工具级联 | 3+ 连续工具错误 |
| 循环 | 重复的相似消息 |
| 过强模型 | 简单编辑用 Opus |
| 过弱模型 | 复杂任务用 Haiku |
| 糟糕分解 | 单体 500+ 字提示 |
| 浪费思考 | 小编辑的扩展思考 >2x 输出 |
| 输出浪费 | 对简单操作的冗长响应 |
| 缓存不稳定 | 破坏提示缓存的 CLAUDE.md 模式 |
Keep-Warm
API 计费会话的 opt-in 功能。在你的提示缓存条目即将过期前发出一个微小的缓存读取 ping,刷新其 TTL。成本约为前缀的 ~0.1x,对比恢复时你要付的 1.25-2x 重写。如果 ping 不再自付成本,绊线自动关闭。
python3 measure.py keepwarm-enable          # opt-in(仅 API 计费)
python3 measure.py keepwarm-report            # 净节省、支出、绊线状态
python3 measure.py keepwarm-disable           # 随时 opt-out
舰队审计器
跨 Claude Code、Codex 和自定义转录设置扫描,以发现空闲烧钱、模型误路由和配置臃肿,每项发现附美元节省。
CLAUDE.md 路由注入
从你的实际使用数据生成模型路由指令并注入 CLAUDE.md。48 小时陈旧守卫自动移除过时建议。
python3 measure.py inject-routing --dry-run   # 预览
python3 measure.py inject-routing              # 注入
FAQ
🔒 它会降低我的上下文质量吗?
不会。结构优化只移除真正未使用的组件。主动压缩控制可用单个命令或环境变量禁用。质量评分系统实时追踪退化。
💾 它会破坏提示缓存吗?
不会。Token Optimizer 从不触碰已在你的上下文中的内容。它作用于进入你窗口的新内容和压缩边界。你的缓存前缀保持完整,这意味着它两次省钱:每轮更少输入,以及之后每轮更便宜的缓存读取。
📡 它会把任何数据发到任何地方吗?
无分析,无遥测端点,无产品数据离开你的机器。测量事件是你拥有的本地 SQLite 行。零网络调用。
⚠️ 它会伤害我的会话吗?
不会。所有 hook 都是非阻塞的失败开放设计。如果某个 Token Optimizer 脚本出错,你的命令正常运行。
📦 有任何运行时依赖吗?
没有。在 Claude Code 和 Codex 上是纯 Python 标准库。在 OpenCode 和 OpenClaw 上是零运行时依赖的 TypeScript。
🔐 install.sh 如何验证文件完整性?
解析最新的 GitHub Release 标签,检出该标签,从同一发布获取 CHECKSUMS.sha256,并验证每个脚本文件。带外验证意味着一个被攻破的提交无法同时替换代码和校验和。
所有命令
显示所有命令
| 命令 | 做什么 | 文档 |
|---|---|---|
/token-optimizer |
6 个并行代理的完整审计,引导修复 | → |
/token-coach |
30 天趋势分析,带优先级修复 | → |
quick |
10 秒健康检查 | → |
doctor |
安装检查,10 分制评分 | → |
dashboard |
打开 HTML 仪表盘 | → |
savings |
美元节省报告 | → |
report |
按组件的 token 分解 | → |
quality |
实时会话的上下文质量分析 | → |
trends |
skill 采纳、模型混合、随时间的开销 | → |
compression-stats |
主动压缩的计量节省 | → |
memory-review |
MEMORY.md 结构审计 | → |
git-context |
为你当前 diff 建议文件 | → |
drift |
与你上次快照的并排对比 | → |
conversation |
按消息的 token 和成本分解 | → |
pricing-tier |
查看或切换定价层级 | → |
expand |
检索归档的工具结果(渐进式披露) | → |
resume-lean |
用免 token 重建重开冷会话 | → |
许可证
PolyForm Noncommercial 1.0.0,另附书面的小型企业许可。源码可见。
个人 / 爱好 / 研究 / 教育?
放手去做。完整源码,本地运行,无需购买许可证。你自己的开源业余项目也包括在内。关键在于这项工作为谁而做,而不是在哪里运行:为雇主做的工作,即使在家里做,也属于雇主的使用。
小型企业(少于 5 人 且 月收入低于 $20k)?
免费商业许可证,以书面形式授予:LICENSE-SMALL-BUSINESS.md。两个条件都针对整个公司(包括母公司和关联公司),而不是团队或使用人数。大公司里的小团队需要商业许可证。
从个人开始,现在要变成生意了?
你过去的使用完全没问题。不再符合条件后,你有 32 天时间办理商业许可证。
更大的公司 / 商业使用?
联系 Alex Greenshpun 或 [email protected]。条款合理,并按公司规模确定。
由 Alex Greenshpun 创建。