
aigclink/geolook
aigclink/geolook has 811 GitHub stars and 206 forks. GitHot measured +2 stars in 24 hours and +9 in 7 days. Last checked 2026-11-09 22:04 UTC. Last push 2026-08-10.
Open-source end-to-end GEO implementation: status analysis, diagnosis, strategy, tickets, execution, verification
实测星标增长
- 24小时
- +2
- 7天
- +9
- 15天
- 更新延迟
- 1个月
- 更新延迟
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
README.zh-CN.md
原文GeoLook
开源的全流程 GEO 实施平台 · 自托管
面向具体项目:现状分析 → 诊断 → 方案 → 实施计划工单 → 执行落地 → 效果验收


🌐 官网 geolook.cc · 🔍 在线演示(只读) · 📹 高清演示视频 (mp4) · 🖼 全部截图
域名生效前可用镜像:geolook.cc · 演示
GEO = 生成式引擎优化(Generative Engine Optimization):让 DeepSeek、豆包、ChatGPT、Perplexity 这些 AI 引擎在回答用户问题时,主动提到并引用你的品牌。不是地理信息,也不是传统 SEO。
一、解决什么问题
越来越多的用户直接问 AI「有哪些好用的 XX 工具」「XX 和 YY 哪个好」。如果你的品牌:
| 问题 | GeoLook 给的答案 |
|---|---|
| AI 根本不提你——搜品类问题时你不在候选集里 | 逐引擎采样真实回答,量化提及率/位次/引用份额,诊断出「完全缺席」还是「竞品主导」 |
| 不知道为什么不提你——AI 是黑盒 | 六维站点体检 + 差距诊断:抓不到正文?缺抽取块?没铺 AI 实际引用的阵地?口径不一致?逐项定位 |
| 知道该做但落不了地——建议一堆,没人执行没人验收 | 生成带验收标准的实施工单,86% 可由程序自动验收(示例项目 18/21),做没做完不靠口头确认 |
| 做了不知道有没有用 | 逐题前后期采样对比 + 任务级 before/after,哪些动作真的让 AI 改了口,有数 |
| 给客户做 GEO 服务,交付难 | 一键产出诊断报告、优化方案、执行方案、工单 CSV、验收表的完整交付包 |
二、功能全景
四段主线 + 运营能力,全部在一个自托管看板里:
现状 · 我在 AI 里什么样
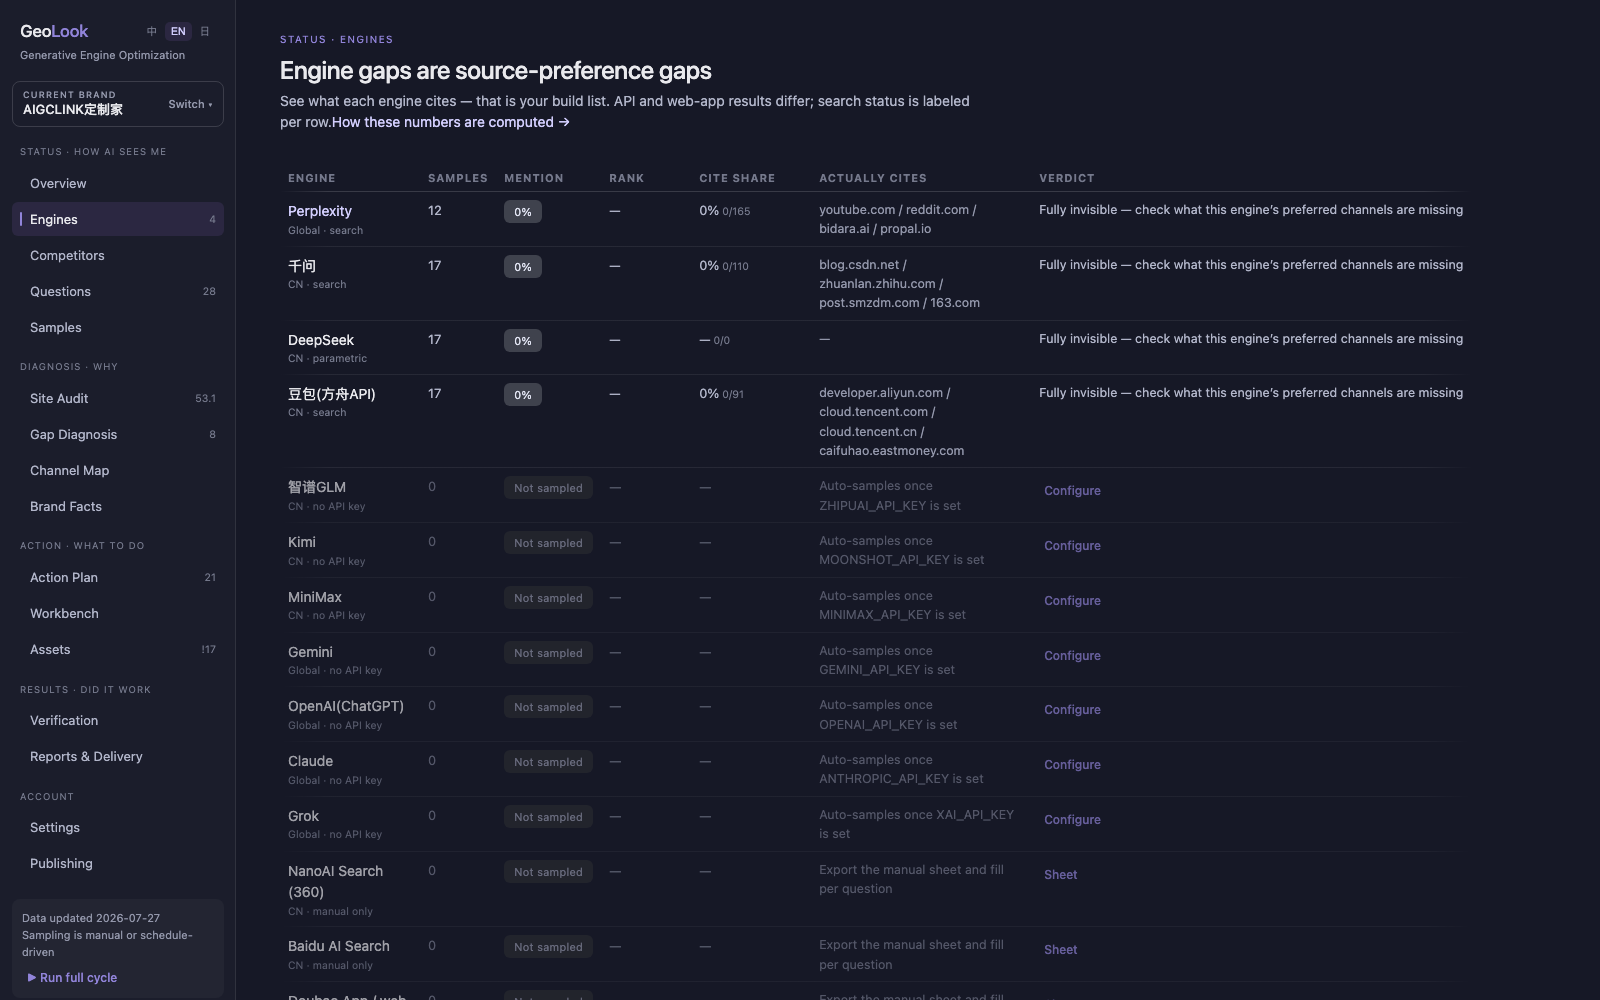
- 引擎表现:国内海外 17 个引擎(10 个 API 自动采样 + 7 个人工采样,含 Google AI Overviews 与秘塔),每个引擎的提及率、提及位次、引用份额、它实际在引用谁、样本回放(真实回答原文,品牌命中高亮)、疑似负面标记
- 品牌提及分布:单引擎与全引擎汇总,回答里你和竞品各占多少(国内/海外分开算)
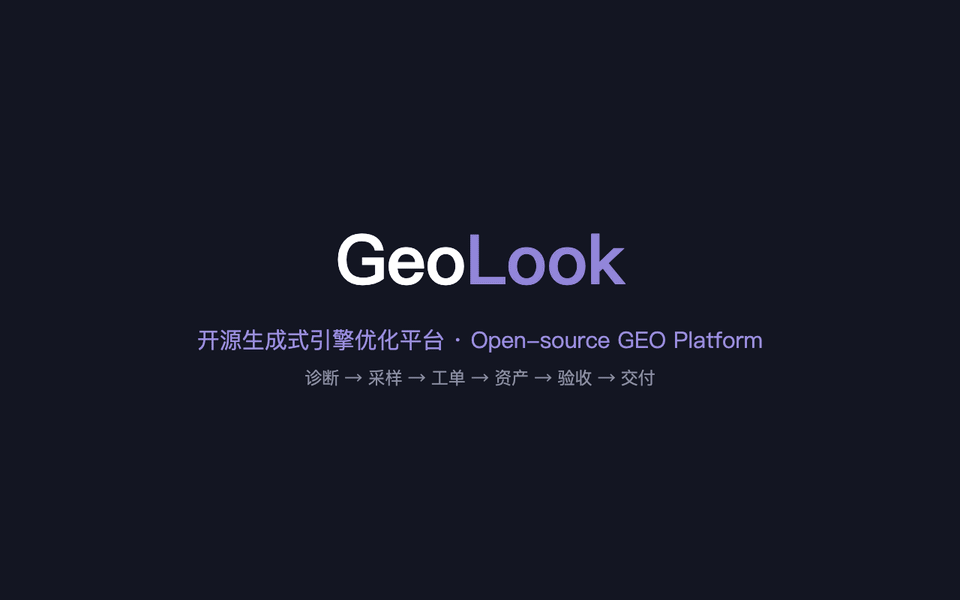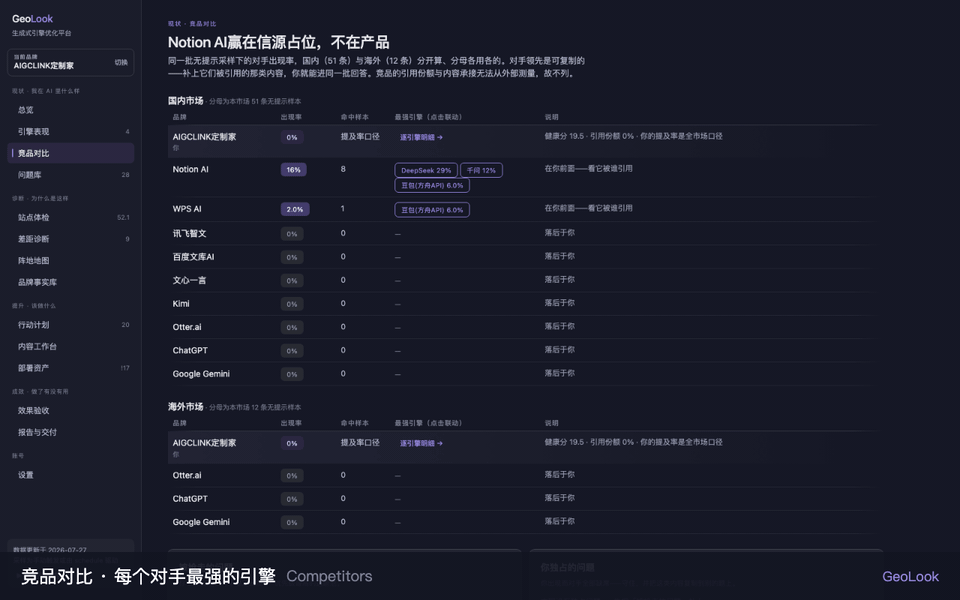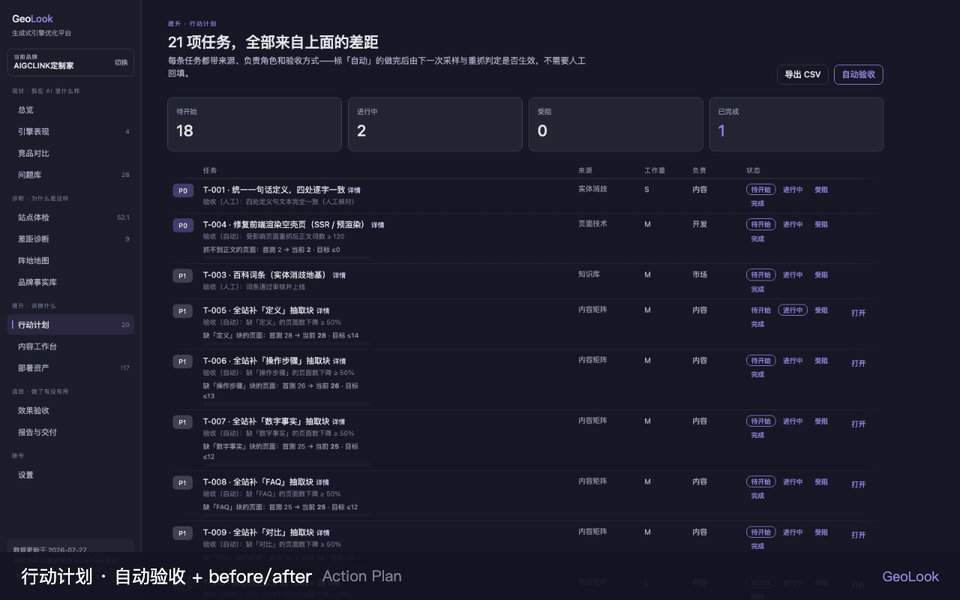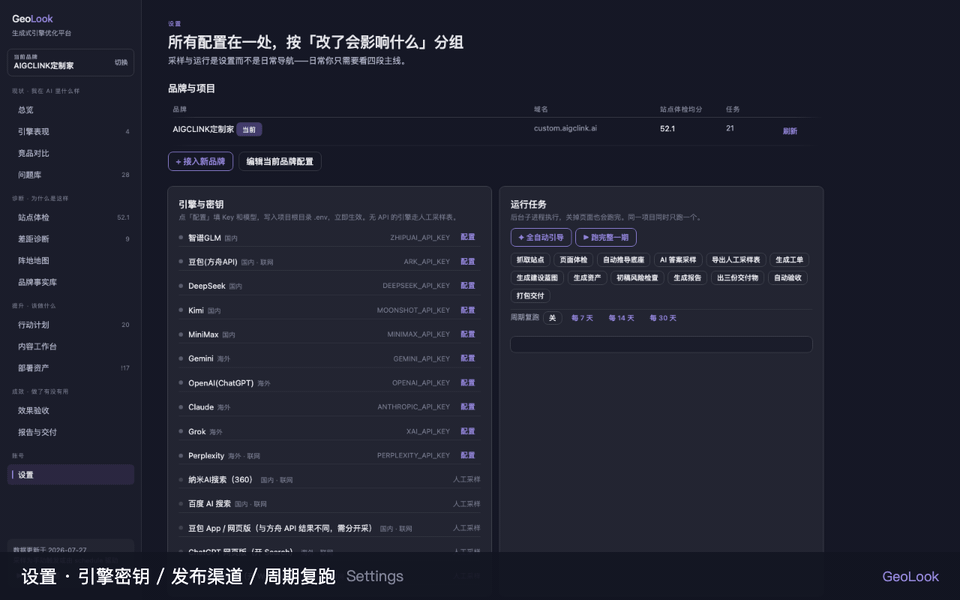
- 竞品对比:同一批无提示样本下的对手出现率;每个对手最强的引擎一键联动;每个对手的信源构成(它被谁引用)与「竞品有、你没有的信源」阵地差集——输给谁升级为输在哪块阵地;「被抢走的问题」「你独占的问题」直接变成选题池
- 问题库:七组问题(推荐/比较/替代/价格/风险/品牌验证/场景),意图分组卡(买家/教育/探测三类,一眼看出哪类问题上最没存在感);每题带诊断分型(疑似负面 > 竞品主导 > 完全缺席 > 排名靠后),点名探测题单独归类不污染指标
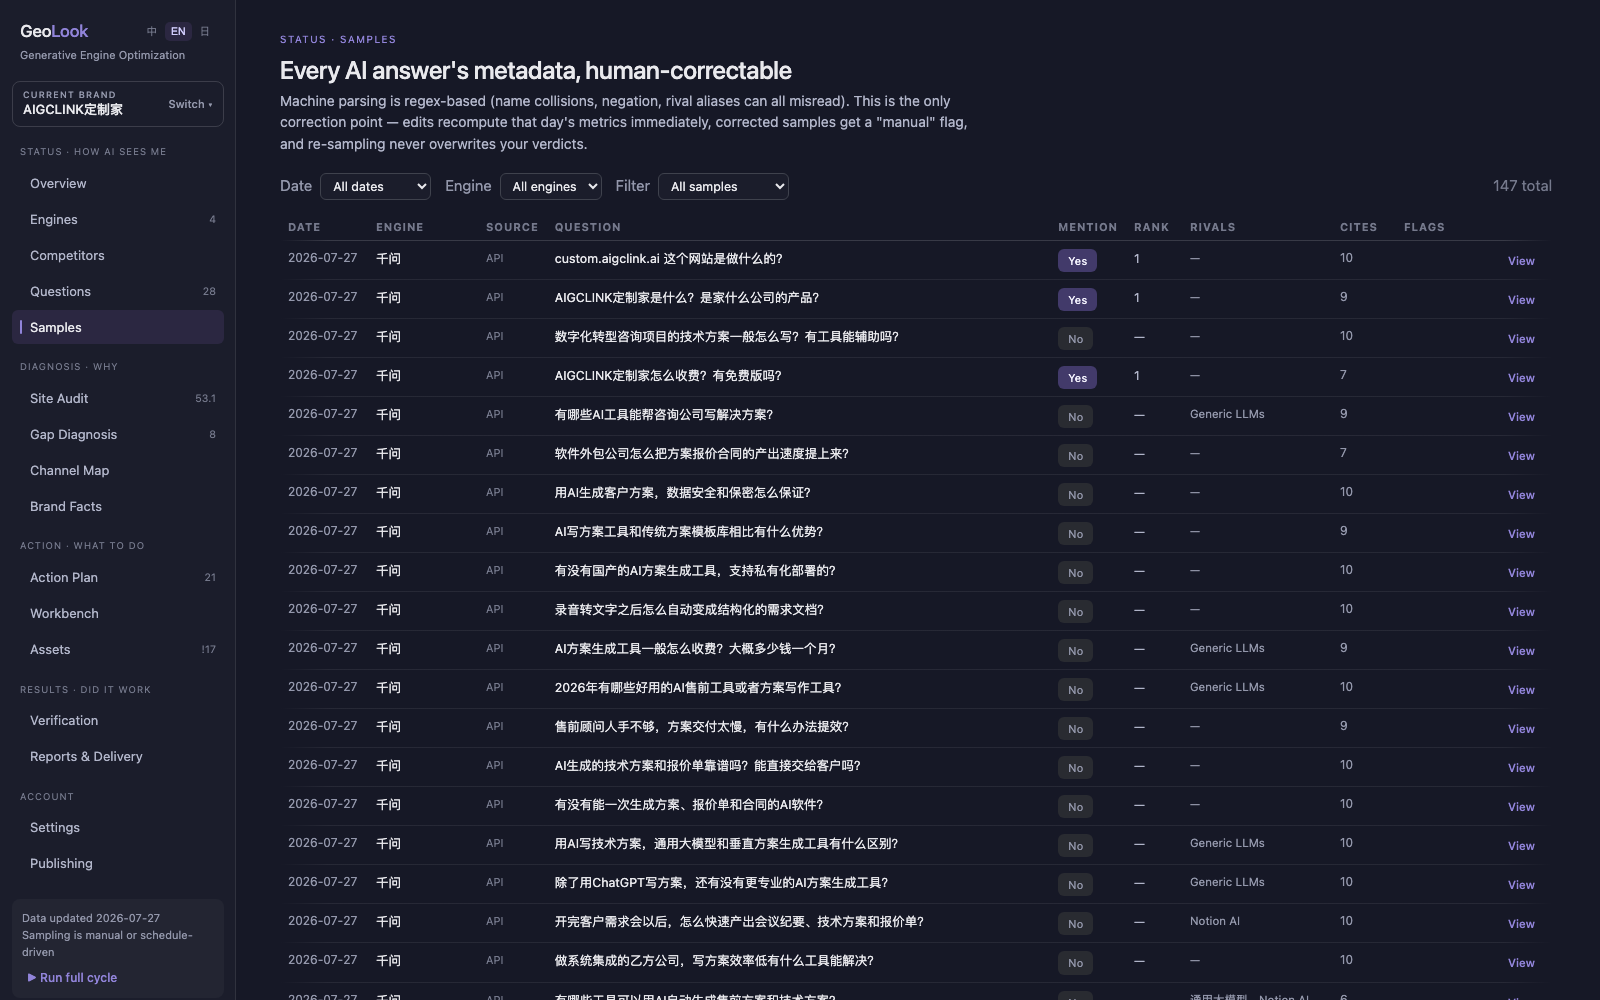
- 样本库:每条 AI 答案的元数据可浏览、可人工复核纠正——正则判读的撞词/否定语境误判在这里修,改完立刻重算指标、重跑不覆盖人工结论;每条样本带引用源站构成(域名 × 次数 · 占比)与采样环境溯源(沙箱/无痕/专用号/个人号,个人号自动降级待复核)
- 拓词选题:以品牌/竞品/品类为词根,拉百度下拉 + Google 补全的真实搜索词扩充选题(免费公开端点,无需 Key);每期快照 diff 标「需求上升」参与选题排序;竞品词根扩出的替代/对比问法直达竞品对比页。只产候选,入库手动勾选,不动指标口径
诊断 · 为什么是这样
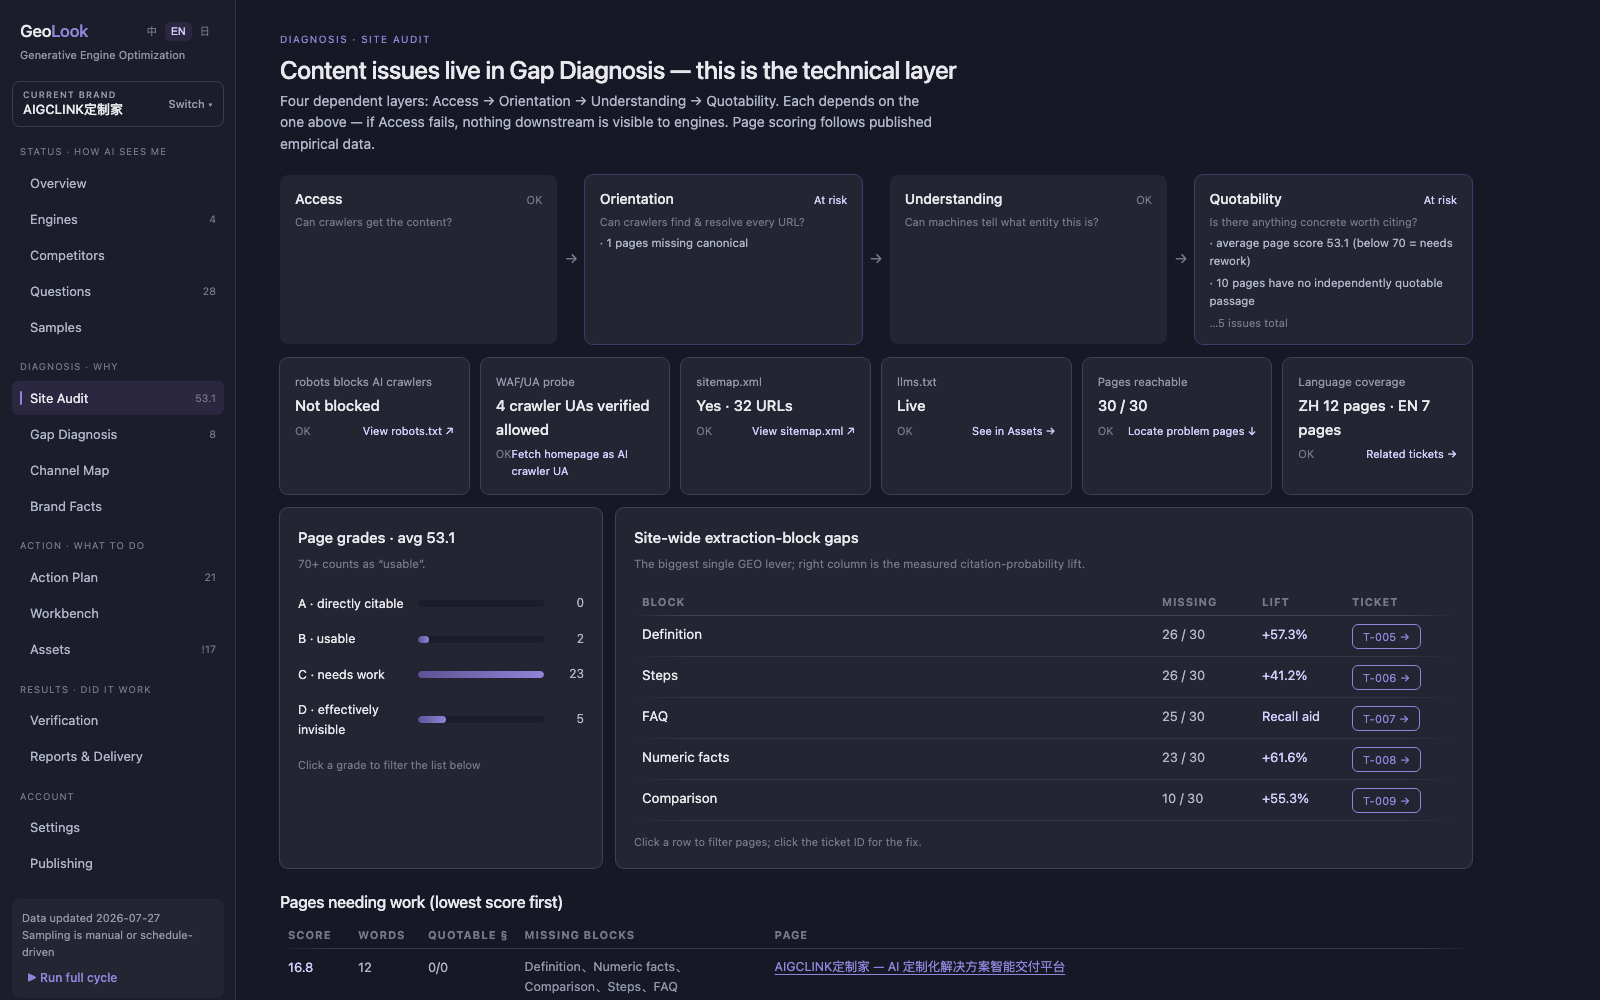
- 站点体检:按「访问 → 定向 → 理解 → 可引用」四层依赖链组织——每层依赖上一层,访问层失败时下游一切优化在引擎侧不可见,修复顺序算给你。访问层远不止查 robots:RFC 9309 规范的 robots 解析(通配符组封禁、多 UA 共享组、specificity 覆盖这些逐行正则漏掉的都能检出)、换真实 AI 爬虫 UA 的 WAF/CDN 差异探测(robots 放行但 CDN 403,浏览器里看不出来)、X-Robots-Tag 头级 noindex、llms.txt 链接有效性、hreflang 覆盖、sitemap 索引污染与重复标题/近重复正文检测;段落级可引分析——检索按段落选材,整页无一段自包含可引的页面会被点名并给出改法。点等级或缺块直接筛选问题页、直达修复工单
- 差距诊断:内容缺口 → 阵地缺口 → 事实偏差,三类按「先修哪个」排序
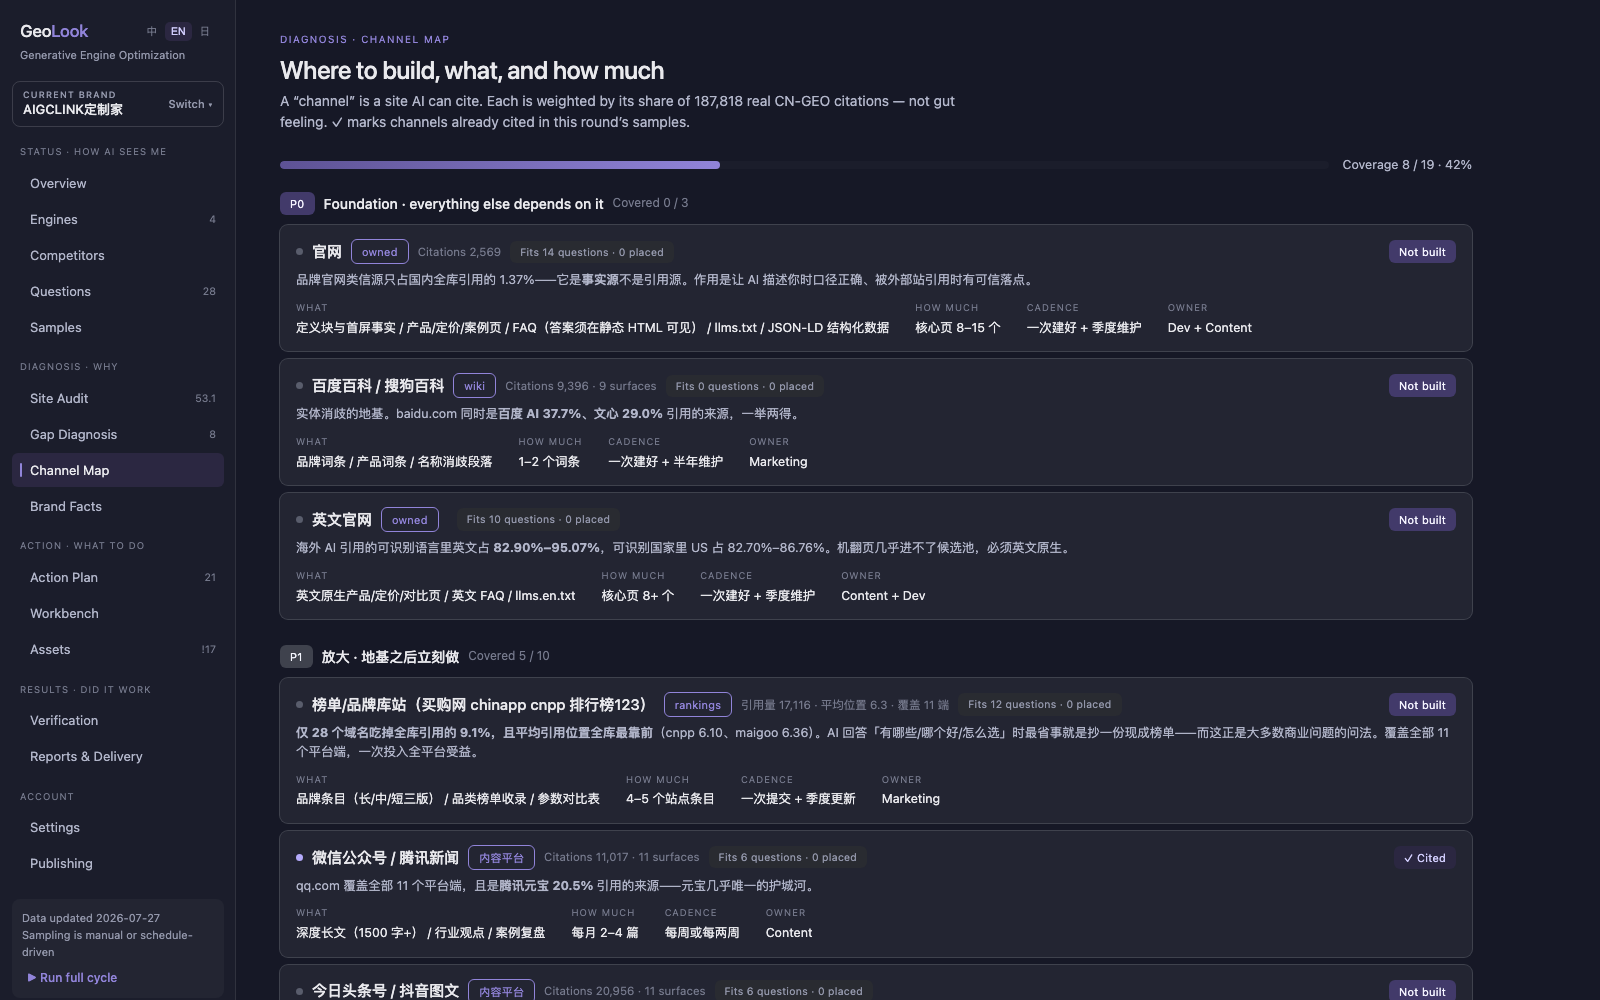
- 阵地地图:19 个阵地(百科/榜单站/公众号/头条/知乎/技术社区/G2/Wikipedia/Reddit/YouTube…)按真实引用语料标注分量与优先级;每个阵地写清建什么、建多少、节奏、谁来做
- 品牌事实库:全站唯一口径来源——llms.txt、JSON-LD、内容草稿都从这里取事实;AI 说法逐条比对,比对过「事实一致性」才进健康分
提升 · 该做什么
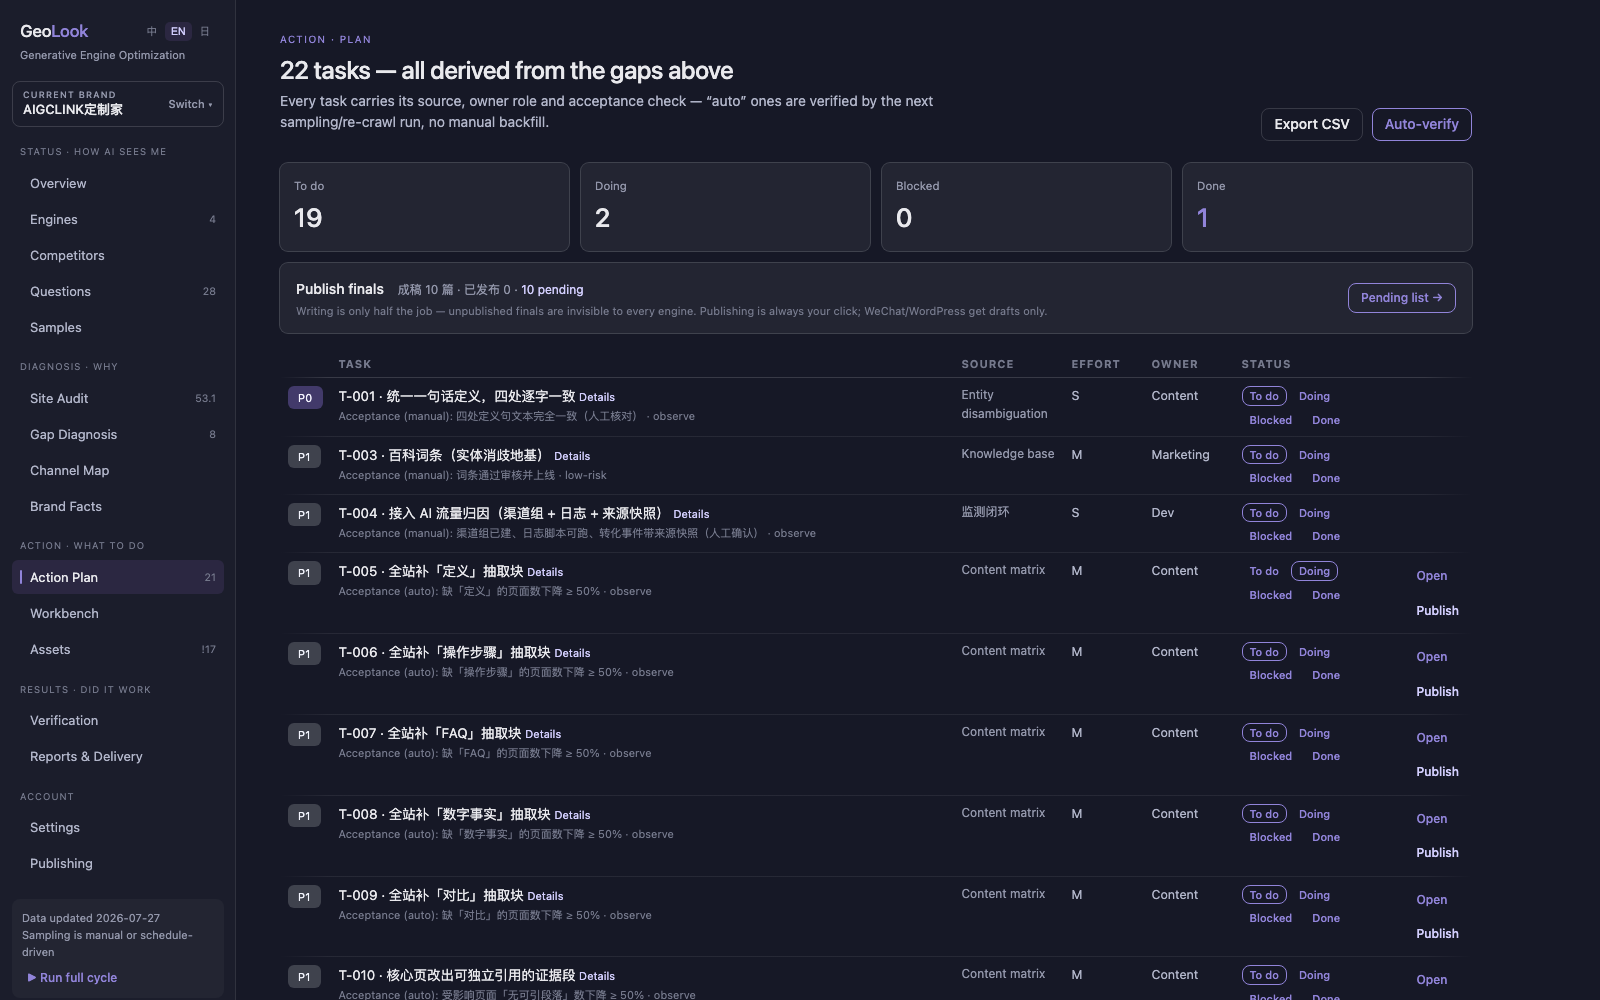
- 行动计划:结构化工单(依据/负责角色/工作量/时间窗口/验收标准)带独立风险分级(低风险快速优化 / 需观察·发布后 7/14/28 天复核 / 高风险技术改造·备份小批量留回滚——优先级说多重要,风险说动手时多小心);标「自动」的由重抓站点 + 下期采样判定;量化工单显示「首测 → 当前 → 目标」进度条,回归自动打回;工单直达它最该写的那道题
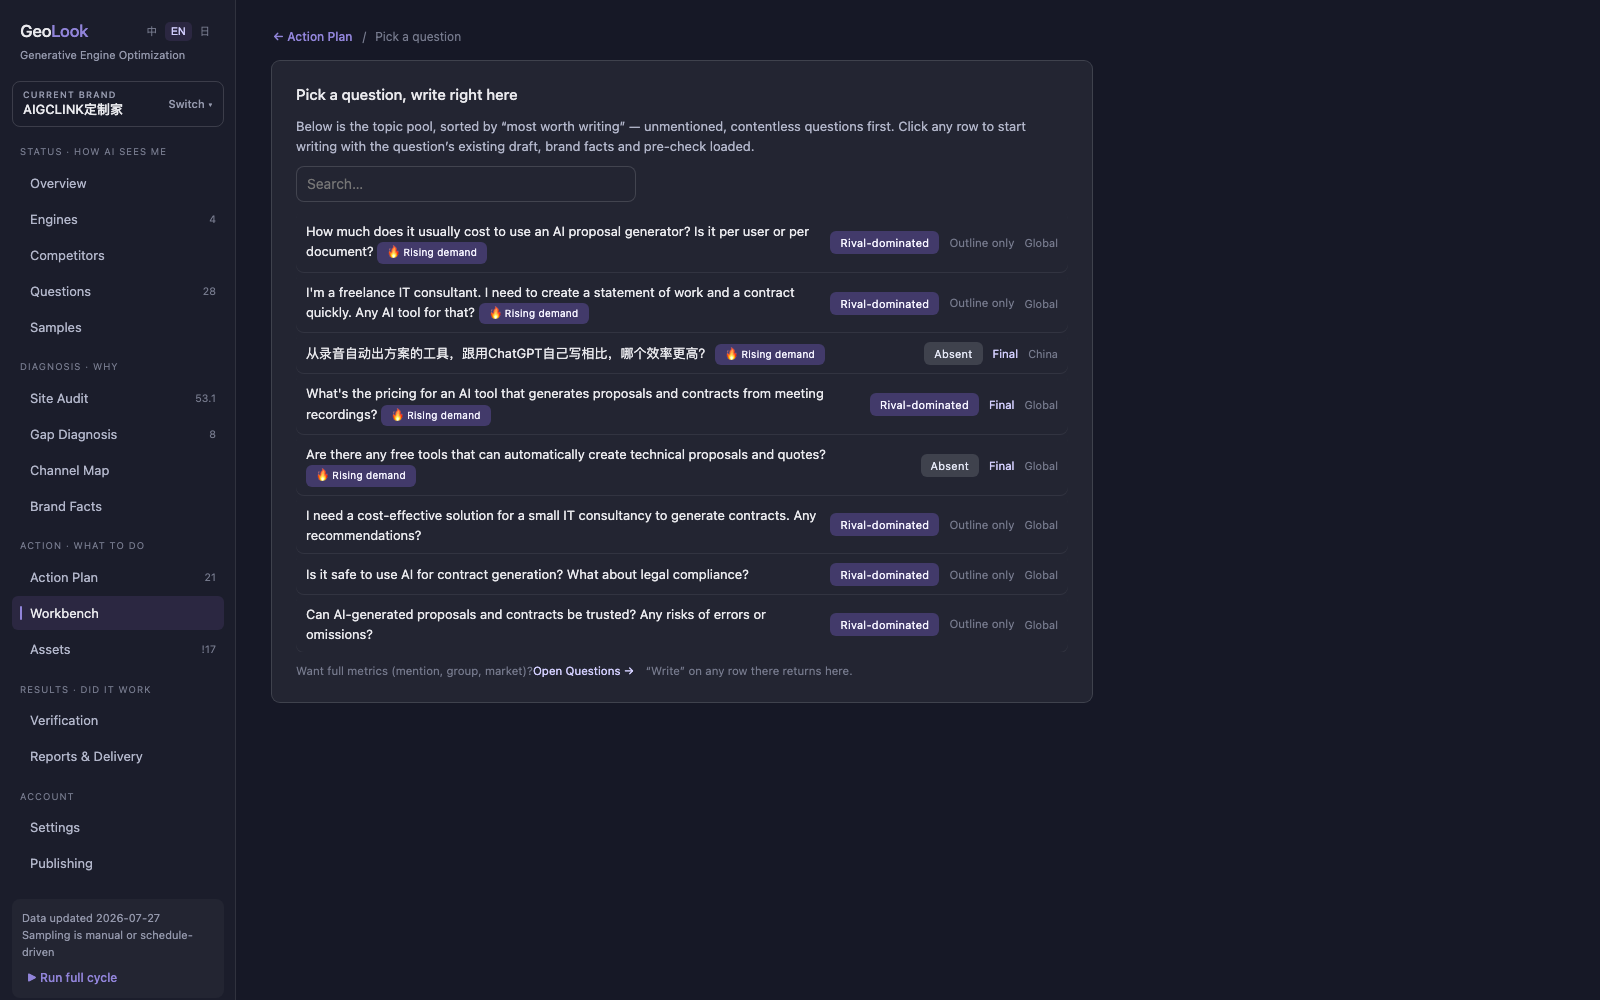
- 内容工作台:选题池按「未提及 + 无内容」排序;写稿时左侧给必含抽取块与品牌事实,右侧实时可被引用度预检;AI 初稿必须过编造风险 lint;分发清单按问题类别匹配目标阵地,铺完打勾
- 部署资产:llms.txt、JSON-LD(Organization/FAQ/Article…)、定义块与 FAQ 的 HTML 片段,每个文件标注去处;AI 流量归因包(GA4「AI 引擎」渠道组正则 + 服务器日志统计脚本 + 来源快照说明,把闭环从「被引用」延伸到「带来转化」);DEPLOY.md 给开发的部署清单含验收标准
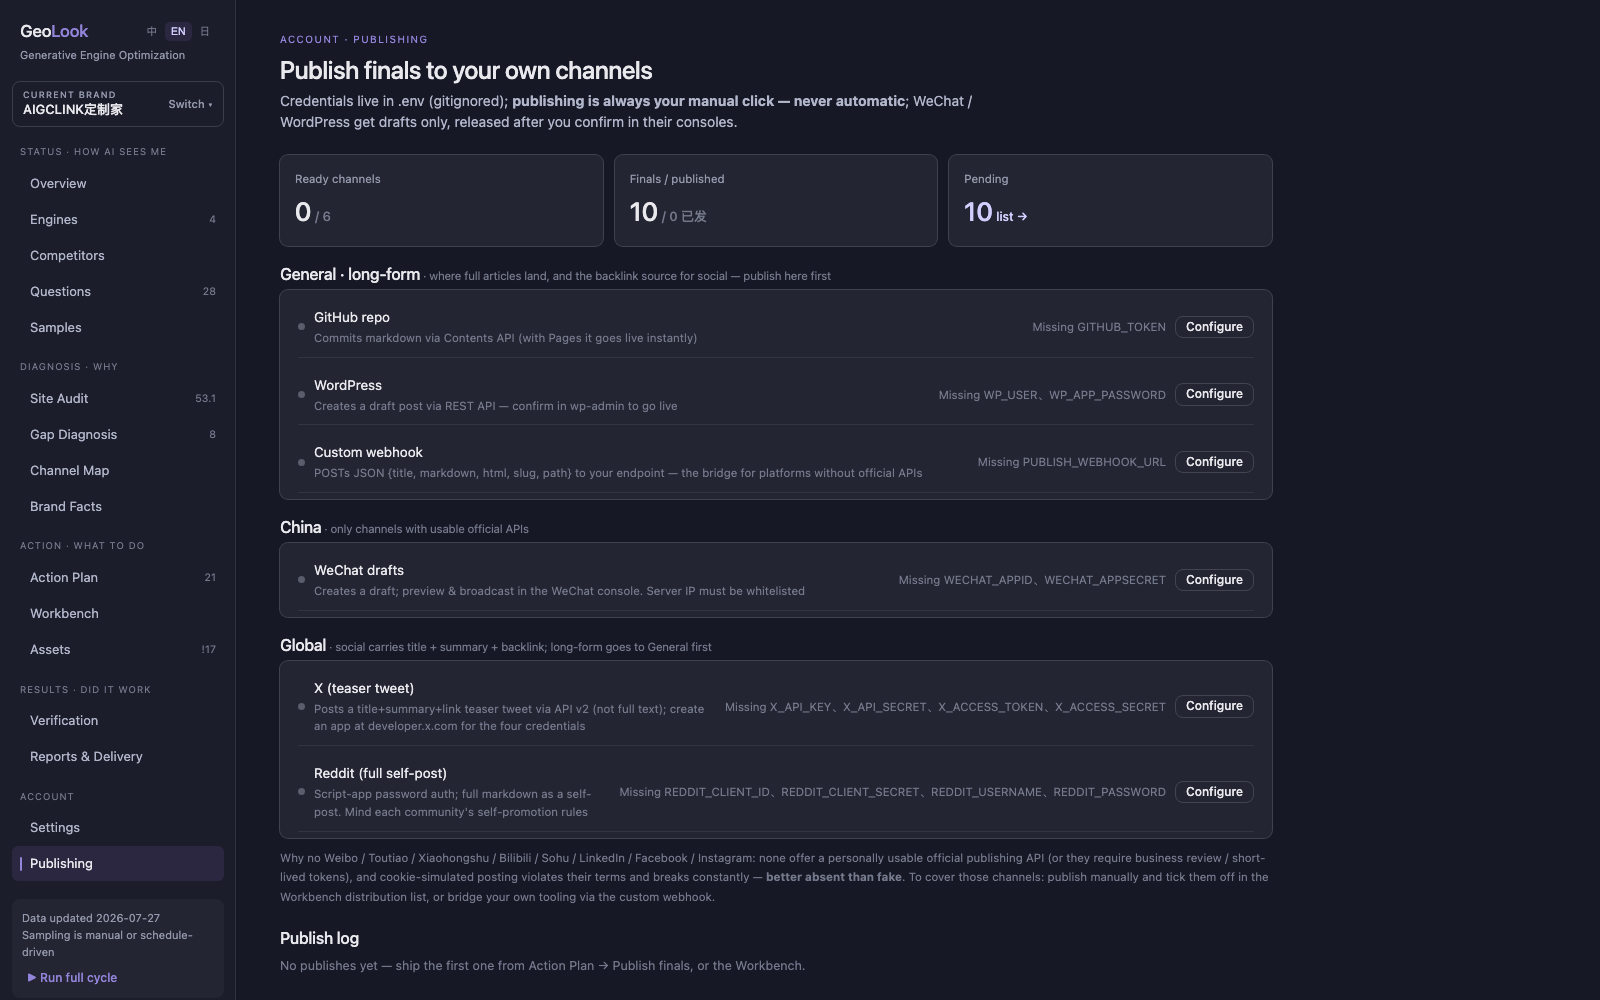
- 发布渠道:按通用 / 国内 / 海外分组——GitHub、WordPress 草稿、公众号草稿箱、Webhook,加真实接入的 X(标题+摘要+自动回链的引流推文)与 Reddit(markdown 全文自帖);每个渠道配置弹窗内置分步教程与申请页直达;每篇成稿可勾选多渠道一次发布,发布状态同步回行动计划、待发布清单与问题库。没有个人可用官方 API 的平台(微博/小红书/头条/B站/LinkedIn/Facebook/Instagram)刻意不接——宁可不接不做假接入,页面写明原因并给 Webhook 桥接。凭证在本地
.env,每次发布逐篇人工确认,无任何自动外发路径
成效 · 做了有没有用
- 效果验收:逐题前后期提及率对比(全部/国内/海外分 tab)、任务级 before/after、验收历史
- 报告与交付:给老板的一页结论、给执行团队的分批执行方案、给客户的完整交付包(HTML + CSV)
运营
- 周期复跑:每 7/14/30 天自动跑完整一期;
./scripts/service.sh install把看板注册为 macOS 常驻服务(登录自启、崩溃自动拉起、关终端不停),到期必跑,真正无人值守 - 多品牌:一个实例管多个项目,数据互相隔离,侧栏一键切换
- 人工采样闭环:无 API 的引擎导出采样表(
--intent buyer --limit 20出每周买家意图轻量周检表),人工/浏览器填完回灌,与自动采样同一套指标
采样助手(Chrome 插件,extension/)
无 API 的引擎恰恰是真实用户最多的入口。侧栏载入买家意图队列(按分组分节)→ 填入问题(默认手动模式回车由你按)→ 答案生成完一键提取全文与全部引用链接 → 回传本机看板入库为 A 级样本——每周核查从半小时压到十分钟。可显式开启「自动跑队列」(人在场、限速、上限 20 题、撞验证码/风控立刻停,ToS 风险在其 README 如实写明)。配套 sandbox.sh:一条命令起一次性干净沙箱(无历史无 Cookie、插件自动装载)或持久登录沙箱——「陌生买家看到什么」的采样卫生从纪律变成一条命令。
三、和市面 GEO 工具的区别
市面上的 GEO 产品绝大多数是监测型 SaaS:告诉你提及率和排名,按月收订阅费,数据在别人云上。GeoLook 的定位是实施平台,差别在这几处:
| 典型 GEO 监测 SaaS | GeoLook | |
|---|---|---|
| 闭环深度 | 监测 + 建议 | 监测 → 诊断 → 工单 → 资产 → 自动验收 → 交付,落地全流程 |
| 验收方式 | 无(或人工回填) | 程序判定:重抓站点 + 下期采样自动验收,回归自动打回 |
| 指标口径 | 黑盒算法 | 全部可复现,界面里点开「这些数字怎么来的」查完整口径;算不出显示「未测」,不编数 |
| 中文市场 | 多为海外引擎 | 国内引擎矩阵(GLM/豆包/DeepSeek/Kimi/MiniMax/纳米/百度AI)+ 按国内引用语料标定的阵地(百科/榜单站/公众号/头条…),国内海外分开出题分开算 |
| 评分依据 | 经验规则 | 锚定公开实证数据:602 条 Prompt / 21,143 条引用 / CN-GEO 187,818 条国内去重引用(references/) |
| 数据归属 | 厂商云端 | 全部在你本机 work/ 目录(JSON/Markdown),git 一下就是备份 |
| 成本 | 按月订阅 | 开源免费,只花你自己的引擎 API 采样费(可为零:纯人工采样也能跑) |
| 交付能力 | 截图仪表盘 | 直接产出可发客户的诊断报告/优化方案/执行方案/工单表,适合代理商与顾问 |
诚实说明边界:GeoLook 是单机工具,没有账号体系和团队协作;采样频率与样本量由你自己的 API 预算决定;「疑似负面」等判定是线索提示,定性仍需人工复核——这些是刻意的设计取舍,不是还没做完。
四、部署教程
环境要求
- macOS 或 Linux(Windows 请用 WSL;代码用了
fcntl文件锁) - Python 3.9+
- 唯三的第三方依赖:
requests、beautifulsoup4、lxml
三步跑起来
# 1. 克隆并安装依赖
git clone https://github.com/aigclink/geolook.git
cd geolook
pip3 install requests beautifulsoup4 lxml

# 2. 启动看板(自动打开浏览器)
python3 scripts/geo.py ui        # → http://127.0.0.1:8765
#    macOS 可注册为常驻服务:./scripts/service.sh install
#   (登录自启、崩溃自动拉起、关终端不停)

# 3.(可选)配置引擎 API Key
#    方式 A:看板「设置 → 引擎与密钥」里点「配置」填入,自动写进本地 .env
#    方式 B:cp .env.example .env 后手动编辑
一个 Key 都不配也能用:自动采样会跳过,改用「导出人工采样表 → 人工/浏览器采样 → 回灌」的流程;抓站、体检、工单、资产等功能不依赖任何 Key。配一个国内引擎 Key(如 DeepSeek/GLM)即可解锁「自动推导问题库/品牌事实」和「AI 初稿」。
服务器/远程部署
服务默认只绑定 127.0.0.1。要远程访问,两种方式:
# 方式 A(推荐):SSH 隧道,不暴露任何端口
ssh -N -L 8765:127.0.0.1:8765 user@your-server
# 然后本地浏览器打开 http://127.0.0.1:8765

# 方式 B:绑定公网 + 访问令牌(两个变量缺一不可,不设令牌会拒绝启动)
export GEOLOOK_TOKEN=$(openssl rand -hex 16)
export GEOLOOK_HOST=0.0.0.0
python3 scripts/geo.py ui
# 浏览器首次访问输入令牌(或打开 http://server:8765/?token=令牌),
# 之后凭 HttpOnly cookie 访问;API 调用带 X-Geolook-Token 头
公网部署建议再套一层 HTTPS 反向代理(nginx/caddy),令牌走明文 HTTP 会被中间人看到。.env 与 work/ 含密钥和项目数据,注意文件权限。
升级
git pull # 数据在 work/ 与 .env,均被 gitignore,升级不影响
五、使用教程
路线 A:一条命令全自动(约 10–30 分钟)
python3 scripts/geo.py new --url https://example.com --market both
--market 取 cn / global / both。九步自动完成:抓站 → 体检 → 推导品牌事实/竞品/问题库 → 逐引擎采样 → 生成工单 → 产出资产 → 报告 → 自动验收 → 交付包。产出在 work/<项目>/delivery/<日期>/。
路线 B:看板逐步走(推荐首次使用)
第 1 步 · 接入品牌:python3 scripts/geo.py ui → 首次进入自动到接入引导,填官网域名、选目标市场,点「创建并开始自动引导」。后台自动跑完首期(可关页面,任务照跑)。
第 2 步 · 人工核对底座(重要,10 分钟):自动推导只从官网正文抽取,抽不到的标「待确认」。到「品牌事实库」核对口径、补别名与关键数字;到「问题库」检查题目是否像真实用户问法(漏配别名会低估提及率)。
第 3 步 · 看现状:「总览」一句结论 + 健康分五项;「引擎表现」逐引擎下钻,点样本回放看 AI 原话,发现说错的点「记一条事实偏差」;「竞品对比」看对手最强的引擎——那就是你要去建设的信源。
第 4 步 · 看诊断:「站点体检」技术层(点缺块直达修复工单)→「差距诊断」内容/阵地/事实三类缺口 →「阵地地图」每个阵地点开看建设方案(建什么/建多少/节奏/谁来做)。
第 5 步 · 执行:
- 「行动计划」按 P0→P1 领工单,点标题看详情(为什么做/具体怎么干/怎么算做完)
- 「内容工作台」从选题池选题 → 按大纲写稿(右侧预检达到 B 以上)→「发布为成稿」→ 分发清单告诉你该铺到哪些阵地,铺完打勾
- 「部署资产」把 llms.txt 传网站根目录、JSON-LD 贴进
<head>、片段贴进模板(每个文件顶部写了去处,完整清单见 DEPLOY.md)
第 6 步 · 验收:「设置 → 运行任务」点「自动验收」(重抓站点判定工单);下一期采样后到「效果验收」看逐题 before/after。
第 7 步 · 长期运营:「设置」开启周期复跑(每 7/14/30 天自动跑一期);「报告与交付」生成月报与客户交付包。
没有官网的商品/品牌
没有自有网站也能做 GEO——官网只占国内引用的 1.37%,AI 可见性主要靠外部阵地:
python3 scripts/geo.py init --no-site --name "商品名" --materials 介绍材料.md --market cn
介绍材料取代官网正文,成为品牌事实、竞品与问题库的推导底座(不给 --materials
会生成模板让你填)。差异只有三处:抓取/体检自动跳过、llms.txt 与 JSON-LD 不产出
(需挂自有域名)、引用官网率显示「不适用」而非 0。其余全部照常。
无 API 引擎的人工采样
python3 scripts/geo.py sample-sheet --slug <项目>    # 导出采样表(含每题指引)
python3 scripts/geo.py sample-sheet --slug <项目> --intent buyer --limit 20  # 每周买家意图周检表
# 人工/浏览器在纳米AI、百度AI、ChatGPT网页版等提问并粘贴回答
python3 scripts/geo.py sample-import --slug <项目> --file <采样表>
也可在看板「设置 → 运行任务」里点「导出人工采样表」,「引擎表现」页导入。
CLI 速查
| 命令 | 作用 |
|---|---|
new / serve / cycle |
全自动新项目 / 已有项目跑完整一期 / 轻量循环 |
ui |
全流程看板 |
bootstrap / crawl / audit |
推导底座 / 抓站 / 六维打分 |
sample / sample-sheet / sample-import |
API 采样 / 人工采样表导出与回灌 |
plan / generate / lint |
生成工单 / 生成资产(--draft 出初稿)/ 初稿风险检查 |
verify / report / deliverables / deliver |
自动验收 / 报告 / 三份交付物 / 客户交付包 |
publish / task / status / list |
发布成稿 / 工单状态 / 项目看板 / 项目列表 |
每条命令 --help 有完整参数。
FAQ
Q:AI 回答每次都不一样,采样结果怎么保证稳定?
单条 AI 回答天然有随机性,所以 GeoLook 的指标从不看单条回答,稳定性靠四层机制:
- 聚合口径——提及率等指标是「几十道题 × 多个引擎」的比例,单题抖动会被摊平;
- 固定变量——每个引擎的采样模型版本固定(设置里可查可改),问题库固定,同一套题跨期复用,变的只有时间;
- 多轮加密——
sample --repeat N支持每题重复采样,预算够可以加密样本量; - 归因纪律——界面里明确标注「单期波动默认只作观察相关」「下降未必是变差——采样有噪声」,连续两期同向变化才当趋势;工单验收靠重抓站点这类确定性信号,不单赌采样。
诚实说:它测的是分布不是定值——这恰恰更接近真实用户体验,因为真实用户每次问 AI,得到的本来就是随机采样的回答。
评分依据
六个体检维度全部锚在公开实证数据上,scripts/audit.py 是 references/method.md 的代码实现。几条最有用的结论:
- 高影响力页面平均 1,943 词,低分页仅 170 词(11.4×)
- 含数字 +61.6%、定义 +57.3%、对比 +55.3%、how-to +41.2% 被引用概率
- 纯 Q&A 排版反而 −5.7%——排成问答样子没用
- 对题性是最强预测因子(r = 0.432),高于权威度
- 品牌官网类信源只占国内全库引用的 1.37%——官网是事实源不是引用源,外部阵地才是引用来源
设计原则与安全边界
- 单机自托管:标准库
http.server只绑 127.0.0.1;无数据库无账号,数据即文件 - 宁缺毋滥:品牌事实只从官网正文抽取,抽不到标「待确认」;竞品严禁发明名字;AI 初稿必须过 lint 并人工核实
- 验收即产品:能自动判定的绝不靠人回填
- 发布永远手动:渠道凭证在本地
.env(权限 600),每次发布人工点击确认;公众号/WordPress 只进草稿箱
与 Claude Code 集成(可选)
本仓库同时是一个 Claude Code 技能(SKILL.md):放进技能目录后对 Claude 说「给 example.com 做 GEO」即可驱动全流程。不用 Claude 也完全可用——所有脚本都是普通 CLI。
目录结构
scripts/          全部逻辑(geo.py CLI · dashboard.py 看板服务 · ui.html 单页前端 · service.sh 常驻服务)
extension/        Chrome 采样助手插件 + sandbox.sh 沙箱 + 自带 e2e 测试
references/       方法论:采样纪律、内容模式实测、归因口径、国内外平台引用结构
tests/            单元测试
work/<slug>/      每个项目的全部数据(gitignore,不出本机)
docs/             截图与 40 秒演示视频
致谢
联系我
问题、建议或合作:邮箱 [email protected],或提 issue。
License
探索相关项目
affaan-m/ECC
智能体执行与控制框架的性能优化系统。面向 Claude Code、Codex、Opencode、Cursor 等,涵盖技能、本能、记忆、安全与研究优先的开发。
300,313 星标NousResearch/hermes-agent
与你一同成长的智能体
262,134 星标multica-ai/andrej-karpathy-skills
一个用于改进 Claude Code 行为的 CLAUDE.md 文件,源自 Andrej Karpathy 对 LLM 编程陷阱的观察。
231,460 星标firecrawl/firecrawl
借助来自网络及其他来源的数据,强化你的 AI 智能体。正在构建面向超级智能的资料库。🔥
200,178 星标