
Zleap-AI/SAG has 2,787 GitHub stars and 201 forks. GitHot measured +14 stars in 24 hours and +141 in 7 days. Last checked 2026-11-08 14:03 UTC. Last push 2026-11-01.
A new SOTA for RAG — an original retrieval architecture and an open-source knowledge base for humans and agents.
实测星标增长
- 24小时
- +14
- 7天
- +141
- 15天
- 更新延迟
- 1个月
- 更新延迟
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
README-CN.md
原文
SAG
English · 简体中文


从今天起,你只需要这一个知识库应用
基于 SOTA 的 SAG 架构,把分散的文档与数据变成可搜索、可关联、可追溯的知识。
https://github.com/user-attachments/assets/a080ad1a-5c08-4213-acfa-a226e3c0f68a
目录
社区交流 · 项目介绍 · 技术原理 · 用户指南 · 开发者指南
项目介绍
更新日志
版本发布记录与各版本变更请查看 CHANGELOG.md。
一分钟了解 SAG
SAG 不是传统 RAG 与 GraphRAG 的融合,而是一套替代二者的原创检索架构。
它通过 event-entity 索引与查询时动态超边,在一个系统中同时实现语义检索与关系推理,不再需要维护两套 RAG 系统或拼接两路召回结果。
在 HotpotQA、2WikiMultiHopQA 和 MuSiQue 上的实验表明,SAG 在每个基准测试中均取得最佳的检索与端到端 QA 性能,实现 RAG 领域的新 SOTA。
本项目是基于 SAG 制作的面向个人与 Agent 的完整知识库应用:
信源与文档 → 结构化知识 → 检索与原文溯源 → 带引用的 Agent 回答 → 通过 API 或 MCP 复用
文档只需上传一次。SAG 会自动解析、分块、向量化,抽取事件与实体,并让每一条检索结果都能回到原文。你可以跨信源搜索、查看 event-entity 图谱、进行带引用的问答,也可以把同一份知识开放给其他应用。
| 能力 | 解决的问题 |
|---|---|
| 知识导入 | 文件与网页信源、文档解析、分块、向量化、事件/实体抽取、后台处理 |
| 检索 | 跨信源或指定信源检索,支持快速(vector / multi_es_fast)、精确(multi)与可选 JEV 精排(multi_jev)模式 |
| 原文溯源 | 每条检索结果和引用都能打开对应的原文块 |
| 知识图谱 | 查看事件、实体及其可查询的关联关系 |
| Agent 对话 | 基于指定信源进行多轮问答,并提供可点击引用 |
| 对外集成 | 自托管 REST/OpenAPI、OpenAI 兼容接口、MCP 与 zleap-sag Python 包 |
产品默认面向本地单用户场景。它使用 SQLite 与 LanceDB 即可启动,不依赖外部数据库,同时保留迁移至 PostgreSQL/pgvector 等生产后端的路径。
技术原理
论文
SAG: SQL-Retrieval Augmented Generation with Query-Time Dynamic Hyperedges
Yuchao Wu*、Junqin Li、XingCheng Liang、Yongjie Chen、Yinghao Liang、Linyuan Mo、Guanxian Li
一套原创的第三种架构
传统稠密 RAG 主要依靠语义相似度召回文本块。GraphRAG 在此基础上引入离线图谱构建,却要承担三元组抽取、实体合并、关系归一、全局维护和增量更新困难等成本。
SAG 不是对这两套系统的封装或组合。它用自己的数据模型和执行路径替代了这种选型:
chunk → 一个语义完整的 event
chunk → 多个用于索引的 entities
event ↔ entities → 一条潜在超边
- **事件(event)**承载一个 chunk 的完整语义,不再被拆成彼此独立的三元组。
- **实体(entity)**只负责索引和扩展,不替代事件所承载的完整含义。
- 查询时动态超边只在检索发生时,通过 SQL 将共享实体的事件连接成当前查询需要的局部结构。SAG 不预先构建、也不全局维护这些超边。
- 原文证据始终是输出边界。被选中的事件最终映射回原始 chunk,用于生成回答和引用。
SAG 内部的语义路径和结构路径都是 SAG 自己检索管线的组成部分,并不是一套传统 RAG 服务和一套 GraphRAG 服务同时运行。
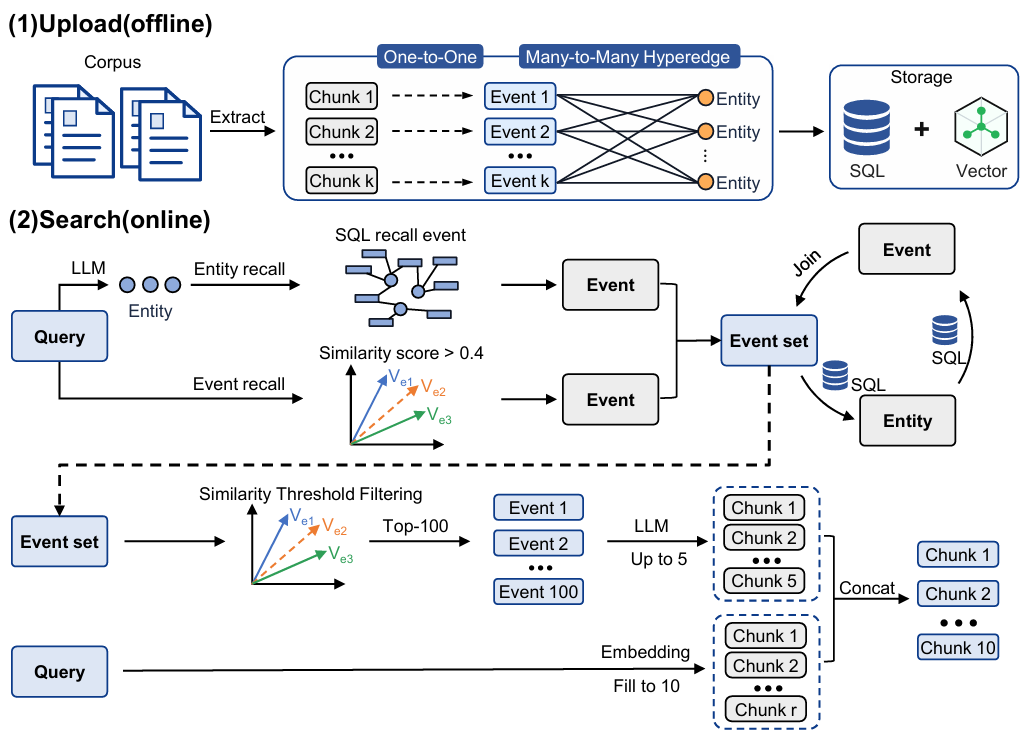
检索流程
离线索引
- 将文档解析为语义连贯的 chunks。
- 从每个 chunk 并行抽取一个事件和多个实体。
- 将 chunks、事件、实体和 event-entity 关联写入关系型存储。
- 将 chunk、事件和实体表示写入向量与全文索引。
在线检索
- 通过语义与词法信号找到种子实体和事件。
- 使用 SQL 沿共享实体扩展种子事件,形成局部候选空间。
- 只实例化当前查询需要的超边,不进行全局图遍历或重建。
- 从事件候选与直接 chunk 候选中选出最强证据,去重后返回原文块。
因此,增量写入不需要重算全局图谱。每个新 chunk 只需加入自己的事件、实体和关联即可。
RAG 领域新 SOTA
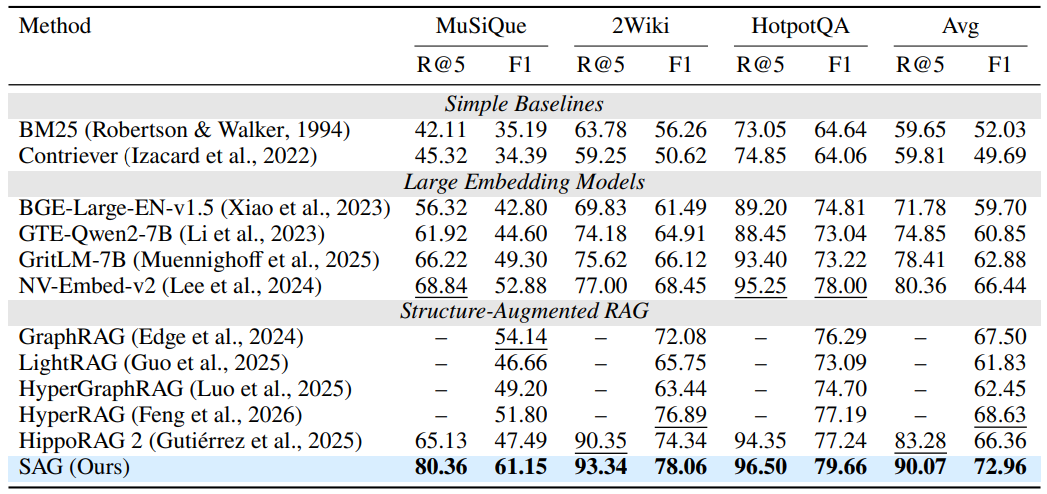
在相同的 BGE-Large-EN-v1.5 Embedding 与 Qwen3.6-Flash LLM 配置下,SAG 在 HotpotQA、2WikiMultiHopQA 和 MuSiQue 的每个基准测试中均取得最佳的检索与端到端 QA 性能。
- SAG 在三个数据集上的平均 Recall@5 和 F1 为 90.07%/72.96%,相比最强基准分别提升 6.79/4.33 个百分点。
- 在最具挑战的 MuSiQue 上,Recall@5 和 F1 较各指标的最强基准分别提升 11.52/7.01 个百分点。
完整跑分如下:
完整方法与复现脚本见论文和 SAG-Benchmark。
用户指南
桌面客户端(最省事)
从 GitHub Releases 下载最新桌面安装包:
| 平台 | 下载文件 | 更新方式 |
|---|---|---|
| macOS 15+,Apple Silicon | SAG-*-mac-arm64.dmg |
已签名、公证;应用内更新由用户分别确认下载和安装 |
| Windows 10/11,x64 | SAG-Setup-*-win-x64.exe |
暂不签名,Windows 可能提示“未知发布者”;应用内更新由用户分别确认下载和安装 |
桌面客户端已经包含 Web 工作台和本地知识后端,用户无需安装 Python、Node.js 或数据库。整包更新不会覆盖系统应用数据目录中的知识库与上传文件;每个 Release 同时提供 SHA256SUMS.txt 完整性校验。
检测到不兼容的旧知识数据时,SAG 会先保持旧数据不变,直到你确认备份并创建全新知识库。SAG 不会自动迁移或合并旧知识库;完成设置后需要重新上传文档。备份可供人工恢复。账号和模型配置会保留,但旧知识库、文档、智能体、会话及关联任务记录不会出现在新工作区中。当前格式的工作区继续使用原数据目录。
快速开始(Docker,自托管)
准备 Docker Desktop,或 Docker Engine 与 Compose v2。
git clone https://github.com/Zleap-AI/SAG.git
cd SAG
docker compose up -d --build
启动应用不需要提前准备 API Key、Python、Node 或外部数据库。两个服务健康后打开:
- Web 应用:http://localhost:3000
- API 文档:http://localhost:8000/docs
首次使用:
- 填写名字,创建或恢复本地身份。
- 选择 302.AI 或 DeepSeek 快速配置,也可进入 设置 → 模型自行配置模型连接。
- 创建信源并上传文档,等待状态变为就绪。
- 开始检索、打开原文,或直接进行带引用的对话。
DeepSeek 使用 Flash 非思考模式。两种快速配置均可选择 302.AI、智谱或阿里云百炼的向量服务,使用不同厂商时需分别填写 Key。
没有模型密钥时,界面和服务仍可启动。Embedding 用于索引与向量检索;LLM 用于事件抽取、查询理解和生成回答。
模型配置优先级
Docker Compose 或 .env 中的 SAG_LLM_* 用于提供首次启动时的模型默认值。管理员在 Web 设置页保存模型配置后,后续抽取和生成任务会直接使用已持久化的设置,无需重启服务。
新配置入口建议生成模型 qwen3.8-flash、向量模型 Qwen/Qwen3-Embedding-4B。升级会保留已保存的模型设置和显式环境配置;未显式设置生成模型的部署仍沿用原运行默认值 qwen3.6-flash。升级已有 BGE 索引时,请保留 SAG_EMBEDDING_MODEL=bge-large-en-v1.5;如需切换模型,请先完成已有索引文档的删除,再更换模型并重新导入。
如需由部署环境强制统一配置,请设置 SAG_LOCK_LLM_CONFIG=true。SAG 会在设置页明确显示生成模型字段已锁定,并持续使用 SAG_LLM_* 的值。此时请修改 Docker Compose 或 .env,再重新创建 API 容器使改动生效。API Key 始终由部署环境管理,Settings API 不会返回密钥明文。
如需分别配置聊天和查询端点,可以在同一模型设置页启用 Chatbot LLM 或 Query embedding。两者均为可选配置,文档抽取和索引仍使用原始连接。查询向量沿用原始模型与向量维度。部署设置、凭据存储和恢复方法详见可选 Chatbot 连接。
选择 OpenAI 兼容,再为原始生成模型或可选 Chatbot LLM 选择 Responses API 格式,即可使用 OpenAI 兼容、Azure 或 Bedrock Responses 端点。端点配置、推理控制、认证和验证方法详见Responses API 设置。
保存前,可以点击测试检查尚未保存的原始或可选模型连接。成功时显示绿色勾和模型名称或向量维度,失败时显示红色错误;测试不会保存草稿。可选连接保存成功后用于后续操作,已经开始的操作继续使用各自保存的配置快照。后台处理文档时,查询可以复用已初始化的兼容引擎,减少等待。运行细节详见可选 Chatbot 连接。
导入知识
创建信源后,可以添加 Markdown、文本、PDF、Office 等支持的文档。SAG 会先将文档规范化为 Markdown,再在后台完成分块、向量化、事件抽取和实体抽取。
上传时显示真实传输进度。后台处理时,文档列表和详情显示当前阶段与可用的分块计数(例如“已处理 810 / 2,033 个分块”),不显示整体百分比。文档变为就绪后即可检索。
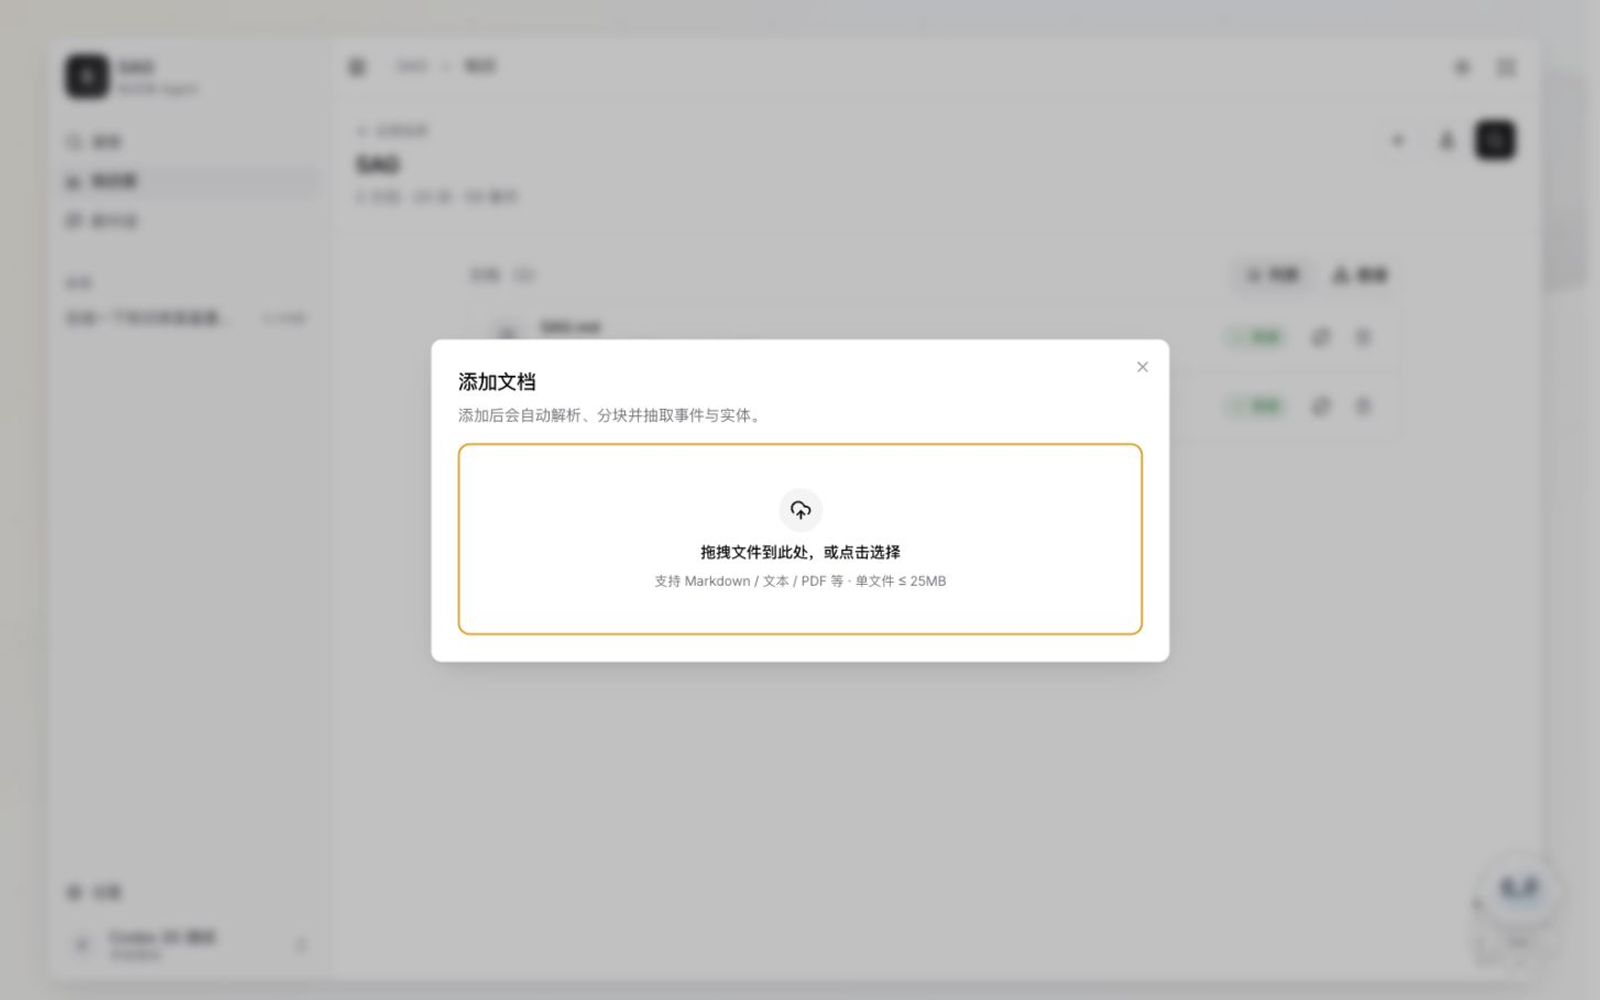
PDF 在 MinerU 配置完整时优先使用 MinerU;未配置或解析失败时自动回退本地 MarkItDown。其他 Office 和文本格式默认使用 MarkItDown。
PDF 解析也支持自托管 MinerU 4.x V1 API(mineru-kit api-server)。参照 .env.example,配置 SAG_MINERU_PROVIDER=self_hosted、SAG_MINERU_BASE_URL,并将 SAG_DOCUMENT_PARSER 设为 auto 或 mineru。本机或内网地址还需显式设置 SAG_MINERU_ALLOW_PRIVATE_BASE_URL=true。修改部署配置后重新创建 API 容器。此前在界面保存的解析器/MinerU 配置会覆盖环境默认值;请通过鉴权 PUT /api/v1/system/model-config 更新已保存的值,并在导入 PDF 前核对实际生效配置。
也可以在设置页把解析方式切换为 AnyDoc(或设置 SAG_DOCUMENT_PARSER=anydoc):docx/pptx/epub/pdf/csv 在本机由 AnyDoc 转换,文件不上传、不调用托管 OCR;xls/xlsx 沿用本机 MarkItDown 转换,以保留引擎的 Excel 记录组和检索切片,并记录实际解析器。仅 AnyDoc 明确不支持的文件回退 MarkItDown,其他转换错误直接报告失败。CSV 先按 SAG 的编码识别规范成 UTF-8 再交给 AnyDoc,避免非 UTF-8 中文出现乱码。扫描版或图文混排 PDF 会被整体提示需要 OCR(保留页码),此时请用已配置的 MinerU 重新处理;该路径不缓存部分文本。auto 默认规则保持不变。
检索并核对原文
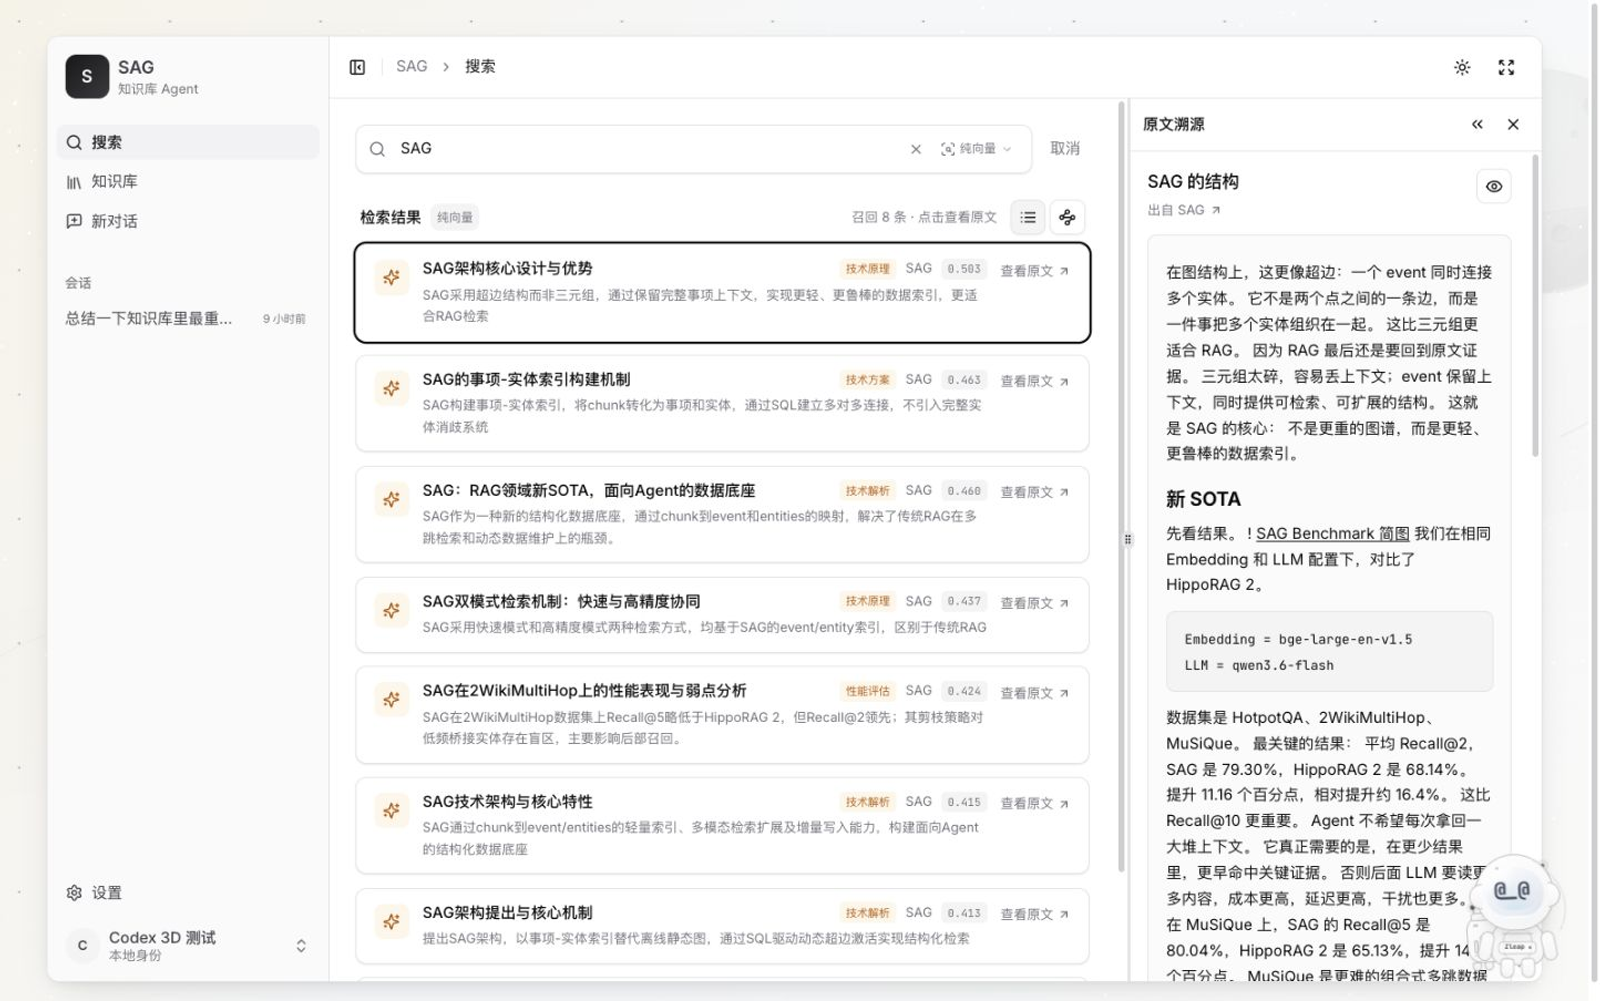
可以跨信源检索,也可以只搜索指定信源。未显式选择信源时,全局检索和默认 Agent 的知识检索默认最多使用 16 个候选信源;可通过 @ 指定需要检索的信源。每一条结果都能在右侧打开对应原文块,让 Agent 使用前的召回质量可以被直接核验。
进行带引用的问答
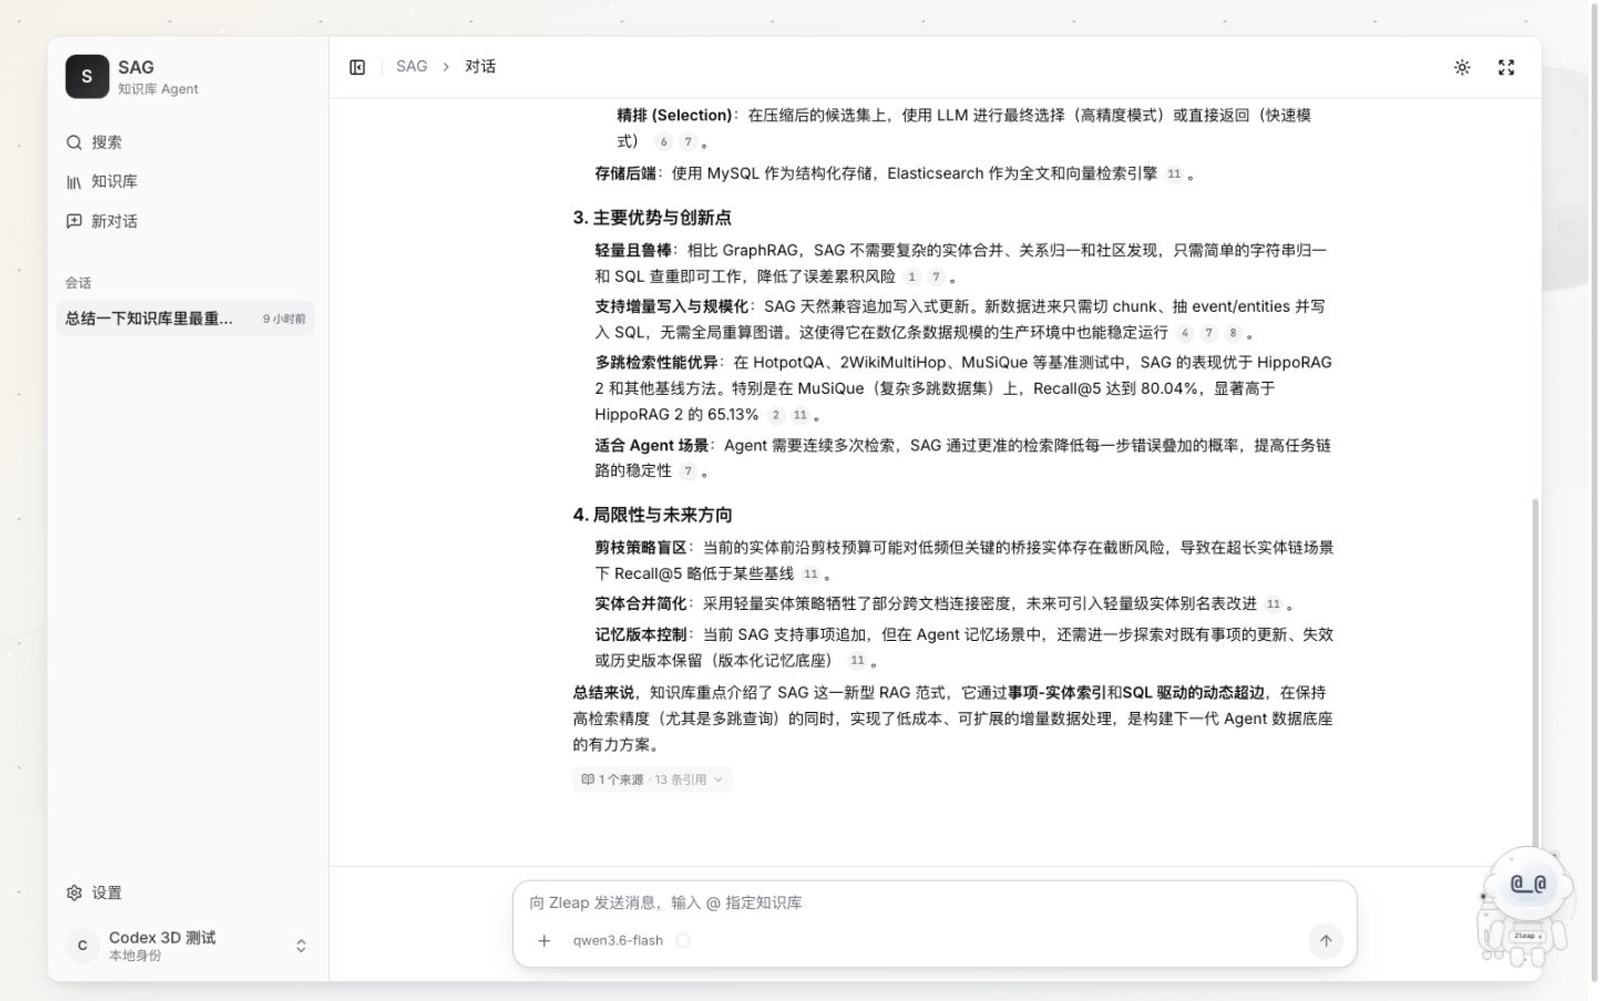
Agent 会在本轮知识范围内检索、流式生成回答,并附上可点击引用。同一套对话能力也通过 OpenAI 兼容接口开放。
通过 @ 选择信源,可以缩小某个问题的知识检索范围。每个问题选择的信源标签会保留在对话历史中,点击“重试”时会复用该问题保存的范围。标签表示选定的检索范围,回答中的引用表示实际使用的证据。详见对话历史中的信源范围。
在任意页面点击侧栏的“新建对话”,都可以打开空白草稿。即使旧对话仍在生成回答,返回聊天页时也会保留新草稿的选中状态。原有对话仍保留在历史中,新草稿会在发送第一个问题后保存为对话。SAG 一次生成一个回答,因此需要等待当前回答结束或先停止它,再在新草稿中发送问题。
探索模式
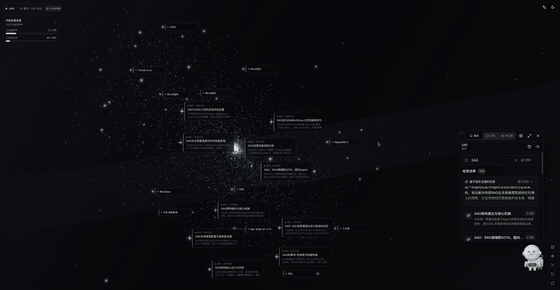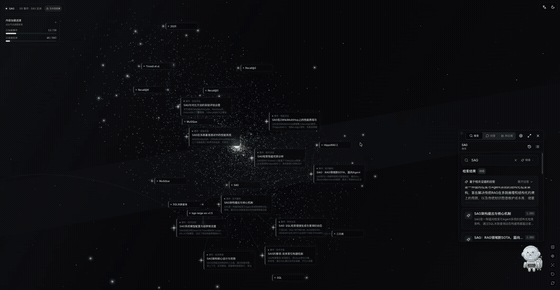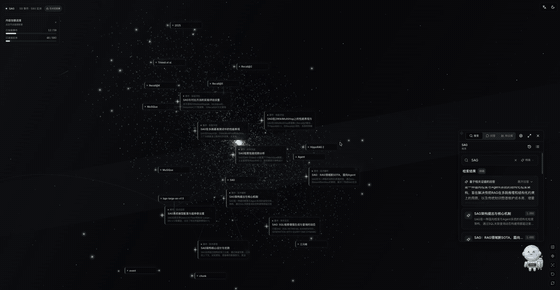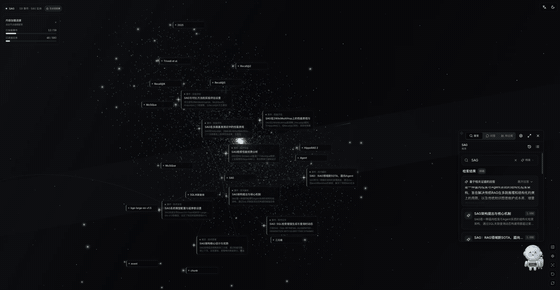
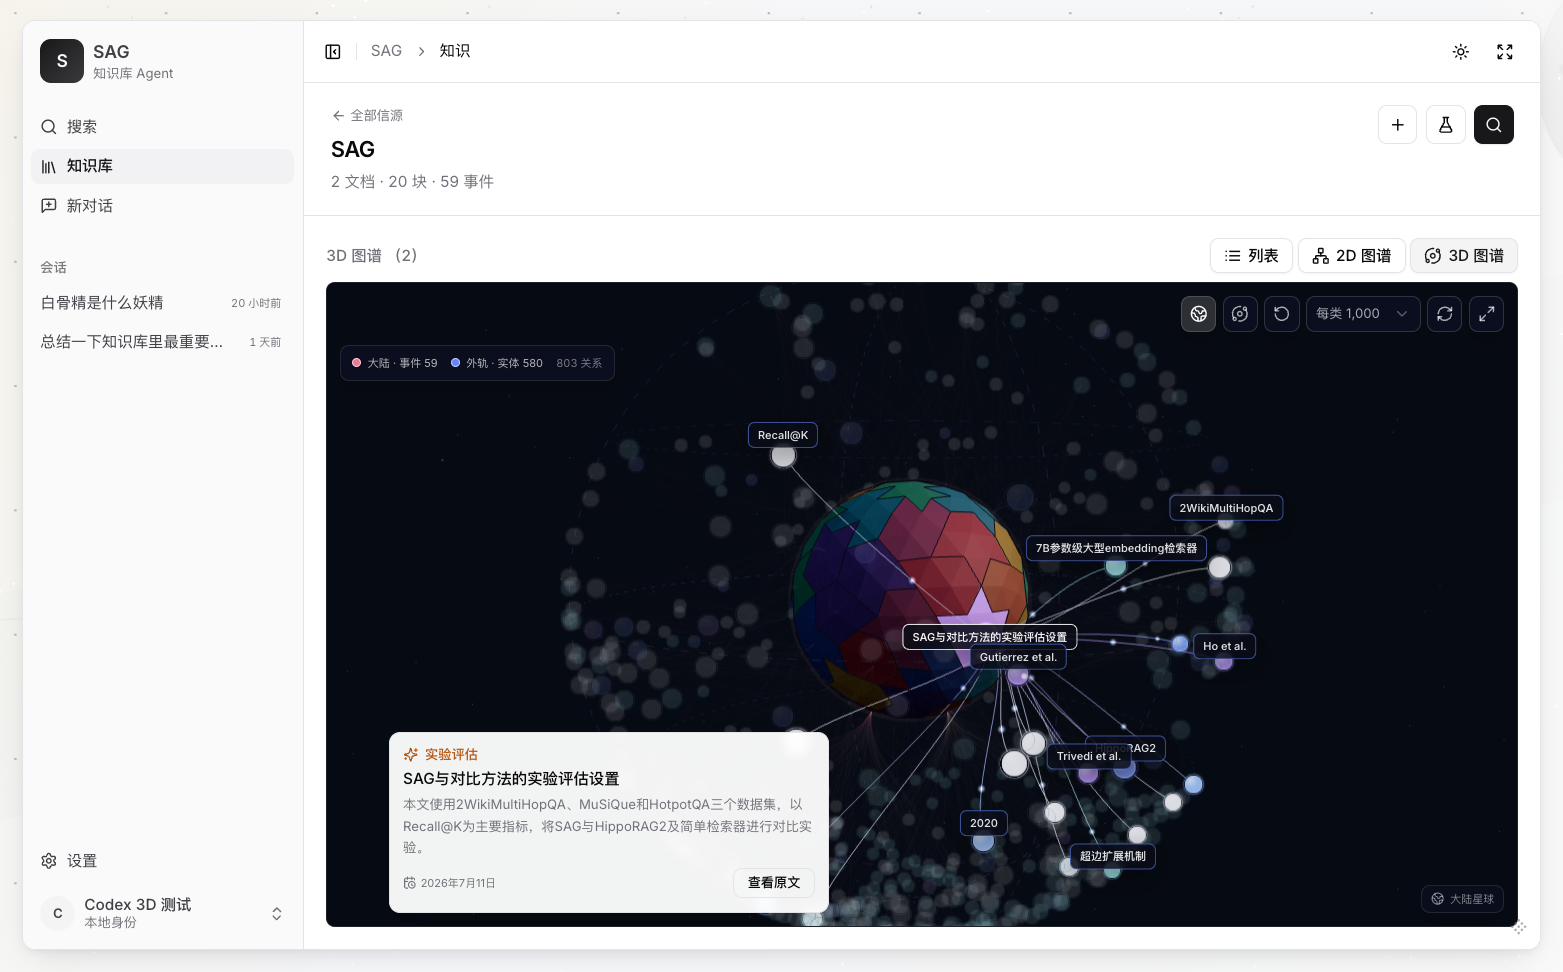
探索模式会将整个知识库展开为可交互的知识宇宙。你可以在同一视图中搜索事件与实体、沿关联关系漫游,并随时打开事件详情与原文。
查看 event-entity 图谱
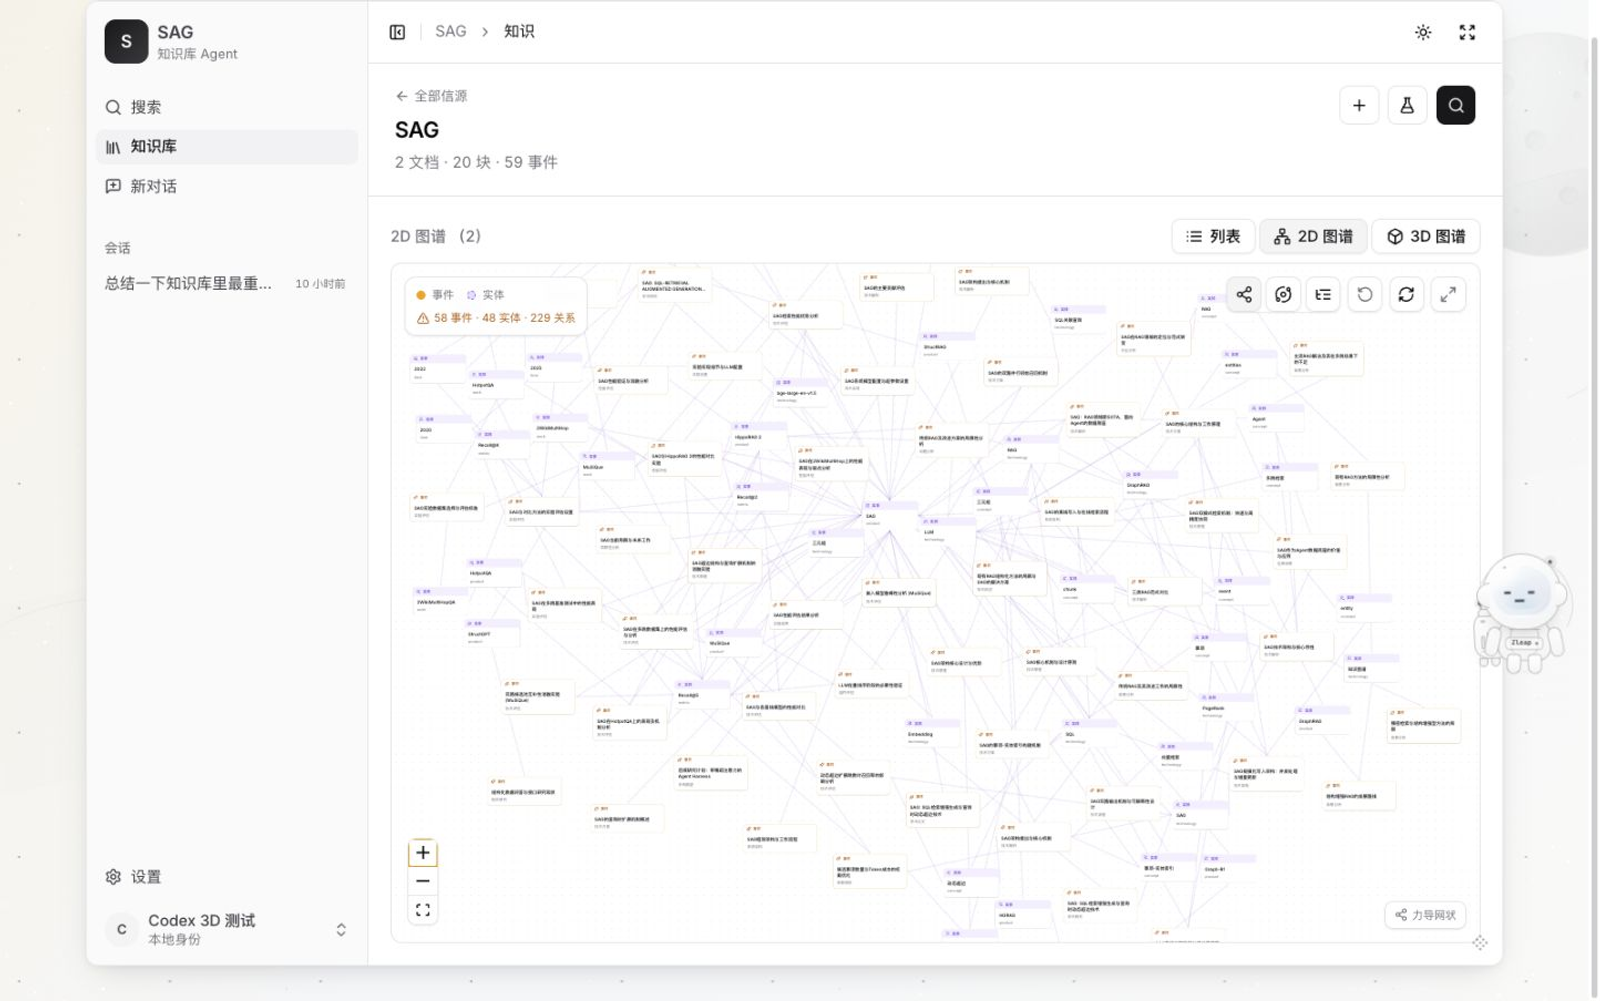
在信源中从列表切换到图谱,可以查看 SAG 索引生成的事件、实体和关联关系。
MCP 指南
推荐路径分两步:CLI 挂载 MCP,Skill 教会 Agent 怎么高效探索。二者组合即可开箱即用,不需要手改任何配置文件。
第一步:用 CLI 挂载 MCP
@zleap-ai/sag-cli 是 SAG 的官方命令行客户端。它会自动发现本机 Docker SAG 容器,验证 MCP 可用,并把它接入 Codex 或 Claude Code —— 本机 Docker 路径全程不需要 JWT。
安装(Node.js ≥ 20.19):
npm install --global @zleap-ai/sag-cli
一条命令接入 MCP:
sag mcp test                     # 验证 SAG MCP 可用
sag agent connect codex          # 挂载进 Codex
sag agent connect claude-code    # 或挂载进 Claude Code
sag agent status                 # 查看当前接入状态
接入远程 SAG 实例(本机没有 Docker)时,先在终端登录:
sag profile add prod https://sag.example.com
sag profile use prod
sag auth login --name "你的名字" # 直接登录 SAG
sag agent connect claude-code
CLI 不会把 JWT 写入 Agent 配置文件,可用时优先保存到操作系统凭据存储,且只会删除自己创建的 MCP 条目。任何写入操作都可以用 --dry-run 预览。完整使用指南见 SAG CLI 使用指南。
第二步:安装 Skill
Skill 随 @zleap-ai/sag-cli 发布,复制到 Agent 的 skills 目录即可:
# Claude Code
SKILL_SRC="$(npm root -g)/@zleap-ai/sag-cli"
cp -r "$SKILL_SRC/skill" ~/.claude/skills/sag-knowledge

# Codex
SKILL_SRC="$(npm root -g)/@zleap-ai/sag-cli"
cp -r "$SKILL_SRC/skill" ~/.codex/skills/sag-knowledge
手动挂载(备选)
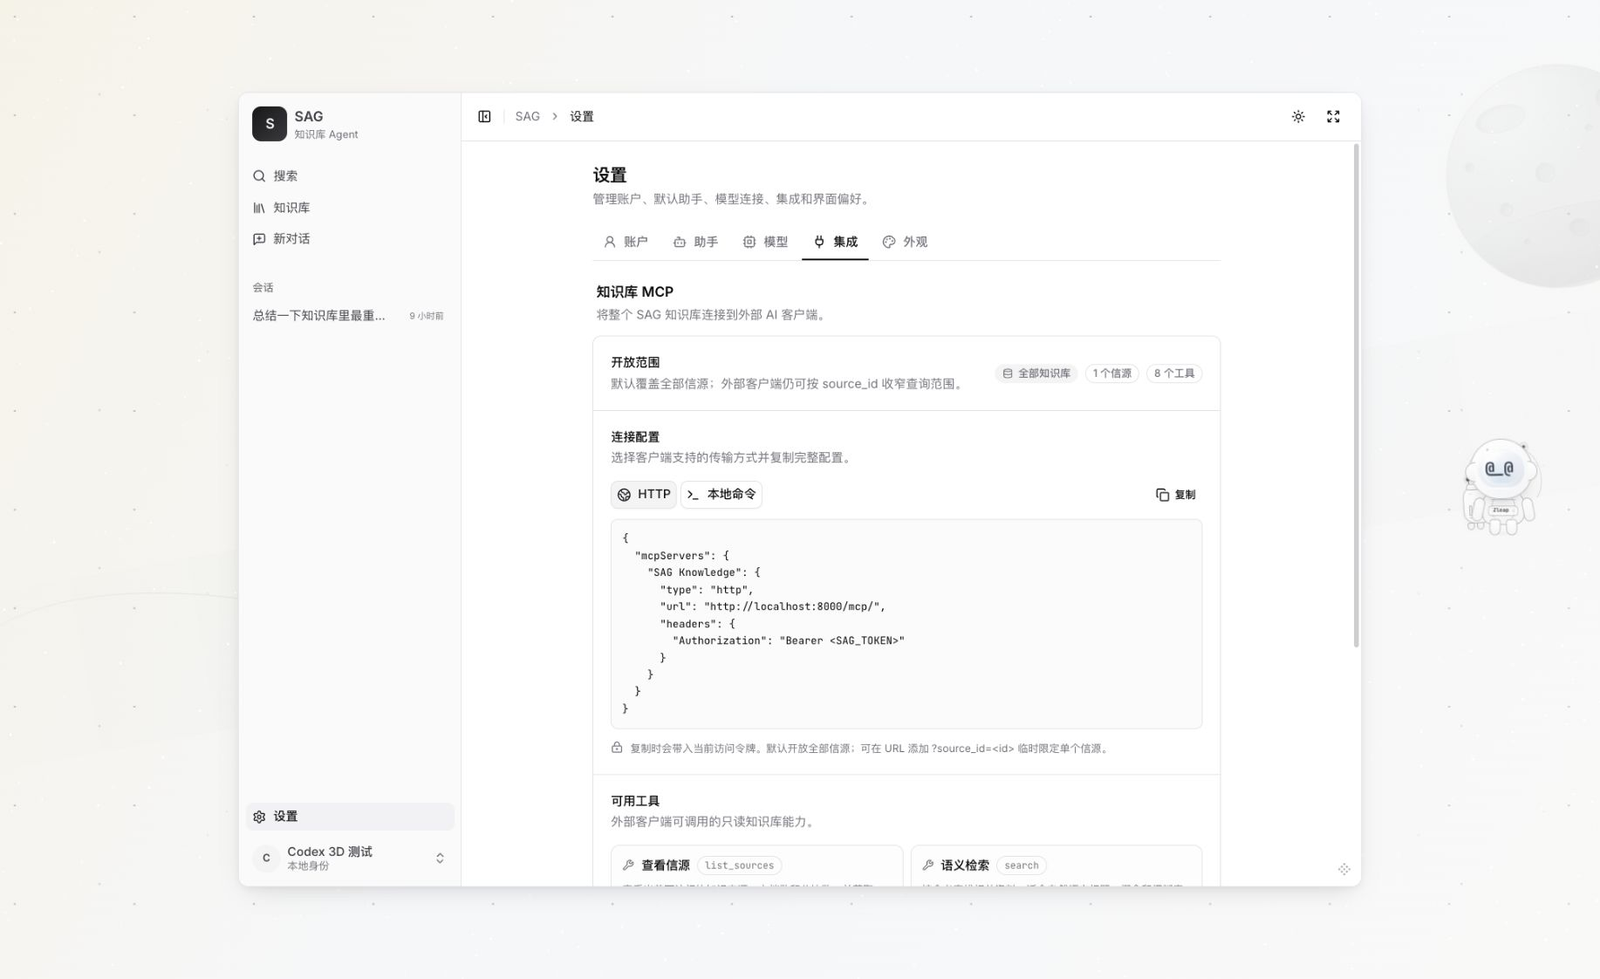
不方便安装 CLI 时,可以在 SAG 中打开 设置 → 集成 → 知识库 MCP,选择 HTTP 或本地命令,把完整配置复制粘贴到 Agent 的 MCP 配置文件里。HTTP 配置已自动带入当前 JWT,默认开放全部信源,也可以通过 source_id 限定范围。
在 DeepSeek Harness 中使用 SAG
通过 dsh-sag 将 SAG 知识库接入 DeepSeek Harness。当前插件 dsh-sag 0.2.0 支持 DeepSeek Harness 0.2.0-rc.2。
启动 SAG,待 dsh-sag 0.2.0 发布到 npm 后安装并运行插件:
dsh plugin --profile web add @zleap-ai/[email protected]
dsh plugin --profile web exec dsh-sag doctor
dsh --profile web
在 dsh 中说:“在 SAG 中查找上传限制,并给出原文依据。”连接方式和插件能力详见插件使用指南。
作为模型被调用(OpenAI 兼容)
SAG 暴露一个 OpenAI Chat Completions 端点,检索与引用行为和站内对话一致:
curl -s http://localhost:8000/api/v1/openai/<AGENT_ID>/chat/completions \
  -H "Authorization: Bearer <SAG_JWT>" \
  -H "Content-Type: application/json" \
  -d '{"messages":[{"role":"user","content":"这份资料讲了什么?"}]}'
返回标准 chat.completion,并额外提供 sag.citations 引用字段;标准客户端会忽略未知字段。设置 "stream": true 后以 SSE 分块返回。
作为 Dify 外部知识库
SAG 可以通过专用兼容端点接入 Dify 的“连接外部知识库”,无需修改 Dify
源码。密钥、Docker 网络、Source ID 与控制台配置步骤见
docs/dify-integration.md。
运行与更新
docker compose ps                  # api 和 web 应显示 healthy
docker compose logs -f api web     # 持续查看日志
docker compose restart             # 重启服务
docker compose down                # 停止并保留全部数据

git pull --ff-only                 # 更新本地代码
docker compose up -d --build       # 重建服务,不删除数据卷
默认持久化方式:
| 运行方式 | 应用元数据 | 知识引擎 | 保存位置 |
|---|---|---|---|
| Docker 默认 | SQLite | SQLite + LanceDB | Docker 数据卷 sagdata |
| 本地开发 | SQLite | SQLite + LanceDB | apps/api/.data/ |
| PostgreSQL 覆盖 | PostgreSQL | PostgreSQL + pgvector | pgdata 与 sagdata 数据卷 |
docker compose down 会保留数据。docker compose down -v 会永久删除数据库、知识索引和已上传文件。
网络与生产安全
默认 Compose 只将 3000 和 8000 端口绑定到 127.0.0.1,并使用 SAG_AUTH_MODE=local:名字只是本地身份,不是密码认证。不要把这种默认模式直接暴露到不可信网络。
需要自定义端口或在受信局域网访问时:
cp .env.example .env
# 修改 BIND_ADDRESS、WEB_PORT、API_PORT、SAG_CORS_ORIGINS 和 NEXT_PUBLIC_API_BASE。
# 对外访问时同时设置 SAG_AUTH_MODE=password,并保持 SAG_ALLOW_REGISTRATION=false。
docker compose up -d --build
password 模式首次打开 Web 页面时会引导创建邮箱和密码;此后登录必须同时提供正确邮箱和密码,不再按名字或首个用户兜底。SAG_ALLOW_REGISTRATION=false 仍允许建立首个正式凭据,建立后会关闭后续注册。
NEXT_PUBLIC_API_BASE 会在构建时写入 Web 镜像,因此修改后必须带 --build。服务器部署还应配置强 SAG_SECRET_KEY、HTTPS,以及 VPN、IP 白名单或反向代理限流等防护。当前 sag auth login --name 只适用于 local 模式;password 模式下可先通过 Web 登录,并通过 SAG_TOKEN 向 CLI 提供已签发的令牌。
开发者指南
系统边界
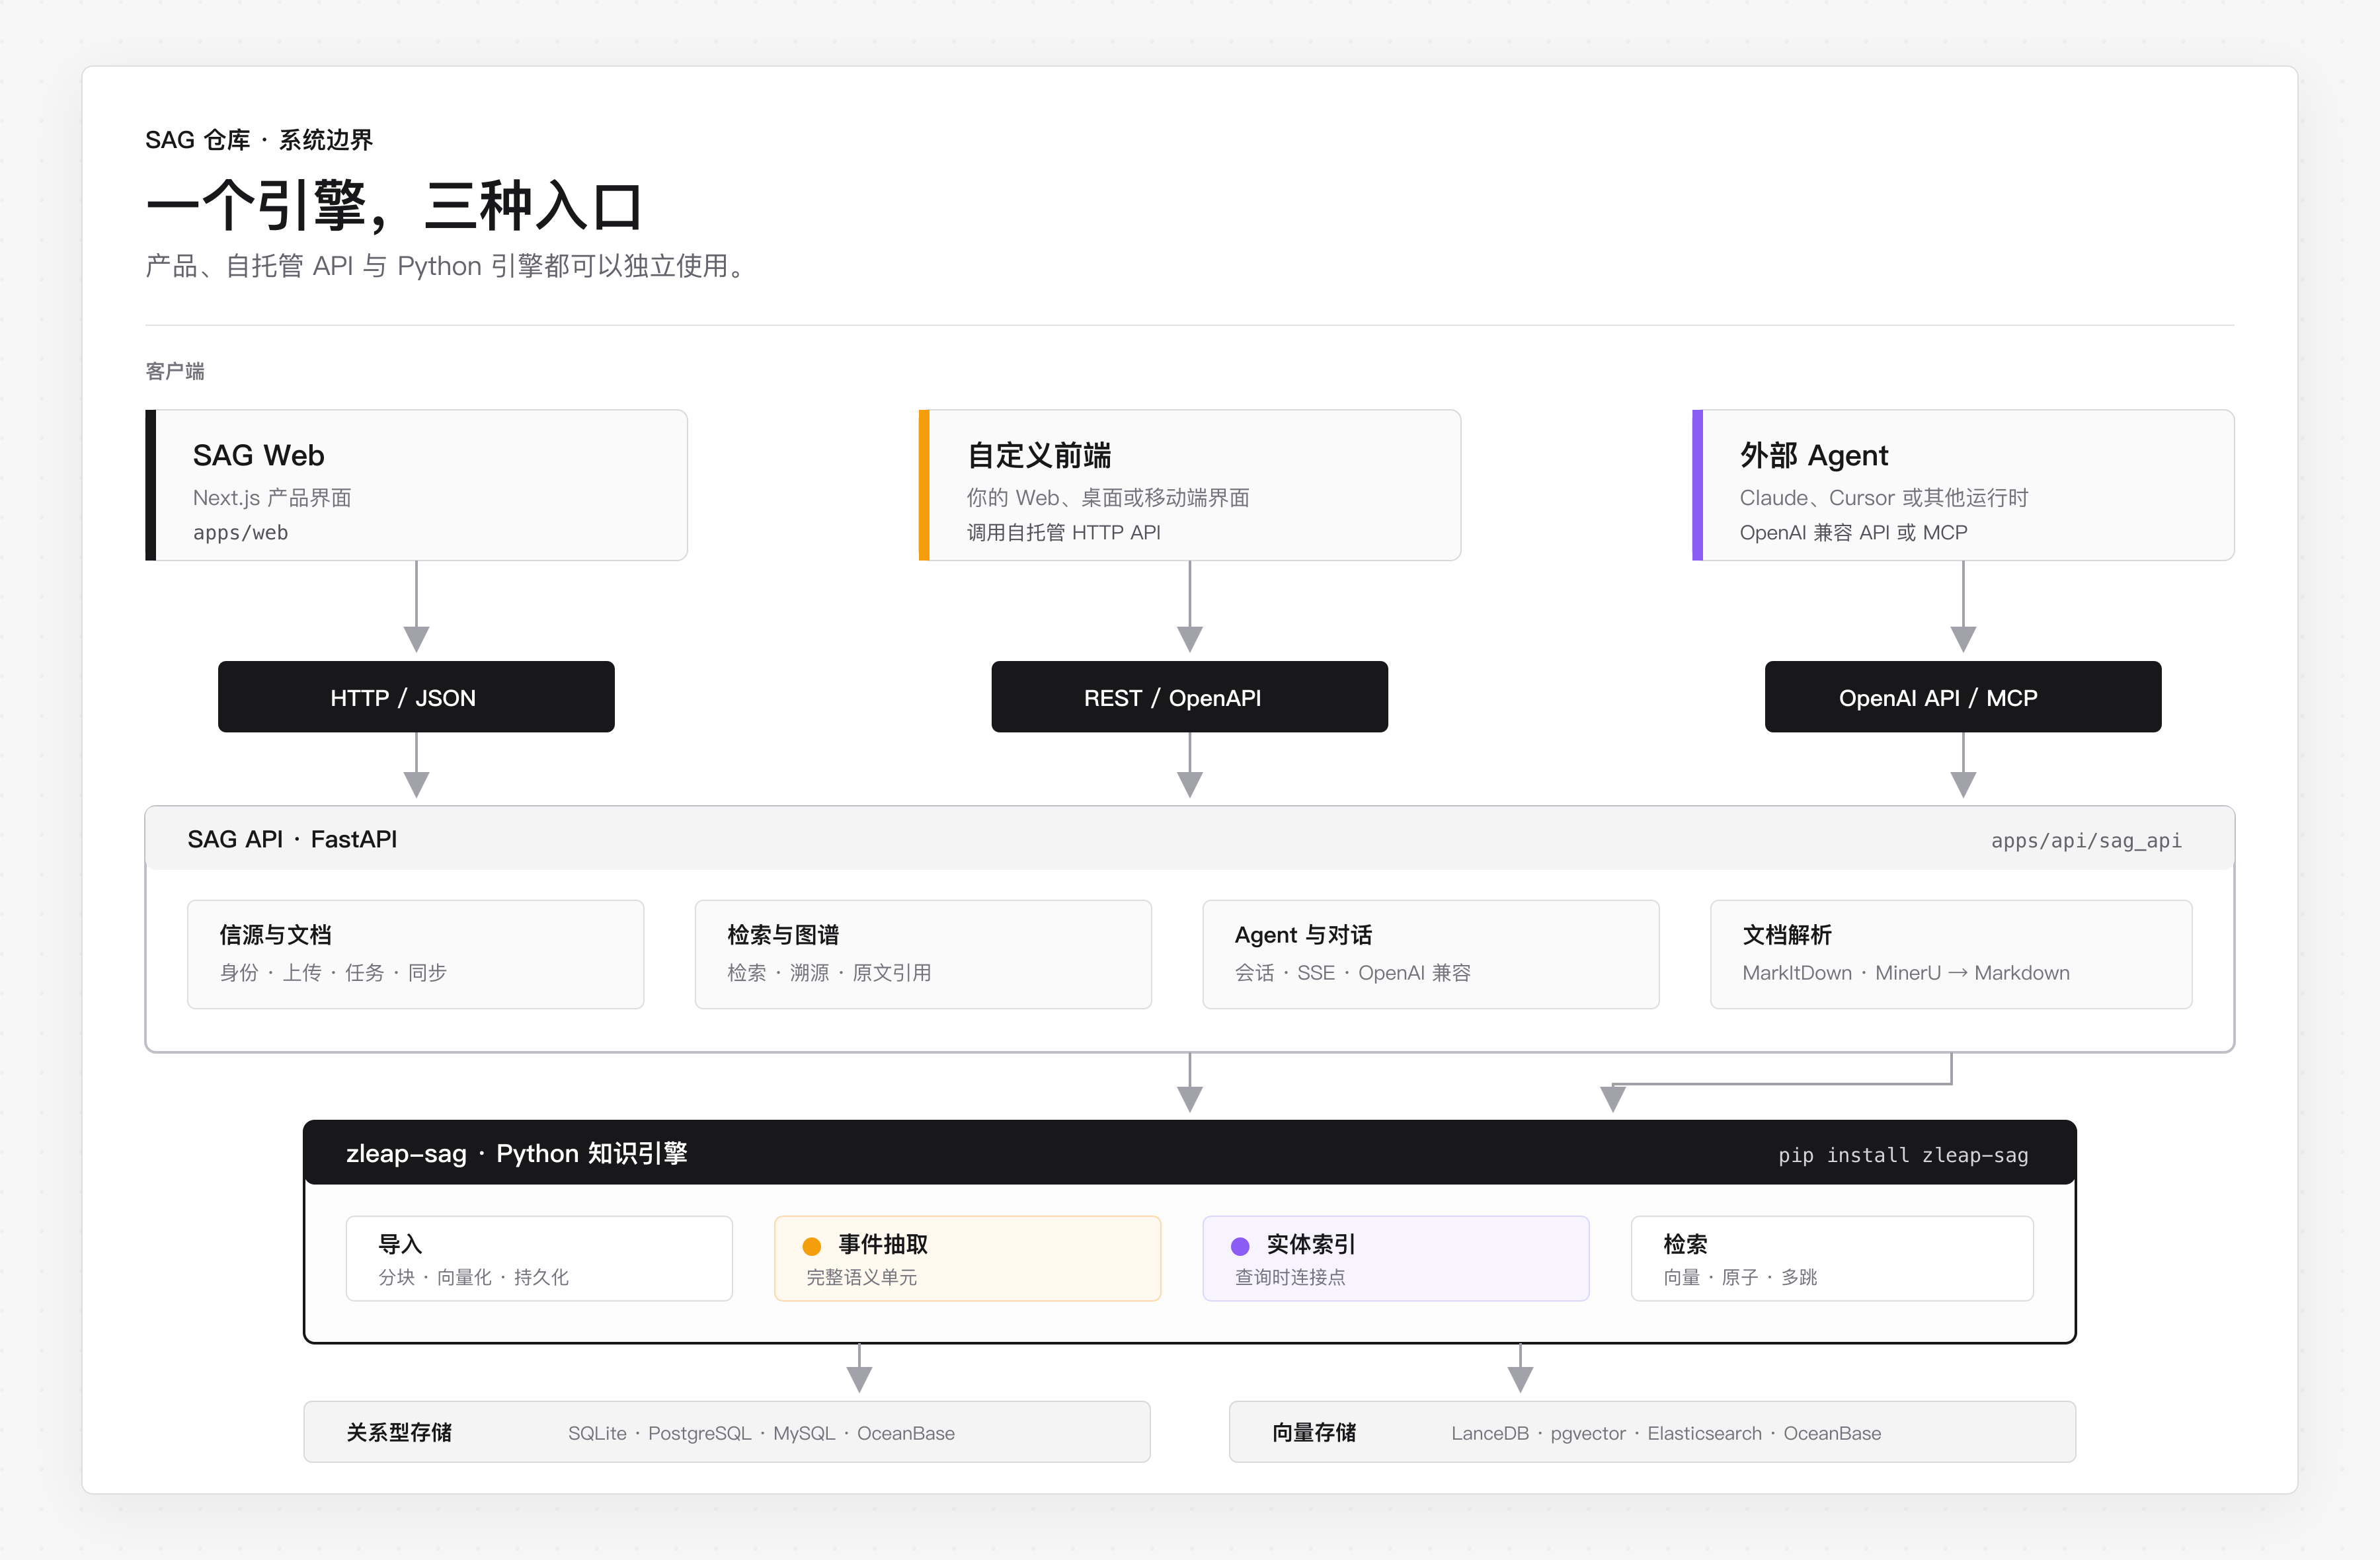
SAG 采用 Next.js 前端与 FastAPI 后端分离的架构。后端是基于公开 Python 引擎 zleap-sag 制作的参考应用。开发者既可以保留整个后端、制作自己的前端,也可以在自己的 Python 服务中直接嵌入 zleap-sag。
代码库结构
apps/
├── web/                    Next.js 15 + React 19 产品前端
├── desktop/                Electron 桌面壳、打包与本地运行时生命周期
└── api/
    ├── sag_api/
    │   ├── api/v1/         FastAPI HTTP 路由与序列化
    │   ├── connectors/     文件/网页信源连接器与注册表
    │   ├── parsing/        MarkItDown 与 MinerU 文档规范化
    │   ├── jobs/           后台 ingest → extract 状态机
    │   ├── sag/            应用内唯一导入 zleap-sag 的适配层
    │   ├── generation/     检索证据 → 流式带引用回答
    │   ├── mcp/            知识库 MCP Server 与 HTTP 挂载
    │   ├── services/       应用与领域编排
    │   └── tools/          内置工具与远端 MCP Agent 工具
    └── sag_agent/          与框架无关的 Agent Runtime Core
deploy/                     部署初始化资源
integrations/dsh-sag/       独立发布的 DeepSeek Harness 插件及 embedded 运行时
docs/assets/readme/         README 配图与示意图
核心依赖规则很简单:应用只能通过 apps/api/sag_api/sag/ 访问知识引擎;引擎不知道 FastAPI、Web UI、用户、对话和引用的存在。
本地开发
从仓库根目录分别启动后端和前端。
# 终端 1:API,地址 http://localhost:8000
cd apps/api
python -m venv .venv
. .venv/bin/activate
pip install -e ".[dev]"
cp .env.example .env
uvicorn sag_api.main:app --reload
# 终端 2:Web,地址 http://localhost:3000
cd apps/web
npm install
npm run dev
常用检查:
cd apps/api && pytest
cd apps/api && ruff check .
cd apps/web && npm run typecheck
cd apps/web && npm run build
桌面客户端
Electron 客户端将同一套 Next.js 应用与本地 FastAPI 后端一起打包。桌面开发、分平台发布构建、签名、更新配置和数据目录见 apps/desktop/README.md。
直接使用 zleap-sag
zleap-sag 是 SAG 应用底层持续维护的 Python 引擎。发行包名为 zleap-sag,导入路径为 zleap.sag,要求 Python 3.11+,采用 MIT 许可。当前应用要求 zleap-sag==0.15.0。
安装默认的零基础设施版本:
pip install zleap-sag==0.15.0
准备已有的 knowledge.md 和可用的模型凭据后,运行完整的导入 → 抽取 → 检索流程:
import asyncio
from pathlib import Path

from zleap.sag import DataEngine, EngineConfig
from zleap.sag.config import EmbeddingConfig, LLMConfig
from zleap.sag.pipeline import SearchOptions, SearchRequest, SearchScope


async def main() -> None:
    config = EngineConfig(
        storage_mode="normal",
        llm=LLMConfig(
            api_key="sk-...",
            base_url="https://your-openai-compatible-host/v1",
            model="qwen3.8-flash",
        ),
        # 不填写 api_key/base_url 时,Embedding 会复用 LLM 接口。
        embedding=EmbeddingConfig(model="Qwen/Qwen3-Embedding-4B"),
        language="zh",
    )

    # 一个 DataEngine 实例对应一个逻辑信源。
    async with DataEngine(config, data_source_id="knowledge-demo") as engine:
        chunks = await engine.ingest(Path("knowledge.md"))
        events = await engine.extract(chunks)
        request = SearchRequest(
            query="SAG 为什么适合多跳检索?",
            scope=SearchScope(data_source_ids=(chunks.data_source_id,)),
            options=SearchOptions(strategy="full_expand", top_k=5, return_type="chunk"),
        )
        result = await engine.search(request)

        print(chunks.chunk_count, events.event_count)
        for hit in result.chunks:
            print(hit.content[:200])


asyncio.run(main())
本地数据会自动创建在 ./.zleap/,请将该目录加入 .gitignore。
配置方式
两种配置方式选择其一,不要混用:
| 方式 | 创建方法 | 适用场景 |
|---|---|---|
| 参数注入 | EngineConfig(storage_mode="normal", llm=..., embedding=...) |
Python 库、Notebook、显式应用装配 |
| 环境变量 | EngineConfig.from_env() 或 from_env(env_file=".env") |
容器与 12-factor 服务 |
最小环境变量配置:
export SAG_STORAGE_MODE=normal
export OPENAI_API_KEY=sk-...
export OPENAI_BASE_URL=https://your-openai-compatible-host/v1
export LLM_MODEL=qwen3.8-flash
export EMBEDDING_MODEL=Qwen/Qwen3-Embedding-4B
from zleap.sag import EngineConfig

config = EngineConfig.from_env()
EngineConfig(...) 不会自动读取环境变量。请使用显式参数,或调用 from_env()。独立的 Embedding 接口可以通过 EmbeddingConfig(api_key=..., base_url=..., model=...) 配置。
DataEngine 公共 API
| API | 作用 |
|---|---|
await engine.start() |
初始化连接;本地 SQLite/LanceDB 会自动创建结构 |
await engine.aclose() |
关闭引擎资源;使用 async with 时自动执行 |
await engine.parse(source, options=None) |
将 FileSource、TextSource 等 SourceInput 解析为 ParsedSource,但不写入数据库 |
await engine.chunk(parsed, options=None) |
将 ParsedSource 分块为 ChunkSet,但不写入数据库 |
await engine.ingest(source, ...) |
解析、分块、向量化并持久化路径、文本或 SourceInput,返回 ChunkSetRef |
await engine.extract(target, options=None) |
从 ChunkSetRef 或 PersistedChunkSelector 抽取并保存事件/实体,返回 EventSetRef |
await engine.search(request) |
使用包含问题、范围、选项的显式 SearchRequest 检索,返回带 chunks、events、stats 的 SearchResult |
await engine.init_schema() |
幂等初始化生产数据库结构;默认本地后端不需要调用 |
流水线请求和结果类型位于 zleap.sag.pipeline:ParsedSource、ChunkSet、ChunkSetRef、EventSetRef、SearchRequest、SearchResult。所有引擎异常都继承 zleap.sag.exceptions 中的 SagError,应用边界只需捕获一个基础类型。
检索模式
| 界面名称 | 应用/API 策略 | 代码实现 |
|---|---|---|
| 快速(vector) | vector |
基于语义相似度直接召回,响应更快 |
| 快速(multi_es-fast) | multi_es_fast |
BM25 实体召回与事件多跳检索,跳过 LLM 精排 |
| 精确 | multi |
结合实体关系与 LLM 精排,结果更完整 |
| JEV 精排 | multi_jev |
召回与图扩展后,通过独立 JEV 服务为候选证据评分 |
这里列出的是应用/API 策略名称;应用将 multi 映射到 Python 引擎的 full_expand,将 multi_es_fast 映射到 pruned_expand_rff。可用性取决于存储能力:multi_es_fast 需要词法检索支持。
在“设置 → 知识库 → 检索”配置 302.AI、TypeSafe 官方或自定义 JEV 服务(默认 jev-latest,独立 API Key),再选择 JEV 精排。仅保存服务不会启用;默认限时 30 秒、失败报错,可选择粗排降级。
支持 LanceDB、Elasticsearch,暂不支持 pgvector;PostgreSQL 作为关系库不受影响。未启用时沿用原检索策略,已有文档无需重新入库。效果与成本见更新日志。
存储后端
| 部署方式 | 关系型存储 | 向量存储 | 安装 extra |
|---|---|---|---|
| 本地默认 | SQLite | LanceDB | 无 |
| 单数据库 | PostgreSQL | pgvector | zleap-sag[postgres] |
| 生产拆分 | MySQL/PostgreSQL/OceanBase | Elasticsearch | zleap-sag[mysql]、[postgres]、[es] |
| 单数据库 | OceanBase 4.3.3+ | OceanBase vector | zleap-sag[mysql] |
只需修改 EngineConfig 即可切换后端,导入、抽取和检索代码保持不变。每个 DataEngine 实例拥有自己的连接和资源,请通过 async with 或 aclose() 关闭。
完整配置、可选依赖、示例和更新记录见 zleap-sag 包说明。
基于 SAG 后端制作自己的前端
浏览器不能直接导入 Python 包。自定义前端应调用一个持有 DataEngine 的 Python HTTP 服务。本仓库的 FastAPI 后端就是参考实现,并且已经与 Next.js 前端分离。
启动 SAG 后即可使用自托管 API:
| 入口 | 地址 |
|---|---|
| API Base | http://localhost:8000/api/v1 |
| 交互式 OpenAPI | http://localhost:8000/docs |
| OpenAPI Schema | http://localhost:8000/openapi.json |
| MCP Streamable HTTP | http://localhost:8000/mcp/ |
这是自托管 API,不是由项目方托管的公共云 API。默认 local 模式下,大部分接口使用名字登录签发的 SAG JWT:
curl -s http://localhost:8000/api/v1/auth/login \
  -H 'Content-Type: application/json' \
  -d '{"name":"Developer"}'
从响应中复制 access_token,后续请求携带:
Authorization: Bearer <SAG_TOKEN>
启用 SAG_AUTH_MODE=password 后,先通过 POST /auth/register 建立首个凭据,再使用邮箱密码登录:
curl -s http://localhost:8000/api/v1/auth/login \
  -H 'Content-Type: application/json' \
  -d '{"email":"[email protected]","password":"<YOUR_PASSWORD>"}'
API 地图
| 领域 | 主要路由 | 用途 |
|---|---|---|
| 系统 | GET /system/health、/system/ready、/system/capabilities |
健康状态与当前引擎能力 |
| 身份 | POST /auth/login、GET /auth/me |
本地身份与 JWT |
| 信源 | GET/POST /sources、GET/PATCH/DELETE /sources/{id} |
信源生命周期 |
| 文档 | /sources/{id}/documents 与 /documents/ingest |
文件上传、持续文本/消息写入、重新处理、删除 |
| 检索 | POST /search、POST /sources/{id}/search |
全局或指定信源的 vector/multi 检索 |
| 图谱 | GET /sources/{id}/entities、/sources/{id}/graph |
查看 event-entity 结构 |
| Agent | /agents、/threads、/ask |
Agent 配置、会话、SSE 运行与引用 |
| OpenAI 兼容 | POST /openai/{agent_id}/chat/completions |
将任意 SAG Agent 作为带引用模型调用,支持流式 |
| MCP | /mcp/ 或 /mcp/?source_id={id} |
将整个知识库或单个信源开放给 MCP 宿主 |
创建信源、持续写入文本并执行检索:
BASE=http://localhost:8000/api/v1
TOKEN=<SAG_TOKEN>

SOURCE_ID=$(curl -s -X POST "$BASE/sources" \
  -H "Authorization: Bearer $TOKEN" \
  -H 'Content-Type: application/json' \
  -d '{"name":"Product docs"}' | jq -r .id)

curl -s -X POST "$BASE/sources/$SOURCE_ID/documents/ingest" \
  -H "Authorization: Bearer $TOKEN" \
  -H 'Content-Type: application/json' \
  -d '{"title":"SAG","text":"SAG 使用 event-entity 索引与查询时动态超边。"}'

curl -s -X POST "$BASE/sources/$SOURCE_ID/search" \
  -H "Authorization: Bearer $TOKEN" \
  -H 'Content-Type: application/json' \
  -d '{"query":"SAG 如何检索知识?","strategy":"multi","top_k":5}'
文档写入由后台任务队列处理。在期待检索结果前,请检查返回的文档状态或对应任务是否完成。
如果自定义前端与 API 不同源,请将前端地址加入 SAG_CORS_ORIGINS。API 地址改变时,还要用对应的 NEXT_PUBLIC_API_BASE 重新构建 Web 镜像。
PostgreSQL/pgvector 部署
可选的生产覆盖会将应用元数据与知识引擎迁移到 PostgreSQL/pgvector:
cp .env.example .env
openssl rand -hex 32   # 填入 SAG_SECRET_KEY
openssl rand -hex 24   # 填入 POSTGRES_PASSWORD

docker compose -f compose.yaml -f compose.postgres.yaml config
docker compose -f compose.yaml -f compose.postgres.yaml up -d --build
服务器部署前应设置真实的 SAG_CORS_ORIGINS 与 NEXT_PUBLIC_API_BASE。升级前同时备份 pgdata 和 sagdata。
参与贡献与许可
- 贡献流程:CONTRIBUTING.md
- Python 引擎:
zleap-sagPyPI - 论文复现:Zleap-AI/SAG-Benchmark
SAG 使用 MIT License。
社区交流
通过 Discord 或微信加入 SAG 社区,与项目维护者和其他用户交流。
| Discord | 微信 |
|---|---|
 |
 |
探索相关项目
affaan-m/ECC
智能体执行与控制框架的性能优化系统。面向 Claude Code、Codex、Opencode、Cursor 等,涵盖技能、本能、记忆、安全与研究优先的开发。
299,820 星标NousResearch/hermes-agent
与你一同成长的智能体
261,852 星标multica-ai/andrej-karpathy-skills
一个用于改进 Claude Code 行为的 CLAUDE.md 文件,源自 Andrej Karpathy 对 LLM 编程陷阱的观察。
231,055 星标firecrawl/firecrawl
借助来自网络及其他来源的数据,强化你的 AI 智能体。正在构建面向超级智能的资料库。🔥
199,847 星标