
Tencent/AngelSlim
Tencent/AngelSlim has 1,786 GitHub stars and 198 forks. GitHot measured -1 stars in 24 hours, +7 in 7 days, and +15 in 15 days. Last checked 2026-11-08 07:24 UTC. Last push 2026-10-31.
Model compression toolkit engineered for enhanced usability, comprehensiveness, and efficiency.
可以做什么
- Highly Integrated: This toolkit integrates mainstream compression algorithms into a unified framework, offering developers one-click access with exceptional ease of use.
- Continuous Innovation: Beyond integrating widely-used industry algorithms, we are continuously researching better compression algorithms, which will be gradually open-sourced in the future.
- Performance-Driven: We continuously optimize end-to-end performance in model compression workflows and algorithm deployment, such as enabling quantization of models like Qwen3-235B and DeepSeek-R1 on a single GPU.
实测星标增长
- 24小时
- -1
- 7天
- +7
- 15天
- +15
- 1个月
- 正在收集历史
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
README_cn.md
原文简体中文 | English
致力于打造更易用、更全面和更高效的大模型压缩工具包
✒️ TechnicalReport | 📖 Documentation | 🤗 Hugging Face | 🤖 ModelScope
📣最新进展
- [26/07/29] 我们已发布 hy4 preview MIX-STQ1_0 版本!模型从 1.5TB 压缩至 214 GiB,在 SWE-bench Pro 上的性能仅下降了 0.7%。借助 [Prima.cpp],我们 在4090笔记本(32GB 内存,16GB 显存) 以及搭载 4 张 A4000(32GB 内存,每张 16GB 显存)的服务器 上成功运行了该模型,推理速度达到了 1.02 tokens/s。详情请见博客和部署指南!🔥🔥🔥
- [26/07/20] 我们支持了基于 Megatron-Core 的 Qwen3-MoE 和 Hy3 量化感知蒸馏,训练时仅更新量化 scale,并支持 TP/EP/CP/SP 分布式训练。[文档]
- [26/07/06] 我们支持了 Hy3(MoE A21B)模型的 FP8-Static 量化,SmoothQuant 量化. [文档]
- [26/06/04] 我们发布了 Stem,一种稀疏注意力算法,通过在 block 粒度动态选择 top-k 关键块执行 block-sparse attention,加速长上下文 LLM 的 Prefill 阶段,在大幅降低延迟的同时实现几乎无损的生成质量。[文档]
- [26/06/01] 我们发布了 DFlare,一种基于 layer-wise fusion 的块扩散投机解码框架,端到端加速比可达 5.52×。[文档]
- [26/05/27] 我们发布了 D-Cut,一种用于投机解码的自适应验证深度裁剪技术。[文档]
- [26/05/20] 我们支持了模型蒸馏功能,适用于huggingface 全精度或者QAT量化模型,详细步骤可以参考文档.🔥🔥🔥
- [26/05/08] 我们发布了用于 1.25-bit 模型的 STQ1_0 内核,并向 llama.cpp 提交了 PR #22836!如果您对 STQ_0 有任何疑问或建议,欢迎在该 PR 下留言!🔥🔥🔥
- [26/04/29] 我们发布了 2bit 与 1.25bit 腾讯混元翻译模型 Hy-MT1.5-1.8B-2bit, Hy-MT1.5-1.8B-1.25bit。并且还制作了 离线翻译体验 Demo。 欢迎体验 🔥🔥🔥
- [26/04/23] 我们支持了 Hy3-preview(MoE A20B)模型的 FP8-Static 量化。
- [26/03/25] 我们发布了量化算法DAQ,该方法在后训练参数更新较小时,可保留量化后模型能力 [论文] | [文档]
- [26/02/09] 我们发布了 HY-1.8B-2Bit, 2比特端侧大模型, 模型可见[Huggingface].
- [26/01/13] 我们发布V0.3版本, 支持了全模态场景的投机采样训练及部署,文档:Eagle3 for LLM/VLM/Audio。并且我们发布了 Sherry 新的硬件高效的1.25bit三值量化算法 [论文] | [代码]🔥🔥🔥
历史更新
- [25/11/05] 我们发布V0.2版本,支持了包括GLM-4.6/Qwen3-VL/Qwen3-Omni等更多模型的量化,开源投机采样Eagle3训练框架,更新Diffusion模型量化工具。
- [25/09/30] 我们开源了思考早退新算法 SpecExit [论文] | [文档] | [vLLM代码]
- [25/09/30] 我们发布了三值量化新算法 Tequila [论文] | [代码]
- [25/09/24] 我们支持了Qwen3系列模型的NVFP4的PTQ量化,我们还开源了Qwen3-32B-NVFP4、Qwen3-235B-A22B-NVFP4权重。
- [25/09/01] 我们支持了Hunyuan-MT-7B翻译开源模型的FP8量化;支持了Eagle3的Torch推理及Benchmark评测流程。
- [25/08/06] 我们支持了
Hunyuan 0.5B/1.8B/4B/7B和Qwen2.5VL 3B/7B/32B/72B的FP8、INT4量化,支持了DeepSeek-R1/V3和Kimi-K2模型的W4A8-FP8量化。我们还开源了Hunyuan 1.8B/4B/7B系列模型的Eagle3权重。 - [25/07/04] 我们支持了
Hunyuan/Qwen2.5/Qwen3/DeepSeek-R1-Distill-Qwen等模型的量化,包含INT8、FP8、INT4等算法。 我们还开源了Qwen3系列模型的Eagle3权重。
🌟主要特性
- 高度集成化:本工具将主流的压缩算法集成到工具,开发者可一键式调用,具有很好的易用性。
- 持续算法创新:本工具除了集成工业界使用最广的算法,还持续自研更好的压缩算法,并且会陆续开源。
- 追求极致性能:在模型压缩流程、压缩算法部署方面,本工具持续端到端优化,例如单卡GPU可量化Qwen3-235B和Deepseek-R1。
💼技术概览
| 场景 | 模型 | 压缩策略 | ||
|---|---|---|---|---|
| 量化 | 投机采样 | 其他技术 | ||
| 文生文(LLM) |
|
|||
| 图/视频生文(VLM) |
|
|||
| 文生图/视频/3D(Diffusion) | - |
|
||
| 语音(TTS/ASR) |
|
🛎️如何使用
1、安装 AngelSlim
推荐使用pip直接安装最新稳定版AngelSlim:
pip install angelslim
也可以选择克隆代码仓库后,以可编辑的方式从源代码安装:
cd AngelSlim && python setup.py install
注意: AngelSlim 以 git submodule 形式集成了投机采样训练框架 AngelSpec(位于
third_party/AngelSpec/)。克隆时请加--recursive拉取,或在已克隆的仓库中初始化:# 克隆时同时拉取 submodule git clone --recursive https://github.com/Tencent/AngelSlim.git # 或者,在已克隆的仓库中执行 git submodule update --init --recursive
更详细的安装说明以及不同平台的安装指引,可参考安装文档。
2、快速开始
2.1 投机采样
AngelSlim 的投机采样训练由 AngelSpec 提供(git submodule,位于 third_party/AngelSpec/)——一个用于训练投机解码 draft 模型的 torch-native 框架,提供丰富的 draft 架构、target 模型支持与生产级训练能力,支持多种 draft 方法,以 DFly 与 MTP + TTT 为代表。
框架采用训推分离设计:推理引擎运行冻结的 target 模型并抽取多层隐状态,经 Mooncake store 通过 RDMA 直接流式传输(不落盘)至 FSDP2 训练进程,由 controller 负责批处理、背压与评估。推理与训练运行在独立的 GPU 资源池上,可独立扩缩。
核心能力:
- 多推理后端 —— vLLM(一等支持)、SGLang、HuggingFace。
- 长序列训练 —— Ulysses 序列并行(USP),支持 128k+ 上下文。
- 文档感知序列 packing —— 严格的跨文档注意力隔离。
- 在线评估 —— 训练过程中直接测量投机解码接受率。
- 多机 —— 大型 MoE target 模型跨节点分布,经 Mooncake RDMA 互联。
- 词表裁剪 —— 在训练或转换阶段将 draft
lm_head裁剪到更小的 token 集。
# 初始化 submodule(参见上文安装章节)
git submodule update --init --recursive
cd third_party/AngelSpec
# 安装 AngelSpec 及 vLLM 后端
pip install -e ".[vllm]"
# Hidden-state 传输(extras 未自动拉取,需单独安装)
pip install mooncake-transfer-engine
# 单机快速开始(默认 4 GPU:2 推理 + 2 训练)
./examples/qwen3-8b-single-node/run.sh
更多细节请参考技术报告、AngelSpec 文档、AngelSpec README 与 Hugging Face 权重。
2.2 LLM/VLM模型量化
完成安装AngelSlim后,您可以通过以下脚本快速开始,完成Qwen3-1.7B模型的静态FP8量化:
1、一键式启动
python3 tools/run.py -c configs/qwen3/fp8_static/qwen3-1_7b_fp8_static.yaml
该示例将会加载HugggingFace模型进行PTQ量化校准,最终量化产出模型权重.
对 Hy3-preview(MoE A20B)进行 FP8-Static 量化:
python tools/run.py -c configs/hunyuan/fp8_static/hunyuanv3_a20b_fp8_static_c8.yaml
2、源码启动
例如对Qwen3-1.7B完成动态FP8量化:
from angelslim.engine import Engine

slim_engine = Engine()
# Prepare model
slim_engine.prepare_model(model_name="Qwen", model_path="Qwen/Qwen3-1.7B")
# Initialize compressor
slim_engine.prepare_compressor("PTQ", default_method="fp8_dynamic")
# Compress model
slim_engine.run()
# Save compressed model
slim_engine.save("./output")
详情请参考量化快速开始文档。
2.3 Diffusion模型量化
使用 scripts/diffusion/run_diffusion.py 脚本进行量化与推理:
# 在线量化并运行推理
python scripts/diffusion/run_diffusion.py \
  --model-name-or-path black-forest-labs/FLUX.1-schnell \
  --quant-type fp8-per-tensor \
  --prompt "A cat holding a sign that says hello world" \
  --height 1024 --width 1024 --steps 4 --guidance 0.0 --seed 0
更多量化推理方式请参考Diffusion模型量化文档。
2.4 Token 压缩 (多模态/VLM)
AngelSlim 提供了一套基于元数据驱动的通用视觉 Token 剪枝与合并框架。你可以通过以下 Smoke Test 快速验证压缩策略(如 VisionZip):
python tools/test_universal_pruning.py \
    --model_path "Qwen/Qwen2.5-VL-3B-Instruct" \
    --config "configs/qwen2_5_vl/pruning/visionzip_r0.9.yaml"
关于如何新增自定义剪枝策略及算法实现细节,请参考 Token 压缩说明文档。
3、部署与测试
3.1 离线推理
通过transformers加载量化模型进行离线推理。
执行脚本细节
python scripts/deploy/offline.py $MODEL_PATH "Hello, my name is"
其中 MODEL_PATH 为量化产出模型路径。
3.2 服务部署
支持通过 vLLM、SGLang推理框架部署 OpenAI 兼容的 API 服务。
执行脚本细节
vLLM
vLLM 服务启动脚本,建议版本
vllm>=0.8.5.post1,部署MOE INT8量化模型需要vllm>=0.9.2。bash scripts/deploy/run_vllm.sh --model-path $MODEL_PATH --port 8080 -d 0,1,2,3 -t 4 -p 1 -g 0.8 --max-model-len 4096其中
-d为可见设备,-t为张量并行度,-p为流水线并行度,-g为显存使用率。SGLang
SGLang 服务启动脚本,建议版本
sglang>=0.4.6.post1:bash scripts/deploy/run_sglang.sh --model-path $MODEL_PATH --port 8080 -d 0,1,2,3 -t 4 -g 0.8
3.3 服务调用
通过 OpenAI 格式 接口发起请求。
执行脚本细节
bash scripts/deploy/openai.sh -m $MODEL_PATH -p "Hello, my name is" --port 8080 --max-tokens 4096 --temperature 0.7 --top-p 0.8 --top-k 20 --repetition-penalty 1.05 --system-prompt "You are a helpful assistant."
其中-p为输入prompt
3.4 效果验证
使用 lm-evaluation-harness 评估量化模型精度,建议版本lm-eval>=0.4.8
执行脚本细节
bash scripts/deploy/lm_eval.sh -d 0,1 -t 2 -g 0.8 -r $RESULT_PATH -b "auto" --tasks ceval-valid,mmlu,gsm8k,humaneval -n 0 $MODEL_PATH
其中RESULT_PATH为测试结果保存目录,-b为batch size大小,--tasks为评测任务,-n为few-shot数量
详细操作指南请参阅部署文档。
📈Benchmark
1、投机采样
下列结果来自 AngelSpec——一个 torch-native、训推分离投机采样训练框架,由 AngelSlim 以 git submodule 形式集成(详见 2.1 节),支持多种 draft 方法,以 DFly 与 MTP + TTT 为代表。[论文] | [文档] | [Hugging Face]
✨ 核心亮点
- 🏗️ 全链路开源:AngelSpec 训练框架 + Hy3-A21B 的 MTP / DFly drafter 权重与训练代码,一次性放出。
- 🚀 DFly 全面领先:在 Hy3-A21B 上,DFly 于 4–64 全部并发档位、六个 benchmark 均取得最高吞吐——相较 AR 基线平均加速 1.98–2.40×(代码 / 数学单项峰值 2.86×),并比 DFlash 快 10.5–11.8%。
- 📈 接受长度大幅提升:DFly 平均接受长度达 4.79,较 DFlash(3.69)+30%、较 MTP(3.00)约 1.6×,HumanEval 高达 5.52。
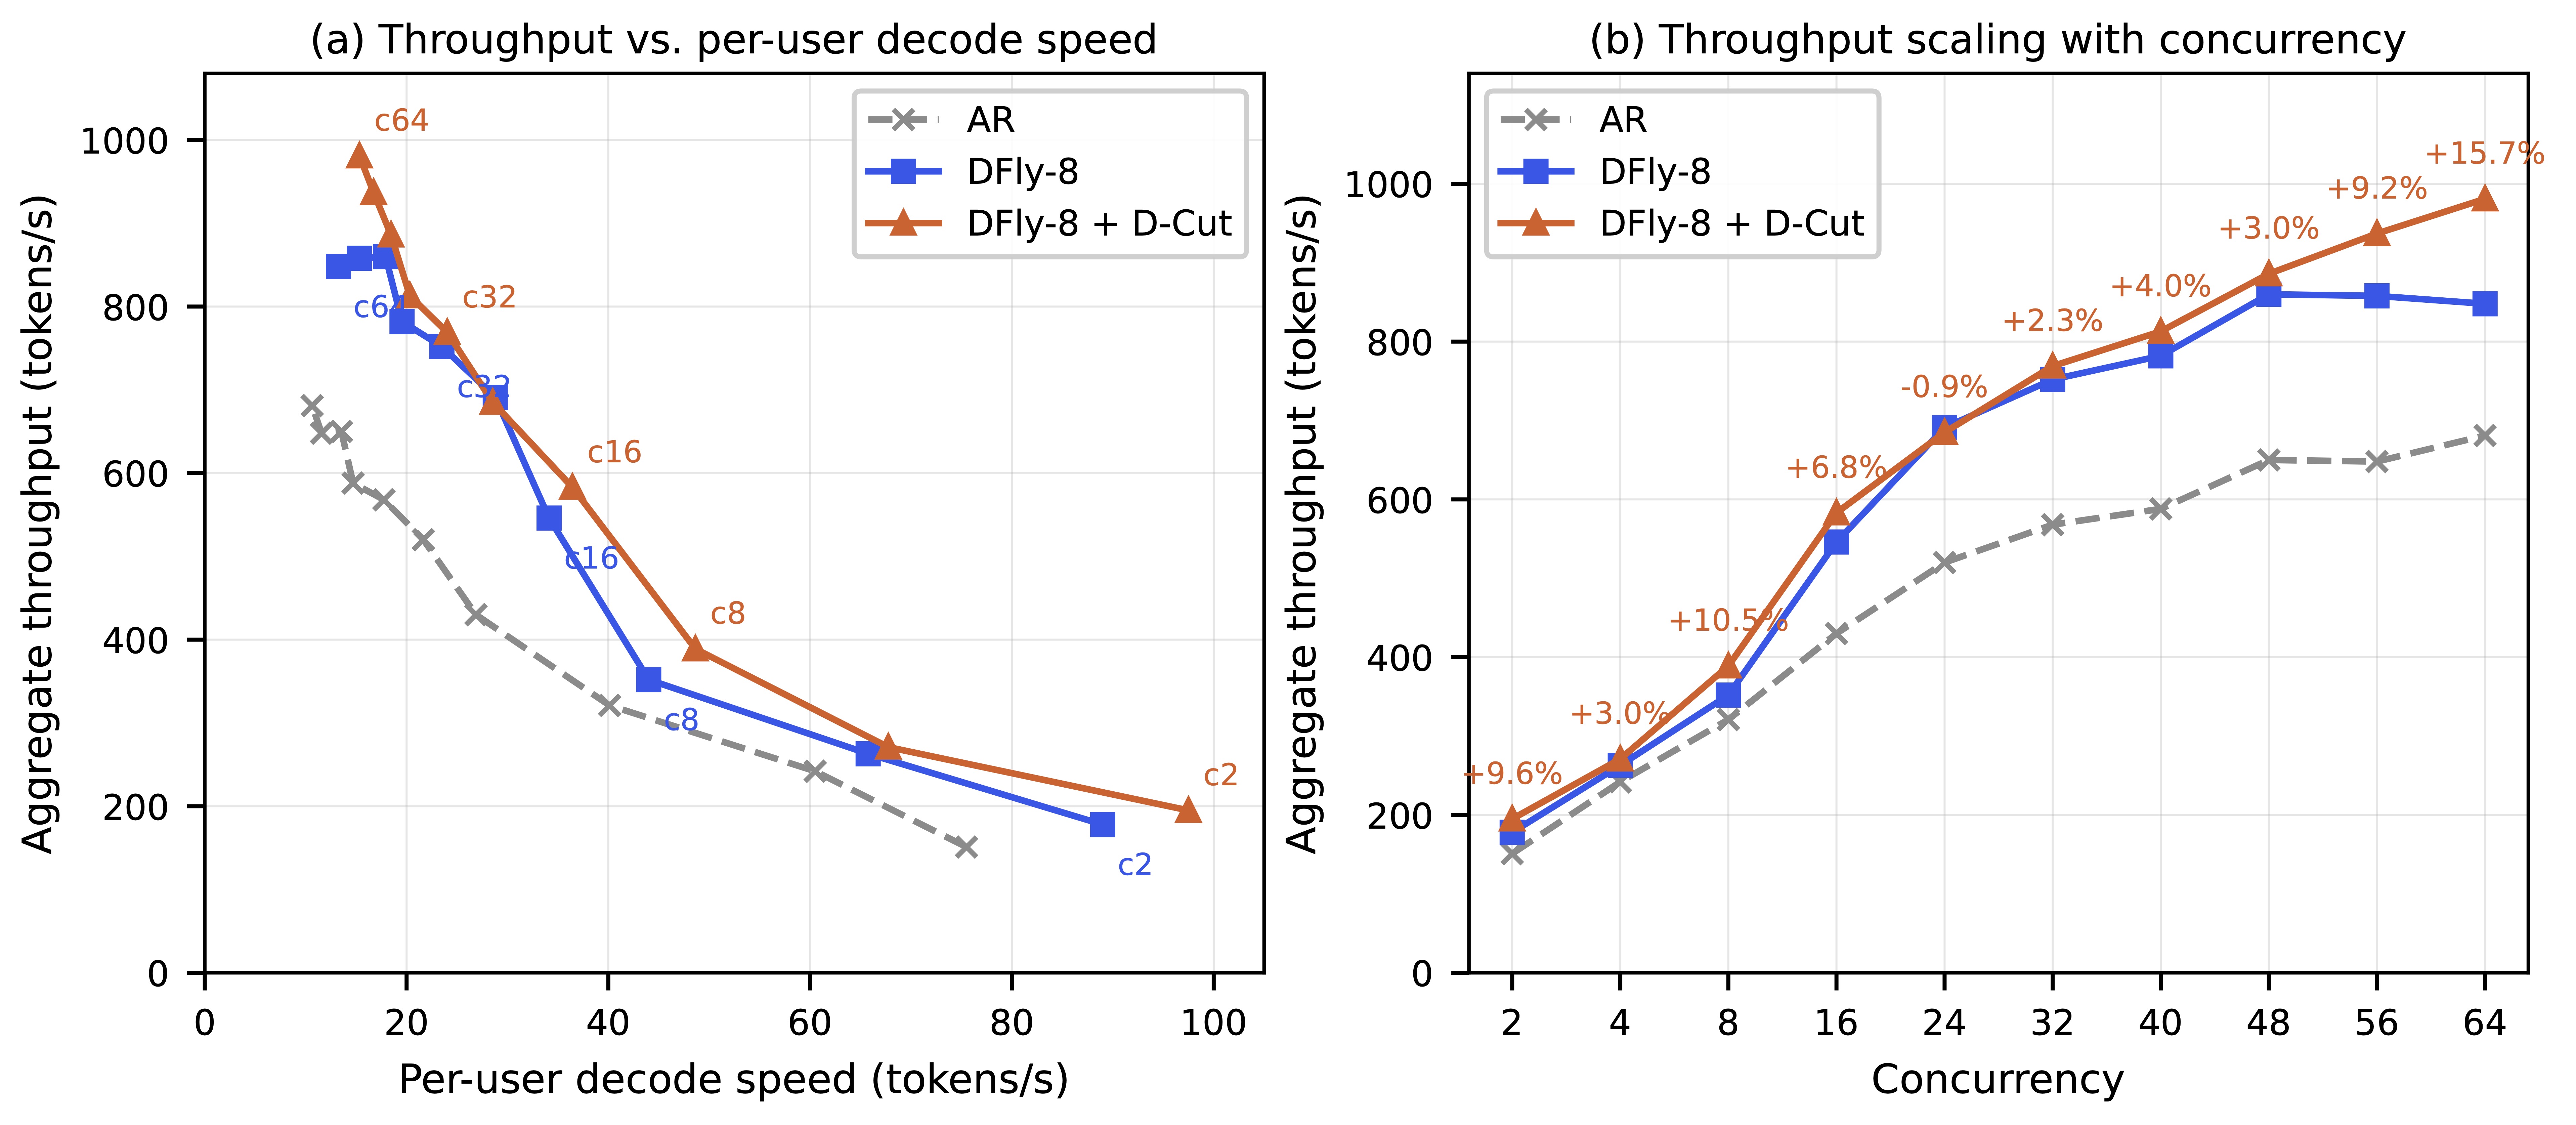
- ⚡ D-cut 榨干高并发:在 295B 模型线上真实流量中,高并发区间额外带来最高 +15.7% 吞吐,且几乎无损(平均接受长度 2.50 → 2.46)。
- 💬 MTP + TTT 攻克对话:修复训练-推理不一致,平均接受率 52.8% → 66.4%,平均接受长度 2.58 → 2.99。
1.1 🏆 Drafter 大比拼:DFly 领跑
起草质量:平均接受长度。 在 Qwen3-8B 与 Hy3-A21B 上、覆盖数学/代码/对话基准测得(temperature = 1,no thinking);粗体表示每个目标模型在对应基准上的最优 drafter。DFly 平均领先——Qwen3-8B 达 5.41、Hy3-A21B 达 4.79,并在几乎所有基准上夺魁,明显甩开 DFlash 与 MTP。
| Target Model | Drafter | Math | Code | Chat | Avg. | |||
|---|---|---|---|---|---|---|---|---|
| Math500 | GSM8K | HumanEval | MBPP | LiveCodeBench | MT-Bench | |||
| Qwen3-8B | MTP | 3.53 | 3.56 | 3.33 | 3.22 | 3.25 | 2.57 | 3.24 |
| DFlash | 4.97 | 5.54 | 4.77 | 4.50 | 4.46 | 3.16 | 4.57 | |
| DSpark | 5.87 | 6.25 | 5.56 | 5.25 | 5.20 | 3.77 | 5.32 | |
| DFly | 6.06 | 6.42 | 5.60 | 5.34 | 5.36 | 3.67 | 5.41 | |
| Hy3-A21B | MTP | 3.30 | 3.30 | 3.13 | 3.04 | 2.84 | 2.40 | 3.00 |
| DFlash | 4.01 | 4.23 | 4.36 | 4.05 | 3.10 | 2.38 | 3.69 | |
| DFly | 5.23 | 5.53 | 5.52 | 5.41 | 4.07 | 2.96 | 4.79 |
端到端吞吐:Hy3-295B-A21B。 相对 AR 基线的输出 token 吞吐(Tok/s)与加速比(Spd.)(TP=8,temperature 1,并发 c4–c64;每格为 3×120s 窗口)。粗体表示每个基准在对应并发下的最优加速比;MTP-3 使用 3 个投机 token,DFlash-8 / DFly-8 使用 block 长度 8。DFly-8 在每个并发档位都拿下最高平均加速——相较 AR 1.98×–2.40×,HumanEval 上峰值达 2.86×。
| Conc. | Method | GSM8K | Math500 | HumanEval | MBPP | LiveCodeBench | MT-Bench | Avg. | |||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Tok/s | Spd. | Tok/s | Spd. | Tok/s | Spd. | Tok/s | Spd. | Tok/s | Spd. | Tok/s | Spd. | Tok/s | Spd. | ||
| c4 | AR | 287.9 | 1.00× | 293.9 | 1.00× | 279.7 | 1.00× | 294.4 | 1.00× | 284.5 | 1.00× | 290.0 | 1.00× | 288.4 | 1.00× |
| MTP-3 | 495.5 | 1.72× | 517.0 | 1.76× | 473.6 | 1.69× | 476.7 | 1.62× | 414.0 | 1.46× | 384.5 | 1.33× | 460.2 | 1.60× | |
| DFlash-8 | 569.5 | 1.98× | 587.9 | 2.00× | 588.1 | 2.10× | 575.7 | 1.96× | 408.4 | 1.44× | 371.6 | 1.28× | 516.9 | 1.79× | |
| DFly-8 | 635.4 | 2.21× | 643.9 | 2.19× | 647.2 | 2.31× | 661.5 | 2.25× | 455.2 | 1.60× | 384.0 | 1.32× | 571.2 | 1.98× | |
| c8 | AR | 426.3 | 1.00× | 435.7 | 1.00× | 400.3 | 1.00× | 433.7 | 1.00× | 413.4 | 1.00× | 421.8 | 1.00× | 421.8 | 1.00× |
| MTP-3 | 756.9 | 1.78× | 791.5 | 1.82× | 717.4 | 1.79× | 729.1 | 1.68× | 620.8 | 1.50× | 590.1 | 1.40× | 701.0 | 1.66× | |
| DFlash-8 | 857.0 | 2.01× | 860.1 | 1.97× | 866.2 | 2.16× | 866.2 | 2.00× | 609.1 | 1.47× | 545.5 | 1.29× | 767.4 | 1.82× | |
| DFly-8 | 964.8 | 2.26× | 959.5 | 2.20× | 974.1 | 2.43× | 1001.5 | 2.31× | 641.3 | 1.55× | 565.8 | 1.34× | 851.2 | 2.02× | |
| c16 | AR | 650.7 | 1.00× | 670.6 | 1.00× | 594.8 | 1.00× | 667.9 | 1.00× | 617.2 | 1.00× | 628.1 | 1.00× | 638.2 | 1.00× |
| MTP-3 | 1146.6 | 1.76× | 1174.0 | 1.75× | 1076.1 | 1.81× | 1103.3 | 1.65× | 893.5 | 1.45× | 876.6 | 1.40× | 1045.0 | 1.64× | |
| DFlash-8 | 1446.1 | 2.22× | 1430.4 | 2.13× | 1433.3 | 2.41× | 1440.4 | 2.16× | 970.5 | 1.57× | 901.0 | 1.43× | 1270.3 | 1.99× | |
| DFly-8 | 1623.8 | 2.50× | 1607.5 | 2.40× | 1595.4 | 2.68× | 1677.8 | 2.51× | 1046.7 | 1.70× | 961.5 | 1.53× | 1418.8 | 2.22× | |
| c32 | AR | 918.6 | 1.00× | 1000.8 | 1.00× | 850.8 | 1.00× | 1018.7 | 1.00× | 893.2 | 1.00× | 921.1 | 1.00× | 933.9 | 1.00× |
| MTP-3 | 1923.8 | 2.09× | 1989.8 | 1.99× | 1780.7 | 2.09× | 1863.6 | 1.83× | 1394.2 | 1.56× | 1469.4 | 1.60× | 1736.9 | 1.86× | |
| DFlash-8 | 2261.8 | 2.46× | 2334.3 | 2.33× | 2170.6 | 2.55× | 2339.3 | 2.30× | 1489.9 | 1.67× | 1453.4 | 1.58× | 2008.2 | 2.15× | |
| DFly-8 | 2527.4 | 2.75× | 2608.9 | 2.61× | 2429.1 | 2.86× | 2741.3 | 2.69× | 1602.6 | 1.79× | 1549.4 | 1.68× | 2243.1 | 2.40× | |
| c64 | AR | 1156.9 | 1.00× | 1381.3 | 1.00× | 1197.6 | 1.00× | 1513.9 | 1.00× | 1229.6 | 1.00× | 1306.9 | 1.00× | 1297.7 | 1.00× |
| MTP-3 | 2932.0 | 2.53× | 3170.0 | 2.29× | 2639.6 | 2.20× | 3011.3 | 1.99× | 2050.4 | 1.67× | 2350.0 | 1.80× | 2692.2 | 2.08× | |
| DFlash-8 | 2523.4 | 2.18× | 2947.1 | 2.13× | 2655.2 | 2.22× | 2671.8 | 1.76× | 2015.8 | 1.64× | 1815.8 | 1.39× | 2438.2 | 1.89× | |
| DFly-8 | 2827.8 | 2.44× | 3301.8 | 2.39× | 2965.0 | 2.48× | 3130.9 | 2.07× | 2195.0 | 1.79× | 1936.6 | 1.48× | 2726.2 | 2.11× |
1.2 ⚡ D-cut:突破高并发吞吐天花板
并发一高,target 验证就成了瓶颈,被拒绝的 draft 后缀白白占用 batch 容量。D-cut 把验证当作 batch 级的共享预算——按「期望收益/成本」对各请求的验证深度全局排序,空闲时自动加深 draft,繁忙时主动裁剪。优势恰好出现在 DFly 触顶之处:并发 48 之后 DFly 吞吐饱和,而 D-cut 仍在把负载转化为吞吐,相较 DFly 最高 +15.7%,且几乎无损(平均接受长度 2.50 → 2.46)。
2、量化
下面只展示了部分模型的效果测试情况,完整Benchmark可以参考Benchmark文档
2.1 Hunyuan系列模型
Hunyuan-Instruct的BF16、FP8、INT4-GPTQ、INT4-AWQ在OlympiadBench、AIME 2024、DROP、GPQA-Diamond上的评测结果如下:
| Model | Quantization | OlympiadBench | AIME 2024 | DROP | GPQA-Diamond |
|---|---|---|---|---|---|
| Hunyuan-A13B-Instruct | BF16 | 82.7 | 87.30 | 91.1 | 71.2 |
| FP8-Static | 83.0 | 86.7 | 91.1 | - | |
| Int4-GPTQ | 82.7 | 86.7 | 91.1 | - | |
| Int4-AWQ | 82.6 | 85.6 | 91.0 | - | |
| Hunyuan-7B-Instruct | BF16 | 76.5 | 81.1 | 85.9 | 60.1 |
| FP8-Static | 76.6 | 80.9 | 86.0 | 60.1 | |
| Int4-GPTQ | 76.2 | 81.0 | 85.7 | 60.0 | |
| Int4-AWQ | 76.4 | 80.9 | 85.9 | 60.1 | |
| Hunyuan-4B-Instruct | BF16 | 73.1 | 78.3 | 78.2 | 61.1 |
| FP8-Static | 73.1 | 76.6 | 78.3 | 60.2 | |
| Int4-GPTQ | 72.9 | - | 78.1 | 58.1 | |
| Int4-AWQ | 72.8 | - | 78.2 | - | |
| Hunyuan-1.8B-Instruct | BF16 | 63.4 | 56.7 | 76.7 | 47.2 |
| FP8-Static | 62.5 | 55.2 | 75.1 | 47.7 | |
| Int4-GPTQ | 60.9 | - | 73.0 | 44.4 | |
| Int4-AWQ | 61.7 | - | 71.7 | 43.6 | |
| Hunyuan-0.5B-Instruct | BF16 | 29.6 | 17.2 | 52.8 | 23.3 |
| FP8-Static | 29.6 | 17.2 | 51.6 | 22.5 | |
| Int4-GPTQ | 26.8 | - | 50.9 | 23.3 | |
| Int4-AWQ | 26.3 | - | 48.9 | 23.3 |
2.2 Qwen3系列模型
Qwen3系列模型的BF16、FP8-Static、FP8-Dynamic、INT8-Dynamic、INT4-GPTQ、INT4-AWQ在CEVAL、MMLU、GSM8K、HUMANEVAL上的评测结果如下:
| Model | Quantization | CEVAL | MMLU | GSM8K | HUMANEVAL |
|---|---|---|---|---|---|
| Qwen3-0.6B | BF16 | 45.84 | 47.21 | 42.99 | 19.51 |
| FP8-Static | 45.99 | 46.87 | 38.06 | 18.90 | |
| FP8-Dynamic | 45.99 | 46.93 | 38.29 | 20.73 | |
| INT8-Dynamic | 45.17 | 46.95 | 41.17 | 21.34 | |
| Qwen3-8B | BF16 | 79.27 | 74.78 | 87.79 | 63.41 |
| FP8-Static | 78.23 | 74.79 | 86.96 | 62.20 | |
| FP8-Dynamic | 78.45 | 74.75 | 87.64 | 62.80 | |
| INT8-Dynamic | 78.01 | 74.84 | 86.96 | 67.07 | |
| INT4-GPTQ | 77.19 | 73.26 | 86.43 | 62.20 | |
| INT4-AWQ | 76.15 | 73.59 | 86.96 | 63.41 | |
| Qwen3-14B | BF16 | 83.06 | 78.90 | 88.40 | 55.49 |
| FP8-Static | 82.62 | 78.57 | 89.46 | 57.32 | |
| FP8-Dynamic | 82.24 | 78.92 | 88.32 | 52.44 | |
| INT8-Dynamic | 81.87 | 78.13 | 86.28 | 56.10 | |
| INT4-GPTQ | 81.05 | 78.02 | 87.34 | 57.93 | |
| INT4-AWQ | 82.02 | 77.68 | 84.23 | 61.59 | |
| Qwen3-32B | BF16 | 86.55 | 82.00 | 74.53 | 37.80 |
| FP8-Static | 86.92 | 81.78 | 70.20 | 39.63 | |
| FP8-Dynamic | 86.55 | 81.89 | 70.43 | 38.41 | |
| INT4-GPTQ | 86.18 | 81.01 | - | 43.29 | |
| INT4-AWQ | 86.18 | 81.54 | - | 36.59 | |
| Qwen3-30B-A3B | BF16 | 83.66 | 79.36 | 89.99 | 31.71 |
| FP8-Static | 83.95 | 79.47 | 89.01 | 31.10 | |
| FP8-Dynamic | 84.10 | 79.40 | 89.16 | 32.93 | |
| INT8-Dynamic | 83.36 | 79.48 | 89.16 | 34.15 | |
| Qwen3-235B-A22B | BF16 | 89.60 | 86.28 | 85.29 | 27.44 |
| FP8-Static | 89.67 | 86.19 | 86.96 | 27.44 | |
| FP8-Dynamic | 89.67 | 86.18 | 85.22 | 28.05 | |
| INT8-Dynamic | 88.93 | 86.20 | 86.20 | 23.78 |
2.3 DeepSeek系列模型
DeepSeek-R1-0528模型的FP8-Block-Wise、W4A8-FP8在GPQA Diamond、AIME 2024、SimpleQA、LiveCodeBench上的评测结果如下:
| Model | Quantization | GPQA Diamond | AIME 2024 | SimpleQA | LiveCodeBench |
|---|---|---|---|---|---|
| DeepSeek-R1-0528 | FP8-Block-Wise | 78.28 | 88.67 | 27.8 | 77.1 |
| W4A8-FP8 | 77.37 | 88.67 | 26.83 | 78.86 |
备注
- 以上评测结果使用TRT-LLM框架部署测试5次求平均
- 评测时使用的超参如下:
{
 "top_k": 20,
 "top_p": 0.6,
 "temperature": 0.7,
 "output_seq_len": 32768,
 "max_input_seq_len": 16384
}
2.4 Qwen-VL 系列模型
Qwen3-VL Benchmark
Qwen3VL系列模型的BF16、FP8-Static、FP8-Dynamic在MMMU_VAL、DocVQA_VAL、ChartQA_TEST上的评测结果如下:
| Model | Quantization | MMMU_VAL | DocVQA_VAL | ChartQA_TEST |
|---|---|---|---|---|
| Qwen3-VL-32B-Instruct | BF16 | 60.11 | 96.08 | 94.64 |
| FP8-Static | 61.22 | 96.00 | 94.64 | |
| FP8-Dynamic | 60.78 | 96.19 | 94.72 | |
| Qwen3-VL-30B-A3B-Instruct | BF16 | 50.44 | 95.28 | 95.36 |
| FP8-Dynamic | 50.67 | 95.25 | 95.20 |
Qwen2.5VL Benchmark
Qwen2.5VL系列模型的BF16、FP8-Static、FP8-Dynamic、INT4-GPTQ、INT4-AWQ在MMMU_VAL、DocVQA_VAL、ChartQA_TEST上的评测结果如下:
| Model | Quantization | MMMU_VAL | MMLDocVQA_VALU | ChartQA_TEST |
|---|---|---|---|---|
| Qwen2.5VL-3B | BF16 | 47.11 | 78.57 | 80.32 |
| FP8-Static | 47.33 | 79.34 | 79.68 | |
| FP8-Dynamic | 45.99 | 46.93 | 38.29 | |
| INT4-GPTQ | 46.56 | 77.20 | 78.96 | |
| INT4-AWQ | 45.78 | - | 79.60 | |
| Qwen2.5VL-7B | BF16 | 45.44 | 89.71 | 84.64 |
| FP8-Static | 47.00 | 89.83 | 85.92 | |
| FP8-Dynamic | 47.22 | 89.80 | 88.64 | |
| INT4-GPTQ | 46.67 | 90.45 | - | |
| INT4-AWQ | 45.67 | 89.28 | - | |
| Qwen2.5VL-32B | BF16 | 57.00 | 90.03 | - |
| FP8-Static | 57.00 | 89.88 | - | |
| FP8-Dynamic | 56.44 | 89.88 | - | |
| INT4-GPTQ | 55.22 | 89.80 | - | |
| INT4-AWQ | 55.22 | 90.30 | - | |
| Qwen2.5VL-72B | BF16 | 58.78 | 94.39 | 85.60 |
| FP8-Static | 57.89 | 94.41 | 85.84 | |
| FP8-Dynamic | 58.67 | 94.38 | 85.60 | |
| INT4-GPTQ | 57.56 | 94.46 | 86.48 | |
| INT4-AWQ | 58.78 | 94.19 | 87.28 |
2.5 Qwen-Omni 系列模型
Qwen3-Omni Text to Text Benchmark
Qwen3-Omni系列模型的BF16、FP8-Static、FP8-Dynamic在aime25、gpqa_diamond、mmlu_redux上的评测结果如下:
| Model | Quantization | aime25 | gpqa_diamond | mmlu_redux |
|---|---|---|---|---|
| Qwen3-Omni-30B-A3B-Instruct | BF16 | 73.32 | 56.77 | 88.09 |
| FP8-Static | 71.33 | 56.57 | 87.91 | |
| FP8-Dynamic | 73.33 | 55.15 | 88.07 |
备注
- 以上评测结果使用vllm框架部署测试5次求平均(vllm只支持thinker部分)
- 评测时使用的超参如下:
{
 "top_p": 0.95,
 "temperature": 0.6,
 "do_sample": true,
 "max-model-len 65536": 65536
}
2.6 其他模型
其他模型比如GLM、Qwen2.5、Seed-OSS等模型利用FP8-Static、FP8-Dynamic、INT4-GPTQ、INT4-AWQ量化等策略在CEVAL、MMLU、GSM8K上进行了评测。
Benchmark实验细节
| Model | Quantization | CEVAL | MMLU | GSM8K |
|---|---|---|---|---|
| Qwen2.5-1.5B-Instruct | BF16 | 67.01 | 60.05 | 54.28 |
| FP8-Static | 66.27 | 60.23 | - | |
| FP8-Dynamic | 66.79 | 60.08 | 51.71 | |
| Qwen2.5-7B-Instruct | BF16 | 81.20 | 74.55 | 79.98 |
| FP8-Static | 81.13 | 74.03 | 79.30 | |
| FP8-Dynamic | 80.31 | 74.07 | 79.00 | |
| INT4-GPTQ | 79.05 | 73.05 | 74.75 | |
| INT4-AWQ | 79.35 | 73.22 | 79.38 | |
| Qwen2.5-32B-Instruct | BF16 | 87.30 | 83.21 | 81.73 |
| FP8-Static | 87.59 | 83.08 | 81.58 | |
| FP8-Dynamic | 87.30 | 83.04 | 81.58 | |
| INT4-GPTQ | 86.70 | 82.45 | 82.03 | |
| INT4-AWQ | 87.00 | 82.64 | - | |
| DeepSeek-R1-Distill-Qwen-7B | BF16 | 53.49 | 53.80 | 75.74 |
| FP8-Static | 53.57 | 54.17 | 76.19 | |
| FP8-Dynamic | 52.97 | 54.13 | 74.15 | |
| INT4-GPTQ | 51.86 | 52.44 | 75.89 | |
| INT4-AWQ | 53.49 | 53.70 | - | |
| DeepSeek-R1-Distill-Qwen-14B | BF16 | 77.71 | 74.28 | 85.67 |
| FP8-Static | 77.56 | 74.66 | 86.73 | |
| FP8-Dynamic | 76.82 | 74.63 | 87.11 | |
| INT4-GPTQ | 74.29 | 72.37 | 84.61 | |
| INT4-AWQ | 74.81 | 73.00 | 86.05 | |
| DeepSeek-R1-Distill-Qwen-32B | BF16 | 84.18 | 80.89 | 87.41 |
| FP8-Static | 83.43 | 80.90 | 87.57 | |
| FP8-Dynamic | 83.73 | 81.10 | 86.43 | |
| INT4-GPTQ | 84.10 | 79.80 | 86.73 | |
| INT4-AWQ | 82.84 | 80.15 | 87.19 |
3. Token 压缩 (多模态/VLM)
我们在 Qwen2.5-VL-3B-Instruct 模型上评估了多种视觉 Token 压缩策略(剪枝与合并)。你可以使用以下指令复现评测结果:
python tools/run_pruning_eval.py \
    --model_path "Qwen/Qwen2.5-VL-3B-Instruct" \
    --configs "configs/qwen2_5_vl/pruning/visionzip_r0.9.yaml" \
    --tasks "textvqa" \
    --output_dir "./results/visionzip_test"
Token 压缩详细评测结果 (Qwen2.5-VL-3B-Instruct)
| 方法 | AI2D | ChartQA | DocVQA | MMBCN | MMB | MME | MMStar | OCRBench | POPE | SQA | VQAText | 平均值 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Baseline | 79.11 | 83.56 | 92.48 | 73.28 | 77.32 | 1517 | 56.05 | 80.10 | 87.41 | 80.81 | 78.79 | 100.0% |
| 保留 25% Tokens (75% 压缩比) | ||||||||||||
| FastV | 72.70 | 70.04 | 75.98 | 63.40 | 66.92 | 1437 | 47.39 | 36.60 | 86.42 | 79.33 | 73.51 | 86.02% |
| VisionZip | 74.19 | 71.32 | 70.11 | 67.35 | 71.22 | 1452 | 49.37 | 42.50 | 85.51 | 81.36 | 68.12 | 87.34% |
| HiPrune | 73.83 | 72.76 | 72.10 | 67.27 | 72.34 | 1449 | 48.93 | 41.30 | 85.86 | 80.91 | 69.27 | 87.67% |
| VisionSelector | 75.19 | 73.72 | 90.24 | 68.81 | 72.59 | 1521 | 49.97 | 61.80 | 85.36 | 80.37 | 76.86 | 93.62% |
| DivPrune | 73.06 | 62.96 | 78.46 | 67.10 | 71.82 | 1459 | 48.38 | 51.40 | 86.81 | 80.22 | 68.91 | 88.15% |
| DART | 71.08 | 65.20 | 79.72 | 65.38 | 71.05 | 1428 | 48.78 | 41.80 | 80.97 | 80.91 | 68.25 | 86.17% |
| VisPruner | 74.29 | 68.20 | 72.52 | 67.35 | 70.88 | 1458 | 49.74 | 44.80 | 86.59 | 81.46 | 69.62 | 87.87% |
| SCOPE | 75.84 | 74.00 | 82.40 | 68.81 | 72.94 | 1471 | 50.35 | 56.00 | 86.62 | 80.96 | 74.04 | 91.98% |
| IDPruner | 75.94 | 75.84 | 90.00 | 69.42 | 73.80 | 1505 | 49.49 | 64.90 | 86.26 | 80.42 | 76.90 | 94.42% |
| 保留 10% Tokens (90% 压缩比) | ||||||||||||
| FastV | 65.87 | 29.72 | 36.89 | 48.37 | 51.98 | 1257 | 37.28 | 13.90 | 79.50 | 77.05 | 57.75 | 65.30% |
| VisionZip | 67.65 | 51.60 | 37.88 | 59.62 | 63.06 | 1338 | 42.82 | 21.40 | 81.14 | 80.47 | 51.56 | 72.75% |
| HiPrune | 67.75 | 53.20 | 41.15 | 59.45 | 63.14 | 1326 | 41.08 | 20.30 | 80.90 | 80.96 | 53.31 | 73.00% |
| VisionSelector | 70.50 | 65.92 | 79.94 | 59.97 | 64.69 | 1374 | 42.86 | 45.20 | 82.66 | 80.61 | 71.57 | 84.42% |
| DivPrune | 67.71 | 43.12 | 58.03 | 61.25 | 65.12 | 1389 | 40.43 | 27.90 | 82.24 | 79.18 | 56.87 | 75.50% |
| DART | 67.49 | 47.56 | 60.23 | 57.99 | 63.83 | 1299 | 42.18 | 23.40 | 74.20 | 78.63 | 58.02 | 74.09% |
| VisPruner | 67.75 | 47.92 | 48.65 | 59.28 | 63.32 | 1305 | 41.51 | 22.50 | 78.74 | 79.77 | 54.95 | 73.19% |
| SCOPE | 69.75 | 56.24 | 55.01 | 64.26 | 67.18 | 1390 | 44.35 | 30.80 | 83.34 | 80.47 | 62.58 | 79.37% |
| IDPruner | 71.79 | 63.32 | 79.38 | 63.57 | 68.21 | 1438 | 44.05 | 45.50 | 84.51 | 80.57 | 70.02 | 85.71% |
📝许可协议
本项目的代码依照 License for AngelSlim 协议开源。
🔗引用
@article{angelslim2026,
  title={AngelSlim: A more accessible, comprehensive, and efficient toolkit for large model compression},
  author={Hunyuan AI Infra Team},
  journal={arXiv preprint arXiv:2602.21233},
  year={2026}
}
💬技术交流
AngelSlim是由腾讯混元AI Infra团队研发,新功能在持续迭代更新中,有问题或建议欢迎通过GitHub Issues给我们提issue,或者加入微信技术交流群。
⭐ 欢迎给这个仓库点Star来关注后续我们的更新。并且如果有兴趣加入团队进行实习或正式工作,可投递简历至邮箱:[email protected]。
探索相关项目
affaan-m/ECC
智能体执行与控制框架的性能优化系统。面向 Claude Code、Codex、Opencode、Cursor 等,涵盖技能、本能、记忆、安全与研究优先的开发。
299,558 星标NousResearch/hermes-agent
与你一同成长的智能体
261,686 星标multica-ai/andrej-karpathy-skills
一个用于改进 Claude Code 行为的 CLAUDE.md 文件,源自 Andrej Karpathy 对 LLM 编程陷阱的观察。
230,859 星标firecrawl/firecrawl
借助来自网络及其他来源的数据,强化你的 AI 智能体。正在构建面向超级智能的资料库。🔥
199,551 星标