
Tencent-Hunyuan/HunyuanWorld-Mirror
Tencent-Hunyuan/HunyuanWorld-Mirror has 1,229 GitHub stars and 124 forks. GitHot measured +1 stars in 24 hours and +6 in 7 days. Last checked 2026-11-12 03:33 UTC. Last push 2026-05-27.
[ICML 2026] WorldMirror: Fast and Universal 3D reconstruction model for versatile tasks
实测星标增长
- 24小时
- +1
- 7天
- +6
- 15天
- 正在收集历史
- 1个月
- 正在收集历史
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
README_zh.md
原文HunyuanWorld-Mirror [ICML 2026]



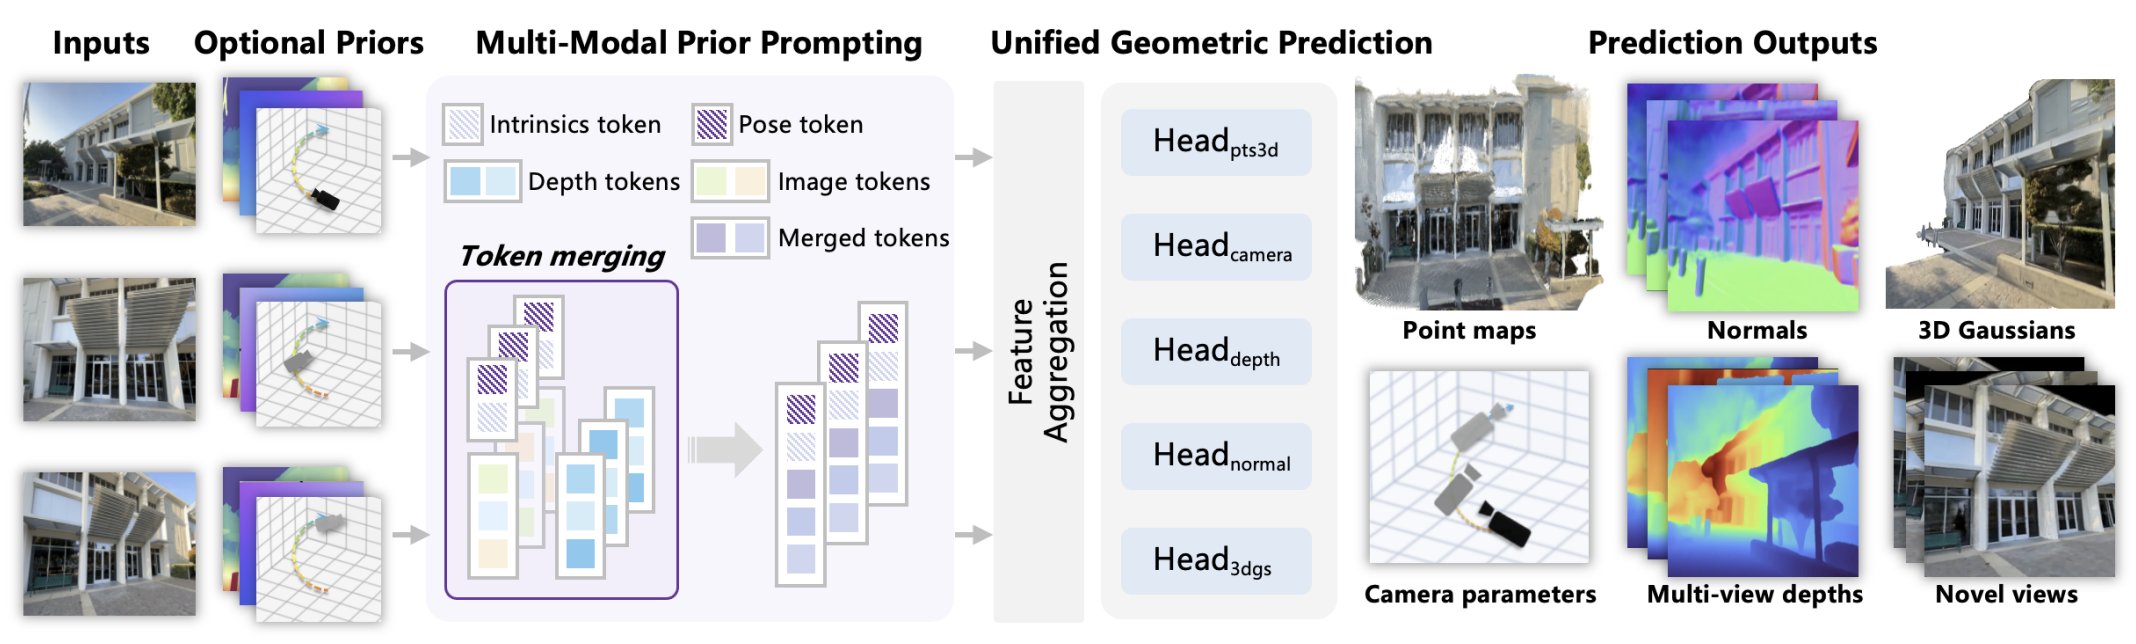
HunyuanWorld-Mirror 是一个多功能的前馈模型,用于全面的3D几何预测。它整合了多种几何先验(相机位姿、校准内参、深度图),并在单次前向传播中同时生成各种3D表示(点云、多视图深度、相机参数、表面法线、3D高斯)。
https://github.com/user-attachments/assets/ced3ef9e-8f90-423f-8ad0-ada9069111d6
🔥🔥🔥 更新
- [2026年5月20日]: 🚀🚀🚀 WorldMirror论文被ICML2026接收了!
- [2026年4月16日]: 🤗 我们发布了 HY-World-2.0 和 WorldMirror-2.0, 3D世界模型新标杆!
- [2025年11月7日]:🚀🚀🚀 我们发布了训练和评估代码。详见训练说明和评估说明。
- [2025年10月22日]:我们发布了推理代码和模型权重。下载预训练模型。
| 微信群 | 小红书 | X | Discord |
|---|---|---|---|
 |
 |
 |
 |
目录
☯️ HunyuanWorld-Mirror 介绍
架构
HunyuanWorld-Mirror 由两个关键组件组成:
(1) 多模态先验提示:一种将多种先验模态(包括校准内参、相机位姿和深度)嵌入到前馈模型中的机制。给定任何可用先验的子集,我们利用几个轻量级编码层将每种模态转换为结构化的token。
(2) 通用几何预测:一个统一的架构,能够处理从相机和深度估计到点图回归、表面法线估计和新视图合成的全方位3D重建任务。
🛠️ 依赖和安装
我们建议使用 CUDA 12.4 版本进行手动安装。
# 1. 克隆仓库
git clone https://github.com/Tencent-Hunyuan/HunyuanWorld-Mirror
cd HunyuanWorld-Mirror

# 2. 创建 conda 环境
conda create -n hunyuanworld-mirror python=3.10 cmake=3.14.0 -y
conda activate hunyuanworld-mirror

# 3. 使用 pip 安装 PyTorch 和其他依赖
# 对于 CUDA 12.4
pip install torch==2.4.0 torchvision==0.19.0 --index-url https://download.pytorch.org/whl/cu124

# 4. 安装 pip 依赖
pip install -r requirements.txt

# 5. 安装 gsplat 用于 3D 高斯点云渲染
# 对于 CUDA 12.4
pip install gsplat --index-url https://docs.gsplat.studio/whl/pt24cu124
🎮 快速开始
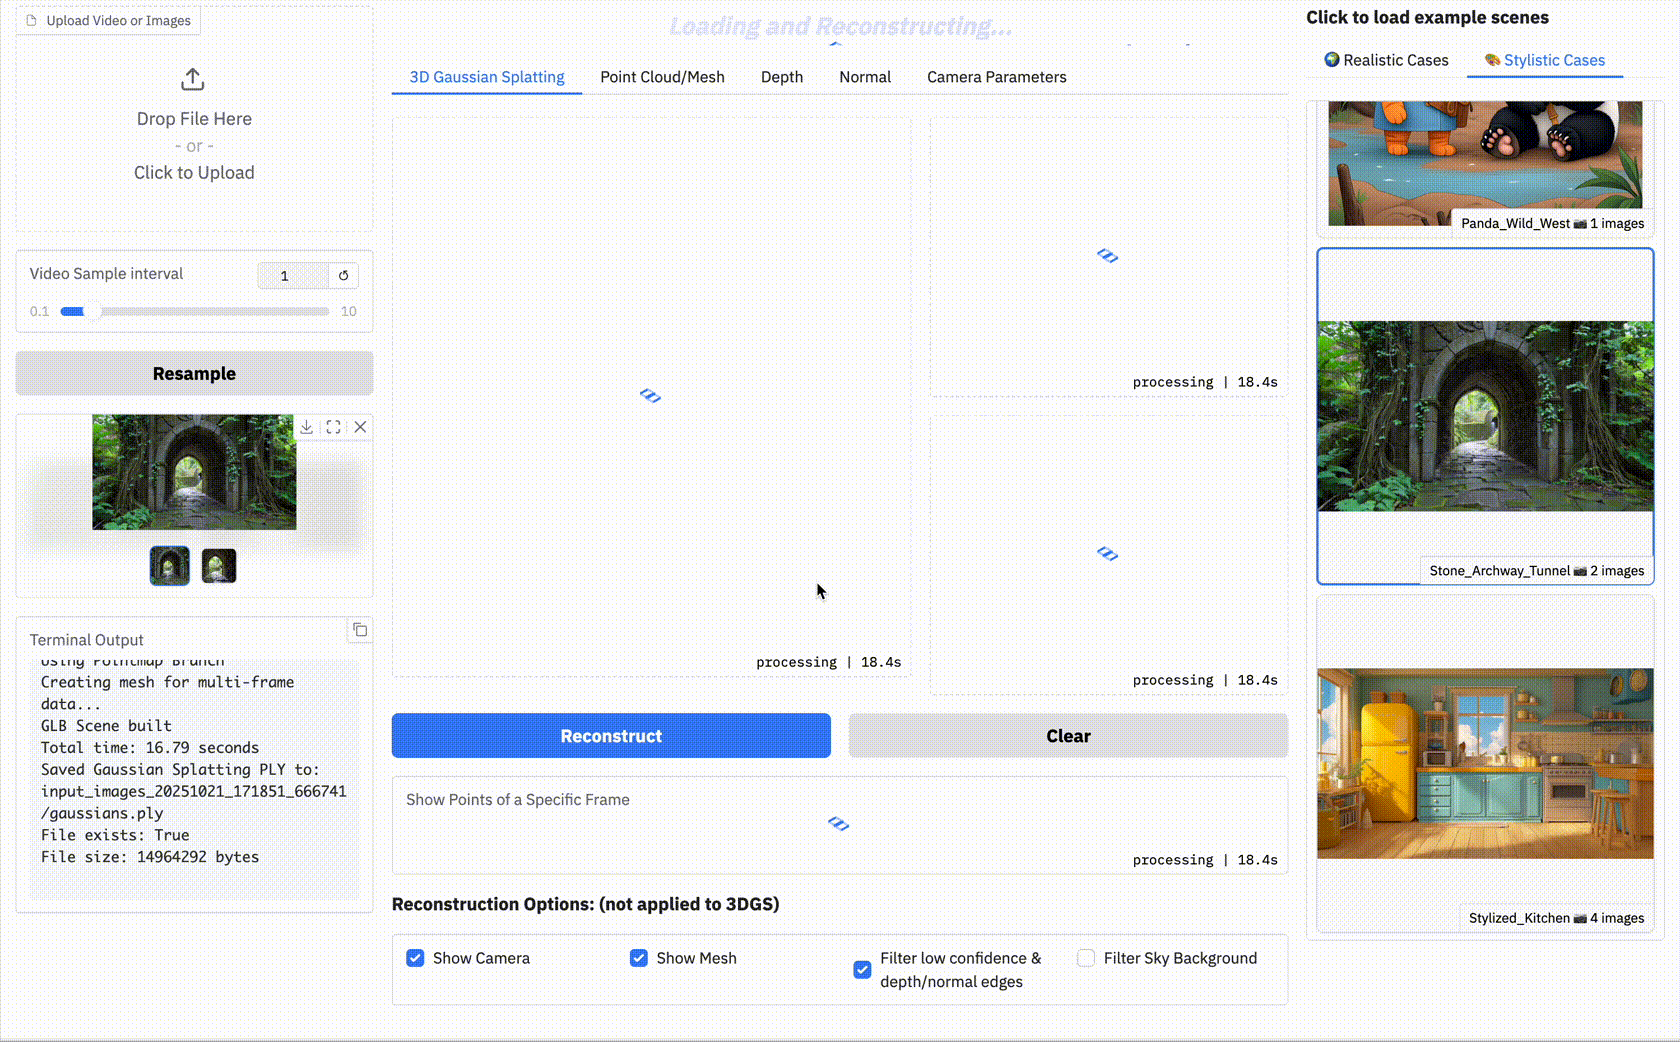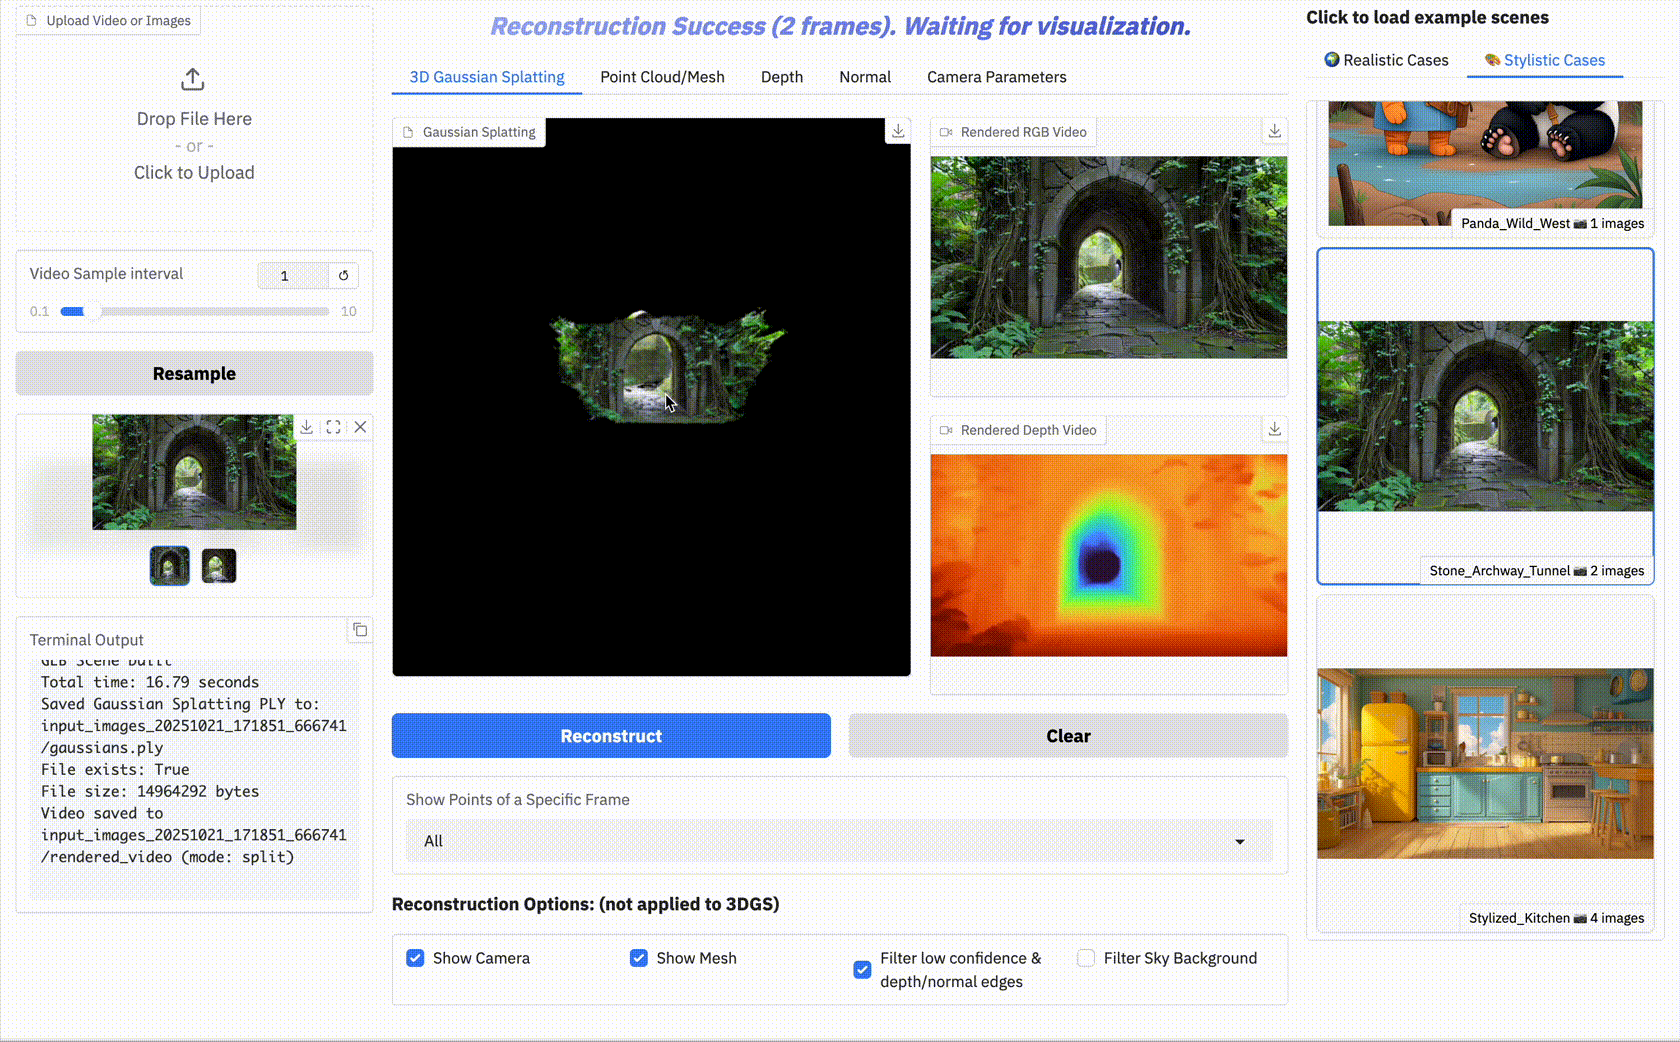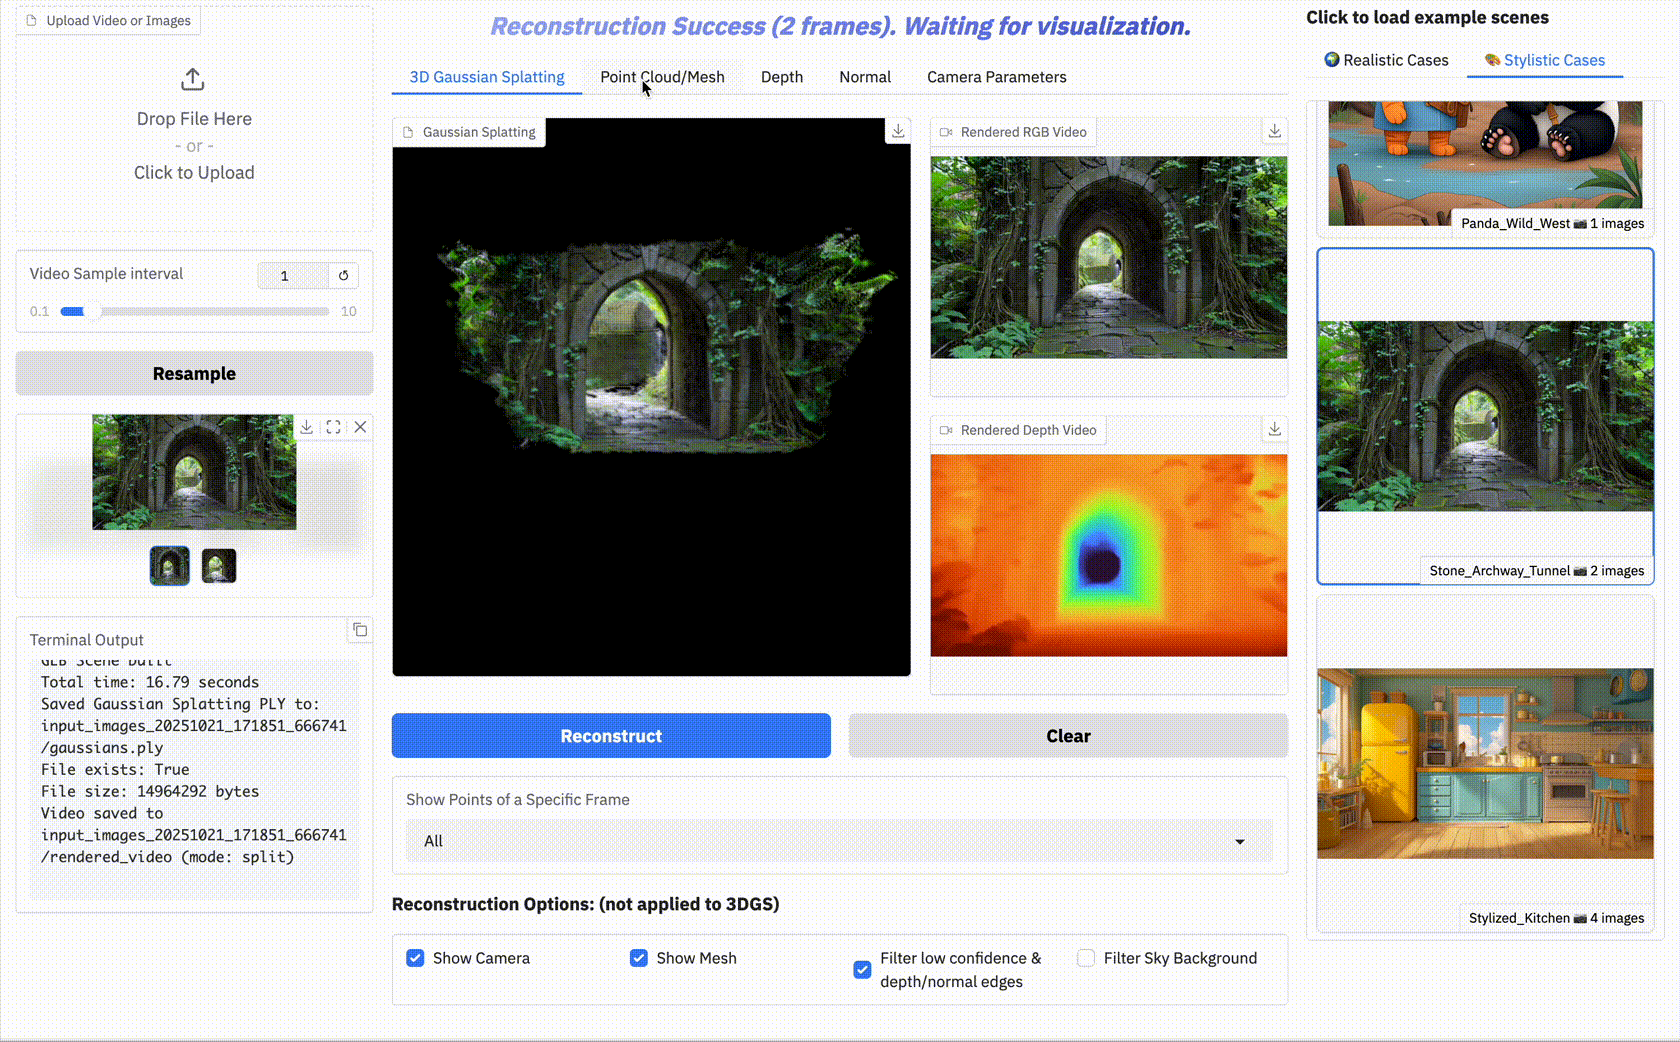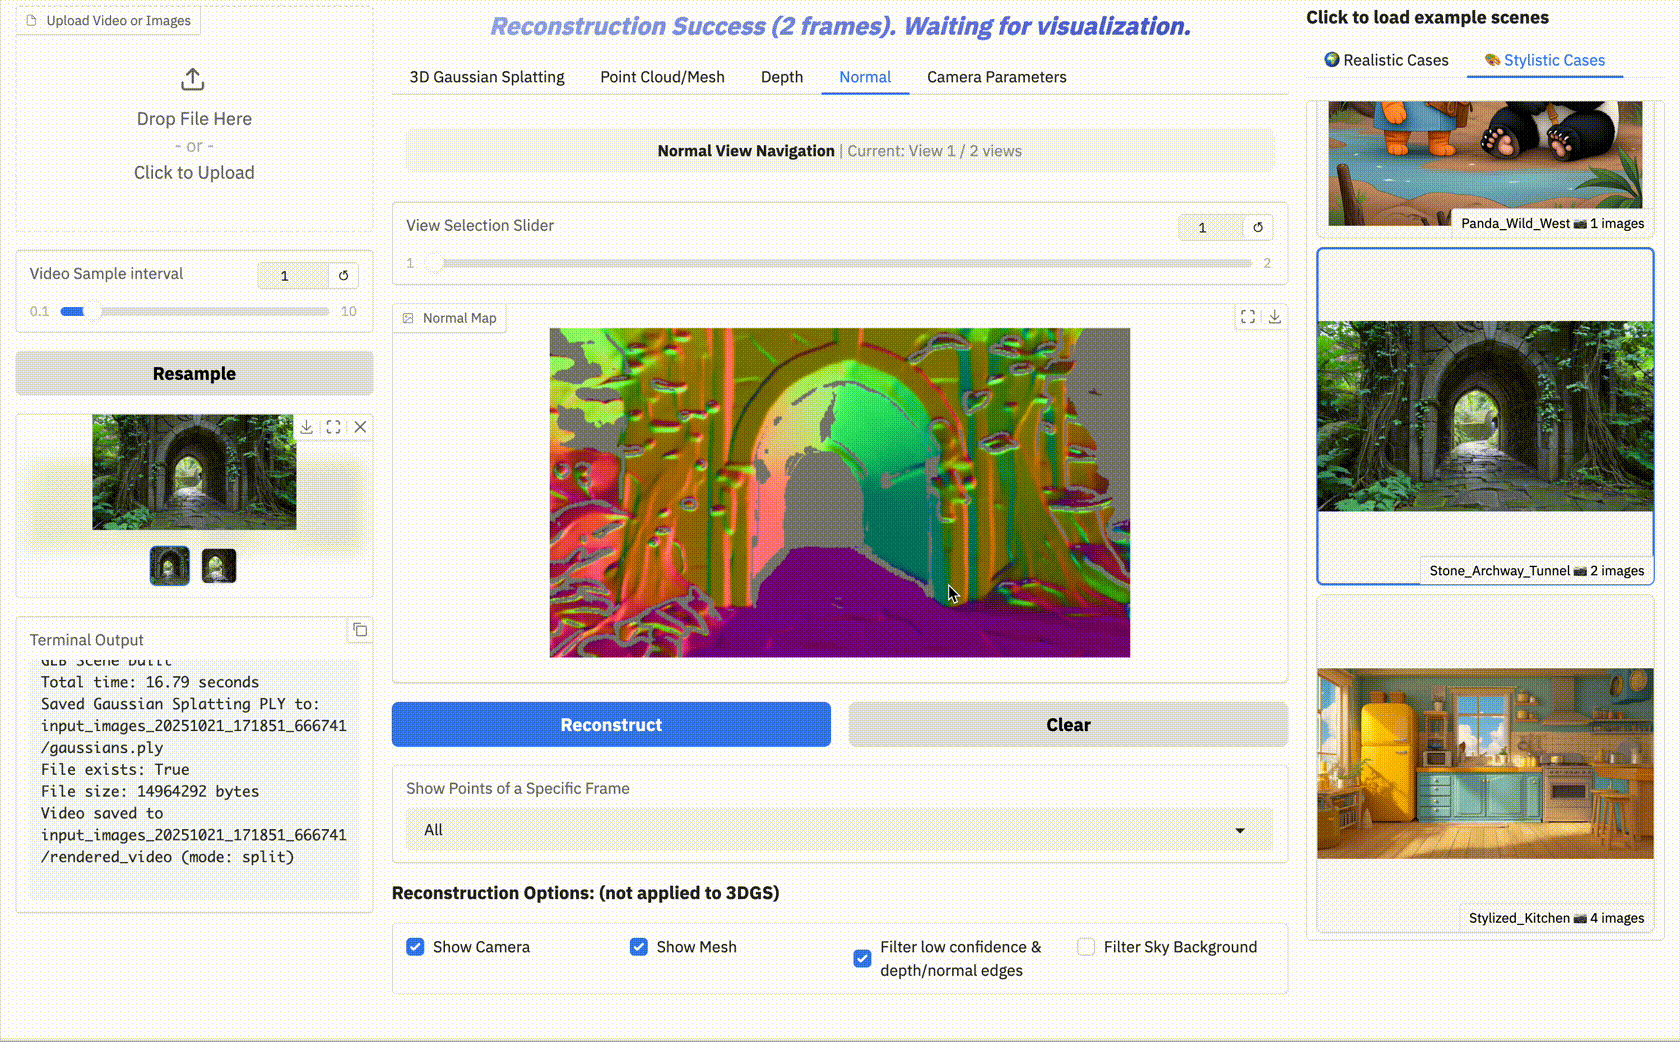
我们提供了一个 Gradio 演示,用于快速体验 HunyuanWorld-Mirror 模型。
在线演示
无需安装即可试用我们的在线演示:🤗 Hugging Face 演示
本地演示
# 1. 安装 gradio 演示所需的依赖
pip install -r requirements_demo.txt
# 对于 Windows 系统,请将 onnxruntime 和 gsplat 替换为 Windows 版本的 wheel 包(详见 requirements_demo.txt 中的注释)
# 2. 在本地启动 gradio 演示
python app.py
📦 下载预训练模型
要下载 HunyuanWorld-Mirror 模型,首先安装 huggingface-cli:
python -m pip install "huggingface_hub[cli]"
然后使用以下命令下载模型:
huggingface-cli download tencent/HunyuanWorld-Mirror --local-dir ./ckpts
注意:对于推理,模型权重将在运行推理脚本时自动从 Hugging Face 下载,因此如果愿意,您可以跳过此手动下载步骤。
🚀 使用图像和先验进行推理
示例代码片段
from pathlib import Path
import torch
from src.models.models.worldmirror import WorldMirror
from src.utils.inference_utils import extract_load_and_preprocess_images

# --- Setup ---
device = 'cuda' if torch.cuda.is_available() else 'cpu'
model = WorldMirror.from_pretrained("tencent/HunyuanWorld-Mirror").to(device)

# --- Load Data ---
# 加载 N 张图像序列到张量
inputs = {}
inputs['img'] = extract_load_and_preprocess_images(
    Path("path/to/your/data"), # 视频或包含图像的目录
    fps=1, # 从视频提取帧的帧率
    target_size=518
).to(device)  # [1,N,3,H,W], 范围 [0,1]
# -- 加载先验(可选) --
# 配置条件标志和先验路径
cond_flags = [0, 0, 0]  # [camera_pose, depth, intrinsics]
prior_data = {
    'camera_poses': None,      # 相机位姿张量 [1, N, 4, 4]
    'depthmap': None,         # 深度图张量 [1, N, H, W]
    'camera_intrs': None # 相机内参张量 [1, N, 3, 3]
}
for idx, (key, data) in enumerate(prior_data.items()):
    if data is not None:
        cond_flags[idx] = 1
        inputs[key] = data

# --- Inference ---
with torch.no_grad():
    predictions = model(views=inputs, cond_flags=cond_flags)
输出格式
# 几何输出
pts3d_preds, pts3d_conf = predictions["pts3d"][0], predictions["pts3d_conf"][0]      # 世界坐标系中的3D点云:[S, H, W, 3], 点云置信度: [S, W, H]
depth_preds, depth_conf = predictions["depth"][0], predictions["depth_conf"][0]      # 相机坐标系中的Z深度:[S, H, W, 1], 深度置信度: [S, W, H]
normal_preds, normal_conf = predictions["normals"][0], predictions["normals_conf"][0] # 相机坐标系中的表面法线:[S, H, W, 3], 法线置信度: [S, W, H]

# 相机输出
camera_poses = predictions["camera_poses"][0]  # 相机到世界的位姿(OpenCV约定):[S, 4, 4]
camera_intrs = predictions["camera_intrs"][0]  # 相机内参矩阵:[S, 3, 3]
camera_params = predictions["camera_params"][0]   # 相机向量:[S, 9](平移,旋转四元数,fov_v,fov_u)

# 3D高斯点云输出
splats = predictions["splats"]
means = splats["means"][0].reshape(-1, 3)      # 高斯均值:[N, 3]
opacities = splats["opacities"][0].reshape(-1) # 高斯不透明度:[N]
scales = splats["scales"][0].reshape(-1, 3)    # 高斯尺度:[N, 3]
quats = splats["quats"][0].reshape(-1, 4)      # 高斯四元数:[N, 4]
sh = splats["sh"][0].reshape(-1, 1, 3)         # 高斯球谐函数:[N, 1, 3]
其中:
S是输入视图的数量H, W是输入图像的高度和宽度N是3D高斯的数量
更多功能的推理
对于高级用法,请参阅 infer.py,它提供了额外的功能:
- 保存预测:点云、深度图、法线、相机参数和3D高斯点云
- 可视化输出:深度图、表面法线和3D点云
- 使用3D高斯渲染新视图
- 将3D高斯点云结果和相机参数导出为 COLMAP 格式
🎯 后期 3DGS 优化(可选)
安装依赖
cd submodules/gsplat/examples
# 安装example依赖
pip install -r requirements.txt
# 安装 rmbrualla 的 pycolmap2
git clone https://github.com/rmbrualla/pycolmap.git
cd pycolmap
# 在 pyproject.toml 中,将 name = "pycolmap" 重命名为 name = "pycolmap2"
vim pyproject.toml
# 将文件夹 pycolmap 重命名为 pycolmap2
mv pycolmap/ pycolmap2/
python3 -m pip install -e .
优化
首先,使用 --save_colmap 和 --save_gs 标志运行 infer.py 以生成 COLMAP 格式的初始化:
python infer.py --input_path /path/to/your/input --output_path /path/to/your/output --save_colmap --save_gs
重建结果(相机参数、3D点和3D高斯)将保存在 /path/to/your/output 下,例如:
output/
├── images/                 # 输入图像
├── sparse/
│   └── 0/
│       ├── cameras.bin     # 相机内参
│       ├── images.bin      # 相机位姿
│       └── points3D.bin    # 3D点
└── gaussians.ply           # 3D高斯点云初始化
然后,运行优化脚本:
python submodules/gsplat/examples/simple_trainer_worldmirror.py default --data_factor 1 --data_dir /path/to/your/inference_output --result_dir /path/to/your/gs_optimization_output
🔮 性能表现
HunyuanWorld-Mirror 在多个 3D 感知任务中实现了最先进的性能,超越了现有的前馈式 3D 重建方法。其在 点云重建、相机位姿估计、表面法线预测、新视角渲染和深度估计 等任务中均表现出色。引入 相机位姿、深度或内参 等 3D 先验信息,对于提升这些任务的性能起到了关键作用。以下是点云重建和新视角合成任务的性能表现:
点云重建
| 方法 | 7-Scenes | NRGBD | DTU | |||
|---|---|---|---|---|---|---|
| Acc. ⬇ | Comp. ⬇ | Acc. ⬇ | Comp. ⬇ | Acc. ⬇ | Comp. ⬇ | |
| Fast3R | 0.096 | 0.145 | 0.135 | 0.163 | 3.340 | 2.929 |
| CUT3R | 0.094 | 0.101 | 0.104 | 0.079 | 4.742 | 3.400 |
| VGGT | 0.046 | 0.057 | 0.051 | 0.066 | 1.338 | 1.896 |
| π³ | 0.048 | 0.072 | 0.026 | 0.028 | 1.198 | 1.849 |
| HunyuanWorld-Mirror | 0.043 | 0.049 | 0.041 | 0.045 | 1.017 | 1.780 |
| + 内参 | 0.042 | 0.048 | 0.041 | 0.045 | 0.977 | 1.762 |
| + 深度 | 0.038 | 0.039 | 0.032 | 0.031 | 0.831 | 1.022 |
| + 相机位姿 | 0.023 | 0.036 | 0.029 | 0.032 | 0.990 | 1.847 |
| + 所有先验 | 0.018 | 0.023 | 0.016 | 0.014 | 0.735 | 0.935 |
新视角合成
| 方法 | Re10K | DL3DV | ||||
|---|---|---|---|---|---|---|
| PSNR ⬆ | SSIM ⬆ | LPIPS ⬇ | PSNR ⬆ | SSIM ⬆ | LPIPS ⬇ | |
| FLARE | 16.33 | 0.574 | 0.410 | 15.35 | 0.516 | 0.591 |
| AnySplat | 17.62 | 0.616 | 0.242 | 18.31 | 0.569 | 0.258 |
| HunyuanWorld-Mirror | 20.62 | 0.706 | 0.187 | 20.92 | 0.667 | 0.203 |
| + 内参 | 22.03 | 0.765 | 0.165 | 22.08 | 0.723 | 0.175 |
| + 相机位姿 | 20.84 | 0.713 | 0.182 | 21.18 | 0.674 | 0.197 |
| + 内参 + 相机位姿 | 22.30 | 0.774 | 0.155 | 22.15 | 0.726 | 0.174 |
几何先验增强
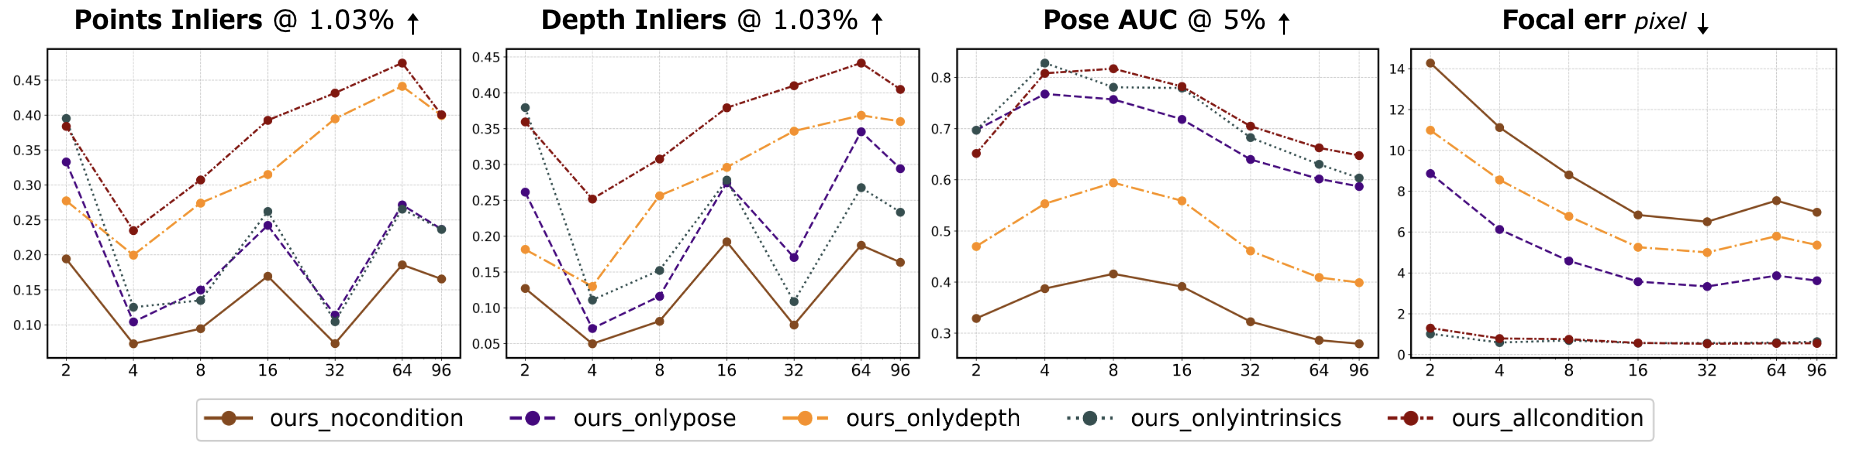
关于其他任务的性能比较,请参考 技术报告。
🤖 训练
训练数据准备
请按照 CUT3R 数据准备说明 下载和准备训练数据集。目前,我们提供了 Hypersim 的示例数据集。
安装训练依赖
参考 安装。
训练命令
我们的模型训练包括两个阶段。快速开始命令如下:
# 第一阶段:先验、点图、相机、深度和法线
python training/launch.py train=stage1.yaml
# 第二阶段:3D高斯点云
python training/lanuch.py train=stage2.yaml
注意:
- 这将自动检测所有可用的 GPU。要指定 GPU,使用
CUDA_VISIBLE_DEVICES=<CUDA_ID> - 如果您想从检查点恢复训练,可以设置
ckpt_path标志为检查点的路径,例如python training/launch.py train=stage1.yaml ckpt_path=path/to/your/checkpoint.ckpt。 - 您可以在配置文件中注释掉
data.validation_datasets中的一些验证数据集,并调整wrapper.eval_modalities以减少评估时间。
自定义训练命令
我们在 training/configs/train/custom.yaml 中提供了微调配置,您可以在其中自定义训练参数和模型架构。例如,您可以在配置文件中禁用某些预测头:
wrapper:
  model:
    enable_cam: true      # 相机预测头
    enable_pts: true      # 点云预测头
    enable_depth: true    # 深度预测头
    enable_norm: false    # 法线预测头
    enable_gs: false      # 高斯点云预测头
然后运行以下脚本:
python training/lanuch.py train=custom.yaml
如果您想在单个阶段中训练所有预测头都打开的模型,可以运行以下命令:
python training/launch.py train=all.yaml # 调整 train/all.yaml 中的 max_images_per_gpu 以避免 OOM
评估训练检查点
训练后,您可以通过运行以下脚本在点重建任务上评估训练的检查点:
python training/launch.py --config-name=eval.yaml eval=pointmap.yaml wrapper.pretrained=path/to/your/checkpoint.ckpt
📊 评估
评估数据准备
请将所有评估数据集放在 data 文件夹中,或相应地修改 configs/paths/default.yaml 配置文件。数据预处理说明:
点图重建:我们按照 Spann3r 的数据处理说明 准备 DTU、7-Scene 和 NRGBD。
表面法线估计:我们按照 DSINE 准备 Ibims、NYU-v2 和 Scannet-Normal。
新视角合成:对于 RealEstate10K,我们按照 pixelSplat 的详细说明。对于 DL3DV,我们按照 DL3DV 官方仓库 下载 480P 10K 子集。
深度估计:我们按照 MonST3R 的数据说明 准备 NYU-v2、Sintel 和 KITTI。
相机位姿估计:我们从 Huggingface 下载 RealEstate10K。
安装评估依赖
参考 安装。
评估命令
1. 点图重建
配置见 configs/eval/pointmap.yaml。
python training/launch.py --config-name eval.yaml eval=pointmap.yaml
2. 表面法线估计
配置见 configs/eval/normal.yaml。
python training/launch.py --config-name eval.yaml eval=normal.yaml
3. 新视角合成
配置见 configs/eval/nvs.yaml。
python training/launch.py --config-name eval.yaml eval=nvs.yaml
4. 深度估计
配置见 configs/eval/depthmap.yaml。
python training/launch.py --config-name eval.yaml eval=depthmap.yaml
5. 相机位姿估计
配置见 configs/eval/pose.yaml。
python training/launch.py --config-name eval.yaml eval=pose.yaml
📑 开源计划
- 推理代码
- 模型权重
- 技术报告
- Gradio演示
- 评估代码
- 训练代码
🔗 BibTeX
如果您发现 HunyuanWorld-Mirror 对您的研究和应用有用,请使用以下 BibTeX 引用:
@article{liu2025worldmirror,
  title={WorldMirror: Universal 3D World Reconstruction with Any-Prior Prompting},
  author={Liu, Yifan and Min, Zhiyuan and Wang, Zhenwei and Wu, Junta and Wang, Tengfei and Yuan, Yixuan and Luo, Yawei and Guo, Chunchao},
  journal={arXiv preprint arXiv:2510.10726},
  year={2025}
}
📧 联系方式
如有任何问题,请发送邮件至 [email protected]。
致谢
我们衷心感谢HunyuanWorld、VGGT、Fast3R、CUT3R 和 DUSt3R 的作者和贡献者,感谢他们杰出的开源工作和开创性的研究。