
QwenAudio/SenseVoice
QwenAudio/SenseVoice has 9,742 GitHub stars and 847 forks. GitHot measured +10 stars in 24 hours and +55 in 7 days. Last checked 2026-11-11 19:45 UTC. Last push 2026-09-30.
开源 SenseVoiceSmall 模型,支持普通话、粤语、英语、日语和韩语的自动语音识别、语言识别、情绪识别和音频事件检测。
可以做什么
- Research scope vs released checkpoint: The broader SenseVoice work reports training on more than 400,000 hours and support for more than 50 languages. The released SenseVoiceSmall checkpoint linked above supports Mandarin, Cantonese, English, Japanese, and Korean; the benchmark comparisons below are task- and language-specific.
- Possess excellent emotion recognition capabilities, achieving and surpassing the effectiveness of the current best emotion recognition models on test data.
- Offer sound event detection capabilities, supporting the detection of various common human-computer interaction events such as bgm, applause, laughter, crying, coughing, and sneezing.
- Efficient Inference: SenseVoiceSmall uses a non-autoregressive end-to-end framework for low-latency inference; see the benchmark setup and comparison below.
实测星标增长
- 24小时
- +10
- 7天
- +55
- 15天
- 更新延迟
- 1个月
- 更新延迟
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
README_zh.md
原文SenseVoice
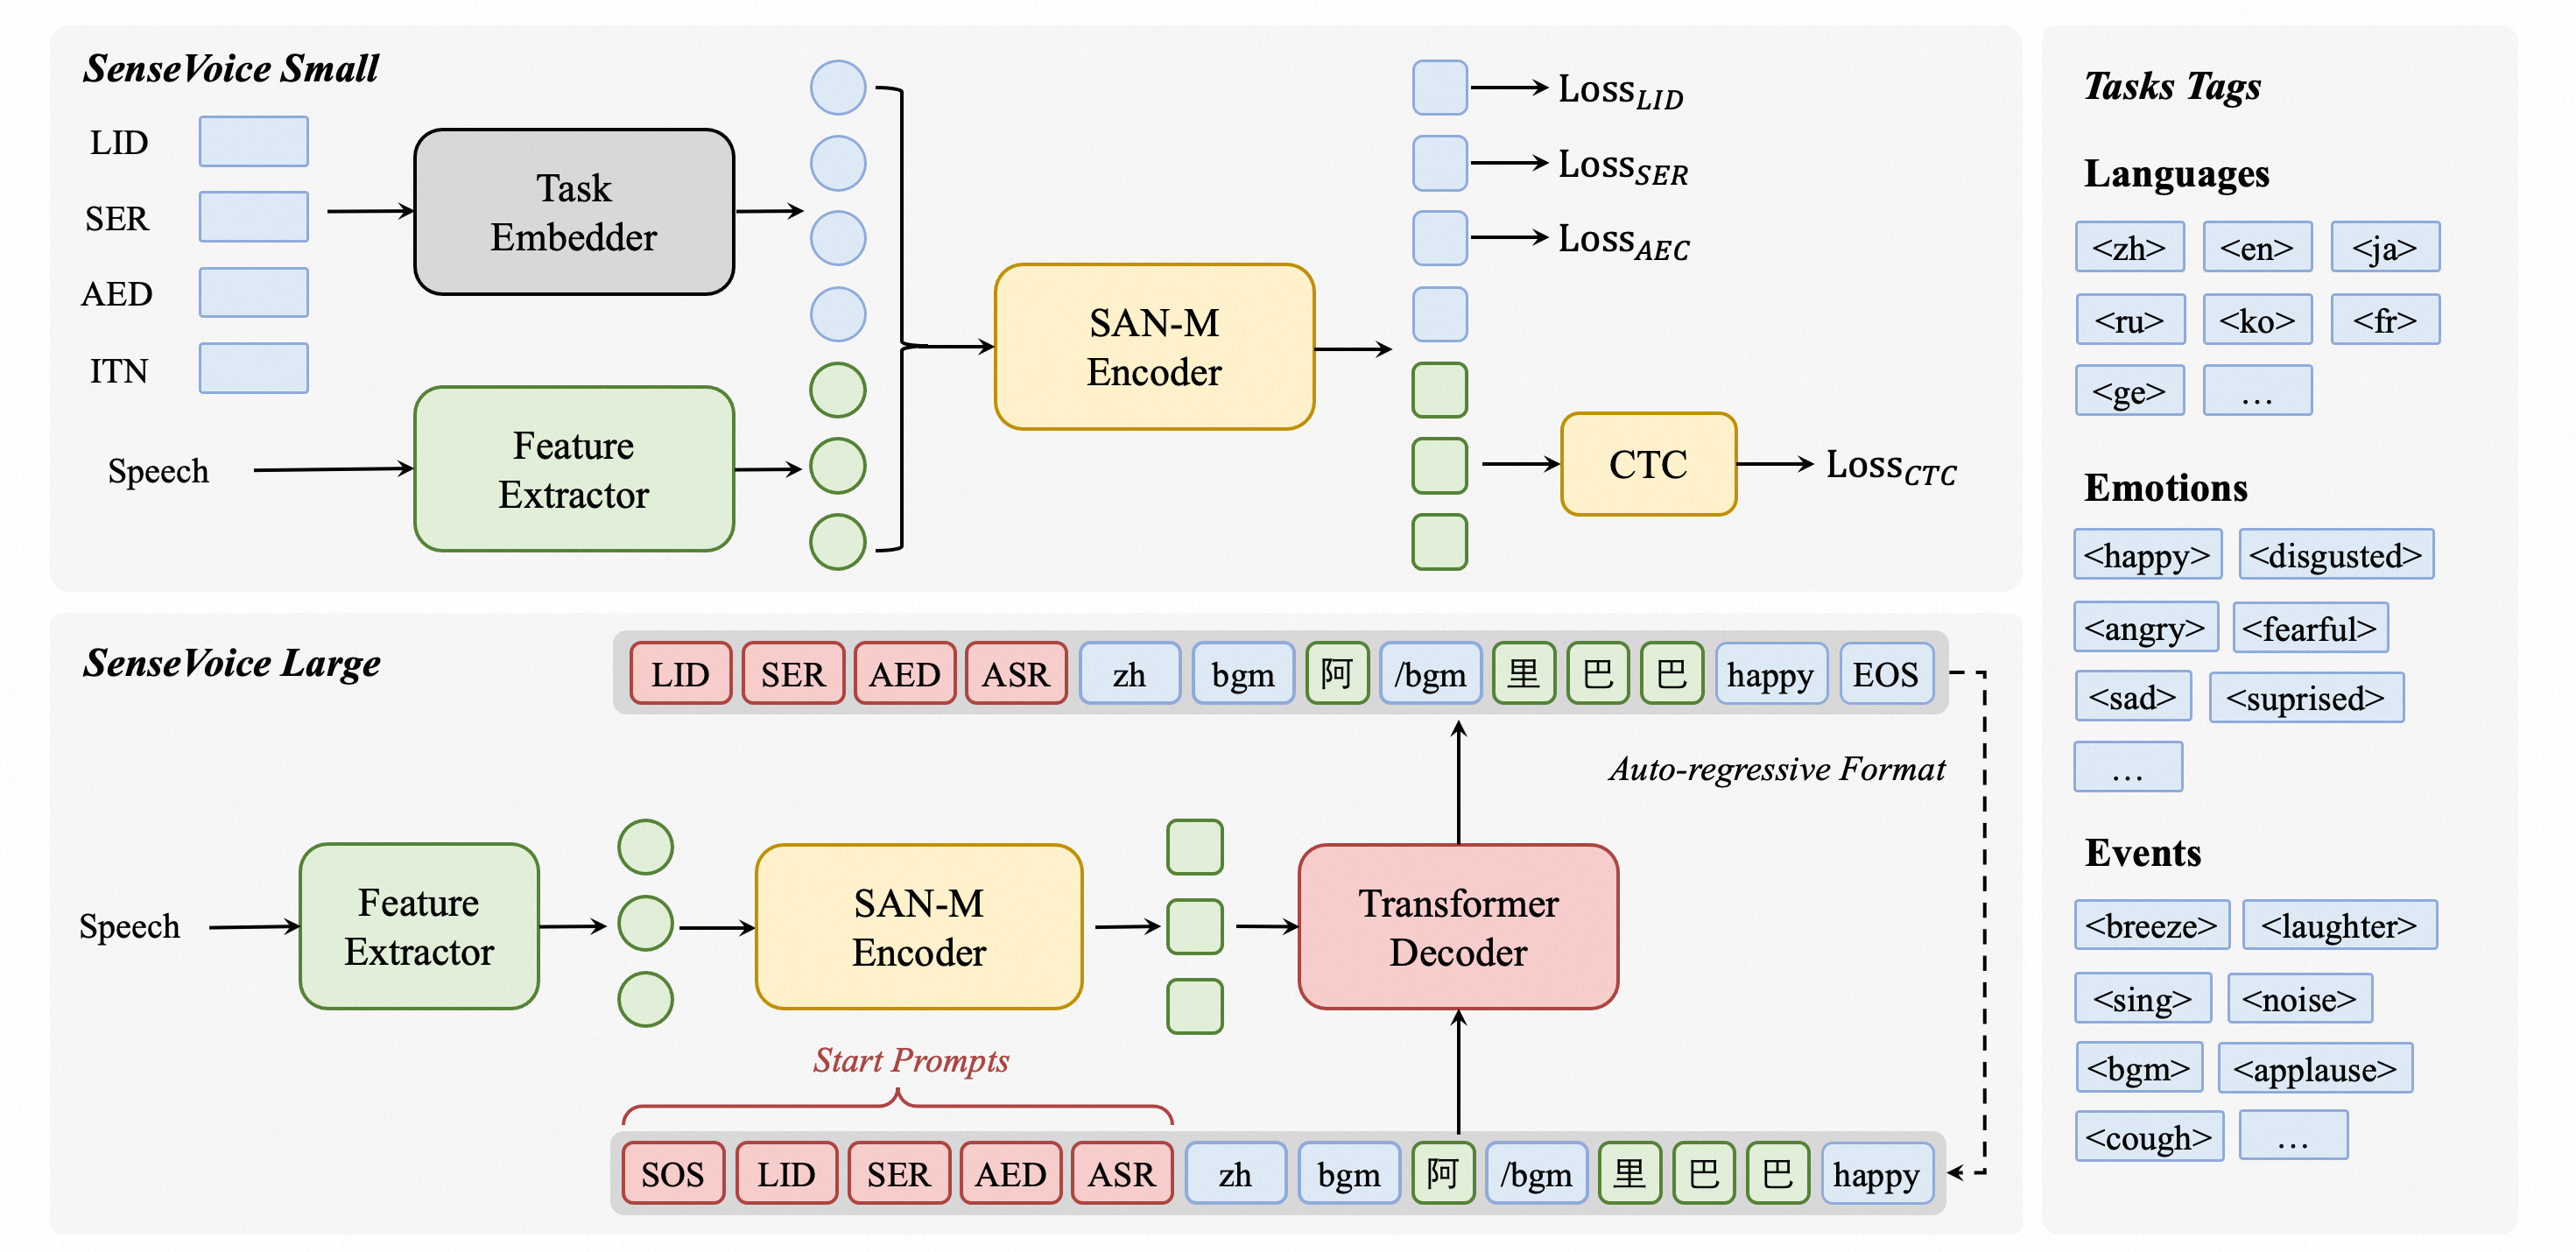
SenseVoice 是具有音频理解能力的音频基础模型,包括语音识别(ASR)、语种识别(LID)、语音情感识别(SER)和声学事件分类(AEC)或声学事件检测(AED)。本项目提供 SenseVoice 模型的介绍以及在多个任务测试集上的 benchmark,以及体验模型所需的环境安装的与推理方式。
Homepage | 最新动态 | 性能评测 | 环境安装 | 用法教程 | 联系我们
模型仓库:modelscope,huggingface,论文
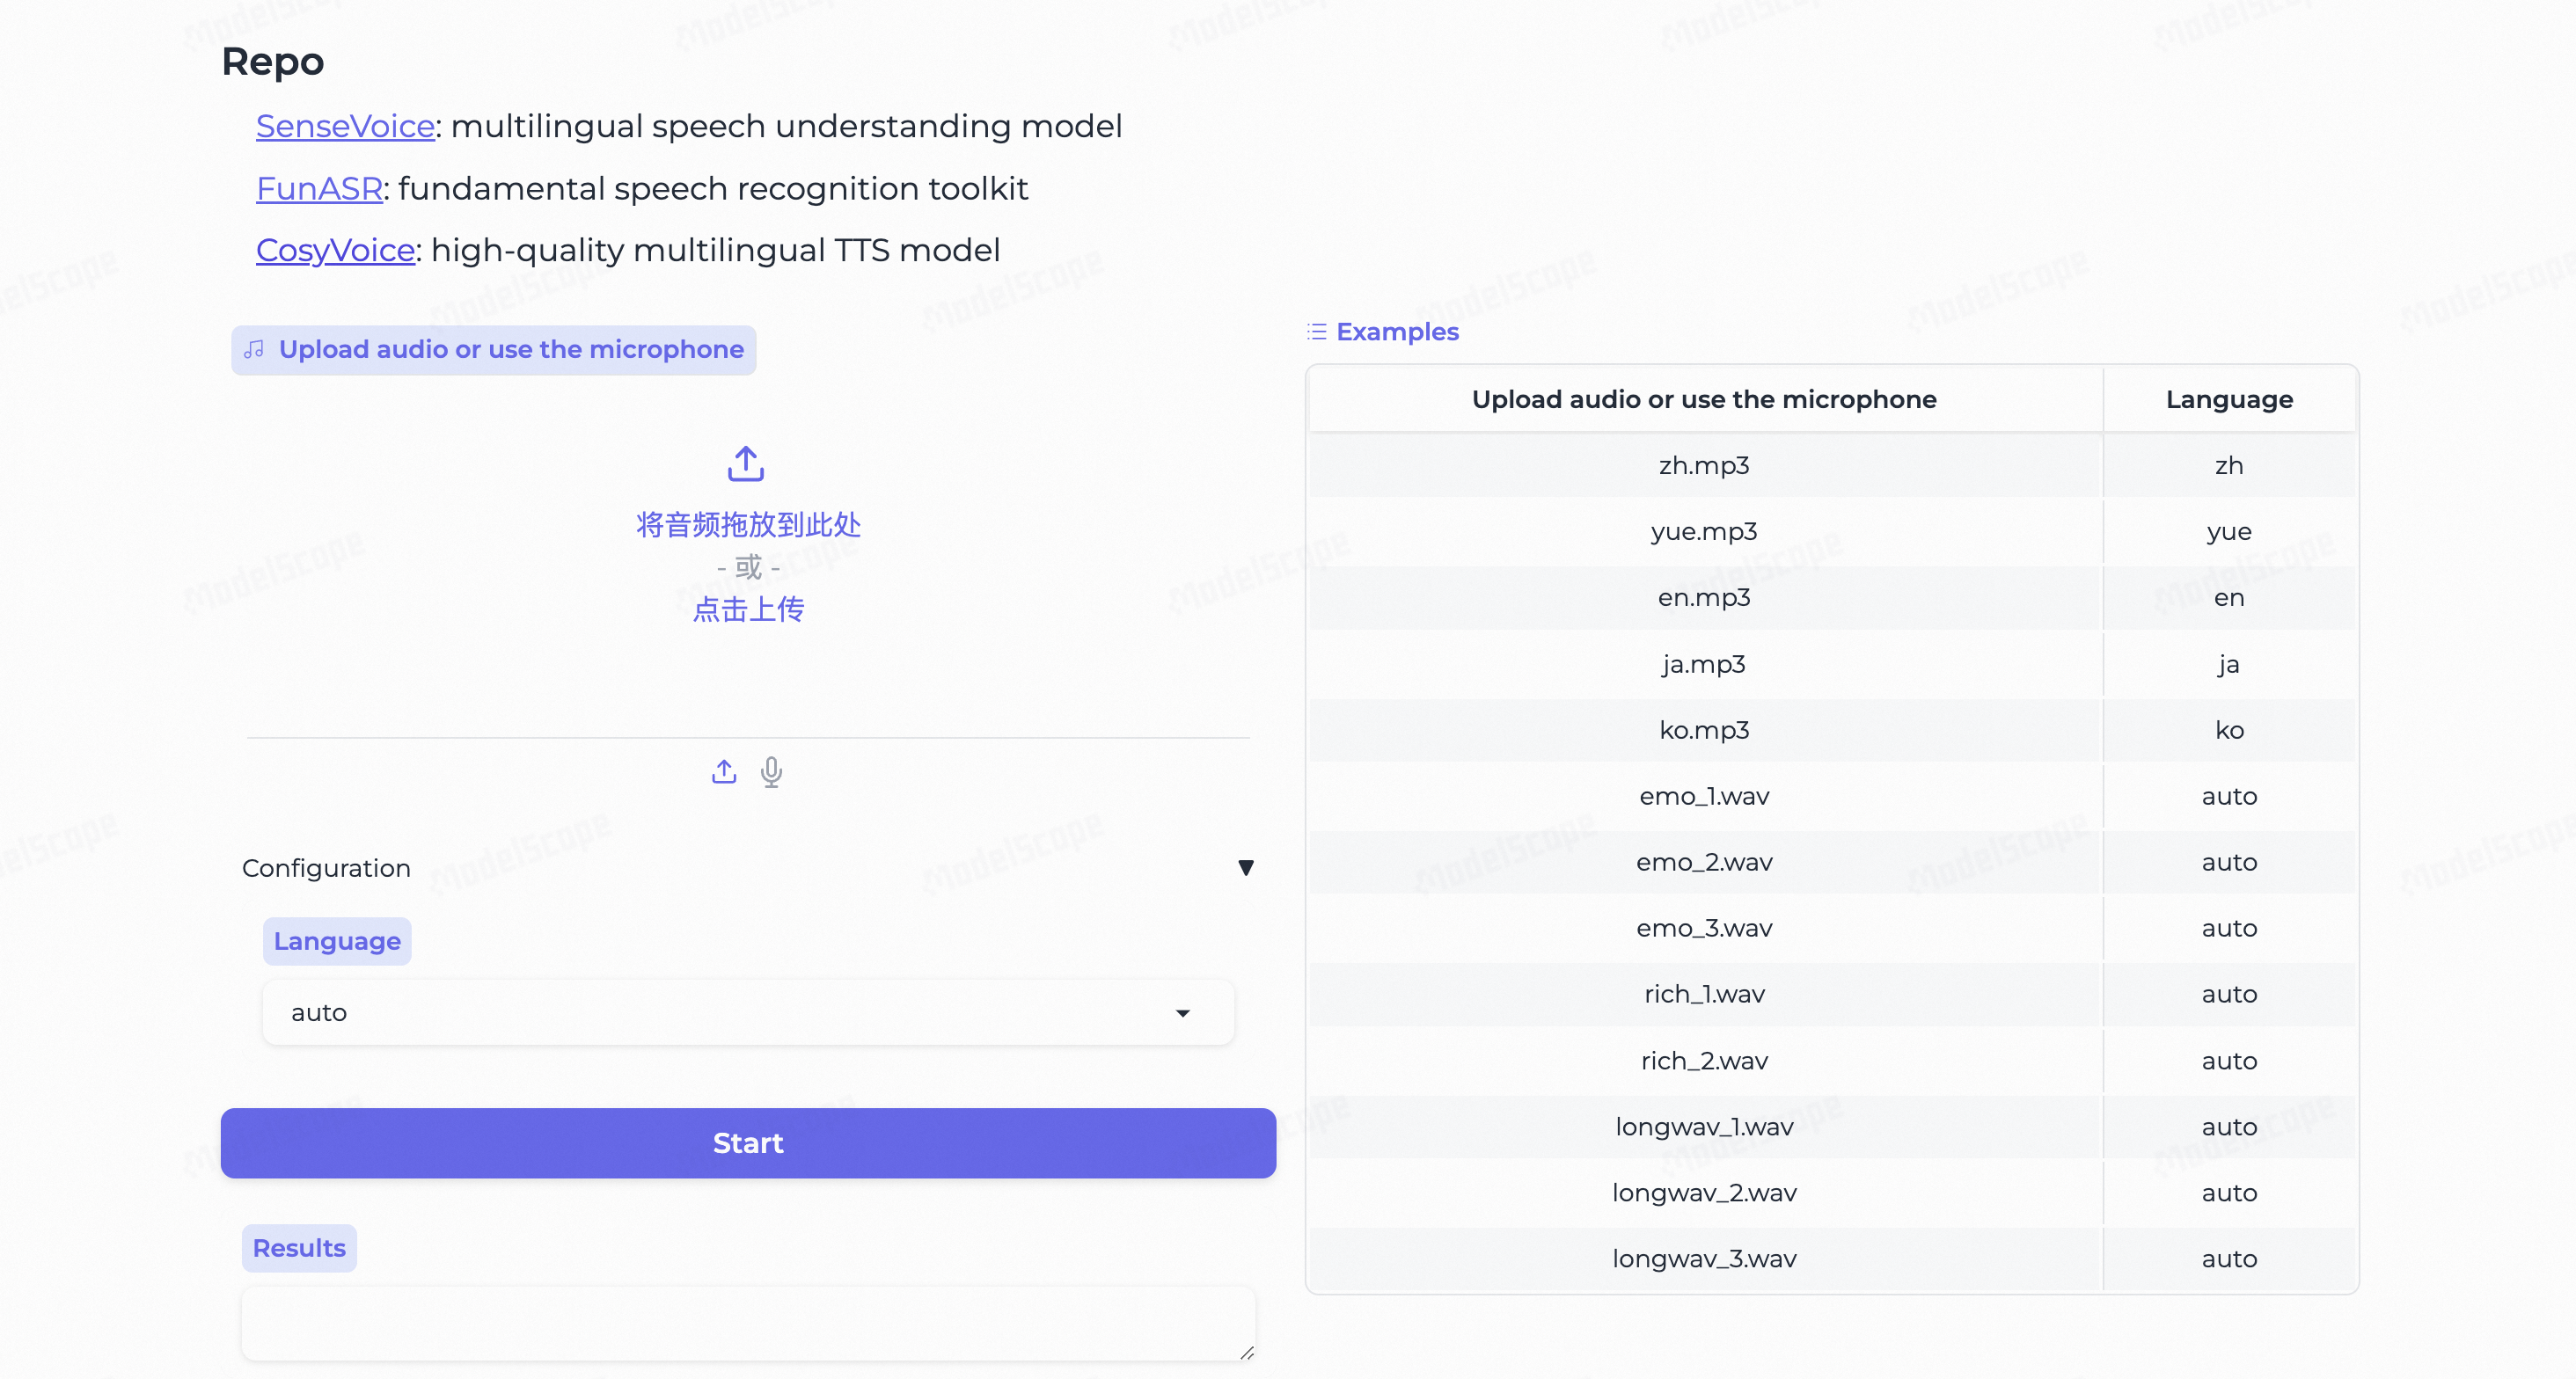
在线体验: modelscope demo, huggingface space
已发布 checkpoint 范围: SenseVoiceSmall 支持中文、粤语、英文、日文和韩文的 ASR 与语种识别,并输出情感和音频事件标签。说话人分离是 FunASR 组合独立 FSMN-VAD 与 CAM++ 的 pipeline 能力,并非 SenseVoiceSmall checkpoint 本身的输出。
核心功能 🎯
SenseVoice 专注于高精度多语言语音识别、情感辨识和音频事件检测。
- 研究范围与已发布 checkpoint: 更广泛的 SenseVoice 研究描述采用超过 40 万小时数据训练并覆盖 50 多种语言;当前公开的 SenseVoiceSmall checkpoint 支持中文、粤语、英文、日文和韩文,下面的 benchmark 对比仅对应所列任务与语种。
- 富文本识别:
- 具备优秀的情感识别,能够在测试数据上达到和超过目前最佳情感识别模型的效果。
- 支持声音事件检测能力,支持音乐、掌声、笑声、哭声、咳嗽、喷嚏等多种常见人机交互事件进行检测。
- 高效推理: SenseVoiceSmall 采用非自回归端到端框架,具有低延迟推理能力;具体测试条件与速度对比见下方 benchmark。
- 微调定制: 具备便捷的微调脚本与策略,方便用户根据业务场景修复长尾样本问题。
- 服务部署: 具有完整的服务部署链路,支持多并发请求,支持客户端语言有,python、c++、html、java 与 c# 等。
最新动态 🔥
- 当前部署路径: 安装
funasr==1.4.14,即可使用 SenseVoice 的 Python、OpenAI 兼容服务与容器工作流。发布说明 · SenseVoice Releases - 长音频无需 VAD:
long_audio_no_vad.py使用有界重叠窗口并保留原始 chunk 输出,小时级录音不必一次送入模型占用无界显存。运行脚本 -> - 一体化说话人标注: 更广泛的 FunASR 生态已接入 OpenMOSS/MOSS-Transcribe-Diarize,离线输出转写、时间戳和匿名说话人标签,不需要业务侧手工拼 VAD 与 speaker 模型。部署指南 ->
完整版本历史请查看 Releases。
性能评测 📝
多语言语音识别
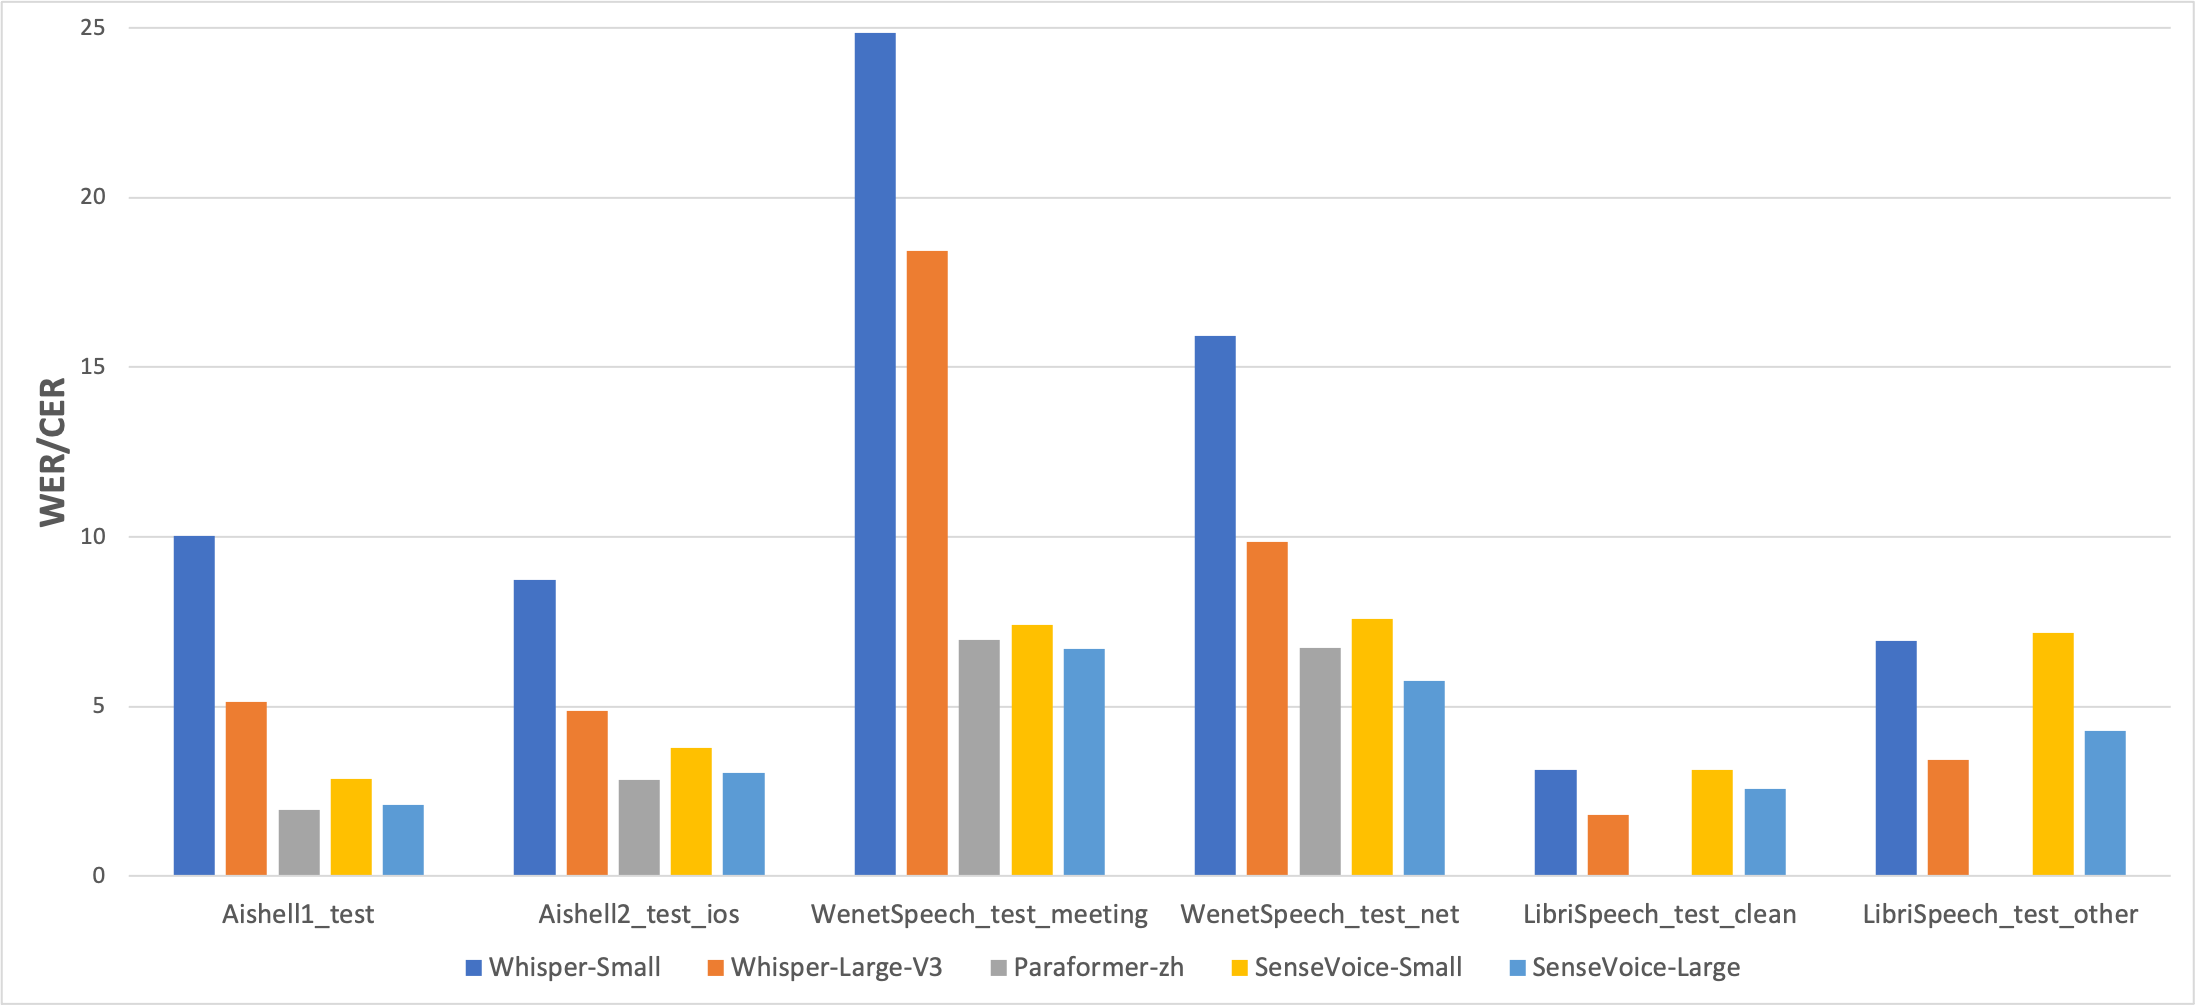
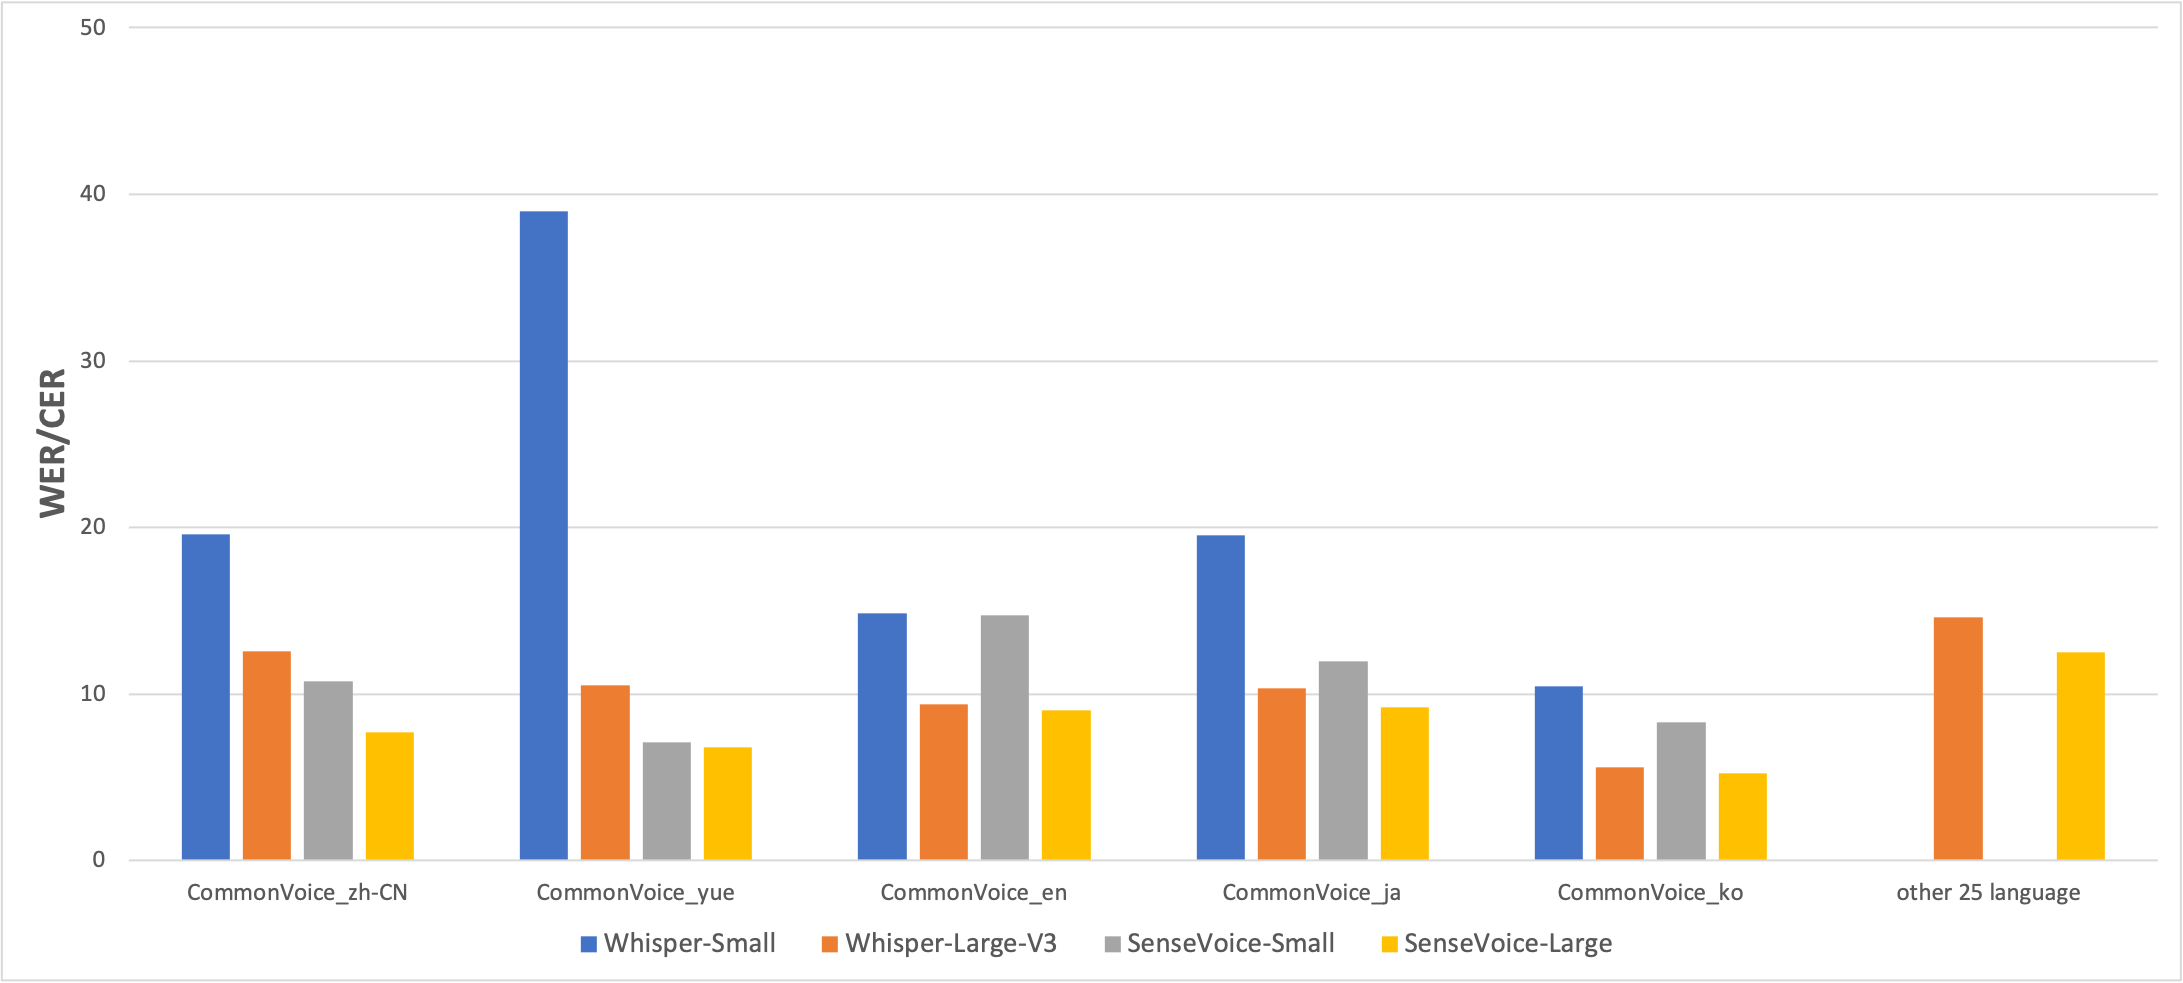
我们在开源基准数据集(包括 AISHELL-1、AISHELL-2、Wenetspeech、Librispeech 和 Common Voice)上比较了 SenseVoice 与 Whisper 的多语言语音识别性能和推理效率。在中文和粤语识别效果上,SenseVoice-Small 模型具有明显的效果优势。
情感识别
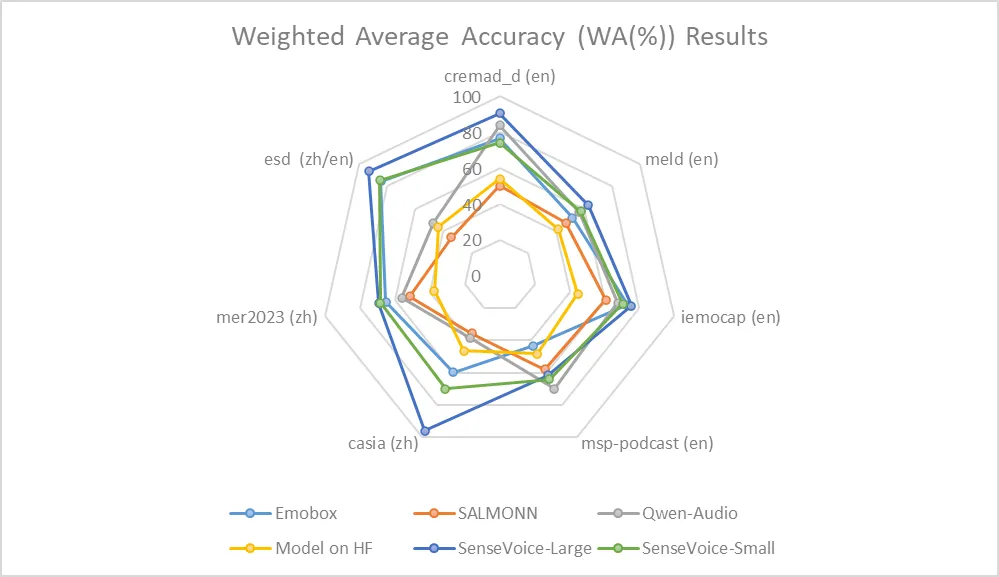
由于目前缺乏被广泛使用的情感识别测试指标和方法,我们在多个测试集的多种指标进行测试,并与近年来 Benchmark 上的多个结果进行了全面的对比。所选取的测试集同时包含中文 / 英文两种语言以及表演、影视剧、自然对话等多种风格的数据,在不进行目标数据微调的前提下,SenseVoice 能够在测试数据上达到和超过目前最佳情感识别模型的效果。
需要复现零训练的 CASIA 或 RAVDESS 结果时,请使用 SER 评测契约。该脚本直接读取 SenseVoice 原始情感标签,同时输出 UA 和 WA;不要从富文本转写结果中用字符串切分推断情感标签。
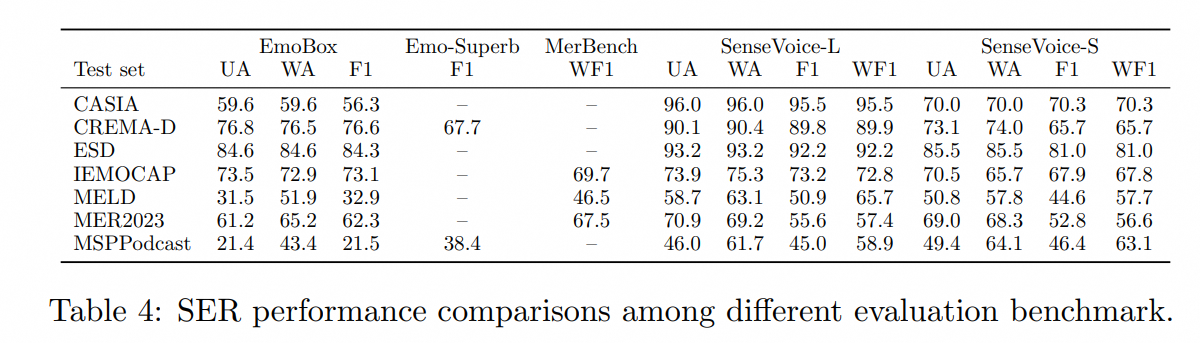
同时,我们还在测试集上对多个开源情感识别模型进行对比,结果表明,SenseVoice-Large 模型可以在几乎所有数据上都达到了最佳效果,而 SenseVoice-Small 模型同样可以在多数数据集上取得超越其他开源模型的效果。
事件检测
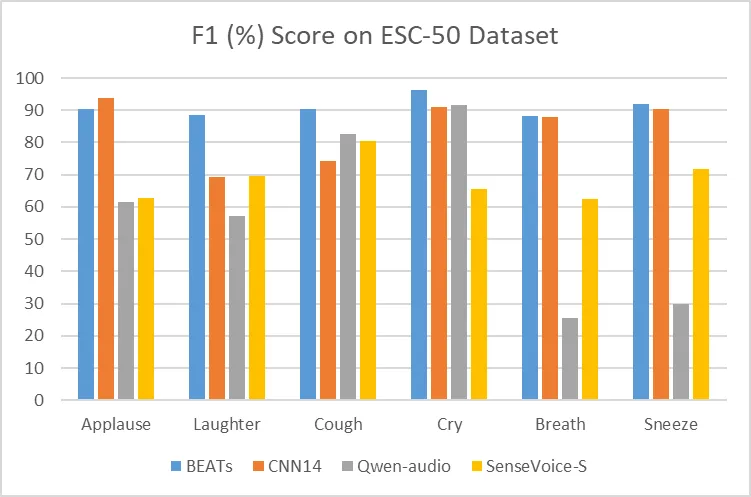
尽管 SenseVoice 只在语音数据上进行训练,它仍然可以作为事件检测模型进行单独使用。我们在环境音分类 ESC-50 数据集上与目前业内广泛使用的 BEATS 与 PANN 模型的效果进行了对比。SenseVoice 模型能够在这些任务上取得较好的效果,但受限于训练数据与训练方式,其事件分类效果专业的事件检测模型相比仍然有一定的差距。
推理效率
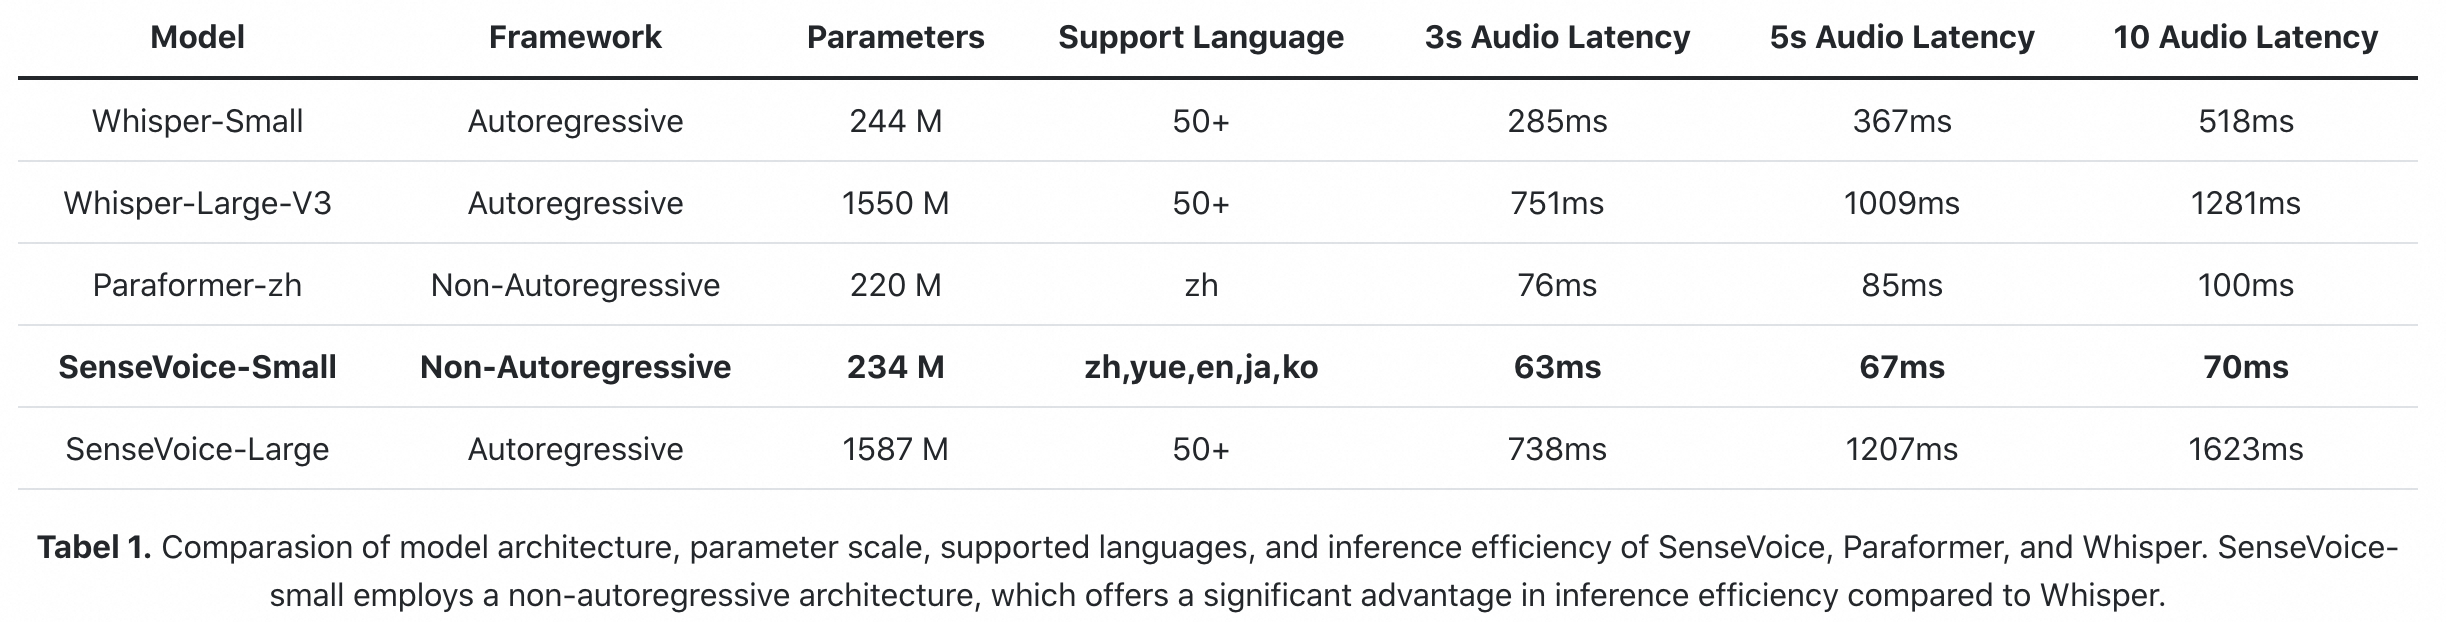
在下图所示 benchmark 设置中,SenseVoiceSmall 采用非自回归端到端架构;在参数量与 Whisper-Small 相当的情况下,其推理速度比 Whisper-Small 快 5 倍以上,比 Whisper-Large 快 15 倍。
安装依赖环境 🐍
pip install -r requirements.txt
SenseVoiceSmall 示例与 FunASR 组合说话人分离路径需要 funasr>=1.3.26。如果你之前已经安装过本仓库,请先执行 pip install -U "funasr>=1.3.26",再重新运行 demo。
用法 🛠️
推理
使用 funasr 推理
支持常见格式音频输入。长录音必须先分段再送入编码器;下例使用 FSMN-VAD 完成分段。
使用 remote_code="./model.py" 时,升级 FunASR 包不会同步更新本地的
model.py,请同时更新仓库源码。当前时间戳格式为 timestamp=[[开始毫秒, 结束毫秒], ...],
与 words 一一对应;旧版的 [词元, 开始秒, 结束秒] 三元组不兼容 VAD 聚合。
直接调用模型的代码也需改为从 words 读取文字,参见 demo2.py。
说话人组合示例见 Speaker Diarization,已用
FunASR 1.4.15 和固定公开样本验证流程;这不是说话人准确率或真实身份识别验证。
from funasr import AutoModel
from funasr.utils.postprocess_utils import rich_transcription_postprocess

model_dir = "iic/SenseVoiceSmall"


model = AutoModel(
    model=model_dir,
    trust_remote_code=True,
    remote_code="./model.py",
    vad_model="fsmn-vad",
    vad_kwargs={"max_single_segment_time": 30000},
    device="cuda:0",
)

# en
res = model.generate(
    input=f"{model.model_path}/example/en.mp3",
    cache={},
    language="auto",  # "zh", "en", "yue", "ja", "ko", "nospeech"
    use_itn=True,
    batch_size_s=60,
    merge_vad=True,
    merge_length_s=15,
)
text = rich_transcription_postprocess(res[0]["text"])
print(text)
参数说明(点击展开)
model_dir:模型名称,或本地磁盘中的模型路径。trust_remote_code:vad_model:表示开启 VAD,VAD 的作用是将长音频切割成短音频,此时推理耗时包括了 VAD 与 SenseVoice 总耗时,为链路耗时,如果需要单独测试 SenseVoice 模型耗时,可以关闭 VAD 模型。vad_kwargs:表示 VAD 模型配置,max_single_segment_time: 表示vad_model最大切割音频时长,单位是毫秒 ms。use_itn:输出结果中是否包含标点与逆文本正则化。batch_size_s表示采用动态 batch,batch 中总音频时长,单位为秒 s。merge_vad:是否将 vad 模型切割的短音频碎片合成,合并后长度为merge_length_s,单位为秒 s。ban_emo_unk:禁用 emo_unk 标签,禁用后所有的句子都会被赋与情感标签。默认False
不使用 VAD 的长音频推理
把一小时波形直接传给一次 model.generate 会使编码器内存远大于音频文件本身。
当业务不能接受 VAD 时,可使用有界内存参考脚本。它通过 ffmpeg 解码,以默认 30 秒
窗口和 2 秒重叠调用 SenseVoice,并且不会配置 VAD 模型:
python long_audio_no_vad.py meeting.mp3 \
  --output meeting.txt \
  --window-seconds 30 \
  --overlap-seconds 2
合并文本只删除相邻窗口边界处完全相同的重复文字。meeting.chunks.jsonl 会保留每个
窗口的原始模型输出和窗口偏移,因此不匹配的内容不会被静默丢弃;传入 --no-dedupe
可连完全匹配的去重也关闭。窗口偏移是输入窗口边界,并非逐词时间戳。此路径避免把
整段录音送入编码器造成 OOM,但固定切点仍可能影响边界附近的识别;业务允许按内容
分段时,仍推荐使用上面的 VAD pipeline。
如果输入均为短音频(小于 30s),并且需要批量化推理,为了加快推理效率,可以移除 vad 模型,并设置 batch_size
model = AutoModel(model=model_dir, trust_remote_code=True, device="cuda:0")

res = model.generate(
    input=f"{model.model_path}/example/en.mp3",
    cache={},
    language="auto", # "zh", "en", "yue", "ja", "ko", "nospeech"
    use_itn=True,
    batch_size=64,
)
更多详细用法,请参考 文档
直接推理
支持任意格式音频输入,输入音频时长限制在 30s 以下
from model import SenseVoiceSmall
from funasr.utils.postprocess_utils import rich_transcription_postprocess

model_dir = "iic/SenseVoiceSmall"
m, kwargs = SenseVoiceSmall.from_pretrained(model=model_dir, device="cuda:0")
m.eval()

res = m.inference(
    data_in=f"{kwargs ['model_path']}/example/en.mp3",
    language="auto", # "zh", "en", "yue", "ja", "ko", "nospeech"
    use_itn=False,
    ban_emo_unk=False,
    **kwargs,
)

text = rich_transcription_postprocess(res [0][0]["text"])
print(text)
服务部署
Undo
导出与测试
ONNX 与 Libtorch 导出
ONNX
# pip3 install -U funasr funasr-onnx
from pathlib import Path
from funasr_onnx import SenseVoiceSmall
from funasr_onnx.utils.postprocess_utils import rich_transcription_postprocess


model_dir = "iic/SenseVoiceSmall"

model = SenseVoiceSmall(model_dir, batch_size=10, quantize=True)

# inference
wav_or_scp = ["{}/.cache/modelscope/hub/{}/example/en.mp3".format(Path.home(), model_dir)]

res = model(wav_or_scp, language="auto", use_itn=True)
print([rich_transcription_postprocess(i) for i in res])
备注:ONNX 模型导出到原模型目录中
Libtorch
from pathlib import Path
from funasr_torch import SenseVoiceSmall
from funasr_torch.utils.postprocess_utils import rich_transcription_postprocess


model_dir = "iic/SenseVoiceSmall"

model = SenseVoiceSmall(model_dir, batch_size=10, device="cuda:0")

wav_or_scp = ["{}/.cache/modelscope/hub/{}/example/en.mp3".format(Path.home(), model_dir)]

res = model(wav_or_scp, language="auto", use_itn=True)
print([rich_transcription_postprocess (i) for i in res])
备注:Libtorch 模型导出到原模型目录中
CPU/边缘端运行:llama.cpp / GGUF(无需 GPU,无需 Python)
SenseVoice 可以作为单个自包含二进制运行。这个路径类似 Whisper 的 whisper.cpp,但在中文与粤语场景下更适合 SenseVoice;运行时内置 FSMN-VAD,无需 Python 环境。
bash runtime/llama.cpp/download-funasr-model.sh sensevoice ./gguf
llama-funasr-sensevoice -m ./gguf/sensevoice-small-f16.gguf --vad ./gguf/fsmn-vad.gguf -a audio.wav
预编译二进制: Releases · 下载与快速开始: funasr.com/llama-cpp · GGUF 模型: Hugging Face · 文档与 benchmark: runtime/llama.cpp/
部署
使用 FastAPI 部署
export SENSEVOICE_DEVICE=cuda:0
fastapi run --port 50000
使用 Docker 构建
docker build -t sensevoice .
构建工作流也会发布
ghcr.io/qwenaudio/sensevoice,但该容器包当前为 private,匿名拉取会返回 HTTP 401。在容器包页面 显示 Public 之前,请使用上面的本地构建。
运行(GPU,默认)
docker run --rm --gpus all -p 50000:50000 -v sensevoice-models:/models sensevoice
运行(仅 CPU)
docker run --rm -e SENSEVOICE_DEVICE=cpu -p 50000:50000 -v sensevoice-models:/models sensevoice
容器健康后访问 http://127.0.0.1:50000/docs。
微调
安装训练环境
git clone https://github.com/modelscope/FunASR.git && cd FunASR
pip3 install -e ./
数据准备
数据格式需要包括如下几个字段:
{"key": "YOU0000008470_S0000238_punc_itn", "text_language": "<|en|>", "emo_target": "<|NEUTRAL|>", "event_target": "<|Speech|>", "with_or_wo_itn": "<|withitn|>", "target": "Including legal due diligence, subscription agreement, negotiation.", "source": "/cpfs01/shared/Group-speech/beinian.lzr/data/industrial_data/english_all/audio/YOU0000008470_S0000238.wav", "target_len": 7, "source_len": 140}
{"key": "AUD0000001556_S0007580", "text_language": "<|en|>", "emo_target": "<|NEUTRAL|>", "event_target": "<|Speech|>", "with_or_wo_itn": "<|woitn|>", "target": "there is a tendency to identify the self or take interest in what one has got used to", "source": "/cpfs01/shared/Group-speech/beinian.lzr/data/industrial_data/english_all/audio/AUD0000001556_S0007580.wav", "target_len": 18, "source_len": 360}
详细可以参考:data/train_example.jsonl
数据准备细节介绍
key: 数据唯一 IDsource:音频文件的路径source_len:音频文件的 fbank 帧数target:音频文件标注文本target_len:音频文件标注文本长度text_language:音频文件的语种标签emo_target:音频文件的情感标签event_target:音频文件的事件标签with_or_wo_itn:标注文本中是否包含标点与逆文本正则化
可以用指令 sensevoice2jsonl 从 train_wav.scp、train_text.txt、train_text_language.txt、train_emo_target.txt 和 train_event_target.txt 生成,准备过程如下:
train_text.txt
左边为数据唯一 ID,需与 train_wav.scp 中的 ID 一一对应
右边为音频文件标注文本,格式如下:
BAC009S0764W0121 甚至出现交易几乎停滞的情况
BAC009S0916W0489 湖北一公司以员工名义贷款数十员工负债千万
asr_example_cn_en 所有只要处理 data 不管你是做 machine learning 做 deep learning 做 data analytics 做 data science 也好 scientist 也好通通都要都做的基本功啊那 again 先先对有一些 > 也许对
ID0012W0014 he tried to think how it could be
train_wav.scp
左边为数据唯一 ID,需与 train_text.txt 中的 ID 一一对应
右边为音频文件的路径,格式如下
BAC009S0764W0121 https://isv-data.oss-cn-hangzhou.aliyuncs.com/ics/MaaS/ASR/test_audio/BAC009S0764W0121.wav
BAC009S0916W0489 https://isv-data.oss-cn-hangzhou.aliyuncs.com/ics/MaaS/ASR/test_audio/BAC009S0916W0489.wav
asr_example_cn_en https://isv-data.oss-cn-hangzhou.aliyuncs.com/ics/MaaS/ASR/test_audio/asr_example_cn_en.wav
ID0012W0014 https://isv-data.oss-cn-hangzhou.aliyuncs.com/ics/MaaS/ASR/test_audio/asr_example_en.wav
train_text_language.txt
左边为数据唯一 ID,需与 train_text_language.txt 中的 ID 一一对应
右边为音频文件的语种标签,支持 <|zh|>、<|en|>、<|yue|>、<|ja|> 和 <|ko|>,格式如下
BAC009S0764W0121 <|zh|>
BAC009S0916W0489 <|zh|>
asr_example_cn_en <|zh|>
ID0012W0014 <|en|>
train_emo.txt
左边为数据唯一 ID,需与 train_emo.txt 中的 ID 一一对应
右边为音频文件的情感标签,支持 <|HAPPY|>、<|SAD|>、<|ANGRY|>、<|NEUTRAL|>、<|FEARFUL|>、<|DISGUSTED|> 和 <|SURPRISED|>,格式如下
BAC009S0764W0121 <|NEUTRAL|>
BAC009S0916W0489 <|NEUTRAL|>
asr_example_cn_en <|NEUTRAL|>
ID0012W0014 <|NEUTRAL|>
train_event.txt
左边为数据唯一 ID,需与 train_event.txt 中的 ID 一一对应
右边为音频文件的事件标签,支持 <|BGM|>、<|Speech|>、<|Applause|>、<|Laughter|>、<|Cry|>、<|Sneeze|>、<|Breath|> 和 <|Cough|>,格式如下
BAC009S0764W0121 <|Speech|>
BAC009S0916W0489 <|Speech|>
asr_example_cn_en <|Speech|>
ID0012W0014 <|Speech|>
生成指令
# generate train.jsonl and val.jsonl from wav.scp, text.txt, text_language.txt, emo_target.txt, event_target.txt
sensevoice2jsonl \
++scp_file_list='["../../../data/list/train_wav.scp", "../../../data/list/train_text.txt", "../../../data/list/train_text_language.txt", "../../../data/list/train_emo.txt", "../../../data/list/train_event.txt"]' \
++data_type_list='["source", "target", "text_language", "emo_target", "event_target"]' \
++jsonl_file_out="../../../data/list/train.jsonl"
若无 train_text_language.txt、train_emo_target.txt 和 train_event_target.txt,则自动通过使用 SenseVoice 模型对语种、情感和事件打标。
# generate train.jsonl and val.jsonl from wav.scp and text.txt
sensevoice2jsonl \
++scp_file_list='["../../../data/list/train_wav.scp", "../../../data/list/train_text.txt"]' \
++data_type_list='["source", "target"]' \
++jsonl_file_out="../../../data/list/train.jsonl" \
++model_dir='iic/SenseVoiceSmall'
启动训练
注意修改 finetune.sh 中 train_tool 为你前面安装 FunASR 路径中 funasr/bin/train_ds.py 绝对路径
bash finetune.sh
WebUI
python webui.py
优秀三方工作
- Triton(GPU)部署最佳实践,triton + tensorrt,fp32 测试,V100 GPU 上加速比 526,fp16 支持中,repo
- sherpa-onnx 部署最佳实践,支持在 10 种编程语言里面使用 SenseVoice, 即 C++, C, Python, C#, Go, Swift, Kotlin, Java, JavaScript, Dart. 支持在 iOS, Android, Raspberry Pi 等平台使用 SenseVoice,repo
- Orca 已通过 sherpa-onnx 集成 SenseVoice 本地离线语音识别,支持在 macOS、Linux 和 Windows 上自动识别中文、英文、日文、韩文和粤语。该集成已在 #7436 合并,当前可通过 v1.4.159-rc.1 预发布版 使用;Orca v1.4.158 稳定版发布早于本次集成。
- SenseVoice.cpp 基于GGML,在纯C/C++中推断SenseVoice,支持3位、4位、5位、8位量化等,无需第三方依赖。
- 流式SenseVoice,通过分块(chunk)的方式进行推理,为了实现伪流式处理,采用了截断注意力机制(truncated attention),牺牲了部分精度。此外,该技术还支持CTC前缀束搜索(CTC prefix beam search)以及热词增强功能。
- OmniSenseVoice 轻量化推理库,支持batch推理。
- SenseVoice Hotword,神经网络热词增强,WeNet 中开源基于 CPPN 的神经网络热词增强。
许可证
- 本仓库源码采用 MIT License。
- 模型权重单独发布,并以各模型卡标注的条款为准。官方 SenseVoiceSmall 模型卡 链接至 FunASR 模型开源协议;其他制品和转换版本可能标注不同条款,使用前请核对对应模型卡。
- 维护者已针对 FunASR 模型开源协议 v1.1 发布 SenseVoiceSmall 官方许可澄清:遵守模型协议时,允许商业使用官方 SenseVoiceSmall 权重;第 3 节属于责任和风险免责声明,不构成额外的“禁止商用”限制;微调后的衍生权重可以保持私有。使用、复制、修改或分享模型时,仍需遵守第 2.2 节的署名和模型名称要求。此澄清仅适用于官方权重,第三方转换版本和打包制品仍需分别核对其条款。
联系我们
如果您在使用中遇到问题,可以直接在 github 页面提 Issues。欢迎语音兴趣爱好者扫描以下的钉钉群二维码加入社区群,进行交流和讨论。
| FunASR |
|---|
 |