
QwenAudio/Fun-ASR
QwenAudio/Fun-ASR has 1,610 GitHub stars and 162 forks. GitHot measured +11 in 7 days and +16 in 15 days. Last checked 2026-11-15 19:45 UTC. Last push 2026-11-09.
可以做什么
- Far-field High-noise Recognition: Deeply optimized for far-distance sound pickup and high-noise scenarios (such as conference rooms, in-vehicle environments, industrial sites, etc.), improving recognition accuracy to 93%.
- Supports 7 major dialects: Wu, Cantonese, Min, Hakka, Gan, Xiang, Jin
- Covers 26 regional accents: including Henan, Shaanxi, Hubei, Sichuan, Chongqing, Yunnan, Guizhou, Guangdong, Guangxi and more than 20 other regions
- Checkpoint-specific language coverage: Fun-ASR-Nano supports Chinese, English, Japanese, and Chinese dialects and accents. Fun-ASR-MLT-Nano supports 31 languages, with emphasis on East and Southeast Asian languages.
实测星标增长
- 24小时
- 更新延迟
- 7天
- +11
- 15天
- +16
- 1个月
- 更新延迟
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
关于
Fun-ASR speech recognition models, with native Hugging Face Transformers support for Fun-ASR-Nano and separate FunASR, vLLM and llama.cpp deployment paths.
机器学习README_zh.md
原文Fun-ASR
「简体中文」|「English」
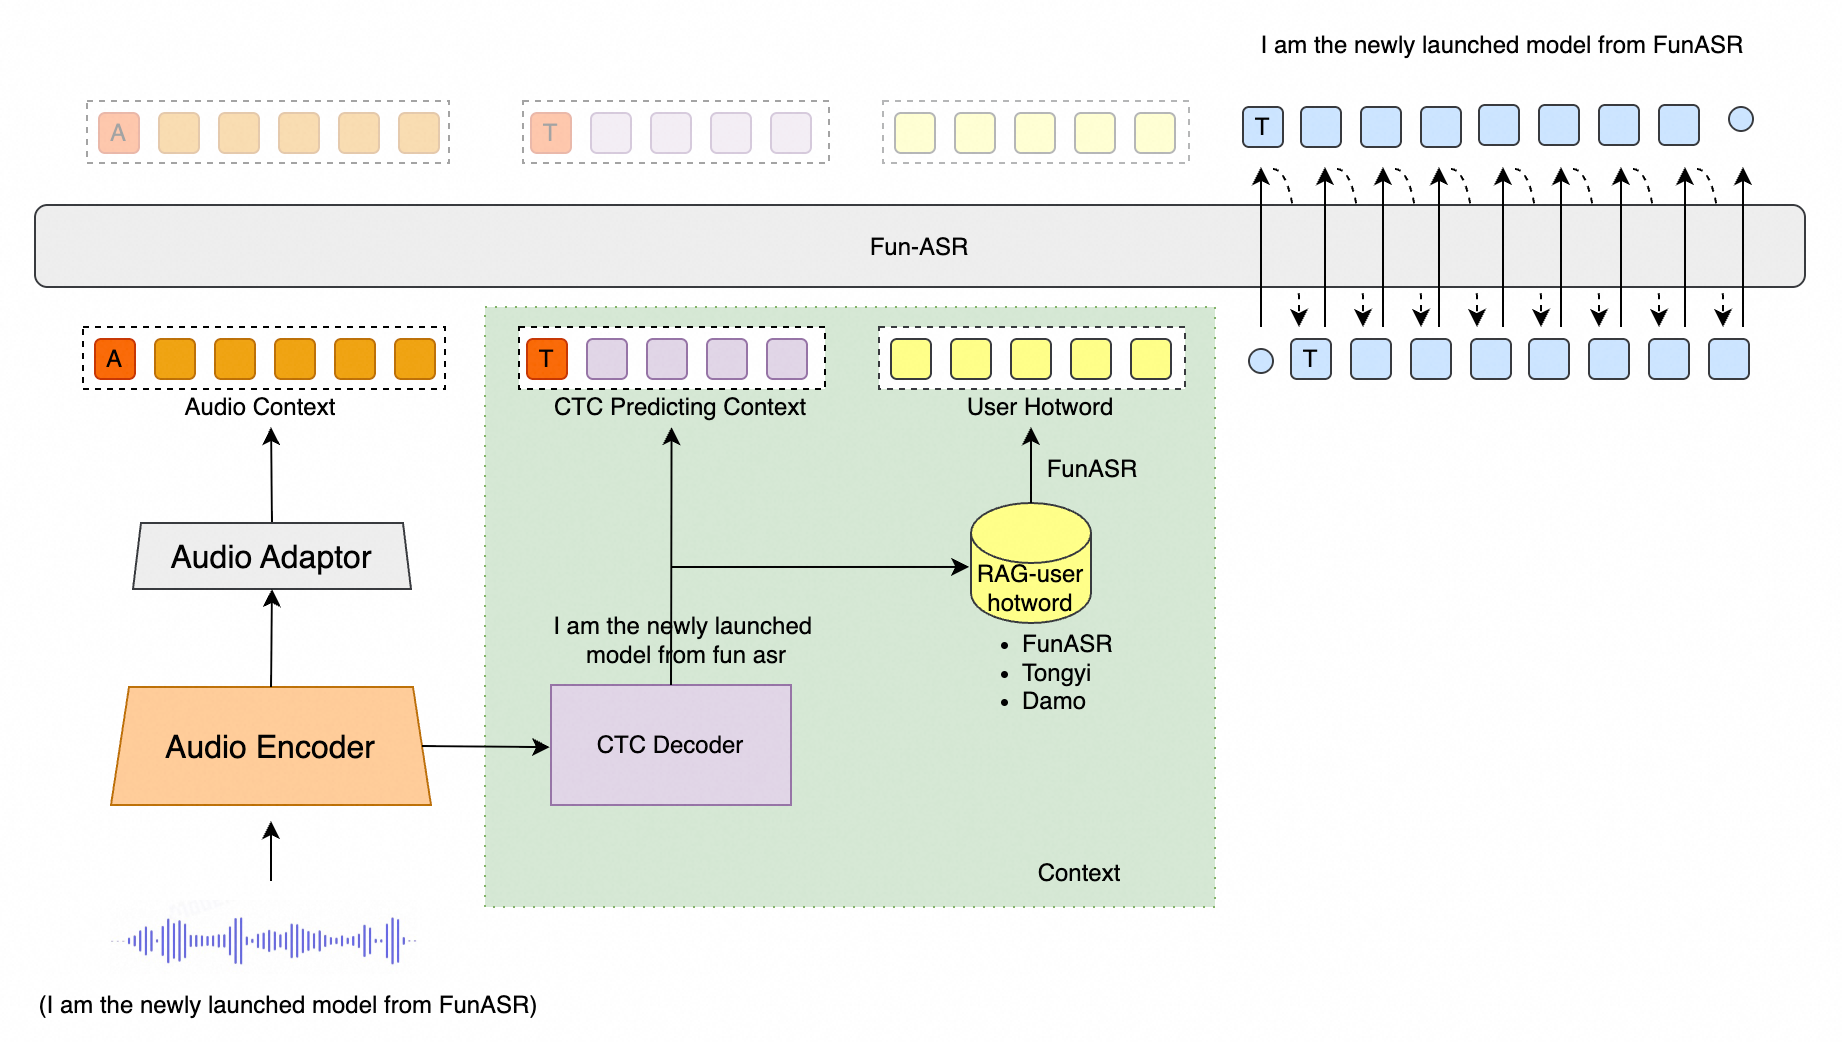
Fun-ASR 是通义实验室推出的端到端语音识别模型家族,不同 checkpoint 的能力范围不同:Fun-ASR-Nano-2512 基于数千万小时语音训练,支持中文、英文、日文及中文方言和地域口音;Fun-ASR-MLT-Nano-2512 是基于数十万小时多语种语音训练的 8 亿参数 checkpoint,支持 31 种语言。两者均可通过 FunASR 完成推理与服务部署。
Homepage | 核心特性 | 性能评测 | 环境安装 | 用法教程
模型仓库:Fun-ASR-Nano(ModelScope、HF / Transformers · HF / FunASR) · Fun-ASR-MLT-Nano(ModelScope、Hugging Face)
在线体验: 魔搭社区创空间,huggingface space
可运行示例脚本 覆盖快速上手、直接推理、说话人分离、vLLM 批量推理和 Streaming SDK。
| 模型 | 介绍 | 训练数据 | 参数 |
|---|---|---|---|
| Fun-ASR-Nano (⭐ HF / Transformers · HF / FunASR) |
支持中文、英文、日文。中文包含 7 种方言(吴语、粤语、闽语、客家话、赣语、湘语、晋语)及 26 种地域口音支持(河南、陕西、湖北、四川、重庆、云南、贵州、广东、广西、河北、天津、山东、安徽、南京、江苏、杭州、甘肃、宁夏)。英文、日文涵盖多种地域口音。额外功能包括歌词识别与说唱语音识别。 | 数千万小时 | 8 亿 |
| Fun-ASR-MLT-Nano (⭐ 🤗) |
支持中文、英文、粤语、日文、韩文、越南语、印尼语、泰语、马来语、菲律宾语、阿拉伯语、印地语、保加利亚语、克罗地亚语、捷克语、丹麦语、荷兰语、爱沙尼亚语、芬兰语、希腊语、匈牙利语、爱尔兰语、拉脱维亚语、立陶宛语、马耳他语、波兰语、葡萄牙语、罗马尼亚语、斯洛伐克语、斯洛文尼亚语、瑞典语,共 31 种语言。 | 数十万小时 | 8 亿 |
最新动态 🔥
- FunASR 1.4.15 是当前 Python 发布版,覆盖源码安装、MOSS 发现与实时/工业部署。安装命令:
python -m pip install -U "funasr==1.4.15"。发布说明 -> - MOSS-Transcribe-Diarize 是 OpenMOSS 的第三方模型,可离线完成长音频转写、时间戳和匿名说话人标签;FunASR 已提供服务、Docker、Kubernetes、vLLM、SGLang、LocalAI 与 FunClip 部署路径。部署 MOSS ->
- 工业部署 覆盖实时 WebSocket 服务、原生 vLLM 批量/流式路径,以及已校验的 Linux、macOS、Windows llama.cpp / GGUF 包。Runtime v0.2.6 -> · vLLM 指南 ->
Transformers 原生快速开始
直接使用已发布的 Transformers 5.17.0,不需要安装 FunASR 工具库或执行模型仓库的远程 Python 代码。基础 Nano 支持中、英、日;31 语言 MLT 是另一个 checkpoint。
python -m pip install 'transformers==5.17.0' 'torch==2.10.0' 'torchaudio==2.10.0' 'librosa==0.11.0' 'soundfile==0.13.1'
完整 Python 示例 · 本地音频、批处理与热词 · Notebook · Space
import torch
from transformers import AutoModelForSpeechSeq2Seq, AutoProcessor

torch.set_num_threads(4)
model_id = "FunAudioLLM/Fun-ASR-Nano-2512-hf"
revision = "d93b302ee7fd505e1b3576120fc142fc6f7820e1"
audio = "https://huggingface.co/FunAudioLLM/Fun-ASR-Nano-2512/resolve/272c57b82523ada6fd87095e955f8e29100979ab/example/en.mp3"

processor = AutoProcessor.from_pretrained(
    model_id, revision=revision, trust_remote_code=False, token=False
)
model = AutoModelForSpeechSeq2Seq.from_pretrained(
    model_id, revision=revision, trust_remote_code=False, token=False,
    dtype=torch.float32,
).to("cpu").eval()
inputs = processor.apply_transcription_request(
    audio=audio, language="en",
    processor_kwargs={
        "return_tensors": "pt",
        "audio_kwargs": {"sampling_rate": 16000},
        "text_kwargs": {"padding": True},
    },
)
with torch.inference_mode():
    generated = model.generate(**inputs, max_new_tokens=128, do_sample=False)
new_tokens = generated[:, inputs.input_ids.shape[1]:]
print(processor.batch_decode(new_tokens, skip_special_tokens=True)[0])
核心特性 🎯
Fun-ASR 专注于高精度语音识别、checkpoint 级多语言支持和行业定制化能力。
- 远场高噪声识别: 针对远距离拾音及高噪声场景(如会议室、车载环境、工业现场等)进行深度优化,识别准确率提升至 93%。
- 中文方言与地方口音:
- 支持 7 大方言:吴语、粤语、闽语、客家话、赣语、湘语、晋语
- 覆盖 26 个地区口音:包括河南、陕西、湖北、四川、重庆、云南、贵州、广东、广西等 20 多个地区
- 按 checkpoint 区分语言范围: Fun-ASR-Nano 支持中文、英文、日文及中文方言和地域口音;Fun-ASR-MLT-Nano 支持 31 种语言,重点覆盖东亚与东南亚语种。
- 音乐背景歌词识别: 强化在音乐背景干扰下的语音识别性能,支持对歌曲中歌词内容的精准识别。
环境安装 🐍
git clone https://github.com/QwenAudio/Fun-ASR.git
cd Fun-ASR
pip install -r requirements.txt
能力边界
- checkpoint 原生字级时间戳(需区分模型托管源)
当前 ModelScope
FunAudioLLM/Fun-ASR-Nano-2512checkpoint 已包含全部 86 个训练后的ctc_decoder.*/ctc.*张量(model.ptSHA-256:81fec8616083c69377f3ceef36aba3655660ee0ca69a5d4a1e9810cd340ca499),可以输出原生 CTC 时间戳。Hugging Face revision272c57b82523ada6fd87095e955f8e29100979ab仍是旧的纯文本权重(model.ptSHA-256:55ae0d2fee369f0f11cce0795f6927934ad17cf11b278a7e56a51272074160bb),不含 CTC 张量。使用本仓库当前model.py与funasr>=1.3.26时,不完整 checkpoint 会安全关闭 CTC:文本转写继续可用,但不会再返回随机的 60 ms 时间戳。Hugging Face 权重和远程代码同步前,需要原生时间戳请使用hub="ms"。详见 issue #70 与 FunASR #3496。 - checkpoint 原生说话人分离
Fun-ASR-Nano 和 Fun-ASR-MLT-Nano 本身不输出说话人标签;需在 FunASR 中组合独立的
fsmn-vad与cam++模型。 如需一次完成转写、时间戳和匿名说话人标签,可使用第三方 OpenMOSS 的 MOSS-Transcribe-Diarize 部署指南。它是独立模型,不是 Fun-ASR-Nano checkpoint 的原生能力。 - 支持模型训练
用法 🛠️
推理
CPU / 边缘设备运行 — llama.cpp / GGUF(无 GPU、无 Python 运行时)
Fun-ASR-Nano 可作为单个自包含二进制运行,类似 whisper.cpp,内置 FSMN-VAD,适合离线 CPU/边缘部署。
bash runtime/llama.cpp/download-funasr-model.sh nano ./gguf
llama-funasr-cli --enc ./gguf/funasr-encoder-f16.gguf -m ./gguf/qwen3-0.6b-q8_0.gguf -a audio.wav --vad ./gguf/fsmn-vad.gguf
fsmn-vad.gguf 独立发布在共享的 FunAudioLLM/fsmn-vad-GGUF 仓库中,不在 Nano GGUF 仓库内。上面的 nano 下载脚本会自动拉取;如果只想单独下载 VAD 文件,可使用:
hf download FunAudioLLM/fsmn-vad-GGUF --include "*.gguf" --local-dir ./gguf
预编译二进制: Releases · 下载与快速开始: funasr.com/llama-cpp · GGUF: Nano encoder/LLM · FSMN-VAD · 文档与 benchmark: runtime/llama.cpp/
使用 funasr 推理
from funasr import AutoModel


def main():
    model_dir = "FunAudioLLM/Fun-ASR-Nano-2512"
    model = AutoModel(
        model=model_dir,
        trust_remote_code=True,
        remote_code="./model.py",
        device="cuda:0",
        hub="ms"
    )

    wav_path = f"{model.model_path}/example/zh.mp3"
    res = model.generate(
        input=[wav_path],
        cache={},
        batch_size=1,
        hotwords=["开放时间"],
        # 中文、英文、日文 for Fun-ASR-Nano-2512
        # 中文、英文、粤语、日文、韩文、越南语、印尼语、泰语、马来语、菲律宾语、阿拉伯语、
        # 印地语、保加利亚语、克罗地亚语、捷克语、丹麦语、荷兰语、爱沙尼亚语、芬兰语、希腊语、
        # 匈牙利语、爱尔兰语、拉脱维亚语、立陶宛语、马耳他语、波兰语、葡萄牙语、罗马尼亚语、
        # 斯洛伐克语、斯洛文尼亚语、瑞典语 for Fun-ASR-MLT-Nano-2512
        language="中文",
        itn=True, # or False
    )
    text = res[0]["text"]
    print(text)

    model = AutoModel(
        model=model_dir,
        trust_remote_code=True,
        vad_model="fsmn-vad",
        vad_kwargs={"max_single_segment_time": 30000},
        remote_code="./model.py",
        device="cuda:0",
    )
    res = model.generate(input=[wav_path], cache={}, batch_size=1)
    text = res[0]["text"]
    print(text)


if __name__ == "__main__":
    main()
直接推理
from model import FunASRNano


def main():
    model_dir = "FunAudioLLM/Fun-ASR-Nano-2512"
    m, kwargs = FunASRNano.from_pretrained(model=model_dir, device="cuda:0")
    m.eval()

    wav_path = f"{kwargs['model_path']}/example/zh.mp3"
    res = m.inference(data_in=[wav_path], **kwargs)
    text = res[0][0]["text"]
    print(text)


if __name__ == "__main__":
    main()
参数说明(点击展开)
model_dir:模型名称,或本地磁盘中的模型路径。trust_remote_code:是否信任远程代码,用于加载自定义模型实现。remote_code:指定模型具体代码的位置(例如,当前目录下的model.py),支持绝对路径与相对路径。device:指定使用的设备,如 "cuda:0" 或 "cpu"。
微调
详情请参考 docs/finetune_zh.md
性能评测 📝
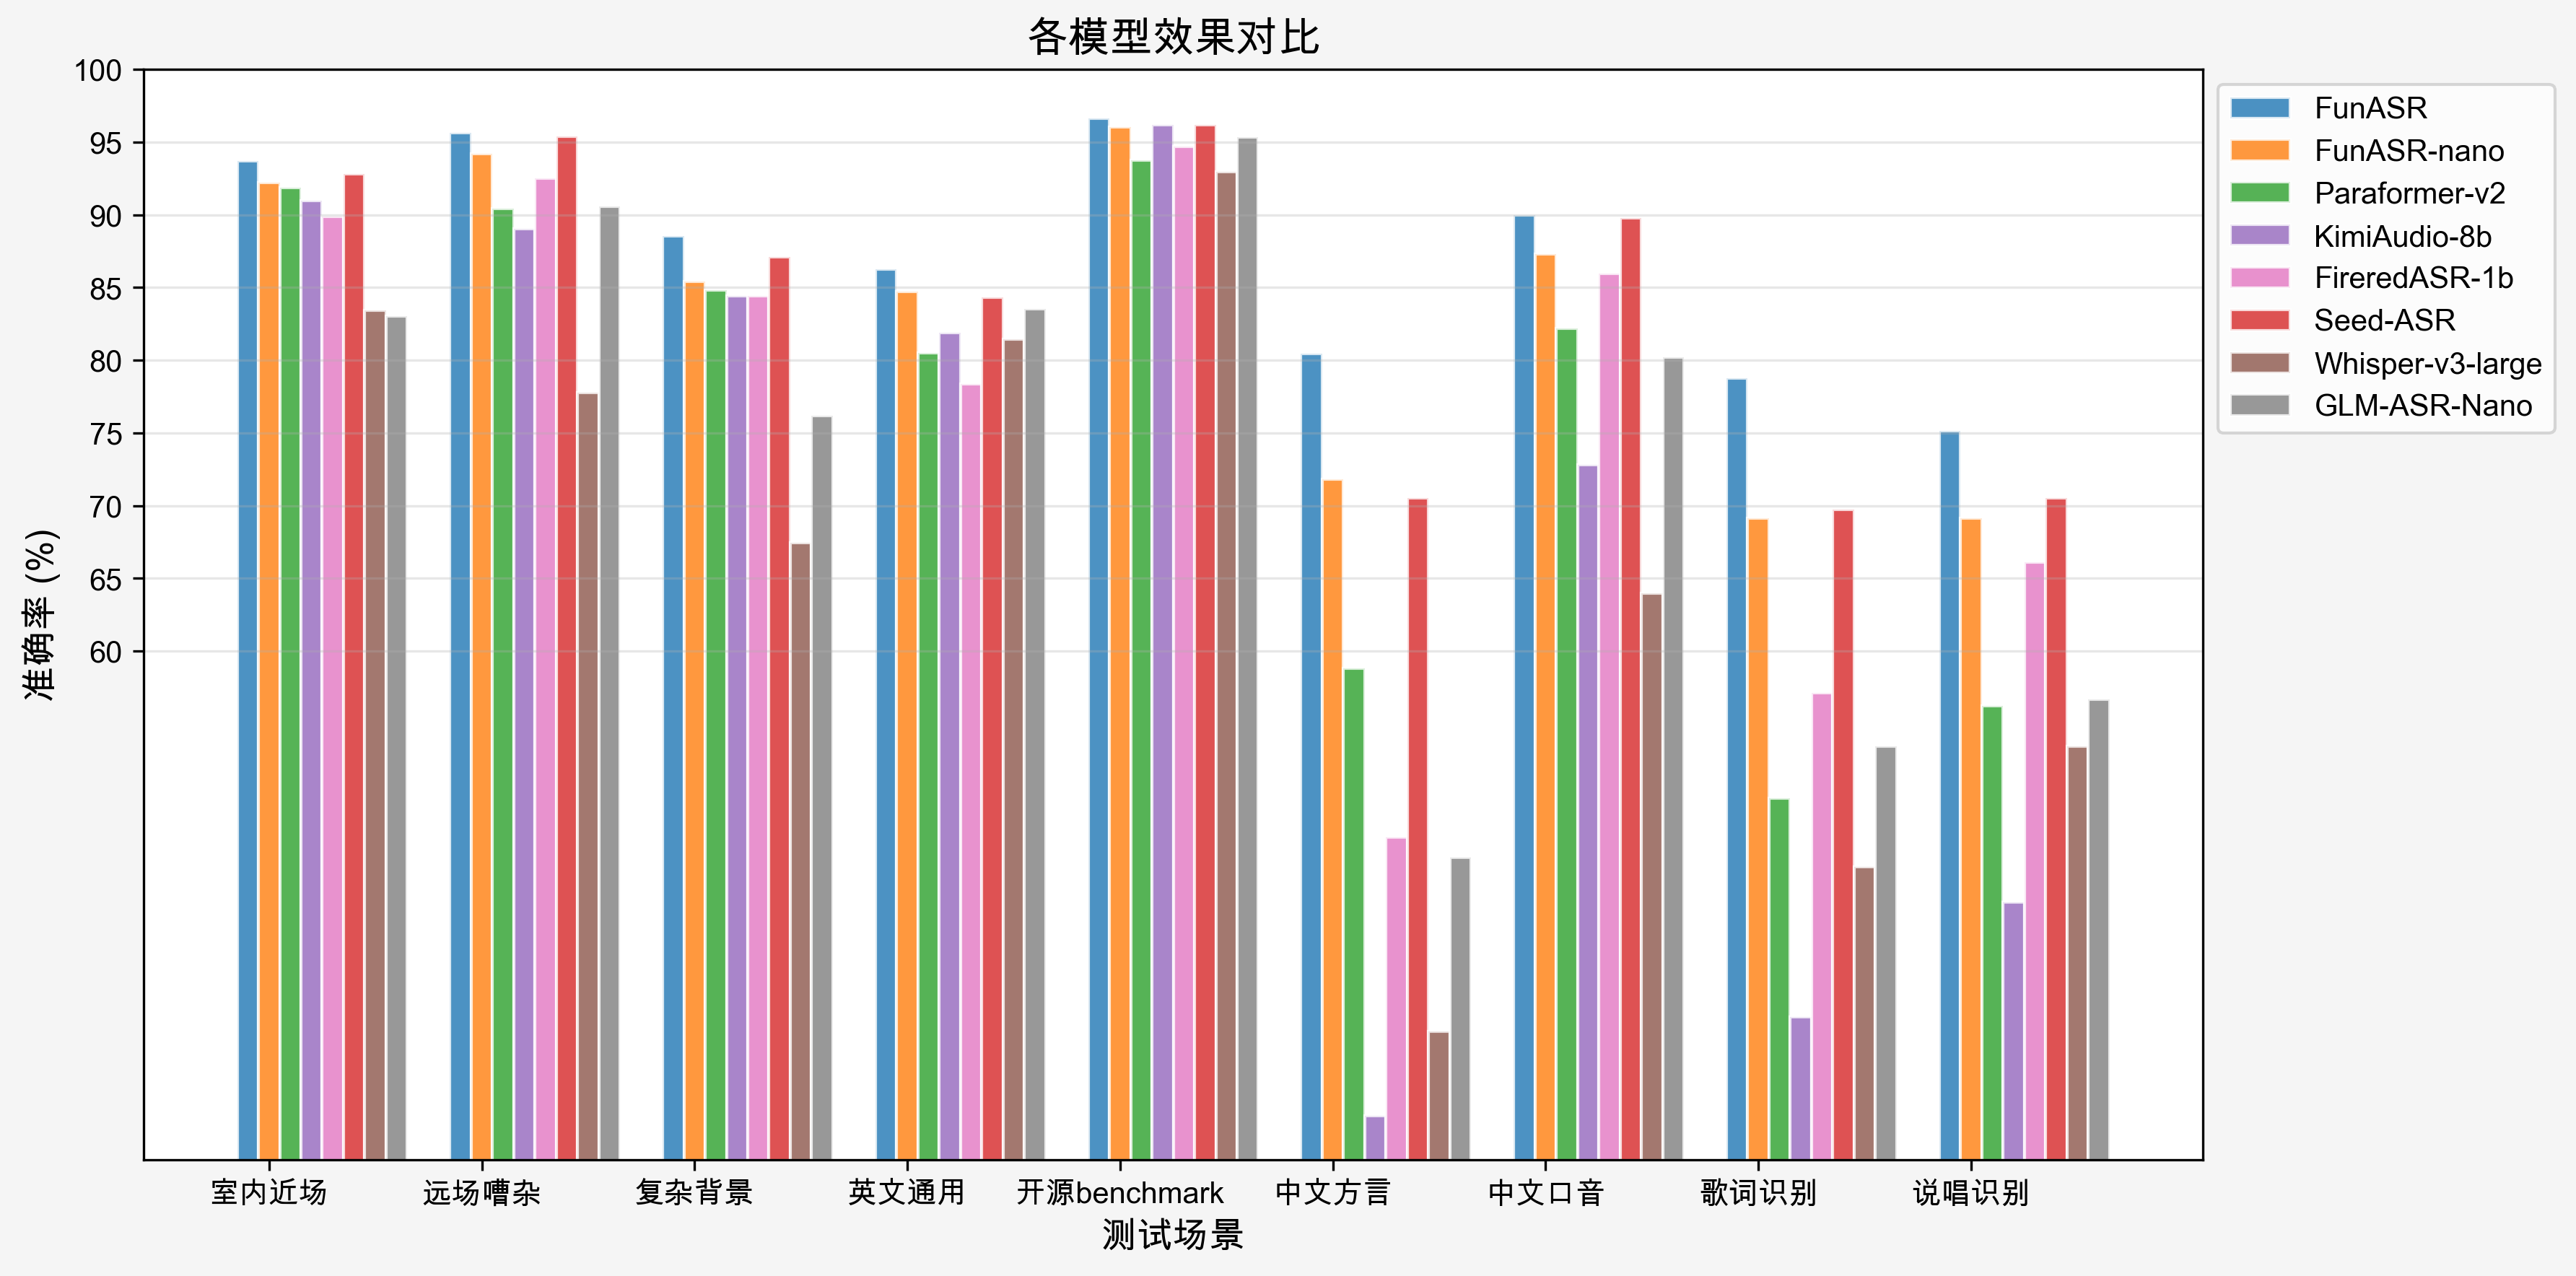
我们在开源基准数据集、中文方言测试集和工业测试集上,比较了 Fun-ASR 与其他模型的多语言语音识别性能。Fun-ASR 模型均具有明显的效果优势。
1. 开源数据集性能 (WER %)
| Test set | GLM-ASR-nano | GLM-ASR-nano* | Whisper-large-v3 | Seed-ASR | Seed-ASR* | Kimi-Audio | Step-Audio2 | FireRed-ASR | Fun-ASR-nano | Fun-ASR |
|---|---|---|---|---|---|---|---|---|---|---|
| Model Size | 1.5B | 1.5B | 1.6B | - | - | - | - | 1.1B | 0.8B | 7.7B |
| OpenSource | ✅ | ✅ | ✅ | ❌ | ❌ | ✅ | ✅ | ✅ | ✅ | ❌ |
| AIShell1 | 1.81 | 2.17 | 4.72 | 0.68 | 1.63 | 0.71 | 0.63 | 0.54 | 1.80 | 1.22 |
| AIShell2 | - | 3.47 | 4.68 | 2.27 | 2.76 | 2.86 | 2.10 | 2.58 | 2.75 | 2.39 |
| Fleurs-zh | - | 3.65 | 5.18 | 3.43 | 3.23 | 3.11 | 2.68 | 4.81 | 2.56 | 2.53 |
| Fleurs-en | 5.78 | 6.95 | 6.23 | 9.39 | 9.39 | 6.99 | 3.03 | 10.79 | 5.96 | 4.74 |
| Librispeech-clean | 2.00 | 2.17 | 1.86 | 1.58 | 2.8 | 1.32 | 1.17 | 1.84 | 1.76 | 1.51 |
| Librispeech-other | 4.19 | 4.43 | 3.43 | 2.84 | 5.69 | 2.63 | 2.42 | 4.52 | 4.33 | 3.03 |
| WenetSpeech Meeting | 6.73 | 8.21 | 18.39 | 5.69 | 7.07 | 6.24 | 4.75 | 4.95 | 6.60 | 6.17 |
| WenetSpeech Net | - | 6.33 | 11.89 | 4.66 | 4.84 | 6.45 | 4.67 | 4.94 | 6.01 | 5.46 |
注:Seed-ASR* 结果使用 volcengine 上的官方 API 评估;GLM-ASR-nano* 结果使用开源 checkpoint 评估。
2. 工业数据集性能 (WER %)
| Test set | GLM-ASR-Nano | Whisper-large-v3 | Seed-ASR | FireRed-ASR | Kimi-Audio | Paraformer v2 | Fun-ASR-nano | Fun-ASR |
|---|---|---|---|---|---|---|---|---|
| Model Size | 1.5B | 1.6B | - | 1.1B | 8B | 0.2B | 0.8B | 7.7B |
| OpenSource | ✅ | ✅ | ❌ | ✅ | ✅ | ✅ | ✅ | ❌ |
| Nearfield | 16.95 | 16.58 | 7.20 | 10.10 | 9.02 | 8.11 | 7.79 | 6.31 |
| Farfield | 9.44 | 22.21 | 4.59 | 7.49 | 10.95 | 9.55 | 5.79 | 4.34 |
| Complex Background | 23.79 | 32.57 | 12.90 | 15.56 | 15.56 | 15.19 | 14.59 | 11.45 |
| English General | 16.47 | 18.56 | 15.65 | 21.62 | 18.12 | 19.48 | 15.28 | 13.73 |
| Opensource | 4.67 | 7.05 | 3.83 | 5.31 | 3.79 | 6.23 | 4.22 | 3.38 |
| Dialect | 54.21 | 66.14 | 29.45 | 52.82 | 71.94 | 41.16 | 28.18 | 15.21 |
| Accent | 19.78 | 36.03 | 10.23 | 14.05 | 27.20 | 17.80 | 12.90 | 10.31 |
| Lyrics | 46.56 | 54.82 | 30.26 | 42.87 | 65.18 | 50.14 | 30.85 | 21.00 |
| Hiphop | 43.32 | 46.56 | 29.46 | 33.88 | 57.25 | 43.79 | 30.87 | 28.58 |
| Average | 26.13 | 33.39 | 15.95 | 22.63 | 31.00 | 23.49 | 16.72 | 12.70 |
优秀三方工作
- Fun-ASR-vllm(@yuekaizhang)— 社区实现的 Fun-ASR vLLM 方案,支持批量推理和 NVIDIA Triton Inference Server 高并发部署。参见 #34。
Fun-ASR 也已内置原生 vLLM 支持,包括
AutoModelVLLM批量推理、Streaming SDK 和 WebSocket 服务;请参考 vLLM 中文指南 与 可运行示例脚本。
许可证
- 本仓库源码采用 Apache License 2.0。
- 模型权重单独发布,并以各模型卡标注的许可证为准。官方 Fun-ASR-Nano 与 Fun-ASR-MLT-Nano 模型卡目前均标注 Apache-2.0;请在下载具体制品前再次核对对应模型卡。
Citations
@misc{an2025funasrtechnicalreport,
      title={Fun-ASR Technical Report},
      author={Keyu An and Yanni Chen and Zhigao Chen and Chong Deng and Zhihao Du and Changfeng Gao and Zhifu Gao and Bo Gong and Xiangang Li and Yabin Li and Ying Liu and Xiang Lv and Yunjie Ji and Yiheng Jiang and Bin Ma and Haoneng Luo and Chongjia Ni and Zexu Pan and Yiping Peng and Zhendong Peng and Peiyao Wang and Hao Wang and Haoxu Wang and Wen Wang and Wupeng Wang and Yuzhong Wu and Biao Tian and Zhentao Tan and Nan Yang and Bin Yuan and Jieping Ye and Jixing Yu and Qinglin Zhang and Kun Zou and Han Zhao and Shengkui Zhao and Jingren Zhou and Yanqiao Zhu},
      year={2025},
      eprint={2509.12508},
      archivePrefix={arXiv},
      primaryClass={cs.CL},
      url={https://arxiv.org/abs/2509.12508},
}