
NovaSearch-Team/RAG-Retrieval
NovaSearch-Team/RAG-Retrieval has 1,137 GitHub stars and 88 forks. GitHot measured 0 stars in 24 hours and 0 in 7 days. Last checked 2026-11-11 08:09 UTC. Last push 2026-08-28.
Unify Efficient Fine-tuning of RAG Retrieval, including Embedding, ColBERT, ReRanker.
可以做什么
- Simple yet Elegant: Rejects complex, with a simple and understandable code structure for easy modifications.
- Supports end-to-end fine-tuning of RAG retrieval models: Embedding (bert-based, llm-based), late interaction models (colbert), and reranker models (bert-based, llm-based).
- Supports fine-tuning of any open-source RAG retrieval models: Compatible with most open-source embedding and reranker models, such as: bge (bge-embedding, bge-m3, bge-reranker), bce (bce-embedding, bce-reranker), gte (gte-embedding, gte-multilingual-reranker-base).
- Supports distillation of larger models into smaller models: Enables the distillation of larger LLM-based reranker or embedding models into smaller ones (e.g., a 0.5B-parameter LLM or BERT-base).
实测星标增长
- 24小时
- 0
- 7天
- 0
- 15天
- 更新延迟
- 1个月
- 更新延迟
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
README_zh.md
原文RAG-Retrieval


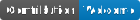

RAG-Retrieval 提供了全链路的RAG检索模型微调(train)和推理(infer)以及蒸馏(distill)代码。
- 对于微调,支持微调任意开源的RAG检索模型,包括向量模型(图a,bert-based,llm-based embedding)、迟交互式模型(图d,colbert)、重排序模型(图c,bert-based, llm-based reranker)。
- 对于推理,RAG-Retrieval专注于重排序(reranker),开发了一个轻量级的python库rag-retrieval,提供统一的方式调用任意不同的RAG排序模型。
- 对于蒸馏,支持向量模型和排序模型的蒸馏,可以从较大的模型蒸馏到较小的模型(0.5b llm or bert-base)中。
社区交流
最新更新
🔥 22/05/2025:RAG-Retrieval 发布 Myopic Trap,一项针对全流程信息检索(IR)链路中位置偏置的实证研究。我们在两个精心设计的位置感知型基准数据集(SQuAD-PosQ 和 FineWeb-PosQ)上,系统评估了多种 SOTA 检索模型,包括 BM25、稠密向量模型、ColBERT-style 模型以及重排序器(reranker)。了解更多
29/12/2024:RAG-Retrieval发布Stella and jasper embedidng model 的核心训练代码(stage3)Jasper and Stella: distillation of SOTA embedding models.
21/10/2024: RAG-Retrieval发布基于LLM做Reranker任务的两种不同方法,以及将其蒸馏到bert中的方法。LLM在Reranker任务上的最佳实践?A simple experiment report(with code)
05/06/2024: RAG-Retrieval的Embedding模型的MRL loss实现。RAG-Retrieval:让MRL loss成为训练向量(embedding)模型的标配
02/06/2024: RAG-Retrieval实现基于LLM偏好监督RAG检索器微调。RAG-Retrieval实现基于LLM偏好监督RAG检索器微调
05/05/2024:发布RAG-Retrieval的轻量级的python库RAG-Retrieval:你的RAG应用值得更好的排序推理框架
18/03/2024:发布RAG-Retrieval RAG-Retrieval知乎介绍
项目特色
- 简单且优雅: 拒绝复杂的封装,简单易懂的代码结构,方便修改。
- 支持全链路的RAG检索模型微调: 向量(bert-based,llm-based),迟交互模型(colbert),重排序模型(bert-based,llm-based)。
- 支持微调任意开源的RAG检索模型: 支持大部分开源的embedding和reranker模型,例如:bge(bge-embedding,bge-m3,bge-reranker),bce(bce-embedding,bce-reranker),gte(gte-embedding,gte-multilingual-reranker-base)。
- 支持将较大的检索模型蒸馏为较小的模型: 支持将较大的基于LLM的 reranker 和 embedding 模型蒸馏到较小的检索模型中(例如,0.5B LLM 或 BERT)。
- 先进算法: 对于embedding模型,支持MRL算法来缩减输出向量的维度,支持Stella 模型先进的蒸馏方法。
- 多卡训练策略: deepspeed,fsdp。
快速开始
安装
对于训练(all):
conda create -n rag-retrieval python=3.8 && conda activate rag-retrieval
#为了避免自动安装的torch与本地的cuda不兼容,建议进行下一步之前先手动安装本地cuda版本兼容的torch。
pip install -r requirements.txt
对于预测(reranker):
#为了避免自动安装的torch与本地的cuda不兼容,建议进行下一步之前先手动安装本地cuda版本兼容的torch。
pip install rag-retrieval
训练
对于不同的模型类型,请进入不同的子目录。例如: 对于embedding,其他同理。详细的流程可参考模型目录下的readme.
cd ./rag_retrieval/train/embedding
bash train_embedding.sh
预测
RAG-Retrieval开发了一个轻量级的python库rag-retrieval,提供统一的方式调用任意不同的RAG排序模型,具有以下的特点。
支持多种排序模型:支持常见的开源排序模型(Cross Encoder Reranker,Decoder-Only 的LLM Reranker)
长doc友好:支持两种不同的对于长doc的处理逻辑(最大长度截断,切分取最大分值)。
益于扩展:如果有新的排序模型,用户只需要继承basereranker,并且实现rank以及comput_score函数即可。
rag-retrieval包详细的使用方法和注意事项可以参考Tutorial
实验结果
reranker模型在 MTEB Reranking 任务的结果
| Model | Model Size(GB) | T2Reranking | MMarcoReranking | CMedQAv1 | CMedQAv2 | Avg |
|---|---|---|---|---|---|---|
| bge-reranker-base | 1.11 | 67.28 | 35.46 | 81.27 | 84.10 | 67.03 |
| bce-reranker-base_v1 | 1.11 | 70.25 | 34.13 | 79.64 | 81.31 | 66.33 |
| rag-retrieval-reranker | 0.41 | 67.33 | 31.57 | 83.54 | 86.03 | 67.12 |
其中,rag-retrieval-reranker是我们使用RAG-Retrieval代码在hfl/chinese-roberta-wwm-ext模型上训练所得,训练数据使用bge-rerank模型的训练数据.
colbert模型在 MTEB Reranking 任务的结果
| Model | Model Size(GB) | Dim | T2Reranking | MMarcoReranking | CMedQAv1 | CMedQAv2 | Avg |
|---|---|---|---|---|---|---|---|
| bge-m3-colbert | 2.24 | 1024 | 66.82 | 26.71 | 75.88 | 76.83 | 61.56 |
| rag-retrieval-colbert | 0.41 | 1024 | 66.85 | 31.46 | 81.05 | 84.22 | 65.90 |
其中,rag-retrieval-colbert是我们使用RAG-Retrieval代码在hfl/chinese-roberta-wwm-ext模型上训练所得,训练数据使用bge-rerank模型的训练数据.
用领域内数据微调开源的BGE系列模型
| Model | T2ranking | |
|---|---|---|
| bge-v1.5-embedding | 66.49 | |
| bge-v1.5-embedding finetune | 67.15 | +0.66 |
| bge-m3-colbert | 66.82 | |
| bge-m3-colbert finetune | 67.22 | +0.40 |
| bge-reranker-base | 67.28 | |
| bge-reranker-base finetune | 67.57 | +0.29 |
后面带有finetune的代表我们使用RAG-Retrieval在对应开源模型的基础上继续微调所得,训练数据使用T2-Reranking的训练集。
值得注意的是bge的三种开源模型,训练集中已经包含了T2-Reranking,并且该数据较为通用,因此使用该数据继续微调的性能提升效果不大,但是如果使用垂直领域的数据集继续微调开源模型,性能提升会更大。
Acknowledge
在开发过程中,我们借鉴或基于以下项目,衷心感谢这些团队为开源做出的贡献。
Star History
License
RAG-Retrieval is licensed under the MIT License.
探索相关项目
affaan-m/ECC
智能体执行与控制框架的性能优化系统。面向 Claude Code、Codex、Opencode、Cursor 等,涵盖技能、本能、记忆、安全与研究优先的开发。
301,279 星标NousResearch/hermes-agent
与你一同成长的智能体
262,699 星标multica-ai/andrej-karpathy-skills
一个用于改进 Claude Code 行为的 CLAUDE.md 文件,源自 Andrej Karpathy 对 LLM 编程陷阱的观察。
232,181 星标firecrawl/firecrawl
借助来自网络及其他来源的数据,强化你的 AI 智能体。正在构建面向超级智能的资料库。🔥
200,444 星标