
MiniMax-AI/MiniMax-H3
MiniMax-AI/MiniMax-H3 has 11,603 GitHub stars and 855 forks. GitHot measured +26 stars in 24 hours. Last checked 2026-11-08 09:49 UTC. Last push 2026-10-28.
Install the H3 prompt writing skill — one of nine skills bundled with this repository:
实测星标增长
- 24小时
- +26
- 7天
- 正在收集历史
- 15天
- 正在收集历史
- 1个月
- 正在收集历史
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
README.zh-CN.md
原文





MiniMax H3
提示词编写技能
安装 H3 提示词编写技能。这是本仓库内置的九个技能之一:
npx skills add https://github.com/MiniMax-AI/MiniMax-H3 --skill h3-prompt-writing
该技能在 skills/h3-prompt-writing/references/ 下提供两份提示词指南:base-en.txt 用于文本/关键帧模式,ref-en.txt 用于全参考(Ref2VA)模式。
智能体兼容性: h3-prompt-writing 是一个纯 Markdown + 参考文件技能,不调用任何外部 API,因此可在 Claude Code、Claude Agent SDK、Cursor、Windsurf、基于 OpenAI 的智能体/Codex、LangChain,以及任何能够读取 SKILL.md 和本地文件的运行环境中使用。内置的 skills/h3-prompt-writing/agents/openai.yaml 仅按照 OpenAI 的技能规范 提供可选的 ChatGPT/Codex 界面元数据(显示名称、描述、默认提示词),并不会将该技能限制为仅适用于 OpenAI 智能体。
其余八个是面向 MiniMax Hub 画布工作流(hub_generate_video、hub_generate_image、画布节点、选择卡片等)构建的特定风格视频生成技能,无法移植到通用智能体运行环境:
在线 API
通过 API 直接使用 MiniMax-H3。
- Global: platform.minimax.io | CN: platform.minimaxi.com
在线应用
通过应用直接使用 MiniMax-H3。
- WebApp Global: hailuoai.video | CN: hailuoai.com
- Desktop Global: hub.minimax.io | CN: hub.minimaxi.com
系统概览
MiniMax H3 是一个通用全模态生成系统。它支持对由文本、图像、视频和音频组成的多模态上下文进行统一理解,并可生成最高 2K 分辨率、最长 15 秒、带原生立体声音频的视频。得益于面向任务泛化的系统设计,H3 在预训练阶段已经具备广泛的多模态上下文理解与生成能力,能够出色地遵循复杂的多模态指令。
H3 支持以下输入和输出规格:
| 类别 | 规格 |
|---|---|
| 输出时长 | 4–15 秒 |
| 输出宽高比 | 支持多种宽高比,包括但不限于 21:9、16:9、4:3、1:1、3:4 和 9:16 |
| 输出分辨率 | 支持多种分辨率尺寸。默认短边为 768 像素。可通过 H3-Regenerate-2K 实现 2K 生成 |
| 输出帧率 | 24 FPS |
| 输出音频 | 32 kHz 立体声 |
| 支持的对话语言 | 稳定支持 11 种语言:阿拉伯语、中文、英语、法语、德语、意大利语、日语、韩语、葡萄牙语、俄语和西班牙语。其他语言也有不同程度的支持 |
模型变体和输入规格
| 模型变体 | 输入模式 | 规格 |
|---|---|---|
| H3-Base-FL2VA | 首尾帧模式 | 支持零张、一张或两张输入图像。 - 无图像输入:文生视频模式 - 一张图像输入:首帧生视频或尾帧生视频 - 两张图像输入:首尾帧生视频 |
| H3-Base-Ref2VA | 全参考模式 | 支持多模态参考输入: - 图像: ≤ 9 张 - 视频: ≤ 3 段;每段 2–15 秒;总时长 ≤ 15 秒 - 音频: ≤ 3 段;音频必须与图像或视频输入一起使用,不能作为唯一输入;每段 2–15 秒;总时长 ≤ 15 秒 - 混合输入: 所有输入类型的文件总数最多为 12 个 |
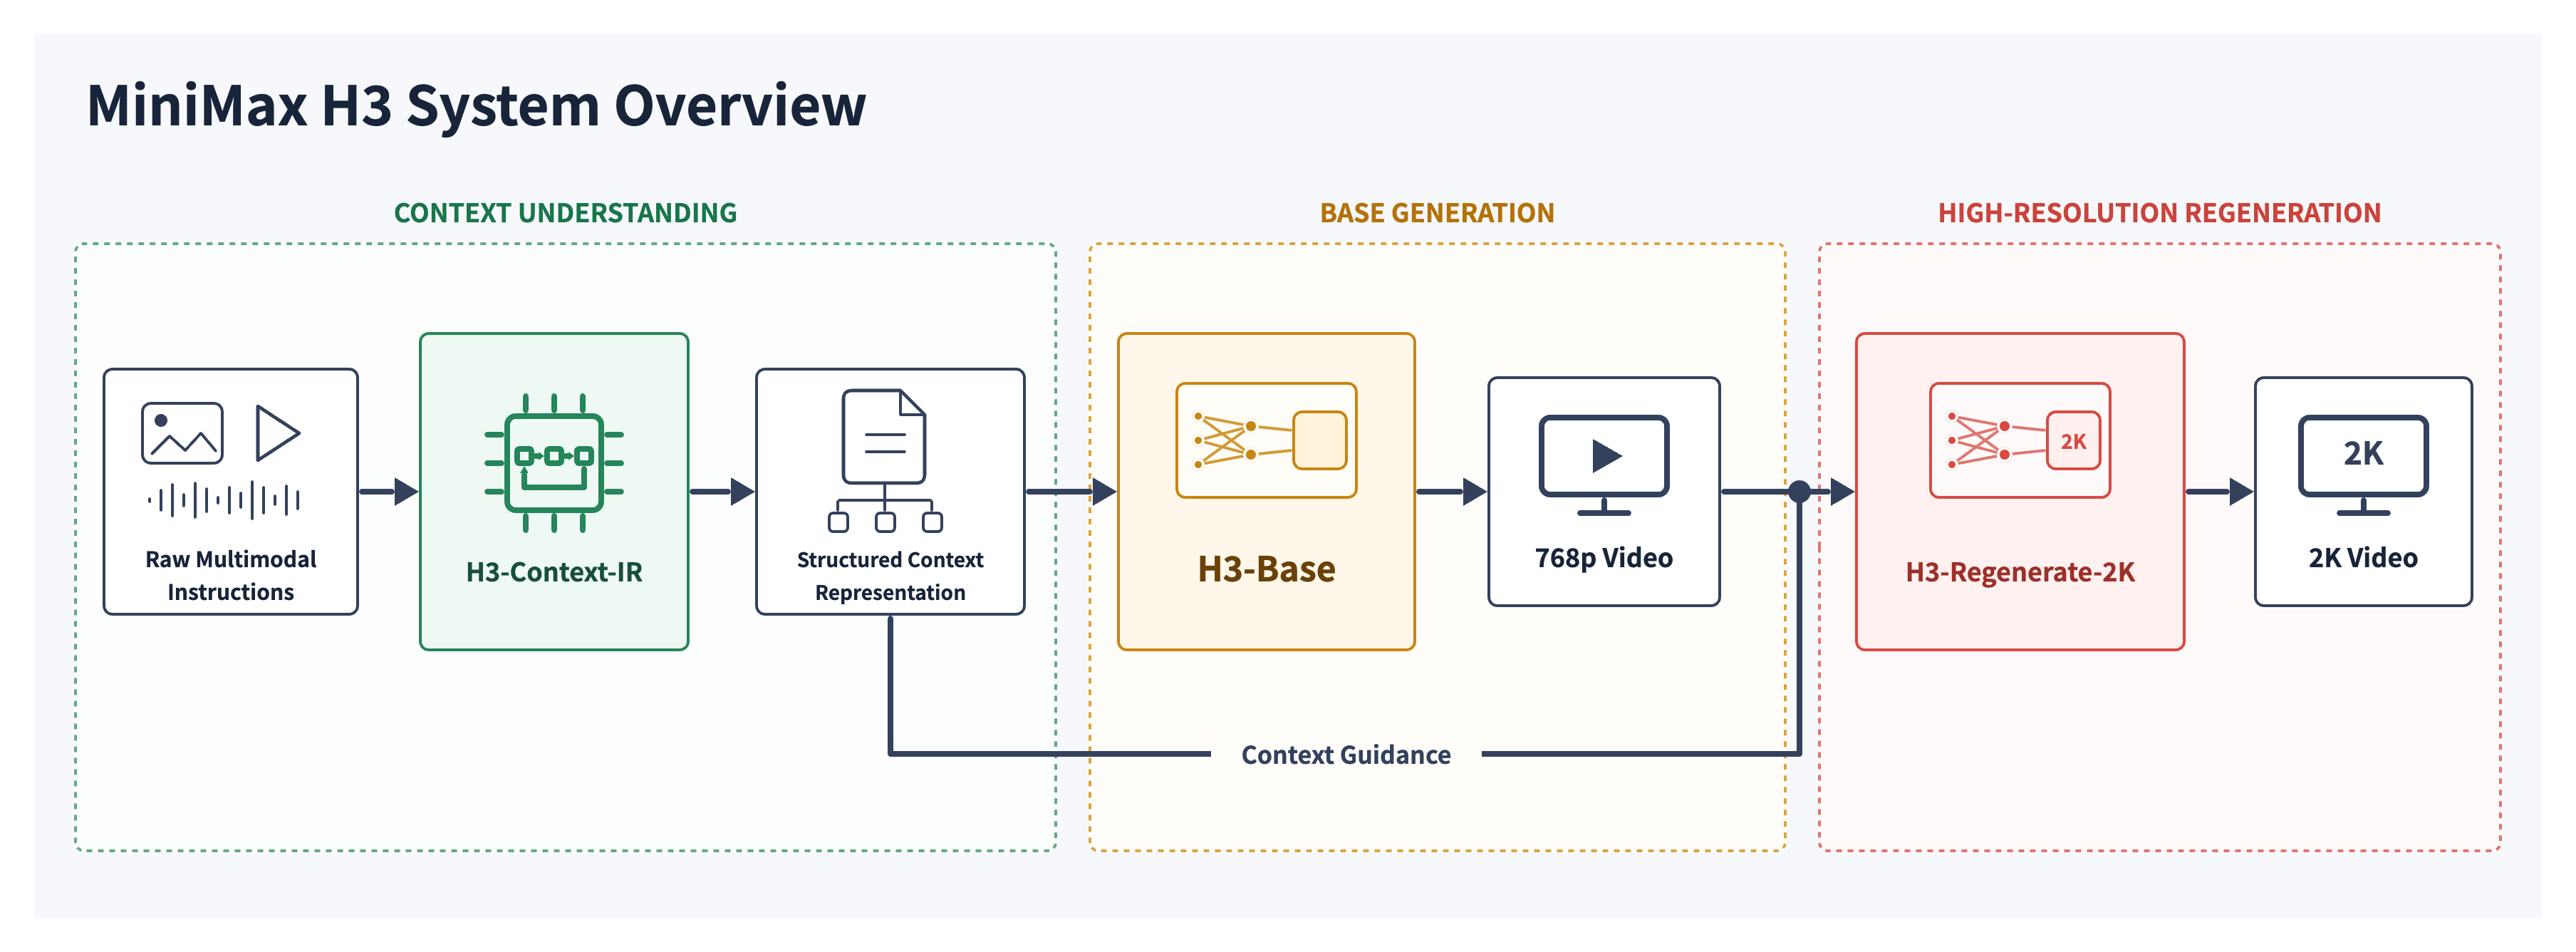
完整的 H3 系统由以下三个模块组成:
- H3-Context-IR:随着输入变得越来越复杂,我们构建了一个专用系统,用于深入理解和细化输入的多模态指令,并将其转换为 H3 易于理解的形式,即用于生成的上下文中间表示。H3-Context-IR 对最终输出质量至关重要,因此我们强烈建议将其纳入你的生成流水线,或按照“提示词指导”构建自己的上下文处理系统。
- H3-Base:基于 H3-Context-IR 的输出生成音频和视频,产出 768p 分辨率结果。
- H3-Regenerate-2K:将 768p 结果与原始上下文一起送回 H3,重新生成 2K 分辨率输出。该过程同时利用 H3 强大的生成能力和原始上下文中的丰富信息,从而生成细节更准确、视觉保真度更高的高分辨率结果。
模型架构
H3-Context-IR
H3-Context-IR 是一个托管式预处理与编排系统,面向自由形式的多模态输入设计。
它会解析文本、图像、音频和参考视频之间的关系,以及这些素材与目标生成结果之间的关系。其内部流程包括指令解析、跨模态关联、时间理解和复杂逻辑推理。
H3-Context-IR 会将其对上下文的理解序列化为 H3-Base 可接受的结构化表示。在不偏离用户原始意图的前提下,它也会在适当情况下补充缺失或描述不足的语义细节。
由于 H3-Context-IR 依赖多阶段工作流以及多个托管模型和服务,本次开源版本不包含该模块。我们提供 API,帮助用户复现官方工作流的行为。我们也提供了详细教程,开发者可以按照 提示词指导 构建自己的预处理系统。
详细使用说明请参阅 推荐工作流 - 完整 2K 工作流。
安全防护机制
用户提交的文本、图像和视频以及增强后的提示词都会经过自动审核。涉嫌违法、色情或侵犯第三方权利的内容可能会被拦截。我们采用行业标准的过滤措施,但无法完全消除误判或漏判。这些防护机制不影响被许可方在 MiniMax H3 Community License 下的义务,尤其是与合法使用和使用限制相关的义务。
H3-Base
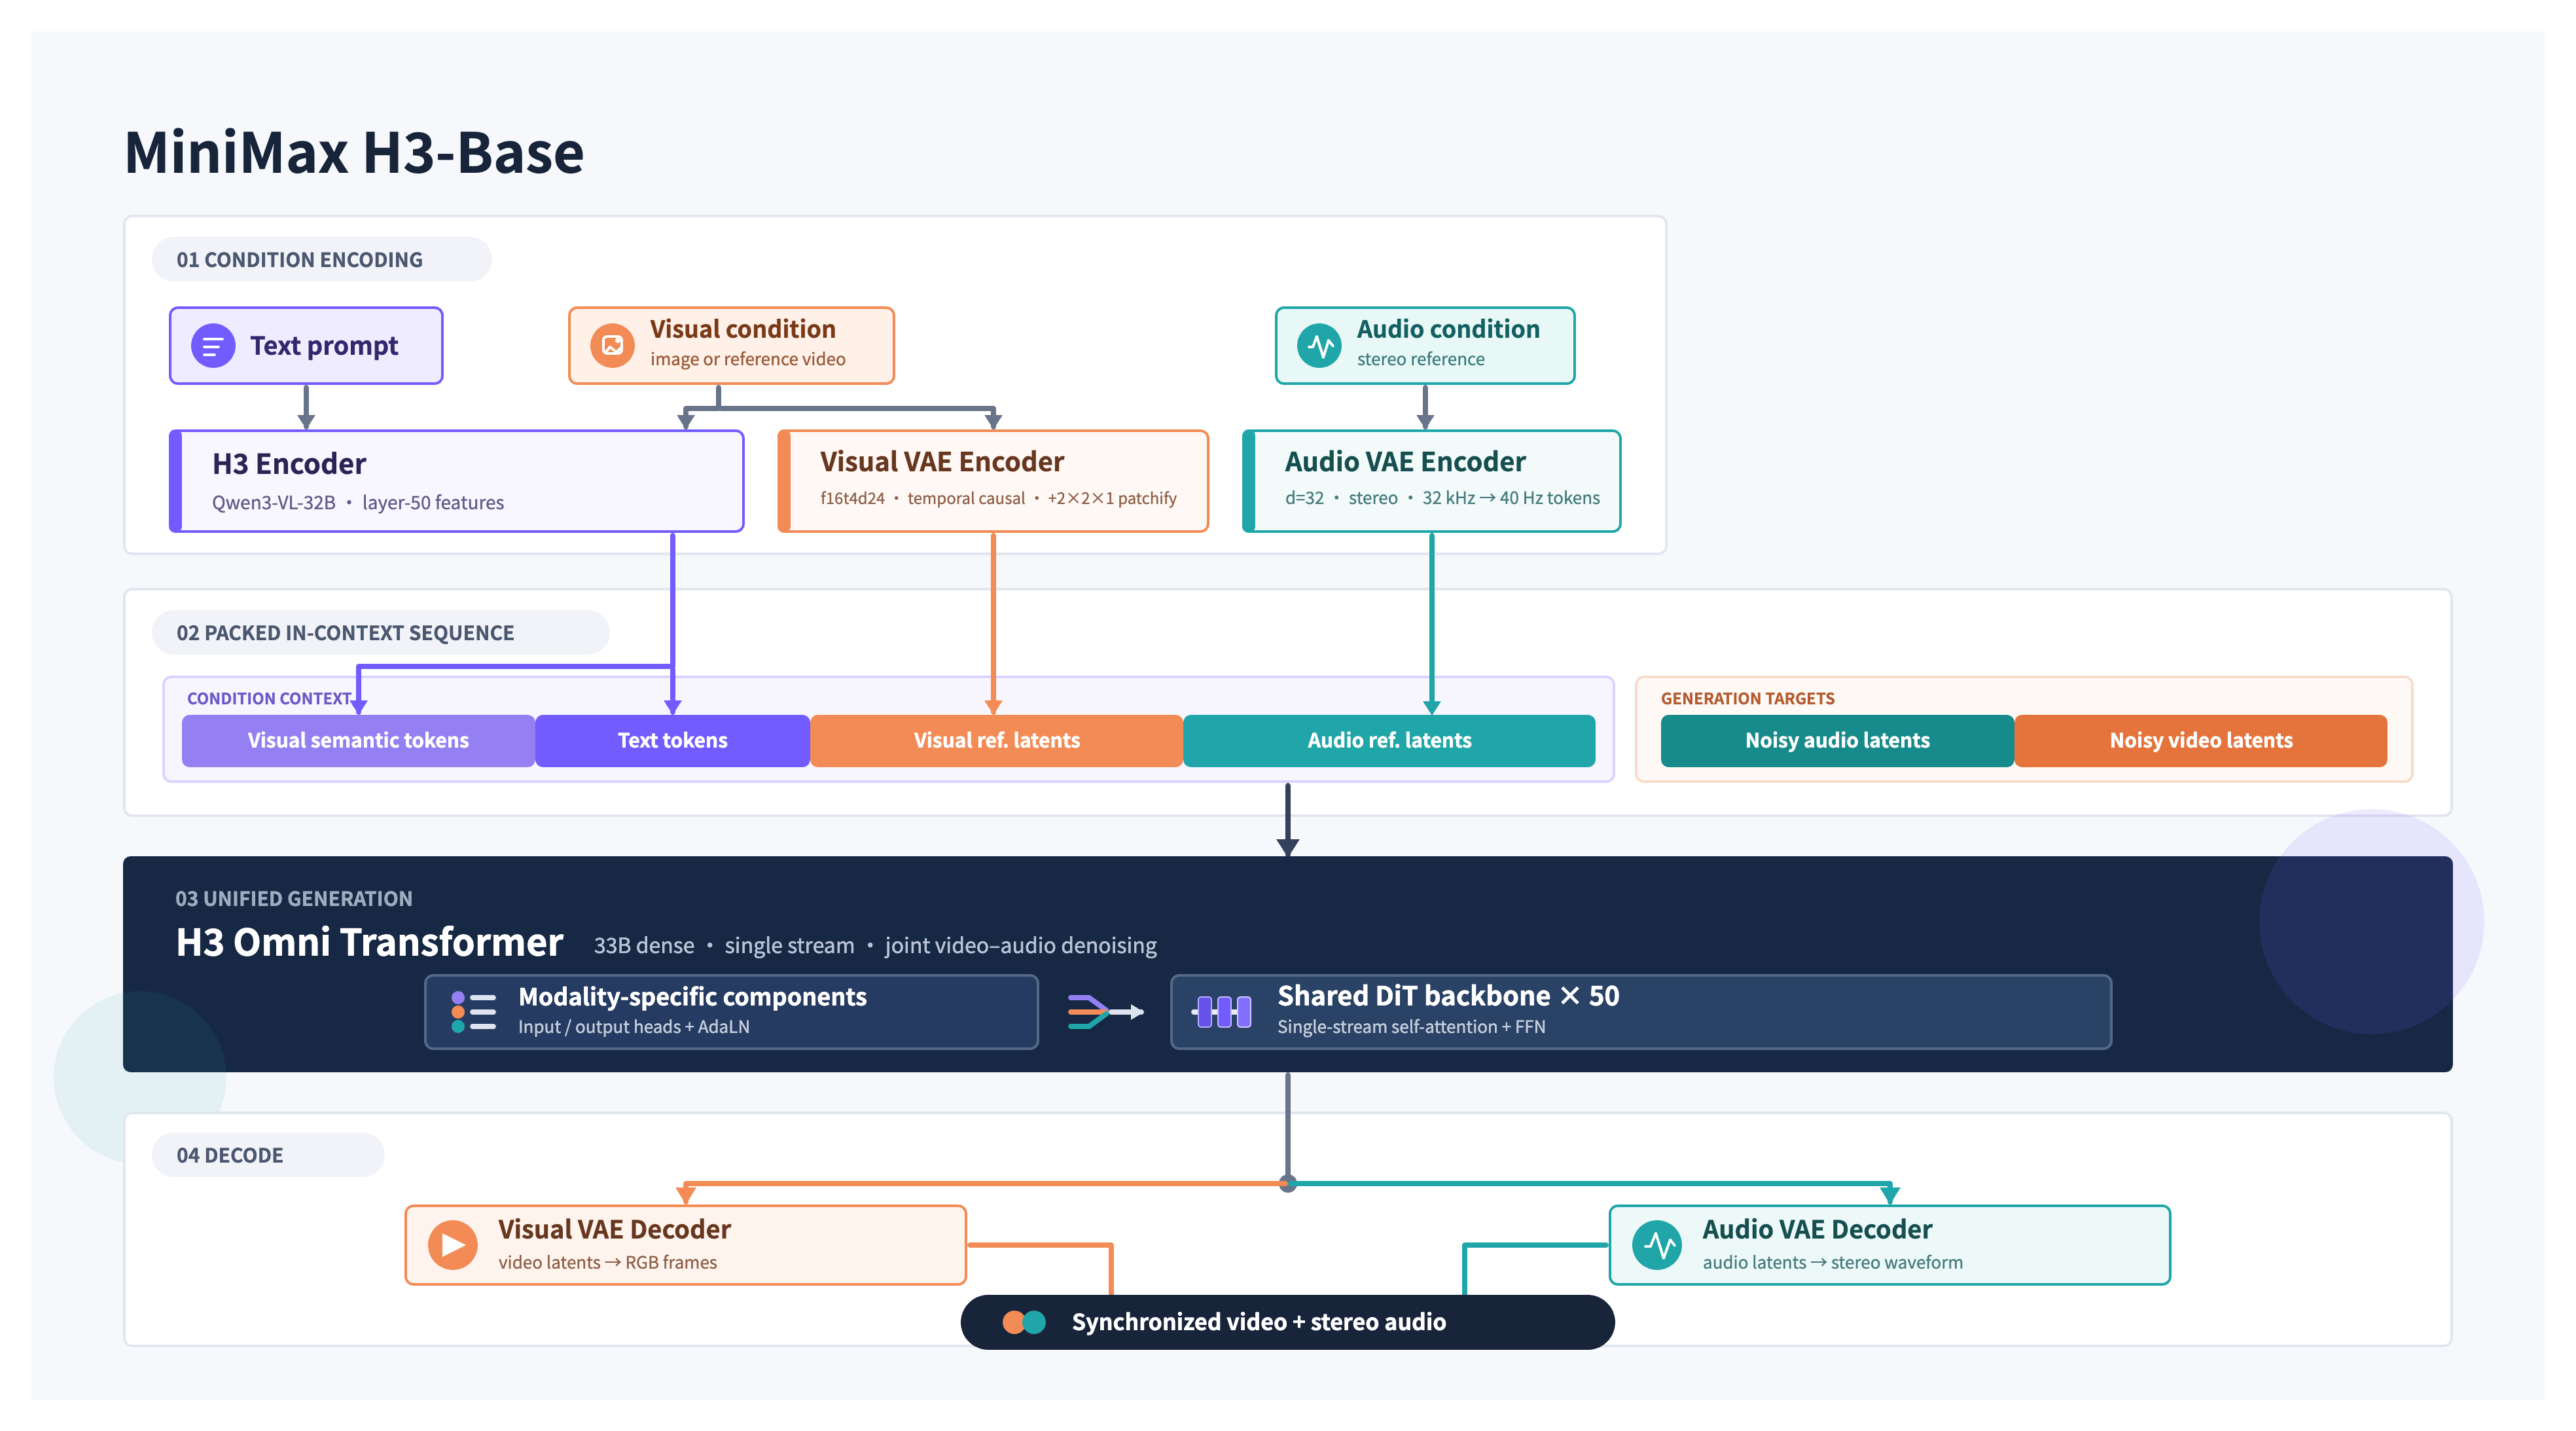
架构概览
H3-Base 使用对应的编码器或 VAE 对不同模态进行编码,并将编码后的表示组织为统一打包的多模态序列。在整个序列输入 H3-Omni-Transformer 之前,系统使用 RoPE 捕获 token 之间必要的空间和时间关系。
具体而言,文本由 H3-Encoder 编码;视觉输入由 H3-Encoder 和 H3-VisualVAE 共同编码;音频仅由 H3-AudioVAE 编码。
H3-Omni-Transformer 联合预测视频和音频 latent,随后分别解码为视频和立体声音频。
为降低长多模态序列的计算成本,H3 原生支持稀疏注意力训练和推理。初始开源版本仅提供全注意力推理。我们的稀疏注意力实现将在后续更新中发布。
H3-Encoder
H3-Encoder 使用 Qwen3-VL-32B 的完整预训练权重,并将其第 50 层的隐藏状态提供给 H3-Omni-Transformer。
我们在 tokenizer 配置中添加了若干特殊 token,例如
<d>。使用 H3 时,需要使用 H3 仓库中提供的 tokenizer 及相关配置文件。
H3-VAE
H3 使用独立的视觉 latent 和音频 latent 来表示各自的模态。
H3-VisualVAE
H3-VisualVAE 是一个时间因果视频自编码器,空间压缩因子为 16×,时间压缩因子为 4×,latent 通道数为 24,记作 f16t4d24。我们应用了多种 latent 空间优化技术,以同时提升重建质量和 latent 可学习性。
在输入 H3-Omni-Transformer 之前,视觉 latent 会沿
(time, height, width)维度以1 × 2 × 2的 patch size 进一步 patchify。因此,进入 Transformer 的视觉 token 具有 32× 的有效空间下采样因子,而时间下采样因子保持为 4×。H3-VisualVAE 的 latent 空间同时针对重建质量和生成模型的学习便利性进行优化。在训练其编码器之后,我们额外训练了一个基于 ViT 的解码器,以降低解码成本并进一步提升重建质量。
H3-AudioVAE
- H3-AudioVAE 对左右声道使用相同的编码器和解码器,同时独立处理每个声道。解码后的声道随后重新合并,从而支持立体声音频输入和输出。
- 对每个声道,H3-AudioVAE 将 32 kHz 音频压缩为时间率为 40 Hz 的 latent token 序列。
- 受 VA-VAE 启发,我们优化 latent 空间,使其在保持音频重建质量的同时更易于生成模型学习。
H3-Omni-Transformer
为了可扩展性和泛化能力,我们采用了相对简洁的 Transformer block 设计。H3-Omni-Transformer 是一个 33B 参数的稠密单流 Transformer,其中约 13B 参数位于 AdaLN 相关分支。由于 AdaLN 调制输出可以预先计算并缓存,纯推理部署时无需加载这些参数。我们发布完整模型权重,以支持包括微调在内的进一步开发。
注意力层和 FFN 层都不包含模态特定结构。模态特定参数仅限于输入/输出层和 AdaLN 分支。尤其是模态特定 AdaLN 能以较低的额外训练和推理成本提升生成质量。
模型使用三维多模态旋转位置编码(MM-RoPE)来表示时间维和两个空间维
(t, h, w)上的位置关系。在训练的最后阶段,我们引入原生稀疏注意力,以降低长序列的计算成本。稀疏注意力实现未包含在初始开源版本中,将在后续更新中单独发布。
H3-Regenerate-2K
对于 H3 的 2K 分辨率输出,我们没有使用传统的专用超分辨率模块,而是让 H3 base model 以 in-context 方式重新生成其低分辨率结果。
这种方法有两个优势:(1)重生成过程可以最大程度复用 H3 base model 的生成能力;(2)in-context 格式在生成高分辨率输出时可以复用原始多模态上下文,从而恢复传统超分辨率方法通常只能“猜测”的信息,例如小文字和精细细节。
In-context 重生成也是任务泛化的一个例子。
由于系统复杂度较高,该模块尚未开源。我们会在准备就绪后发布。 我们提供了用于验证官方结果的 API;请参阅下方“完整 2K 工作流”。
推荐工作流
为了帮助社区正确部署 MiniMax H3,我们提供了两种验证方法。
由于完整的 H3 系统由 H3-Context-IR、H3-Base 和 H3-Regenerate-2K 三个模块组成,“完整 2K 工作流”提供了一个用于 2K 输出的端到端验证流水线,将开放平台 API 与本地部署的 H3-Base 结合使用。“H3-Base 本地部署”部分则提供了仅使用本地部署 H3-Base 验证 768p 输出的方法。
此外,“提示词指导”部分提供了详细教程,帮助社区开发自己的提示词系统。
H3-Base 本地部署
MiniMax H3 以两个任务特定 checkpoint 形式发布。每个 checkpoint 都包含一个专用 Omni Transformer Model,以及所需的 processor、tokenizer、text encoder、Visual VAE 和独立 Audio VAE 组件。
| Checkpoint | 支持任务 | 输入条件 | 输出 | 精度 |
|---|---|---|---|---|
| MiniMax-H3 Base FL2VA | 文生音视频(t2va)、首帧/尾帧生音视频(fl2va) |
文本;可选首帧、尾帧或两者 | 视频和音频 | BF16 |
| MiniMax-H3 Base Ref2VA | 参考输入生音视频(ref2va) |
文本以及参考图像、视频和/或音频 | 视频和音频 | BF16 |
发布的 checkpoint 是经过 CFG 蒸馏的 Omni Transformer 模型权重。
每个 checkpoint 都以自包含的 Hugging Face 风格仓库形式分发,包含以下组件:
<TASK>/
├── model_index.json
├── processor/
├── tokenizer/
├── text_encoder/
├── transformer/
├── visual_vae/
└── audio_vae/
下载模型。仓库同时托管原始 checkpoint(FL2VA/、Ref2VA/)和 diffusers 格式,因此请按你的框架需求限定下载范围:
model_index.json 是仓库级公开入口。特定任务族的 diffusers 索引仍位于 FL2VA/model_index.json 和 Ref2VA/model_index.json。
# Original checkpoint, both task families (SGLang, vLLM):
hf download MiniMaxAI/MiniMax-H3 --include "model_index.json" "FL2VA/*" "Ref2VA/*" --local-dir MiniMax-H3

# Or a single task family:
hf download MiniMaxAI/MiniMax-H3 --include "model_index.json" "FL2VA/*" --local-dir MiniMax-H3
diffusers 用户无需手动下载:ModularPipeline.from_pretrained("MiniMaxAI/MiniMax-H3") 会准确拉取所需组件。加载方法请参阅 diffusers documentation。
我们推荐使用以下推理框架来服务模型:
vLLM - see vllm recipes
diffusers - see diffusers docs
ComfyUI - see Comfy tutorial; use R2V template / T2V template
Sglang 部署
这里以 sglang 作为部署示例。更多部署配置请参阅 MiniMax-H3 deployment guide。
FL2VA:
sglang serve \
  --model-path MiniMaxAI/MiniMax-H3 \
  --num-gpus 4 \
  --ulysses-degree 4 \
  --performance-mode speed \
  --host 0.0.0.0 \
  --port 30010 \
  --model-variant fl2va
Ref2VA:
sglang serve \
  --model-path MiniMaxAI/MiniMax-H3 \
  --num-gpus 4 \
  --ulysses-degree 4 \
  --performance-mode speed \
  --host 0.0.0.0 \
  --port 30011 \
  --model-variant ref2va
可复现的 768p 示例
以下三个用例 T2VA、FL2VA 和 Ref2VA 展示了如何复现 MiniMax-H3 音视频生成。
| 用例 | 请求 | 结果 |
|---|---|---|
| T2VA | 查看脚本 | t2va.mp4 |
| FL2VA | 查看脚本 | fl2va.mp4 |
| Ref2VA | 查看脚本 | ref2va.mp4 |
完整 2K 工作流
本节说明如何将本地部署的 SGLang 服务与官方 H3-Context-IR 和 H3-Regenerate-2K API 结合使用,以复现直接通过 MiniMax API 生成的 2K 视频质量。 开始之前,请配置 SGLang endpoint 和 MiniMax API 凭证:
# URL of your SGLang deployment
SGLANG_DEPLOYMENT_URL="<sglang-deployment-url>"

# MiniMax API endpoint (choose one)
# CN
MINIMAX_API_BASE="https://api.minimaxi.com"
# Global
# MINIMAX_API_BASE="https://api.minimax.io"

# API token obtained from the MiniMax platform
TOKEN="<token>"
MiniMax 平台:
API 文档:
- 创建 H3-2K:使用 /video-generation-v2-create EN-docs,CN-docs
- H3-Context-IR:使用 /video-generation-v2-h3-context-ir EN-docs,CN-docs
- H3-Regenerate-2K:使用 /video-generation-v2-regeneration EN-docs,CN-docs
以下示例会将本地 H3-Base 输出文件编码为 Base64 Data URL。生产环境建议将视频上传到可公开访问的 URL,并将该 URL 作为 base_video 传入。
对于下方每个案例,我们都提供了直接通过开放平台 API 生成的 2K 和 768p 参考输出,便于验证结果。
case-T2VA
- 类型:文生视频
- 时长:10 秒
- 宽高比:16:9
| 阶段 | 请求 | 结果 |
|---|---|---|
| H3-Context-IR | 查看脚本 | |
| H3-Base | 查看脚本 | t2va.mp4 |
| H3-Regenerate-2K | 查看脚本 | t2va_2k.mp4 |
| 直接调用开放平台 API 的 2K 参考结果 | 查看脚本 | h3_direct_2k.mp4 |
| 直接调用开放平台 API 的 768P 参考结果 | 查看脚本 | h3_direct_768p.mp4 |
case-I2VA
- 类型:首帧图生视频
- 时长:8 秒
- 宽高比:自适应
| 阶段 | 请求 | 结果 |
|---|---|---|
| H3-Context-IR | 查看脚本 | |
| H3-Base | 查看脚本 | i2va.mp4 |
| H3-Regenerate-2K | 查看脚本 | i2va_2k.mp4 |
| 直接调用开放平台 API 的 2K 参考结果 | 查看脚本 | i2va_direct_2k.mp4 |
| 直接调用开放平台 API 的 768P 参考结果 | 查看脚本 | i2va_direct_768p.mp4 |
case-Ref2VA
- 类型:多模态参考生视频(视频 + 音频)
- 时长:5 秒
- 宽高比:自适应
| 阶段 | 请求 | 结果 |
|---|---|---|
| H3-Context-IR | 查看脚本 | |
| H3-Base | 查看脚本 | r2va.mp4 |
| 直接调用开放平台 API 的 2K 参考结果 | 查看脚本 | r2va_2k.mp4 |
| 开放平台中的 H3 API 2K 参考结果 | 查看脚本 | r2va_direct_2k.mp4 |
| 直接调用开放平台 API 的 768P 参考结果 | 查看脚本 | r2va_direct_768p.mp4 |
提示词指导
为保持 Markdown 布局简洁,Hugging Face 发布中的提示词指导文档未复制到本仓库。
许可证
MiniMax H3 基于 MiniMax H3 Community License Agreement 发布。
联系我们
请通过 [email protected] 联系我们。