
Lyfxxk/Opengrep-Studio
Lyfxxk/Opengrep-Studio has 52 GitHub stars and 1 forks. GitHot measured 0 stars in 24 hours and 0 in 7 days. Last checked 2026-11-13 10:49 UTC. Last push 2026-11-02.
实测星标增长
- 24小时
- 0
- 7天
- 0
- 15天
- 正在收集历史
- 1个月
- 正在收集历史
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
关于
Local-first code audit workbench for Opengrep. Scan locally, track findings across versions, verify fixes, and produce reproducible security audit reports.
安全docs/README.zh-Hans.md
原文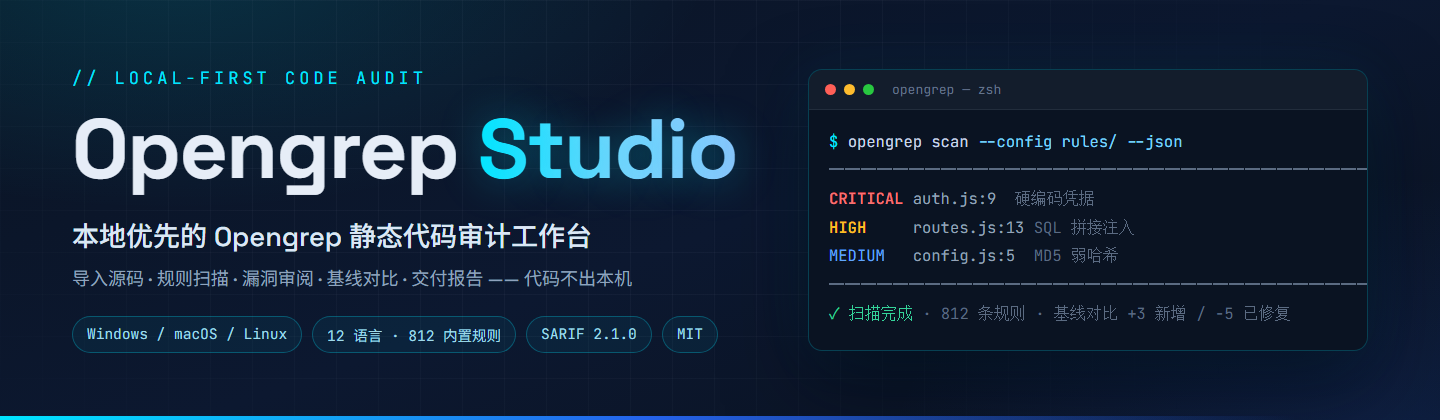
Opengrep Studio · 码审工作台
让隐患,先于攻击者现形。
本地优先的 Opengrep 静态代码审计工作台——上传源码、规则扫描、逐条审阅、基线对比、交付报告,代码不出本机。
English · 繁體中文 · 快速开始 · 功能亮点 · 安全模型 · 常见问题



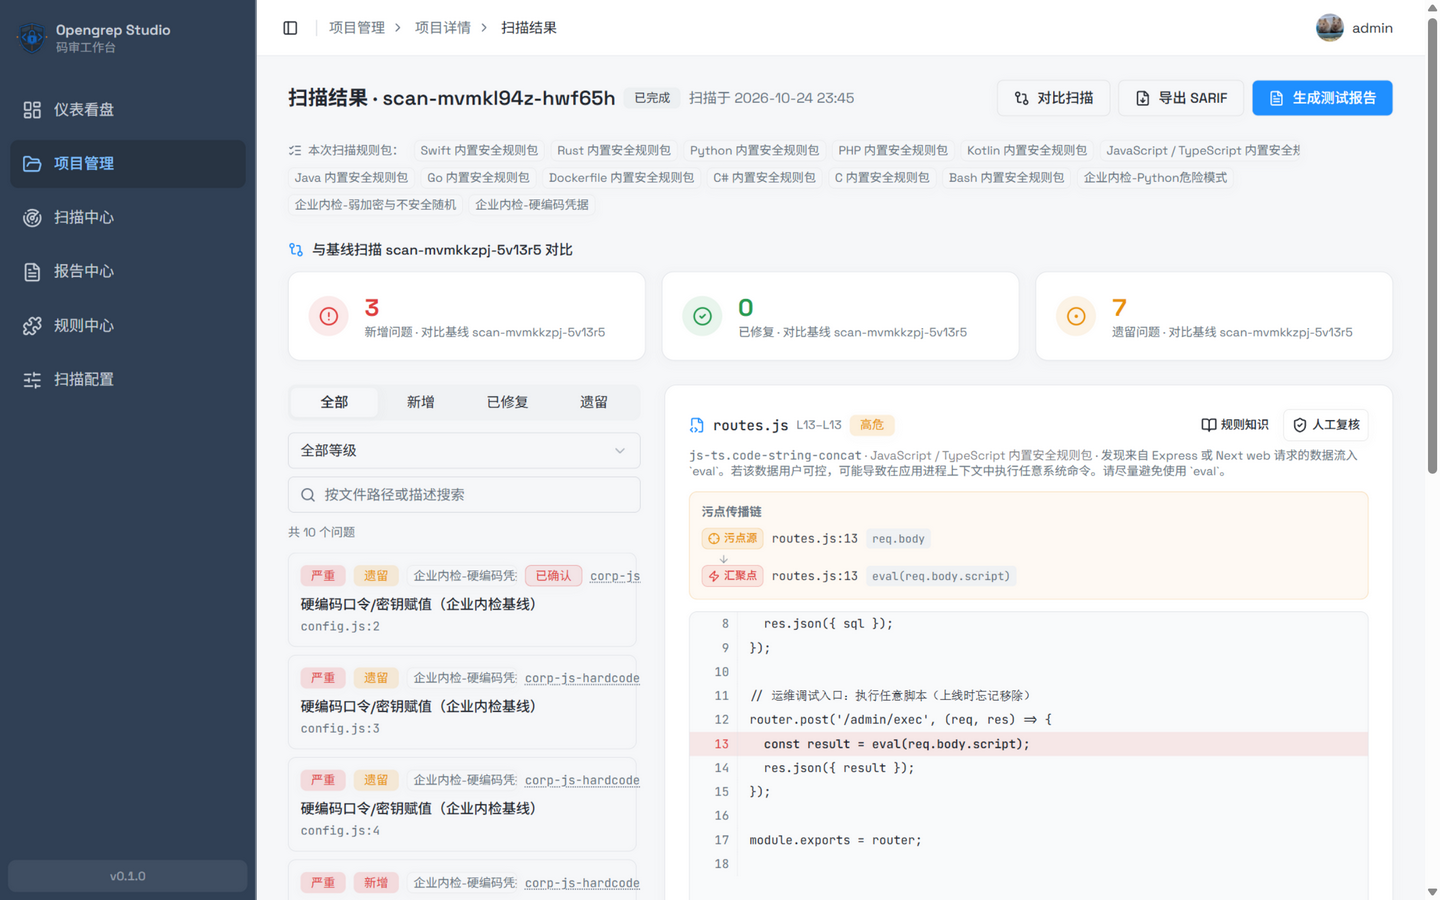
扫描结果审阅页:基线三卡(新增 / 已修复 / 遗留)· 污点传播链(源 → 传播 → 汇聚点)· 命中代码高亮 · 人工复核标记
为什么需要 Opengrep Studio
每个项目里都可能埋着几颗雷:写死在代码里的数据库密码、直接拼进 SQL 的用户输入、忘了删的调试接口、还在用 MD5 存的密码。静态代码扫描做的事,就是不上传代码、不运行程序,把这类问题提前标出来。
先说 AI:读得懂,但兜不住
必须承认,AI 读代码有两把刷子——业务逻辑漏洞、越权风险、规则没覆盖的新颖写法,它都能看懂意图。但拿「AI 聊天」当「代码审计」,会撞上四堵墙:
- AI 是抽样,审计要穷举——十万行的项目上下文装不下;47 处 SQL 拼接,它可能点出 5 处「显眼的」,剩下 42 处你根本不知道它没看到。规则引擎的承诺是「每一条命中都会报出来」,扫完你才敢在结论里写下「这 812 条规则覆盖的问题模式,全部查过」;
- 聊天是一次性的,审计要有台账——AI 不记得上个月读过什么:哪些是这次新引入的、哪些真修掉了、你之前判定过的误报,统统从头再来;
- 「AI 说的」不能当证据——交付客户要的是可复现:源码哈希、引擎版本、完整命令行,别人拿着就能跑出同样的结果;一段聊天记录既不能复核,也不能归责;
- 按提交频率跑不起——通读一遍全库是真金白银的 token,项目越大越贵、漏得越多;本地引擎秒级到分钟级、零边际成本,才接得进 CI。
再说引擎:扫得全,但命令行做不完审计
所以答案不是二选一:规则引擎负责穷举兜底,AI 负责语义理解——Semgrep 官方做 AI 辅助、各家 SAST 接大模型,走的都是这条路。Opengrep Studio 选用的 opengrep(社区从 Semgrep OSS 延续的开源扫描引擎)扫得很专业,但直接用它的命令行做完一次完整审计,依然是四道坎:
- 扫完只是一堆 JSON——命中了哪些问题、有多严重,全靠肉眼翻终端输出,没有逐条审阅的工作台;
- 规则消息是英文的——像 "tainted data flowing into eval" 这样的提示,不是每个人都能立刻看懂问题在哪、该怎么改;
- 修复了不知道修没修好——改完代码重扫一次,哪些是新冒出来的、哪些真的修掉了,全靠手工比对两份 JSON;
- 给管理者和客户交不了差——风险报告要从 JSON 里一条条手工拼,格式还不专业。
Studio 补齐的,是扫描之后的整条流水线
Opengrep Studio 把这条流水线补齐:拖进代码 → 点一下扫描 → 逐条审阅 → 一键出报告。扫描引擎在本地运行,代码从头到尾不出你的机器;引擎能力归功上游,Studio 专注于把结果变成可审阅、可对比、可复核、可交付的审计工作流。AI 时代,这套工作流反而更稀缺:AI 一次吐给你一大堆发现,去重、定基线、跨扫描追踪、出报告,总要有个地方接——AI 负责产点,Studio 负责管点。
这个工具适合谁
- 接代码审计活的安服工程师 / 独立顾问——客户代码不能传第三方云平台,也不该贴给在线 AI;交付时需要一份可复现的中文测试报告;
- 没有商业 SAST 预算的小团队——商业代码审计平台一年动辄十几万,这里是免费开源(MIT)+ 本地部署;
- 正在学应用安全的人——812 条规则全量中文消息 + CWE 中文修复建议 + 污点传播链可视化,规则实验室即写即验证;
- 开源作者——项目发布前扫一遍硬编码密钥、危险函数调用,几分钟的事。
功能亮点
🗂 多源导入,代码不经云端
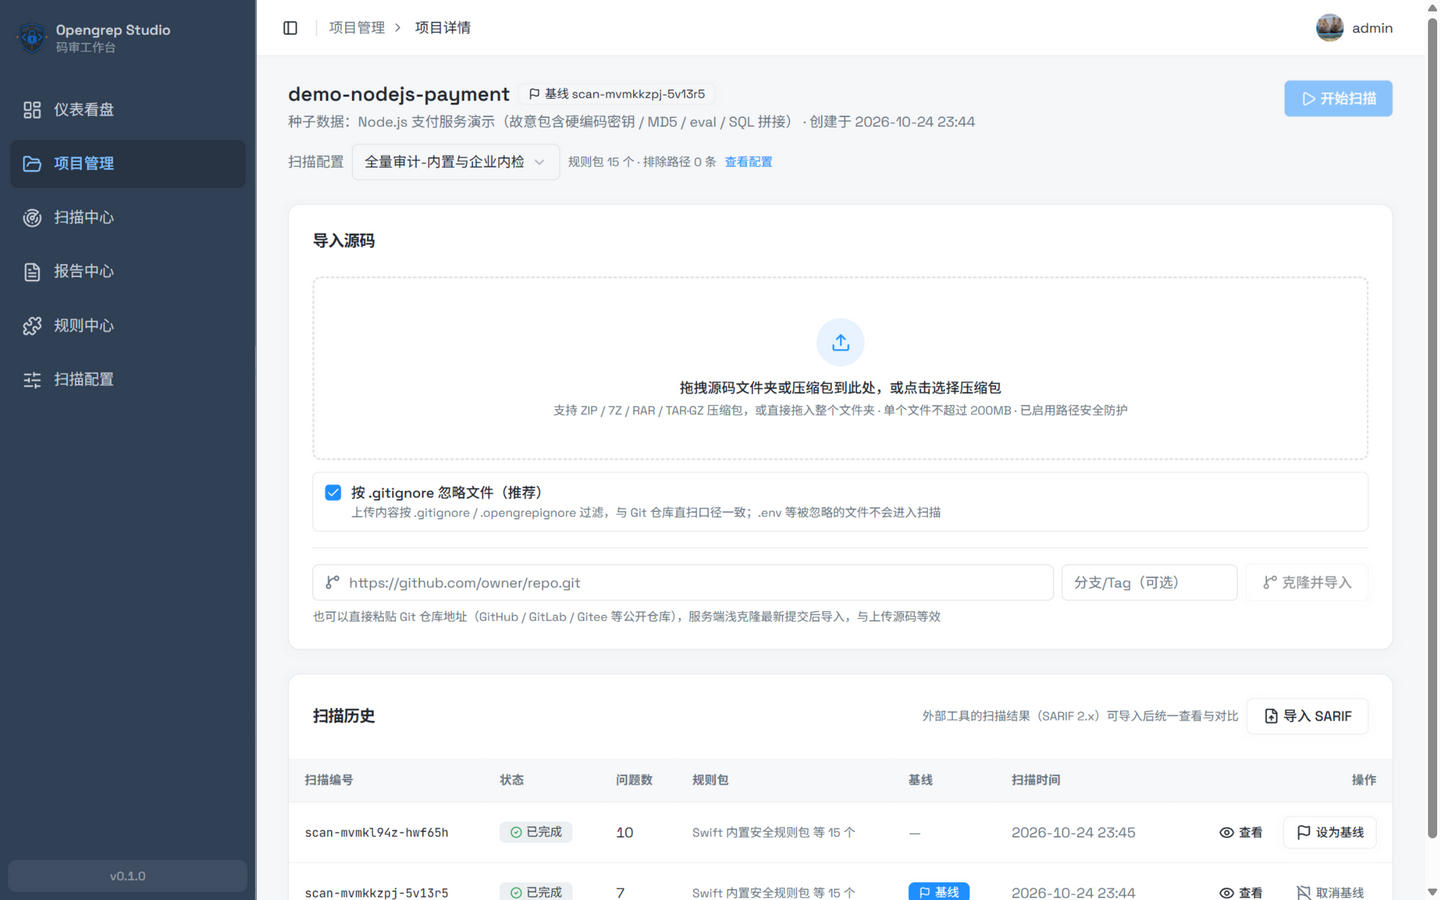
拖拽整个文件夹、上传 ZIP / 7Z / RAR / TAR.GZ 压缩包,或粘贴 Git 仓库地址浅克隆导入(默认遵循 .gitignore / .opengrepignore 口径,也可关掉以深挖 .env 里的硬编码密钥)。上传后自动统计语言构成。
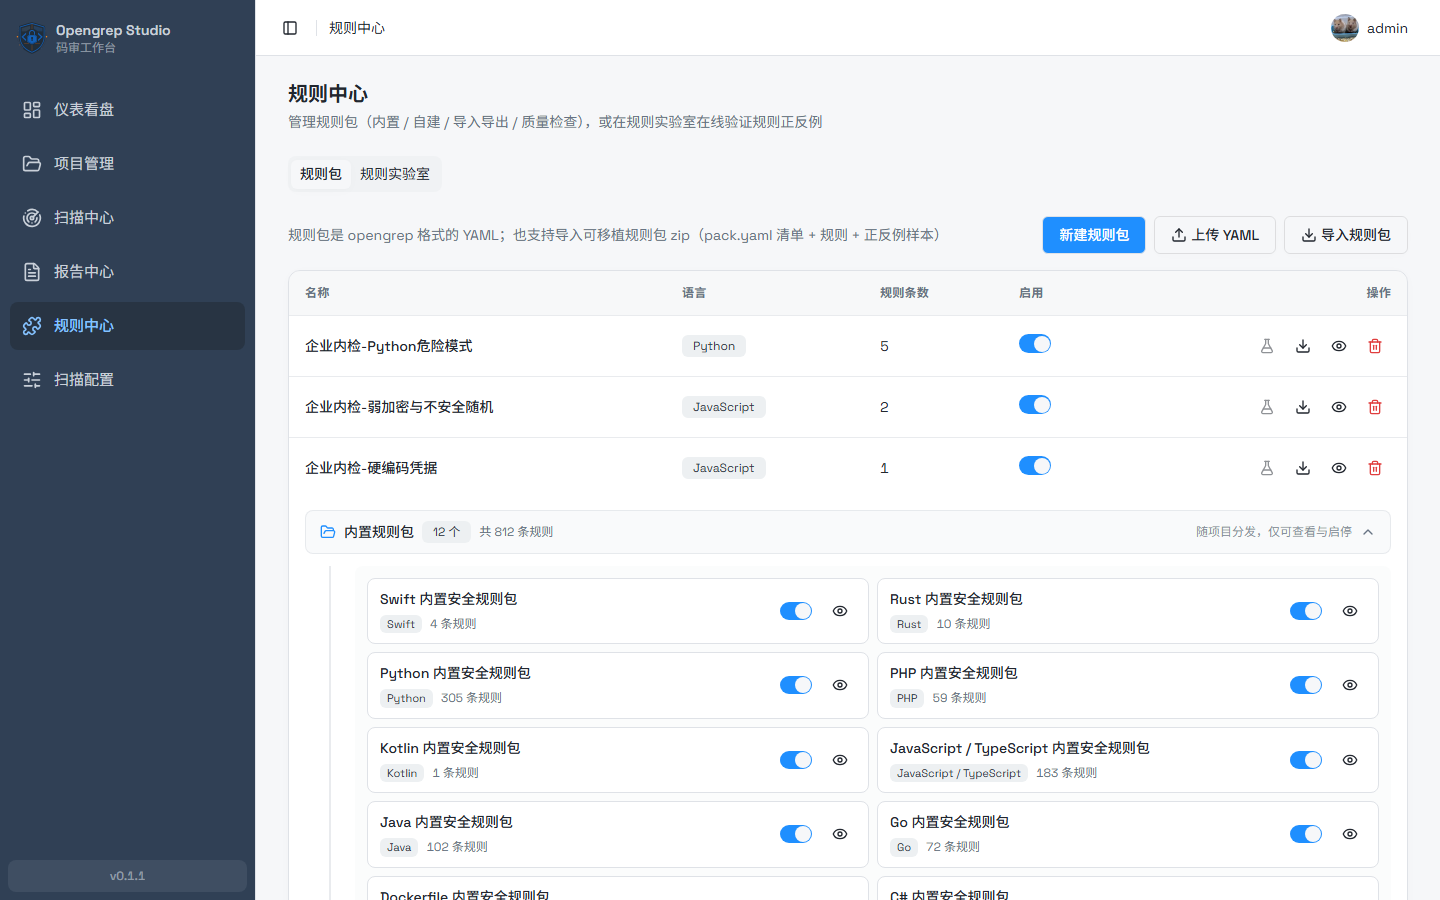
📚 812 条内置规则,12 种语言,全量中文消息
精选自 opengrep-rules(优先收录带 CWE / OWASP 元数据的规则,每条保留上游溯源链接),覆盖 108 种 CWE;812 条规则消息 100% 提供中文翻译,另附 108 类 CWE 中文弱点说明与修复建议。自建规则包支持在线编辑、导入导出与质量检查。
🔍 逐条审阅:代码定位、污点链路、人工复核
每条问题直达文件与行号,命中行红色高亮;污点类问题展示「污点源 → 传播路径 → 汇聚点」链路;人工复核结论(已确认 / 误报 / 已接受)按问题指纹跨扫描继承,构成审计证据链。
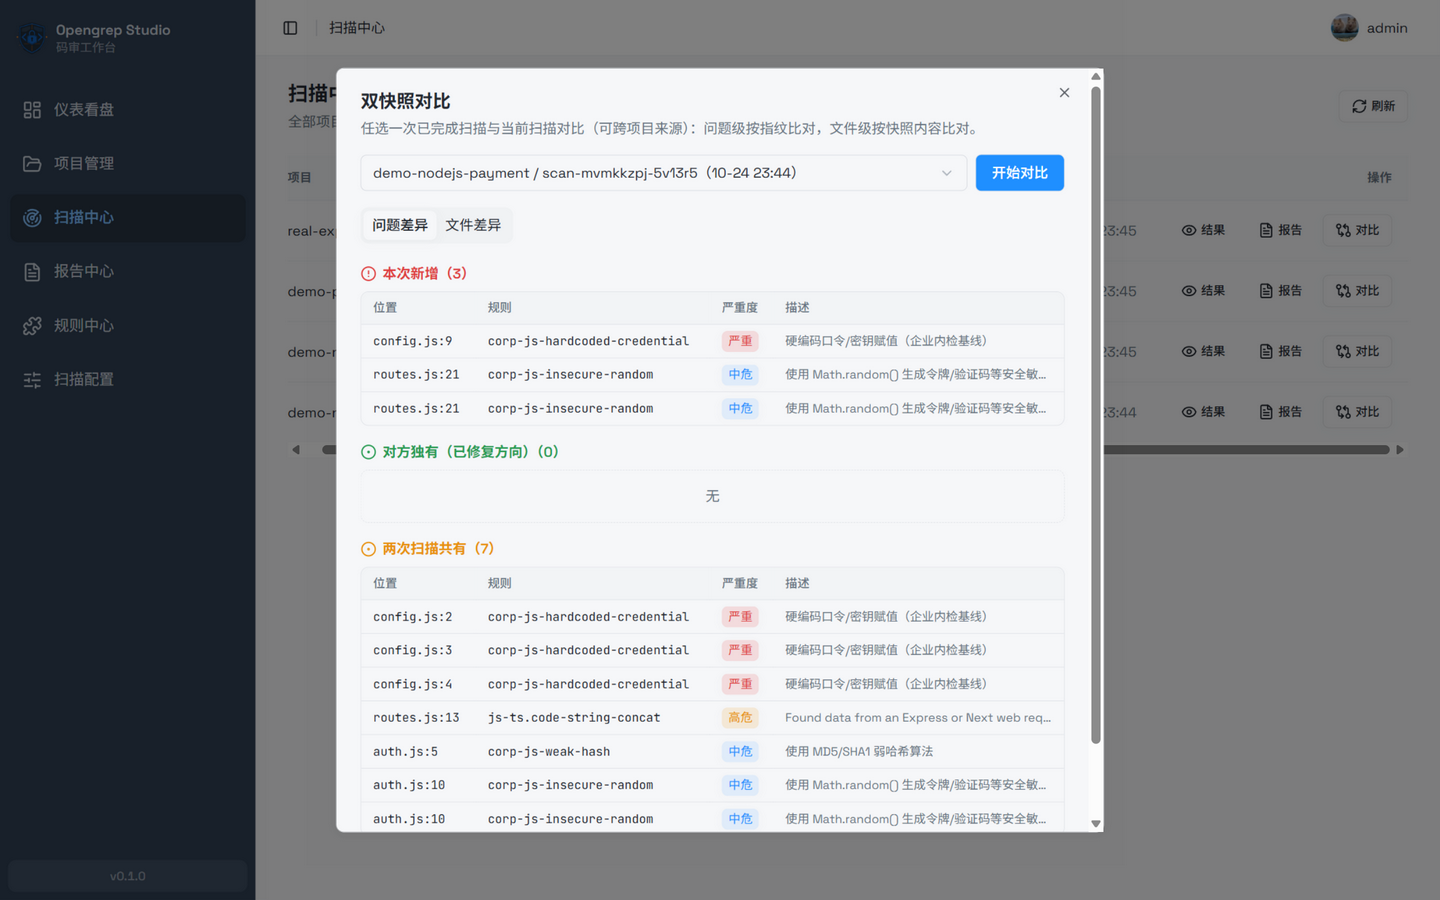
📊 基线对比与双快照对比
设定基线扫描后,每次扫描自动给出 新增 / 已修复 / 遗留 三分类;扫描中心还支持任选两次已完成扫描做双快照对比(可跨项目):问题级按指纹比对,文件级按源码快照内容比对。
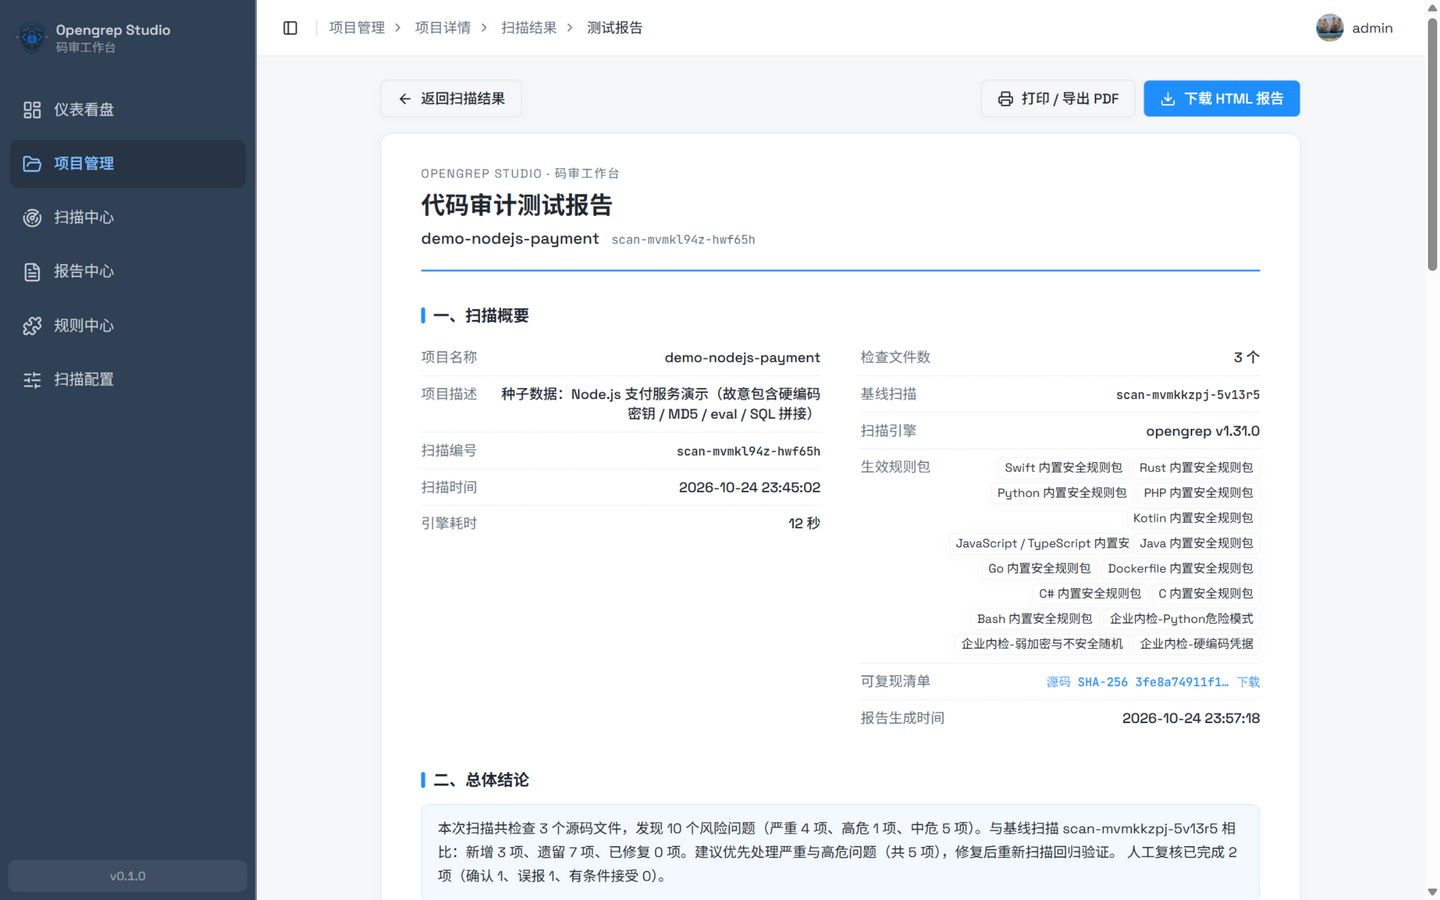
📄 可打印的审计报告 + 可复现清单
一键生成纸感排版的《代码审计测试报告》:总体结论、风险分布、高频规则、热点文件、问题明细、复核统计,支持直接打印为 PDF 或下载单文件离线 HTML;每份报告附带可复现清单(源码 SHA-256、完整引擎命令行、规则文件哈希)。
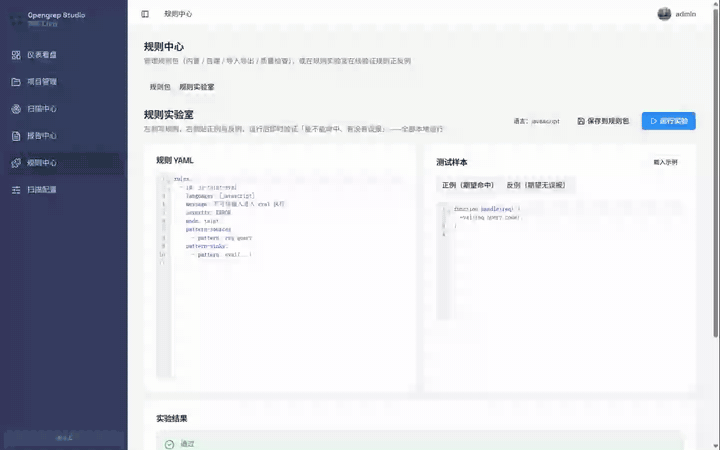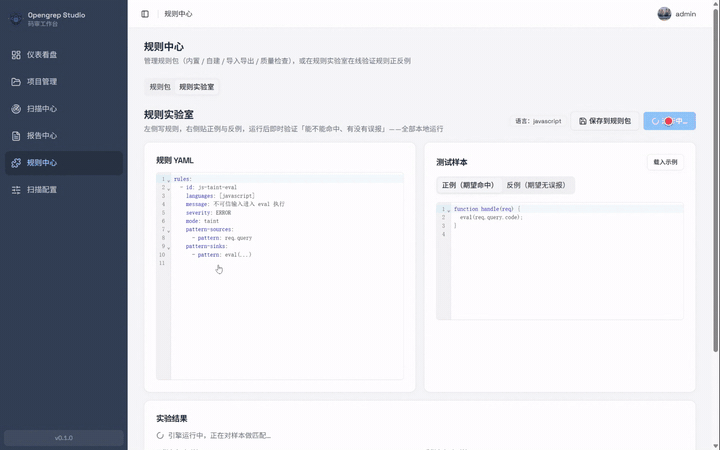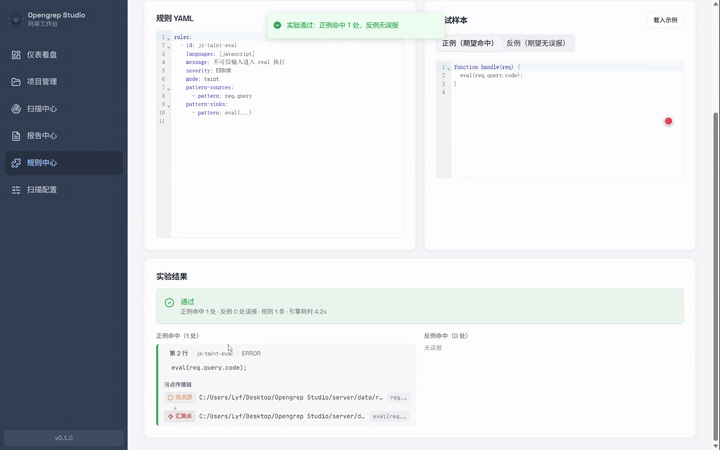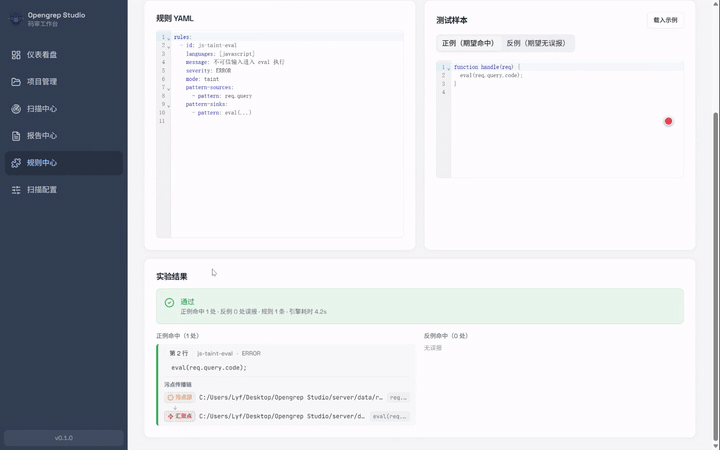
🧪 规则实验室:先验证,再入库
左侧写规则 YAML,右侧贴正例与反例,一键运行真实引擎验证「能不能命中、有没有误报」;调通的规则连同样本保存为便携规则包,后续可一键回归检查。草稿自动保存,Ctrl+Enter 运行。
🔁 SARIF 双向互通
导出 SARIF 2.1.0 供 GitHub Code Scanning / DefectDojo / SonarQube 消费;也可把其他工具产出的 SARIF 2.x 导入为一次完整扫描,纳入基线与报告体系。
🖥 仪表看盘
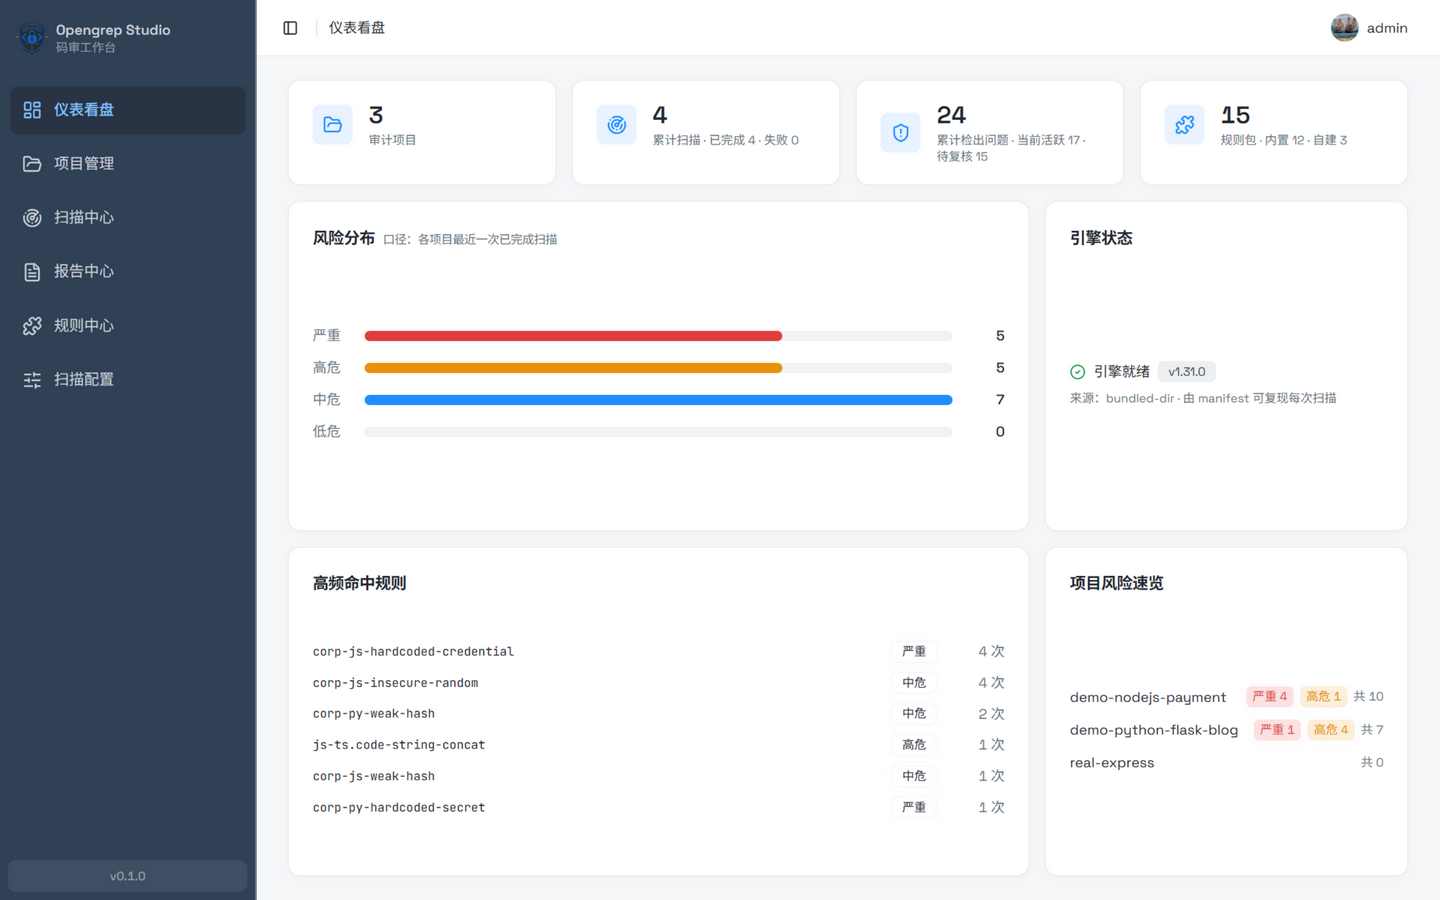
项目数、累计扫描、检出问题、规则包一目了然;跨项目的风险分布、高频命中规则、引擎状态与各项目风险速览,扫描进行中自动刷新。
⬆️ 引擎检查更新与一键升级
仪表盘的「引擎状态」卡片会显示实际安装的版本与来源,点「检查更新」比对上游最新 stable,发现新版本可一键升级:
- 升级是原子替换:下载 → SHA-256(GitHub release 资产的 digest)校验 → 运行
opengrep --version核对 → 才替换文件,任一步失败旧引擎原封不动 - 只对最新 stable 开放(不碰 pre-release);
OPENGREP_BIN自管引擎的用户按钮置灰 - 扫描 / 规则实验室运行期间禁用升级(Windows 不允许替换运行中的 exe),升级后版本探测缓存自动失效
- 实际安装版本记录在
opengrep-tool/installed.json,重跑npm run setup:engine不会把升级过的引擎降级回engines.json的钉住版本
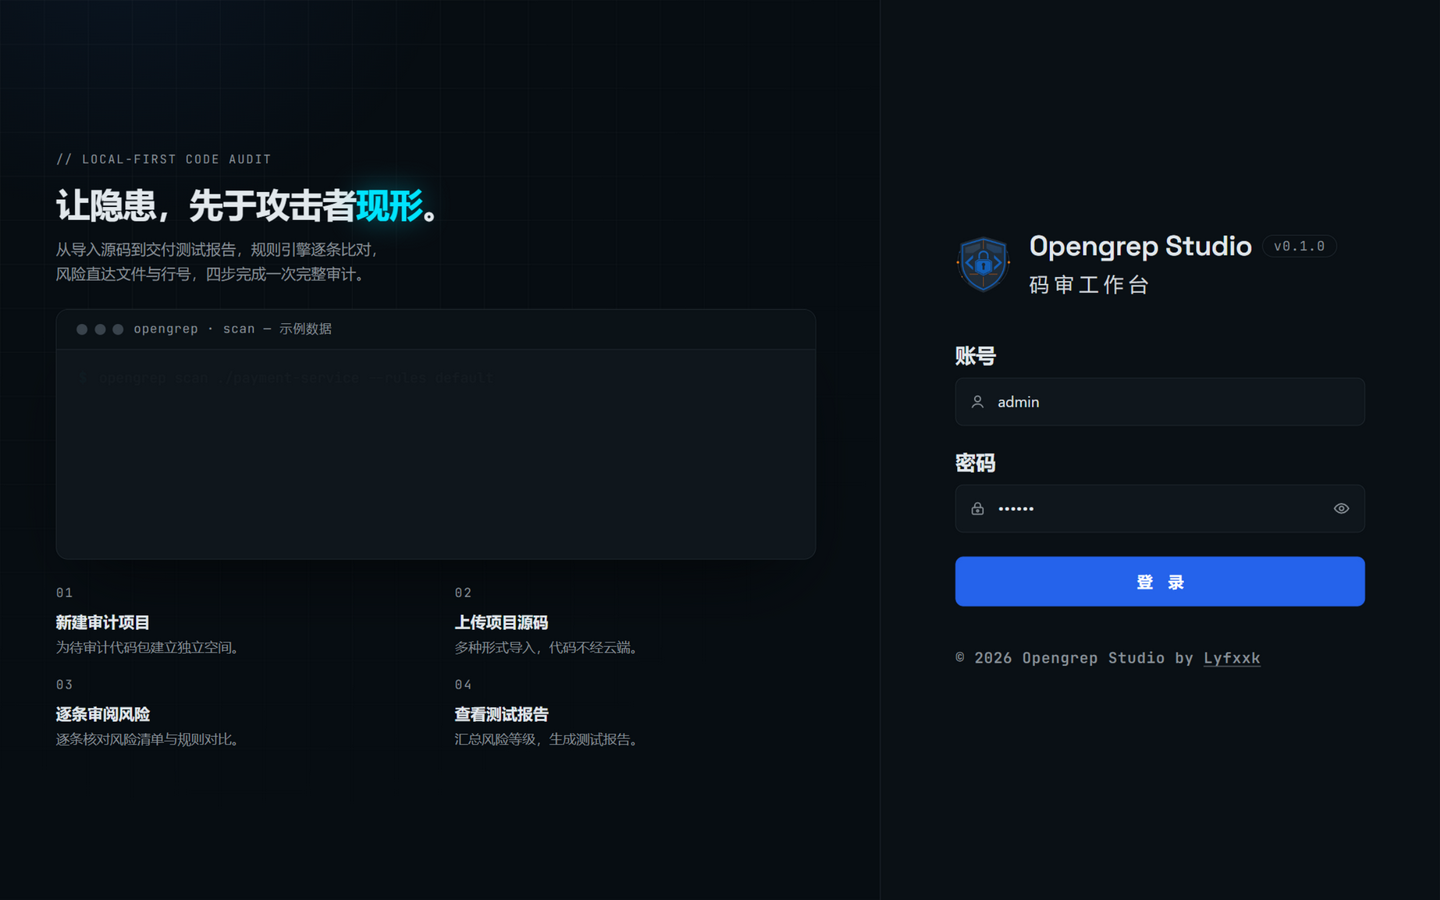
界面一览(登录页与仪表盘)
 |
 |
快速开始
环境要求
- Node.js ≥ 22.12(后端内置
node:sqlite需 22.5+,前端 Vite 8 需 22.12+;同样无原生依赖) - 扫描引擎由脚本自动下载(约 50 MB,SHA-256 校验),无需预装;Git 仅在使用仓库克隆导入时需要
方式一:一键启动(推荐)
Windows 用户双击 一键启动(Windows).bat,macOS / Linux 用户执行:
./一键启动(macOS/Linux).sh
脚本会自动检查 Node 版本、安装依赖、下载引擎,并打开浏览器。前端 http://localhost:1022,后端 API http://localhost:8787。
方式二:手动三步
git clone https://github.com/Lyfxxk/Opengrep-Studio.git
cd Opengrep-Studio
npm run install:all   # 安装根目录 / server / code 三处依赖
npm run setup:engine  # 下载 opengrep v1.33.1 并校验 SHA-256
npm run dev           # 同时启动后端(8787)与前端(1022)
方式三:Docker
npm run docker:build
npm run docker:run    # 等价于 docker run --rm -p 8787:8787 -v ogstudio-data:/data opengrep-studio
镜像内置引擎与已构建前端,访问 http://localhost:8787 即可使用,数据持久化在 ogstudio-data 卷。
注意:容器内「一键升级」写入的是容器可写层(/app/opengrep-tool),容器重启后仍在,但重建容器(如 docker compose down && up)后会丢失并回落到 engines.json 钉住的版本;长期更换引擎版本请修改 server/scripts/engines.json 后重新构建镜像。
首次使用
默认账号 admin / 123456(见安全模型)。建议流程:
- 扫描配置——勾选要启用的规则包(可加排除 / 包含路径、引擎参数)
- 新建项目并绑定该配置——也可以先不绑:未绑定或绑定的配置被删时,扫描会自动改用不可删除的「默认扫描配置」兜底
- 导入源码(拖文件夹 / 压缩包 / Git 克隆)
- 发起扫描,完成后逐条审阅、复核
- 设基线、再扫描,看 新增 / 已修复 / 遗留;需要交付时生成测试报告
想先看效果?npm run seed 可一键灌入三个演示项目(含基线对比与复核记录)。
故障排查
- 引擎下载慢或失败:下载会自动按
OPENGREP_DOWNLOAD_BASE 镜像 → github.com → api.github.com依次降级,github.com 不可达时通常无需干预即可装完;仍失败时可手动设置镜像set OPENGREP_DOWNLOAD_BASE=<镜像地址>(macOS/Linux 用export),或从 opengrep Releases 手动下载后用OPENGREP_BIN指向二进制路径 - 检查更新提示 GitHub API 限流:匿名调用上限 60 次/小时,检查结果缓存 30 分钟;稍后再试即可,不影响扫描
- macOS 提示无法验证引擎:
xattr -d com.apple.quarantine <引擎路径> - 端口被占用:
node server/scripts/kill-port.mjs 8787 1022 - 更多环境变量:
PORT/HOST/DATA_DIR/CUSTOM_RULES_DIR/OPENGREP_BIN/OPENGREP_DOWNLOAD_BASE(后端);超时类变量取值单位为秒:CLONE_TIMEOUT_SECONDS/SEVEN_Z_TIMEOUT_SECONDS/RULE_LAB_TIMEOUT_SECONDS;前端开发另有API_TARGET指定/api代理目标。只设DATA_DIR时自定义规则包文件仍落在server/rules/custom,换数据目录请两个变量一起设,否则库和文件会分家(后端启动时会打印两个目录并报告对不上的残骸)
与命令行直扫对比
| 能力 | opengrep scan 直扫 |
Opengrep Studio |
|---|---|---|
| 结果形态 | 终端 JSON / 文本 | 可交互审阅:代码高亮、污点链路、过滤搜索 |
| 中文体验 | 英文消息 | 812 条规则消息全量中文(简 / 繁)+ CWE 中文知识库 |
| 基线管理 | 无 | 新增 / 已修复 / 遗留自动分类,复核跨扫描继承 |
| 版本对比 | 无 | 双快照对比(问题级 + 文件级,可跨项目) |
| 报告交付 | 手工拼 | 一键纸感报告(打印 / 离线 HTML)+ 可复现清单 |
| 规则调试 | 改完重跑 | 规则实验室:正反例即时验证、样本回归 |
| 工具链互通 | 自行处理 | SARIF 2.1.0 导入 / 导出 |
工作原理
flowchart LR
    U["浏览器 UI<br/>React 19 + Vite"] -->|"REST /api"| S["Express 后端<br/>:8787"]
    S -->|"子进程编排<br/>--json --dataflow-traces"| E["opengrep 引擎<br/>v1.33.1"]
    S --> DB[("SQLite<br/>server/data/studio.db")]
    S --> FS[("不可变源码快照<br/>data/workspace/")]
- 单进程部署:后端同时托管构建后的前端(生产模式访问 8787 端口即可),默认只监听
127.0.0.1 - 每次扫描基于不可变源码快照执行,快照哈希与完整命令行存档,报告可复现
- SQLite 存储项目 / 扫描 / 问题 / 复核 / 配置,无外部服务依赖,全部数据在
server/data/ - 扫描最多 2 路并发(超出的自动排队),规则实验室与扫描互斥
安全模型
诚实声明,请务必了解:
- 本地单机工具:默认只监听
127.0.0.1,代码与结果不上传、无遥测 - 登录仅为防误触的前端门禁(固定账号
admin/123456),后端接口无鉴权——不要将服务暴露到公网;确需局域网使用时自行设置HOST并加上访问控制 - Docker 模式默认
HOST=0.0.0.0,请仅在内网 / 加防护的前提下使用 - 上传解压有 Zip-Slip / 符号链接 / 体积与文件数防护;Git 克隆仅允许 https 协议并禁用凭证交互
常见问题
支持哪些语言和平台?
内置规则覆盖 Python、JS/TS、Java、Go、C、C#、PHP、Bash、Kotlin、Swift、Rust、Dockerfile 共 12 种语言;Studio 本身可运行在 Windows(x64)/macOS(x64 / arm64)/Linux(x64 / arm64)及 Docker。
和 Semgrep 是什么关系?
Opengrep 是社区从 Semgrep OSS 延续出的开源引擎(LGPL-2.1),Studio 编排其官方二进制,规则精选自 opengrep-rules。Studio 与 Semgrep Inc. 无关联。
我的代码会被上传吗?
不会。扫描、存储、报告生成全部在本机完成,服务默认只监听本机回环地址。
数据存在哪里?删除项目会残留吗?
全部在 server/data/(SQLite + 源码快照)与自建规则包目录。删除项目会级联删除其扫描、问题、复核记录与快照目录。
怎么接入 GitHub Code Scanning?
在扫描结果页「导出 SARIF」,把产物按 GitHub 文档上传到 code-scanning 即可;指纹采用稳定去重格式,支持增量上报。
能导入其他工具的扫描结果吗?
支持 SARIF 2.x:在项目详情页「导入 SARIF」,结果会成为一次完整扫描,可设基线、出报告。
Roadmap
- 内置规则中文化(812 条全覆盖)与 CWE 中文知识库
- 基线对比 / 双快照对比 / 复核证据链
- SARIF 2.1.0 导入导出与可复现清单
- 规则实验室与便携规则包(含样本回归)
- Docker 镜像与三平台一键启动
- 引擎更新检查与一键升级(下载三通道兜底)
- 界面多语言 i18n(英文 / 简体中文 / 繁体中文)
- 扫描队列与并行调度
- 规则包在线 URL 导入与社区规则包索引
- GitHub Action 工作流模板(CI 中跑扫描并回传 SARIF)
- 报告模板自定义(品牌 / 页眉页脚)
致谢
- opengrep/opengrep —— 扫描引擎(LGPL-2.1),本仓库不内嵌其二进制,由脚本下载并校验
- opengrep/opengrep-rules —— 内置规则的来源,感谢上游所有规则作者
- shadcn/ui / Radix UI / Tailwind CSS / CodeMirror / Vite / React —— 构成界面的一切好东西
License
本项目代码以 MIT 发布。
需要注意的两项第三方许可:
- 扫描引擎:opengrep 以 LGPL-2.1 发布,本仓库不含引擎二进制,
npm run setup:engine从官方 Releases 下载并做 SHA-256 校验 - 内置规则:精选自 opengrep-rules(LGPL 2.1 + Commons Clause),可自由使用与再分发(保留署名),但不得将规则本身作为付费产品出售
探索相关项目
trimstray/the-book-of-secret-knowledge
汇集各类启发灵感的清单、手册、速查表、博客、技巧、单行命令、CLI/Web 工具等内容。
258,192 星标Hack-with-Github/Awesome-Hacking
面向黑客、渗透测试人员与安全研究人员的各类 Awesome 清单合集。
125,428 星标swisskyrepo/PayloadsAllTheThings
一份用于 Web 应用安全以及渗透测试/CTF 的实用 payload 与绕过方法列表。
82,654 星标caddyserver/caddy
快速、可扩展的跨平台 HTTP/1-2-3 Web 服务器,支持自动 HTTPS
79,041 星标