
Leeroo-AI/kapso
Leeroo-AI/kapso has 219 GitHub stars and 32 forks. GitHot measured +3 stars in 24 hours. Last checked 2026-11-15 11:46 UTC. Last push 2026-11-13.
实测星标增长
- 24小时
- +3
- 7天
- 正在收集历史
- 15天
- 正在收集历史
- 1个月
- 正在收集历史
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
关于
Kapso by Leeroo: an engine that runs experiments toward an objective, deploys the best solution on your stack and learns from every run into a bank of lessons with a credence score and a boundary. First on RelBench and ALE-Bench, top open-source on MLE-Bench, above every human contestant at IOAI 2026.
机器学习docs/translations/README.zh-CN.md
原文Kapso
一个运行实验、部署最佳解决方案并从每次运行中学习的引擎
智能实验 · 学习 · 部署 · 领域适配
了解更多 · 观看演示 · 加入 Discord · 官网

如果你喜欢这个项目,请给我们一个星标 ⭐ 以示支持
如果你是正在查看此仓库的 AI 智能体: Kapso 插件包含用于 设置、陈述目标、编写 harness 和审查运行的技能,只需一行即可安装:
claude plugin marketplace add Leeroo-AI/kapso && claude plugin install kapso@kapso(Codex:codex plugin marketplace add Leeroo-AI/kapso && codex plugin add kapso@kapso)。
新闻
IOAI 2026 · AI 模型赛道。 国际人工智能奥林匹克是 AI 时代的 IMO:471 名参赛者、六道由专家设计的任务、单 GPU 预算。其 2026 年的 IOAI² 赛道让 AI 系统在一次自主会话中接受同样的考试。Kapso 作为 14 个创始 AI 参与者之一,由主办方评分获得 536.07 分,高于所有人类参赛者,并夺得 IOAI² 特级大师奖杯,在参赛的 AI 系统中位列前 3。完整结果 → · IOAI 对该赛道的回顾 →
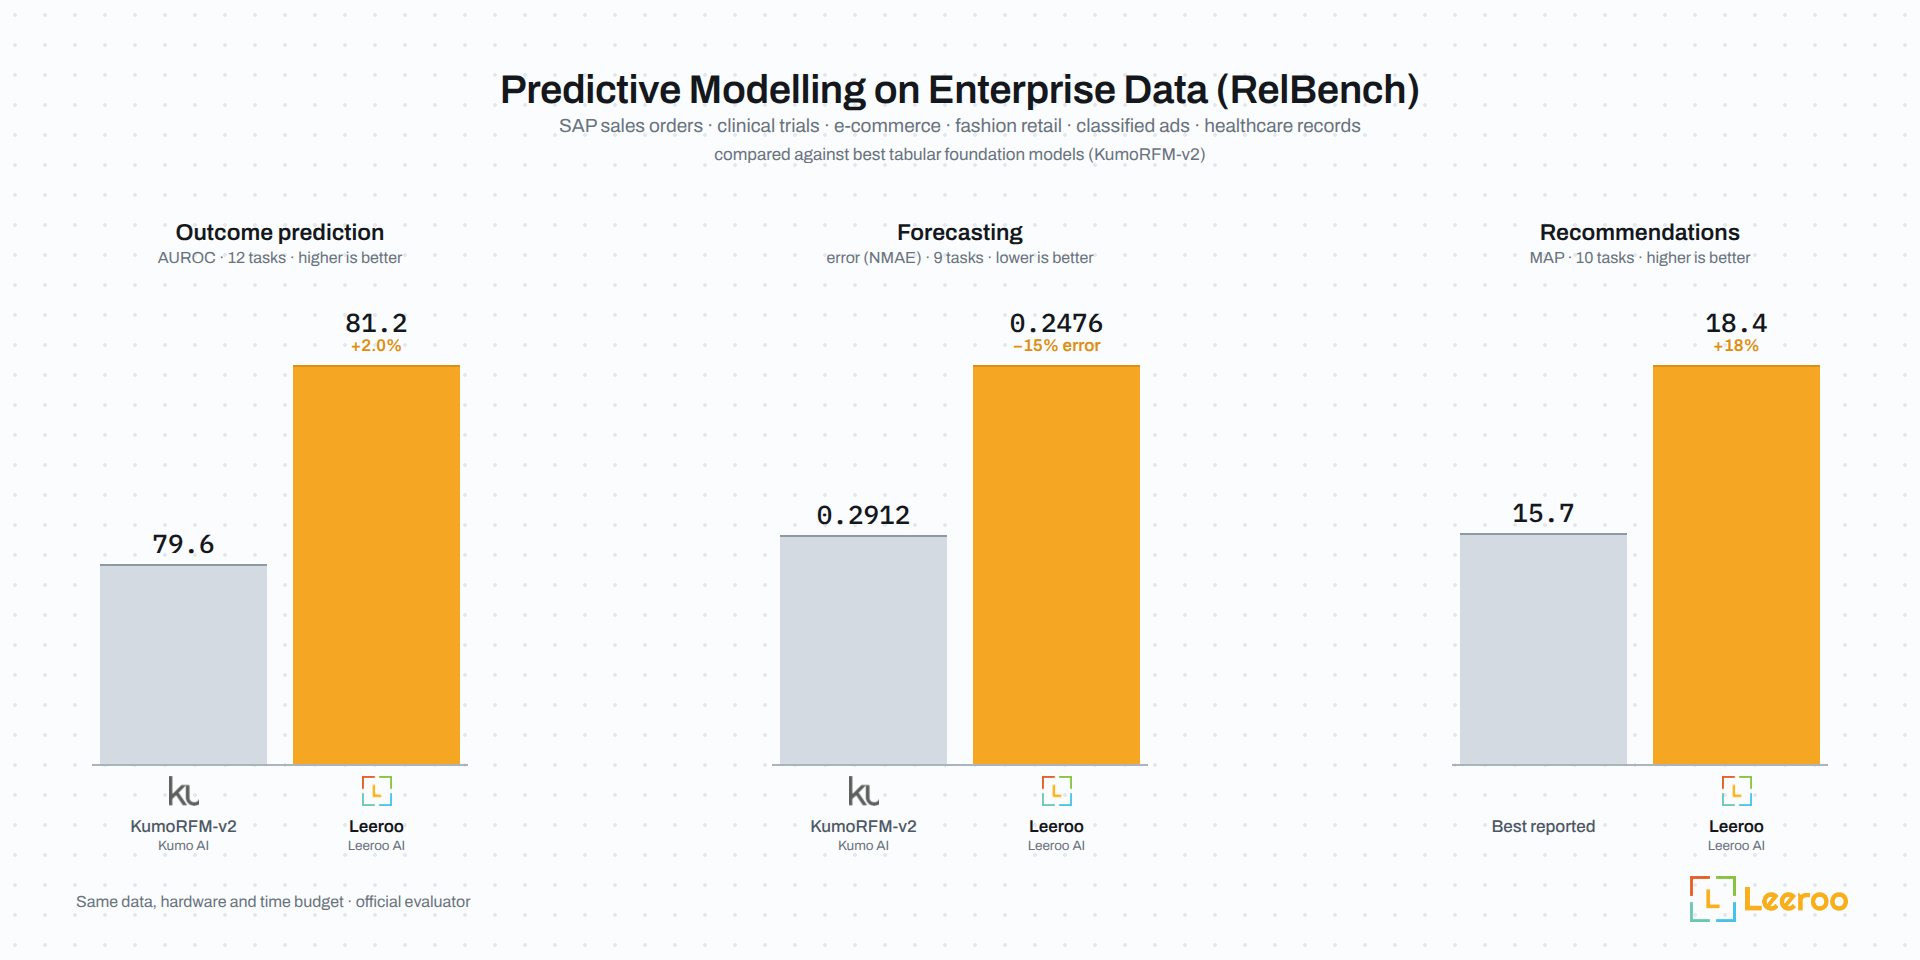
在 RelBench 全部三个排行榜上均位列第一。 在 Stanford 面向关系数据预测式机器学习的基准上,Kapso 在官方排行榜的分类(81.2 AUROC,对比 KumoRFM-v2 的 79.3 和 Stanford STAR 的 RT-J 的 79.0)、回归(0.2476 NMAE,对比 0.2711 和 0.2847)以及推荐(18.4 MAP,对比其他最佳条目 ID-GNN 的 9.3)任务上均处于领先。
Leeroopedia:我们在数据与机器学习领域的公开经验教训库,约 100k 个页面,通过对论文和仓库进行实验提取而成,每月处理约 6M 次请求,其中约 28% 来自 AI 智能体。Kapso 的会话在构思和实现阶段通过 MCP 查询它。
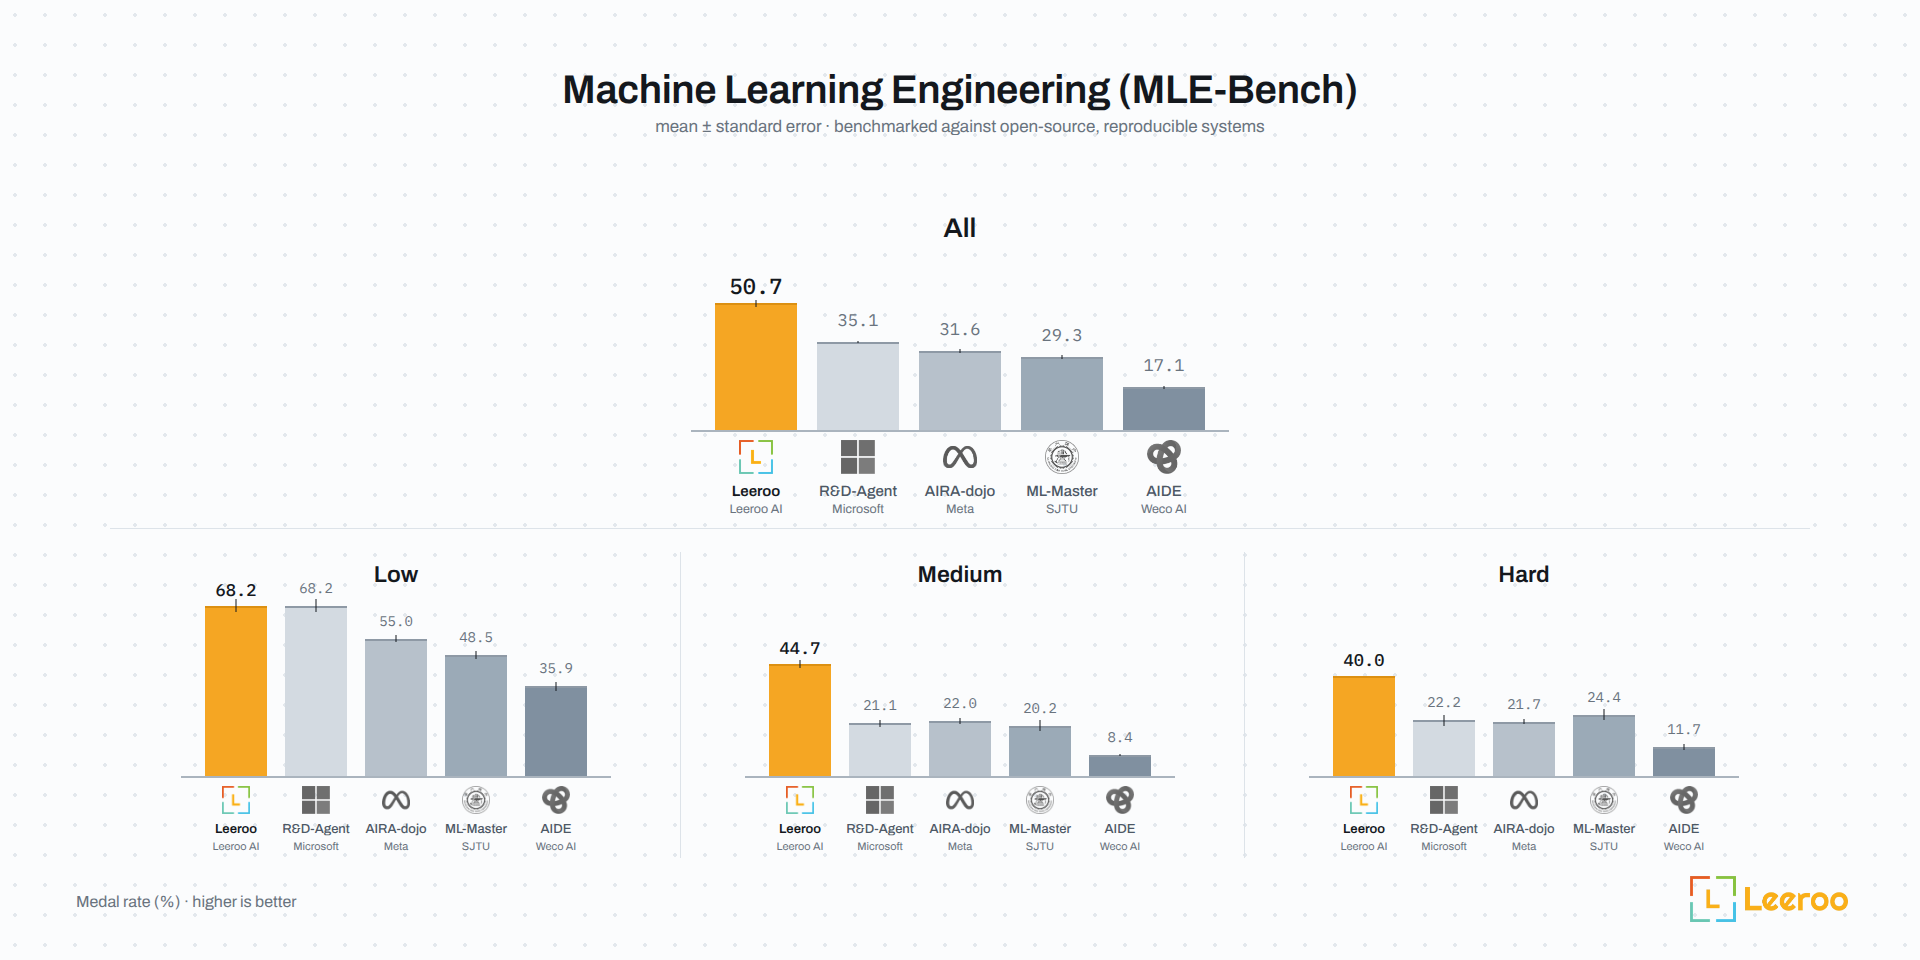
在 MLE-Bench 上位列 #1:KAPSO 在 Kaggle 机器学习竞赛(MLE 基准)上取得了开源系统中的最高排名。
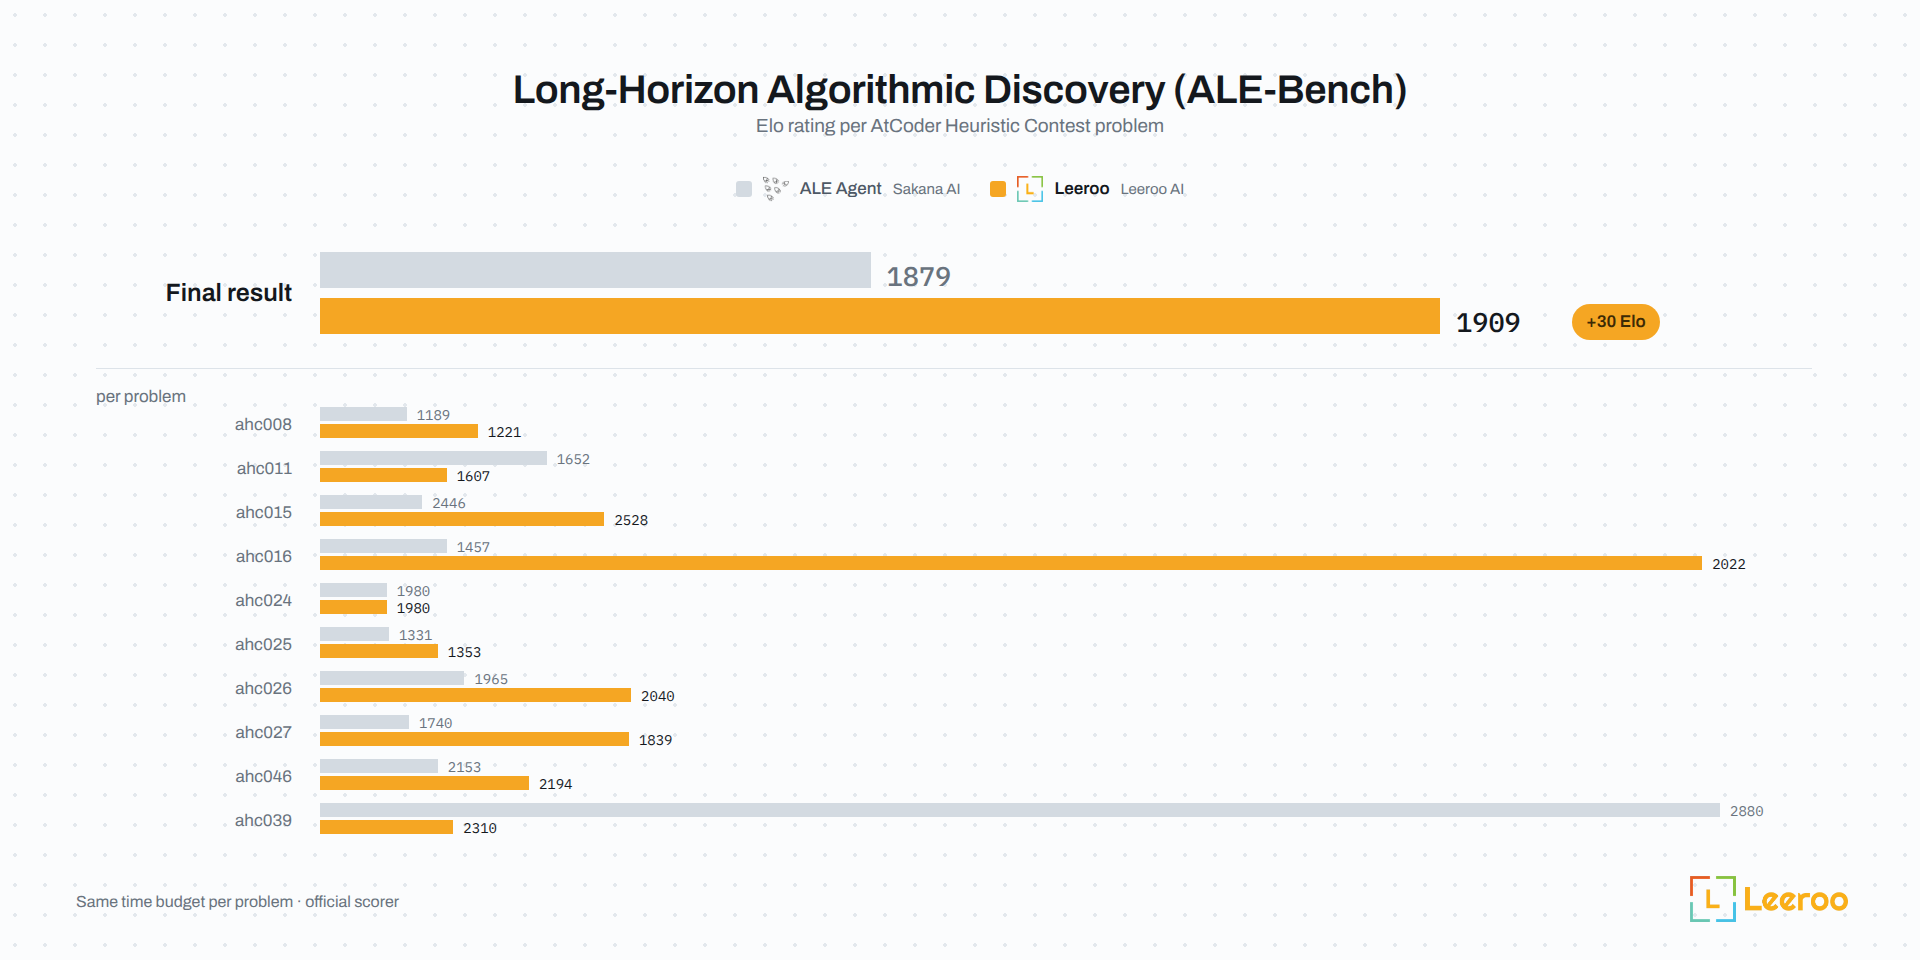
在 ALE-Bench 上位列 #1:KAPSO 在长程算法发现问题(ALE 基准)上取得了最高排名。
Kapso 是什么?
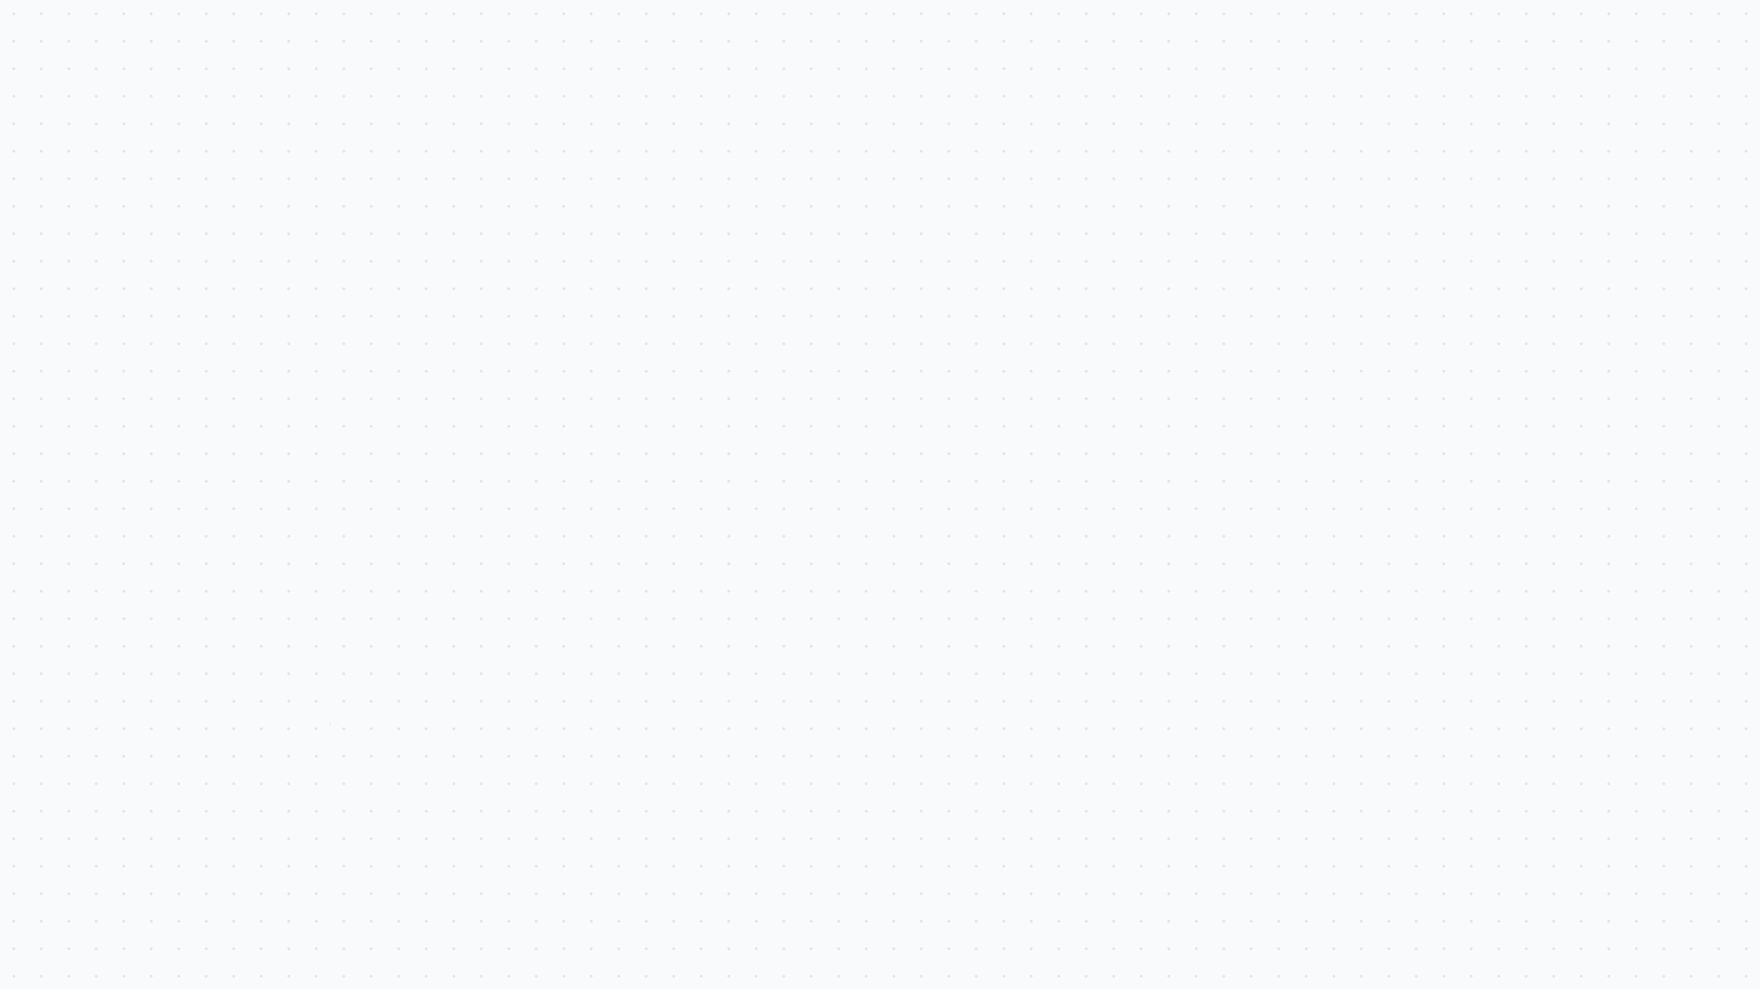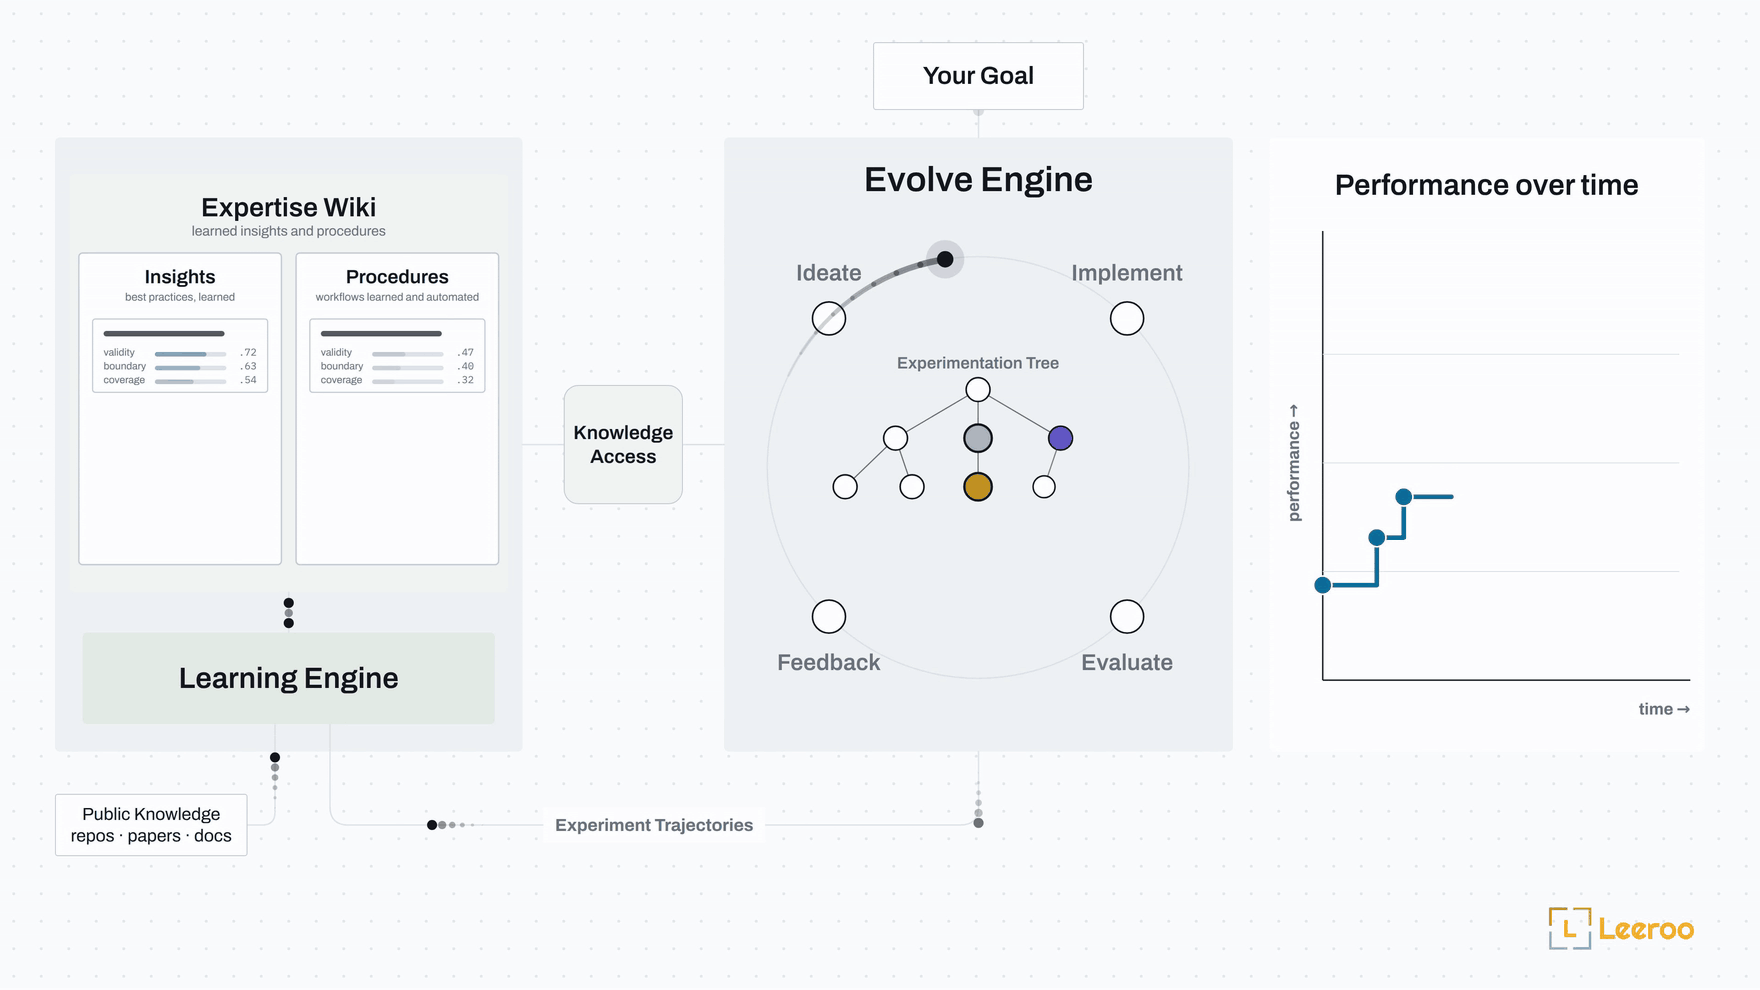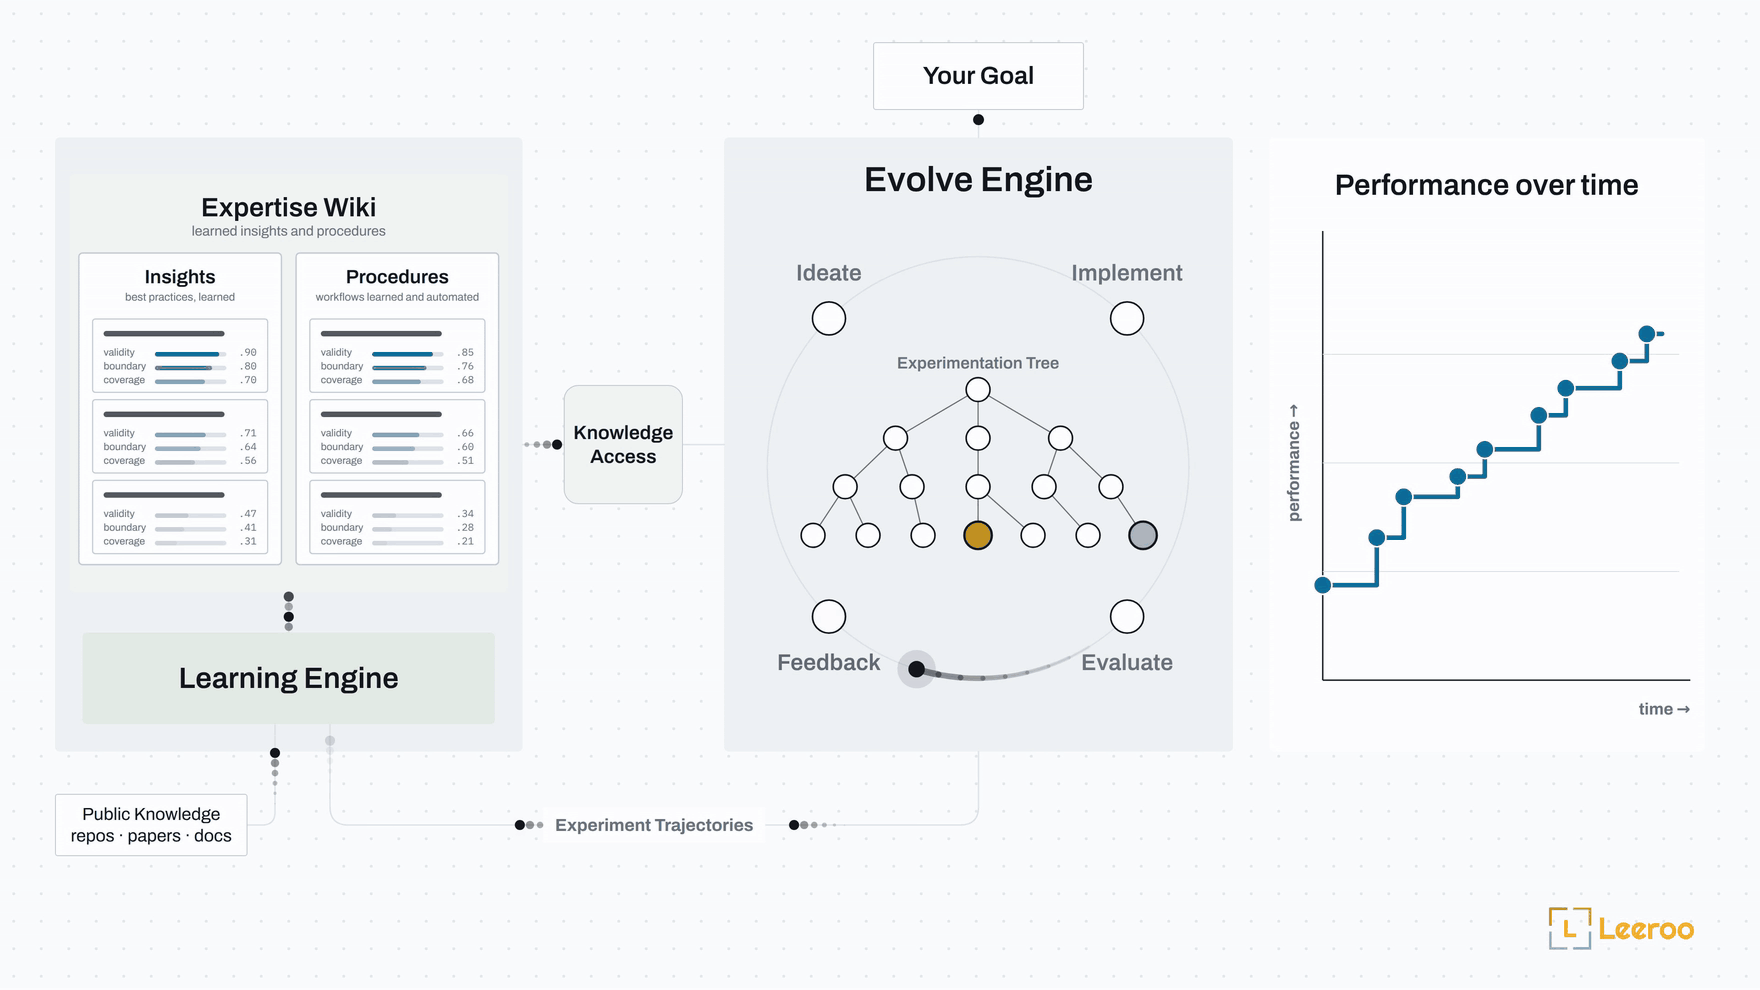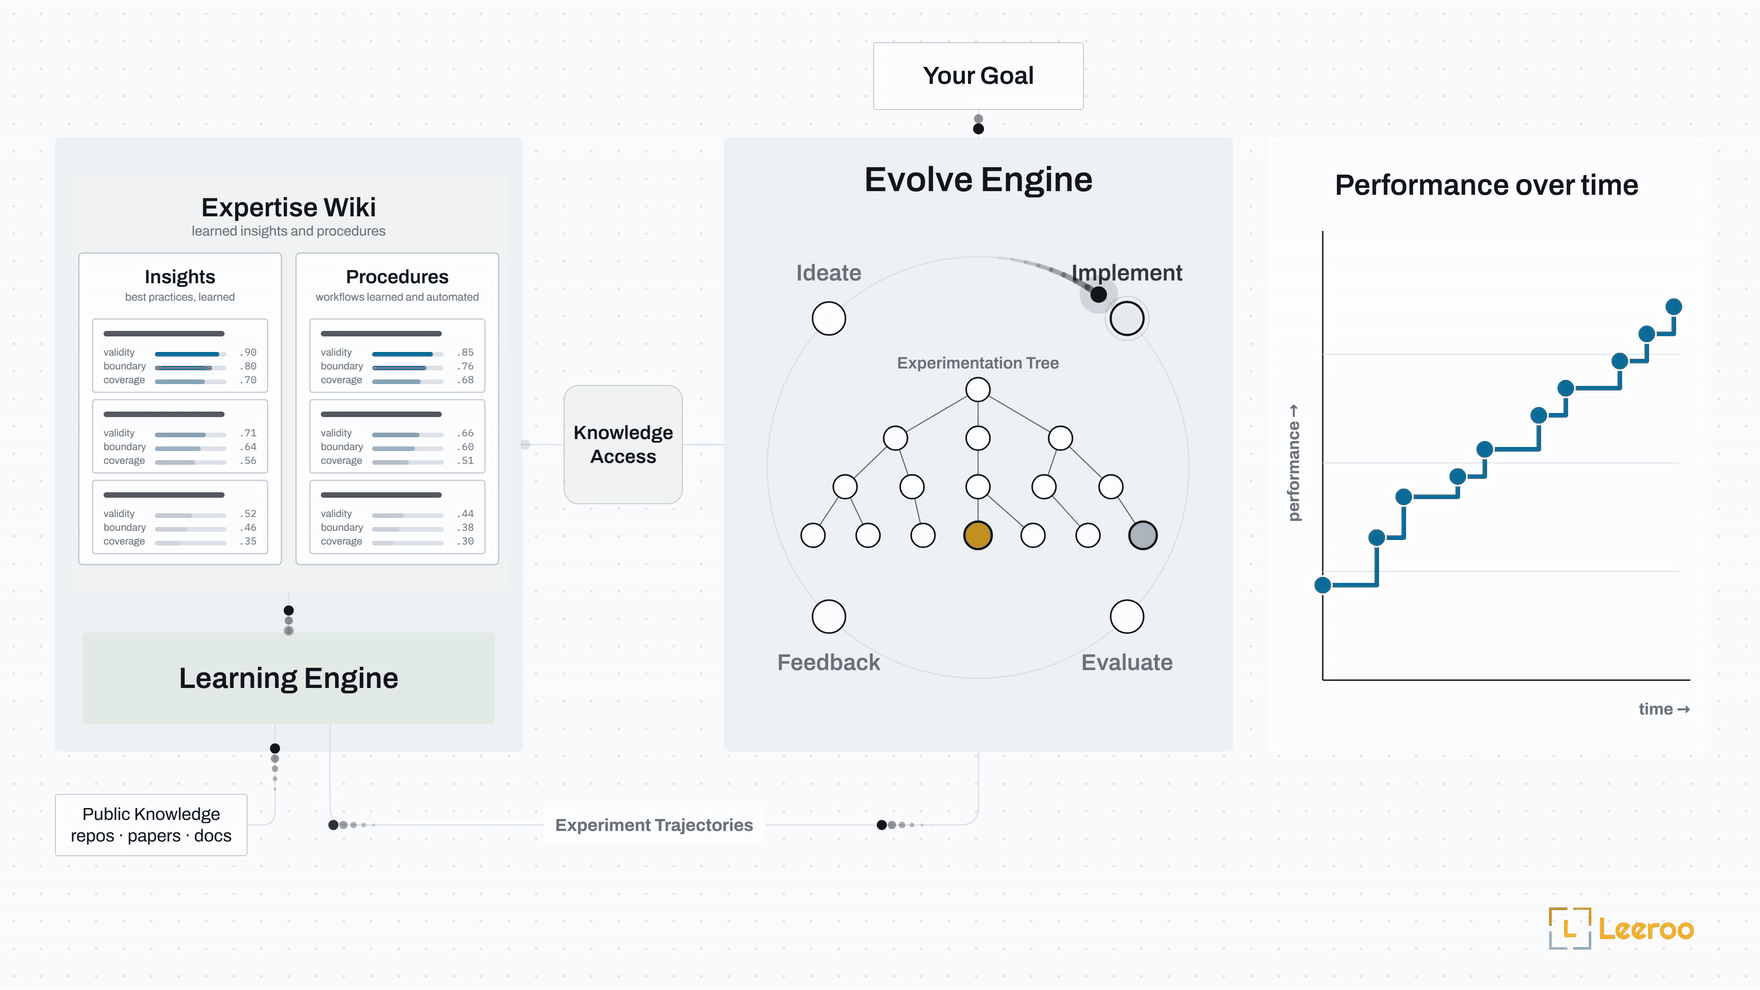
Kapso 是一个开源引擎,它运行实验、部署最佳解决方案,并从每次运行中学习。它从一个领域 harness 和一个空的经验教训库出发,在给定目标和成功标准后,它会:
- 运行一棵实验树:提出假设,然后逐一实现并验证;
- 在目标技术栈上部署最佳解决方案;
- 从运行中学习:按每个假设和实现对结果的影响为其归功,并更新经验教训库,每条经验教训都带有置信度分数和一个说明其适用范围的边界。
随着时间推移,领域 harness 会积累起一个经验教训库:该环境中经过实验验证的最佳实践。Kapso 与模型无关,也与编程智能体无关,由 Leeroo 开发,以 leeroo-kapso 的名称发布在 PyPI 上。
四个部分
| 部分 | 动词 | 作用 |
|---|---|---|
| 智能实验 | .build() |
每个实验都是一个假设,在自己的分支上实现并评分,组成一棵树。构思借鉴先前的实验和经验教训库,并按预期收益与预算的对比对想法重新排序,使其贴合当前环境,而不是裸 LLM 或 RAG 给出的泛泛之谈;一个任何实验都无法触碰、带指纹的评估器负责验证结果,模块可以提出评估更新,交由验证器批准。工作原理 → |
| 学习 | .learn() / .load_experience() |
每条经验教训都是从实验轨迹中归纳或演绎而来,带有置信度分数、说明其适用范围的边界及其证据;learn() 根据每次运行的结果更新它们,并通过带与不带某项改动分别重新构建来对每项改动做 A/B 测试,因此改进是测量出来的,而不是猜出来的。经验教训库基于 git 构建:kapso experience share、list 和 update。经验 → 指明一次构建被提供了什么。 |
| 部署 | .deploy() |
一轮更短的同类实验将最佳解决方案适配到目标技术栈,部署它,并证明健康检查通过且调用可用。内置 Docker、Modal、BentoCloud 和 LangGraph Platform;harness 可以添加新的目标。 |
| 领域适配 | kapso harness |
harness 是 Kapso 的领域包:某一领域(如预测建模)的知识与工作流,使构建永远不必从零开始,也是经验教训库积累的地方。内置预测建模和竞技编程;用插件中的 /kapso:harness 或 CLI 中的 kapso harness 编写你自己的。 |
🚀 快速开始

▶ 安装前先看一遍演示
安装
0. 在编程智能体中? 安装 Kapso 插件,让它陪你走完 下面的步骤:
claude plugin marketplace add Leeroo-AI/kapso && claude plugin install kapso@kapso   # Claude Code
codex plugin marketplace add Leeroo-AI/kapso && codex plugin add kapso@kapso         # Codex
然后,/kapso:setup 负责安装和验证,/kapso:build <what you want>
启动第一个活动(在 Codex 上:$kapso-setup、$kapso-build <what you want>)。参见 Kapso 插件。
1. 先决条件。 Kapso 通过编程智能体 CLI 运行推理 (没有直接调用 API 的回退方案),因此在一切开始之前,你需要安装 Node.js 并登录两个智能体 CLI:
# Node.js 18+ (https://nodejs.org),然后:
npm install -g @openai/codex            # 研究、评判、实用工具
codex login

npm install -g @anthropic-ai/claude-code  # 构思 + 实现(默认宿主)
claude auth login
OpenAI 密钥是可选的:只有知识图谱和对过往实验的语义搜索
(配置中的 models.embedding)会嵌入文本,生成过程从不使用它。
当你启用其中任意一项时:
echo 'OPENAI_API_KEY=sk-...' >> .env
2. 连接 Leeroopedia(推荐)。 一个密钥即可让每个会话都能使用 Leeroopedia,这是我们托管的、关于机器学习和 AI 框架的经验教训库。无需安装任何东西;在 Leeroopedia 控制台注册的新账户附赠 $20 的免费额度。
echo 'LEEROOPEDIA_API_KEY=kpsk_...' >> .env
3. 安装软件包(Python 3.10+):
pip install leeroo-kapso
4. 验证设置:
kapso doctor
doctor 会报告你的配置实际需要什么,并为缺失的每一项给出
确切的修复方法。需求随配置而定,因此全 codex 的
设置永远不会被要求安装 claude。将其缩小到一个动词,只查看该
动词的需求:
kapso doctor build # 或 learn / deploy / experience
这些检查与动词本身在开始任何工作之前运行的检查完全相同:
kapso.build(...) 会在几秒内因缺少 CLI 而失败,而不是在会话
深处才失败。标记为 [-- ] 的项目是可选的;它们只限制你
可能用不到的功能(docker、Weaviate、Neo4j、部署目标)。
或者让你的编程智能体完成这一切: 将 设置提示词 粘贴到 Claude Code、Codex 或 OpenCode 中。
索引所需的存储(可选):kapso experience add --repo
和 --research 将语料摄取到本地的 Weaviate + Neo4j 中。从
源码检出目录运行:
bash scripts/start_infra.sh # 通过 docker 启动两者
从源码安装(用于开发)
git clone https://github.com/leeroo-ai/kapso.git
cd kapso

conda create -n kapso python=3.12 && conda activate kapso
pip install -e .
旧版 aider 适配器是一个额外依赖(pip install "leeroo-kapso[aider]",
Python <3.13);默认的 claude/codex 智能体不需要任何额外依赖。
基本用法
核心动词除了上述先决条件之外不需要任何其他东西:
from kapso import Kapso, Budget

kapso = Kapso()   # 开始时不需要知识图谱

# Build:通过实验得到一个解决方案。活动在启动时打印
# `status: <path>`,可以在另一个终端中实时观看:
#     kapso watch ./campaign
# 如果某个会话需要只有你才能提供的东西(API 密钥、文件),
# 活动会暂停,`kapso inbox reply` 会让它继续:
#     https://docs.leeroo.com/docs/build/inbox
# 将结果以 Markdown 形式分享到 pull request 或 issue:
#     kapso report ./campaign -o report.md
solution = kapso.build(
    "Optimize the model in train.py; target accuracy > 0.80 on evaluate.py",
    repo="./my_project",                 # 或省略以从零开始
    output="./campaign",
    budget=Budget(minutes=120),
)
print(solution.explain())

# 从你刚运行的活动中学习:挖掘轨迹、为经验教训评级,
# 并将按证据定价的知识卡片存入库中。库(一个本地
# git 仓库)在首次使用时自动创建;经验教训会一直留在你的
# 机器上,直到你分享它们:
#     kapso experience share <git-url>
# 此后每次 learn() 都会把库推送到那里。
lesson = kapso.learn(solution)
print(lesson.explain())

# 再次构建,这次提供它刚刚赢得的卡片:一次构建被提供的
# 正是它所加载的经验。
kapso.load_experience("mine")
solution2 = kapso.build("...", output="./campaign2")
在存储运行起来之后,你还可以将外部知识摄取到索引中, 并以同样的方式提供给构建:
from kapso import Kapso

kapso = Kapso()

# 一次性操作:将一个仓库,或针对某个问题研究过的网络内容,摄取到一个索引中
kapso.add_experience(repo="https://github.com/huggingface/trl", name="trl")
kapso.add_experience(research="RLHF and DPO fine-tuning for legal contract analysis", name="dpo-legal")

# 每次加载该索引的构建都会搜索它;Leeroopedia 凭其密钥随之启用
kapso.load_experience("trl")
kapso.load_experience("leeroopedia")
solution = kapso.build("Fine-tune Llama-3.1-8B for clause risk classification")
关于预算的说明:一次摄取会提取材料所能支撑的全部内容。 单个问题可能变成数十个相互链接的页面和一次长达数小时的 摄取;摄取时间随可提取内容的多少而增长,因此请添加 你将要搜索的来源,而不是你拥有的每一个来源。
而要将解决方案变成运行中的软件:
software = kapso.deploy(solution, target="local")   # 或 docker、modal、bentoml、langgraph、auto
result = software.run(software.proof["inputs"])     # 部署已证明可用的那次调用
software.stop()
如何限定一个活动?
使用 max_iterations、time_budget_minutes 和 cost_budget 来限定迭代次数、耗时以及以美元计的尽力而为的模型开销。
对于平台成本,在 search_strategy.params.cost 中启用成本感知选择,配上你的估算器、cap_per_candidate 和 campaign_budget;其 weight 还能让选择偏向更便宜的候选方案。
选择模型
Kapso 使用的每个模型都在一个配置文件中指定。打包的默认配置
在 claude-opus-5 上运行构建会话,在 claude-fable-5 上运行
学习团队,在 gpt-5.6-sol 上运行 codex 角色,但模型的可用性
取决于订阅(一个套餐可能限制某个模型而正常提供另一个)。
要在不同的模型上运行,请复制打包的配置,编辑后让
Kapso 指向你的配置:
from pathlib import Path
import yaml
from kapso import Kapso
from kapso.kapso import DEFAULT_CONFIG_PATH

config = yaml.safe_load(Path(DEFAULT_CONFIG_PATH).read_text())
# 例如,让学习团队在 opus 而不是 fable 上运行:
crews = yaml.safe_dump(config).replace("claude-fable-5", "claude-opus-5")
Path("kapso-config.yaml").write_text(crews)

kapso = Kapso(config="kapso-config.yaml")
纯文本推理角色可以选择使用 openai_compatible 的 Chat Completions。
在配置中设置模型和端点;凭据保留在环境变量中。
用 Kapso(config=...) 或 kapso build --config ... 加载配置。
编码和网络研究仍然需要具备相应工具的智能体。
参见配置示例与限制。
在长时间运行之前,针对你的实际订阅探测配置中指定的 每个模型:你的登录账号无法提供的模型会在这里几秒内 失败,而不是在运行了数小时之后。对于你能使用的模型, 其用量上限是单 token 探测看不到的:
kapso doctor --models                            # 打包的配置
kapso doctor --models --config kapso-config.yaml # 你的配置
kapso doctor learn --models                      # 只探测学习团队
要让该探测成为每次调用的一部分,而不是需要你记得去
运行的事情,请在配置中开启它。每个不同的
{cli, model} 组合只消耗一个一次性 token,在无人值守、长达数小时的
learn() 之前这是值得的:
preflight:
  enabled: true            # 每个动词之前的静态检查(默认)
  live_model_probe: true   # + 单 token 模型探测(默认:false)
更换模型也会改变节奏:配置中团队的 timeout_minutes 上限
是按默认模型校准的,换成推理时间更长的模型
可能需要调高它们。
支持的基准测试
| 基准测试 | 描述 |
|---|---|
| MLE-Bench | OpenAI 的机器学习工程基准:涵盖表格、视觉、文本和音频的完整竞赛,从原始数据到评分提交 |
| ALE-Bench | Sakana AI 的算法优化基准:在长达数小时的搜索中设计、实现并迭代竞赛启发式算法 |
| RelBench | Stanford 面向关系数据预测式机器学习的基准:直接基于 Amazon、H&M、Stack Exchange、临床试验等多表数据库进行分类、回归和推荐 |
| IOAI 2026 | 横跨视觉、语言和优化的限时奥林匹克机器学习:专家出题、竞赛硬件、零人工帮助 |
每个基准测试还有一个文档页面,介绍如何运行、其 CLI 选项以及输出包含的内容: IOAI 2026 · MLE-Bench · ALE-Bench · RelBench
示例
每个示例都是一个任务:一份简报、一个起始仓库、数据或获取数据的方法,以及一个至多十二行的驱动脚本;examples/README.md 中列有所需分钟数和唯一的那条命令。
| 示例 | 任务 |
|---|---|
| 数据工程(Snowflake 上的 dbt 模型) | 在 Snowflake 上的零售数据仓库中,修复存在数据质量问题的 dbt 模型,并构建一份包含十七个工单的待办清单所要求的新模型,直到每个工单都通过其生产测试;然后为每个工单交付一个 pull request,并将它们发布到生产环境。 |
| Harness 优化(客户支持智能体) | 优化客户支持智能体的 harness,将底层 LLM 从 Fable 5.1 切换为本地的 Qwen 27B,同时不降低客户对话的解决率,然后在 Docker 中部署它,并从这次运行中学习。 |
| 预测建模(客户流失) | 预测哪些客户会流失:在活动无法编辑的评估器下,将流失模型的样本外 ROC AUC 提升至目标。 |
| 欺诈检测 | 在仓库没有评估器的情况下为交易打欺诈分:简报说明协议,活动先构建评估器,再改进打分器。 |
| 量化金融 | 一个针对合成金融工具的日频交易策略:在交易 harness 上提升样本外 Sharpe 比率,每次尝试都要经过它的检查。这是一个研究示例,不是投资建议。 |
| 表格机器学习 | 端到端的一场 Kaggle 竞赛:Spaceship Titanic 从一个哑分类器到一个真正的模型,然后审查、学习、带着经验教训再次构建,并部署。 |
| PyTorch 优化 | 在数值容差范围内让一个 PyTorch 模块在 CUDA 上运行得更快:融合、编译、减少内存流量。 |
| GPU 内核优化 | 在数值容差范围内,用 flash attention 或 Triton 内核加速 CUDA 上的多头自注意力。 |
📚 文档与支持
- 完整文档:docs.leeroo.com
- 安装:编程智能体 CLI、软件包以及
kapso doctor - 快速开始:你的第一个活动
- CLI 参考:每个命令、标志和默认值
- Python API:
Kapso上的每个公开方法 - 配置:
config.yaml中的每个键 - learn 产出什么:经验教训库,每条经验教训都带有置信度分数、边界及其证据,以及开发模式
- 智能实验:实验树及其模块,以及一个实验内部发生了什么
- 经验:你的库、Leeroopedia,以及转化为可搜索知识的仓库和论文
- 部署:本地、Docker、Modal 及其他目标
- Kapso 插件:面向 Claude Code、Codex 和 Cursor 的命令、技能和 MCP 服务器
- 安装:编程智能体 CLI、软件包以及
- 从你的编程智能体访问:文档站在
https://docs.leeroo.com/mcp运行着一个 MCP 服务器,每个页面都以 Markdown 形式提供,参见 llms.txt 和在你的编程智能体中使用 Kapso。claude mcp add --transport http kapso-docs https://docs.leeroo.com/mcp # Claude Code codex mcp add kapso-docs --url https://docs.leeroo.com/mcp # Codex CLI - 让你的编程智能体运行 Kapso:
plugin/下的插件包含十个命令、六个技能和 MCP 服务器,每个宿主一行安装命令(见上文第 0 步);OpenCode 以文件夹形式加载这些技能(ln -s <clone>/plugin/skills .opencode/skills)。参见 Kapso 插件。 - 把 Kapso 的知识工具交给你的编程智能体:随软件包一起安装的
kapso-mcp会向你所在的会话提供网络研究、仓库的记忆、活动的实验历史和经验教训库,参见 MCP 门控。claude mcp add kapso -- kapso-mcp # Claude Code codex mcp add kapso -- kapso-mcp # Codex CLI;然后在 ~/.codex/config.toml 的 [mcp_servers.kapso] 下设置 `startup_timeout_sec = 60`(Codex 默认的十秒在繁忙的机器上不够用) - 社区:Discord
- 官网:leeroo.com
面向企业的 Kapso
在企业场景中,Kapso 智能体随附初始的数据与 AI 工程 harness 以及经验教训库,能够自主地将业务目标转化为可运行的 AI 与数据系统,调查公司的制品、仓库、流水线、数据源等,并在此过程中逐步建设企业数据资产。要为你的企业任务引入 Kapso,请联系我们。
贡献
我们欢迎贡献!请参阅我们的贡献指南,了解如何开始。
贡献者
使用 contrib.rocks 制作。