
JuneYaooo/rea-video
JuneYaooo/rea-video has 7,559 GitHub stars and 1,115 forks. GitHot measured +433 stars in 24 hours. Last checked 2026-11-13 03:23 UTC. Last push 2026-11-09.
Reverse-engineer any video, shot by shot: filmed, AI-generated or coded, and how to remake it. 逆向一切视频,逐个镜头看是拍的、AI 生成的还是代码做的,再告诉你怎么复刻。
可以做什么
- Live footage - Talking-head, tabletop, handheld product demo, vlog, store visit - Setups and camera positions, framing, camera moves, lighting (12 setups with gear lists), color grade
- AI video - Text/image-to-video, AI short drama, AI music video - Evidence, a reverse-engineered prompt per shot, how to batch into generations and which model to use
- Avatar - A portrait driven by audio, lip-sync - Which shots are avatar shots, what portrait and audio you need
- 3D / animation - Blender / C4D explainers, product animation, 2D animation, stop-motion - Whether to generate with a video model or render from 3D code
实测星标增长
- 24小时
- +433
- 7天
- 正在收集历史
- 15天
- 正在收集历史
- 1个月
- 正在收集历史
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
i18n/README_zh.md
原文
逆向一切视频。
逐个镜头看一条视频是拍的、AI 生成的还是代码做的,再告诉你怎么复刻。
官网 | 中文 | English | Русский | 日本語 | 한국어 | Español | Português | Français | Deutsch



⭐ 觉得有用就点个 Star 吧,能让更多人看到它!
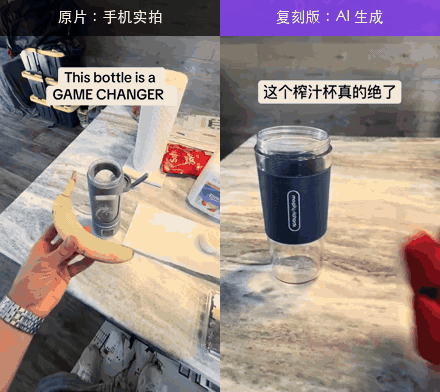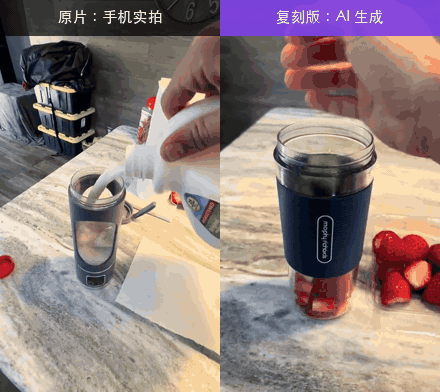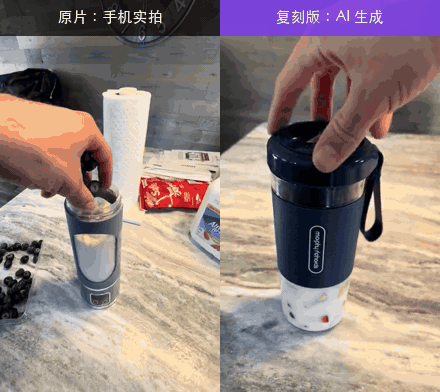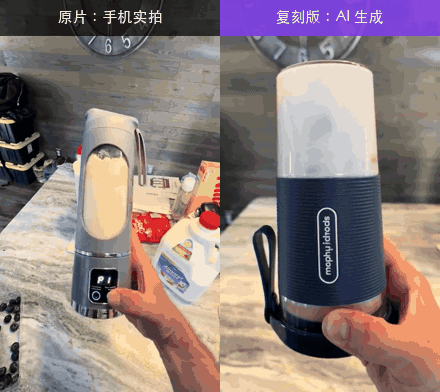
左边是 TikTok 上手机实拍的原片,右边是别人换了个产品、用 AI 重做的版本。rea-video 的判断:左边全是实拍,一个场景、两个机位;右边全是 AI,8 个镜头分 3 次生成。
快速开始
rea-video 是给 AI agent 用的。打开 Claude Code、Codex 这类能跑命令的 agent,直接说:
安装 https://github.com/JuneYaooo/rea-video ,然后拆解这条视频:/path/to/video.mp4
agent 会自己装好命令行工具、看懂拆解流程,然后一路跑完。电脑上需要有 ffmpeg 和 Python 3.10 以上。
手动安装
brew install ffmpeg            # sudo apt install ffmpeg
git clone https://github.com/JuneYaooo/rea-video && cd rea-video
bash scripts/install_skill.sh  # 装命令行工具(pip 不让装时改用 pipx 或仓库内 .venv),并把 skill 链接到各 agent 目录
rea-video --help
跑完你会拿到:
- 一句话结论,比如「AI 视频 41% + 代码界面 59%,有 8 秒真实录屏,曲库配乐 122 BPM」
- 复刻方案,按实拍、AI 生成、代码分开写
- 完整报告
report.html:逐镜头截图、判断依据、提示词、拍法和声音拆解
还可以配一个能看视频的模型(Gemini、豆包都行),把接口地址和密钥给 agent 就好。配上之后实拍、AI、3D 分得更准,每个镜头还会反推出提示词。不配也能用,agent 自己能看图的话,会补看没把握的镜头。
能拆哪些视频
| 视频类型 | 常见例子 | 拆出什么 |
|---|---|---|
| 实拍 | 口播、桌拍、手持带货、vlog、探店 | 拍摄场次和机位,景别、运镜、布光(12 种方案附器材)、调色 |
| AI 视频 | 文生 / 图生视频、AI 短剧、AI MV | 判断依据,每镜反推的提示词,合并成几次生成、用哪个模型 |
| 数字人 | 人像被声音驱动说话、对口型 | 哪些镜头是数字人,需要的人像和音频 |
| 3D / 动画 | Blender / C4D 科普、产品动画、2D 动画、定格动画 | 用视频模型生成还是写 3D 代码渲染 |
| 代码 / 模板 | 文字动效、UI 演示、图表、PPT 式卡片 | 文字、版式、动效节奏,可以写成 Remotion 工程 |
| 录屏 / 截图 | 软件教程、网页演示 | 哪些是真实素材,复刻时要你自己录 |
| 混合 / 混剪 | AI 人物 + 代码界面 + 真实录屏,实拍口播 + 用本人出镜视频生成的 AI 带货段 | 每一镜分开判断,再按原时间线拼回 |
除了画面怎么做的,每条视频还会拆:
- 字幕和花字:每句字幕的起止时间(可导出 SRT / ASS),花字用什么颜色、描边、怎么出场
- 贴纸、表情包、画中画:放在哪、停多久
- 剪辑:在哪切、节奏多快、有没有卡节拍
- 声音:真人还是 AI 配音,配乐是 AI 做的还是曲库的、多少 BPM,音效落在哪一下
- 要你自己准备的素材:录屏、截图、产品图
案例
docs/cases/videos/ 里的样片为了减小仓库体积重新压缩过,抹掉了抖音 / TikTok 的平台标记。自己拿它们跑,结果会和下面的报告不一样,不开看图模型时尤其明显。要复现请用平台下载的原文件。
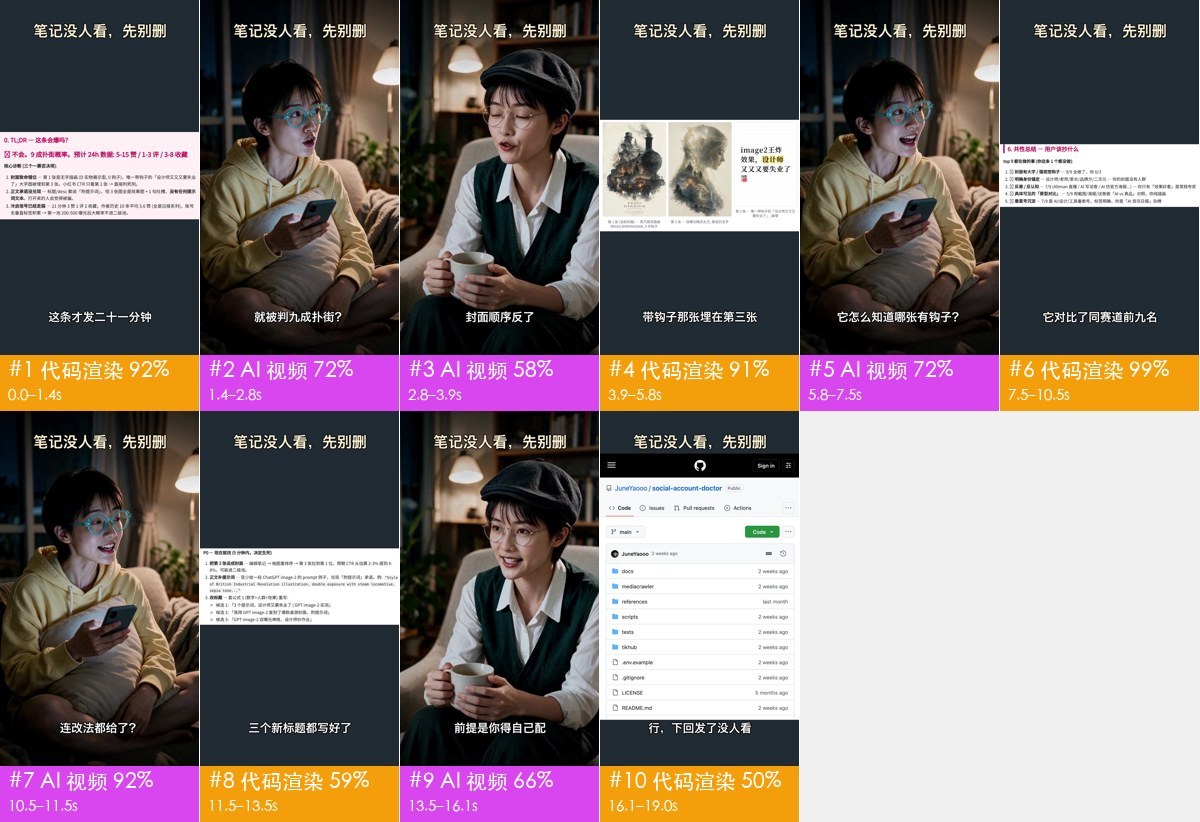 混合片 · 19 秒 · 10 镜 AI 人物对话 + 代码界面 + 8 秒真实录屏。5 个对话镜头被界面隔开,但同一个场景,一次生成就够。 视频 · 报告 |
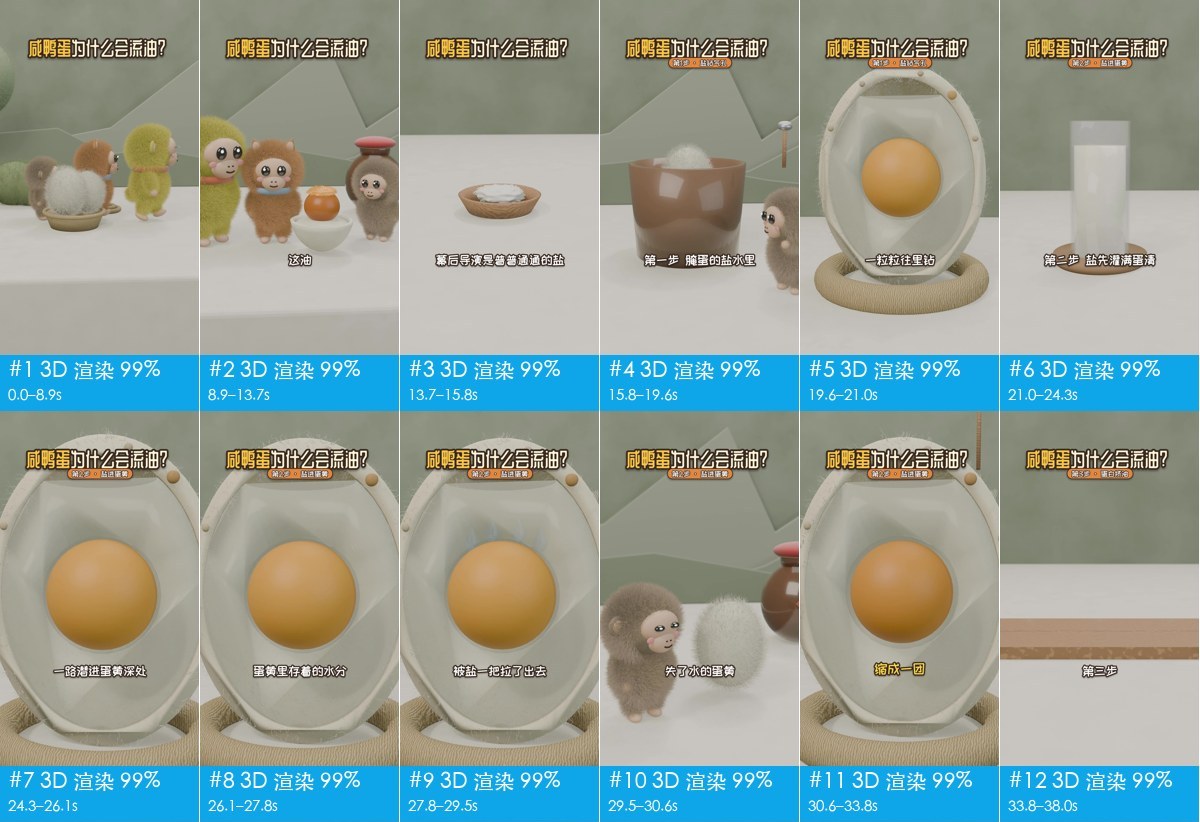 3D 科普片 · 67 秒 · 21 镜 全部 3D 渲染,AI 旁白。可以合并成 10 次视频生成,也可以让大模型写 Blender / Three.js 代码。 视频 · 报告 |
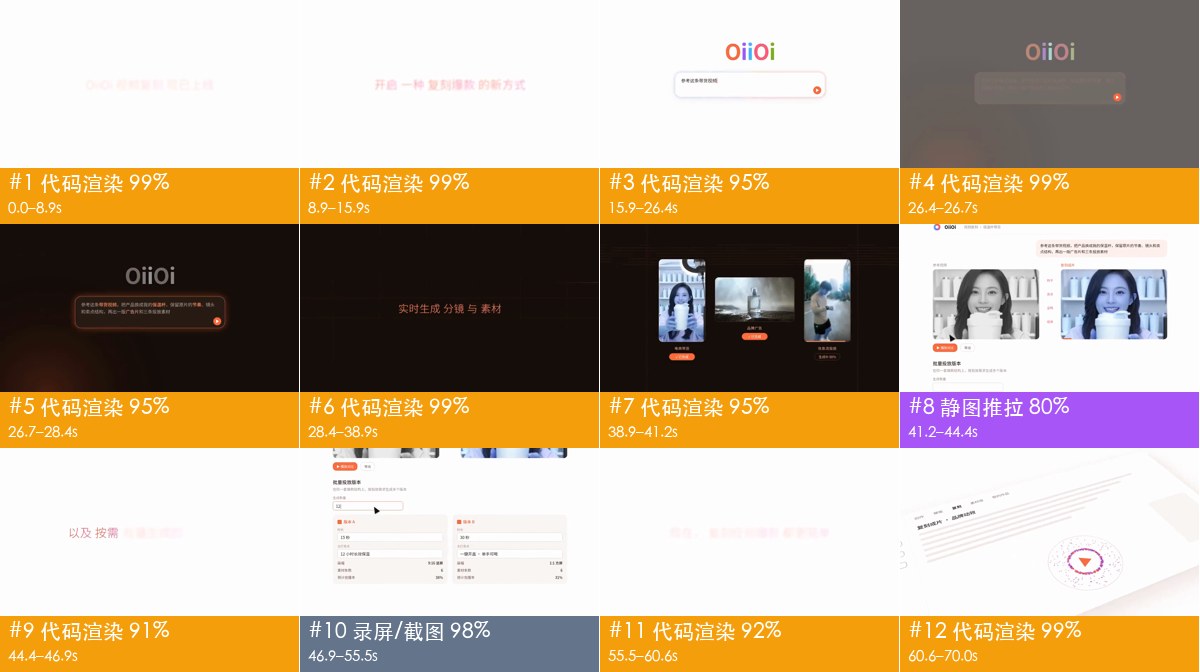 产品宣传片 · 70 秒 · 12 镜 83% 是代码动效,12% 录屏。不需要视频模型,写一个 Remotion 工程就能做。 视频 · 报告 |
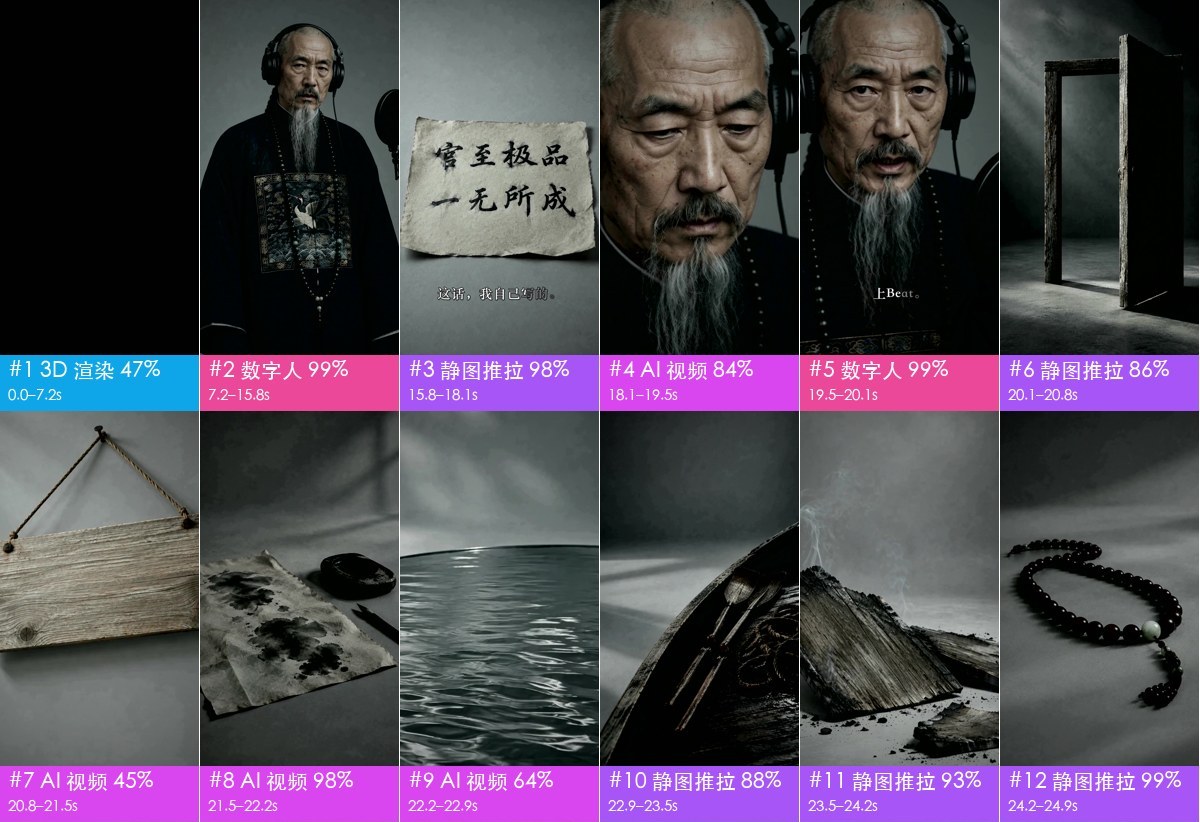 AI 音乐 MV · 165 秒 · 86 镜 判出歌是 AI 生成的(实际用的是 Suno)。有些镜头看图模型说是「影视剧实拍」,agent 从奏折上的假汉字认出是 AI。 视频 · 报告 |
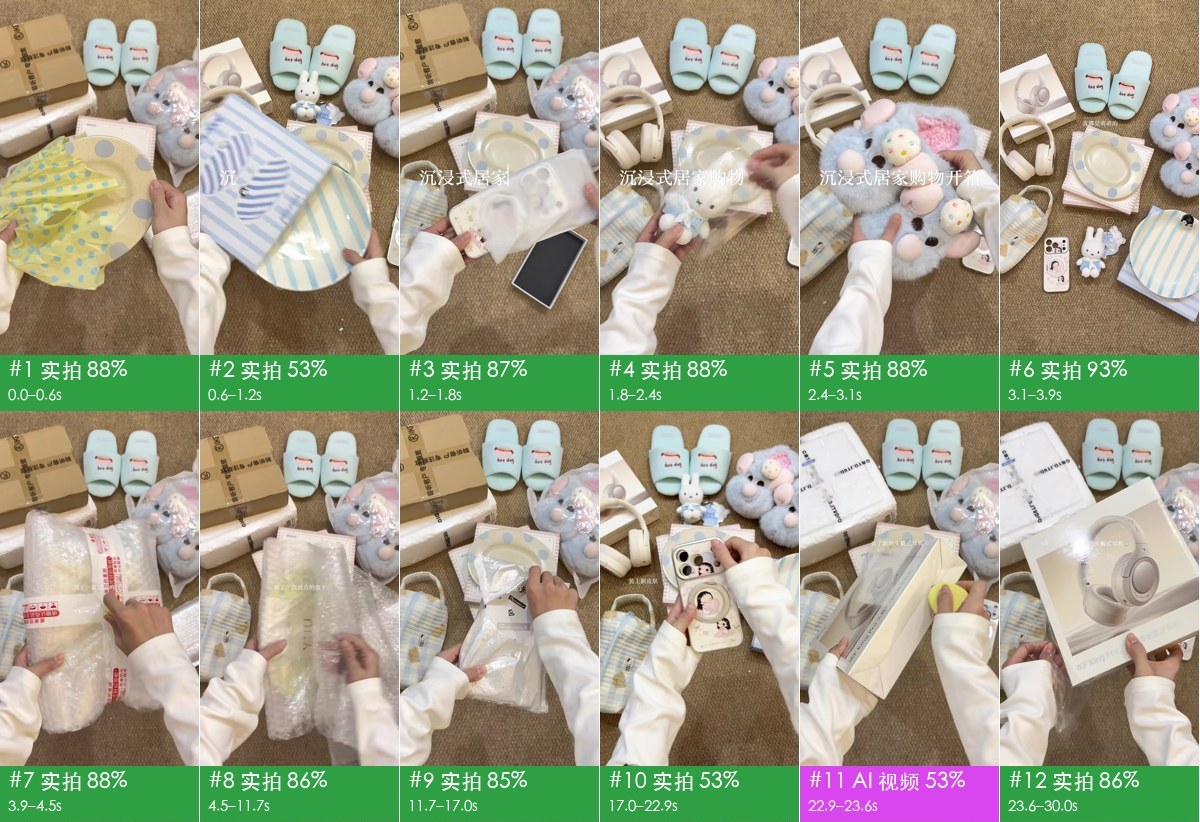 实拍开箱带货 · 72 秒 · 29 镜 全部实拍:头顶俯拍支架、一块地毯一个机位,无口播,同期声 + 曲库 BGM。平台转码后,工具把 35% 判成了 AI,agent 看图复核后回到 97% 实拍。 视频 · 报告 |
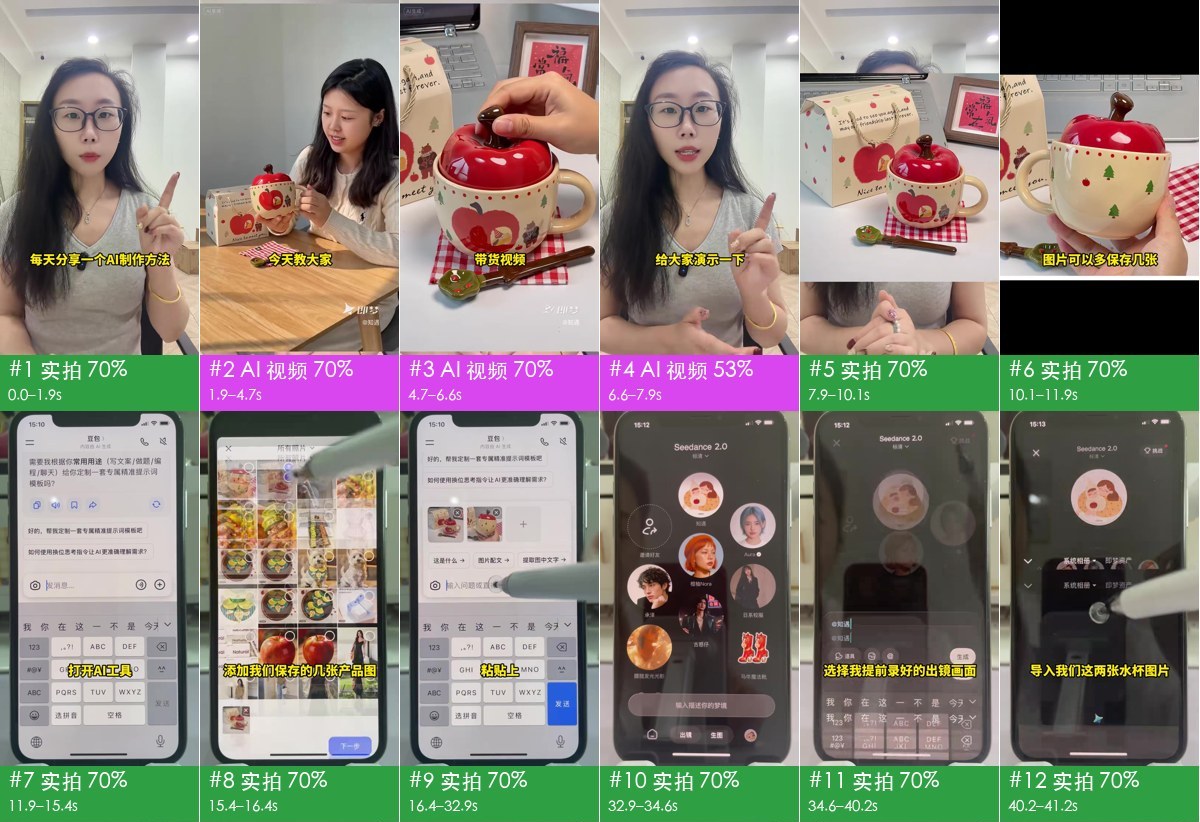 AI 与真人混合 · 58 秒 · 21 镜 实拍 75%(口播 + 拍手机屏幕演示)+ AI 25%:作者拿自己的出镜视频和两张商品图,在即梦里生成「真人带货」片段。靠即梦水印和礼盒乱码认出 AI 段。 视频 · 报告 |
复刻效果
rea-video 拆完,交给 capsule-cinema 的复刻配方生成:运镜、动作、节奏、转场跟着原片走,只换你指定的元素。 目前的效果是用自己部署的 MiniMax H3 生成的:原镜头当动作参考,换好元素的关键帧(gpt-image-2)定长相和场景。 下面是公众号文章里 OiiOii 做过的三组复刻,每组我们做了两版:和 OiiOii 同样的换法,以及把主体、场景、道具一起换掉。 每个动图里四格同步播放:原片、OiiOii 复刻、我们的复刻、换元素版。
|
俯拍换装 · 12 秒 同款:女生换成男生,三套衣服换成对应男装。换元素:古风少女、三套汉服、中式书房,遥控器换成团扇。 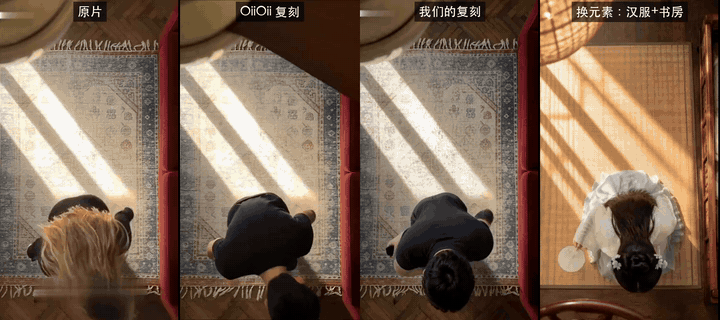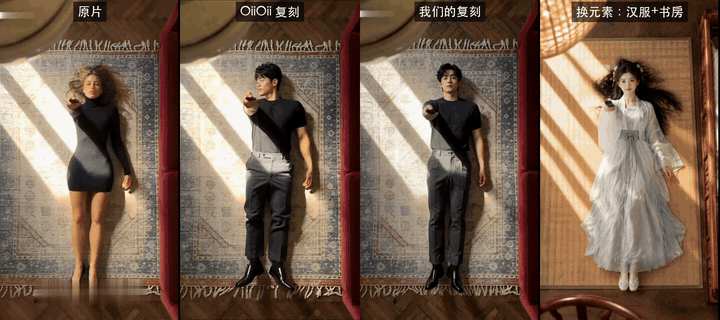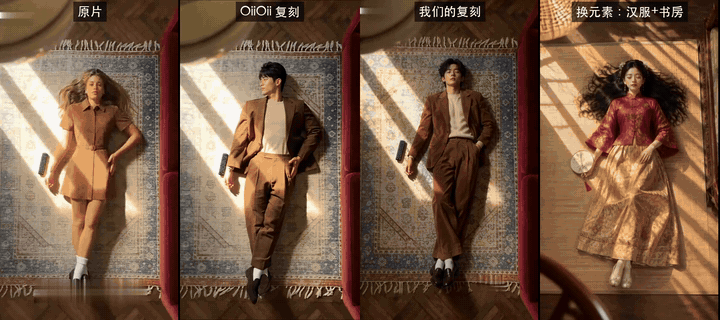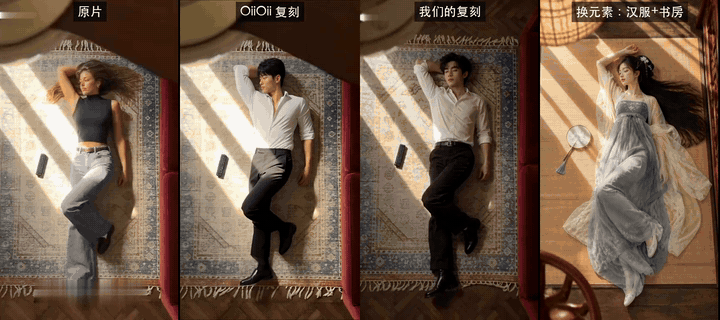 高清对比视频(带声音) · 同一时刻抽帧 |
|
纸艺 / 水彩动画 · 30 秒 同款:主角换成黏土小女孩。换元素:主角换成小狐狸,森林换成海底,云端换成星空,晚霞换成极光。 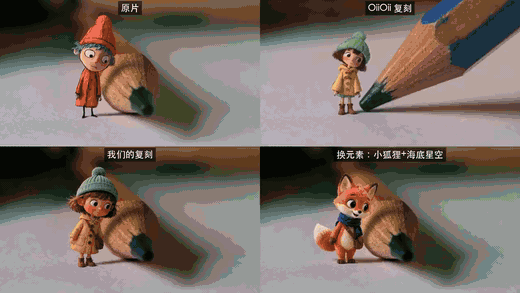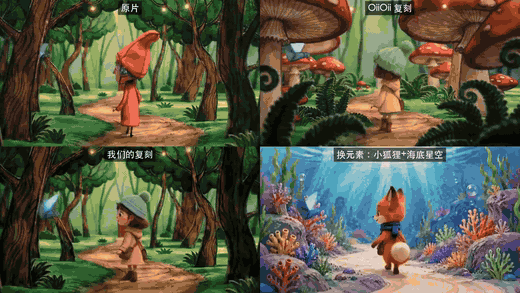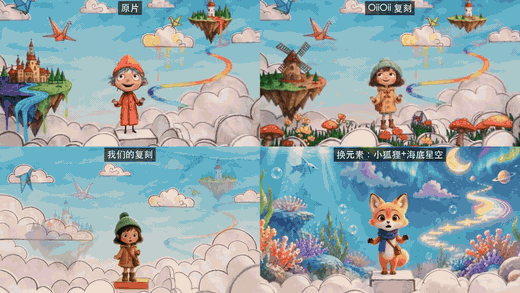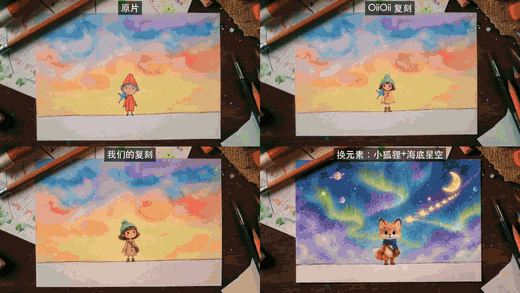 高清对比视频(带声音) · 同一时刻抽帧 |
|
实拍带货 · 21 秒 · 11 镜 同款:产品换成原创新款,英文贴字换成中文。换元素:樱花粉产品,厨房换成户外露营,食材换成草莓、燕麦奶、猕猴桃。 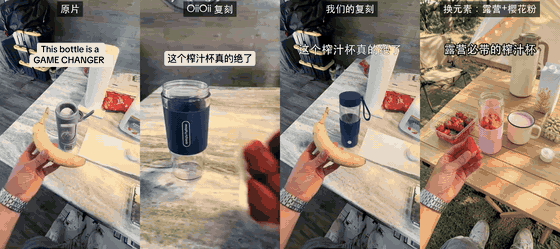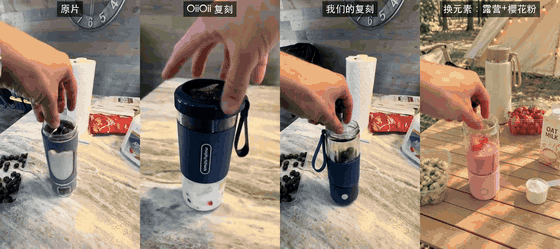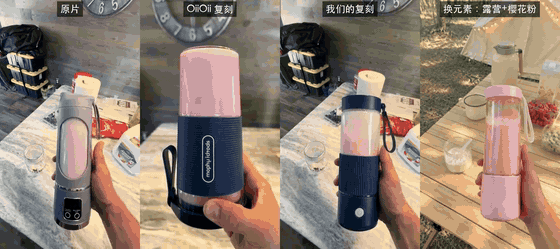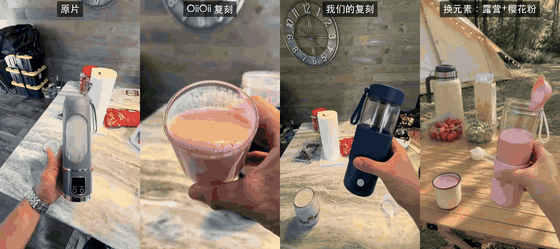 高清对比视频(带声音) · 同一时刻抽帧 |
高清对比视频的声音用原片。原片和 OiiOii 版取自公众号文章,仅用于对比展示。
准不准
按镜头时长算的「制作方式」准确率:
| 调参集(15 条) | 留出集(16 条) | 公众号转码视频(10 条) | |
|---|---|---|---|
| 只用工具(离线、免费) | 98.3% | 99.6% / 98.9% | 88.6% |
| + 看图模型(Gemini) | — | 99.6% / 99.8% | 99.6% |
| + agent 看图复核 | — | 99.6% / 99.8% | 100% |
留出集的两个数分别是 holdout(9 条)和 holdout2(7 条)。
原始文件只用工具基本就够了。从平台下载的视频压缩过,噪点证据没了,要靠看图才能回到 99% 以上。
抖音带货两条(实拍开箱、AI 与真人混合)只用工具 46%,开看图模型 64%,agent 看图复核后 97.5%:拍真实手机屏幕的画面工具会判成 3D / AI,目前要靠看图纠正。
真实素材识别 97–99%,镜头切点全对。明细和复现方法在 eval/RESULTS.md。
怎么判断的
- 切镜头:把视频按镜头切开,声音拆成人声、配乐、音效。
- 取证据:测画面(帧率规律、噪点、是不是整张图在推拉、文件里有没有 AIGC 标识);看图(手指、文字、物理细节对不对);听声音(BPM、调性、是唱还是说)。
- 综合判断:AIGC 标识、帧率这类硬证据优先于「看起来像」。几方意见冲突时标出来,交给 agent 看图复核。
- 出复刻方案:按目标视频模型的实际能力分批,比如单次能生成多长、能不能一次出多个镜头、能吃几张参考图。
Star History
常见问题
和 Hypit 这类一键复刻工具有什么区别?
Hypit 拿一条参考视频直接做一条新片:agent 看抽帧理解原片,再用它接入的模型(Seedance、PixVerse、MiniMax、Wan 等)生成画面,字幕和动效用 HTML 渲染出来。
它不区分原片是怎么做的。原片是实拍的,它照样按自己的流程重做,不会告诉你原片几个机位、怎么打光。AI 视频能做到什么程度,取决于它接了哪些模型:没有可灵、Veo,也没有专门的数字人和 3D;不生成 AI 配乐,配乐要自己准备。它最顺手的是口播、播客、采访这类跟着台词走的视频,纯音乐卡点、产品动效、电影感短片要弱一些。
rea-video 不直接出片。它先逐个镜头判断是拍的、AI 生成的还是代码做的,再分别给拍摄方案、提示词或代码思路。想马上做一条同款,用 Hypit 更快;想弄清原片怎么做、怎么少花钱做出来,用 rea-video。两个可以一起用。
一定要配看视频的模型吗?要花多少钱?
不一定。只用工具是离线、免费的,原始文件的准确率已经很高。从平台下载、压缩过的视频建议配一个能看视频的模型(Gemini、豆包都行),或者用本身能看图的 agent。模型按你用的服务计费。自动生成视频(capsule-cinema)会先免费试跑一遍,你确认后才会正式调用模型。
能自动把整条视频复刻出来吗?
可以做「换元素复刻」:用 capsule-cinema 的复刻配方,原片的运镜、动作、节奏和声音不变,把人物、产品、服装、场景换掉,整条自动生成并拼回原时间线(见上面的「复刻效果」)。 想按原样重做:AI 镜头可以自动生成;实拍镜头要你按拍摄方案去拍;代码镜头要 agent 写 Remotion 工程。详见 docs/replicate.md。
可以拿别人的视频直接搬运吗?
不可以。rea-video 用来学习视频的结构、节奏和做法,再用你有权使用的素材重新制作。请勿直接搬运他人的画面、音乐、角色或肖像。投放时请遵守平台规则和当地的 AI 生成内容标识要求。
文档
- docs/what-it-detects.md:能拆出什么(10 类画面、拍法、打光、调色、声音)
- docs/replicate.md:拿到报告后怎么复刻
- docs/cases.md:案例详情
- docs/decompose.md:判断规则
- docs/cli.md:命令行用法、和 capsule-cinema 的对接
- rea_video/capabilities/:各家视频 / 图像 / 音频模型的能力表,复刻方案按它选模型
社区
欢迎来 linux.do 交流使用体验、拆解案例和复刻思路。也可以加入 Discord 聊天。
有想拆的视频,开一个「求拆解」issue,贴上链接就行,拆完会发成案例。
也欢迎加微信交流群:拆视频时遇到的问题、判断制作方式的方法、复刻经验和案例,都可以在群里交流、分享:
致谢
思路来自 REA(Reverse Engineer Anything):从现象一路追到实现,结论都附证据,并且用测量来验证。