
Human-Agent-Society/reef has 7,799 GitHub stars and 733 forks. GitHot measured +9 in 7 days. Last checked 2026-11-10 21:28 UTC. Last push 2026-11-07.
Infrastructure for continually self‑improving agents
实测星标增长
- 24小时
- 更新延迟
- 7天
- +9
- 15天
- 正在收集历史
- 1个月
- 正在收集历史
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
README.zh.md
原文
面向持续自我进化 Agent 的基础设施


English | 中文
Reef 是首个面向持续自我进化 Agent 的开源基础设施。它连接 Agent 推理、反馈、学习与 版本化交付。你可以用它配合 Slime 和 SGLang 训练模型权重,也可以改进 Agent 的 harness,包括提示词、规则和技能。
🚀 快速上手 | 🗺️ 路线图 | 🗓️ Office Hours | 📣 发布文章 | 💬 加入 Discord | 📱 加入微信群
🎯 何时使用 Reef
如果你希望 Agent 通过与你的日常交互不断学习、持续进化,就适合使用 Reef。
| 你的目标 | 学习路径 | 所需条件 |
|---|---|---|
| 持续获得更贴合自身需求的强大模型 | 模型权重训练 | 可训练模型、受支持的 GPU 栈,以及 recipe 可利用的反馈 |
| 让 harness 自我进化 | Harness 优化 | 模型端点、有代表性的任务和评估器;无需本地训练 GPU |
| 进行科学发现 | 测试时训练 | 执行环境、正确性检查器和可度量的目标 |
🧩 Reef 在技术栈中的位置
| 能力 | 推理引擎(vLLM、SGLang…) | RL 训练框架(Slime、veRL、AReaL…) | Reef |
|---|---|---|---|
| 承接线上流量 | ✅ | ❌ | ✅ |
| 训练权重 | ❌ | ✅ | ✅ |
| 版本管理 | ❌ | ❌ | ✅ |
| 更新期间持续服务 | ❌ | ❌ | ✅ |
| 可进化权重以外的部分(技能、harness) | ❌ | ❌ | ✅ |
🔄 工作原理
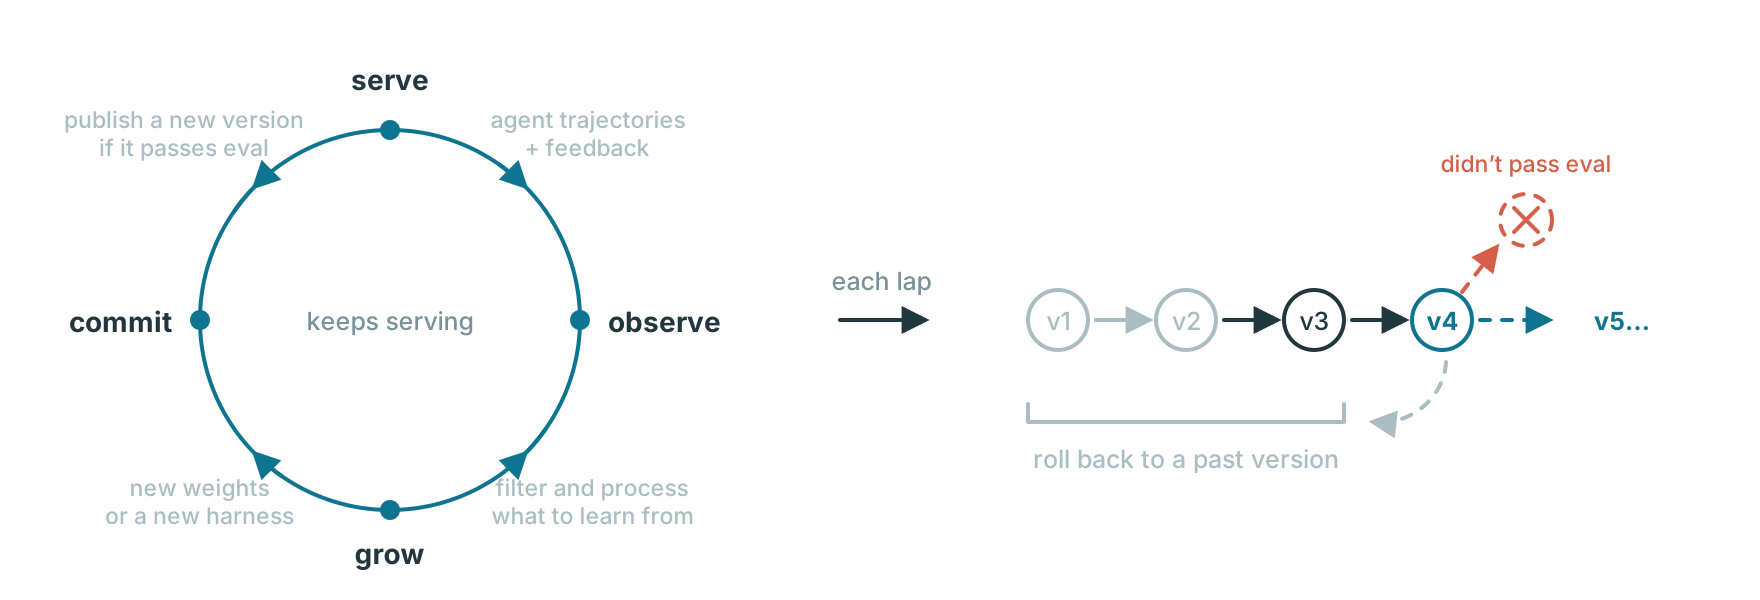
Reef 的每个学习周期分为四步,下表同时列出各步骤对应的模块。
| 步骤 | 说明 | 对应模块 |
|---|---|---|
| 1 · Serve | 响应 Agent 请求,记录每次交互。 | service/ — Agent 请求与交互记录inference/ — 推理与 artifact 更新 |
| 2 · Observe | 将反馈匹配到已记录的交互。 | storage/records.py — 已存储的交互与反馈record2sample/ — 反馈匹配、条件判定与样本生成 |
| 3 · Grow | 从符合条件的记录中产出一次更新。 | recipe/ — recipe 接入train/ — 训练管线、训练任务数据(job data)与训练任务 |
| 4 · Commit | 应用配置的选择策略并发布通过的更新。 | evaluation/ — 候选评估artifact/ — 版本历史与 release 组件 |
📦 安装
💡 注意
Reef 的 artifact 和 checkpoint 功能依赖系统的
git-lfs包。Reef 会在本地为自身的 artifact 仓库初始化 Git LFS。
推荐使用 uv 管理依赖,下文命令均基于 uv。
通过 PyPI 安装
uv venv && source .venv/bin/activate
uv pip install reef-infra
python3 -c "import reef; print(reef.__version__)"
通过源码安装
git lfs install
git clone https://github.com/Human-Agent-Society/reef.git
cd reef
uv venv && source .venv/bin/activate
uv pip install -e .
python3 -c "import reef; print(reef.__version__)"
开发或运行下文的训练示例时,请使用源码安装。
🔧 使用 Reef
Reef 支持两类学习载体:模型权重和 Agent 的 harness。每个部署使用的 recipe 决定其 scenario 更新哪一种载体。
作为最小示例,将 Reef 启动为纯推理服务:
uv run reef serve --inference.model-path Qwen/Qwen2.5-1.5B-Instruct
模型权重训练部署
启动部署
下面的示例启动 SAO(arXiv:2607.07508)示例部署。请在 Reef 源码目录下运行,并确保 运行环境满足进化你的模型中的 GPU 要求。
uv pip install -e ".[slime]" && uv pip install --no-deps --group runtime

export MODEL_PATH="Qwen/Qwen2.5-1.5B-Instruct"
export REEF_TOKEN="reef-local"

reef serve -c recipes/sao/examples/imo_answerbench/serve.yaml \
  --inference.model-path "$MODEL_PATH" \
  --reef.port "8900"

curl -f http://127.0.0.1:8900/healthz          # ready to serve
发送推理请求并上报反馈
将推理请求发送至 Reef,并为每个响应上报分数。SAO recipe 使用每条符合条件的带分 rollout 执行一次训练。
Reef 的推理端点兼容 OpenAI 和 Anthropic:/v1/chat/completions、/v1/responses 与 /v1/messages
直接接收相应模型提供商的请求体。请求需包含 x-reef-scenario 请求头;新的名称会使用
部署配置的 recipe 创建 scenario。请求本身不选择 recipe。
响应体使用模型提供商的 OpenAI 兼容格式。Reef 会添加 x-reef-agent-record-id 响应头,
其值是后续报告用来标识本次交互的回执。报告可以包含数值 score、文本或结构化
feedback,以及它所评估的回执。下面的示例同时上报分数和简短说明。
import os
import httpx

reef = httpx.Client(
    base_url="http://127.0.0.1:8900",
    headers={"Authorization": f"Bearer {os.environ['REEF_TOKEN']}", "x-reef-scenario": "hello-reef"},
    timeout=300,
)

# Send a provider-compatible inference request
response = reef.post(
    "/v1/chat/completions",
    json={
        "model": os.environ["MODEL_PATH"],
        "messages": [{"role": "user", "content": "Return exactly: reef is ready"}],
    },
)

response.raise_for_status()
receipt = response.headers["x-reef-agent-record-id"]
answer = response.json()["choices"][0]["message"]["content"]

# Sending report about the inference
matched = answer.strip() == "reef is ready"

reef.post(
    "/reef/report",
    json={"score": float(matched), "feedback": "matched" if matched else "wrong answer", "references": [receipt]},
).raise_for_status()
部分 recipe 需要的不止一个分数,feedback 用于承载更丰富的信号,可以是纯文本或
结构化对象。端点会校验上报 schema(reef/core/reports/)。
观察学习与进化
反馈积累到一定数量后,Reef 会向训练组件提交一个训练任务。任务保存的检查点通过评估后,推理运行时会将其作为新版本加载。 后续推理请求直接使用当前版本,无需重启 Reef。
Harness 进化部署
用模型 API(而非 GPU),根据打分反馈进化编码 agent 的 skills 和 rules。
Harness 部署服务的是 reef.recipe.harness:HarnessEvolutionRecipe。该 recipe 把 agent 的 harness 保存为一个文本文件 tree。每一步,method 根据该步的 trace 修改这个 tree 的副本,评估用候选版本让真实的 agent 运行任务,胜出的候选版本发布为任何客户端都能拉取的 release。Harness 进化教程在 pi 上运行最小的完整循环。它需要一个 OpenAI 兼容端点,以及供 pi 使用的 Node.js 和 npm。在 Reef checkout 和已激活的 Python 环境中:
cd tutorials/evolve-your-harness
./run.sh
configs/serve.yaml 指定端点(inference.upstream-url,不带 /v1 后缀)和模型(inference.upstream-model)。把它们改成你自己的 provider;端点需要密钥时设置 REEF_UPSTREAM_API_KEY。run.sh 在 127.0.0.1:8900 启动 Reef,经由它发送任务、上报每个分数,并拉取已发布的 tree。每次运行都会写出 work/replay.html,其中包含 release 链和每个步骤修改的文件。
GET /reef/harness 提供已发布的 tree,按部署的 adapter 渲染。这些文件不含端点、密钥或模型:客户端把它们写到 agent 读取的位置,并把 agent 的模型绑定到这个 Reef(见 Use a published tree)。请把 tree 放在 agent 工作的项目之外:会话可以写入其项目中的文件,tree 若在项目内,就可能改变下一个会话运行的内容。Evolve agent prompts, rules, and skills 说明了该循环及其配置。
📚 Recipes 与示例
根据工作负载的任务类型和希望进化的对象(模型权重或 Agent 的 harness)来选择
recipe。进化权重的 recipe 需要 GPU 训练栈,而 harness recipe 只需要一个模型端点。下表中每个
recipe 链接到其指南,每个已测 benchmark 链接到其结果页,Recipe 目录
还列出了每个 recipe 的代码和示例。SFT
随 reef-infra 内置提供,在 demonstration 或导入的样例上训练,适用于所有任务类型。
其他实现位于本仓库的 recipes/ cookbook 中,通过带点号的类路径指定,不随 Reef wheel 发布。
| 任务类型 | 任务形状 | 进化模型 | 进化 harness | 标准 benchmark |
|---|---|---|---|---|
| 开放式发现 | 对一个有可度量目标、没有已知答案的难题反复尝试 | TTT-Discover、Guidance-TTT | 暂无 | 已测:TriMul、圆填充、Erdős 最小重叠。 |
| 有已知答案的离线任务 | 来自固定集合的独立任务,每个都有参考答案 | SAO、SDFT、SDPO、OPD | GEPA、Meta-Harness | 已测:IMOAnswerBench、AIME 2024、AIME 2025、SciKnowEval、ToolAlpaca、Terminal-Bench。 |
| 从使用中在线学习 | 与用户的会话,交互本身就是信号 | OpenClaw-RL | ACE、ReasoningBank | 已测:GSM8K 与模拟学生用户。 |
recipes/basic/ 是只记录、不学习的起始栈,不在目录之内。如果想快速了解
反馈、候选修改和发布流程,可以从编程 harness 教程开始。
每个结果页面都会说明任务、评估设置、测量结果和局限性。
📐 架构
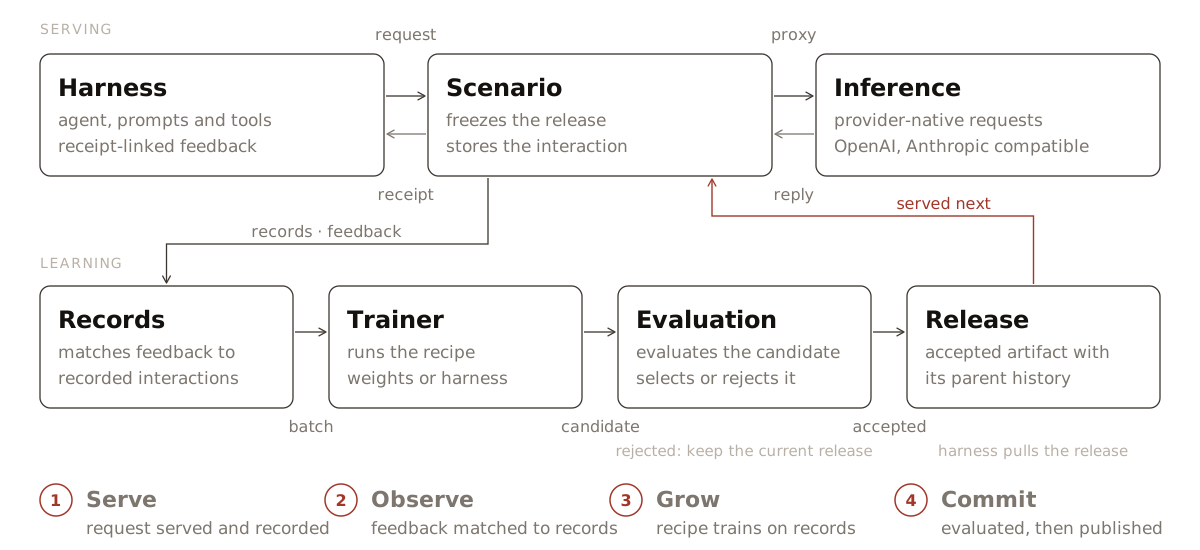
📖 进一步了解
文档按以下顺序组织:
- 快速上手:安装 Reef,接入客户端,查看版本历史
- HTTP API:使用 HTTP API 并上报反馈
- 编写 recipe:配置 Reef 如何处理数据、产出更新
- 进化你的 harness:不训练权重,改进 harness
- 进化你的模型:配置并运维训练部署
- Recipes:按任务类型整理的 cookbook recipe 目录,含各自的代码、文档、示例和结果
- 核心循环:Reef 的核心循环
- 术语表:文档所用术语的解释
🤝 社区与贡献
你是否也在研究持续自我进化的 Agent?
- 加入 Discord,分享 recipe、交流实现细节、讨论新功能。
- 加入微信群:群已满,扫码添加小助手拉你进群。
- 在 GitHub Discussions 提问、分享想法、与社区交流。
- 参与开发请从贡献指南开始。
- 设计方案请通过 RFC issue 提出。
- 发现疑似漏洞请按安全策略私下反馈。
如果 Reef 对你有帮助,欢迎点个 Star ⭐,让更多人发现并参与进来。
📚 引用
如果你在研究中使用 Reef,请引用:
@misc{reef2026,
  title  = {Reef: Infrastructure for Continually Self-Improving Agents},
  author = {{Reef Contributors}},
  year   = {2026},
  url    = {https://github.com/Human-Agent-Society/reef}
}
引用元数据也可在 CITATION.cff 中获取。
👥 团队
Reef 汇聚了一群探索 Agent 如何从经验中学习、持续进化的人。以下成员共同将这一想法 变成可用的基础设施。
这份名单并未列尽所有团队成员,以下按姓氏字母顺序排列:
Wenhao Chai, Shuangrui Ding, Shiyi Zoe Du, Hao He, Haoze He, Chonghe Jiang, Nan Jiang, Xuan Jiang, Xiaochen Li, Paul Liang, Bo Liu, Boyuan Long, Qiuyang Mang, Zhenting Qi, Ao Qu, Mingruo Qu, Yihong Tang, Zhaokai Wang, Xuezhi Yan, Hanfei Yu, Haofei Yu, Simon Yu, Han Zheng, Kaichen Zhou, Zijian Zhou, Jiacheng Zhu, Dingyi Zhuang, Xinkai Zou.
⭐ Star History
🙏 致谢
以下项目支撑了 Reef 的关键部分,在此感谢:
探索相关项目
affaan-m/ECC
智能体执行与控制框架的性能优化系统。面向 Claude Code、Codex、Opencode、Cursor 等,涵盖技能、本能、记忆、安全与研究优先的开发。
300,735 星标NousResearch/hermes-agent
与你一同成长的智能体
262,416 星标multica-ai/andrej-karpathy-skills
一个用于改进 Claude Code 行为的 CLAUDE.md 文件,源自 Andrej Karpathy 对 LLM 编程陷阱的观察。
231,833 星标firecrawl/firecrawl
借助来自网络及其他来源的数据,强化你的 AI 智能体。正在构建面向超级智能的资料库。🔥
200,444 星标