
CVHub520/X-AnyLabeling
CVHub520/X-AnyLabeling has 10,902 GitHub stars and 1,207 forks. GitHot measured +10 stars in 24 hours and +54 in 7 days. Last checked 2026-11-06 19:57 UTC. Last push 2026-11-02.
X-AnyLabeling:一款轻量、高效且统一的跨平台桌面应用,用于标注文本、图像、视频、点云和多模态数据,集多样的内置工具、先进的 AI 模型与灵活的多格式导出于一体。
可以做什么
- Unified support for annotating and processing text, image, video, point cloud, and multimodal data.
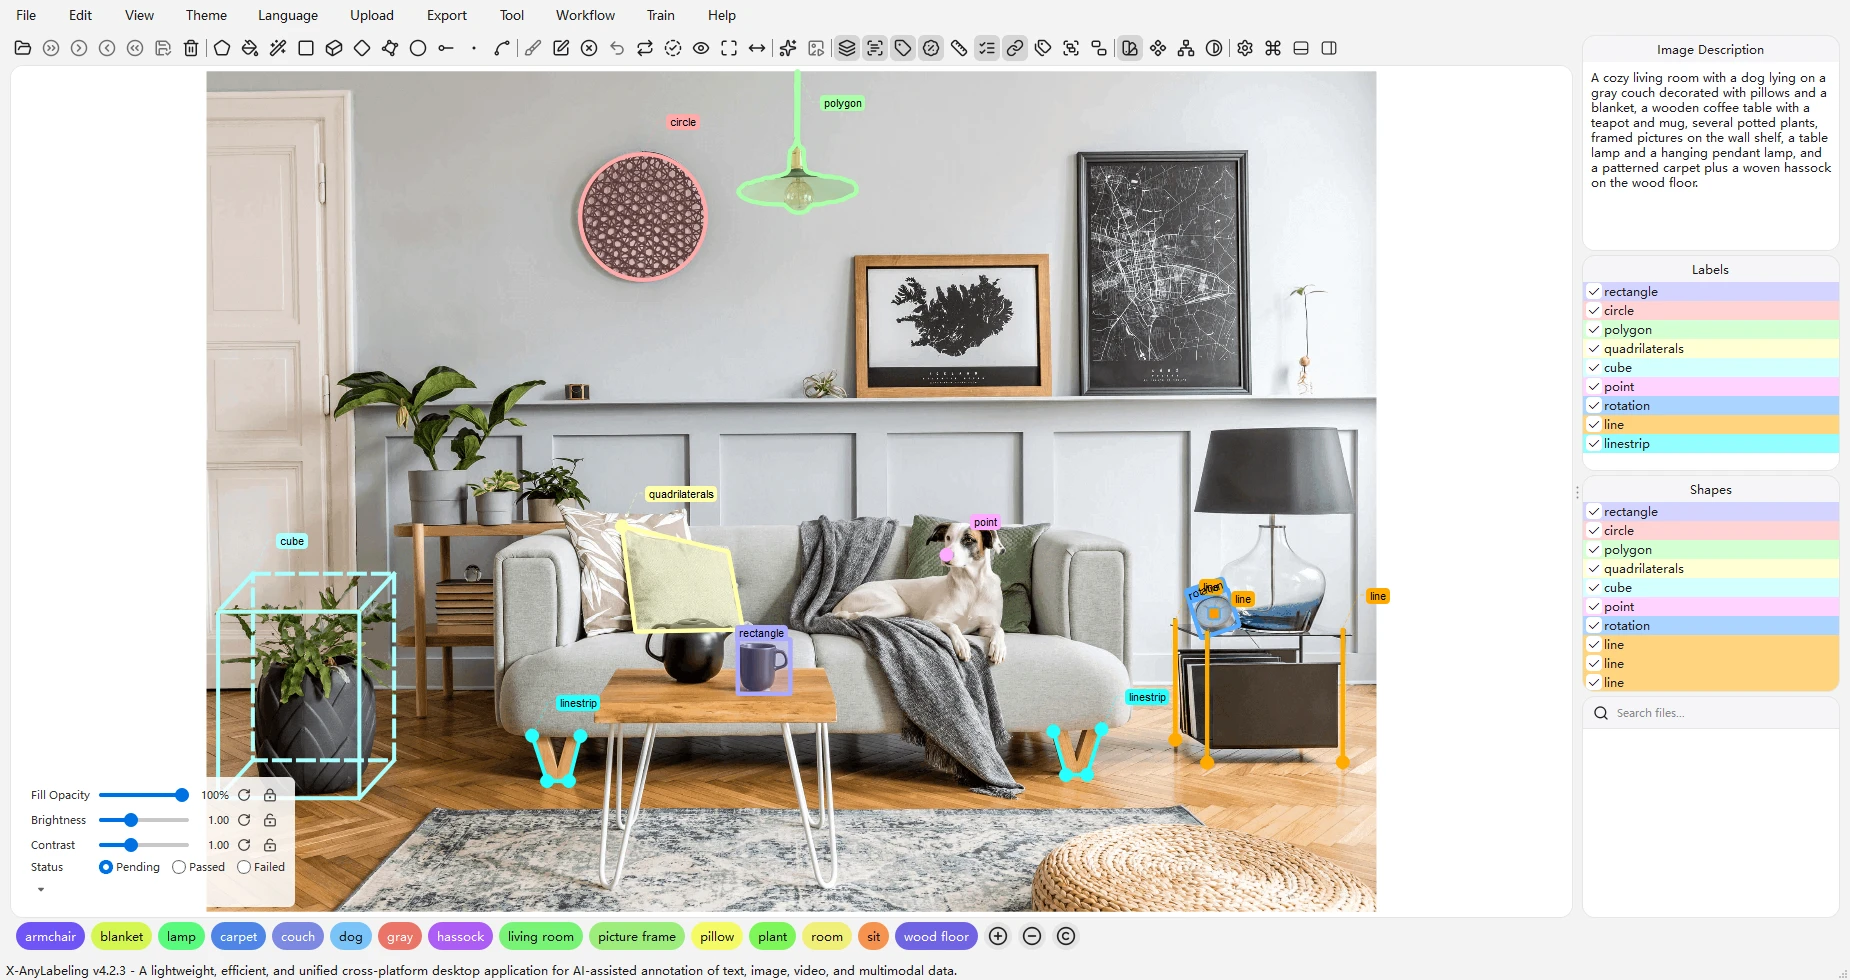
- Covers tasks such as 2D image classification, object detection, instance segmentation, pose estimation, oriented object detection, multi-object tracking, optical character recognition, lane annotation, image captioning, visual question answering, document parsing, and 3D point clouds.
- Provides polygons, rectangles, cuboids, rotated boxes, quadrilaterals, circles, lines, polylines, points, masks, and task-specific tools for text detection, text recognition, relation recognition, and KIE.
- Integrates a wide range of state-of-the-art deep learning models for AI-assisted annotation, automated labeling, and batch dataset prediction.
实测星标增长
- 24小时
- +10
- 7天
- +54
- 15天
- 正在收集历史
- 1个月
- 正在收集历史
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
README_zh-CN.md
原文



🥳 新功能
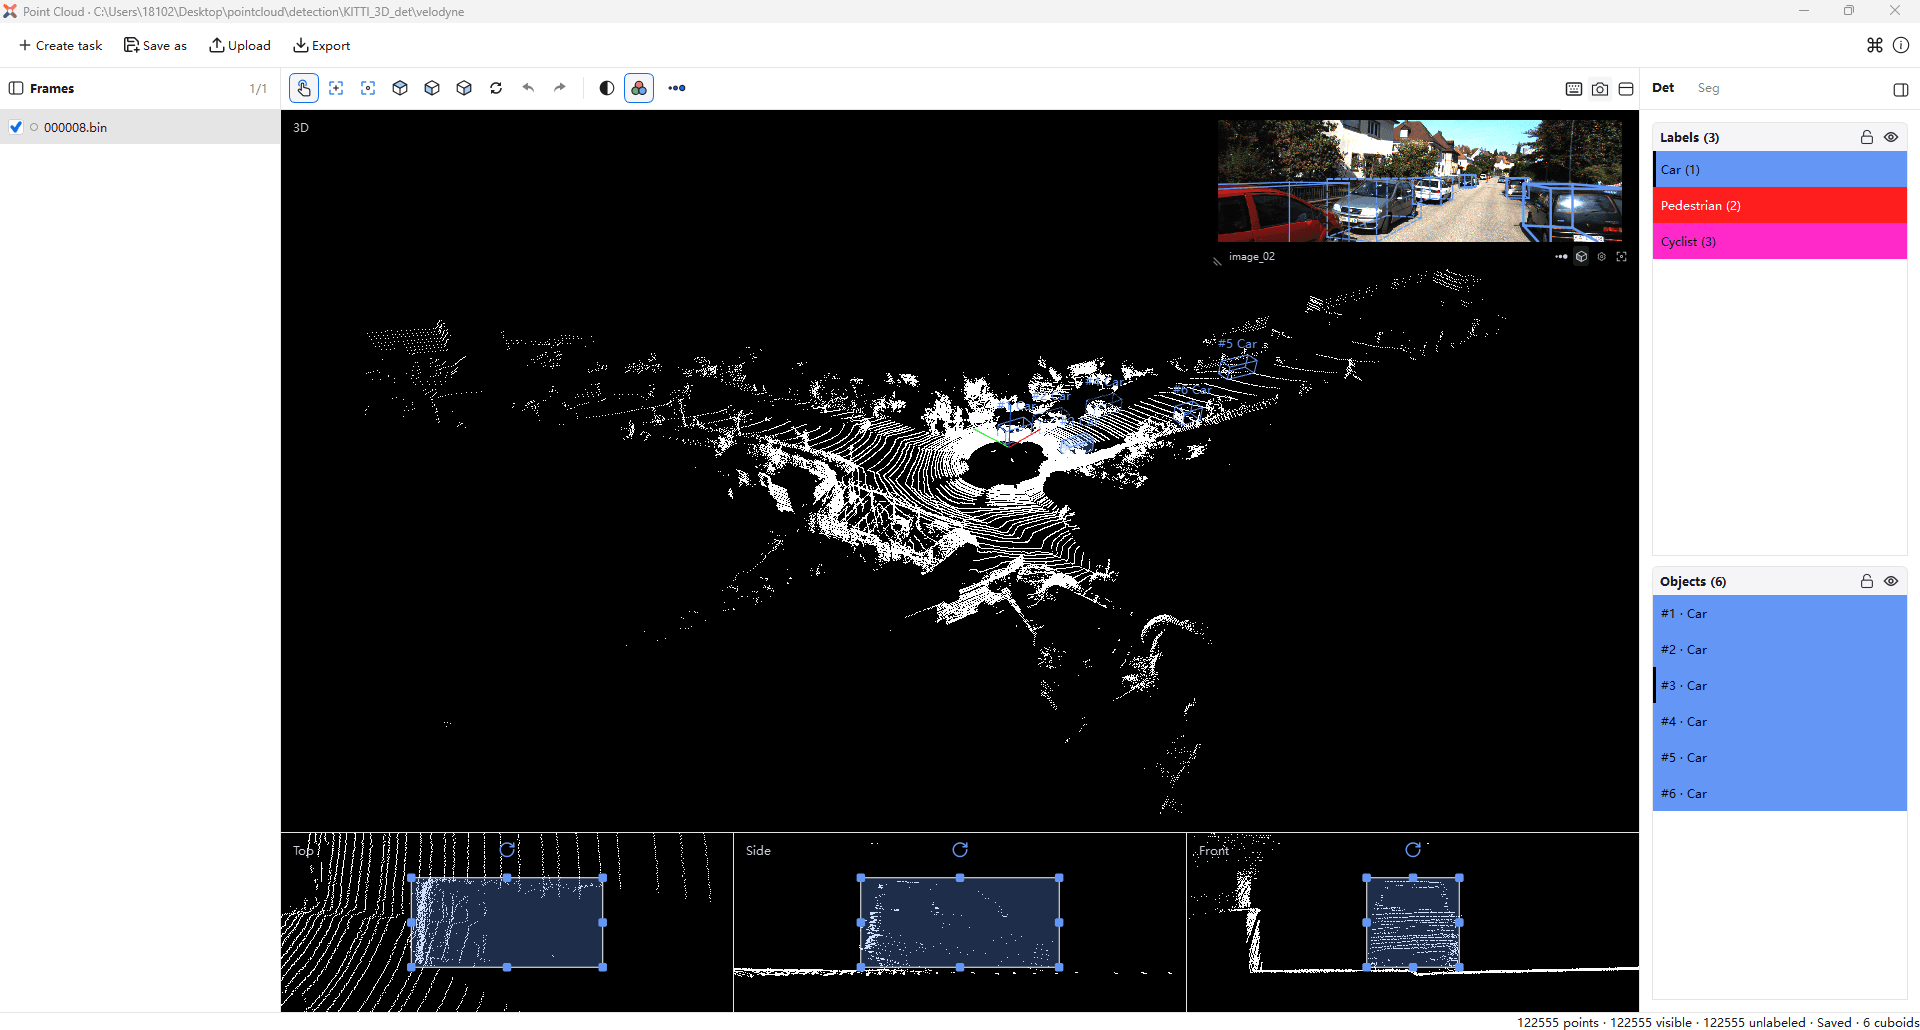
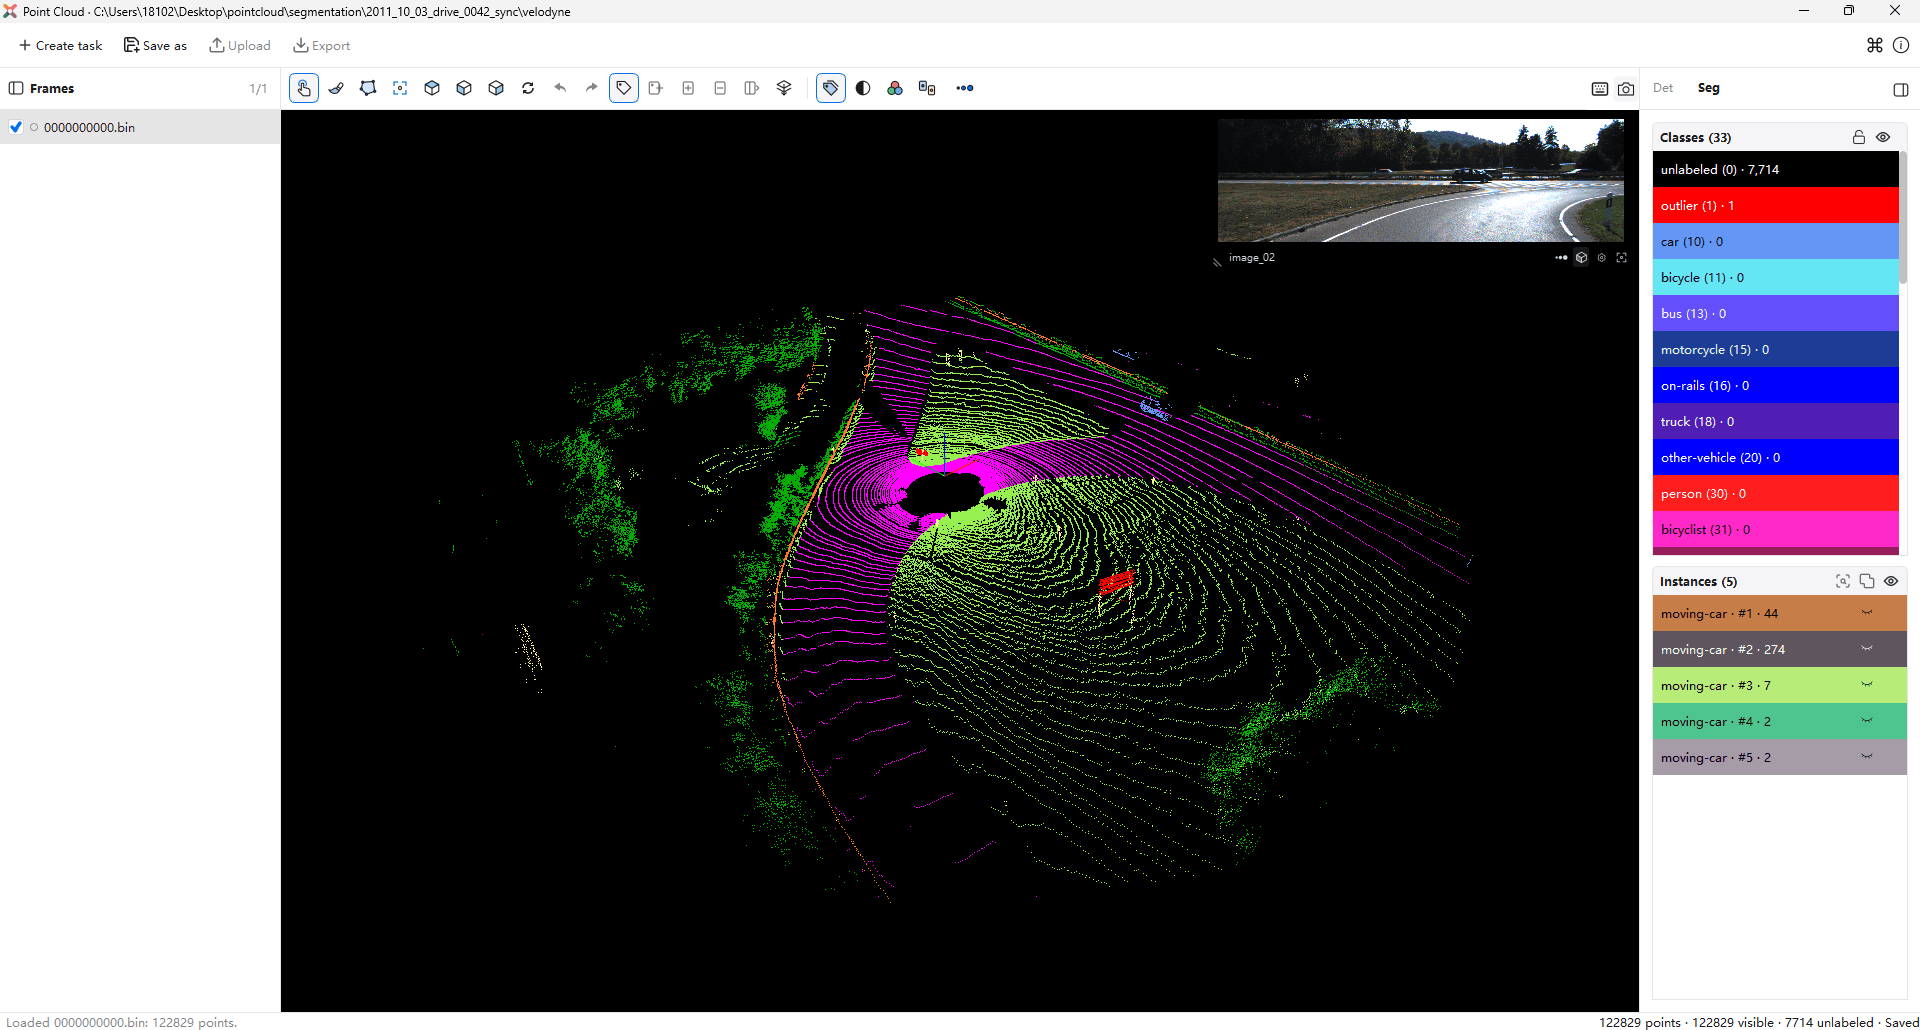
2026-11-03:新增可调整的图像网格,支持显示网格编号,方便检查标注。2026-11-01:新增支持 RelateAnything 目标关系预测模型。2026-10-31:新增对象级多任务属性标注,支持 AI 标注及并发推理。2026-10-30:新增支持 Unlimited-OCR-2 模型,支持图像、PDF 文档解析与多页上下文识别。2026-10-28:新增支持 WeVisOne-VL 模型,支持目标检测、描述定位、目标指点、计数、OCR、文本定位、分割、文本及框提示抠图、参考框检测和自由提示。2026-10-28:新增支持 Xiaomi-Lens-0 模型,支持描述理解与分割、多实例定位、推理分割、具身指令定位及细粒度感知。2026-10-27:新增标注显示模式,支持按类别、实例或群组配色,以及黑色背景、白色前景的二值掩码视图。2026-10-27:新增支持正方形标注。2026-10-24:支持画布上的平滑缩放、自由平移和边界裁剪。2026-10-18:新增支持 GroundingPI、GroundAnything 和 GroundAnything-VLM 模型,支持目标检测、描述定位、描述与类别指点、OCR、文档版面分析、GUI 定位及参考框检测。2026-10-01:新增 3D 点云标注功能,支持 3D 点云检测与分割。2026-08-19:新增图片标签功能,支持标签新增、编辑、排序及批量删除。2026-08-12:新增支持 D-FINE-seg 实例分割模型。2026-08-08:新增支持 RT-DETRv2-OBB 旋转目标检测模型。2026-08-08:新增魔术棒工具,可基于连续颜色区域快速创建多边形标注。2026-08-05:发布 X-AnyLabeling v4.0.0。- 更多详情,请参考更新日志
简介
X-AnyLabeling 是一款轻量、高效、统一的跨平台桌面应用,面向文本、图像、视频、点云及多模态数据提供 AI 辅助标注能力。它集成了丰富的内置工具、自动化标注工作流、先进的深度学习模型,以及灵活的多格式数据导入与导出能力。对于远程推理场景,X-AnyLabeling-Server 提供轻量且可扩展的后端,用于连接自定义模型和计算资源。
核心特性
- 统一支持文本、图像、视频、点云及多模态数据的标注与处理。
- 覆盖 2D 图像分类、目标检测、实例分割、姿态估计、旋转目标检测、多目标跟踪、光学字符识别、车道线标注、图像描述、视觉问答、文档解析和 3D 点云标注等任务。
- 提供多边形、矩形、长方体、旋转框、四边形、圆形、线段、折线、点和掩码等标注工具,并支持文本检测、文本识别、关系识别和 KIE 等任务专用工具。
- 集成多种先进的深度学习模型,支持 AI 辅助标注、自动标注和数据集批量预测。
- 支持本地与远程推理,可接入
ONNX Runtime、TensorRT、OpenCV DNN、vLLM、SGLang等推理引擎与服务框架。 - 支持导入和导出
COCO、VOC、YOLO、DOTA、MOT、MASK、PPOCR、MMGD、VLM-R1和ShareGPT等多种数据格式。 - 支持 Windows、Linux 和 macOS,并提供英文、简体中文、日文和韩文界面。
- 支持接入自定义模型,并提供灵活的扩展与二次开发能力。
模型库
| 任务类别 | 支持模型 |
|---|---|
| 🖼️ 图像分类 | YOLOv5-Cls, YOLOv8-Cls, YOLO11-Cls, InternImage, PULC |
| 🎯 目标检测 | YOLOv5/6/7/8/9/10, YOLO11/12/26, YOLOX, YOLO-NAS, D-FINE, DAMO-YOLO, Gold_YOLO, RT-DETR, RF-DETR, DEIMv2 |
| 🖌️ 实例分割 | YOLOv5-Seg, YOLOv8-Seg, YOLO11-Seg, YOLO26-Seg, Hyper-YOLO-Seg, RF-DETR-Seg, D-FINE-seg |
| 🎨 语义分割 | U-Net |
| 🏃 姿态估计 | YOLOv8-Pose, YOLO11-Pose, YOLO26-Pose, DWPose, RTMO |
| 😀 人脸估计 | SCRFD, YOLOv6Lite-Face |
| 👣 目标跟踪 | TrackTrack, Bot-SORT, ByteTrack, SAM2/3-Video |
| 🔄 旋转目标检测 | YOLOv5-Obb, YOLOv8-Obb, YOLO11-Obb, YOLO26-Obb, RT-DETRv2-OBB |
| 📏 深度估计 | DepthAnything 1/2 |
| 🔗 关系识别 | RelateAnything |
| 🧩 分割一切 | SAM 1/2/3, SAM-HQ, SAM-Med2D, EdgeSAM, EfficientViT-SAM, MobileSAM |
| ✂️ 图像抠图 | RMBG 1.4/2.0 |
| 💡 候选框提取 | UPN |
| 🏷️ 图像标记 | RAM, RAM++ |
| 📄 光学字符识别 | PP-OCRv4, PP-OCRv5, PP-OCRv6 |
| 🧾 综合版面分析 | PP-DocLayoutV3 |
| 📑 文档解析 | PaddleOCR-VL, PaddleOCR-VL-1.6, Unlimited-OCR-2 |
| 🗣️ 视觉基础模型 | Rex-Omni, Florence2, LocateAnything, GroundingPI, GroundAnything, GroundAnything-VLM, Xiaomi-Lens-0, WeVisOne-VL |
| 👁️ 视觉语言模型 | Qwen3-VL, Gemini, ChatGPT, GLM |
| 🛣️ 车道线检测 | CLRNet |
| 🔢 目标计数 | CountGD, GeCO, GeCo2 |
| 📍 视觉定位 | Grounding DINO, YOLO-World, YOLOE, SAM 3 |
| 📚 其他 | 👉 model_zoo 👈 |
文档
示例
- Classification
- Detection
- Segmentation
- Description
- Estimation
- OCR
- Document Parsing
- MOT
- iVOS
- Matting
- Relation
- VFM
- Counting
- Grounding
- Training
贡献指南
我们欢迎社区协作!X‑AnyLabeling 项目的成长离不开开发者们的共同参与,无论是修复 Bug、优化文档、还是添加新功能,您的贡献都非常宝贵。
在参与前请阅读我们的 贡献指南,并在提交 Pull Request 前确认您已同意 贡献者许可协议 (CLA)。
如果你觉得这个项目有帮助,请点亮右上角的⭐星标⭐。如有任何问题或疑问,欢迎创建 issue 或发送邮件至 [email protected]。
衷心感谢每一位为项目贡献力量的朋友 🙏
许可
本项目采用 GNU General Public License v3.0 许可。您可以使用、修改和重新分发本软件,包括用于商业用途,但须遵守该许可证的相关条款。
赞助
你的赞助将支持 X-AnyLabeling 的功能开发、模型集成、文档完善和社区维护。
致谢
衷心感谢 AnyLabeling、LabelMe、LabelImg、roLabelImg、PPOCRLabel 和 CVAT 的开发者与贡献者,他们的工作为本项目提供了重要基础。
引用
如果您在研究中使用了这个软件,请按照以下方式引用它:
@misc{X-AnyLabeling,
  year = {2023},
  author = {Wei Wang},
  publisher = {Github},
  organization = {CVHub},
  journal = {Github repository},
  title = {X-AnyLabeling: A Unified Desktop Platform for AI-Assisted Data Annotation},
  howpublished = {\url{https://github.com/CVHub520/X-AnyLabeling}}
}