
AutoArk/open-audio-opd
AutoArk/open-audio-opd has 1,112 GitHub stars and 71 forks. GitHot measured 0 in 7 days. Last checked 2026-11-11 00:09 UTC. Last push 2026-06-05.
Industrial audio online policy distillation (OPD) training stack for ASR and TTS, distilling compact audio models from stronger teacher models.
实测星标增长
- 24小时
- 更新延迟
- 7天
- 0
- 15天
- 正在收集历史
- 1个月
- 正在收集历史
各周期内的星标净变化,周期相互重叠,并非每日新增。缺失的测量保持空白。星标代表关注度,不代表软件质量。
README_zh.md
原文


最新动态
2026.05.28: ARK-ASR-0.6B 在线 Demo 已上线。 可在 Hugging Face Space 中直接体验 ASR 模型。
2026.05.27: ARK-ASR OPD 论文已上线 arXiv。 阅读 Data-Efficient On-Policy Distillation for Automatic Speech Recognition。
2026.05.25: open-audio-opd 已在 GitHub 开源。 仓库包含工业级 ASR 在线策略蒸馏训练栈,并支持 FSDP2 分布式训练。
2026.05.25: ARK-ASR-0.6B 模型权重已发布。 可从 Hugging Face 下载紧凑 ASR student checkpoint。
TTS OPD 已进入路线图。 计划中的 TTS recipe 会复用在线 student rollout 和 teacher scoring,并针对语音生成质量、对齐和 acoustic-token 监督做适配。
摘要
open-audio-opd 包含用于从更强教师模型蒸馏紧凑音频模型的生产级音频在线策略蒸馏
(OPD)训练栈。当前版本聚焦 ASR:自回归 ASR student 按 on-policy 方式生成转写,
更强的 teacher 对同一音频和转写进行评分,然后在 union top-k token support 上用
token-level KL 更新 student。
本仓库基于 THUNLP/OPD 和
verl。仓库内包含精简后的 vendored verl/,
使训练脚本可以使用 FSDP2 封装、梯度裁剪和 checkpoint 管理,而不依赖另一份本地
checkout。
仓库不包含音频文件、JSONL 数据集或私有机器路径。所有模型、数据和输出路径都通过 命令行参数显式传入。ASR 模型权重单独发布在 AutoArk-AI/ARK-ASR-0.6B。
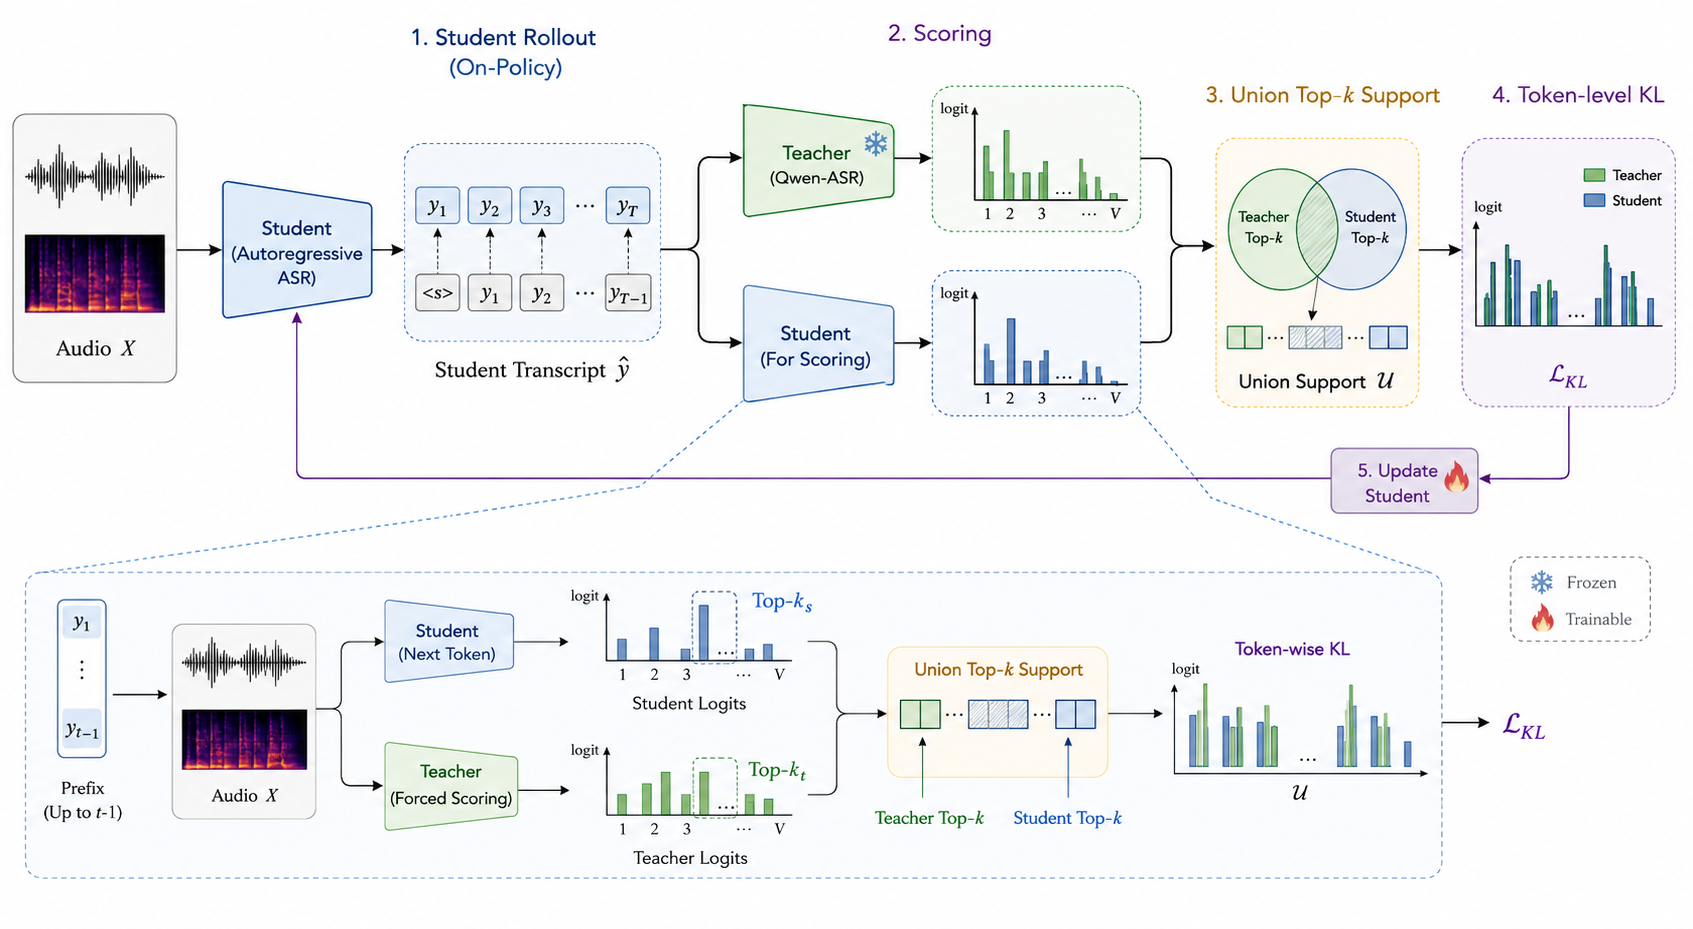
图 1. Audio OPD 基于在线 rollout 和 teacher 在 union top-k token support 上的评分训练紧凑 student。
路线图
| 类别 | 项目 | 状态 |
|---|---|---|
| ASR OPD | FSDP2 在线策略蒸馏 trainer | 完成 |
| Qwen3-ASR 风格 teacher scoring backend | 完成 | |
| 可恢复的 FSDP2 checkpoint | 完成 | |
| 多机 hostfile launcher | 完成 | |
| ASR 推理和 J/WER 评测脚本 | 完成 | |
| 模型发布 | ARK-ASR-0.6B | 完成 |
| TTS OPD | 在线 rollout 和 teacher-scoring recipe | 计划中 |
| 语音生成质量和对齐目标 | 计划中 | |
| Acoustic-token 监督支持 | 计划中 |
模型发布
| ARK-ASR-0.6B | |
|---|---|
| Checkpoint | AutoArk-AI/ARK-ASR-0.6B |
| 任务 | 自回归 ASR |
| 语言 | 中文、英语、德语、日语、法语、韩语、西班牙语、波兰语、意大利语、罗马尼亚语、匈牙利语、捷克语、荷兰语、芬兰语、克罗地亚语、斯洛伐克语、斯洛文尼亚语、爱沙尼亚语、立陶宛语 |
| 训练 recipe | SFT baseline 加 teacher-data adaptation 和 OPD |
| 仓库用途 | 推理、评测和 OPD 继续训练工作流 |
仓库结构
scripts/train/train_ark_asr_opd_fsdp2_resume.py      # main FSDP2 ASR OPD trainer
scripts/run/run_ark_asr_opd_fsdp2_resume_hostfile.sh # multi-node launcher
scripts/infer/ark_asr_transformers.py                # ASR inference
scripts/eval/eval_jwer_ark_asr_transformers.py       # J/WER evaluation
scripts/eval/run_arkasr_eval.sh                      # multi-GPU evaluation launcher
configs/hostfile.example                             # hostfile format example
https://arxiv.org/abs/2605.28139                     # arXiv paper
assets/opd_overview.png                              # OPD overview figure
verl/                                                # vendored verl runtime code
README.md / README_zh.md                             # usage docs
实验结果
Ark-ASR 是 0.6B 参数规模的 ASR student 模型。本组 OPD 实验只使用了 10 万小时 ASR 音频。公开的 Qwen3-ASR technical-report 材料显示,Qwen3-ASR 使用多阶段训练 流程,其中仅 AuT encoder 预训练阶段就使用约 4000 万小时伪标注 ASR 音频,后续还包括 Omni training、ASR SFT 和 ASR RL。在这个对比下,Ark-ASR 使用的音频规模约为公开披露 ASR 预训练音频规模的 1/400,同时达到了与 Qwen3-ASR 0.6B baseline 可比的水平。
Ark-ASR 表示本仓库使用 teacher-data adaptation 和 on-policy distillation 训练并
发布的 0.6B checkpoint。CER/WER 越低越好。
英文 WER
| Model | AMI | Earnings22 | GigaSpeech | LS Clean | LS Other | SPGISpeech | VoxPopuli | Avg |
|---|---|---|---|---|---|---|---|---|
| Ark-ASR | 11.54% | 10.07% | 8.95% | 1.87% | 3.89% | 2.89% | 6.63% | 6.55% |
| Qwen3-ASR-0.6B | 11.66% | 11.06% | 9.14% | 2.13% | 4.45% | 3.03% | 7.07% | 6.93% |
| Qwen3-ASR-1.7B | 10.56% | 10.25% | 8.74% | 1.63% | 3.40% | 2.84% | 6.35% | 6.25% |
中文 CER
| Model | AISHELL-1 | Wenet-meeting | Wenet-net | Avg |
|---|---|---|---|---|
| Ark-ASR | 2.02% | 5.92% | 4.96% | 4.30% |
| Qwen3-ASR-0.6B | 2.07% | 5.57% | 5.45% | 4.36% |
| Qwen3-ASR-1.7B | 1.50% | 4.69% | 4.55% | 3.58% |
主要结论:
- 只使用 10 万小时音频,Ark-ASR 就达到与使用更大公开 ASR 数据规模训练的 Qwen3-ASR 模型有竞争力的水平。
- Ark-ASR 将 Qwen3-ASR-0.6B 的英文平均 WER 从 6.93% 降到 6.55%,并在 Earnings22、GigaSpeech、LS Clean、LS Other、SPGISpeech 和 VoxPopuli 上取得更好结果。
- Ark-ASR 也将 Qwen3-ASR-0.6B 的中文平均 CER 从 4.36% 降到 4.30%,并在 AISHELL-1 和 Wenet-net 上取得更好结果。
- Qwen3-ASR-1.7B 整体仍然更强,但 Ark-ASR 在保持 0.6B 参数规模的同时缩小了与更大 ASR 模型之间的差距。
训练方法
ASR OPD 使用在线 rollout 和 teacher score 训练 student ASR 模型:
audio batch
  -> student generates transcript tokens with no grad
  -> teacher scores the same audio plus the student transcript
  -> student scores its own transcript with gradients
  -> build teacher/student union top-k support
  -> optimize KL(teacher || student) on aligned transcript positions
  -> save FSDP2 checkpoints that can be resumed
关键点是 teacher 不提供静态转写标签,而是对 student 在线生成的内容进行评分,因此 student 学到的是自身当前行为下的 teacher 偏好分布。
Student 和 Teacher
--student_model 是可训练的、支持音频输入的 ASR 模型。它必须能通过
AutoModelForCausalLM.from_pretrained(..., trust_remote_code=True) 加载,并且它的
processor/tokenizer 必须支持脚本使用的音频 prompt 格式。student 会被 FSDP2 包裹并接收梯度。
--teacher_model 是用于评分的更强 ASR 模型。它以 eval mode 加载,不接收梯度。支持的
teacher backend 包括:
qwen3_asr_teacher_forcing: Qwen3-ASR 风格 teacher 的默认生产路径。qwen3_asr_transformers: Qwen3-ASR 的 Transformers backend。qwen3_asr_vllm: 安装匹配 vLLM 栈时使用的 vLLM backend。hf_causal_lm: 通用 Hugging Face causal LM teacher 路径。
对 qwen3_asr_* backend,需要通过 --qwen3_asr_code_path 传入本地 Qwen3-ASR
Transformers backend 代码路径。该 backend 代码没有 vendored 到本仓库。
安装
先准备与集群匹配的 CUDA/PyTorch 环境,然后安装本仓库及其 Python 依赖:
pip install -e .
如果你的工作流需要将 verl 作为独立 editable package 安装:
pip install -e ./verl
如果使用 qwen3_asr_vllm,需要单独安装兼容的 vLLM 栈:
pip install -e ".[vllm]"
数据格式
训练数据为 JSONL,每行一个 ASR 样本:
{"audio":"/path/to/audio.wav","text":"reference transcript","task":"asr","begin_time":-1,"end_time":-1}
字段说明:
audio: 必需,音频路径。text: 必需,参考转写文本,用于 ASR 监督和元信息。task: 可选;如果存在,必须为asr。begin_time: 可选,音频片段起点,单位为秒。-1表示整段音频。end_time: 可选,音频片段终点,单位为秒。-1表示整段音频。
脚本遇到缺失音频路径会直接失败,不会用 fallback 音频静默替换坏样本。
推理
使用 Hugging Face Transformers 运行 ASR 推理:
import torch
from transformers import AutoModelForCausalLM, AutoProcessor, AutoTokenizer

model_path = "AutoArk-AI/ARK-ASR-0.6B"
audio_path = "assets/libai.wav"

device = "cuda" if torch.cuda.is_available() else "cpu"
torch_dtype = torch.float16 if device == "cuda" else torch.float32

processor = AutoProcessor.from_pretrained(model_path, trust_remote_code=True)
tokenizer = AutoTokenizer.from_pretrained(model_path, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
    model_path,
    trust_remote_code=True,
    torch_dtype=torch_dtype,
    attn_implementation="sdpa",
).to(device)

conversation = [
    {
        "role": "user",
        "content": [
            {"type": "audio", "path": audio_path},
            {"type": "text", "text": "Please transcribe this audio."},
        ],
    }
]

inputs = processor.apply_chat_template(
    conversation,
    add_generation_prompt=True,
    return_tensors="pt",
)
inputs = inputs.to(device)
if "audios" in inputs:
    inputs["audios"] = inputs["audios"].to(dtype=torch_dtype)

bad_words_ids = [[token_id] for token_id in tokenizer.all_special_ids if token_id != tokenizer.eos_token_id]
outputs = model.generate(
    **inputs,
    do_sample=False,
    max_new_tokens=256,
    pad_token_id=tokenizer.pad_token_id,
    eos_token_id=tokenizer.eos_token_id,
    bad_words_ids=bad_words_ids,
)
decoded_outputs = tokenizer.batch_decode(
    outputs[:, inputs.input_ids.shape[1] :],
    skip_special_tokens=True,
)
print(decoded_outputs)
批量 JSONL 推理可以使用:
python scripts/infer/ark_asr_transformers.py \
  --input /path/to/input.jsonl \
  --output runs/infer/predictions.jsonl \
  --model_path AutoArk-AI/ARK-ASR-0.6B \
  --processor_path AutoArk-AI/ARK-ASR-0.6B \
  --batch_size 40 \
  --dtype float16 \
  --attn_impl sdpa
vLLM 在线服务
Ark-ASR 也可以通过 scripts/vllm/ark_asr_vllm 中的 vLLM adapter 部署。arki-dev-h20
上已验证的运行环境是:
/root/miniforge3/envs/asr_vlm
Python 3.10
PyTorch 2.9.0+cu128
Transformers 4.57.3
vLLM 0.12.0
启动在线服务:
cd /data/yumu/open-audio-opd
GPU=2 PORT=8025 scripts/vllm/deploy_ark_asr_vllm_service.sh start
检查服务状态和 token masking:
scripts/vllm/deploy_ark_asr_vllm_service.sh status
curl -sS http://127.0.0.1:8025/health
curl -sS http://127.0.0.1:8025/token-mask
运行一次 ASR 请求:
curl -sS -X POST http://127.0.0.1:8025/asr \
  -F file=@assets/libai.wav \
  -F max_new_tokens=64
服务还提供 OpenAI 风格接口:
curl -sS -X POST http://127.0.0.1:8025/v1/audio/transcriptions \
  -F file=@assets/libai.wav \
  -F model=ark-asr
停止服务:
scripts/vllm/deploy_ark_asr_vllm_service.sh stop
日志和 PID 文件写入 runs/vllm/。vLLM 服务在生成阶段使用 allowed_token_ids 做
token masking,因此 <|user|>、<|assistant|>、<|audio|>、<|begin_of_audio|> 和
<|end_of_audio|> 等非 ASR 控制 token 会在解码时被屏蔽。<|im_end|> 保留为 stop token。
更多适配说明见 docs/ark_asr_vllm_adaptation.md。
本地浏览器测试页见 tools/ark_asr_vllm_test.html,默认连接
http://172.31.0.3:8025,支持文件上传、麦克风录音、health 检查和 token mask 检查。
评测
对单个 JSONL 文件运行 J/WER 评测:
python scripts/eval/eval_jwer_ark_asr_transformers.py \
  --input /path/to/test_aishell.jsonl \
  --output runs/eval/test_aishell_result.jsonl \
  --model_path AutoArk-AI/ARK-ASR-0.6B \
  --processor_path AutoArk-AI/ARK-ASR-0.6B \
  --batch_size 40 \
  --dtype float16 \
  --attn_impl sdpa
评测输出按 cer_errors 降序排序,便于检查 bad case。每行包含 ref_text、
pred_text、清洗后的文本字段、wer_errors、cer_errors、ref_words 和 ref_chars。
如果你的环境将 text_process normalizer 放在单独 Python 环境中,传入:
--text_normalize_python /path/to/wetext/bin/python
如需使用内部 run_arkasr_step30000_eval.sh 同款五套集多 GPU 评测模式,可以使用没有硬编码
数据路径的开源 launcher:
MODEL_PATH=AutoArk-AI/ARK-ASR-0.6B \
EVAL_DATA_DIR=/path/to/eval_jsonl_dir \
OUTPUT_DIR=runs/eval/arkasr_step30000 \
SUFFIX=step30000 \
GPUS="0 1 2 3 4" \
PRESETS="aishell clean meeting net other" \
scripts/eval/run_arkasr_eval.sh
launcher 期望 EVAL_DATA_DIR 下存在名为 test_${preset}.jsonl 的文件。日志、pid 文件和结果
JSONL 会写入 OUTPUT_DIR。本仓库不包含评测数据。
单机训练
torchrun --nproc_per_node 8 scripts/train/train_ark_asr_opd_fsdp2_resume.py \
  --student_model AutoArk-AI/ARK-ASR-0.6B \
  --teacher_model /path/to/qwen3_asr_model \
  --qwen3_asr_code_path /path/to/qwen3-asr/backend \
  --train_data /path/to/train.jsonl \
  --output_dir runs/ark_asr_opd_fsdp2 \
  --teacher_backend qwen3_asr_teacher_forcing \
  --calibrate_only False \
  --per_device_train_batch_size 1 \
  --learning_rate 1e-6 \
  --opd_top_k 32 \
  --asr_opd_max_new_tokens 256 \
  --save_freq 1000
建议先使用小 batch 和较小的 --asr_opd_max_new_tokens 起步,在确认生成长度、非空生成比例、
teacher 对齐情况和 opd_valid_topk_mean 后再扩大规模。
多机 Hostfile 启动
创建 hostfile:
node0 slots=8
node1 slots=8
node2 slots=8
启动:
HOSTFILE=/path/to/hostfile \
STUDENT_MODEL=AutoArk-AI/ARK-ASR-0.6B \
TEACHER_MODEL=/path/to/qwen3_asr_model \
QWEN3_ASR_CODE_PATH=/path/to/qwen3-asr/backend \
TRAIN_DATA=/path/to/train.jsonl \
OUTPUT_DIR=runs/ark_asr_opd_fsdp2 \
NCCL_SOCKET_IFNAME=hpn0 \
GLOO_SOCKET_IFNAME=hpn0 \
scripts/run/run_ark_asr_opd_fsdp2_resume_hostfile.sh
launcher 要求提供 HOSTFILE、STUDENT_MODEL、TEACHER_MODEL 和 TRAIN_DATA。当
TEACHER_BACKEND 以 qwen3_asr_ 开头时,还要求提供 QWEN3_ASR_CODE_PATH。
恢复训练
从指定 checkpoint 恢复:
torchrun --nproc_per_node 8 scripts/train/train_ark_asr_opd_fsdp2_resume.py \
  --student_model AutoArk-AI/ARK-ASR-0.6B \
  --teacher_model /path/to/qwen3_asr_model \
  --qwen3_asr_code_path /path/to/qwen3-asr/backend \
  --train_data /path/to/train.jsonl \
  --output_dir runs/ark_asr_opd_fsdp2 \
  --resume_from_checkpoint runs/ark_asr_opd_fsdp2/checkpoints/global_step_1000 \
  --calibrate_only False
从 output_dir/checkpoints 下最新 checkpoint 恢复:
--resume_from_checkpoint latest
auto 可作为 latest 的别名。
Calibration 模式
默认 --calibrate_only True。Calibration 会执行 forward pass 并打印初始 loss/生成指标,
但不执行 optimizer step。正式训练前建议先使用该模式验证模型加载、数据加载、rollout、
teacher scoring 和 OPD 对齐。
正式训练时传入:
--calibrate_only False
关键参数
--student_model: 可训练 student ASR 模型路径或 HF repo id。--teacher_model: teacher ASR 模型路径或 HF repo id。--teacher_backend: teacher scoring 实现。--qwen3_asr_code_path: Qwen3-ASR teacher backend 必需。--train_data: JSONL 训练数据。--output_dir: 日志和 FSDP2 checkpoint 输出目录。--hf_cache_dir: Hugging Face datasets cache 目录。--opd_top_k: teacher/student top-k support 大小。--opd_temperature: OPD 分布温度。--asr_block_token_id_from: student 生成时屏蔽非 ASR token id。--asr_opd_max_new_tokens: rollout 长度上限。--save_freq: checkpoint 保存间隔。设为-1可禁用保存。--resume_from_checkpoint: checkpoint 目录、latest或auto。
Smoke Checks
以下检查不需要模型权重:
python3 -m py_compile scripts/train/train_ark_asr_opd_fsdp2_resume.py
python3 -m py_compile scripts/infer/ark_asr_transformers.py
python3 -m py_compile scripts/eval/eval_jwer_ark_asr_transformers.py
bash -n scripts/run/run_ark_asr_opd_fsdp2_resume_hostfile.sh
bash -n scripts/eval/run_arkasr_eval.sh
python scripts/train/train_ark_asr_opd_fsdp2_resume.py --help
最后的 --help 命令必须在已安装训练依赖的环境中运行,包括 numpy、torch、datasets、
transformers、omegaconf,以及 pyproject.toml 中列出的 verl 依赖。
引用
如果你在工作中使用本仓库或 ARK-ASR,请引用:
@misc{lin2026dataefficientopd,
  title={Data-Efficient On-Policy Distillation for Automatic Speech Recognition},
  author={Lin, Yu and Wang, Yiming and Cai, Runyuan and Zeng, Xiaodong},
  year={2026},
  eprint={2605.28139},
  archivePrefix={arXiv},
  primaryClass={cs.AI},
  url={https://arxiv.org/abs/2605.28139}
}