
yeyupiaoling/VoiceprintRecognition-Tensorflow
yeyupiaoling/VoiceprintRecognition-Tensorflow has 338 GitHub stars and 64 forks. Star changes are not measured yet. Last checked 2026-11-16 01:21 UTC. Last push 2024-06-16.
Measured star growth
- in 24h
- Collecting history
- in 7 days
- Collecting history
- in 15 days
- Collecting history
- in 1 month
- Collecting history
Net star changes over overlapping periods, not daily totals. Missing measurements are left blank. Stars measure attention, not software quality.
About
使用Tensorflow实现声纹识别
Machine LearningREADME.md
Original前言
本章介绍如何使用Tensorflow实现简单的声纹识别模型,首先你需要熟悉音频分类,没有了解的可以查看这篇文章《基于Tensorflow实现声音分类》 。基于这个知识基础之上,我们训练一个声纹识别模型,通过这个模型我们可以识别说话的人是谁,可以应用在一些需要音频验证的项目。不同的是本项目使用了ArcFace Loss,ArcFace loss:Additive Angular Margin Loss(加性角度间隔损失函数),对特征向量和权重归一化,对θ加上角度间隔m,角度间隔比余弦间隔在对角度的影响更加直接。
建议你使用这个版本 VoiceprintRecognition-Pytorch 或者 VoiceprintRecognition-PaddlePaddle ,本项目已不维护。
欢迎大家扫码入知识星球或者QQ群讨论,知识星球里面提供项目的模型文件和博主其他相关项目的模型文件,也包括其他一些资源。
使用环境:
- Python 3.8
- Tensorflow 2.13.0
- Ubuntu 18.04 or Windows 10
模型下载
| 数据集 | 类别数量 | threshold | EER | 下载地址 |
|---|---|---|---|---|
| zhvoice | 2798 | 0.06820 | 0.06789 | 加入知识星球获取 |
安装环境
- 安装Tensorflow,如果已经安装过Tensorflow,测无需再次安装。
pip install tensorflow==2.13.0 -i https://pypi.tuna.tsinghua.edu.cn/simple
如果安装麻烦,也可以使用Docker容器,但要提前安装安装 NVIDIA Container Toolkit。
sudo docker pull tensorflow/tensorflow:2.13.0-gpu
sudo docker run -itd --gpus all --name tensorflow -v $PWD/:/workspace/ tensorflow/tensorflow:2.13.0-gpu
sudo docker exec -it tensorflow /bin/bash
- 安装其他依赖库,命令如下。
pip install -r requirements.txt -i https://pypi.tuna.tsinghua.edu.cn/simple
- 如果需要安装pyaudio,请用conda命令安装,pip安装很难成功,命令如下。
conda install pyaudio
创建数据
本教程笔者使用的是zhvoice ,这个数据集经过处理,一共有2798个人的训练数据,91个人的评估数据,有80W+条语音数据。如果读者有其他更好的数据集,可以混合在一起使用,但要用python的工具模块aukit处理音频,降噪和去除静音。
首先是创建一个数据列表,数据列表的格式为<语音文件路径\t语音分类标签>,创建这个列表主要是方便之后的读取,也是方便读取使用其他的语音数据集,语音分类标签是指说话人的唯一ID,不同的语音数据集,可以通过编写对应的生成数据列表的函数,把这些数据集都写在同一个数据列表中。
在create_data.py创建数据列表,在创建数据列表之后,可能有些数据的是错误的,所以我们要检查一下,将错误的数据删除。执行下面程序完成数据准备。
python create_data.py
执行上面的程序之后,会生成以下的数据格式,如果要自定义数据,参考如下数据列表,前面是音频的相对路径,后面的是该音频对应的说话人的标签,就跟分类一样。
dataset/zhvoice/zhaishell/S0002/BAC009S0002W0129.mp3    1104
dataset/zhvoice/zhaishell/S0002/BAC009S0002W0130.mp3    1104
dataset/zhvoice/zhaishell/S0002/BAC009S0002W0131.mp3    1104
dataset/zhvoice/zhaishell/S0002/BAC009S0002W0132.mp3    1104
dataset/zhvoice/zhaishell/S0002/BAC009S0002W0133.mp3    1104
dataset/zhvoice/zhaishell/S0002/BAC009S0002W0134.mp3    1104
dataset/zhvoice/zhaishell/S0002/BAC009S0002W0135.mp3    1104
dataset/zhvoice/zhaishell/S0002/BAC009S0002W0136.mp3    1104
dataset/zhvoice/zhaishell/S0002/BAC009S0002W0137.mp3    1104
dataset/zhvoice/zhaishell/S0002/BAC009S0002W0138.mp3    1104
数据读取
有了上面创建的数据列表和均值标准值,就可以用于训练读取。主要是把语音数据转换短时傅里叶变换的幅度谱,使用librosa可以很方便计算音频的特征,如梅尔频谱的API为librosa.feature.melspectrogram(),输出的是numpy值,可以直接用PaddlePaddle训练和预测。跟梅尔频谱同样很重要的梅尔倒谱(MFCCs)更多用于语音识别中,对应的API为librosa.feature.mfcc()。在本项目中使用的API分别是librosa.stft()和librosa.magphase()。在训练时,使用了数据增强,如随机翻转拼接,随机裁剪。经过处理,最终得到一个257*257的短时傅里叶变换的幅度谱。
wav, sr_ret = librosa.load(audio_path, sr=sr)
linear = librosa.stft(extended_wav, n_fft=n_fft, win_length=win_length, hop_length=hop_length)
linear_T = linear.T
mag, _ = librosa.magphase(linear_T)
mag_T = mag.T
freq, freq_time = mag_T.shape
spec_mag = mag_T[:, :spec_len]
mean = np.mean(spec_mag, 0, keepdims=True)
std = np.std(spec_mag, 0, keepdims=True)
spec_mag = (spec_mag - mean) / (std + 1e-5)
训练模型
创建train.py开始训练模型,使用的是经过修改过的resnet34模型,数据输入层设置为[None, 1, 257, 257],这个大小就是短时傅里叶变换的幅度谱的shape,如果读者使用了其他的语音长度,也需要修改这个值。每训练一轮结束之后,执行一次模型评估,计算模型的准确率,以观察模型的收敛情况。同样的,每一轮训练结束保存一次模型,分别保存了可以恢复训练的模型参数,也可以作为预训练模型参数。还保存预测模型,用于之后预测。
python train.py
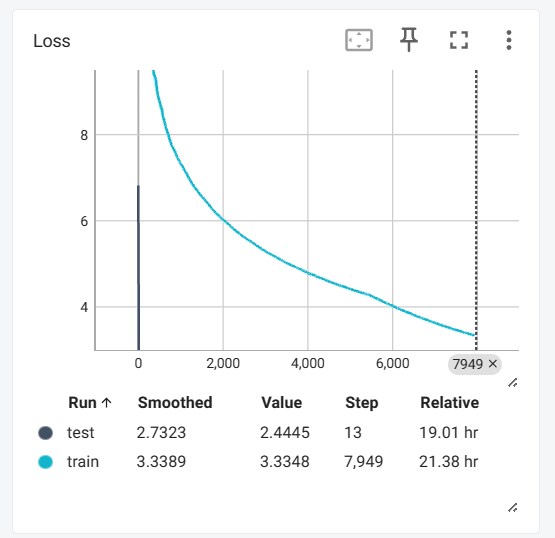
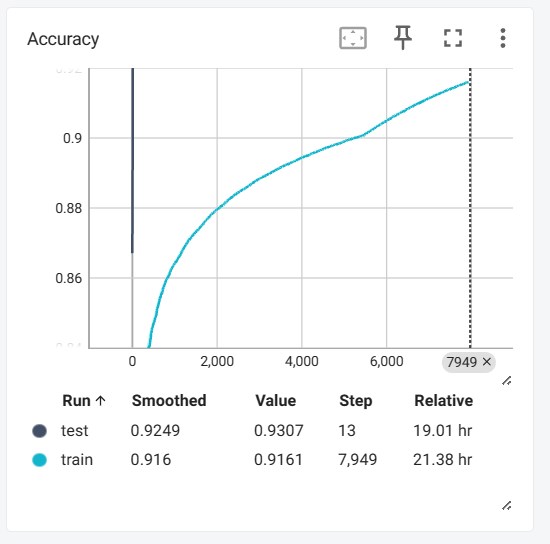
训练过程中,会使用tensorboard保存训练日志,通过启动tensorboard可以随时查看训练结果,启动命令tensorboard --logdir=log --host 0.0.0.0
评估模型
训练结束之后会保存预测模型,我们用预测模型来预测测试集中的音频特征,然后使用音频特征进行两两对比,阈值从0到1,步长为0.01进行控制,找到最佳的阈值并计算准确率。
python eval.py
输出类似如下:
-----------  Configuration Arguments -----------
input_shape: (1, 257, 257)
list_path: dataset/test_list.txt
model_path: models/infer/model
------------------------------------------------

开始提取全部的音频特征...
100%|█████████████████████████████████████████████████████| 5332/5332 [01:09<00:00, 77.06it/s]
开始两两对比音频特征...
100%|█████████████████████████████████████████████████████| 5332/5332 [01:43<00:00, 51.62it/s]
100%|█████████████████████████████████████████████████████| 100/100 [00:03<00:00, 28.04it/s]
当阈值为0.990000, 准确率最大,准确率为:0.999693
声纹对比
下面开始实现声纹对比,创建infer_contrast.py程序,编写infer()函数,在编写模型的时候,模型是有两个输出的,第一个是模型的分类输出,第二个是音频特征输出。所以在这里要输出的是音频的特征值,有了音频的特征值就可以做声纹识别了。我们输入两个语音,通过预测函数获取他们的特征数据,使用这个特征数据可以求他们的对角余弦值,得到的结果可以作为他们相识度。对于这个相识度的阈值threshold,读者可以根据自己项目的准确度要求进行修改。
python infer_contrast.py --audio_path1=audio/a_1.wav --audio_path2=audio/b_2.wav
输出类似如下:
-----------  Configuration Arguments -----------
audio_path1: audio/a_1.wav
audio_path2: audio/b_1.wav
input_shape: (257, 257, 1)
model_path: models/infer_model.h5
threshold: 0.7
------------------------------------------------
Model: "functional_1"
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
resnet50v2_input (InputLayer [(None, 257, 257, 1)]     0
_________________________________________________________________
resnet50v2 (Functional)      (None, 2048)              23558528
_________________________________________________________________
batch_normalization (BatchNo (None, 2048)              8192
=================================================================
Total params: 23,566,720
Trainable params: 23,517,184
Non-trainable params: 49,536
_________________________________________________________________

audio/a_1.wav 和 audio/b_1.wav 不是同一个人,相似度为:0.503458
声纹识别
在上面的声纹对比的基础上,我们创建infer_recognition.py实现声纹识别。同样是使用上面声纹对比的infer()预测函数,通过这两个同样获取语音的特征数据。 不同的是笔者增加了load_audio_db()和register(),以及recognition(),第一个函数是加载声纹库中的语音数据,这些音频就是相当于已经注册的用户,他们注册的语音数据会存放在这里,如果有用户需要通过声纹登录,就需要拿到用户的语音和语音库中的语音进行声纹对比,如果对比成功,那就相当于登录成功并且获取用户注册时的信息数据。第二个函数register()其实就是把录音保存在声纹库中,同时获取该音频的特征添加到待对比的数据特征中。最后recognition()函数中,这个函数就是将输入的语音和语音库中的语音一一对比。
有了上面的声纹识别的函数,读者可以根据自己项目的需求完成声纹识别的方式,例如笔者下面提供的是通过录音来完成声纹识别。首先必须要加载语音库中的语音,语音库文件夹为audio_db,然后用户回车后录音3秒钟,然后程序会自动录音,并使用录音到的音频进行声纹识别,去匹配语音库中的语音,获取用户的信息。通过这样方式,读者也可以修改成通过服务请求的方式完成声纹识别,例如提供一个API供APP调用,用户在APP上通过声纹登录时,把录音到的语音发送到后端完成声纹识别,再把结果返回给APP,前提是用户已经使用语音注册,并成功把语音数据存放在audio_db文件夹中。
python infer_recognition.py
输出类似如下:
-----------  Configuration Arguments -----------
audio_db: audio_db
input_shape: (257, 257, 1)
model_path: models/infer_model.h5
threshold: 0.7
------------------------------------------------
Model: "functional_1"
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
resnet50v2_input (InputLayer [(None, 257, 257, 1)]     0
_________________________________________________________________
resnet50v2 (Functional)      (None, 2048)              23558528
_________________________________________________________________
batch_normalization (BatchNo (None, 2048)              8192
=================================================================
Total params: 23,566,720
Trainable params: 23,517,184
Non-trainable params: 49,536
_________________________________________________________________

Loaded 李达康 audio.
Loaded 沙瑞金 audio.
请选择功能,0为注册音频到声纹库,1为执行声纹识别:0
按下回车键开机录音,录音3秒中:
开始录音......
录音已结束!
请输入该音频用户的名称:夜雨飘零
请选择功能,0为注册音频到声纹库,1为执行声纹识别:1
按下回车键开机录音,录音3秒中:
开始录音......
录音已结束!
识别说话的为:夜雨飘零,相似度为:0.920434
其他版本
- PaddlePaddle:VoiceprintRecognition-PaddlePaddle
- Pytorch:VoiceprintRecognition-Pytorch
- Keras:VoiceprintRecognition-Keras