
szad670401/HyperLandmark
szad670401/HyperLandmark has 1,711 GitHub stars and 515 forks. GitHot measured 0 stars in 24 hours and 0 in 7 days. Last checked 2026-11-09 01:33 UTC. Last push 2024-10-15.
Deep Learning Based Free Mobile Real-Time Face Landmark Detector. Contact:[email protected]
What you can do
- 106点,人脸轮廓描述更加细腻
- 准确度高,逆光、暗光情况下依然可以取得良好的标定效果
- 模型小,跟踪模型2MB左右,非常适合移动端集成
- 速度快,Android平台代码在 Qualcomm 820 (st) 单张人脸7ms (2018.08.14)
Measured star growth
- in 24h
- 0
- in 7 days
- 0
- in 15 days
- Collecting history
- in 1 month
- Collecting history
Net star changes over overlapping periods, not daily totals. Missing measurements are left blank. Stars measure attention, not software quality.
README.md
OriginalFree Mobile Real-Time Face Landmark 106 points Localization
Introduce
良心级开源人脸标定算法,人脸美颜,美妆,配合式活体检测,人脸校准的预处理步骤.该项目Windows工程基于传统的SDM算法,通过修改开源代码,精简保留测试部分代码,优化代码结构. Android代码基于深度学习,我们设计了高效的网络模型,该模型鲁棒性较好,支持多人脸跟踪.目前深度学习算法在人脸标定方向取得了良好的效果,该项目旨在提供一种较为简单易用的实现方式.
Note
2024.10.15: 本项目已经停止维护,我们启动了一个新的更加面向专业的人脸相关开源项目。新的项目实现并集成了大部分SOTA的人脸相关算法,包括人脸识别、人脸检测、人脸(关键点)跟踪、人脸属性分析和活体检测等功能,具体项目地址可访问:InspireFace。
Related Resources
- 基于HyperLandmark的活体检测
- 基于SDM的HyperLandmark-iOS实现 (2019.02.06)
- 相关技术博客
- 参考开源SDM算法。
- 基于CNN的人脸标定。
- HyperLandmark 106点序号
Features
- 106点,人脸轮廓描述更加细腻
- 准确度高,逆光、暗光情况下依然可以取得良好的标定效果
- 模型小,跟踪模型2MB左右,非常适合移动端集成
- 速度快,Android平台代码在 Qualcomm 820 (st) 单张人脸7ms (2018.08.14)
- 增加多人脸跟踪
APP
- 体验 Android APP:http://demo.zeusee.com/ZeusFaceTrack
Latest Update
- Add OpenGL based camera interface.
TODO
- Dense face landmark (800 points)
- Facial action recognition
- Euler angle , face pose estimation.
- Open source native tracking code.
Notes
Windows实现是基于免费intraface实现的,与android并不相同。
依赖
- Windows demo 依赖 OpenCV
- Android 可直接使用
Demo
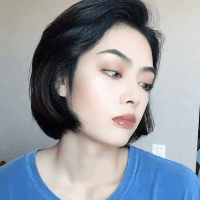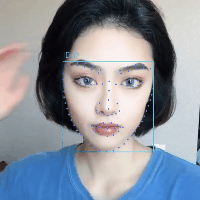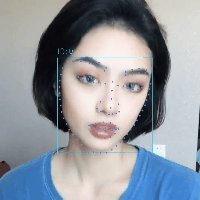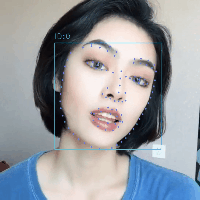
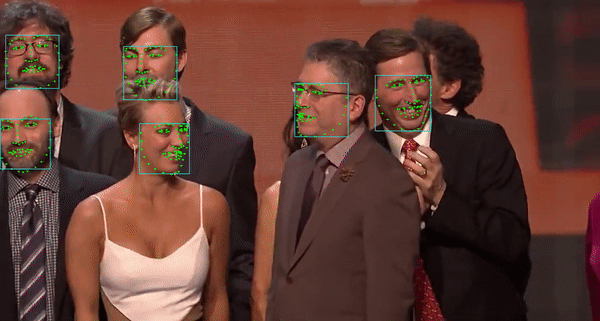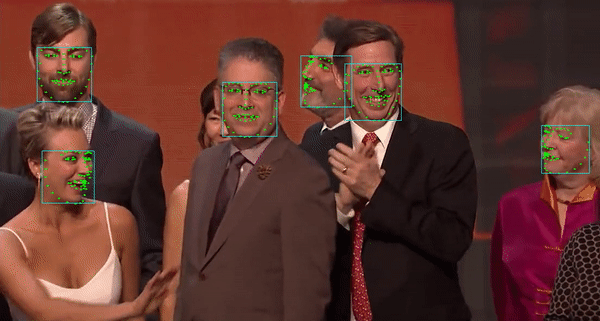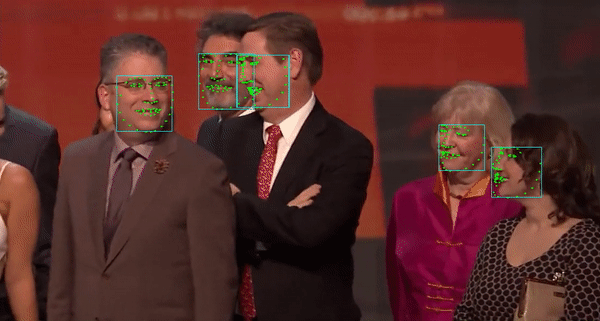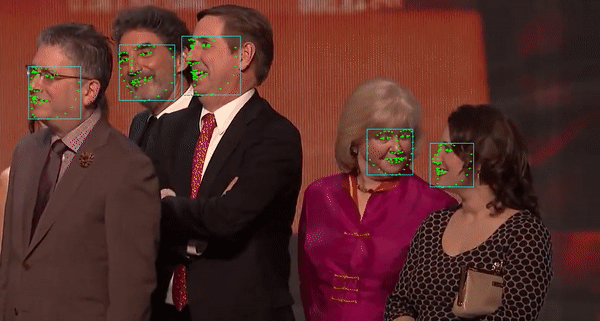
Contact:
关于人脸标定我们正在进行数据收集与算法开发,技术交流、捐献数据可以加入下群。
- HyperAI交流群 529385694
Author
Explore related projects
tensorflow/tensorflow
An Open Source Machine Learning Framework for Everyone
201,400 starshuggingface/transformers
🤗 Transformers: the model-definition framework for state-of-the-art machine learning models in text, vision, audio, and multimodal models, for both inference and training.
168,668 starsAUTOMATIC1111/stable-diffusion-webui
Stable Diffusion web UI
165,261 starsComfy-Org/ComfyUI
The most powerful and modular diffusion model GUI, api and backend with a graph/nodes interface. The fastest local inference engine in the world.
145,835 stars