
hubooooooo/agent-workshop
hubooooooo/agent-workshop has 36 GitHub stars and 5 forks. GitHot measured 0 stars in 24 hours. Last checked 2026-11-14 19:09 UTC. Last push 2026-11-10.
Measured star growth
- in 24h
- 0
- in 7 days
- Collecting history
- in 15 days
- Collecting history
- in 1 month
- Collecting history
Net star changes over overlapping periods, not daily totals. Missing measurements are left blank. Stars measure attention, not software quality.
About
Agent 工坊(Agent Workshop):给它一个 PRD、一个需求点子、或一个可落地的 Agent 方向,它推导出架构方案、组件选型与代码骨架,直到一个能在真实环境运行的产品。
AIREADME.md
Original
Agent 工坊
一句话点子 → 可确认的 PRD 与架构方案 → 你的 AI 写出能跑的骨架 → 引擎对照 PRD 验收 → 按新需求持续迭代
一个本地运行的 Agent 产品推导引擎。它不替你写代码,而是先把「该做什么、该用哪些机制、哪里还没想清楚」推导清楚,交给你自己的 AI 编程工具去写骨架,再对照 PRD 验收,陪你一轮轮把骨架做对。


教学版和网页版
上课的同学请下载教学版(下表第一行的链接),不要下载本页的网页版;课堂流程、结课检查表都写在教学版里。
| 名称 | 是什么 | 适合 | 下载 |
|---|---|---|---|
| 教学版 | 没有网页界面:项目文件夹、Python 引擎和命令行。用 AI 编程工具打开文件夹,让它全局阅读项目,再按引导一步步带你做到骨架验收 | 课堂上跟着老师学,看清项目里有什么、每一步怎么跑起来 | 下载 · 浏览源码 |
| 网页版(本页) | 在教学版的基础上加了本地网页界面:对话式新建产品、回答问题、试玩、导出交接包、检查外部项目 | 想直接用的普通用户:下载后双击启动,在网页上操作 | 下载 |
两个版本都下载到自己电脑上运行,不是网站。教学版由 AI 在终端里运行命令,用法看教学版的 README「课堂上这样用」;网页版双击 启动界面.command,第一次双击如果被 macOS 拦下,看常见问题。
它能帮你做什么
| 你手上有 | 你说 | 你拿到 |
|---|---|---|
| 💡 一个点子或半份 PRD | 「帮我出个方案」 | 方案.md:待确认问题、需求拆解、组件选型及理由、七层架构图、工具清单、系统提示词草案、测试设计、独立审稿意见 |
| 🔁 一个想认真做下去的产品 | 「按产品循环做,产品名 ……」 | out/<产品名>/ 工作区:带版本的 PRD、方案、验证报告、迭代记录,之后每次加需求都在这里升版;代码骨架由你的 AI 按方案写进 skeleton/ |
| 🔍 一个已经写了的 Agent 项目 | 「检查这个项目缺什么」 | 差距报告.md:缺哪些机制、先补什么、证据在哪一行 + 本该有的PRD.md |
核心:产品循环
做 Agent 产品最常见的坑,是骨架跑起来之后有了新想法,直接改代码,PRD 和方案从此跟代码对不上。产品循环把每一轮新需求都先落回 PRD,再推导、再改骨架:
flowchart LR
    A["💡 一句话点子"] -->|blueprint init| B["📄 PRD V1"]
    B -->|blueprint plan| C["📘 方案.md<br/>待确认清单"]
    C -->|你回答问题<br/>AI 生成代码| D["💻 skeleton/<br/>代码骨架"]
    D -->|blueprint verify<br/>+ 你亲手跑一跑| E["🧪 验证"]
    E -->|有新想法| F["blueprint revise"]
    F -->|PRD 升版 V2<br/>重推方案 · 记录选型变化| B
三方各管一段,边界写死在规则里:
- 引擎负责推导和记账:拆需求、按固定规则选组件、出方案、审稿、PRD 升版快照、记录每轮选型变化。浏览器界面里的「试玩」是引擎按方案模拟出来的对话,给你看看它大概会怎么表现;它不是代码,也不是产品原型,不能导出,不进交接包。
- AI 助手负责写代码:按方案生成骨架,按迭代记录增量修改,只能写进
out/<产品名>/skeleton/。 - 你负责判断:回答待确认问题、亲手跑骨架、决定下一轮要什么。迭代记录里的「人工验证结论」只能由你来填。
引擎里的 agent
引擎外层是固定流程:步骤顺序写死,组件选型由规则计算,费用有上限。其中需要「自己判断下一步」的四处交给 agent,每一处都有代码兜底:
| 环节 | agent 做什么 | 代码守住什么 |
|---|---|---|
| 新建产品的追问 | 自己判断还缺什么、问几轮;想法说完整了就不再问 | 目标、用户、核心闭环、红线四项都有了(或你说不确定)才能整理草稿;最多问 6 轮 |
| 方案推导 | 写五要素和架构设计,可以查组件说明,交卷前自检 | 组件选型由规则算,agent 改不了;工具与选型对不上、降级场景或测试设计漏写,不改好不能交卷 |
| 检查项目和骨架 | 自己翻代码,逐个核实组件,每条结论附读过的代码行 | 只读、只能看项目目录、不读 .env 和私钥;证据必须是真读过的文件和真实行号 |
| 试玩 | 按方案里的提示词和工具清单真的调用工具,卡片边跑边出现 | 标了「禁止」的工具调不了,标了「要确认」的操作不会被当成已完成 |
agent 需要模型支持工具调用。模型不支持、调用出错或费用上限快用完时,这一步自动退回固定流程,报告或方案开头会写明原因,不会让你卡住。
先看效果
下面是引擎对一段话需求的真实输出节选,没有人工修改。输入是:「家长拍一张玩具合影,AI 生成可以亲子共同演绎的剧情脚本……照片涉及隐私,默认不保存……未来希望记住孩子的年龄和偏好。」
| 组件 | 选否 | 引擎给出的理由 |
|---|---|---|
| s03 权限系统 | ✅ 必选 | 照片涉及隐私,默认不保存,属于敏感数据操作 |
| s04 钩子系统 | ✅ 必选 | 生成内容必须过适龄审核,天然需要审核与拦截环节 |
| s09 记忆系统 | ⏸ 二期 | 未来希望记住孩子的年龄和偏好玩具做个性化 |
| s12 定时调度 | ❌ 放弃 | 由家长拍照触发,输入未提任何定时自动触发 |
| s13 Agent 团队 | ❌ 放弃 | 单人单次单脚本的产品形态,不涉及并行与隔离工作区 |
它同时会列出你还没想清楚的问题,例如「目标孩子的年龄段是多少」「交互形态是小程序、App 还是网页」,答不上来的就是风险点。
快速开始
开始前准备两样东西:
| 准备 | 用来做什么 | 什么时候需要 |
|---|---|---|
| 模型 API Key | 引擎推导方案、升版、验收 | 所有方式都要。推荐 DeepSeek,便宜且国内可直连,配置方法见下一节 |
| 能读写本地文件的 AI 编程工具 | 按方案把代码骨架写进 skeleton/ | 要代码时才需要,例如 Codex、Claude Code、Kimi Code、pi。只要方案或差距报告可以不装 |
用方式一或方式三推导完方案后,把下面这段话交给你的 AI 编程工具,让它写骨架:
引擎目录:/你的路径/agent-workshop
先读这个目录里的《使用引导.md》,按「产品循环」工作。
产品 酒馆搭子 的方案已经在 out/酒馆搭子/方案.md,请按方案把代码骨架写进 out/酒馆搭子/skeleton/。
🍎 方式一:Mac 双击(零命令行)
浏览器界面(推荐给不用终端的人):双击 启动界面.command,浏览器会自动打开引擎界面。第一次双击如果提示「无法打开」,按常见问题里的步骤放行一次即可。
- 「模型设置」里选服务商、粘贴 API Key,点「测试连接并保存」。
- 「新建产品」像聊天一样说出想法,AI 追问给谁用、怎么用、什么不能做,信息够了就停(想法说完整了就不再问,只说一句话的一般问三个左右),整理成需求草稿给你确认。确认后开始推导,进度直接显示在对话里。
- 推导完在产品页看方案:组件选型及理由、七层架构、工具清单、系统提示词、测试设计、审稿意见。
- 方案里还没想清楚的问题,在「回答问题」里一题一题答。问题都改成了大白话,只有工程师能判断的技术备注单独放着,不用你答;拿不准的点「帮我想想」,AI 给几个方向。答完自动写进 PRD 并重新推导。
- 在「试玩」里扮演自己产品的使用者(比如来问面包的顾客)和它聊几句,看它按现在的方案会怎么回应。它会按方案里的工具清单一步步做事,每做一步就多一张卡片;查资料、通知店主这些工具不会真的执行,结果是模拟的。方案里要先问人的操作会停下来等确认,禁止的操作调不了,这些地方都单独标出来。哪里不对就点回复下面的「这里不对」记下,最后一起带去「加新需求」。
- 点「导出交接包」,把 zip 发给帮你做产品的开发者:里面有需求、方案、还没定下来的问题、第一版组件的参考代码,以及一段交给 AI 编程工具的提示词。
- 有了新想法,在「加新需求」里说一句,AI 最多再问一个问题,整理成草稿给你确认;确认后需求文档升一版、方案重新推导,自动跳到「版本历史」,告诉你哪些组件的选型变了。每一版的需求文档都能回看。
- 手上已经有一个 Agent 项目,点左栏「检查一个项目」,选它的文件夹(会弹出 Mac 自带的选文件夹窗口,也可以粘贴路径),几分钟后得到差距报告和一份它本该有的需求文档,结果列在左栏「检查过的项目」里。代码改过后点「重新检查」再查一次:「这个项目该有什么」沿用上次的判断,两次的差别只来自代码;项目定位变了再点「重新判断」。
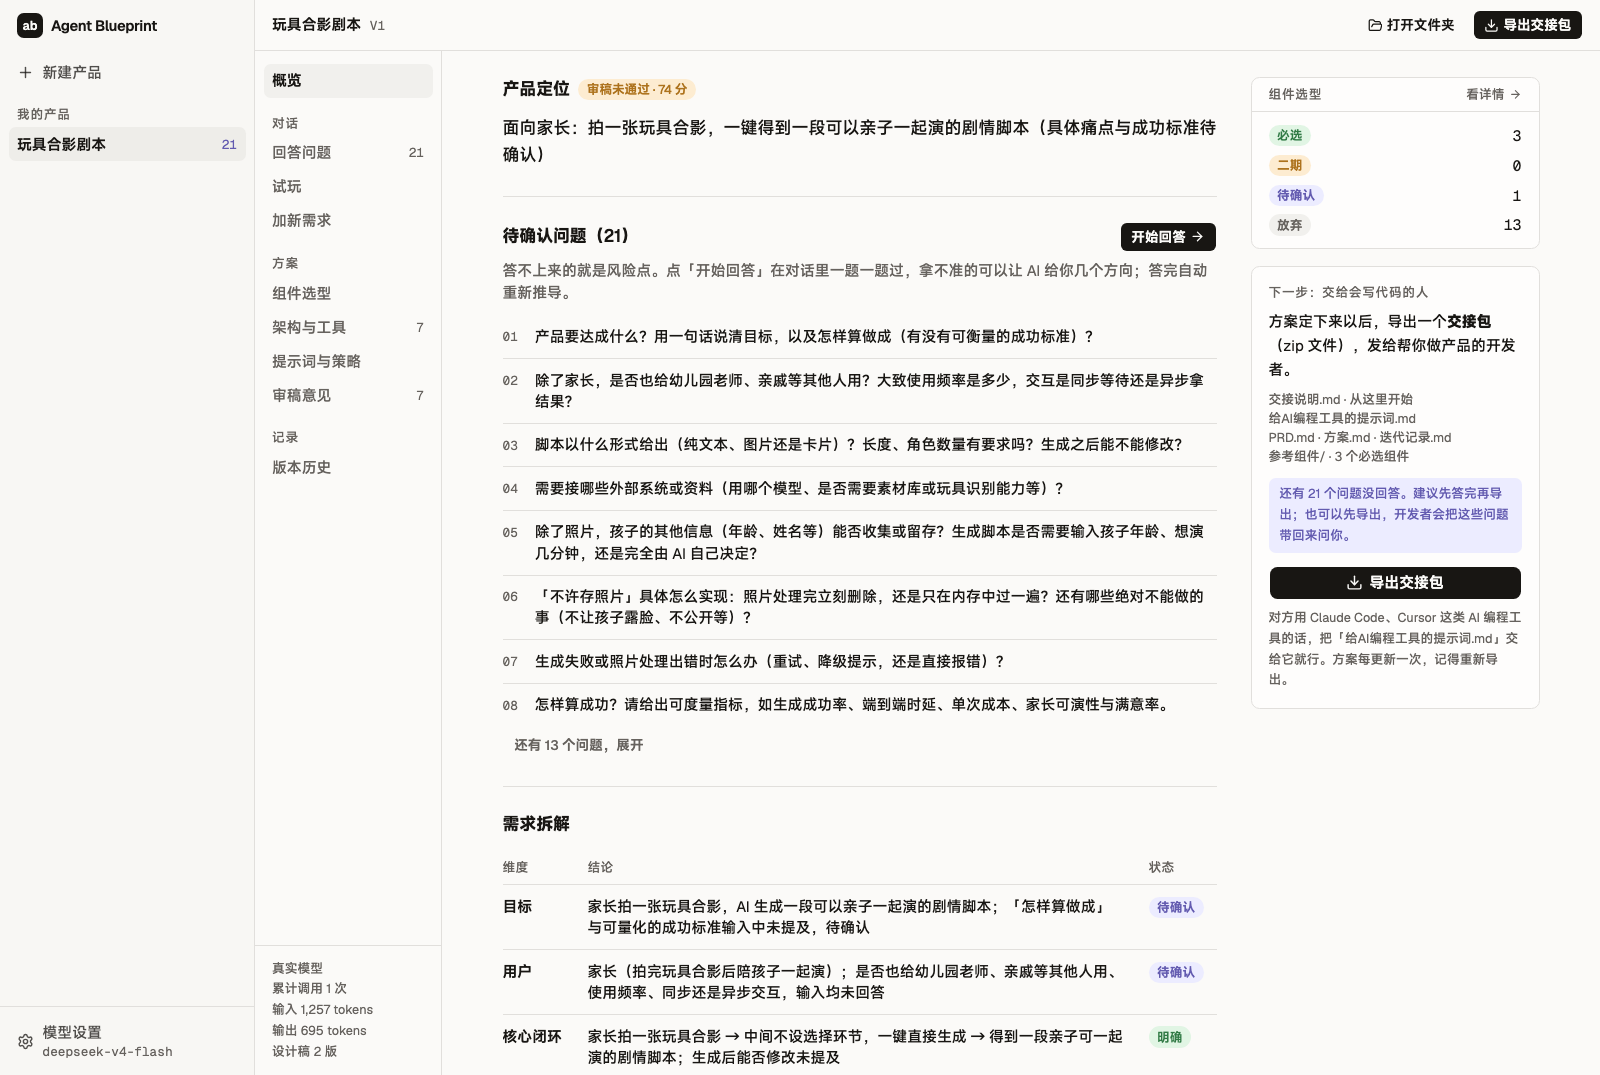 |
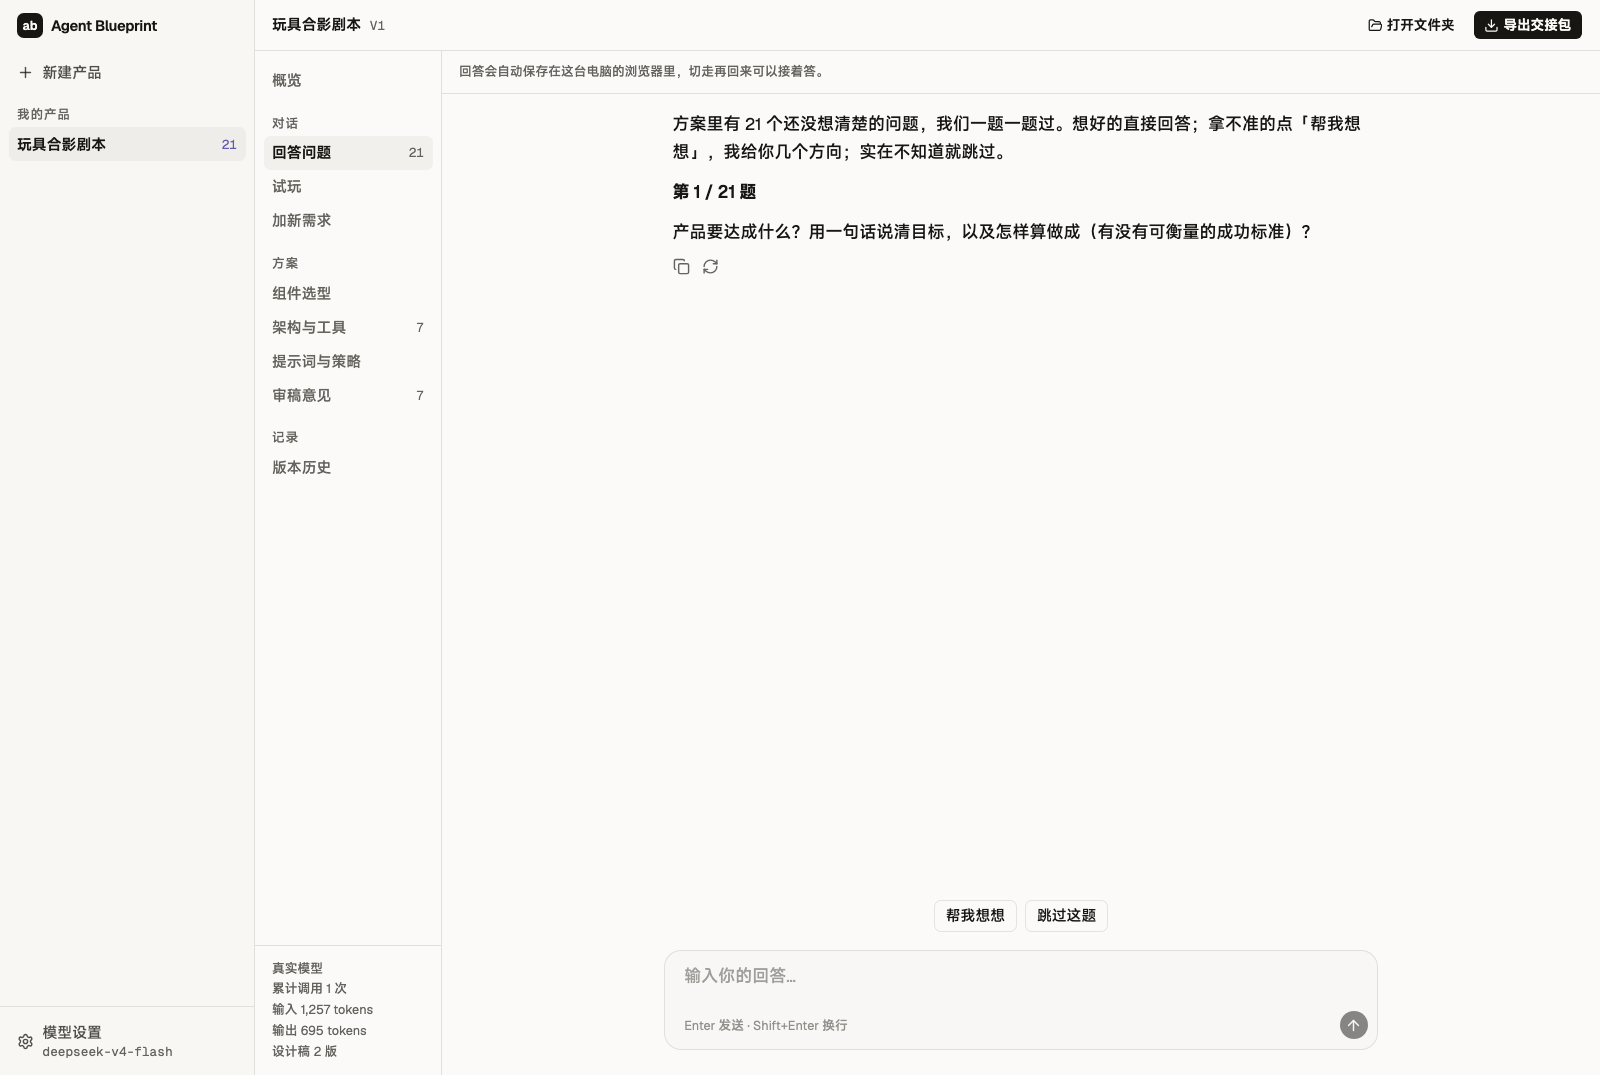 |
| 产品页:方案概览和待确认问题 | 回答问题:一题一题答,拿不准就「帮我想想」 |
产品页左栏底部会显示这个产品累计调用了多少次模型、用了多少 tokens(推导和对话都算,新建产品时的追问不算)。用的时候别关启动它的那个终端窗口。检查产品的代码骨架、对照 PRD 检查外部项目暂时还要用下面的终端问答。
终端问答:双击 启动引擎.command,终端里一问一答走完全程:
- 选模型服务商,粘贴 API Key,自动测试连接。
- 选「开始一个产品」,输入产品名和一句话想法。之后也可以选「加新需求」「检查骨架」「只生成方案」「检查外部项目」。
- 推导完成后自动打开结果文件。
没装 Python 3.10+ 时,两个启动文件都会下载并打开 Python 安装器,装好后重新双击即可。
🤖 方式二:交给能读本地文件的 AI(零安装)
把下面任意一段交给 Codex、Claude Code、Kimi Code、pi 这类能读写本地文件、能运行命令的 AI,替换路径和内容:
引擎目录:/你的路径/agent-workshop
先读这个目录里的《使用引导.md》,按「产品循环」工作。
产品名:酒馆搭子
我的点子是:……
请建立工作区、生成方案,列出要我回答的问题;我确认后再把代码骨架生成到 skeleton/。
引擎目录:/你的路径/agent-workshop
产品 酒馆搭子,新需求:……
请按产品循环升版 PRD、重推方案,再增量更新骨架。
引擎目录:/你的路径/agent-workshop
先读《使用引导.md》。请检查这个项目缺什么、先补什么:/你的路径/目标项目
先检查,不修改项目代码。
普通网页聊天窗口读不了本地文件,只给路径是不够的。
💻 方式三:命令行
bash setup.sh                         # 建虚拟环境、装依赖、生成 .env

# 产品循环
.venv/bin/python -m blueprint init "酒馆搭子" "一句话点子" --plan   # 建工作区并推导方案
.venv/bin/python -m blueprint verify out/酒馆搭子                  # 按方案和 PRD 检查 skeleton/
.venv/bin/python -m blueprint revise out/酒馆搭子 "新需求:……"     # PRD 升版并重推方案
.venv/bin/python -m blueprint revise out/酒馆搭子 "……" --quick     # 只重算选型,最多 3 次调用
.venv/bin/python -m blueprint handoff out/酒馆搭子                 # 打包交接包,交给会写代码的人

# 浏览器界面
.venv/bin/python -m blueprint ui                                  # 默认 http://127.0.0.1:8765(被占用就往后找),只允许本机访问

# 单次使用
.venv/bin/python -m blueprint plan "一句话点子或 PRD 文件路径" -o out/my-plan
.venv/bin/python -m blueprint audit /目标项目路径 [--prd 需求.md] -o out/my-audit
检查项目(audit、verify)默认由 agent 读代码核实,每条结论都附它读过的代码行;一次检查最多调用模型 40 次。想省钱或排查问题时加 --fast,只按关键词扫描,可能误判。
任何一步中断,原命令加 --resume 续跑,已完成的阶段不重复调用模型。
配置模型
在 .env 里填三项即可,向导会帮你写好:
ANTHROPIC_API_KEY=你的 Key
MODEL_ID=deepseek-v4-flash
ANTHROPIC_BASE_URL=https://api.deepseek.com/anthropic
用 GPT(OpenAI 官方,或 OpenAI 格式的中转)时改填这几项。网页「模型设置」和终端问答里选「OpenAI(GPT)」或「OpenAI 格式的中转或其他服务」,也会帮你写好:
API_FORMAT=openai
OPENAI_API_KEY=你的 Key
MODEL_ID=gpt-6-luna
OPENAI_BASE_URL=https://你的中转地址/v1      # 用 OpenAI 官方接口时不填
| 服务商 | 推荐模型 | 说明 |
|---|---|---|
| DeepSeek | deepseek-v4-flash | 推荐,项目的真实基线就是用它跑的 |
| 智谱 GLM | glm-5.2 | |
| Kimi | kimi-k2.7-code | |
| MiniMax | MiniMax-M3 | |
| Anthropic | claude-sonnet-4-6 | 官方接口,不用填 Base URL |
| OpenAI(GPT) | gpt-6-luna | OpenAI 格式。官方接口在国内一般连不上,用中转时填 OPENAI_BASE_URL。gpt-6-astra、gpt-6.1-sol 在这种格式里不能调用工具,会自动改走固定流程 |
各家完整的 Base URL 见 .env.example。
agent 需要模型支持工具调用。DeepSeek 实测支持(Anthropic 格式和 OpenAI 格式都试过);其他服务商或模型中转可以先测一下,三项都通过就能用 agent(这个测试脚本目前只测 Anthropic 格式):
.venv/bin/python tools/probe_tools.py                          # 测 .env 里配的模型
.venv/bin/python tools/probe_tools.py --model 模型名           # 换个模型测
几个开关,需要时在启动前设置:
| 环境变量 | 作用 |
|---|---|
BLUEPRINT_AGENT=off | 推导方案、检查项目都不用 agent,走固定流程 |
BLUEPRINT_PLAY_AGENT=off | 试玩不用 agent,改为一次调用编出整轮(更快,但规矩只靠提示词约束) |
BLUEPRINT_TIMEOUT=300 | 单次请求超时秒数,默认 120;经中转的慢模型容易超时时调大 |
参考用量:
| 操作 | 模型调用 | tokens |
|---|---|---|
| 一份完整方案(agent 推导) | 6–11 次,审稿打回重写时更多 | 约 3–7 万 |
| 一次反向检查(agent 读代码) | 4–9 次 | 约 1–3 万 |
revise --quick | 1–3 次 | 约 0.5–1.5 万 |
| 新建产品时追问一轮 | 2–4 次 | 约 0.1–0.3 万 |
| 试玩里说一句话 | 2–9 次,看它要调几个工具 | 约 0.05–0.7 万 |
每次运行默认最多 40 次调用、150 万 tokens(检查项目加 --fast 时是 16 次、40 万),超出会停下并提示续跑,不会无限扣费。实际用量通常远低于上限。
产出放在哪
引擎孵化的产品,所有东西都在 out/<产品名>/ 一个文件夹里,不会写到桌面或别的地方:
| 文件 | 内容 | 谁产出 |
|---|---|---|
PRD.md | 当前版本的需求文档,给 AI 看,带版本记录 | 引擎建模板和升版,你回答待确认问题后补全 |
prd/V1.md, V2.md … | 每次升版前的快照 | 引擎 |
方案.md, plan.json | 待确认清单、组件选型及理由、架构、工具清单、提示词草案、审稿意见 | 引擎 |
skeleton/ | 代码骨架,唯一允许写产品代码的地方 | 你的 AI 编程工具,引擎不写 |
verify/ | 按方案的组件选型和 PRD 检查骨架的差距报告 | 引擎 |
迭代记录.md | 每一轮:新需求、选型变化、骨架待办、人工验证结论 | 引擎记录;人工验证结论只能由你填 |
引擎不负责部署上线和上线后的运行。
你已有的外部项目保持在原位,只把路径告诉引擎做检查。
17 个 Harness 组件
模型是驾驶者,Harness 是载具。 你构建的是载具,不是智能。
引擎内置 17 个组件,每个都带说明、生产级要点和可运行的参考实现 sNN_*/code.py。选型由固定规则完成:模型只判断需求有没有某个特征,选不选哪个组件由 rules.py 决定,同样的判断永远得到同样的选型。原则是只选需要的,不为完整而选。
| 域 | 组件 | 什么时候需要 |
|---|---|---|
| 行动 | s01 Agent Loop · s02 工具系统 · s14 MCP 插件 | 一切基础;需要接入外部工具生态时加 s14 |
| 约束 | s03 权限系统 · s04 钩子系统 | 涉及删除、支付、隐私等敏感操作;需要审计、拦截、埋点 |
| 认知 | s05 任务规划 · s07 技能加载 · s09 记忆系统 · s17 目标闭环 | 需要跟踪进度;知识库庞大;跨会话记偏好;自动判断何时算完成 |
| 上下文 | s06 子 Agent · s08 上下文压缩 | 子任务会撑爆上下文或可并行;长会话、日志量大 |
| 协作 | s10 任务系统 · s11 后台任务 · s12 定时调度 · s13 Agent 团队 | 目标要持久化续跑;慢操作不能阻塞;定时触发;多任务并行且隔离 |
| 编排 | s15 集成 Harness · s16 工作流运行时 | 选了 3 个以上可选组件需要归一;流程固定可以写死 |
完整的推导方法和选型表见 BLUEPRINT.md。
常见问题
第一次双击提示「无法打开」怎么办? 启动文件没有经过苹果签名,从浏览器下载后第一次双击,macOS 会拦下来,提示「Apple 无法验证……是否包含恶意软件」。放行一次,以后双击就正常了:
- 在弹窗里点「完成」,不要点「移到废纸篓」。
- 打开「系统设置」→ 左栏「隐私与安全性」,右边往下翻到「安全性」。
- 那里会有一行「已阻止"启动界面.command"……」,点旁边的「仍要打开」。没看到这一行的话,先回去再双击一次启动文件,再回来看。
- 输入开机密码(或按指纹),在再次弹出的窗口里点「仍要打开」。
macOS 14 及更早的版本更简单:按住 Control 键点启动文件,选「打开」,再点「打开」。
会用终端的话,也可以一次放行整个文件夹:xattr -dr com.apple.quarantine 解压出来的文件夹路径。用 git clone 下载的不会被拦。
没有 API Key 能用吗?
方式二可以:由你正在用的 AI 按手册分析,报告里会注明「未运行模型管线」。命令行的 --mock 只按关键词占位,用来检查流程能不能跑通,结论不能用于决策。
我的代码会被上传吗?
只会发给你在 .env 里配置的模型服务。正向推导发送你的点子或 PRD。反向检查默认由 agent 读代码,它读过的文件内容会发给模型;.env、私钥等密钥文件一律不读,依赖目录和隐藏目录也会跳过。加 --fast 时只发送 README、目录结构和扫描命中的代码片段。.env 和 out/ 都不进 git,学生打包工具也会排除它们。
结果靠谱吗?
特征判断在题库上的一致率约 90%。模型每次判断会有一两题不一样,所以引擎会拿同一份原文另外判断两次、三票取多数(多 2 次小调用);再次检查同一个项目时,沿用上次检查对「该有什么」的判断,两次报告的差别只来自代码变化,要重新判断加 --rejudge(网页上点「重新判断」)。方案末尾的独立审稿有时会给出「未通过」,这是设计如此:审稿就是要把方案里的矛盾挑出来,这些意见就是你下一轮要回答的问题。agent 推导时会先按规则自检一遍,实测三道题都一次过审,但样本还小。反向报告默认由 agent 读代码核实,「信号覆盖率」按核实结果计算;它没有运行被检查的项目,所以仍然不是功能完成度。
我用的模型很便宜,或者不支持工具调用,会怎样?
不支持工具调用的模型会自动退回固定流程,照样能出方案和报告,只是少了 agent 的自检和核实,试玩里的规矩也只能靠提示词约束。支持工具调用的便宜模型反而更该用 agent:试玩里「禁止」「要确认」由代码保证,不靠模型听不听话。用 tools/probe_tools.py 可以先测一下。
Windows 能用吗?
引擎本身是纯 Python,但只在 macOS 和 Linux 上测试过。Windows 建议用 WSL 或方式二。s13、s15、s16 的参考实现依赖 fcntl,只能在 macOS 和 Linux 上运行。
项目结构
| 位置 | 用途 |
|---|---|
| 使用引导.md | 用户入口:任务模板、产品循环、给 AI 的执行规则 |
| BLUEPRINT.md | 五步推导、五要素、七层架构与组件选型表 |
| blueprint/ | 引擎:需求拆解、规则选型、方案渲染、源码扫描、产品工作区;agent.py 是 agent 循环,intake_agent.py、plan_agent.py、audit_agent.py 分别是追问、方案推导、检查用的 agent;web/ 是浏览器界面的服务端,chat.py 是界面里的几段对话,playground.py 是「试玩」 |
| web/ | 浏览器界面源码(React + assistant-ui),构建产物提交在 blueprint/web/static/ |
s01–s17 | 17 个组件的说明、参考实现与图示 |
| common/ | 组件参考实现共用的启动层 |
| scaffold/ · skills/ | 项目模板;构建 Agent、代码检查等技能 |
| docs/ | 入门指南、真实输出示例、维护手册 |
| evals/ · tests/ | 特征判断题库、反向检查题库(含两道关键词陷阱题)与回归测试 |
| tools/ | 双击向导及其环境脚本、示例刷新、学生打包、测模型能否调用工具 |
开发与维护
.venv/bin/python -m pytest -q                 # 全部测试,不需要 Key
.venv/bin/python -m blueprint eval            # 离线题库回归
.venv/bin/python -m blueprint eval --real     # 真实模型特征一致率
.venv/bin/python -m blueprint eval --real-audit --repeat 3   # 真实模型跑反向检查题库
.venv/bin/python tools/refresh_examples.py    # 改提示词后重新生成示例
.venv/bin/python tools/package_student.py     # 生成 dist/agent-workshop-student.zip
改规则、换模型、调提示词前先看 维护手册,题库口径见 evals/README.md,提交 PR 前看 贡献指南。
文档导航
| 我想… | 看这里 |
|---|---|
| 第一次用 | 使用引导.md |
| 只有一个模糊想法,不知道怎么描述 | 小白入门指南 |
| 看一份完整方案和差距报告 | 真实输出示例 |
| 理解推导方法 | BLUEPRINT.md |
| 改规则、换模型、分发给学生 | 维护手册 |