
hitsz-ids/airda
hitsz-ids/airda has 1,794 GitHub stars and 275 forks. GitHot measured 0 stars in 24 hours. Last checked 2026-11-07 02:08 UTC. Last push 2025-01-07.
airda(Air Data Agent)是面向数据分析的多智能体,能够理解数据开发和数据分析需求、理解数据、生成面向数据查询、数据可视化、机器学习等任务的SQL和Python代码
Measured star growth
- in 24h
- 0
- in 7 days
- Collecting history
- in 15 days
- Collecting history
- in 1 month
- Collecting history
Net star changes over overlapping periods, not daily totals. Missing measurements are left blank. Stars measure attention, not software quality.
README.md
Original📖 介绍
airda(Air Data Agent)是面向数据分析的多智能体,能够理解数据开发和数据分析需求、理解数据、生成面向数据查询、数据可视化、机器学习等任务的SQL和Python代码。
特性:
- 精准数据检索:airda具有强大的数据处理和搜索能力,可以从成百上千张表中精准找数,满足您在大数据环境下的数据查找需求。
- 业务知识理解:airda不仅能处理数据,还深入理解数据指标、计算公式等业务知识,为您提供更深层次、更具业务价值的数据分析。
- 多智能体协同工作:airda采用面向数据分析需求的多轮对话设计,多智能体可以协同工作,进行数据分析代码的self-debug,提升分析效率,降低错误率。
- 数据可视化:airda可以将复杂的数据通过可视化的方式呈现,让数据分析结果更易于理解,帮助您更好地做出决策。
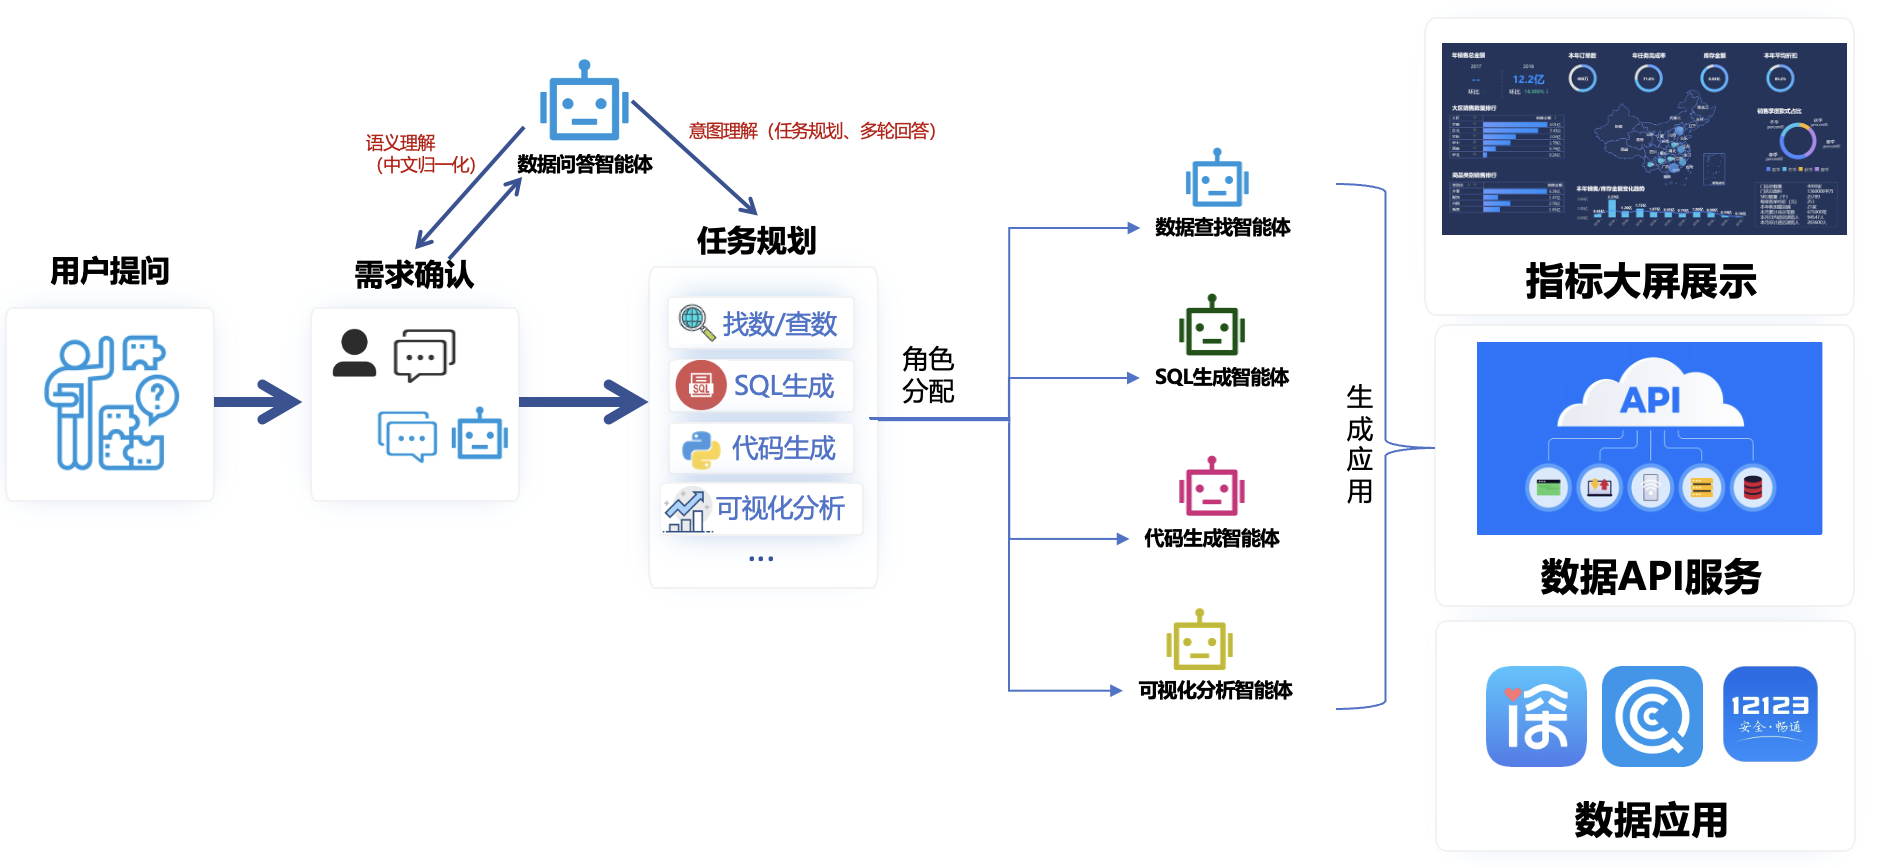
airda工作流程:
- 需求确认: airda与用户建立对话,理解用户的需求。在这一阶段,airda会提出一系列问题,以便更准确地了解用户的需求。
- 任务规划: airda会根据最终确认的需求内容为用户制定任务规划。这个规划包括一系列步骤,airda会按照这些步骤来为用户提供服务。
- 任务执行: airda将规划好的任务分配给不同的智能体,如数据查找智能体、SQL生成智能体、代码生成智能体、可视化分析智能体等。每个智能体负责其专业领域的任务执行,协同工作以确保任务的高效完成。
- 应用生成: airda根据用户需求任务将结果数据转化为应用成果,如指标大屏展示、数据API服务和数据应用等,这些成果能够以可视化的形式展示关键数据指标,提供API接口供其他系统或服务调用,以及根据用户需求生成具体的应用程序。
完成进度:
- SQL生成
- 数据接入
- 知识库
- 语料库
- 图表生成
- 任务规划
✨ 快速开始
环境要求
Python>=3.10
安装 airda
pip安装
pip install airda -i https://pypi.python.org/simple/
依赖安装
使用airda需要用到mongodb,可采用docker安装mongodb
#拉取mongo镜像
docker pull mongo
docker run -itd --name mongo -v /{path_of_mongo_data}:/data/db -p 27017:27017 mongo
自定义配置
环境变量
下载.env.template自定义embedding模型,mongo配置,以及openai配置
airda env load -p {your_path}/.env_template
日志文件(非必须)
下载log_config.yml.template,自定义日志配置
airda log load -p {your_path}/log_config.yml.template
Embedding Model
airda默认使用stella-large-zh-v2模型, 模型默认下载到~/.cache/huggingface/hub/路径,目录下没有需要手动下载
相关配置命令
添加你的数据源
airda datasource add -n {datasource_name} -h {host} -p {port} -k MYSQL -d {database} -u {username} -w {password}
#当前只支持kind为MYSQL的数据源
训练数据源的schema
airda datasource sync -n {datasource_name}
查询当前可用的数据源
airda datasource ls
开始问答
airda run cli -n {datasource_name}
#输入你的问题:
👏 贡献
我们欢迎各种贡献和建议,共同努力,使本项目更上一层楼!麻烦遵循以下步骤:
- 步骤1: 如果您想添加任何额外的功能、增强功能或在使用过程中遇到任何问题,请发布一个 问题 。如果您能遵循 问题模板 我们将不胜感激。问题将在那里被讨论和分配。
- 步骤2: 无论何时,当一个问题被分配后,您都可以按照 PR模板 创建一个 拉取请求 进行贡献。您也可以认领任何公开的问题。共同努力,我们可以使airda变得更好!
- 步骤3: 在审查和讨论后,PR将被合并或迭代。感谢您的贡献!
在您开始之前,我们强烈建议您花一点时间检查 这里 再进行贡献。
Explore related projects
Asabeneh/30-Days-Of-Python
The 30 Days of Python programming challenge is a step-by-step guide to learn the Python programming language in 30 days. This challenge may take more than 100 days. Follow your own pace. These videos may help too: https://www.youtube.com/channel/UC7PNRuno1rzYPb1xLa4yktw
78,303 starsgrafana/grafana
The open and composable observability and data visualization platform. Visualize metrics, logs, and traces from multiple sources like Prometheus, Loki, Elasticsearch, InfluxDB, Postgres and many more.
77,725 starsredis/redis
For developers, who are building real-time data-driven applications, Redis is the preferred, fastest, and most feature-rich cache, data structure server, and document and vector query engine.
77,268 starsapache/superset
Apache Superset is a Data Visualization and Data Exploration Platform
75,439 stars