
ChenHsing/Awesome-Video-Diffusion-Models
ChenHsing/Awesome-Video-Diffusion-Models has 2,329 GitHub stars and 123 forks. GitHot measured 0 stars in 24 hours and 0 in 7 days. Last checked 2026-11-08 08:39 UTC. Last push 2026-09-04.
[CSUR] A Survey on Video Diffusion Models
Measured star growth
- in 24h
- 0
- in 7 days
- 0
- in 15 days
- Update delayed
- in 1 month
- Update delayed
Net star changes over overlapping periods, not daily totals. Missing measurements are left blank. Stars measure attention, not software quality.
README.md
OriginalA Survey on Video Diffusion Models 

Zhen Xing, Qijun Feng, Haoran Chen, Qi Dai, Han Hu, Hang Xu, Zuxuan Wu, Yu-Gang Jiang
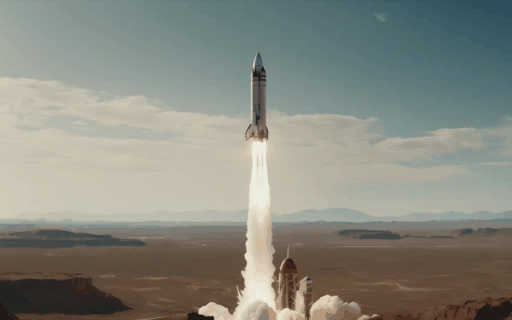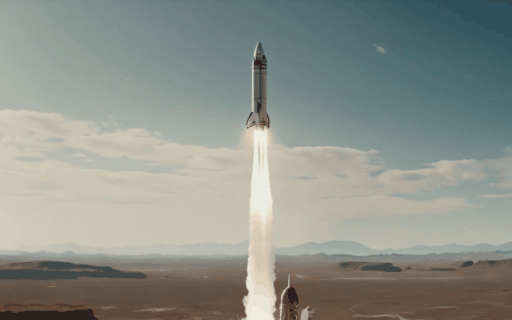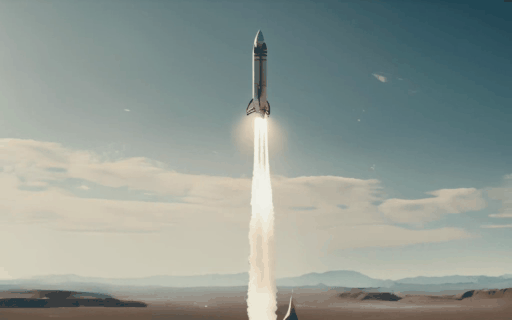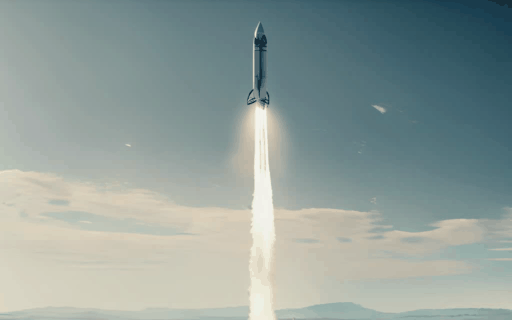
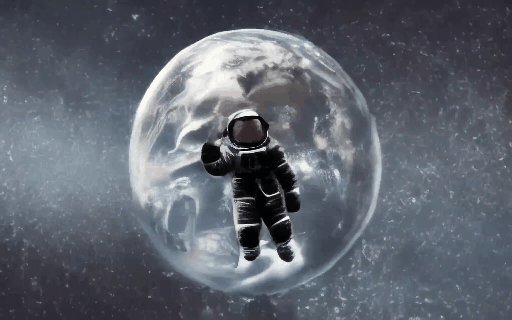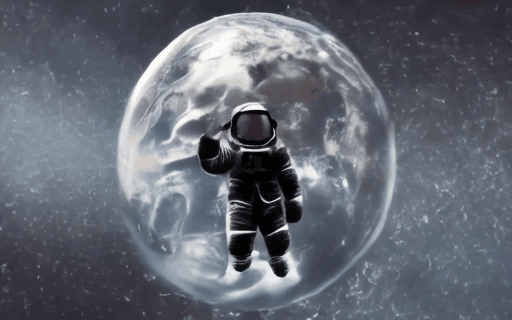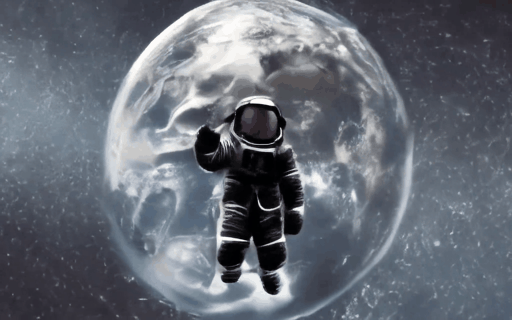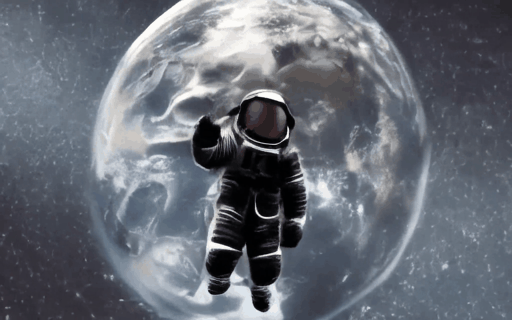
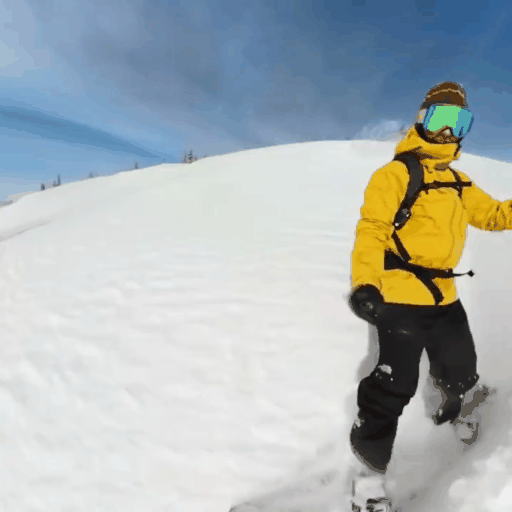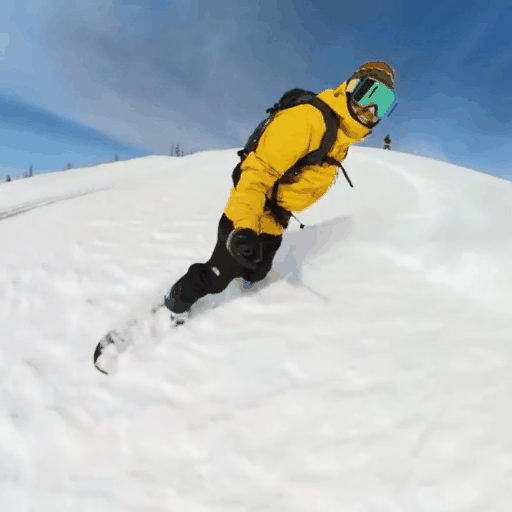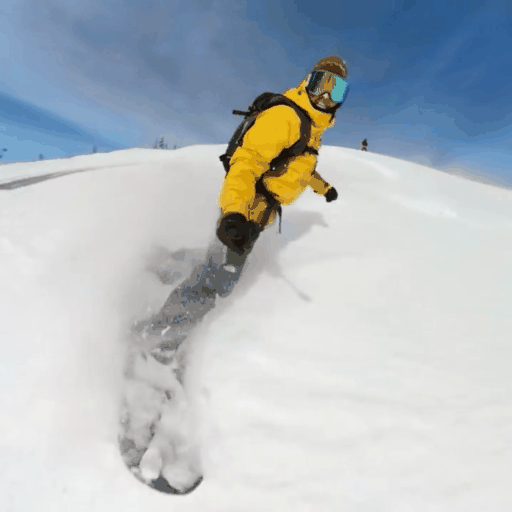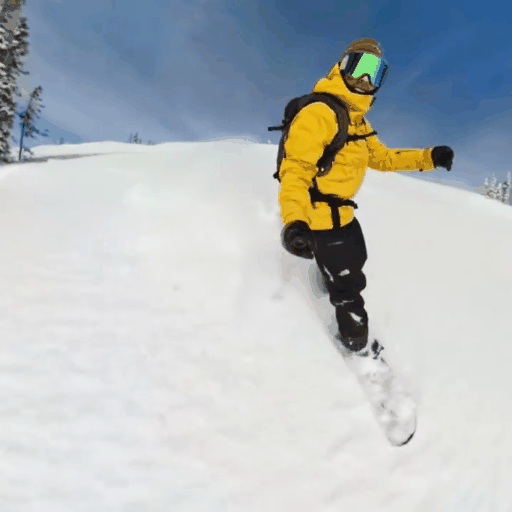
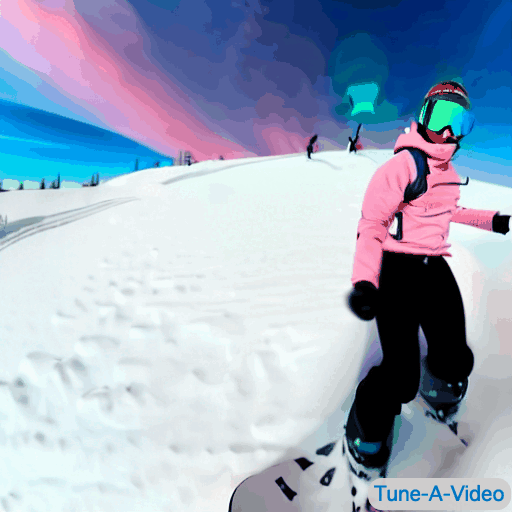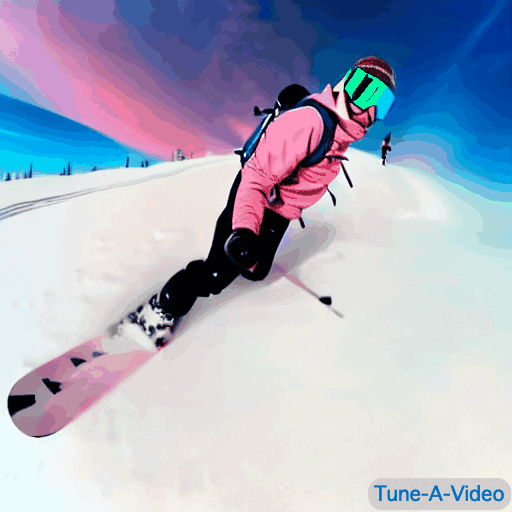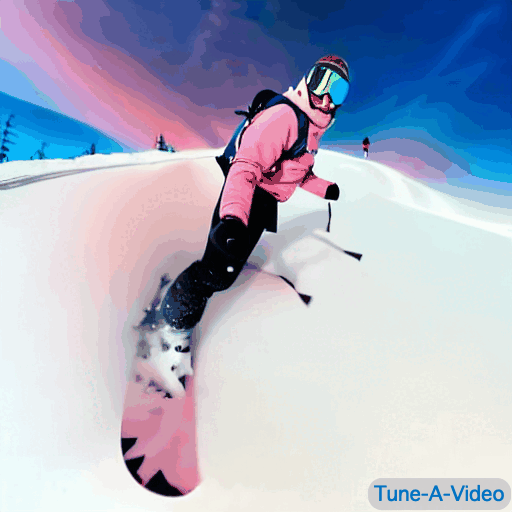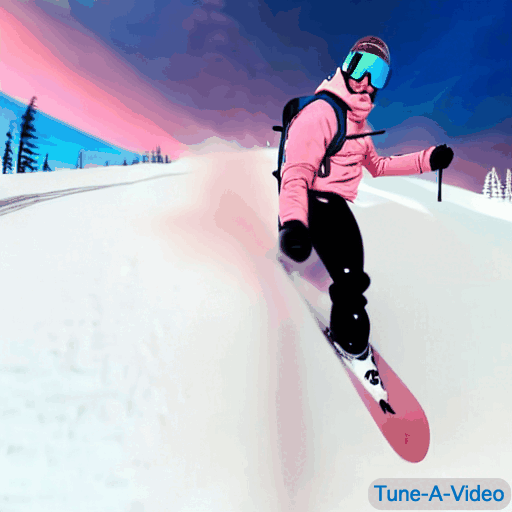
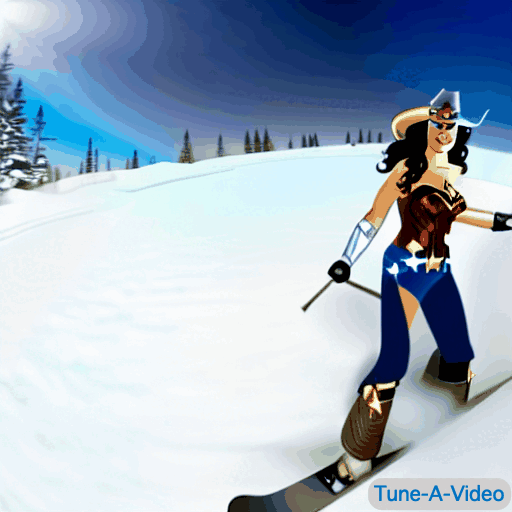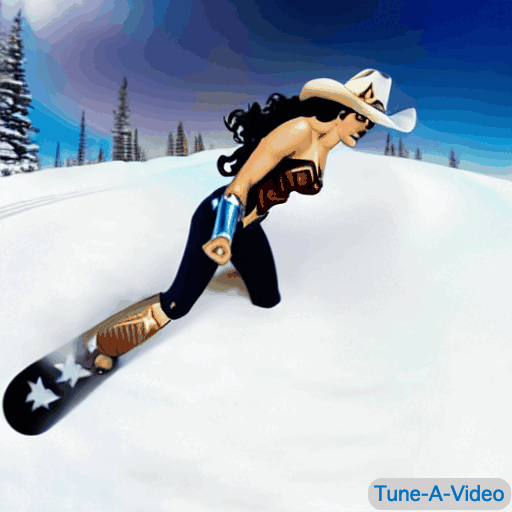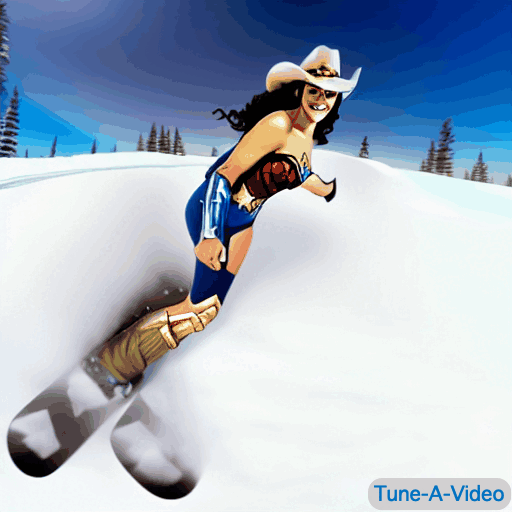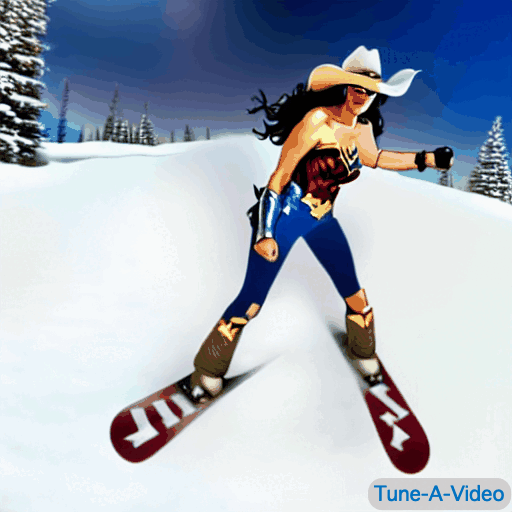
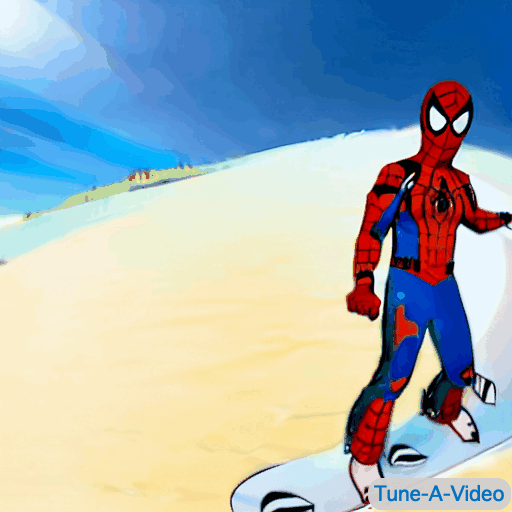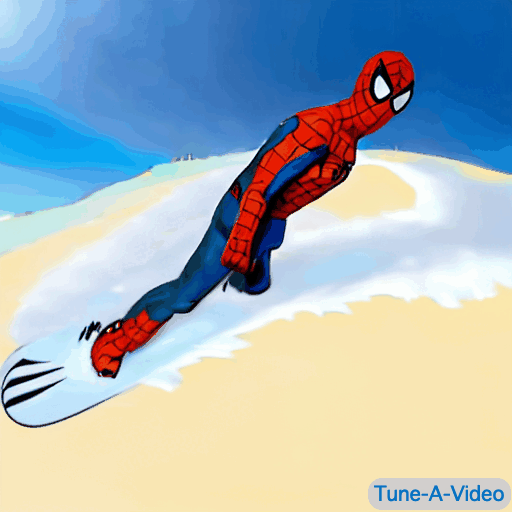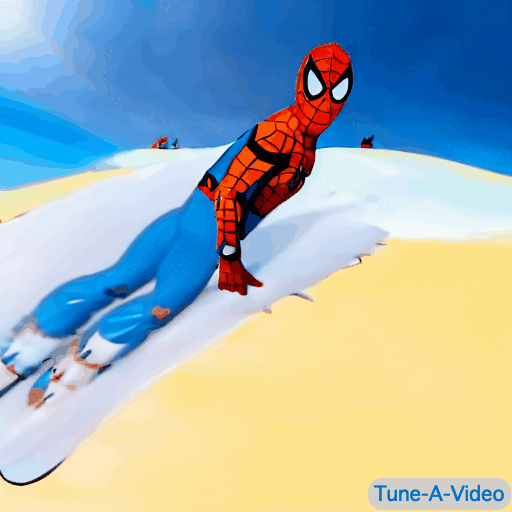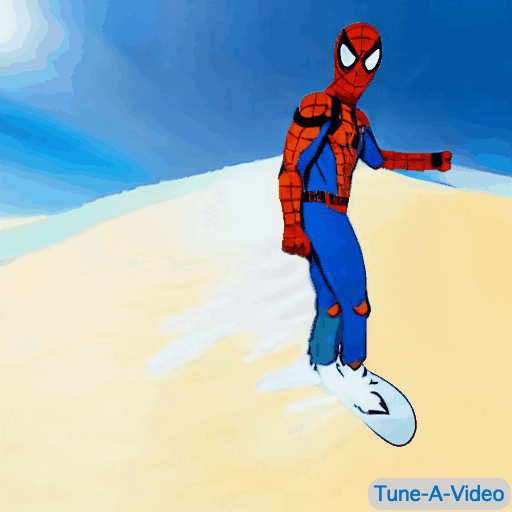
(Source: Make-A-Video, SimDA, PYoCo, SVD , Video LDM and Tune-A-Video)
- [News] The updated version is available on arXiv.
- [News] Our survey is accepted by ACM Computing Surveys (CSUR).
- [News] The Chinese translation is available on Zhihu. Special thanks to Dai-Wenxun for this.
Contact
If you have any suggestions or find our work helpful, feel free to contact us
Homepage: Zhen Xing
Email: [email protected]
If you find our survey is useful in your research or applications, please consider giving us a star 🌟 and citing it by the following BibTeX entry.
@article{xing2023survey,
  title={A survey on video diffusion models},
  author={Xing, Zhen and Feng, Qijun and Chen, Haoran and Dai, Qi and Hu, Han and Xu, Hang and Wu, Zuxuan and Jiang, Yu-Gang},
  journal={ACM Computing Surveys},
  year={2023},
  publisher={ACM New York, NY}
}
Open-source Toolboxes and Foundation Models
| Methods | Task | Github |
|---|---|---|
| Helios | T2V Generation |  |
| Movie Gen | T2V Generation | - |
| CogVideoX | T2V Generation |  |
| Open-Sora-Plan | T2V Generation |  |
| Open-Sora | T2V Generation |  |
| Morph Studio | T2V Generation | - |
| Genie | T2V Generation | - |
| Sora | T2V Generation & Editing | - |
| VideoPoet | T2V Generation & Editing | - |
| Stable Video Diffusion | T2V Generation |  |
| NeverEnds | T2V Generation | - |
| Pika | T2V Generation | - |
| EMU-Video | T2V Generation | - |
| GEN-2 | T2V Generation & Editing | - |
| ModelScope | T2V Generation |  |
| ZeroScope | T2V Generation | - |
| T2V Synthesis Colab | T2V Genetation |  |
| VideoCraft | T2V Genetation & Editing |  |
| Diffusers (T2V synthesis) | T2V Genetation | - |
| AnimateDiff | Personalized T2V Genetation |  |
| Text2Video-Zero | T2V Genetation |  |
| HotShot-XL | T2V Genetation |  |
| Genmo | T2V Genetation | - |
| Fliki | T2V Generation | - |
| Seedream AI Studio | Image Generation + I2V Animation | - |
| Omni-Rewriter | Prompt Expansion (Video/Image PE) |  |
Table of Contents
Video Generation
Data
Caption-level


| MiniMax H3 1K Prompt Dataset | 
 |

Category-level
| Title | arXiv | Github | WebSite | Pub. & Date |
|---|---|---|---|---|
| UCF101: A Dataset of 101 Human Actions Classes From Videos in The Wild | |
- | - | Dec., 2012 |
| First Order Motion Model for Image Animation | |
- | - | May, 2023 |
| Learning to Generate Time-Lapse Videos Using Multi-Stage Dynamic Generative Adversarial Networks | |
- | - | CVPR,2018 |
Metric and BenchMark


Text-to-Video Generation
Training-based


Training-free


Video Generation with other conditions
Pose-guided Video Generation


Motion-guided Video Generation


Sound-guided Video Generation
| Title | arXiv | Github | WebSite | Pub. & Date |
|---|---|---|---|---|
| Hallo: Hierarchical Audio-Driven Visual Synthesis for Portrait Image Animation | |
 |
|
Jun., 2024 |
| Context-aware Talking Face Video Generation | |
- | - | Feb., 2024 |
| EMO: Emote Portrait Alive - Generating Expressive Portrait Videos with Audio2Video Diffusion Model under Weak Conditions | |
 |
|
Feb., 2024 |
| The Power of Sound (TPoS): Audio Reactive Video Generation with Stable Diffusion | |
- | - | ICCV, 2023 |
| Generative Disco: Text-to-Video Generation for Music Visualization | |
- | - | Apr., 2023 |
| AADiff: Audio-Aligned Video Synthesis with Text-to-Image Diffusion | |
- | - | CVPRW, 2023 |
Image-guided Video Generation


Brain-guided Video Generation
| Title | arXiv | Github | WebSite | Pub. & Date |
|---|---|---|---|---|
| NeuroCine: Decoding Vivid Video Sequences from Human Brain Activties | |
- | - | Feb., 2024 |
| Cinematic Mindscapes: High-quality Video Reconstruction from Brain Activity | |
 |
|
NeurIPS, 2023 |
Depth-guided Video Generation
| Title | arXiv | Github | WebSite | Pub. & Date |
|---|---|---|---|---|
| StableV2V: Stablizing Shape Consistency in Video-to-Video Editing | |
 |
|
Nov., 2024 |
| Animate-A-Story: Storytelling with Retrieval-Augmented Video Generation | |
 |
|
Jul., 2023 |
| Make-Your-Video: Customized Video Generation Using Textual and Structural Guidance | |
 |
|
Jun., 2023 |
Multi-modal guided Video Generation


Unconditional Video Generation
U-Net based
| Title | arXiv | Github | WebSite | Pub. & Date |
|---|---|---|---|---|
| Hybrid Video Diffusion Models with 2D Triplane and 3D Wavelet Representation | |
 |
|
Feb. 2024 |
| Video Probabilistic Diffusion Models in Projected Latent Space | |
 |
|
CVPR 2023 |
| VIDM: Video Implicit Diffusion Models | |
 |
|
AAAI 2023 |
| GD-VDM: Generated Depth for better Diffusion-based Video Generation | |
 |
- | Jun., 2023 |
| LEO: Generative Latent Image Animator for Human Video Synthesis | |
 |
|
May., 2023 |
Transformer based
| Title | arXiv | Github | WebSite | Pub. & Date |
|---|---|---|---|---|
| FEAT: Full-Dimensional Efficient Attention Transformer for Medical Video Generation | |
 |
- | Jun., 2025 |
| Redefining Temporal Modeling in Video Diffusion: The Vectorized Timestep Approach | |
 |
- | Oct., 2024 |
| Latte: Latent Diffusion Transformer for Video Generation | |
 |
|
Jan., 2024 |
| VDT: An Empirical Study on Video Diffusion with Transformers | |
 |
- | May, 2023 |
| Long Video Generation with Time-Agnostic VQGAN and Time-Sensitive Transformer | |
 |
|
May, 2023 |
Video Completion
Video Enhancement and Restoration
| Title | arXiv | Github | WebSite | Pub. & Date |
|---|---|---|---|---|
| Towards Language-Driven Video Inpainting via Multimodal Large Language Models | |
 |
|
Jan., 2024 |
| Inflation with Diffusion: Efficient Temporal Adaptation for Text-to-Video Super-Resolution | - | - | - | WACW, 2023 |
| Upscale-A-Video: Temporal-Consistent Diffusion Model for Real-World Video Super-Resolution | |
 |
|
Dec., 2023 |
| AVID: Any-Length Video Inpainting with Diffusion Model | |
 |
|
Dec., 2023 |
| Motion-Guided Latent Diffusion for Temporally Consistent Real-world Video Super-resolution | |
 |
- | CVPR 2023 |
| LDMVFI: Video Frame Interpolation with Latent Diffusion Models | |
- | - | Mar., 2023 |
| CaDM: Codec-aware Diffusion Modeling for Neural-enhanced Video Streaming | |
- | - | Nov., 2022 |
| Look Ma, No Hands! Agent-Environment Factorization of Egocentric Videos | |
- | - | May., 2023 |
Video Prediction


Video Editing
General Editing Model

Training-free Editing Model


One-shot Editing Model


Instruct-guided Video Editing
| Title | arXiv | Github | Website | Pub. Date |
|---|---|---|---|---|
| VIA: A Spatiotemporal Video Adaptation Framework for Global and Local Video Editing | |
 |
|
Jun, 2024 |
| EffiVED:Efficient Video Editing via Text-instruction Diffusion Models | |
- | - | Mar, 2024 |
| Fairy: Fast Parallellized Instruction-Guided Video-to-Video Synthesis | |
- | |
Dec, 2023 |
| Neural Video Fields Editing | |
 |
|
Dec, 2023 |
| VIDiff: Translating Videos via Multi-Modal Instructions with Diffusion Models | |
 |
|
Nov, 2023 |
| Consistent Video-to-Video Transfer Using Synthetic Dataset | |
- | - | Nov., 2023 |
| InstructVid2Vid: Controllable Video Editing with Natural Language Instructions | |
- | - | May, 2023 |
| Collaborative Score Distillation for Consistent Visual Synthesis | |
- | - | July, 2023 |
Motion-guided Video Editing
| Title | arXiv | Github | Website | Pub. Date |
|---|---|---|---|---|
| TrajectoryMover: Generative Movement of Object Trajectories in Videos | |
 |
|
Mar, 2026 |
| MotionCtrl: A Unified and Flexible Motion Controller for Video Generation | |
 |
|
Nov, 2023 |
| Drag-A-Video: Non-rigid Video Editing with Point-based Interaction | |
- | |
Nov, 2023 |
| DragVideo: Interactive Drag-style Video Editing | |
 |
- | Nov, 2023 |
| VideoControlNet: A Motion-Guided Video-to-Video Translation Framework by Using Diffusion Model with ControlNet | |
- | |
July, 2023 |
Sound-guided Video Editing
| Title | arXiv | Github | Website | Pub. Date |
|---|---|---|---|---|
| Speech Driven Video Editing via an Audio-Conditioned Diffusion Model | |
- | - | May., 2023 |
| Soundini: Sound-Guided Diffusion for Natural Video Editing | |
 |
|
Apr., 2023 |
Multi-modal Control Editing Model


Domain-specific Editing Model


Non-diffusion Editing model
| Title | arXiv | Github | Website | Pub. Date |
|---|---|---|---|---|
| DynVideo-E: Harnessing Dynamic NeRF for Large-Scale Motion- and View-Change Human-Centric Video Editing | |
- | |
Oct., 2023 |
| INVE: Interactive Neural Video Editing | |
- | |
Jul., 2023 |
| Shape-Aware Text-Driven Layered Video Editing | |
- | |
Jan., 2023 |
Video Understanding


Explore related projects
ytdl-org/youtube-dl
Command-line program to download videos from YouTube.com and other video sites
141,487 starsexcalidraw/excalidraw
Virtual whiteboard for sketching hand-drawn like diagrams
135,331 starsgodotengine/godot
Godot Engine – Multi-platform 2D and 3D game engine
119,771 starsmrdoob/three.js
JavaScript 3D Library.
117,842 stars