
tocreator/tostore
tocreator/tostore has 67 GitHub stars and 11 forks. GitHot measured 0 stars in 24 hours and 0 in 7 days. Last checked 2026-11-15 04:06 UTC. Last push 2026-11-05.
What you can do
- Declarative schema changes—automatic refactoring, no manual versioning
- Key rotation, schema migration, massive refactoring—all online, business-transparent
- Built-in status spec for automated O&M and Agent recognition
- Supports autonomous evolution and continuous iteration without interrupting service
측정된 스타 증가
- in 24h
- 0
- in 7 days
- 0
- in 15 days
- 기록 수집 중
- in 1 month
- 기록 수집 중
서로 겹치는 기간의 순증가량이며 일별 합계가 아닙니다. 측정값이 없으면 비워 둡니다. 스타는 관심도를 나타내며 품질을 보장하지 않습니다.
소개
Data engine: AI vector & SQL/NoSQL database. Key-value/KV, embeddings, BM25 full-text, hybrid & semantic search for RAG/LLM. Local storage, TTL/LRU cache, offline encrypted.
AIdoc/translations/ko/README.md
Original


English | 简体中文 | 日本語 | 한국어 | Español | Português (Brasil) | Русский | Deutsch | Français | Italiano | Türkçe
빠른 탐색
- ToStore를 선택해야 하는 이유 | 주요 기능 | 설치 안내 | KV 모드 | 테이블 모드 | 메모리 모드
- 스키마 정의 | 분산 아키텍처 | 계단식 외래 키 | 모바일/데스크톱 | 서버/에이전트 | 기본 키 알고리즘
- 고급 쿼리(JOIN) | 집계 및 통계 | 복잡한 논리(쿼리조건) | 반응형 쿼리(보기) | 스트리밍 쿼리
- KV 고급 작업 | 일괄 작업 | 복구 보장 | 하이브리드 검색(밀집 / 희소 / 텍스트) | 테이블 수준 TTL | 용량 제거 | 효율적인 페이지 매김 | 메모리 프로브 및 동기 검색 (peek) | 쿼리 캐시 | 원자 표현 | 거래
- 관리 | 보안설정 | 오류 처리 | 성능 및 진단 | 기여 | AI 코딩 어시스턴트
왜 ToStore를 선택해야 할까요?
ToStore는 AGI 시대와 엣지 인텔리전스 시나리오를 위해 설계된 현대적인 데이터 엔진입니다. Self-Routing 노드 아키텍처를 기반으로 노드에 높은 자율성과 유연한 수평적 확장성을 제공하며, 성능과 데이터 규모를 논리적으로 분리합니다—엣지와 클라우드 단일 노드는 구조화 테이블 조 단위 이상, 벡터·희소 텍스트 검색은 100억 건 이상 규모를 지원하도록 설계되었습니다.
런타임 모델링과 논블로킹 실행 경로를 통해 아키텍처 진화는 항상 온라인이며 비즈니스에 완전히 투명합니다—선언적 스키마 변경, 데이터 인코딩 키 순환, 대규모 데이터 리팩토링이 모두 온라인에서 원활하게 수행됩니다. Agent와 자동화 운영을 위한 런타임 테이블 생성, 동적 메모리 진화 및 이들의 자율적 진화와 지속적 반복을 지원하며, 서비스는 중단되지 않습니다.
관계형 구조화 데이터, 밀집 벡터, 신경 희소 벡터, 비구조화 텍스트를 단일 엔진에 통합하며, 어휘 텍스트 검색·밀집 벡터 검색·신경 희소 검색·다중 경로 리콜 융합을 내장합니다. 아울러 ACID 트랜잭션, 복잡한 관계형 쿼리(JOIN, 계단식 외래 키), 테이블 수준 TTL, 집계, 분산 기본 키 알고리즘, 원자성 표현식, 암호화, 다중 공간 격리, 자가 복구 등 엔터프라이즈급 기능을 제공합니다.
컴퓨팅이 엣지 인텔리전스로 계속 전환됨에 따라, 디바이스는 더 이상 단순한 "콘텐츠 디스플레이"가 아닌 로컬 생성, 환경 인식, 실시간 의사 결정, 조정된 데이터 흐름을 담당하는 지능형 노드입니다. ToStore는 엣지에 대규모 데이터셋과 복잡한 로컬 AI 생성을 지원하는 분산 기능을 제공하며, 엣지와 클라우드 간의 깊은 인텔리전트 협업을 통해 멀티모달 상호작용, 장기 메모리, RAG 및 로컬 지식 베이스, 하이브리드 검색, 공간 모델링, 엣지 자율 협업 등의 시나리오에 신뢰할 수 있는 데이터 기반을 제공합니다.
주요 기능
🤖 런타임 진화와 지능형 운영
- 선언적 스키마 변경—자동 리팩토링, 수동 버전 관리 불필요
- 키 순환, 스키마 마이그레이션, 대규모 리팩토링—모두 온라인, 비즈니스 투명
- 자동화 운영 및 Agent 인식을 위한 상태 사양 내장
- 서비스 중단 없이 자율적 진화와 지속적 반복을 지원
🧠 Self-Routing 분산 아키텍처
- 물리적 주소 지정과 데이터 규모를 분리하는 Self-Routing 노드 아키텍처
- 고도로 자율적인 노드가 협력하여 유연한 데이터 토폴로지 구축
- 탄력적 수평 확장; 단일 노드 테이블 조 단위·벡터 100억 건 이상
🌐 통합 크로스 플랫폼 데이터 엔진
- 모바일, 데스크톱, 웹, 서버 환경 전반에 걸친 통합 API
- 관계형 데이터, 밀집 / 신경 희소 벡터, 텍스트 검색 커버
- 로컬 스토리지부터 엣지-클라우드 협업까지 완전한 데이터 파이프라인
🔍 구조화 쿼리 및 하이브리드 검색
- 복잡한 조건, JOIN, 집계, 테이블 수준 TTL 및 용량 제거(FIFO / LRU)
- 어휘 텍스트·밀집 벡터·신경 희소 검색을 동일 쿼리 체인에서 조합
- 다중 경로 리콜 융합 랭킹. 점수와 채널 진단을 결과와 함께 반환
⚡ 병렬 실행 및 리소스 스케줄링
- 콜드 스타트는 데이터 규모와 무관하게 약 35 ms 유지
- 리소스 인식 로드 스케줄링; 다중 노드 병렬 작업 분해
- 고부하 시에도 UI 애니메이션을 부드럽게 유지하는 타임 슬라이싱
🔐 오프라인 우선 및 프라이버시
- 데이터를 기기에 보관하고 오프라인에서도 사용 가능하여 클라우드 의존성과 노출면을 줄임
- 다중 공간 격리와 선택적 전역 공유, 다중 사용자 / 멀티테넌트에 적합
- ChaCha20-Poly1305 및 AES-256-GCM 암호화 내장
- 다수의 복잡한 재해 복구 시나리오를 통해 검증됨
설치
[!IMPORTANT] v2.x에서 업그레이드하시겠습니까? 중요한 마이그레이션 단계 및 주요 변경 사항에 대해서는 v3.x 업그레이드 가이드를 읽어보세요.
pubspec.yaml에 tostore을 추가하세요.
dependencies:
  tostore: any # Please use the latest version
For AI Coding Assistants
AI 어시스턴트로 ToStore 클라이언트 코드를 생성할 때는 단일 파일 명세 llms-full.txt를 제공하세요. IDE에서 @llms-full.txt, 파일 업로드/붙여넣기, 또는 raw URL을 어시스턴트 문서에 등록하면 됩니다. API 시그니처·제약·안티패턴이 포함되어 공개 API에 맞게 작성하는 데 도움이 됩니다. 인덱스: llms.txt.
빠른 시작
[!TIP] 저장 모드를 어떻게 선택해야 합니까?
- 키-값 모드(KV): 구성 액세스, 분산 상태 관리 또는 JSON 데이터 저장에 가장 적합합니다. 시작하는 가장 빠른 방법입니다.
- 구조화된 테이블 모드: 복잡한 쿼리, 제약 조건 확인 또는 대규모 데이터 거버넌스가 필요한 핵심 비즈니스 데이터에 가장 적합합니다. 무결성 로직을 엔진에 적용하면 애플리케이션 계층 개발 및 유지 관리 비용을 크게 줄일 수 있습니다.
- 메모리 모드: 임시 계산, 단위 테스트, 유계 인메모리 캐시(TTL 및 FIFO / LRU 용량 제거) 또는 초고속 전역 상태 관리에 가장 적합합니다. 글로벌 쿼리와
watch리스너를 사용하면 수많은 글로벌 변수를 유지하지 않고도 애플리케이션 상호 작용을 재구성할 수 있습니다.
키-값 저장소(KV)
이 모드는 사전 정의된 구조화된 테이블이 필요하지 않은 경우에 적합합니다. 간단하고 실용적이며 고성능 스토리지 엔진이 지원됩니다. 효율적인 인덱싱 아키텍처는 매우 큰 데이터 규모의 일반 모바일 장치에서도 쿼리 성능을 매우 안정적으로 유지하고 응답성이 뛰어납니다. 서로 다른 공간의 데이터는 자연스럽게 격리되는 동시에 글로벌 공유도 지원됩니다.
// Initialize the database
final db = await ToStore.open();

// Set key-value pairs (supports String, int, bool, double, Map, List, Json, and more)
await db.setValue('user_profile', {
  'name': 'John',
  'age': 25,
});

// Switch space - isolate data for different users
await db.switchSpace(spaceName: 'user_123');

// Set a globally shared variable (isGlobal: true enables cross-space sharing, such as login state)
await db.setValue('current_user', 'John', isGlobal: true);

// Automatic expiration cleanup (TTL)
// Supports either a relative lifetime (ttl) or an absolute expiration time (expiresAt)
await db.setValue('temp_config', 'value', ttl: Duration(hours: 2));
await db.setValue('session_token', 'abc', expiresAt: DateTime(2026, 2, 31));

// Read data
final profile = await db.getValue('user_profile'); // Map<String, dynamic>

// Listen for real-time value changes (useful for refreshing local UI without extra state frameworks)
db.watchValue('current_user', isGlobal: true).listen((value) {
  print('Logged-in user changed to: $value');
});

// Listen to multiple keys at once
db.watchValues(['current_user', 'login_status']).listen((map) {
  print('Multiple config values were updated: $map');
});

// Remove data
await db.removeValue('current_user');
[!TIP] 더 많은 키-값 기능이 필요하십니까? 타입 안정성이 보장된 읽기(
getInt,getBool), 원자적 증가, 접두사 검색, 체이닝 페이지 단위 레코드 쿼리(db.kv.query()) 등 고급 작업은 키-값 고급 작업 (db.kv)을 참조하십시오.
Flutter UI 자동 새로고침 예시
Flutter에서 StreamBuilder과 watchValue은 매우 간결한 반응형 새로 고침 흐름을 제공합니다.
StreamBuilder(
  // When listening to a global variable, remember to set isGlobal: true
  stream: db.watchValue('current_user', isGlobal: true),
  builder: (context, snapshot) {
    // snapshot.data is the latest value of 'current_user' in KV storage
    final user = snapshot.data ?? 'Not logged in';
    return Text('Current user: $user');
  },
)
구조화된 테이블 모드
구조화된 테이블의 CRUD를 사용하려면 스키마를 미리 생성해야 합니다(스키마 정의 참조). 다양한 시나리오에 권장되는 통합 접근 방식:
- 모바일/데스크톱: 자주 시작하는 시나리오의 경우 초기화 시
schemas을 전달하는 것이 좋습니다. - 서버/에이전트: 장기 실행 시나리오의 경우
createTables을 통해 동적으로 테이블을 생성하는 것이 좋습니다.
// 1. Initialize the database
final db = await ToStore.open();

// 2. Insert data (prepare some base records)
final result = await db.insert('users', {
  'username': 'John',
  'email': '[email protected]',
  'age': 25,
});

// Unified operation result model: DbResult
// It is recommended to check hasErrors
if (!result.hasErrors) {
  print('Insert succeeded, generated primary key ID: ${result.firstPrimaryKey}');
} else {
  print('Insert failed: ${result.message}');
}

// Chained query (see [Query Operators](#query-operators); supports =, !=, >, <, LIKE, IN, and more)
final users = await db.query('users')
    .where('age', '>', 20)
    .where('username', 'like', '%John%')
    .orderByDesc('age')
    .limit(20);

// Update and delete
await db.update('users', {'age': 26}).where('username', '=', 'John');
await db.delete('users').where('username', '=', 'John');

// Real-time listening (see [Reactive Query](#reactive-query) for more details)
db.query('users').where('age', '>', 18).watch().listen((users) {
  print('Users matching the condition have changed: $users');
});

// Pair with Flutter StreamBuilder for automatic local UI refresh
StreamBuilder(
  stream: db.query('users').where('age', '>', 18).watch(),
  builder: (context, snapshot) {
    final users = snapshot.data ?? [];
    return ListView.builder(
      itemCount: users.length,
      itemBuilder: (context, index) => Text(users[index]['username']),
    );
  },
);
메모리 모드
캐싱, 임시 계산 또는 디스크에 대한 지속성이 필요하지 않은 작업 부하와 같은 시나리오의 경우 ToStore.memory()을 통해 순수 메모리 내 데이터베이스를 초기화할 수 있습니다. 이 모드에서는 스키마, 인덱스, 키-값 쌍을 포함한 모든 데이터가 최대 읽기/쓰기 성능을 위해 메모리에 완전히 저장됩니다.
메모리 모드도 여러 제거 전략을 지원합니다. 시간 기반 테이블 수준 TTL / KV TTL과 건수·크기 기반 용량 제거(FIFO / LRU). 단독 또는 함께 써서 핫 데이터를 기한에 맞춰 만료시키거나 한도 내로 유지하세요—세션 캐시·쿼리 결과 풀 등 메모리에 민감한 경로에 적합합니다.
💡 전역 상태 관리로도 작동
전역 변수 더미나 무거운 상태 관리 프레임워크가 필요하지 않습니다. 메모리 모드를 watchValue 또는 watch()과 결합하면 위젯과 페이지 전체에서 완전 자동 UI 새로 고침을 달성할 수 있습니다. 데이터베이스의 강력한 검색 기능을 유지하면서 일반 변수를 훨씬 뛰어넘는 반응형 경험을 제공하므로 로그인 상태, 실시간 구성 또는 글로벌 메시지 카운터에 이상적입니다.
[!CAUTION] 참고: 순수 메모리 모드에서 생성된 데이터는 앱을 닫거나 다시 시작하면 완전히 손실됩니다. 핵심 비즈니스 데이터에는 사용하지 마세요.
// Pure in-memory DB — TTL and/or FIFO/LRU capacity eviction as needed
final memDb = await ToStore.memory(
  config: DataStoreConfig(
    kvCapacityConfig: CapacityConfig(
      maxEntries: 5000,
      policy: CapacityEvictionPolicy.lru,
    ),
  ),
);

// Set a global state value (for example: unread message count)
await memDb.setValue('unread_count', 5, isGlobal: true);

// Listen from anywhere in the UI without passing parameters around
memDb.watchValue<int>('unread_count', isGlobal: true).listen((count) {
  print('UI automatically sensed the message count change: $count');
});

// All CRUD, KV access, and vector search run at in-memory speed
await memDb.insert('active_users', {'name': 'Marley', 'status': 'online'});
스키마 정의
한 번 정의하면 엔진이 엔드투엔드 자동화 거버넌스를 처리하게 되므로 애플리케이션이 더 이상 과도한 검증 유지 관리를 수행하지 않아도 됩니다.
다음 모바일, 서버 측 및 에이전트 예제는 모두 여기에 정의된 appSchemas을 재사용합니다.
테이블스키마 개요
const userSchema = TableSchema(
  name: 'users', // Table name, required
  tableId: 'users', // Unique identifier of the table, optional
  primaryKeyConfig: PrimaryKeyConfig(
    name: 'id', // Primary key field name, defaults to id
    type: PrimaryKeyType.sequential, // Primary key auto-generation strategy
    sequentialConfig: SequentialIdConfig(
      initialValue: 1000, // Initial value for sequential IDs
      increment: 1, // Step size
      useRandomIncrement: false, // Whether to use random step sizes
    ),
  ),
  fields: [
    FieldSchema(
      name: 'username', // Field name, required
      type: DataType.text, // Field data type, required
      nullable: false, // Whether null is allowed
      minLength: 3, // Minimum length
      maxLength: 32, // Maximum length
      unique: true, // Whether it must be unique
      fieldId: 'username', // Stable field identifier, optional, used to detect field renames
      comment: 'Login name', // Optional comment
    ),
    FieldSchema(
      name: 'status',
      type: DataType.integer,
      minValue: 0, // Minimum numeric value
      maxValue: 150, // Maximum numeric value
      defaultValue: 0, // Static default value
      createIndex: true, // Shortcut for creating an index
    ),
    FieldSchema(
      name: 'created_at',
      type: DataType.datetime,
      nullable: false,
      defaultValueType: DefaultValueType.currentTimestamp, // Automatically fill with current time
      createIndex: true,
    ),
  ],
  indexes: const [
    IndexSchema(
      indexName: 'idx_users_status_created_at', // Optional index name
      fields: ['status', 'created_at'], // Composite index fields
      unique: false, // Whether it is a unique index
      type: IndexType.btree, // Index type: btree/vector
    ),
  ],
  foreignKeys: const [], // Optional foreign-key constraints; see "Foreign Keys & Cascading"
  isGlobal: false, // Whether this is a global table; true means it can be shared across spaces
  ttlConfig: null, // Optional table-level TTL; see "Table-level TTL"
  capacityConfig: null, // Optional capacity eviction; see "Capacity Eviction"
);

const appSchemas = [userSchema];
공통
DataType매핑:유형 해당 다트 유형 설명 integerintID, 카운터 및 유사한 데이터에 적합한 표준 정수 bigIntBigInt/String큰 정수; 정밀도 손실을 방지하기 위해 숫자가 18자리를 초과하는 경우 권장됨 doubledouble가격, 좌표 및 유사한 데이터에 적합한 부동 소수점 숫자 textString선택적 길이 제약 조건이 있는 텍스트 문자열 blobUint8List원시 바이너리 데이터 booleanbool부울 값 datetimeDateTime/String날짜/시간 내부적으로 ISO8601로 저장됨 arrayList목록 또는 배열 유형 jsonMap<String, dynamic>동적 구조화된 데이터에 적합한 JSON 객체 vectorVectorData/List<num>의미 최근접 검색용 밀집 벡터(Embedding) sparseSparseVectorData희소 검색용 신경 희소 벡터 PrimaryKeyType자동 생성 전략:전략 설명 특징 none자동 생성 없음 삽입 중에 기본 키를 수동으로 제공해야 합니다 sequential순차적 증가 인간 친화적인 ID에는 적합하지만 분산 성능에는 적합하지 않음 timestampBased타임스탬프 기반 분산 환경에 권장 datePrefixed날짜 접두어 비즈니스에 날짜 가독성이 중요한 경우에 유용합니다 shortCode단축 코드 기본 키 컴팩트하고 외부 디스플레이에 적합
모든 기본 키는 기본적으로
text(String)으로 저장됩니다.
제약 조건 및 자동 유효성 검사
애플리케이션 코드에서 중복된 논리를 피하면서 공통 유효성 검사 규칙을 FieldSchema에 직접 작성할 수 있습니다.
nullable: false: null이 아닌 제약 조건minLength/maxLength: 텍스트 길이 제한minValue/maxValue: 정수 또는 부동 소수점 범위 제약 조건defaultValue/defaultValueType: 정적 기본값 및 동적 기본값unique: 고유 제약 조건createIndex: 고주파 필터링, 정렬 또는 관계를 위한 인덱스 생성fieldId/tableId: 마이그레이션 중 필드 및 테이블에 대한 이름 변경 감지 지원
또한 unique: true은 단일 필드 고유 인덱스를 자동으로 생성합니다. createIndex: true 및 외래 키는 자동으로 단일 필드 일반 인덱스를 생성합니다. 복합 인덱스, 명명된 인덱스, 또는 텍스트 / 희소 / 벡터 검색 인덱스가 필요한 경우 indexes을 사용하세요.
스키마 진화 (Schema Evolution)
엔진은 테이블 구조 변경(테이블/필드 추가·삭제·이름 변경, 속성 조정, 인덱스 변경 등)을 자동으로 감지하고 데이터 마이그레이션을 완료합니다. 수동 버전 관리나 마이그레이션 스크립트가 필요 없습니다. 선언적 schemas는 ToStore.open() 시 진화하고, 런타임에는 updateSchema로도 변경할 수 있습니다——비즈니스에 투명하며 읽기/쓰기는 중단되지 않습니다.
고유 필드를 기본 키로 승격
기존 고유·비 null 필드를 기본 키로 승격할 수 있습니다(이름 변경 가능; 데이터가 있어도 가능; 비즈니스 투명). setPrimaryKeyConfig와 동시에 변경하지 마세요.
- 모바일(선언적
schemas):ToStore.open()시 자동 감지. 대상 기본 키는 반드시PrimaryKeyType.none(값은 원본 고유 필드에서 가져오며, 다른 자동 생성 유형은 지원하지 않음). 이름이 같으면 이름 매칭으로 충분하고, 이름 변경 시fromFieldId에 원본 필드의fieldId를 지정합니다. - 서버(런타임):
updateSchema(...).promoteFieldToPrimaryKey(sourceFieldName: ..., targetPrimaryKeyName: ...)호출.targetPrimaryKeyName은 선택 사항이며, 생략하면 원본 필드명을 유지합니다.
통합 방법 선택
- 모바일/데스크톱:
appSchemas을ToStore.open(...)에 직접 전달할 때 가장 좋습니다. - 서버/에이전트:
createTables(appSchemas)을 통해 런타임에 스키마를 동적으로 생성할 때 가장 적합합니다.
모바일, 데스크탑 및 기타 빈번한 시작 시나리오를 위한 통합
import 'package:path/path.dart' as p;
import 'package:path_provider/path_provider.dart';

// On Android/iOS, resolve the app's writable directory first, then pass dbPath explicitly
final docDir = await getApplicationDocumentsDirectory();
final dbRoot = p.join(docDir.path, 'common');

// Reuse the appSchemas defined above
final db = await ToStore.open(
  dbPath: dbRoot,
  schemas: appSchemas,
);

// Multi-space architecture - isolate data for different users
await db.switchSpace(spaceName: 'user_123');
시작 진행 추적
일반적인 스키마 변경은 비즈니스 로직에 영향을 주지 않으며 시작을 차단하지 않습니다. 모바일 앱을 자주 강제 종료하는 등 드문 예외적인 경우(예: 비정상 종료 후 간단한 데이터 유효성 검사 및 크래시 복구)에만 시작 시간이 눈에 띄게 걸릴 수 있으며, 이때 onStartupProgress를 사용하여 스플래시 화면 또는 진행 표시기를 표시할 수 있습니다:
final db = await ToStore.open(
  dbPath: dbRoot,
  schemas: appSchemas,
  onStartupProgress: (progress, stage) {
    // progress: 0.0 – 1.0  |  stage: opening → recovering → optimizing → ready
    print('시작 진행 ${(progress * 100).toStringAsFixed(0)}% [$stage]');
    // 스플래시 화면 / 진행 표시줄 업데이트
  },
);
// 데이터베이스 완전 준비됨
각 단계:
opening— 구성 로드, 기본 엔진 준비recovering— 보안 검사 및 충돌 복구optimizing— 내부 엔진 튜닝 및 구조 최적화ready— 초기화 완료, 사용 준비됨
로그인 상태 유지 및 로그아웃(활성 공간)
다중 공간은 사용자 데이터 격리에 이상적입니다. 사용자당 하나의 공간, 로그인이 활성화되어 있습니다. Active Space 및 닫기 옵션을 사용하면 앱을 다시 시작해도 현재 사용자를 유지하고 깔끔한 로그아웃 동작을 지원할 수 있습니다.
- 로그인 상태 유지: 사용자를 자신의 공간으로 전환한 후 해당 공간을 활성 상태로 표시합니다. 다음 실행에서는 "기본값을 먼저 사용한 후 전환" 단계 없이 기본 인스턴스를 열 때 해당 공간에 직접 들어갈 수 있습니다.
- 로그아웃: 사용자가 로그아웃하면
keepActiveSpace: false으로 데이터베이스를 닫습니다. 다음 실행 시 이전 사용자의 공간에 자동으로 들어가지 않습니다.
// After login: switch to the user's space and mark it active
await db.switchSpace(spaceName: 'user_$userId', keepActive: true);

// Optional: strictly stay in default when needed (for example, login screen only)
// final db = await ToStore.open(..., applyActiveSpaceOnDefault: false);

// On logout: close and clear the active space so the next launch starts from default
await db.close(keepActiveSpace: false);
서버측/에이전트 통합(장기 실행 시나리오)
🖥️ 예: server_quickstart.dart
final db = await ToStore.open();

// Create table structures while the process is running
await db.createTables(appSchemas);

// Online schema updates
final result = await db.updateSchema('users')
  .renameTable('users_new')                // Rename table
  .modifyField(
    'username',
    minLength: 5,
    maxLength: 20,
    unique: true
  )                                        // Modify field attributes
  .renameField('old_name', 'new_name')     // Rename field
  .removeField('deprecated_field')         // Remove field
  .addField('created_at', type: DataType.datetime)  // Add field
  .removeIndex(fields: ['age'])            // Remove index
  .setPrimaryKeyConfig(                    // Change auto-generated PK strategy; avoid when the table already has data
    const PrimaryKeyConfig(type: PrimaryKeyType.shortCode)
  );
// Promote a unique field to PK (see promote-primary-key section; do not chain with the above):
// await db.updateSchema('users').promoteFieldToPrimaryKey(
//   sourceFieldName: 'user_id',
//   targetPrimaryKeyName: 'uid', // optional; omit to keep the source field name
// );

// Monitor migration progress
final taskId = result.taskId;
if (taskId != null) {
  // Inspect migration metadata
  print('Estimated duration: ${result.estimateDuration?.inMilliseconds} ms');
  print('Migration write mode: ${result.writeMode}'); // e.g. MigrationWriteMode.indexOnly

  final status = await db.queryMigrationTaskStatus(taskId);
  print('Migration progress: ${status?.progressPercentage}%');
}


// Optional performance tuning for pure server workloads
// yieldDurationMs controls how often long-running work yields time slices.
// The default is tuned to 8ms to keep frontend UI animations smooth.
// In environments without UI, 50ms is recommended for higher throughput.
final dbServer = await ToStore.open(
  config: DataStoreConfig(yieldDurationMs: 50),
);
고급 사용법
ToStore는 복잡한 비즈니스 시나리오를 위한 풍부한 고급 기능 세트를 제공합니다.
키-값 고급 작업 (db.kv)
더 복잡한 Key-Value 시나리오의 경우 db.kv 네임스페이스를 사용하는 것이 좋습니다. 공간 격리, 글로벌 공유, 다양한 데이터 타입, 그리고 체이닝 복합 쿼리/필터(예: db.kv.query().prefix(...).orderBy...().limit(...)로 페이지 매김, 정렬, 만료 필터 등)를 지원하는 완전한 API 세트를 제공합니다.
기본 액세스 (Basic Access)
// 값 설정 (String, int, bool, double, Map, List 등 지원)
await db.kv.set('key', 'value', ttl: Duration(hours: 1));

// 원시 동적 타입 값 가져오기
dynamic val = await db.kv.get('key');

// 단일 키 삭제
await db.kv.remove('key');
타입 안정성이 보장된 읽기 (Type-Safe Getters) 수동 타입 변환 없이 목표 형식의 데이터를 직접 가져옵니다:
String? name = await db.kv.getString('user_name');
int? age = await db.kv.getInt('user_age');
bool? isVip = await db.kv.getBool('is_vip');
Map<String, dynamic>? profile = await db.kv.getMap('profile');
List<String>? tags = await db.kv.getList<String>('tags');
일괄 작업 (Bulk Operations) 한 번의 작업으로 여러 키-값 쌍을 효율적으로 처리합니다:
// 일괄 설정
await db.kv.setMany({
  'theme': 'dark',
  'language': 'ko_KR',
});

// 일괄 삭제
await db.kv.removeKeys(['temp_1', 'temp_2']);
원자적 카운터 (Atomic Increment) 고동시성 시나리오에서 숫자 값을 안전하게 증가시키거나 감소시킵니다:
// 1 증가 (기본값)
await db.kv.setIncrement('view_count');
// 5 감소 (음수 전달)
await db.kv.setIncrement('stock_count', amount: -5);
체이닝 레코드 쿼리 (db.kv.query)
db.query()와 유사한 체이닝 API로, 키-값레코드(디코딩된value포함)를 조회하며 페이지 매김을 지원합니다.getKeys(키 이름만)와 달리 전체 레코드를 반환합니다.// 첫 페이지: 접두사 필터, 업데이트 시간 내림차순, 페이지당 20건 final page = await db.kv.query() .prefix('setting_') .orderByUpdatedAtDesc() // 또는 orderByKeyAsc / orderByKeyDesc / orderByUpdatedAtAsc .limit(20); for (final record in page.data) { // record 포함: key, value, updated_at, expires_at print('${record['key']} = ${record['value']}'); } // 권장: next() / prev()로 페이지 이동(테이블 쿼리와 동일, 가장 간편) if (page.hasMore) { final page2 = await page.next(); print('다음 페이지: ${page2.data.length}'); if (page2.hasPrev) { final back = await page2.prev(); print('이전 페이지: ${back.data.length}'); } } // Offset 페이지 매김(cursor와 상호 배타; 깊은 페이지 이동에는 위의 next() 권장) final byOffset = await db.kv.query() .orderByKeyAsc() .limit(20) .offset(20); // 조건에 맞는 레코드 총개수(prefix 없으면 O(1) 메타데이터 집계) final total = await db.kv.query().prefix('setting_').count(); // 첫 번째 일치 레코드 가져오기 final first = await db.kv.query().prefix('setting_').orderByKeyAsc().first(); // 전역 KV 공간 final globalPage = await db.kv.query(isGlobal: true).limit(50); // 기본은 만료된 레코드를 제외; 아직 정리되지 않은 만료 항목을 포함할 때: final withExpired = await db.kv.query() .includeExpired() .limit(20);자주 쓰는 체이닝 메서드:
메서드 설명 prefix(String)key 접두사로 필터 orderByKeyAsc/orderByKeyDesckey(기본 키)로 정렬 orderByUpdatedAtAsc/orderByUpdatedAtDescupdated_at으로 정렬limit(n)페이지당 최대 건수(항상 명시 권장) offset(n)오프셋 페이지 매김(cursor 제거) cursor(token)특수 시나리오 전용: 프로세스/네트워크로 페이지 Token 전달 includeExpired([true])만료되었으나 아직 정리되지 않은 레코드 포함 여부 count()일치 건수 집계 first()첫 번째 레코드 반환(원본 builder의 limit에 영향 없음) 쿼리 결과
QueryResult: 일상적인 페이지 이동은hasMore/hasPrev+next()/prev();nextCursorToken/prevCursorToken은 크로스엔드 전송 등 특수 시나리오용(사용법은 테이블 쿼리와 동일).키 공간 탐색 및 관리 (Discovery & Management)
// 키 이름만 열거(value 미포함); 선택적으로 prefix / limit / offset
final keys = await db.kv.getKeys(prefix: 'setting_');
final pageKeys = await db.kv.getKeys(
  prefix: 'setting_',
  limit: 100,
  offset: 0,
);

// 현재 공간의 총 키-값 쌍 개수 확인
final count = await db.kv.count();

// 키 존재 여부 및 만료 확인
final exists = await db.kv.exists('config_cache');

// 메모리 프로브 (동기, 캐시 히트 시만 — [메모리 프로브 및 동기 검색 (peek)](#query-peek) 참조)
final theme = db.kv.peekGet('theme') ?? await db.kv.get('theme');
if (db.kv.peekExists('config_cache')) { /* ... */ }

// 현재 공간의 모든 KV 데이터 삭제
await db.kv.clear();
생명주기 관리 (TTL) 기존 키의 만료 시간을 확인하거나 업데이트합니다:
// 남은 만료 시간 가져오기
Duration? ttl = await db.kv.getTtl('token');

// 기존 키의 만료 시간 업데이트 (7일 후 만료)
await db.kv.setTtl('token', Duration(days: 7));
반응형 모니터링 (Reactive Watch)
// 단일 키 모니터링
db.kv.watch<int>('unread_count').listen((count) => print(count));

// 여러 키의 변경 스냅샷 모니터링
db.kv.watchValues(['theme', 'font_size']).listen((map) => print(map));
전역 공유 매개변수 (isGlobal) 위의 모든 메서드는 선택적
isGlobal매개변수를 지원합니다.true는 전역 공간(모든 공간에서 공유)에서의 작업을,false(기본값)는 현재 격리된 공간에서의 작업을 나타냅니다.
일괄 작업 (Bulk Operations)
ToStore는 대규모 데이터 처리량에 최적화된 전용 일괄 처리 인터페이스를 제공합니다. 이러한 인터페이스는 병렬 작업 분산 및 타임 슬라이싱 스케줄링 메커니즘을 내장하고 있어, 고성능 쓰기 작업을 수행할 때 UI 메인 스레드에 미치는 영향을 효과적으로 줄여줍니다.
| 인터페이스 | 핵심 용도 | 데이터 요구 사항 | 특징 |
|---|---|---|---|
batchInsert |
다수 레코드 일괄 삽입 | 모든 필수(non-nullable) 필드 포함 | 순수 삽입, 최고 성능 |
batchUpsert |
존재하면 업데이트, 없으면 삽입 | 모든 필수(non-nullable) 필드 포함 | 전체 동기화, 기본 키 또는 고유 필드 기반 자동 판별 |
batchUpdate |
기존 레코드 일괄 부분 업데이트 | 기본 키 또는 고유 필드 + 업데이트 필드 | 증분 업데이트, 기존 레코드 수정에 특화 |
일괄 삽입 (batchInsert)
await db.batchInsert('users', [
  {'username': 'user1', 'email': '[email protected]'},
  {'username': 'user2', 'email': '[email protected]'},
]);
지능형 일괄 동기화 (batchUpsert) 기본 키 또는 고유 필드를 기반으로 '삽입' 또는 '업데이트'를 자동으로 식별합니다. 데이터의 전체 동기화 시나리오에서 주로 사용됩니다.
[!IMPORTANT] 데이터 요구 사항: 삽입 작업이 발생할 수 있으므로,
batchUpsert는 각 레코드에 모든 필수(nullable: false) 필드가 포함되어야 합니다.고효율 일괄 업데이트 (batchUpdate) 기존 레코드를 업데이트하는 데 특화되어 있습니다. 각 레코드는 식별자로서의 기본 키 또는 고유 필드와 수정할 필드를 포함해야 합니다.
[!TIP] 부분 업데이트:
batchUpdate는 제공된 필드만 업데이트하며 모든 필수 필드를 포함할 필요가 없으므로 증분 수정 시나리오에 적합합니다.await db.batchUpdate('users', [ {'username': 'john', 'age': 27}, // 고유 필드 username으로 식별하여 age 업데이트 {'id': '1002', 'status': 'active'}, // 기본 키를 직접 지정할 수도 있음 ]);
[!TIP]
allowPartialErrors: true를 설정하면 개별 데이터 오류(예: 단일 레코드 충돌)가 전체 일괄 작업을 중단시키지 않도록 할 수 있습니다.
데이터 쓰기 복구 보장 (Recovery Durability)
ToStore는 **쓰기 작업이 결과를 반환하는 시점(await 완료 시)**에 갖추는 자가 치유 복구 수준을 유연하게 제어할 수 있습니다:
| 레벨 | 응답 시 복구 보장 | 적용 시나리오 및 특성 |
|---|---|---|
RecoveryDurability.standard(기본 권장) |
응답 전 충돌 자가 치유 보장 | 앱 비정상 종료, 미처리 예외 및 시스템 OOM 강제 종료로부터 보호. 극대화된 처리량과 일상 업무 안전성을 동시에 제공. |
RecoveryDurability.durable |
응답 전 정전 자가 치유 보장 | 물리적 저장소에 강제 동기화 후 반환. 돌발 정전이나 커널 패닉 시에도 완전한 자가 치유 보장. 금융 거래 및 핵심 감사 데이터에 적합. |
RecoveryDurability.async |
초고속 처리량 (응답 후 비동기 저장) | 메모리 큐에 추가 즉시 응답 반환. 응답을 반환한 후 적은 데이터량에서는 일반적으로 몇 밀리초의 극히 짧은 데이터 손실 윈도우만 존재. 대량 로그 수집에 적합. |
1. 전역 기본 설정
데이터베이스 초기화 시 DataStoreConfig에서 인스턴스 전역 기본 복구 수준을 설정:
final db = await ToStore.open(
  config: DataStoreConfig(
    defaultRecoveryDurability: RecoveryDurability.standard, // 기본값: 응답 전 충돌 자가 치유 보장
  ),
);
2. 단일 작업별 유연한 재정의
구조화된 테이블 쓰기, 일괄 작업, 체인형 업데이트/삭제 및 키-값 저장소 (KV) 전체에서 선택적 매개변수 durability를 통한 개별 지정을 지원:
// 1. 구조화된 테이블 작업 재정의
await db.insert('orders', orderData, durability: RecoveryDurability.durable); // 핵심 주문: 정전 방지
await db.batchInsert('logs', logList, durability: RecoveryDurability.async); // 대량 로그: 초고속 비동기

// 2. 체인형 업데이트 및 삭제 재정의
await db.update('users', {'status': 'active'})
  .where('id', '=', userId)
  .durability(RecoveryDurability.durable);

// 3. 키-값 저장소 (KV) 재정의
await db.setValue('token', tokenVal, durability: RecoveryDurability.standard);
await db.kv.set('session_id', 'xyz', durability: RecoveryDurability.async);
await db.kv.setMany(settingsMap, durability: RecoveryDurability.durable);
벡터, 텍스트 및 하이브리드 검색
어휘 텍스트 검색·밀집 벡터 검색·신경 희소 검색은 동일한 쿼리 체인(matchText / matchVector / matchSparse)을 공유합니다. 동일 체인에서 구조화 조건과 조합하거나 다중 경로로 융합할 수 있습니다. 점수와 채널 진단은 QueryResult.retrieval로 반환되며 data 행과 1:1로 대응합니다. 기본키와 점수만 필요할 때는 .select(['id'])(또는 PK 필드명)를 우선해 엔진이 전체 행 하이드레이션을 건너뛰게 하세요. 그렇지 않으면 하이브리드 검색이 완전한 레코드(큰 임베딩 포함)를 로드해 처리량이 크게 떨어질 수 있습니다. 필터·융합이 필요 없는 전용 ANN에는 같은 코어 검색 경로로 db.vectorSearch(...)가 List<VectorSearchResult>(기본키 + 점수)를 반환합니다.
검색 가시성: 삽입/업데이트가 성공을 반환한 직후, 일반 인덱스·텍스트 인덱스·희소 인덱스는 바로 검색에 참여할 수 있습니다. 벡터 인덱스는 처리량에 영향을 주지 않도록 쓰기 경로에 묶여 구축되지 않으며, 즉시 검색되지 않습니다. 검색에 참여시키려면 업무 배치가 끝난 뒤 await db.flush()(선택적 편의 API)를 호출하고, 완료 후에야 matchVector / vectorSearch에 반영됩니다.
await db.createTables([
  const TableSchema(
    name: 'documents',
    primaryKeyConfig: PrimaryKeyConfig(
      name: 'id',
      type: PrimaryKeyType.timestampBased,
    ),
    fields: [
      FieldSchema(name: 'content', type: DataType.text, nullable: false),
      FieldSchema(
        name: 'category',
        type: DataType.text,
        nullable: false,
        createIndex: true,
      ),
      FieldSchema(
        name: 'features',
        type: DataType.sparse, // Neural sparse vector
        nullable: false,
      ),
      FieldSchema(
        name: 'embedding',
        type: DataType.vector, // Dense vector
        nullable: false,
        vectorConfig: VectorFieldConfig(
          dimensions: 128, // Written and queried vectors must match this width
        ),
      ),
    ],
    indexes: [
      IndexSchema(fields: ['content'], type: IndexType.text), // Lexical text index
      IndexSchema(fields: ['features'], type: IndexType.sparse), // Neural sparse index
      IndexSchema(
        fields: ['embedding'],
        type: IndexType.vector, // Dense vector index
        vectorConfig: VectorIndexConfig(
          indexType: VectorIndexType.ngh, // NGH: ToStore built-in dense index
          distanceMetric: VectorDistanceMetric.cosine,
        ),
      ),
    ],
  ),
]);

final queryVector =
    VectorData.fromList(List.generate(128, (i) => i * 0.01));
final querySparse = SparseVectorData.fromMap({12: 0.8, 45: 0.6, 90: 0.3});

// 1) Lexical text retrieval (engine tokenizes TextQuery.text;
//    or use pre-tokenized TextQuery.terms / termsWeighted)
final textHits = await db
    .query('documents')
    .select(['id'])
    .matchText('content', TextQuery.text('distributed kernel storage'))
    .limit(5);

// 2) Neural sparse retrieval
final sparseHits = await db
    .query('documents')
    .select(['id'])
    .matchSparse('features', querySparse, minScore: 0.30)
    .limit(5);

// 3) Dense vector ANN (default searchDepth = 50)
final result = await db
    .query('documents')
    .select(['id'])
    .matchVector('embedding', queryVector, minScore: 0.40)
    .limit(5);

for (var i = 0; i < result.data.length; i++) {
  final record = result.data[i];
  final entry = result.retrieval?.entries[i];
  print('pk=${record['id']}, score=${entry?.score}, '
      'rawScore=${entry?.rawScore}, distance=${entry?.meta?['distance']}');
}

// 4) Structured filter + vector (AND)
final filtered = await db
    .query('documents')
    .whereEqual('category', 'tech')
    .matchVector('embedding', queryVector, minScore: 0.40)
    .limit(5);

// 5) Multi-way fusion: text + sparse + vector (default weightedScore)
final fused = await db
    .query('documents')
    .matchText('content', TextQuery.text('distributed storage'), weight: 0.4)
    .matchSparse('features', querySparse, weight: 0.3, minScore: 0.20)
    .matchVector('embedding', queryVector, weight: 0.6, minScore: 0.40)
    .limit(10);
print('fusion=${fused.retrieval?.fusionMethod}'); // weightedScore

// Opt into rank-only fusion (relative scores — not absolute relevance bands)
final fusedRrf = await db
    .query('documents')
    .matchText('content', TextQuery.text('distributed storage'), weight: 0.4)
    .matchVector('embedding', queryVector, weight: 0.6, minScore: 0.40)
    .fusionMethod(RetrievalFusionMethod.rrf)
    .limit(10);
print('fusion=${fusedRrf.retrieval?.fusionMethod}'); // rrf

// Dedicated ANN (PK + score only; no query chain / fusion)
final ann = await db.vectorSearch(
  'documents',
  fieldName: 'embedding',
  queryVector: queryVector,
  topK: 5,
  minScore: 0.40,
);
채널 / 스키마 대응:
| 채널 | 필드 유형 | 인덱스 | 쿼리 API | 쿼리 값 |
|---|---|---|---|---|
| 어휘 텍스트 | DataType.text |
IndexType.text |
matchText / orMatchText |
TextQuery.text / terms / termsWeighted |
| 신경 희소 | DataType.sparse |
IndexType.sparse |
matchSparse / orMatchSparse |
SparseVectorData |
| 밀집 벡터 | DataType.vector |
IndexType.vector |
matchVector / orMatchVector |
VectorData 등 |
밀집 벡터 설정(VectorFieldConfig, VectorIndexConfig):
dimensions: 실제로 작성하는 임베딩 너비와 일치해야 합니다indexType: 밀집 벡터 알고리즘 식별자. 현재nghdistanceMetric: 인덱스 측 유사도 메트릭(구축·검색 공통).cosine은 의미 임베딩에 일반적,l2는 유클리드 거리,innerProduct는 내적 검색에 적합합니다. 데이터 기록 후 변경 시 벡터 인덱스 재구축이 필요합니다.
체인 검색 매개변수(각 match* / orMatch*, 및 쿼리 체인의 limit):
- 텍스트
TextQuery.text: 엔진이 토큰화TextQuery.terms/termsWeighted: 사전 토큰화됨. 재토큰화 없음. 라틴 토큰은 인덱스 측과 일치해야 함(보통 소문자)operator:or(기본, 용어 합집합 랭킹) 또는and(양의 가중치 용어가 모두 적중해야 랭킹)- 구문 일치는 미지원
- 희소
SparseVectorData/SparseVectorData.fromMap(...): 희소 쿼리 벡터- 문서 측 가중치는
(0, 1]에 두는 것이 바람직
- 벡터
field/vector: 대상 필드와 쿼리 벡터searchDepth:>= 1, 기본값50. 클수록 보통 리콜과 지연이 증가. 근사 최근접 이웃이며 recall@K를 보장하지 않습니다distanceThreshold: 거리 상한
- 공통
weight: 다중 경로 융합 가중치. 기본값1.0minScore: 관련도 하한limit: 반환 건수(topK).fusionMethod(...): 다중 경로 기본값weightedScore.rrf로 전환 가능
결과 및 점수 설명(QueryResult / VectorSearchResult):
- 비즈니스 레코드는
data, 검색 점수와 채널 정보는retrieval.entries에 있으며data와 1:1 대응. 기본키와 점수만 필요하면.select(['id'])를 우선하세요. score(정규화 관련도,0.0 ~ 1.0): 텍스트 / 희소 / 벡터에서 통일(높을수록 관련). 벡터 완전 자기 일치는1.0.minScore로 강한 히트를 유지하고 약한 히트를 제거. 기본 다중 경로weightedScore융합은 강한 단일 경로 히트를 유지. 텍스트와 희소는[0.0, 1.0)에 머무름.rawScore: 비정규화 물리량(코사인 / 내적 / L2 / 텍스트 강도). 하위 메트릭이 필요하면rawScore/distance.entry.meta['distance']: 벡터 채널의 ANN 거리(작을수록 가까움).retrieval.fusionMethod: 단일 채널은null; 다중 경로는 기본weightedScore(.fusionMethod(RetrievalFusionMethod.rrf)로 전환 가능).- 최상위
db.vectorSearch(...)는 전용 ANN용List<VectorSearchResult>(primaryKey/score/rawScore/distance)를 반환. 선택적minScore는matchVector와 동일한 관련도 하한(건수는topK보다 적을 수 있음).
관련도(score) 및 임계값 참조 기준(단일 채널 및 다중 경로 weightedScore; rrf 제외). 일반 embedding(차원 ≥ 128)용; 저차원에서는 약한 이웃도 높은 점수가 날 수 있으므로 필요 시 minScore를 높이거나 rawScore를 사용하세요:
관련도 (score) |
의미 및 대표 시나리오 |
|---|---|
>= 0.85 |
동일 엔티티(얼굴 검증, 생체, 정확 중복 제거) |
>= 0.70 |
고신뢰 시맨틱(핵심 사실, 정밀 Q&A) |
>= 0.40 |
기본 시맨틱 관련(일반 RAG, 환각 억제) |
>= 0.30 |
넓은 초기 리콜(퍼지 탐색, 재순위 후보 풀) |
< 0.30 |
약한 연관 또는 배경 잡음 |
필요에 따라 채널 minScore로 저관련 히트를 필터링하세요.
테이블 수준 TTL(자동 시간 기반 만료)
시간이 지남에 따라 만료되어야 하는 로그, 원격 분석, 이벤트 및 기타 데이터의 경우 ttlConfig을 통해 테이블 수준 TTL을 정의할 수 있습니다. 엔진은 백그라운드에서 만료된 레코드를 자동으로 정리합니다.
const TableSchema(
  name: 'event_logs',
  fields: [
    FieldSchema(
      name: 'created_at',
      type: DataType.datetime,
      nullable: false,
      createIndex: true,
      defaultValueType: DefaultValueType.currentTimestamp,
    ),
  ],
  ttlConfig: TableTtlConfig(
    ttlMs: 7 * 24 * 60 * 60 * 1000, // 7일 보관
    // 새 테이블 / 처음 TTL을 켤 때 필수:
    // 1) DataType.datetime  2) nullable: false
    // 3) DefaultValueType.currentTimestamp
    sourceField: 'created_at',
  ),
);
용량 제거(FIFO / LRU)
건수 및/또는 대략적인 크기로 테이블 보관량을 제한합니다. TTL과 독립적이며 함께 사용할 수 있습니다. 한도를 넘는 행은 백그라운드에서 자동으로 제거됩니다.
// FIFO(기본): 기본 키 기준으로 오래된 것부터 제거.
// sourceField를 설정하지 마세요(PrimaryKeyType.none 제외).
capacityConfig: CapacityConfig(
  maxEntries: 10000,
  // maxBytes: 50 * 1024 * 1024, // 선택적 크기 제한
  policy: CapacityEvictionPolicy.fifo,
),

// LRU: sourceField 필수(datetime, non-null, currentTimestamp).
// 최근 사용으로 칠 때 해당 필드를 갱신하세요.
capacityConfig: CapacityConfig(
  maxEntries: 10000,
  policy: CapacityEvictionPolicy.lru,
  sourceField: 'last_active_at',
),
maxEntries/maxBytes중 하나 이상 설정.- FIFO +
PrimaryKeyType.none도sourceField필요(동일한 datetime 규칙).
기존 테이블에서도 런타임에 용량 제거를 켜거나 바꾸거나 끌 수 있습니다(재오픈 불필요):
// 활성화 / 변경
await db.updateSchema('recent_events').setCapacityConfig(
  CapacityConfig(
    maxEntries: 10000,
    policy: CapacityEvictionPolicy.lru,
    sourceField: 'last_active_at',
  ),
);

// 비활성화(기존 행 유지; 용량 기반 삭제 중단)
await db.updateSchema('recent_events').disableCapacity();
KV 용량은 DB를 열 때 DataStoreConfig로 설정합니다(kv.set마다 전달하지 않음):
kvCapacityConfig: 현재 스페이스 키 한도globalKvCapacityConfig: 전역 KV 한도- 테이블
CapacityConfig와 같은 형태이지만sourceField는 설정하지 않음
final db = await ToStore.open(
  dbPath: '...',
  config: DataStoreConfig(
    kvCapacityConfig: CapacityConfig(
      maxEntries: 5000,
      policy: CapacityEvictionPolicy.lru,
    ),
    globalKvCapacityConfig: CapacityConfig(
      maxEntries: 2000,
      policy: CapacityEvictionPolicy.fifo,
    ),
  ),
);
지능형 스토리지(Upsert)
ToStore에서는 data에 포함된 기본 키 또는 고유 필드를 기준으로 업데이트할지 삽입할지 결정합니다. where은 여기서 지원되지 않습니다. 충돌 대상은 데이터 자체에 의해 결정됩니다.
// By primary key
final result = await db.upsert('users', {
  'id': 1,
  'username': 'john',
  'email': '[email protected]',
});

// 고유 키 기준(레코드는 고유 제약 조건에 참여하는 모든 필드와 필수 필드를 포함해야 합니다)
await db.upsert('users', {
  'username': 'john',
  'email': '[email protected]',
  'age': 26,
});

// Batch upsert (supports atomic mode or partial-success mode)
// allowPartialErrors: true means some records may fail while others still succeed
final batchResult = await db.batchUpsert('users', [
  {'username': 'a', 'email': '[email protected]'},
  {'username': 'b', 'email': '[email protected]'},
], allowPartialErrors: true);
고급 쿼리
ToStore는 유연한 필드 처리 및 복잡한 다중 테이블 관계를 갖춘 선언적 연결 가능 쿼리 API를 제공합니다.
1. 필드 선택(select)
select 메서드는 반환되는 필드를 지정합니다. 호출하지 않으면 기본적으로 모든 필드가 반환됩니다.
- 별칭: 결과 집합의 키 이름을 바꾸기 위해
field as alias구문(대소문자 구분 안 함) 지원 - 테이블 한정 필드: 다중 테이블 조인에서
table.field은 이름 충돌을 방지합니다. - 집계 혼합:
Agg개체를select목록 내부에 직접 배치할 수 있습니다.
final results = await db.query('orders')
    .select([
      'orders.id',
      'users.name as customer_name',
      'orders.amount',
      Agg.count('id', alias: 'total_items')
    ])
    .join('users', 'orders.user_id', '=', 'users.id')
    .where('orders.amount', '>', 1000)
    .limit(20);
2. 가입(join)
표준 join(내부 조인), leftJoin 및 rightJoin을 지원합니다.
3. 스마트 외래 키 기반 조인(권장)
foreignKeys이 TableSchema에 올바르게 정의되어 있으면 조인 조건을 직접 작성할 필요가 없습니다. 엔진은 참조 관계를 분석하고 최적의 JOIN 경로를 자동으로 생성할 수 있습니다.
joinReferencedTable(tableName): 현재 테이블이 참조하는 상위 테이블을 자동으로 조인합니다.joinReferencingTable(tableName): 현재 테이블을 참조하는 하위 테이블을 자동으로 조인합니다.
// Assume posts defines a foreign key to users
final posts = await db.query('posts')
    .joinReferencedTable('users') // Automatically resolves to ON posts.user_id = users.id
    .select(['posts.title', 'users.username'])
    .limit(20);
집계, 그룹화 및 통계(Agg 및 GroupBy)
1. 집계(Agg 공장)
집계 함수는 데이터 세트에 대한 통계를 계산합니다. alias 매개변수를 사용하면 결과 필드 이름을 사용자 정의할 수 있습니다.
| 방법 | 목적 | 예 |
|---|---|---|
Agg.count(field) |
Null이 아닌 레코드 수 계산 | Agg.count('id', alias: 'total') |
Agg.sum(field) |
합계 값 | Agg.sum('amount', alias: 'total_price') |
Agg.avg(field) |
평균값 | Agg.avg('score', alias: 'average_score') |
Agg.max(field) |
최대값 | Agg.max('age') |
Agg.min(field) |
최소값 | Agg.min('price') |
[!TIP] 두 가지 일반적인 집계 스타일
- 단축 방법(단일 측정항목에 권장): 체인에서 직접 호출하고 계산된 값을 즉시 다시 가져옵니다.
num? totalAge = await db.query('users').sum('age');select에 포함됨(여러 측정항목 또는 그룹화용):Agg개체를select목록에 전달합니다.final stats = await db.query('orders').select(['status', Agg.sum('amount')]).groupBy(['status']);
2. 그룹화 및 필터링(groupBy / having)
SQL의 HAVING 동작과 유사하게 groupBy을 사용하여 레코드를 분류한 다음 having을 사용하여 집계된 결과를 필터링합니다.
final stats = await db.query('orders')
    .select([
      'status',
      Agg.sum('amount', alias: 'sum_amount'),
      Agg.count('id', alias: 'order_count')
    ])
    .groupBy(['status'])
    // having accepts a QueryCondition used to filter aggregated results
    .having(QueryCondition().where(Agg.sum('amount'), '>', 5000))
    .limit(10);
3. 도우미 쿼리 방법
exists()(고성능): 일치하는 레코드가 있는지 확인합니다.count() > 0과 달리 하나의 일치 항목이 발견되자마자 단락되므로 매우 큰 데이터 세트에 적합합니다.count(): 일치하는 레코드 수를 효율적으로 반환합니다.first():limit(1)과 동일하고 첫 번째 행을Map으로 직접 반환하는 편의 메서드입니다.distinct([fields]): 결과를 중복 제거합니다.fields이 제공되면 해당 필드를 기반으로 고유성이 계산됩니다.
// Efficient existence check
if (await db.query('users').whereEqual('email', '[email protected]').exists()) {
  print('Email is already registered');
}

// Get a deduplicated city list
final cities = await db.query('users').distinct(['city']);
4. QueryCondition을 사용한 복잡한 논리
QueryCondition은 중첩 논리 및 괄호로 묶인 쿼리 구성을 위한 ToStore의 핵심 도구입니다. 단순한 연결 where 호출로는 (A AND B) OR (C AND D)과 같은 표현이 충분하지 않을 때 사용할 수 있는 도구입니다.
condition(QueryCondition sub):AND중첩된 그룹을 엽니다.orCondition(QueryCondition sub):OR중첩된 그룹을 엽니다.or(): 다음 커넥터를OR으로 변경합니다(기본값은AND).
예 1: 혼합 OR 조건
동등한 SQL: WHERE is_active = true AND (role = 'admin' OR fans >= 1000)
final subGroup = QueryCondition()
    .whereEqual('role', 'admin')
    .or()
    .whereGreaterThanOrEqualTo('fans', 1000);

final results = await db.query('users')
    .whereEqual('is_active', true)
    .condition(subGroup);
예시 2: 재사용 가능한 조건 조각
재사용 가능한 비즈니스 논리 조각을 한 번 정의하고 이를 다른 쿼리로 결합할 수 있습니다.
final hotUser = QueryCondition().whereGreaterThan('fans', 5000);
final recentLogin = QueryCondition().whereGreaterThan('last_login', '2024-01-01');

final targetUsers = await db.query('users')
    .condition(hotUser)
    .condition(recentLogin);
5. 스트리밍 쿼리
모든 것을 한 번에 메모리에 로드하고 싶지 않은 매우 큰 데이터 세트에 적합합니다. 결과를 읽으면서 처리할 수 있습니다.
db.streamQuery('users').listen((data) {
  print('Processing one record: $data');
});
6. 반응형 쿼리
watch() 메서드를 사용하면 쿼리 결과를 실시간으로 모니터링할 수 있습니다. Stream을 반환하고 대상 테이블에서 일치하는 데이터가 변경될 때마다 자동으로 쿼리를 다시 실행합니다.
- 자동 디바운스: 내장된 지능형 디바운싱으로 중복된 쿼리 급증을 방지합니다.
- UI 동기화: 실시간 업데이트 목록을 위해 Flutter
StreamBuilder와 자연스럽게 작동합니다.
// Simple listener
db.query('users').whereEqual('is_online', true).watch().listen((users) {
  print('Online user count changed: ${users.length}');
});

// Flutter StreamBuilder integration example
// Local UI refreshes automatically when data changes
StreamBuilder<List<Map<String, dynamic>>>(
  stream: db.query('messages').orderByDesc('id').limit(50).watch(),
  builder: (context, snapshot) {
    if (snapshot.hasData) {
      return ListView.builder(
        itemCount: snapshot.data!.length,
        itemBuilder: (context, index) => MessageTile(snapshot.data![index]),
      );
    }
    return CircularProgressIndicator();
  },
)
수동 쿼리 결과 캐싱(선택 사항)
[!IMPORTANT] ToStore에는 이미 내부적으로 효율적인 다단계 지능형 LRU 캐시가 포함되어 있습니다. 일상적인 수동 캐시 관리는 권장되지 않습니다. 특별한 경우에만 고려하십시오.
- 거의 변경되지 않는 인덱싱되지 않은 데이터에 대한 비용이 많이 드는 전체 검색
- 핫 쿼리가 아닌 경우에도 지속적인 초저 지연 요구 사항
useQueryCache([Duration? expiry]): 캐시를 활성화하고 선택적으로 만료를 설정합니다.noQueryCache(): 이 쿼리에 대한 캐시를 명시적으로 비활성화합니다.clearQueryCache(): 이 쿼리 패턴에 대한 캐시를 수동으로 무효화합니다.
final results = await db.query('heavy_table')
    .where('non_indexed_field', '=', 'value')
    .useQueryCache(const Duration(minutes: 10)); // Manual acceleration for a heavy query only
쿼리 및 효율적인 페이지 매김
[!TIP] 페이지 크기로 limit을 명시적으로 지정하기: 쿼리할 때 항상
limit을 명시적으로 지정할 것을 강력히 권장합니다. 생략하면 엔진은 한 번에 너무 많은 데이터를 조회하는 것을 방지하기 위해 기본적으로 1000개 레코드로 제한합니다.
ToStore는 듀얼 모드 페이지 매김을 지원합니다. 목록 스크롤이나 무한 로딩의 경우, 내장된 원활한 커서 페이지 매김을 강력히 권장합니다. 특정 페이지로 직접 이동할 때는 일반 오프셋 페이지 매김을 사용하면 됩니다.
1. 기본 페이지 매김 (오프셋 모드)
데이터 양이 적거나(예: 1만 건 이하) 특정 페이지로 정확하게 이동해야 하는 시나리오에 적합합니다.
final result = await db.query('users')
    .orderByDesc('created_at')
    .offset(40) // 처음 40개 행 건너뛰기
    .limit(20); // 20개 행 가져오기
[!TIP]
offset이 매우 커지면 데이터베이스가 많은 레코드를 스캔하고 버려야 하므로 성능이 선형적으로 저하됩니다. 깊은 페이지 매김이나 대용량 데이터 세트의 경우 커서 모드를 사용하는 것이 좋습니다.
2. 커서 페이지 매김 (커서 모드 - 권장)
대용량 데이터 세트 및 무한 스크롤에 이상적입니다. 현재 페이지 데이터 스트림의 시작 위치를 기록하여 페이지 이동 시 해당 위치로 직접 찾아가 읽으므로(seek), 이전 데이터를 스캔하고 버리는 비용을 방지하여 깊은 페이지 매김에서도 항상 일정한 속도를 유지합니다.
- 자동 관리: 페이지당 표시할 레코드 수
limit을 설정한 후,next()또는prev()만 호출하면 간단하고 빠르게 최적의 페이지 매김 성능을 얻을 수 있습니다. - 시작 위치 오프셋: 첫 번째 쿼리 시
.offset(N)을 지정하여 시작 윈도우를 탐색한 후, 이후 직접next()를 호출하여 다음 페이지 데이터를 가져오는 방식을 지원합니다.
// 1. 초기 쿼리 시작
final page1 = await db.query('users')
    .orderByDesc('id')
    .limit(20);

// 2. 다음 페이지 가져오기
if (page1.hasMore) {
  final page2 = await page1.next();
  print('다음 페이지 데이터 수: ${page2.data.length}');

  // 3. 이전 페이지 가져오기
  if (page2.hasPrev) {
    final prevPage = await page2.prev();
    print('이전 페이지 데이터: ${prevPage.data}');
  }
}
고급 시나리오: 무상태 토큰 페이지 매김 (Token-based Cursor)
일상적인 앱 내 페이지 이동에는 위의 next() / prev()를 우선 사용하십시오. 커서 토큰은 클라이언트-서버 API 또는 프로세스/네트워크 간에 페이지 매김 상태를 직렬화해야 할 때만 사용합니다:
- 첫 번째 쿼리는
nextCursorToken/prevCursorToken문자열을 반환합니다. - 다음 쿼리에서
.cursor(token)으로 토큰을 전달하여 seek합니다. - 주의:
cursor와offset은 상호 배타적입니다. 하나를 설정하면 다른 쪽이 지워집니다.
// 초기 쿼리 (예: API 서버 측)
final page1 = await db.query('users')
    .orderByDesc('id')
    .limit(20);

final String? nextToken = page1.nextCursorToken; // 이 토큰을 직렬화하여 클라이언트에 반환

// 클라이언트가 토큰을 포함하여 다음 페이지를 요청할 때:
if (nextToken != null) {
  final page2 = await db.query('users')
      .orderByDesc('id')
      .limit(20)
      .cursor(nextToken); // 토큰을 전달하여 정확한 위치에서 읽기
}
| 특징 | 오프셋 모드 | 커서 모드 |
|---|---|---|
| 쿼리 성능 | 페이지가 깊어질수록 저하됨 | 깊은 페이지 매김에서도 항상 일정함 |
| 가장 적합한 용도 | 적은 데이터 세트, 정확한 페이지 이동 | 대량 데이터 세트, 무한 스크롤 |
| 데이터 변경 시 일관성 | 데이터 변경으로 인한 행 건너뛰기/중복 발생 가능 | 데이터 변경으로 인한 중복 및 누락 방지 |
메모리 프로브 및 동기 검색 (peek)
처리량과 지연 시간에 극단적인 요구가 있는 시나리오를 위해 ToStore는 peek 순수 동기 메모리 검색 시리즈를 제공합니다. 프로세스 내에서 버스트형 핫 리드 트래픽을 직접 처리할 수 있습니다: 엣지 측은 백만 건/초급 읽기를, 서버 측은 더 강력한 하드웨어에서 단일 머신 천만 건/초급에 도달할 수 있습니다(자세한 내용은 벤치마크 참조).
[!NOTE] 메모리 캐시 전용:
peek는 제로 스케줄링 순수 메모리 바이패스입니다. 캐시 미스 시 즉시 빈 값/null을 반환하며, 엔진은 동기 파일 I/O를 수행하지 않습니다(고동시성 시 이벤트 루프 블로킹 방지). 완전한 영속 결과가 필요하면 애플리케이션에서await query()를 사용하세요.
peek API 메서드
| 메서드 | 반환 유형 | 설명 |
|---|---|---|
peekFirst() |
Map<String, dynamic>? |
단일 레코드; 캐시 미스 시 null |
peek() |
QueryResult<T> |
data 목록 및 페이지네이션 메타데이터(hasMore, 커서 등)가 포함된 QueryResult; 캐시 히트 시에만 데이터 있음 |
peekExists() |
bool |
메모리 캐시에 일치 레코드가 있는지 동기 확인 |
peekCount() |
int |
메모리 캐시의 일치 레코드 수를 동기 집계 |
result.peekNext() |
QueryResult<T> |
페이지네이션 결과가 캐시된 경우 동기 다음 페이지 |
result.peekPrev() |
QueryResult<T> |
페이지네이션 결과가 캐시된 경우 동기 이전 페이지 |
모범 사례: 메모리 프로브 우선 (Peek-Through)
// 단일 레코드: 메모리 프로브 먼저, 미스 시 표준 비동기 쿼리
final q = db.query('users').where('id', '=', userId);
final user = q.peekFirst() ?? await q.first();

// 페이지네이션 프로브
final listQ = db.query('users').orderByDesc('id').limit(20);
var page = listQ.peek();
if (page.data.isEmpty) page = await listQ;

if (page.hasMore) {
  final next = page.peekNext(); // 캐시 히트: 동기 페이지 전환
  if (next.data.isEmpty) await page.next();
}
KV 프로브 (db.kv)
| 메서드 | 비동기 대응 | 설명 |
|---|---|---|
peekGet(key) |
get(key) |
동기 메모리 점검색; 만료 키는 null |
peekExists(key) |
exists(key) |
동기 메모리 존재 확인 |
db.kv.query().peek() |
await db.kv.query() |
페이지네이션 동기 프로브 (접두사 / 정렬 / limit) |
db.kv.query().peekFirst() |
await db.kv.query().first() |
첫 레코드 동기 프로브 |
// 점검색: 프로브 우선, 미스 시 비동기 폴백
final theme = db.kv.peekGet('theme', isGlobal: true) ?? await db.kv.get('theme', isGlobal: true);

// 페이지네이션 KV 프로브
var page = db.kv.query().prefix('setting_').limit(20).peek();
if (page.data.isEmpty) page = await db.kv.query().prefix('setting_').limit(20);
[!TIP] 권장: 표준 비동기 쿼리(
await query())는 이벤트 스케줄링으로 장기 안정성과 멀티태스크 공정성을 보장하며, 10만+ QPS면 대부분의 업무에 충분합니다.peek시리즈는 단일 머신에서 백만/천만 건/초급 극한 핫 리드 피크 셰이빙을 위해 설계되었습니다.
외래 키 및 계단식 배열
외래 키는 참조 무결성을 보장하고 계단식 업데이트 및 삭제를 구성할 수 있도록 해줍니다. 쓰기 및 업데이트 시 관계의 유효성이 검사됩니다. 캐스케이드 정책이 활성화되면 관련 데이터가 자동으로 업데이트되어 애플리케이션 코드의 일관성 작업이 줄어듭니다.
await db.createTables([
  const TableSchema(
    name: 'users',
    primaryKeyConfig: PrimaryKeyConfig(name: 'id'),
    fields: [
      FieldSchema(name: 'username', type: DataType.text, nullable: false),
    ],
  ),
  TableSchema(
    name: 'posts',
    primaryKeyConfig: const PrimaryKeyConfig(name: 'id'),
    fields: [
      const FieldSchema(name: 'title', type: DataType.text, nullable: false),
      const FieldSchema(name: 'user_id', type: DataType.integer, nullable: false),
      const FieldSchema(name: 'content', type: DataType.text),
    ],
    foreignKeys: [
        ForeignKeySchema(
          name: 'fk_posts_user',
          fields: ['user_id'],              // Field in the current table
          referencedTable: 'users',         // Referenced table
          referencedFields: ['id'],         // Referenced field
          onDelete: ForeignKeyCascadeAction.cascade,  // Delete posts automatically when the user is deleted
          onUpdate: ForeignKeyCascadeAction.cascade,  // Cascade updates
        ),
    ],
  ),
]);
쿼리 연산자
모든 where(field, operator, value) 조건은 다음 연산자를 지원합니다(대소문자 구분 안 함).
| 연산자 | 설명 | 예제 / 성능 |
|---|---|---|
= |
같음 | where('status', '=', 'val') — [권장] 인덱스 Seek |
!=, <> |
같지 않음 | where('role', '!=', 'val') — [주의] 전체 테이블 스캔 |
> , >=, <, <= |
범위 비교 | where('age', '>', 18) — [권장] 인덱스 Scan |
IN |
포함 | where('id', 'IN', [...]) — [권장] 인덱스 Seek |
NOT IN |
포함되지 않음 | where('status', 'NOT IN', [...]) — [주의] 전체 테이블 스캔 |
BETWEEN |
범위 | where('age', 'BETWEEN', [18, 65]) — [권장] 인덱스 Scan |
LIKE |
패턴 일치 (% = 모든 문자, _ = 단일 문자) |
where('name', 'LIKE', 'John%') — [주의] 아래 참고 사항 참조 |
NOT LIKE |
패턴 불일치 | where('email', 'NOT LIKE', '...') — [주의] 전체 테이블 스캔 |
IS |
null임 | where('deleted_at', 'IS', null) — [권장] 인덱스 Seek |
IS NOT |
null이 아님 | where('email', 'IS NOT', null) — [주의] 전체 테이블 스캔 |
의미론적 쿼리 방법(권장)
손으로 쓴 연산자 문자열을 피하고 더 나은 IDE 지원을 받으려면 권장됩니다.
1. 비교
직접적인 숫자 또는 문자열 비교에 사용됩니다.
db.query('users').whereEqual('username', 'John');           // Equal
db.query('users').whereNotEqual('role', 'guest');          // Not equal
db.query('users').whereGreaterThan('age', 18);             // Greater than
db.query('users').whereGreaterThanOrEqualTo('score', 60);  // Greater than or equal
db.query('users').whereLessThan('price', 100);             // Less than
db.query('users').whereLessThanOrEqualTo('quantity', 10);  // Less than or equal
db.query('users').whereTrue('is_active');                  // Is true
db.query('users').whereFalse('is_banned');                 // Is false
2. 수집 및 범위
필드가 세트 또는 범위 내에 속하는지 여부를 테스트하는 데 사용됩니다.
db.query('users').whereIn('id', ['id1', 'id2']);                 // In list
db.query('users').whereNotIn('status', ['banned', 'pending']);   // Not in list
db.query('users').whereBetween('age', 18, 65);                   // In range (inclusive)
3. Null 확인
필드에 값이 있는지 테스트하는 데 사용됩니다.
db.query('users').whereNull('deleted_at');    // Is null
db.query('users').whereNotNull('email');      // Is not null
db.query('users').whereEmpty('nickname');     // Is null or empty string
db.query('users').whereNotEmpty('bio');       // Is not null and not empty
4. 패턴 매칭
SQL 스타일 와일드카드 검색을 지원합니다(%은 임의 개수의 문자와 일치하고, _은 단일 문자와 일치합니다).
db.query('users').whereLike('name', 'John%');                        // SQL-style pattern match
db.query('users').whereContains('bio', 'flutter');                   // Contains match (LIKE '%value%')
db.query('users').whereStartsWith('name', 'Admin');                  // Prefix match (LIKE 'value%')
db.query('users').whereEndsWith('email', '.com');                    // Suffix match (LIKE '%value')
db.query('users').whereContainsAny('tags', ['dart', 'flutter']);     // Fuzzy match against any item in the list
// Equivalent to: .where('age', '>', 18).where('name', 'like', '%John%')
final users = await db.query('users')
    .whereGreaterThan('age', 18)
    .whereLike('username', '%John%')
    .orderByDesc('age')
    .limit(20);
[!CAUTION] 쿼리 성능 가이드 (인덱스 vs 전체 스캔)
대규모 데이터 세트(수백만 행 이상) 시나리오에서는 메인 스레드 지연 및 쿼리 타임아웃을 방지하기 위해 다음 원칙을 준수하십시오.
인덱스 최적화 - [권장]:
- 의미론적 메서드:
whereEqual,whereGreaterThan,whereLessThan,whereIn,whereBetween,whereNull,whereTrue,whereFalse및whereStartsWith(접두사 일치).- 연산자:
=,>,<,>=,<=,IN,BETWEEN,IS null,LIKE 'prefix%'.- 설명: 이러한 작업은 인덱스를 통해 매우 빠른 위치 지정을 달성합니다.
whereStartsWith/LIKE 'abc%'의 경우에도 인덱스는 접두사 범위 스캔을 수행할 수 있습니다.전체 스캔 위험 - [주의]:
- 모호한 일치:
whereContains(LIKE '%val%'),whereEndsWith(LIKE '%val'),whereContainsAny.- 부정 쿼리:
whereNotEqual(!=,<>),whereNotIn(NOT IN),whereNotNull(IS NOT null/whereNotEmpty).- 패턴 불일치:
NOT LIKE.- 설명: 위 작업은 인덱스가 구성되어 있더라도 일반적으로 전체 데이터 저장 영역을 탐색해야 합니다. 모바일이나 작은 데이터 세트에서는 영향이 미미하지만, 분산형 또는 초대형 데이터 분석 시나리오에서는 다른 인덱스 조건(예: ID 또는 시간 범위별 데이터 필터링) 및
limit절과 결합하여 신중하게 사용해야 합니다.
분산 아키텍처
// Configure distributed nodes
final db = await ToStore.open(
  config: DataStoreConfig(
    distributedNodeConfig: const DistributedNodeConfig(
      enableDistributed: true,            // Enable distributed mode
      clusterId: 1,                       // Cluster ID
      centralServerUrl: 'https://127.0.0.1:8080',
      accessToken: 'b7628a4f9b4d269b98649129'
    )
  )
);

// Batch insert
await db.batchInsert('vector_data', [
  {'vector_name': 'face_2365', 'timestamp': DateTime.now()},
  {'vector_name': 'face_2366', 'timestamp': DateTime.now()},
  // ... efficient one-shot insertion of vector records
]);

// Stream and process large datasets
await for (final record in db.streamQuery('vector_data')
  .where('vector_name', '=', 'face_2366')
  .where('timestamp', '>=', DateTime.now().subtract(Duration(days: 30)))
  .stream) {
  // Process each result incrementally to avoid loading everything at once
  print(record);
}
기본 키 예
ToStore는 다양한 비즈니스 시나리오에 대해 여러 분산 기본 키 알고리즘을 제공합니다.
- 순차 기본 키(
PrimaryKeyType.sequential):238978991 - 타임스탬프 기반 기본 키(
PrimaryKeyType.timestampBased):1306866018836946 - 날짜가 앞에 붙는 기본 키(
PrimaryKeyType.datePrefixed):20250530182215887631 - 단축 코드 기본 키(
PrimaryKeyType.shortCode):9eXrF0qeXZ
// Sequential primary key configuration example
await db.createTables([
  const TableSchema(
    name: 'users',
    primaryKeyConfig: PrimaryKeyConfig(
      type: PrimaryKeyType.sequential,
      sequentialConfig: SequentialIdConfig(
        initialValue: 10000,      // Starting value
        increment: 50,            // Step size
        useRandomIncrement: true, // Random step size to hide business volume
      ),
    ),
    fields: [/* field definitions */]
  ),
]);
원자 표현
표현식 시스템은 유형이 안전한 원자 필드 업데이트를 제공합니다. 모든 계산은 데이터베이스 계층에서 원자적으로 실행되어 동시 충돌을 방지합니다.
// Simple increment: balance = balance + 100
await db.update('accounts', {
  'balance': Expr.field('balance') + Expr.value(100),
}).where('id', '=', accountId);

// Complex calculation: total = price * quantity + tax
await db.update('orders', {
  'total': Expr.field('price') * Expr.field('quantity') + Expr.field('tax'),
}).where('id', '=', orderId);

// Multi-layer parentheses: finalPrice = ((price * quantity) + tax) * (1 - discount)
await db.update('orders', {
  'finalPrice': ((Expr.field('price') * Expr.field('quantity')) + Expr.field('tax')) *
                 (Expr.value(1) - Expr.field('discount')),
}).where('id', '=', orderId);

// Use functions: price = min(price, maxPrice)
await db.update('products', {
  'price': Expr.min(Expr.field('price'), Expr.field('maxPrice')),
}).where('id', '=', productId);

// Timestamp: updatedAt = now()
await db.update('users', {
  'updatedAt': Expr.now(),
}).where('id', '=', userId);
조건식(예: upsert에서 업데이트와 삽입 구별): Expr.isUpdate() / Expr.isInsert()을 Expr.ifElse 또는 Expr.when과 함께 사용하면 식이 업데이트 시에만 평가되거나 삽입 시에만 평가됩니다.
// Upsert: increment on update, set to 1 on insert
// The insert branch can use a plain literal; expressions are only evaluated on the update path
await db.upsert('counters', {
  'key': 'visits',
  'count': Expr.ifElse(
    Expr.isUpdate(),
    Expr.field('count') + Expr.value(1),
    1,
  ),
});

// Use Expr.when (single branch, otherwise null)
await db.upsert('orders', {
  'id': orderId,
  'updatedAt': Expr.when(Expr.isUpdate(), Expr.now(), otherwise: Expr.now()),
});
거래
트랜잭션은 여러 작업에서 원자성을 보장합니다. 즉, 모든 것이 성공하거나 모든 것이 롤백되어 데이터 일관성이 유지됩니다.
거래 특성
- 여러 작업이 모두 성공하거나 모두 롤백됩니다.
- 미완성 작업은 충돌 후 자동으로 복구됩니다.
- 성공적인 운영은 안전하게 지속됩니다.
// Basic transaction - atomically commit multiple operations
final txResult = await db.transaction(() async {
  // Insert a user
  await db.insert('users', {
    'username': 'john',
    'email': '[email protected]',
    'fans': 100,
  });

  // Atomic update using an expression
  await db.update('users', {
    'fans': Expr.field('fans') + Expr.value(50),
  }).where('username', '=', 'john');

  // If any operation fails, all changes are rolled back automatically
});

if (!txResult.hasErrors) {
  print('트랜잭션이 성공적으로 커밋되었습니다');
} else {
  print('다음과 같은 이유로 트랜잭션이 롤백되었습니다:');
  for (final status in txResult.statuses) {
    if (status.type != ResultType.success) {
      print(' - [$status.codeKey}] $status.message}');
    }
  }
}

// Automatic rollback on error
final txResult2 = await db.transaction(() async {
  await db.insert('users', {
    'username': 'jane',
    'email': '[email protected]',
  });
  throw Exception('Business logic error'); // Trigger rollback
}, rollbackOnError: true);
관리 및 유지 관리
다음 API는 플러그인 스타일 개발, 관리 패널 및 운영 시나리오를 위한 데이터베이스 관리, 진단 및 유지 관리를 다룹니다.
- 테이블 관리
createTable(schema): 단일 테이블을 수동으로 생성합니다. 모듈 로딩 또는 주문형 런타임 테이블 생성에 유용합니다.getTableSchema(tableName): 정의된 스키마 정보를 검색합니다. 자동화된 유효성 검사 또는 UI 모델 생성에 유용합니다.getTableNames({isGlobal}): 전역 schema 목록의 사용자 테이블 이름을 조회합니다. 선택isGlobal:true전역만,false비전역만, 생략 시 모두. 비전역 스키마는 공간 간에 공유되며 데이터만 격리됩니다.getTableInfo(tableName): 런타임 통계(totalRecordCount,totalTableDataSizeBytes,totalIndexDataSizeBytes,indexCount, 생성 시간, 전역 여부)를 조회합니다.clear(tableName): 스키마, 인덱스, 내부/외부 키 제약 조건을 안전하게 유지하면서 모든 테이블 데이터를 지웁니다.dropTable(tableName): 테이블과 해당 스키마를 완전히 삭제합니다. 되돌릴 수 없음
- 공간 관리
currentSpaceName: 현재 활성 공간을 실시간으로 가져옵니다.listSpaces(): 현재 데이터베이스 인스턴스에 할당된 모든 공간을 나열합니다.getSpaceInfo(useCache: true): 공간 로컬 집계(totalRecordCount, 테이블/인덱스 데이터 크기).useCache: false로 메타에서 재계산.deleteSpace(spaceName):default및 현재 활성 공간을 제외한 특정 공간 및 해당 공간의 모든 데이터를 삭제합니다.
- 인스턴스 검색
config: 인스턴스에 대한 최종 유효DataStoreConfig스냅샷을 검사합니다.instancePath: 물리적 저장소 디렉터리를 정확하게 찾습니다.getVersion()/setVersion(version): 애플리케이션 수준 마이그레이션 결정을 위한 비즈니스 정의 버전 제어(엔진 버전 아님)
- 유지관리
flush(mode: FlushMode.full): 보류 중인 쓰기를 스토리지에 강제로 반영합니다. 모드:recovery(가장 빠름. 복구 로그만 OS 버퍼에 기록. 앱 크래시 재시작은 복구 가능, 정전 시 데이터 손실 가능),recoveryDurable(복구 로그를 안정 스토리지에 기록. 정전 내성 목표),full(기본값. 복구 로그 + 테이블 데이터 + 인덱스를 안정 스토리지에 기록).deleteDatabase(): 현재 인스턴스에 대한 모든 실제 파일과 메타데이터를 제거합니다. 조심해서 사용하세요
- 진단
db.status.memory(): 캐시 적중률, 인덱스 페이지 사용량 및 전체 힙 할당을 검사합니다.db.status.space()/db.status.table(tableName): 공간 및 테이블에 대한 실시간 통계 및 건강 정보 확인db.status.config(): 현재 런타임 구성 스냅샷을 검사합니다.db.status.migration(taskId): 비동기 마이그레이션 진행 상황을 실시간으로 추적합니다.
final spaces = await db.listSpaces();
final tableNames = await db.getTableNames();
final spaceInfo = await db.getSpaceInfo(useCache: false);
final tableSchema = await db.getTableSchema('users');
final tableInfo = await db.getTableInfo('users');

print('spaces: $spaces');
print('tables: $tableNames');
print(spaceInfo.toJson());
print(tableSchema?.toJson());
print(tableInfo?.toJson());

await db.flush();

final memoryInfo = await db.status.memory();
final configInfo = await db.status.config();
print(memoryInfo.toJson());
print(configInfo.toJson());
백업 및 복원
단일 사용자 로컬 가져오기/내보내기, 대규모 오프라인 데이터 마이그레이션 및 오류 후 시스템 롤백에 특히 유용합니다.
- 백업(
backup)compress: 압축 활성화 여부; 권장되며 기본적으로 활성화되어 있습니다.scope: 백업 범위를 제어합니다.BackupScope.database: 모든 공간과 전역 테이블을 포함하여 전체 데이터베이스 인스턴스를 백업합니다.BackupScope.currentSpace: 전역 테이블을 제외하고 현재 활성 공간만 백업합니다.BackupScope.currentSpaceWithGlobal: 단일 테넌트 또는 단일 사용자 마이그레이션에 이상적인 현재 공간과 관련 전역 테이블을 백업합니다.
- 복원(
restore)backupPath: 백업 패키지의 물리적 경로cleanupBeforeRestore: 복원하기 전에 관련 현재 데이터를 자동으로 삭제할지 여부. 혼합된 논리 상태를 방지하려면true을 사용하는 것이 좋습니다.deleteAfterRestore: 복원 성공 후 백업 소스 파일을 자동으로 삭제합니다.
// Example: export the full data package for the current user
final backupPath = await db.backup(
  compress: true,
  scope: BackupScope.currentSpaceWithGlobal,
);

// Example: restore from a backup package and clean up the source file automatically
final restored = await db.restore(
  backupPath,
  cleanupBeforeRestore: true,
  deleteAfterRestore: true,
);
상태 코드 및 오류 처리
ToStore에는 오류 및 예외 피드백을 위한 두 가지 채널이 있습니다.
[!NOTE] 통합 진단 기반: 응답 결과 모델(DbResult/QueryResult의
statuses)을 통해 반환되든, 치명적인 예외(DbException의statuses)를 통해 발생하든, 모든 진단 상태는 구조화된ResultStatus시스템을 기반으로 하며 동일한 상태 코드를 공유하므로 일관성이 보장됩니다.
- 응답 결과 모델 (Result-based Response)
삽입, 업데이트, 삭제, 쿼리, 트랜잭션 및 런타임 스키마 생성/수정과 같은 일상적인 작업에 사용됩니다. 이러한 작업은 제약 조건 위반, 유효성 검사 실패 또는 잘못된 인수를 발견하더라도 예외를 발생시키지 않습니다. 대신 ToStore는
DbResult또는QueryResult를 사용하여 결과를 래핑하고 모든 진단 정보를 상태 목록에 기록합니다. 이는 일반적인 비즈니스 논리 오류가 데이터베이스를 중단시키지 않도록 보장합니다.
hasErrors: 현재 작업에 오류가 있는지 여부를 나타냅니다. 배치 작업이나 트랜잭션에서 하나 이상의 오류가 있으면 이 속성은true입니다.statuses: 작업에 대한 모든ResultStatus진단 목록입니다. 배치 작업에 매우 유용한 1:1 순서 매칭을 지원합니다.firstPrimaryKey: 단일 삽입/쓰기 작업 성공 시statuses를 수동으로 분석하지 않고 생성된 물리적 기본 키를 직접 읽습니다.ResultType: 상태 범주를 나타내는 열거형으로, 분기 처리 및 검사(예:isBusinessError,isDeveloperError)에 편리합니다.
- 예외 발생 (Exception-based Throwing)
개발자의 실수나 설계 결함으로 인한 치명적인 오류(예:
ToStore.open시 스키마 유효성 검사 실패, 엔진 버전 불일치, 치명적인 데이터 마이그레이션 손상 등)에 사용됩니다. 이 경우 ToStore는 실행을 중단하기 위해DbException을 발생시켜 개발자가 수정하도록 합니다.
[!WARNING] 개발 가이드라인: 일반적인 비즈니스 오류는 예외를 발생시켜서는 안 되며, 애플리케이션 런타임이 중단되지 않도록 응답 결과 모델로 반환해야 합니다.
오류 및 예외 처리 예시
1. 단일 쓰기 응답 처리
final result = await db.insert('users', {
  'username': 'john',
  'email': '[email protected]',
});

if (result.hasErrors) {
  // 첫 번째 오류 유형 및 설명 가져오기
  print('Operation failed: [\${result.firstType.codeKey}] \${result.message}');
} else {
  print('쓰기 성공, 기본 키는: \${result.firstPrimaryKey}');
}
2. 배치 쓰기 정밀 진단
final batchResult = await db.batchInsert('users', [
  {'username': 'alice', 'email': '[email protected]'},
  {'username': 'bob', 'email': 'invalid-email-format'}, // Validation fails
]);

if (batchResult.hasErrors) {
  print('배치 작업이 부분적으로 실패했습니다: 성공 \${batchResult.successCount}, 실패 \${batchResult.failedCount}');

  for (final status in batchResult.statuses) {
    final int idx = status.index;

    if (status is ConstraintStatus) {
      print('Index [\$idx] 제약 조건 위반! 테이블! 테이블: \${status.tableName}, 필드: \${status.fields}');
    } else if (status is InvalidArgumentStatus) {
      print('Index [\$idx] 인수 오류! 매개변수! Parameter: \${status.parameterName}, 전달된 값: \${status.passedValue}');
    } else if (status.type != ResultType.success) {
      print('Index [\$idx] 오류가 발생했습니다: [\${status.codeKey}] \${status.message}');
    }
  }
}
3. 치명적 오류 및 초기화 예외 캡처 (DbException)
try {
  // Initialize database with schemas that might have validation issues
  final db = await ToStore.open(schemas: appSchemas);
} on DbException catch (e) {
  print('❌ 치명적인 데이터베이스 예외! 오류 메시지: \n\${e.message}');

  // Iterate through the detailed status list in the exception
  for (final status in e.statuses) {
    if (status is SchemaValidationStatus) {
      print('조정된 스키마 검증 실패! 테이블! 테이블: \${status.tableName}, 필드: \${status.field}, 잘못된 구성: \${status.wrongValue}');
    } else {
      print('진단 정보: [\${status.codeKey}] \${status.message}');
    }
  }
}
오류 유형, 상세 상태 코드, JSON 직렬화 형식 및 필드 매핑의 전체 목록은 전체 사양서를 참조하십시오: ToStore ResultStatus 자동 진단 및 상태 해제 사양서.
로그 콜백 및 데이터베이스 진단
ToStore는 ToStore.setLogConfig(...)를 통해 데이터베이스 수명 주기 로그를 비즈니스 계층으로 다시 라우팅할 수 있습니다.
onLog콜백은 현재enableLog및logLevel필터를 통과하는 모든LogRecord로그 레코드를 수신합니다.- LogLevel.error: 로컬 오류가 발생했으나 정상 실행에는 영향을 미치지 않습니다.
- LogLevel.critical: 전역적 재난 수준의 오류(디스크 꽉 참, 메모리 부족, 마이그레이션 중대 실패 등)로 수동 개입이 필요합니다. 이 등급에서는 경보 알림을 트리거하는 것을 권장합니다.
- 초기화 전에
ToStore.setLogConfig(...)를 호출하면 초기화 및 자동 마이그레이션 중에 생성된 로그도 캡처됩니다.
  // 로그 매개변수 또는 콜백 구성
  ToStore.setLogConfig(
    enableLog: true,
    logLevel: debugMode ? LogLevel.debug : LogLevel.warn,
    logLabel: 'my_app_db', // 로그 상단의 연한 회색 제목, 앱 또는 데이터베이스 인스턴스 구분용,
    onLog: (log) {
      // 운영 환경에서는 warn/error/critical을 백엔드 또는 로그 플랫폼에 보고할 수 있습니다
      // log.level은 로그 레벨에 대응합니다 (LogLevel.debug, info, warn, error, critical)
      // log.message는 처리된 로그 텍스트에 대응합니다
      // log.status는 기본 ResultStatus 진단 상태에 대응합니다 (code 및 codeKey 포함)
      if (!debugMode && (log.level == LogLevel.warn || log.level == LogLevel.error || log.level == LogLevel.critical)) {
        developer.log(log.message, name: 'my_app_db', time: log.timestamp);
      }
    },
  );

  final db = await ToStore.open();
보안 구성
[!WARNING] 키 관리
키 역할 변경 방법 데이터 전체 재작성 encodingKey데이터 암호화 키 새 값 설정 후 다시 open예 (시간 소요) encryptionKey보안 키, encodingKey보호런타임에 db.rotateEncryptionKey호출아니오 (빠름) 민감한 키를 하드코딩하지 마세요. 기기에 바인딩하려면
encryptionKey를 OS Keychain / Keystore / 보안 엔클레이브에 보관한 뒤 엔진에 전달하세요.
final db = await ToStore.open(
  config: DataStoreConfig(
    encryptionConfig: EncryptionConfig(
      // Supported: none, xorObfuscation, chacha20Poly1305, aes256Gcm
      encryptionType: EncryptionType.chacha20Poly1305,

      // Data encryption key: encrypts table/index/log data; changing it triggers a background rewrite
      encodingKey: 'Your-Encoding-Key...',

      // Security key: protects encodingKey; rotate online via db.rotateEncryptionKey
      encryptionKey: 'Your-Secure-Encryption-Key...',

      // standard: critical table data, B-tree indexes, and log payloads
      // full: encrypts the entire engine files
      encryptionScope: EncryptionScope.standard,
    ),
    // Enable crash recovery logging (Write-Ahead Logging), enabled by default
    enableJournal: true,
    // Whether transactions force data to disk on commit; set false to reduce sync overhead
    persistRecoveryOnCommit: true,
  ),
);
encodingKey 변경: EncryptionConfig에 새 값을 설정하고 다시 open합니다. 엔진이 변경을 감지하여 백그라운드에서 자동으로 데이터를 마이그레이션하며, 애플리케이션 측 조치는 필요 없습니다.
encryptionKey 로테이션(보안/컴플라이언스 정기 교체): 데이터 재작성 없음, 온라인 실행 가능.
// If encryptionKey was never set explicitly, oldKey can be omitted
final result = await db.rotateEncryptionKey(newKey: 'new-secure-key');
// Or: await db.rotateEncryptionKey(oldKey: 'old-key', newKey: 'new-key');
if (result.hasErrors) {
  // 실패 처리 (oldKey 오류, encodingKey 마이그레이션 진행 중 등)
  return;
}
// 성공: 메모리 설정 업데이트됨; 다음 ToStore.open 시 최신 encryptionKey 전달
값 수준 암호화(ToCrypto)
전체 데이터베이스 암호화는 모든 테이블 및 인덱스 데이터를 보호하지만 전반적인 성능에 영향을 미칠 수 있습니다. 몇 가지 중요한 값만 보호해야 하는 경우 대신 ToCrypto를 사용하세요. 데이터베이스에서 분리되고 db 인스턴스가 필요하지 않으며 쓰기 전이나 읽기 후에 애플리케이션에서 값을 인코딩/디코딩할 수 있습니다. 출력은 JSON 또는 TEXT 열에 자연스럽게 맞는 Base64입니다.
key(필수):String또는Uint8List. 32바이트가 아닌 경우 SHA-256을 사용하여 32바이트 키를 파생합니다.type(선택 사항):ToCryptoType의 암호화 유형(예:ToCryptoType.chacha20Poly1305또는ToCryptoType.aes256Gcm). 기본값은ToCryptoType.chacha20Poly1305입니다.aad(선택 사항):Uint8List유형의 추가 인증 데이터입니다. 인코딩 중에 제공되는 경우 디코딩 중에도 정확히 동일한 바이트를 제공해야 합니다.
const key = 'my-secret-key';
// Encode: plaintext -> Base64 ciphertext (can be stored in DB or JSON)
final cipher = ToCrypto.encode('sensitive data', key: key);
// Decode when reading
final plain = ToCrypto.decode(cipher, key: key);

// Optional: bind contextual data with aad (must match during decode)
final aad = Uint8List.fromList(utf8.encode('users:id_number'));
final cipher2 = ToCrypto.encode('secret', key: key, aad: aad);
final plain2 = ToCrypto.decode(cipher2, key: key, aad: aad);
고급 구성 설명(DataStoreConfig)
[!TIP] 제로 구성 인텔리전스 ToStore는 플랫폼, 성능 특성, 사용 가능한 메모리, I/O 동작을 자동으로 감지하여 동시성, 샤드 크기, 캐시 예산과 같은 매개변수를 최적화합니다. 일반적인 비즈니스 시나리오의 99%에서는
DataStoreConfig을 수동으로 미세 조정할 필요가 없습니다. 기본값은 이미 현재 플랫폼에 탁월한 성능을 제공합니다.
| 매개변수 | 기본값 | 목적 및 권고사항 |
|---|---|---|
yieldDurationMs |
8ms | 핵심 권장 사항. 장기 작업이 산출될 때 사용되는 시간 조각입니다. 8ms은 120fps/60fps 렌더링에 적합하며 대규모 쿼리 또는 마이그레이션 중에 UI를 원활하게 유지하는 데 도움이 됩니다. |
maxQueryOffset |
10000 | 쿼리 보호. offset이 이 임계값을 초과하면 오류가 발생합니다. 이는 깊은 오프셋 페이지 매김으로 인한 병리적 I/O를 방지합니다. |
defaultQueryLimit |
1000 | 리소스 가드레일. 쿼리가 limit을 지정하지 않을 때 적용되어 실수로 대규모 결과 세트가 로드되고 잠재적인 OOM 문제가 발생하는 것을 방지합니다. |
cacheMemoryBudgetMB |
(자동) | 세밀한 메모리 관리. 총 캐시 메모리 예산. 엔진은 이를 사용하여 LRU 회수를 자동으로 실행합니다. |
enableJournal |
사실 | 충돌 자가 치유. 활성화되면 충돌이나 정전 후 엔진이 자동으로 복구될 수 있습니다. |
defaultRecoveryDurability |
standard |
응답 시 복구 보장. 쓰기 작업이 결과를 반환하기 전에 갖추는 자가 치유 복구 수준을 정의합니다: • standard (기본값): 응답 전 충돌 자가 치유 보장. 앱 비정상 종료, 예외, OOM 종료로부터 보호.• durable: 응답 전 정전 자가 치유 보장. 물리 디스크 동기화 후 반환하여 돌발 정전에도 복구 가능.• async: 초고속 처리량. 즉시 응답 후 백그라운드 저장. 응답 후 소량 데이터 기준 수 밀리초의 극히 짧은 손실 윈도우만 존재. |
persistRecoveryOnCommit |
사실 | 강력한 내구성 보장. true인 경우 커밋된 트랜잭션이 물리적 스토리지에 동기화됩니다. false인 경우 더 나은 속도를 위해 플러시가 백그라운드에서 비동기적으로 수행되며 극단적인 충돌 시 소량의 데이터가 손실될 위험이 적습니다. |
ttlCleanupIntervalMs |
300000 | 글로벌 TTL 폴링. 엔진이 유휴 상태가 아닐 때 만료된 데이터를 검색하는 백그라운드 간격입니다. 값이 낮을수록 만료된 데이터가 더 빨리 삭제되지만 오버헤드가 더 많이 발생합니다. |
kvCapacityConfig |
null | 스페이스 KV 용량. 스페이스 키의 FIFO/LRU 한도; sourceField를 설정하지 마세요. 용량 제거 참고. |
globalKvCapacityConfig |
null | 전역 KV 용량. kvCapacityConfig와 동일한 형태. |
maxConcurrency |
(자동) | 컴퓨팅 동시성 제어. 벡터 계산 및 암호화/암호 해독과 같은 집약적인 작업을 위한 최대 병렬 작업자 수를 설정합니다. 일반적으로 자동으로 유지하는 것이 가장 좋습니다. |
final db = await ToStore.open(
  config: DataStoreConfig(
    yieldDurationMs: 8, // Excellent for frontend UI smoothness; for servers, 50ms is often better
    defaultQueryLimit: 50, // Force a maximum result-set size
    enableJournal: true, // Ensure crash self-healing
    defaultRecoveryDurability: RecoveryDurability.standard, // 응답 전 충돌 방지 자가 치유 보장
  ),
);
성능 및 경험
벤치마크
하이라이트 — 100K 스위트와 10억 규모 엣지 실측(3라운드, standard durability, 2026-10-08):
| Metric | Result |
|---|---|
| Cold start | ~35 ms (stable vs data scale) |
| PK Read (Hot Cache) | 4.5M ops/s |
| Batch Insert | 588K ops/s |
| Pagination (Hot Cache) | 579K ops/s |
| ANN @ depth 1 (~91%) | 36K ops/s |
전체 차트와 모든 항목: Benchmarks.
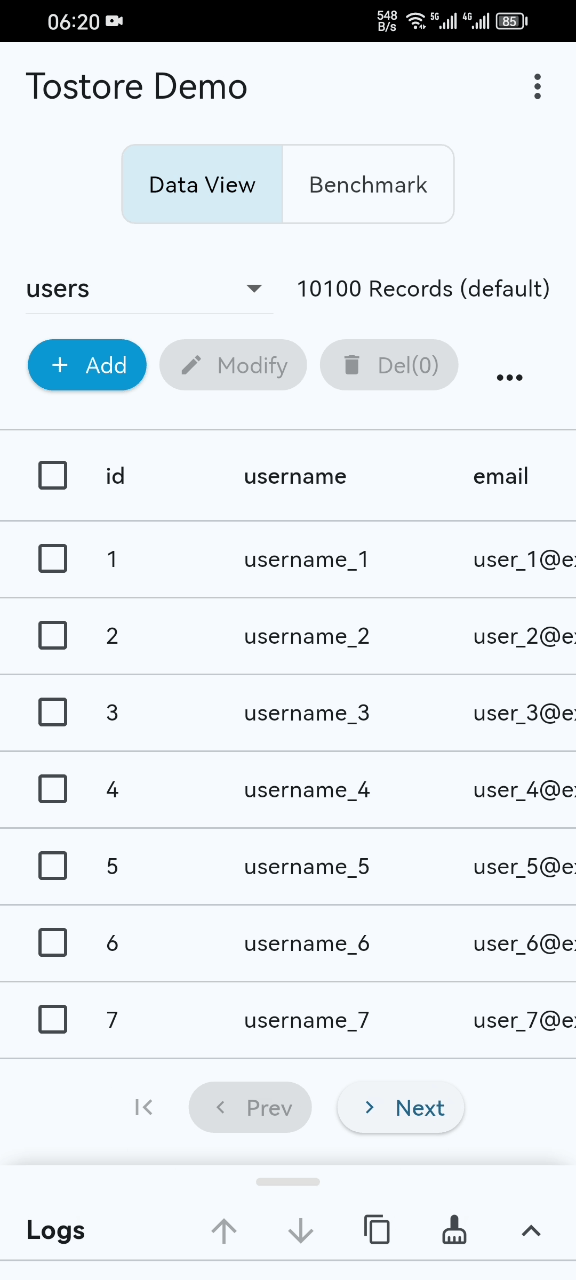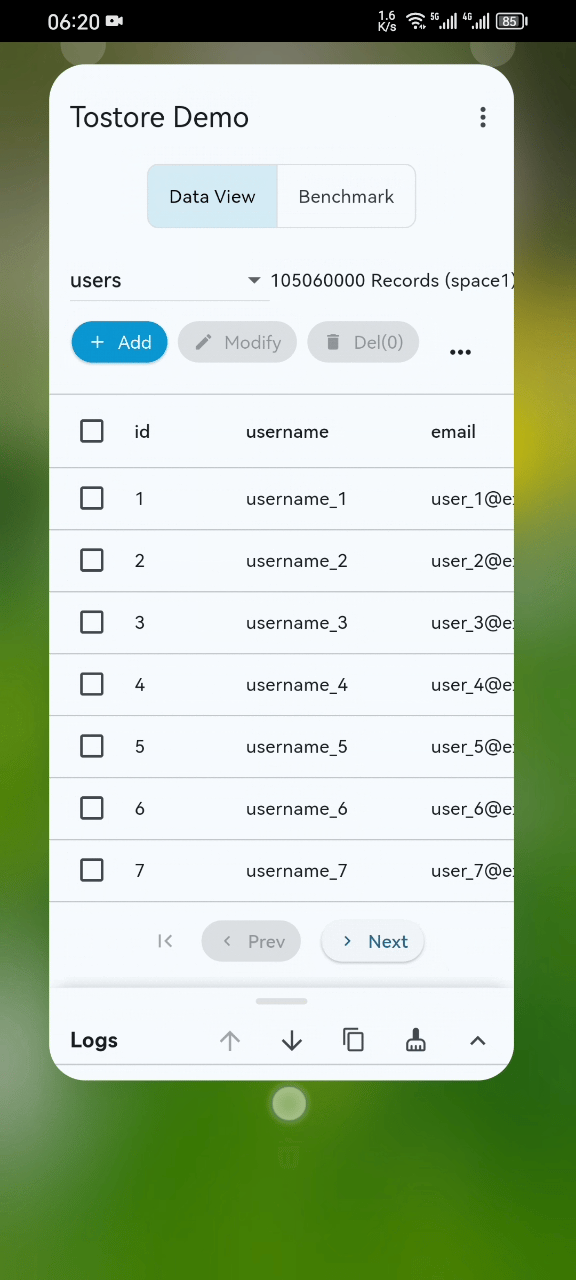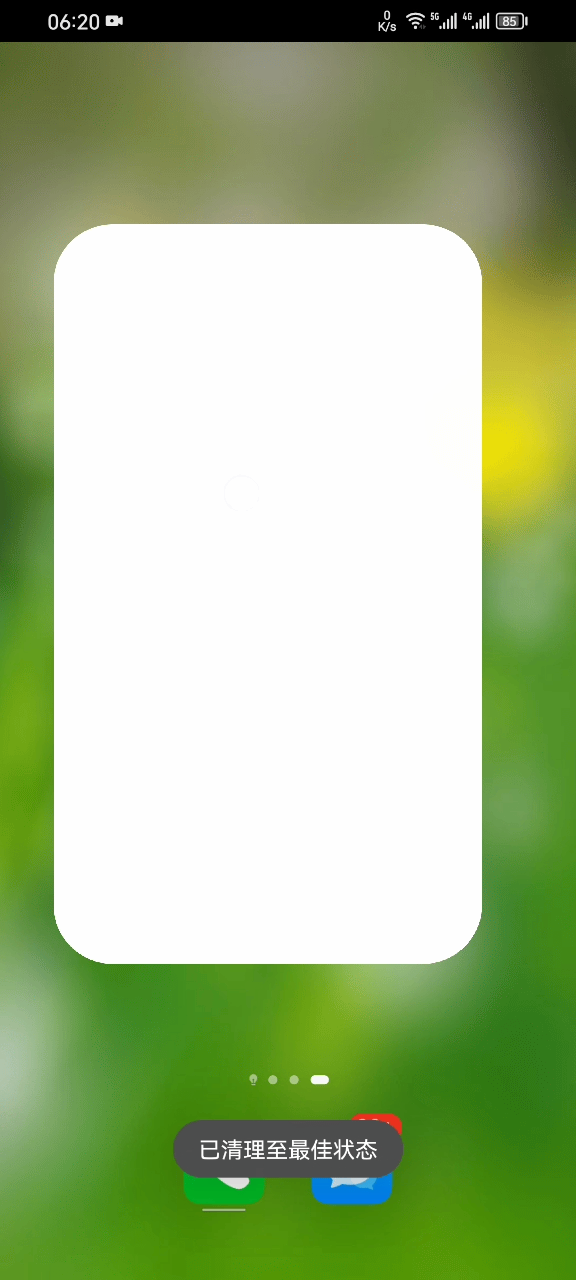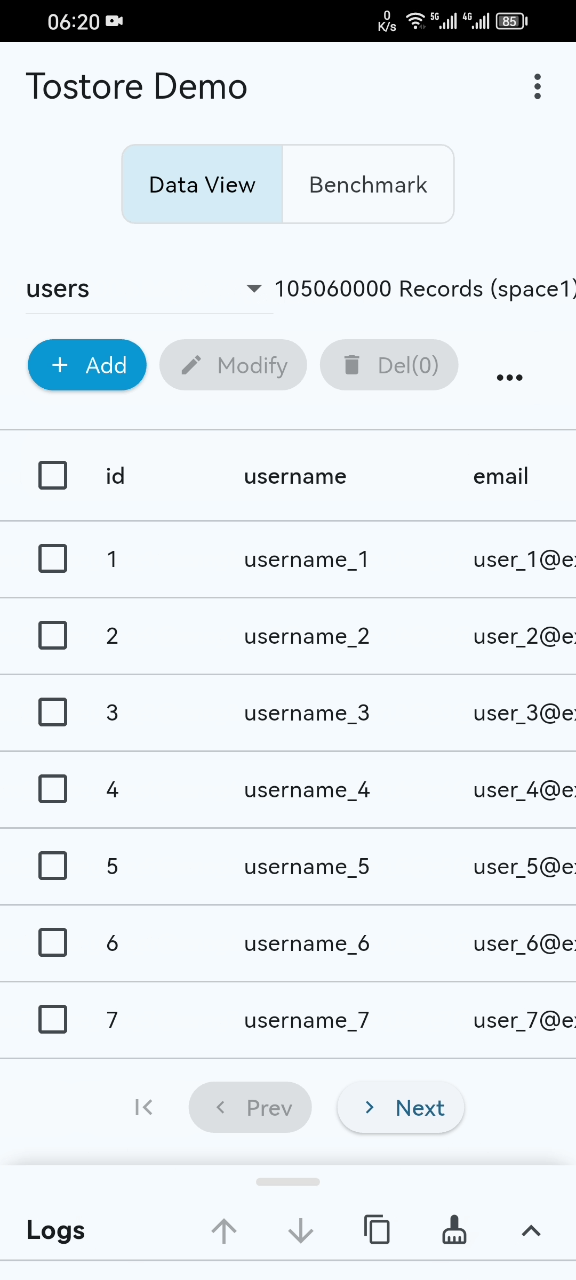
- 기본 성능 데모(basic-demo.mp4): GIF 미리보기에 모든 내용이 표시되지 않을 수 있습니다. 전체 데모를 보려면 비디오를여십시오. 일반 모바일 기기에서도 데이터 세트가 1억 레코드를 초과하더라도 시작, 페이징, 검색이 안정적이고 원활하게 유지됩니다.
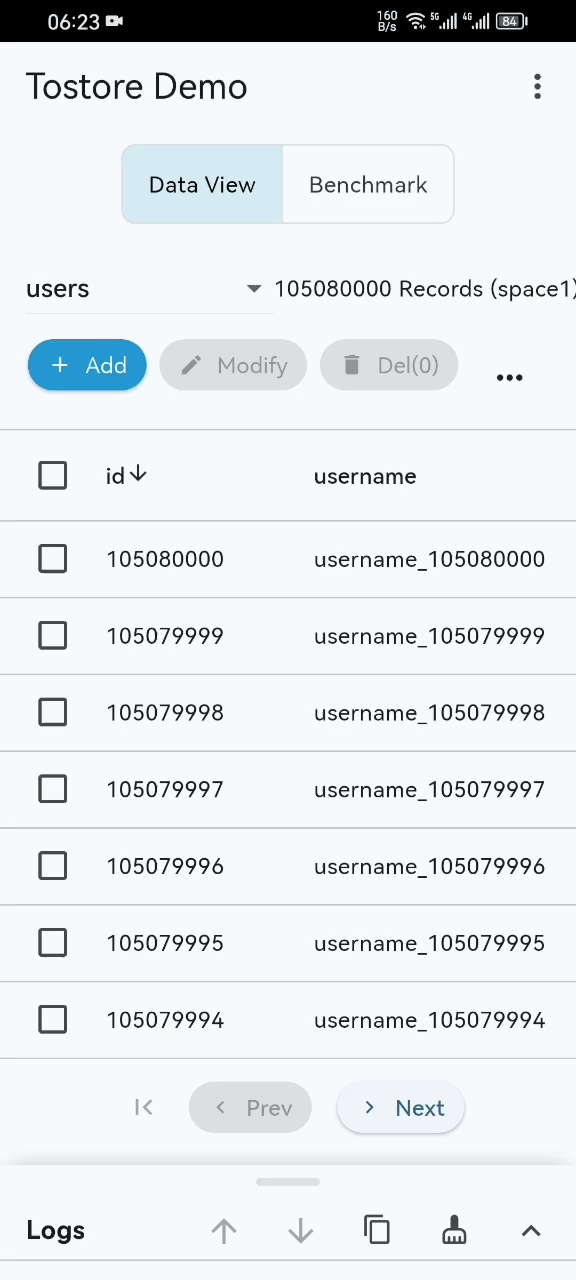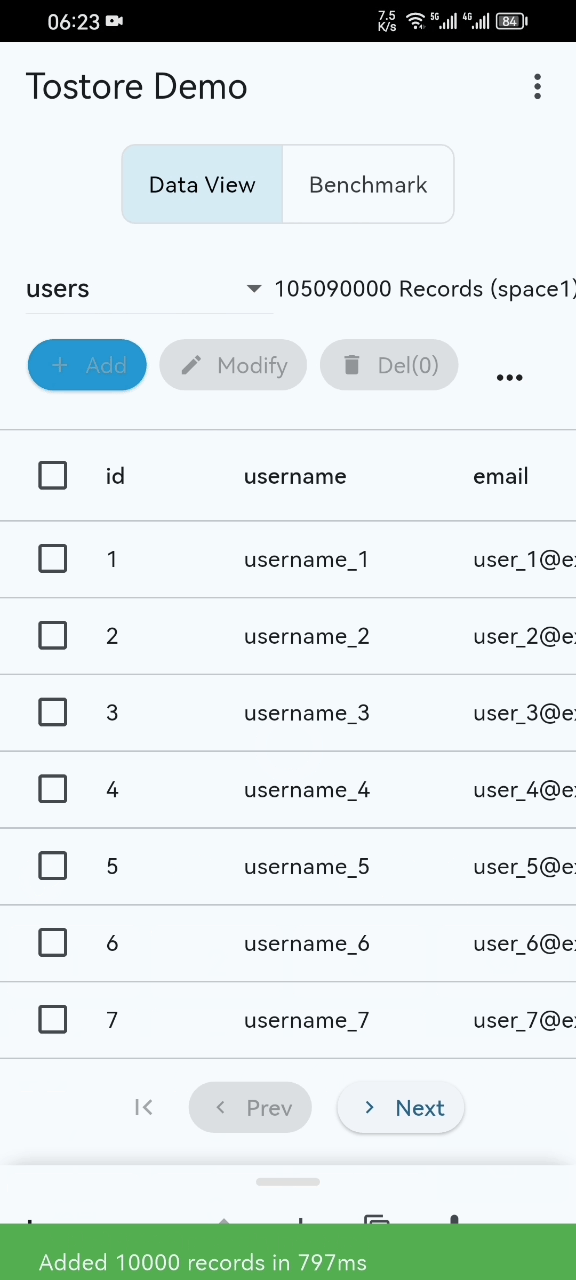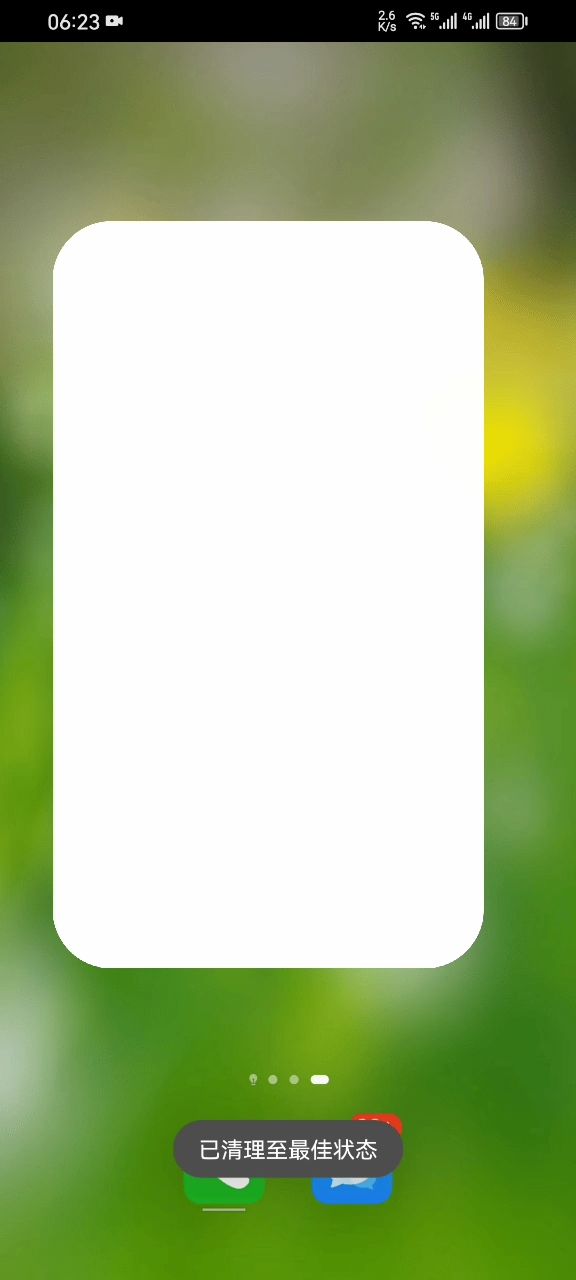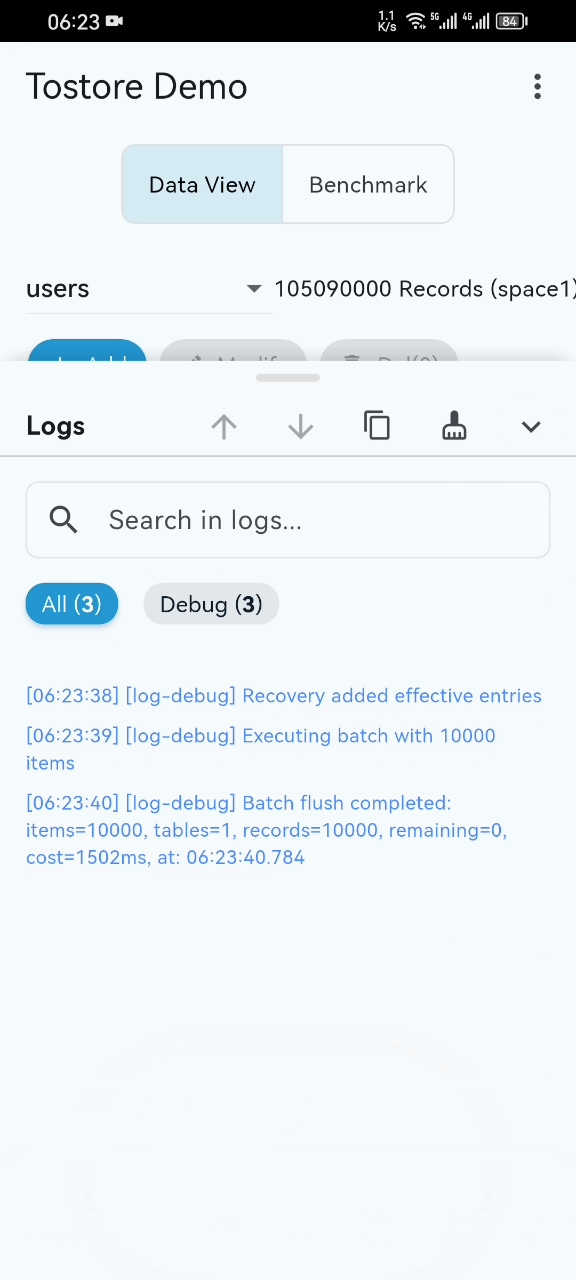
- 재해 복구 스트레스 테스트(disaster-recovery.mp4): 빈도가 높은 쓰기 중에는 충돌 및 정전을 시뮬레이션하기 위해 프로세스가 의도적으로 계속해서 중단됩니다. 투스토어는 빠른 복구가 가능합니다.
경험 팁
- 📱 예제 프로젝트:
example디렉토리에는 완전한 Flutter 애플리케이션이 포함되어 있습니다. - 🚀 프로덕션 빌드: 릴리스 모드에서 패키징하고 테스트합니다. 릴리스 성능은 디버그 모드를 훨씬 뛰어넘습니다.
- ✅ 표준 테스트: 핵심 기능은 표준화된 테스트로 다룹니다.
ToStore가 도움이 되셨다면 ⭐️를 부탁드립니다. 프로젝트를 지원하는 가장 좋은 방법 중 하나입니다. 매우 감사합니다!
🤝 기여
ToStore는 지속적으로 진화하는 현대적인 데이터 엔진으로, 커뮤니티의 기여를 진심으로 환영합니다. 버그 수정, 문서 개선, 아키텍처 개선, 새로운 아이디어 제안 등 PR을 통해 참여해 주세요:
- 🔗 PR 제출: Pull Requests
- 📖 문서: Wiki
- 📢 문제 보고: GitHub Issues
- 💬 기술적 토론: GitHub Discussions