
seohongpark/fql has 349 GitHub stars and 51 forks. GitHot measured 0 stars in 24 hours. Last checked 2026-11-21 18:19 UTC. Last push 2025-07-21.
측정된 스타 증가
- in 24h
- 0
- in 7 days
- 기록 수집 중
- in 15 days
- 기록 수집 중
- in 1 month
- 기록 수집 중
서로 겹치는 기간의 순증가량이며 일별 합계가 아닙니다. 측정값이 없으면 비워 둡니다. 스타는 관심도를 나타내며 품질을 보장하지 않습니다.
소개
The official implementation of flow Q-learning (FQL)
학습README.md
OriginalFlow Q-Learning
Paper Project page
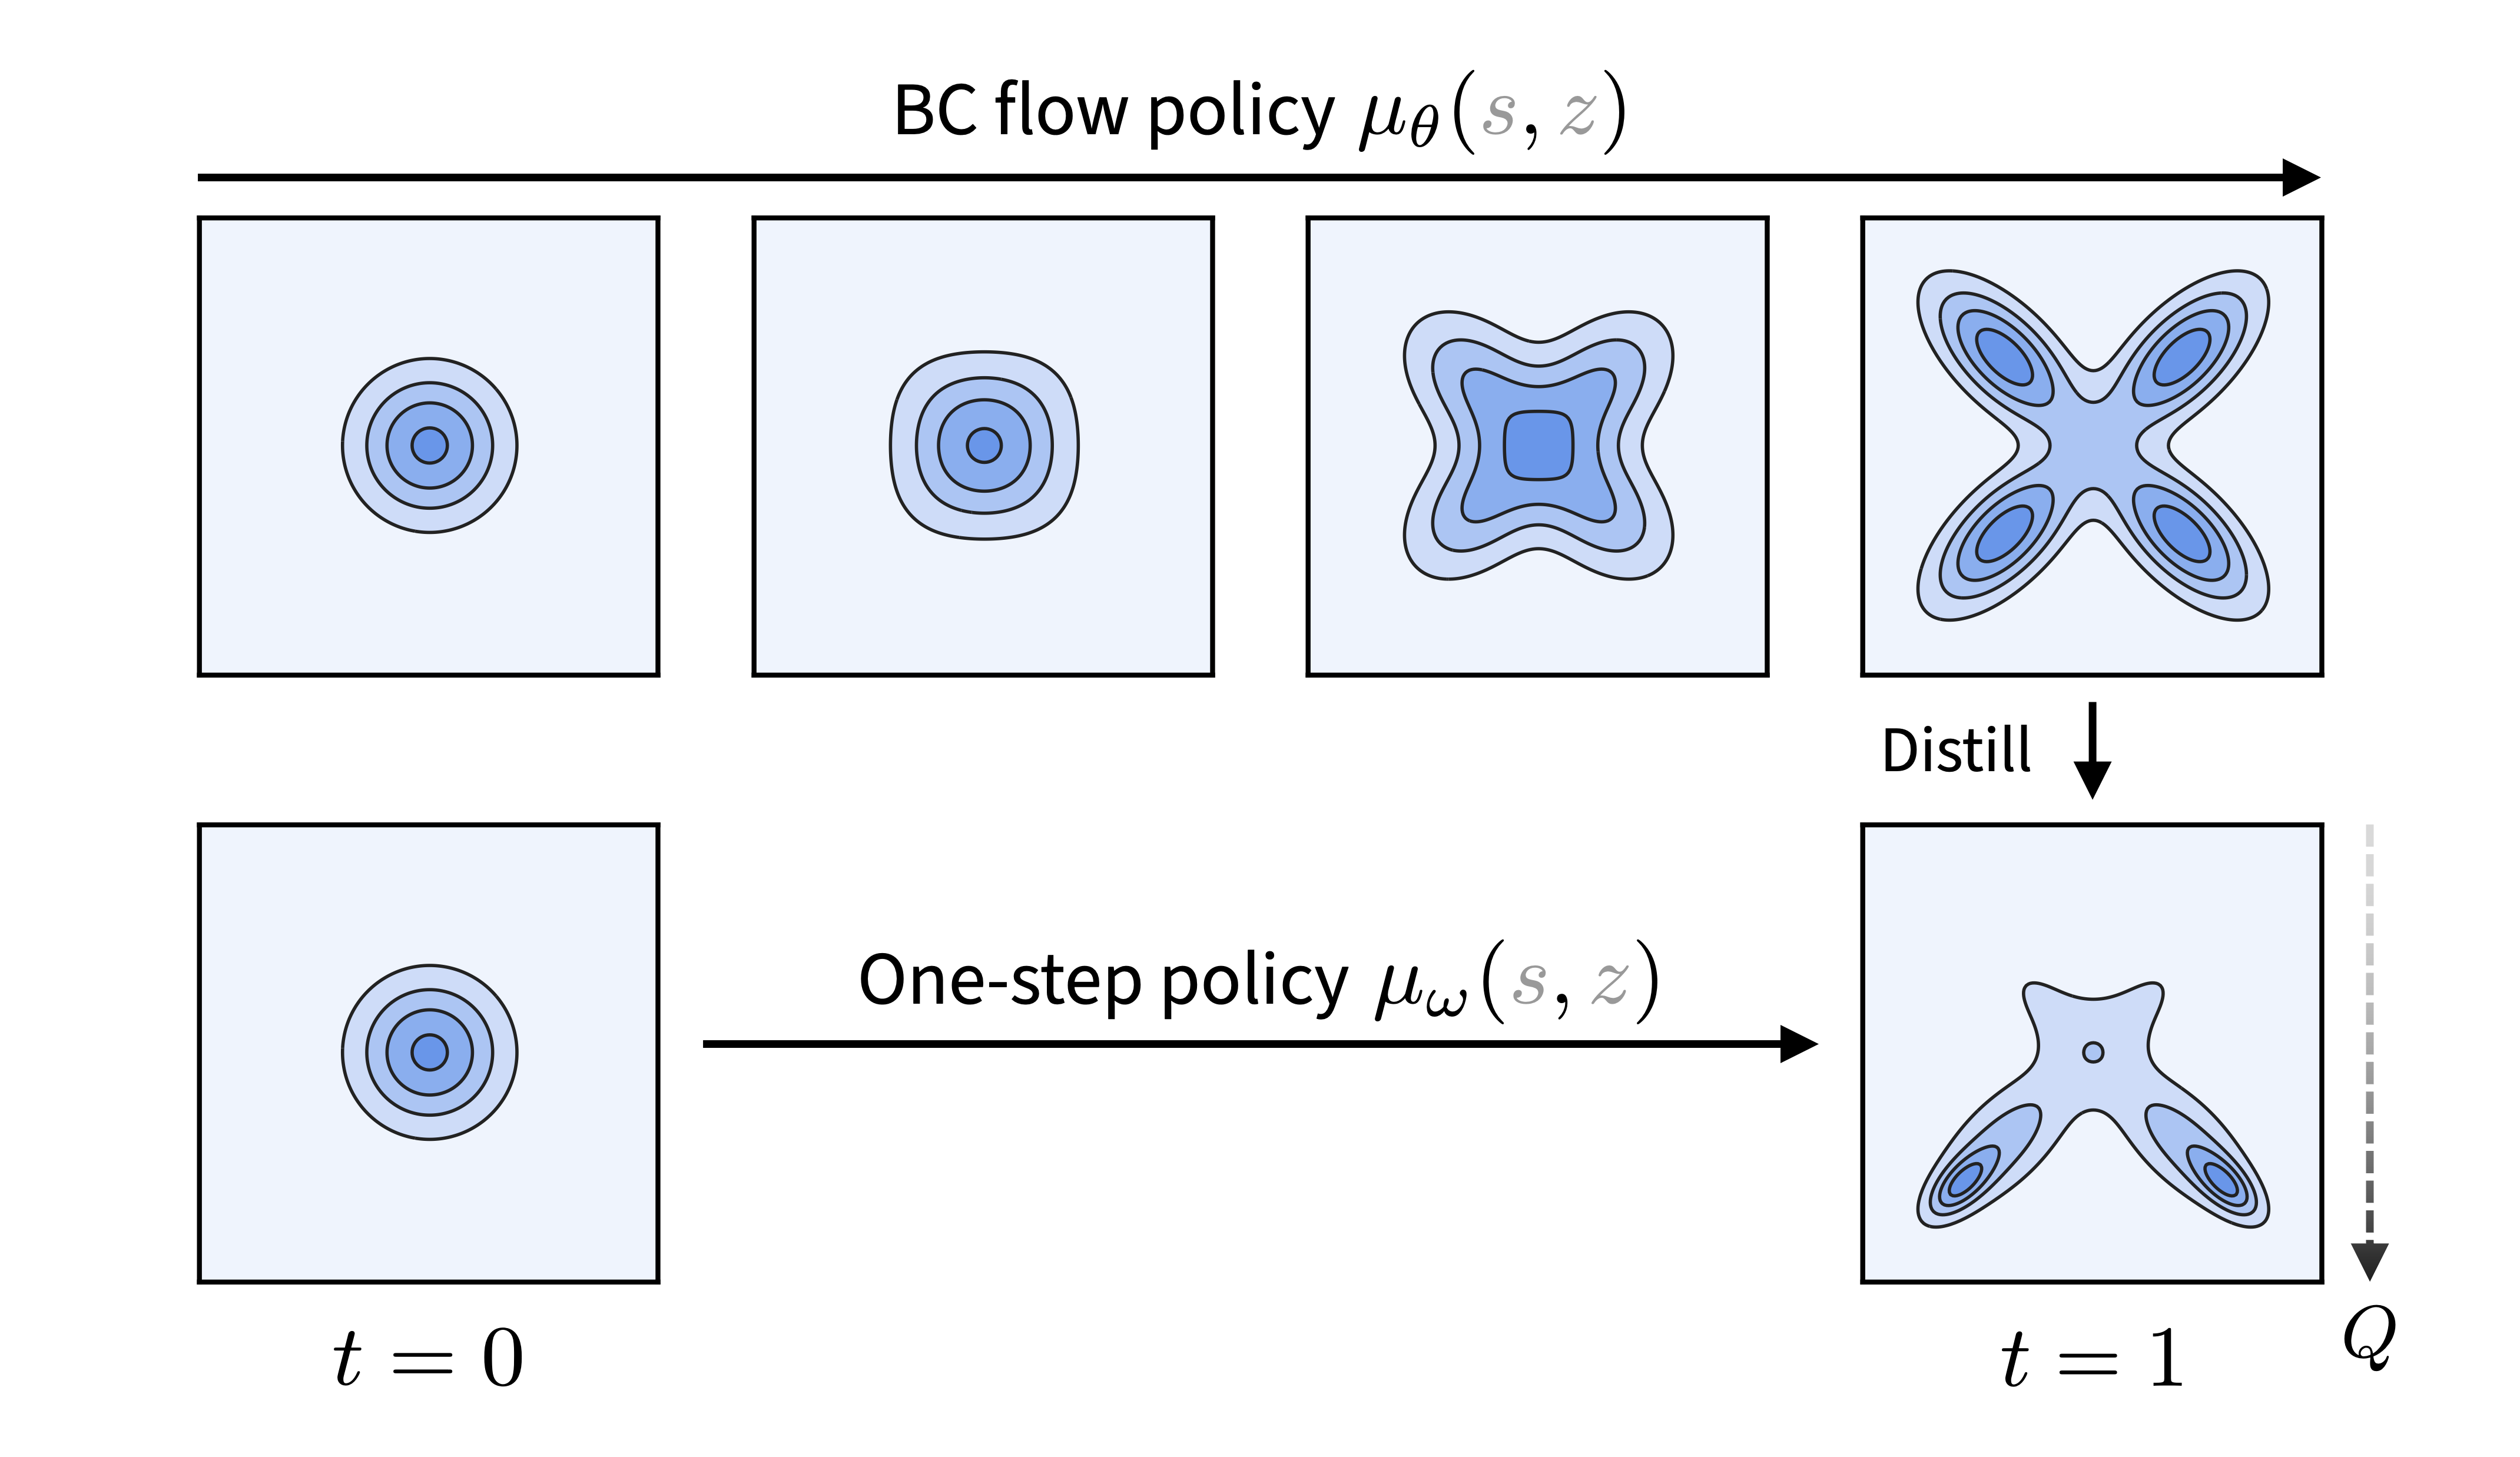
Overview
Flow Q-learning (FQL) is a simple and performance data-driven RL algorithm that leverages an expressive flow-matching policy to model complex action distributions in data.
Installation
FQL requires Python 3.9+ and is based on JAX. The main dependencies are
jax >= 0.4.26, ogbench == 1.1.0, and gymnasium == 0.29.1.
To install the full dependencies, simply run:
pip install -r requirements.txt
[!NOTE] To use D4RL environments, you need to additionally set up MuJoCo 2.1.0.
Usage
The main implementation of FQL is in agents/fql.py, and our implementations of four baselines (IQL, ReBRAC, IFQL, and RLPD) can also be found in the same directory. Here are some example commands (see the section below for the complete list):
# FQL on OGBench antsoccer-arena (offline RL)
python main.py --env_name=antsoccer-arena-navigate-singletask-v0 --agent.discount=0.995 --agent.alpha=10
# FQL on OGBench visual-cube-single (offline RL)
python main.py --env_name=visual-cube-single-play-singletask-task1-v0 --offline_steps=500000 --agent.alpha=300 --agent.encoder=impala_small --p_aug=0.5 --frame_stack=3
# FQL on OGBench scene (offline-to-online RL)
python main.py --env_name=scene-play-singletask-v0 --online_steps=1000000 --agent.alpha=300
Tips for hyperparameter tuning
Here are some general tips for FQL's hyperparameter tuning for new tasks:
- The most important hyperparameter of FQL is the BC coefficient (
--agent.alpha). This needs to be individually tuned for each environment. - Although this was not used in the original paper,
setting
--agent.normalize_q_loss=Truemakesalphainvariant to the scale of the Q-values. For new environments, we highly recommend turning on this flag (--agent.normalize_q_loss=True) and tuningalphastarting from[0.03, 0.1, 0.3, 1, 3, 10]. - For other hyperparameters, you may use the default values in
agents/fql.py. For some tasks, setting--agent.q_agg=min(to enable clipped double Q-learning) may slightly improve performance. See the ablation study in the paper for more details. - For pixel-based environments, don't forget to set
--agent.encoder=impala_small(or larger encoders),--p_aug=0.5, and--frame_stack=3.
Reproducing the main results
We provide the complete list of the exact command-line flags used to produce the main results of FQL in the paper.
[!NOTE] In OGBench, each environment provides five tasks, one of which is the default task. This task corresponds to the environment ID without any task suffixes. For example, the default task of
antmaze-large-navigateistask1, andantmaze-large-navigate-singletask-v0is the same environment asantmaze-large-navigate-singletask-task1-v0.
Click to expand the full list of commands
Offline RL
FQL on state-based OGBench (default tasks)
# FQL on OGBench antmaze-large-navigate-singletask-v0 (=antmaze-large-navigate-singletask-task1-v0)
python main.py --env_name=antmaze-large-navigate-singletask-v0 --agent.q_agg=min --agent.alpha=10
# FQL on OGBench antmaze-giant-navigate-singletask-v0 (=antmaze-giant-navigate-singletask-task1-v0)
python main.py --env_name=antmaze-giant-navigate-singletask-v0 --agent.discount=0.995 --agent.q_agg=min --agent.alpha=10
# FQL on OGBench humanoidmaze-medium-navigate-singletask-v0 (=humanoidmaze-medium-navigate-singletask-task1-v0)
python main.py --env_name=humanoidmaze-medium-navigate-singletask-v0 --agent.discount=0.995 --agent.alpha=30
# FQL on OGBench humanoidmaze-large-navigate-singletask-v0 (=humanoidmaze-large-navigate-singletask-task1-v0)
python main.py --env_name=humanoidmaze-large-navigate-singletask-v0 --agent.discount=0.995 --agent.alpha=30
# FQL on OGBench antsoccer-arena-navigate-singletask-v0 (=antsoccer-arena-navigate-singletask-task4-v0)
python main.py --env_name=antsoccer-arena-navigate-singletask-v0 --agent.discount=0.995 --agent.alpha=10
# FQL on OGBench cube-single-play-singletask-v0 (=cube-single-play-singletask-task2-v0)
python main.py --env_name=cube-single-play-singletask-v0 --agent.alpha=300
# FQL on OGBench cube-double-play-singletask-v0 (=cube-double-play-singletask-task2-v0)
python main.py --env_name=cube-double-play-singletask-v0 --agent.alpha=300
# FQL on OGBench scene-play-singletask-v0 (=scene-play-singletask-task2-v0)
python main.py --env_name=scene-play-singletask-v0 --agent.alpha=300
# FQL on OGBench puzzle-3x3-play-singletask-v0 (=puzzle-3x3-play-singletask-task4-v0)
python main.py --env_name=puzzle-3x3-play-singletask-v0 --agent.alpha=1000
# FQL on OGBench puzzle-4x4-play-singletask-v0 (=puzzle-4x4-play-singletask-task4-v0)
python main.py --env_name=puzzle-4x4-play-singletask-v0 --agent.alpha=1000
FQL on state-based OGBench (all tasks)
# FQL on OGBench antmaze-large-navigate-singletask-{task1, task2, task3, task4, task5}-v0 (default: task1)
python main.py --env_name=antmaze-large-navigate-singletask-task1-v0 --agent.q_agg=min --agent.alpha=10
python main.py --env_name=antmaze-large-navigate-singletask-task2-v0 --agent.q_agg=min --agent.alpha=10
python main.py --env_name=antmaze-large-navigate-singletask-task3-v0 --agent.q_agg=min --agent.alpha=10
python main.py --env_name=antmaze-large-navigate-singletask-task4-v0 --agent.q_agg=min --agent.alpha=10
python main.py --env_name=antmaze-large-navigate-singletask-task5-v0 --agent.q_agg=min --agent.alpha=10
# FQL on OGBench antmaze-giant-navigate-singletask-{task1, task2, task3, task4, task5}-v0 (default: task1)
python main.py --env_name=antmaze-giant-navigate-singletask-task1-v0 --agent.discount=0.995 --agent.q_agg=min --agent.alpha=10
python main.py --env_name=antmaze-giant-navigate-singletask-task2-v0 --agent.discount=0.995 --agent.q_agg=min --agent.alpha=10
python main.py --env_name=antmaze-giant-navigate-singletask-task3-v0 --agent.discount=0.995 --agent.q_agg=min --agent.alpha=10
python main.py --env_name=antmaze-giant-navigate-singletask-task4-v0 --agent.discount=0.995 --agent.q_agg=min --agent.alpha=10
python main.py --env_name=antmaze-giant-navigate-singletask-task5-v0 --agent.discount=0.995 --agent.q_agg=min --agent.alpha=10
# FQL on OGBench humanoidmaze-medium-navigate-singletask-{task1, task2, task3, task4, task5}-v0 (default: task1)
python main.py --env_name=humanoidmaze-medium-navigate-singletask-task1-v0 --agent.discount=0.995 --agent.alpha=30
python main.py --env_name=humanoidmaze-medium-navigate-singletask-task2-v0 --agent.discount=0.995 --agent.alpha=30
python main.py --env_name=humanoidmaze-medium-navigate-singletask-task3-v0 --agent.discount=0.995 --agent.alpha=30
python main.py --env_name=humanoidmaze-medium-navigate-singletask-task4-v0 --agent.discount=0.995 --agent.alpha=30
python main.py --env_name=humanoidmaze-medium-navigate-singletask-task5-v0 --agent.discount=0.995 --agent.alpha=30
# FQL on OGBench humanoidmaze-large-navigate-singletask-{task1, task2, task3, task4, task5}-v0 (default: task1)
python main.py --env_name=humanoidmaze-large-navigate-singletask-task1-v0 --agent.discount=0.995 --agent.alpha=30
python main.py --env_name=humanoidmaze-large-navigate-singletask-task2-v0 --agent.discount=0.995 --agent.alpha=30
python main.py --env_name=humanoidmaze-large-navigate-singletask-task3-v0 --agent.discount=0.995 --agent.alpha=30
python main.py --env_name=humanoidmaze-large-navigate-singletask-task4-v0 --agent.discount=0.995 --agent.alpha=30
python main.py --env_name=humanoidmaze-large-navigate-singletask-task5-v0 --agent.discount=0.995 --agent.alpha=30
# FQL on OGBench antsoccer-arena-navigate-singletask-{task1, task2, task3, task4, task5}-v0 (default: task4)
python main.py --env_name=antsoccer-arena-navigate-singletask-task1-v0 --agent.discount=0.995 --agent.alpha=10
python main.py --env_name=antsoccer-arena-navigate-singletask-task2-v0 --agent.discount=0.995 --agent.alpha=10
python main.py --env_name=antsoccer-arena-navigate-singletask-task3-v0 --agent.discount=0.995 --agent.alpha=10
python main.py --env_name=antsoccer-arena-navigate-singletask-task4-v0 --agent.discount=0.995 --agent.alpha=10
python main.py --env_name=antsoccer-arena-navigate-singletask-task5-v0 --agent.discount=0.995 --agent.alpha=10
# FQL on OGBench cube-single-play-singletask-{task1, task2, task3, task4, task5}-v0 (default: task2)
python main.py --env_name=cube-single-play-singletask-task1-v0 --agent.alpha=300
python main.py --env_name=cube-single-play-singletask-task2-v0 --agent.alpha=300
python main.py --env_name=cube-single-play-singletask-task3-v0 --agent.alpha=300
python main.py --env_name=cube-single-play-singletask-task4-v0 --agent.alpha=300
python main.py --env_name=cube-single-play-singletask-task5-v0 --agent.alpha=300
# FQL on OGBench cube-double-play-singletask-{task1, task2, task3, task4, task5}-v0 (default: task2)
python main.py --env_name=cube-double-play-singletask-task1-v0 --agent.alpha=300
python main.py --env_name=cube-double-play-singletask-task2-v0 --agent.alpha=300
python main.py --env_name=cube-double-play-singletask-task3-v0 --agent.alpha=300
python main.py --env_name=cube-double-play-singletask-task4-v0 --agent.alpha=300
python main.py --env_name=cube-double-play-singletask-task5-v0 --agent.alpha=300
# FQL on OGBench scene-play-singletask-{task1, task2, task3, task4, task5}-v0 (default: task2)
python main.py --env_name=scene-play-singletask-task1-v0 --agent.alpha=300
python main.py --env_name=scene-play-singletask-task2-v0 --agent.alpha=300
python main.py --env_name=scene-play-singletask-task3-v0 --agent.alpha=300
python main.py --env_name=scene-play-singletask-task4-v0 --agent.alpha=300
python main.py --env_name=scene-play-singletask-task5-v0 --agent.alpha=300
# FQL on OGBench puzzle-3x3-play-singletask-{task1, task2, task3, task4, task5}-v0 (default: task4)
python main.py --env_name=puzzle-3x3-play-singletask-task1-v0 --agent.alpha=1000
python main.py --env_name=puzzle-3x3-play-singletask-task2-v0 --agent.alpha=1000
python main.py --env_name=puzzle-3x3-play-singletask-task3-v0 --agent.alpha=1000
python main.py --env_name=puzzle-3x3-play-singletask-task4-v0 --agent.alpha=1000
python main.py --env_name=puzzle-3x3-play-singletask-task5-v0 --agent.alpha=1000
# FQL on OGBench puzzle-4x4-play-singletask-{task1, task2, task3, task4, task5}-v0 (default: task4)
python main.py --env_name=puzzle-4x4-play-singletask-task1-v0 --agent.alpha=1000
python main.py --env_name=puzzle-4x4-play-singletask-task2-v0 --agent.alpha=1000
python main.py --env_name=puzzle-4x4-play-singletask-task3-v0 --agent.alpha=1000
python main.py --env_name=puzzle-4x4-play-singletask-task4-v0 --agent.alpha=1000
python main.py --env_name=puzzle-4x4-play-singletask-task5-v0 --agent.alpha=1000
FQL on pixel-based OGBench
# FQL on OGBench visual-cube-single-play-singletask-task1-v0
python main.py --env_name=visual-cube-single-play-singletask-task1-v0 --offline_steps=500000 --agent.alpha=300 --agent.encoder=impala_small --p_aug=0.5 --frame_stack=3
# FQL on OGBench visual-cube-double-play-singletask-task1-v0
python main.py --env_name=visual-cube-double-play-singletask-task1-v0 --offline_steps=500000 --agent.alpha=100 --agent.encoder=impala_small --p_aug=0.5 --frame_stack=3
# FQL on OGBench visual-scene-play-singletask-task1-v0
python main.py --env_name=visual-scene-play-singletask-task1-v0 --offline_steps=500000 --agent.alpha=100 --agent.encoder=impala_small --p_aug=0.5 --frame_stack=3
# FQL on OGBench visual-puzzle-3x3-play-singletask-task1-v0
python main.py --env_name=visual-puzzle-3x3-play-singletask-task1-v0 --offline_steps=500000 --agent.alpha=300 --agent.encoder=impala_small --p_aug=0.5 --frame_stack=3
# FQL on OGBench visual-puzzle-4x4-play-singletask-task1-v0
python main.py --env_name=visual-puzzle-4x4-play-singletask-task1-v0 --offline_steps=500000 --agent.alpha=300 --agent.encoder=impala_small --p_aug=0.5 --frame_stack=3
FQL on D4RL
# FQL on D4RL antmaze-umaze-v2
python main.py --env_name=antmaze-umaze-v2 --offline_steps=500000 --agent.alpha=10
# FQL on D4RL antmaze-umaze-diverse-v2
python main.py --env_name=antmaze-umaze-diverse-v2 --offline_steps=500000 --agent.alpha=10
# FQL on D4RL antmaze-medium-play-v2
python main.py --env_name=antmaze-medium-play-v2 --offline_steps=500000 --agent.alpha=10
# FQL on D4RL antmaze-medium-diverse-v2
python main.py --env_name=antmaze-medium-diverse-v2 --offline_steps=500000 --agent.alpha=10
# FQL on D4RL antmaze-large-play-v2
python main.py --env_name=antmaze-large-play-v2 --offline_steps=500000 --agent.alpha=3
# FQL on D4RL antmaze-large-diverse-v2
python main.py --env_name=antmaze-large-diverse-v2 --offline_steps=500000 --agent.alpha=3
# FQL on D4RL pen-human-v1
python main.py --env_name=pen-human-v1 --offline_steps=500000 --agent.q_agg=min --agent.alpha=10000
# FQL on D4RL pen-cloned-v1
python main.py --env_name=pen-cloned-v1 --offline_steps=500000 --agent.q_agg=min --agent.alpha=10000
# FQL on D4RL pen-expert-v1
python main.py --env_name=pen-expert-v1 --offline_steps=500000 --agent.q_agg=min --agent.alpha=3000
# FQL on D4RL door-human-v1
python main.py --env_name=door-human-v1 --offline_steps=500000 --agent.q_agg=min --agent.alpha=30000
# FQL on D4RL door-cloned-v1
python main.py --env_name=door-cloned-v1 --offline_steps=500000 --agent.q_agg=min --agent.alpha=30000
# FQL on D4RL door-expert-v1
python main.py --env_name=door-expert-v1 --offline_steps=500000 --agent.q_agg=min --agent.alpha=30000
# FQL on D4RL hammer-human-v1
python main.py --env_name=hammer-human-v1 --offline_steps=500000 --agent.q_agg=min --agent.alpha=30000
# FQL on D4RL hammer-cloned-v1
python main.py --env_name=hammer-cloned-v1 --offline_steps=500000 --agent.q_agg=min --agent.alpha=10000
# FQL on D4RL hammer-expert-v1
python main.py --env_name=hammer-expert-v1 --offline_steps=500000 --agent.q_agg=min --agent.alpha=30000
# FQL on D4RL relocate-human-v1
python main.py --env_name=relocate-human-v1 --offline_steps=500000 --agent.q_agg=min --agent.alpha=10000
# FQL on D4RL relocate-cloned-v1
python main.py --env_name=relocate-cloned-v1 --offline_steps=500000 --agent.q_agg=min --agent.alpha=30000
# FQL on D4RL relocate-expert-v1
python main.py --env_name=relocate-expert-v1 --offline_steps=500000 --agent.q_agg=min --agent.alpha=30000
IQL, ReBRAC, and IFQL (examples)
# IQL on OGBench humanoidmaze-medium-navigate-singletask-v0
python main.py --env_name=humanoidmaze-medium-navigate-singletask-v0 --agent=agents/iql.py --agent.discount=0.995 --agent.alpha=10
# ReBRAC on OGBench humanoidmaze-medium-navigate-singletask-v0
python main.py --env_name=humanoidmaze-medium-navigate-singletask-v0 --agent=agents/rebrac.py --agent.discount=0.995 --agent.alpha_actor=0.01 --agent.alpha_critic=0.01
# IFQL on OGBench humanoidmaze-medium-navigate-singletask-v0
python main.py --env_name=humanoidmaze-medium-navigate-singletask-v0 --agent=agents/ifql.py --agent.discount=0.995 --agent.num_samples=32
# IQL on OGBench visual-cube-single-play-singletask-task1-v0
python main.py --env_name=visual-cube-single-play-singletask-task1-v0 --offline_steps=500000 --agent=agents/iql.py --agent.alpha=1 --agent.encoder=impala_small --p_aug=0.5 --frame_stack=3
# ReBRAC on OGBench visual-cube-single-play-singletask-task1-v0
python main.py --env_name=visual-cube-single-play-singletask-task1-v0 --offline_steps=500000 --agent=agents/rebrac.py --agent.alpha_actor=1 --agent.alpha_critic=0 --agent.encoder=impala_small --p_aug=0.5 --frame_stack=3
# IFQL on OGBench visual-cube-single-play-singletask-task1-v0
python main.py --env_name=visual-cube-single-play-singletask-task1-v0 --offline_steps=500000 --agent=agents/ifql.py --agent.num_samples=32 --agent.encoder=impala_small --p_aug=0.5 --frame_stack=3
Offline-to-online RL
FQL
# FQL on OGBench humanoidmaze-medium-navigate-singletask-v0
python main.py --env_name=humanoidmaze-medium-navigate-singletask-v0 --online_steps=1000000 --agent.discount=0.995 --agent.alpha=100
# FQL on OGBench antsoccer-arena-navigate-singletask-v0
python main.py --env_name=antsoccer-arena-navigate-singletask-v0 --online_steps=1000000 --agent.discount=0.995 --agent.alpha=30
# FQL on OGBench cube-double-play-singletask-v0
python main.py --env_name=cube-double-play-singletask-v0 --online_steps=1000000 --agent.alpha=300
# FQL on OGBench scene-play-singletask-v0
python main.py --env_name=scene-play-singletask-v0 --online_steps=1000000 --agent.alpha=300
# FQL on OGBench puzzle-4x4-play-singletask-v0
python main.py --env_name=puzzle-4x4-play-singletask-v0 --online_steps=1000000 --agent.alpha=1000
# FQL on D4RL antmaze-umaze-v2
python main.py --env_name=antmaze-umaze-v2 --online_steps=1000000 --agent.alpha=10
# FQL on D4RL antmaze-umaze-diverse-v2
python main.py --env_name=antmaze-umaze-diverse-v2 --online_steps=1000000 --agent.alpha=10
# FQL on D4RL antmaze-medium-play-v2
python main.py --env_name=antmaze-medium-play-v2 --online_steps=1000000 --agent.alpha=10
# FQL on D4RL antmaze-medium-diverse-v2
python main.py --env_name=antmaze-medium-diverse-v2 --online_steps=1000000 --agent.alpha=10
# FQL on D4RL antmaze-large-play-v2
python main.py --env_name=antmaze-large-play-v2 --online_steps=1000000 --agent.alpha=3
# FQL on D4RL antmaze-large-diverse-v2
python main.py --env_name=antmaze-large-diverse-v2 --online_steps=1000000 --agent.alpha=3
# FQL on D4RL pen-cloned-v1
python main.py --env_name=pen-cloned-v1 --online_steps=1000000 --agent.q_agg=min --agent.alpha=1000
# FQL on D4RL door-cloned-v1
python main.py --env_name=door-cloned-v1 --online_steps=1000000 --agent.q_agg=min --agent.alpha=1000
# FQL on D4RL hammer-cloned-v1
python main.py --env_name=hammer-cloned-v1 --online_steps=1000000 --agent.q_agg=min --agent.alpha=1000
# FQL on D4RL relocate-cloned-v1
python main.py --env_name=relocate-cloned-v1 --online_steps=1000000 --agent.q_agg=min --agent.alpha=10000
IQL, ReBRAC, IFQL, and RLPD (examples)
# IQL on OGBench humanoidmaze-medium-navigate-singletask-v0
python main.py --env_name=humanoidmaze-medium-navigate-singletask-v0 --online_steps=1000000 --agent=agents/iql.py --agent.discount=0.995 --agent.alpha=10
# ReBRAC on OGBench humanoidmaze-medium-navigate-singletask-v0
python main.py --env_name=humanoidmaze-medium-navigate-singletask-v0 --online_steps=1000000 --agent=agents/rebrac.py --agent.discount=0.995 --agent.alpha_actor=0.01 --agent.alpha_critic=0.01
# IFQL on OGBench humanoidmaze-medium-navigate-singletask-v0
python main.py --env_name=humanoidmaze-medium-navigate-singletask-v0 --online_steps=1000000 --agent=agents/ifql.py --agent.discount=0.995 --agent.num_samples=32
# RLPD on OGBench humanoidmaze-medium-navigate-singletask-v0
python main.py --env_name=humanoidmaze-medium-navigate-singletask-v0 --offline_steps=0 --online_steps=1000000 --agent=agents/sac.py --agent.discount=0.995 --balanced_sampling=1
Acknowledgments
This codebase is built on top of OGBench's reference implementations.
관련 프로젝트 살펴보기
불러오는 중…