
hardness1020/learn-agent-architecture
hardness1020/learn-agent-architecture has 1,211 GitHub stars and 121 forks. GitHot measured 0 stars in 24 hours. Last checked 2026-11-09 08:39 UTC. Last push 2026-10-21.
Learn AI agents from scratch.
측정된 스타 증가
- in 24h
- 0
- in 7 days
- 업데이트 지연
- in 15 days
- 업데이트 지연
- in 1 month
- 업데이트 지연
서로 겹치는 기간의 순증가량이며 일별 합계가 아닙니다. 측정값이 없으면 비워 둡니다. 스타는 관심도를 나타내며 품질을 보장하지 않습니다.
README.ko.md
OriginalLearn Agent Architecture
최신 AI agent가 LLM을 중심으로 어떻게 만들어지는지 배웁니다.


English · 繁體中文 · 简体中文 · 日本語 · 한국어
모델은 추론합니다. harness는 그 추론을 통제된 행동으로 바꾸는데, tool을 실행하고, 호출 사이의 상태를 유지하고, 부수 효과를 통제하고, 여러 loop를 조율합니다. 모델 호출 하나만으로는 그 가운데 어느 것도 할 수 없습니다.
이 저장소는 harness를 섹션 단위로 설명합니다. loop, tool, memory, permission, context, task, 인터페이스 순입니다. 한 번 익히면 여러 agent를 읽을 수 있는데, coding tool과 chat assistant, 자율 실행기의 차이는 대부분 harness 선택에서 오기 때문입니다.
섹션 하나로는 다 담기 어려운 세 주제는 짝이 되는 저장소에서 더 깊이 다룹니다.
- learn-agent-memory: memory loop를 프로덕션 memory 서브시스템으로 키웁니다.
- learn-deepseek-harness: deepseek-harness를 plugin seam 하나씩 처음부터 익힙니다.
- EvalGrill: agent를 실제로 쓴 사례를 재현하고 검증할 수 있는 eval 세트로 바꿉니다.
목차: Loop · 학습 방법 · 대상 시스템 · 섹션 · 구조 · 실행
Agent Loop
대부분의 agent는 같은 제어 흐름을 공유합니다. 모델을 호출하고, 요청된 tool을 실행하고, 결과를 덧붙이고, 모델을 다시 호출합니다.
loop는 작습니다. 엔지니어링 대부분은 그 주위에 있습니다. tool을 dispatch하고, 부수 효과를 통제하고, context를 관리하고, 상태를 저장하고, 다른 loop를 조율합니다.
학습 방법
모든 섹션은 그 자체로 완결되며 같은 네 갈래 관점을 씁니다.
- 여는 글. 이 계층이 푸는 문제.
- 메커니즘. 일반적인 설계와 제어 흐름.
- 시스템별. 실제 시스템이 그것을 어떻게 구현하는지.
- 실패 모드. 무엇이 깨지고 어떻게 완화하는지.
이 저장소로 공부하는 방법입니다.
- 섹션을 순서대로 읽습니다. 각 섹션은 앞 계층 위에 쌓입니다.
- 실행 가능한 섹션은
src/loop.py를 읽고 나서 그demo.py를 돌립니다. - 어떤 섹션의
src/를 그 앞 섹션과 diff합니다. 그 diff가 그 섹션이 더한 메커니즘 하나입니다.
연구 대상 시스템
각 시스템은 아래 섹션들을 위한 실제 사례입니다.
| 시스템 | 사람들이 쓰는 이유 | 무엇을 보려고 읽는지 | 섹션 | 연구한 버전 |
|---|---|---|---|---|
| Claude Code | 최전선 coding agent. 파일을 고치고, 명령을 실행하고, 실제 저장소에 변경을 반영함. | harness 전체, 여기서 시작 | 0부터 23까지(전부) | v2.1.88 |
| Hermes Agent | 장기 assistant. 사용자를 기억하고, workflow를 익히고, 어디서든 돎. | memory, skill, 항상 켜진 channel | 7, 9, 14, 16, 19, 21, 22 | v2026.7.1 |
| mini-swe-agent | 연구용 기준선. bash tool 하나, 약 150줄. | 가장 작은 완전한 loop, 예산, eval harness | 0부터 3까지, 8, 10, 11, 20부터 23까지 | v2.4.5 |
| deepseek-harness | plugin 우선 harness. loop마저 교체 가능한 plugin. | plugin seam, 지속되는 session log, ACP | 1부터 8까지, 10부터 14까지, 16부터 21까지 | dsh-v0.1.0-rc.7 |
| (more soon) |
나중에 OpenClaw와 aider를 비롯한 시스템을 더 넣을 수 있습니다. 짝이 되는 저장소 둘이 더 깊이 들어갑니다. memory 계층은 learn-agent-memory에서, deepseek-harness를 처음부터 익히는 것은 learn-deepseek-harness에서 다룹니다.
섹션
기본 loop에서 스스로 돌아가는 harness까지 여덟 계층입니다. 각 행은 그 자체로 완결된 글 하나로 이어집니다.
섹션 9는 learn-agent-memory에서 이어집니다. 그 memory loop를 프로덕션까지 키우는 단계가 열 개 더 있습니다.
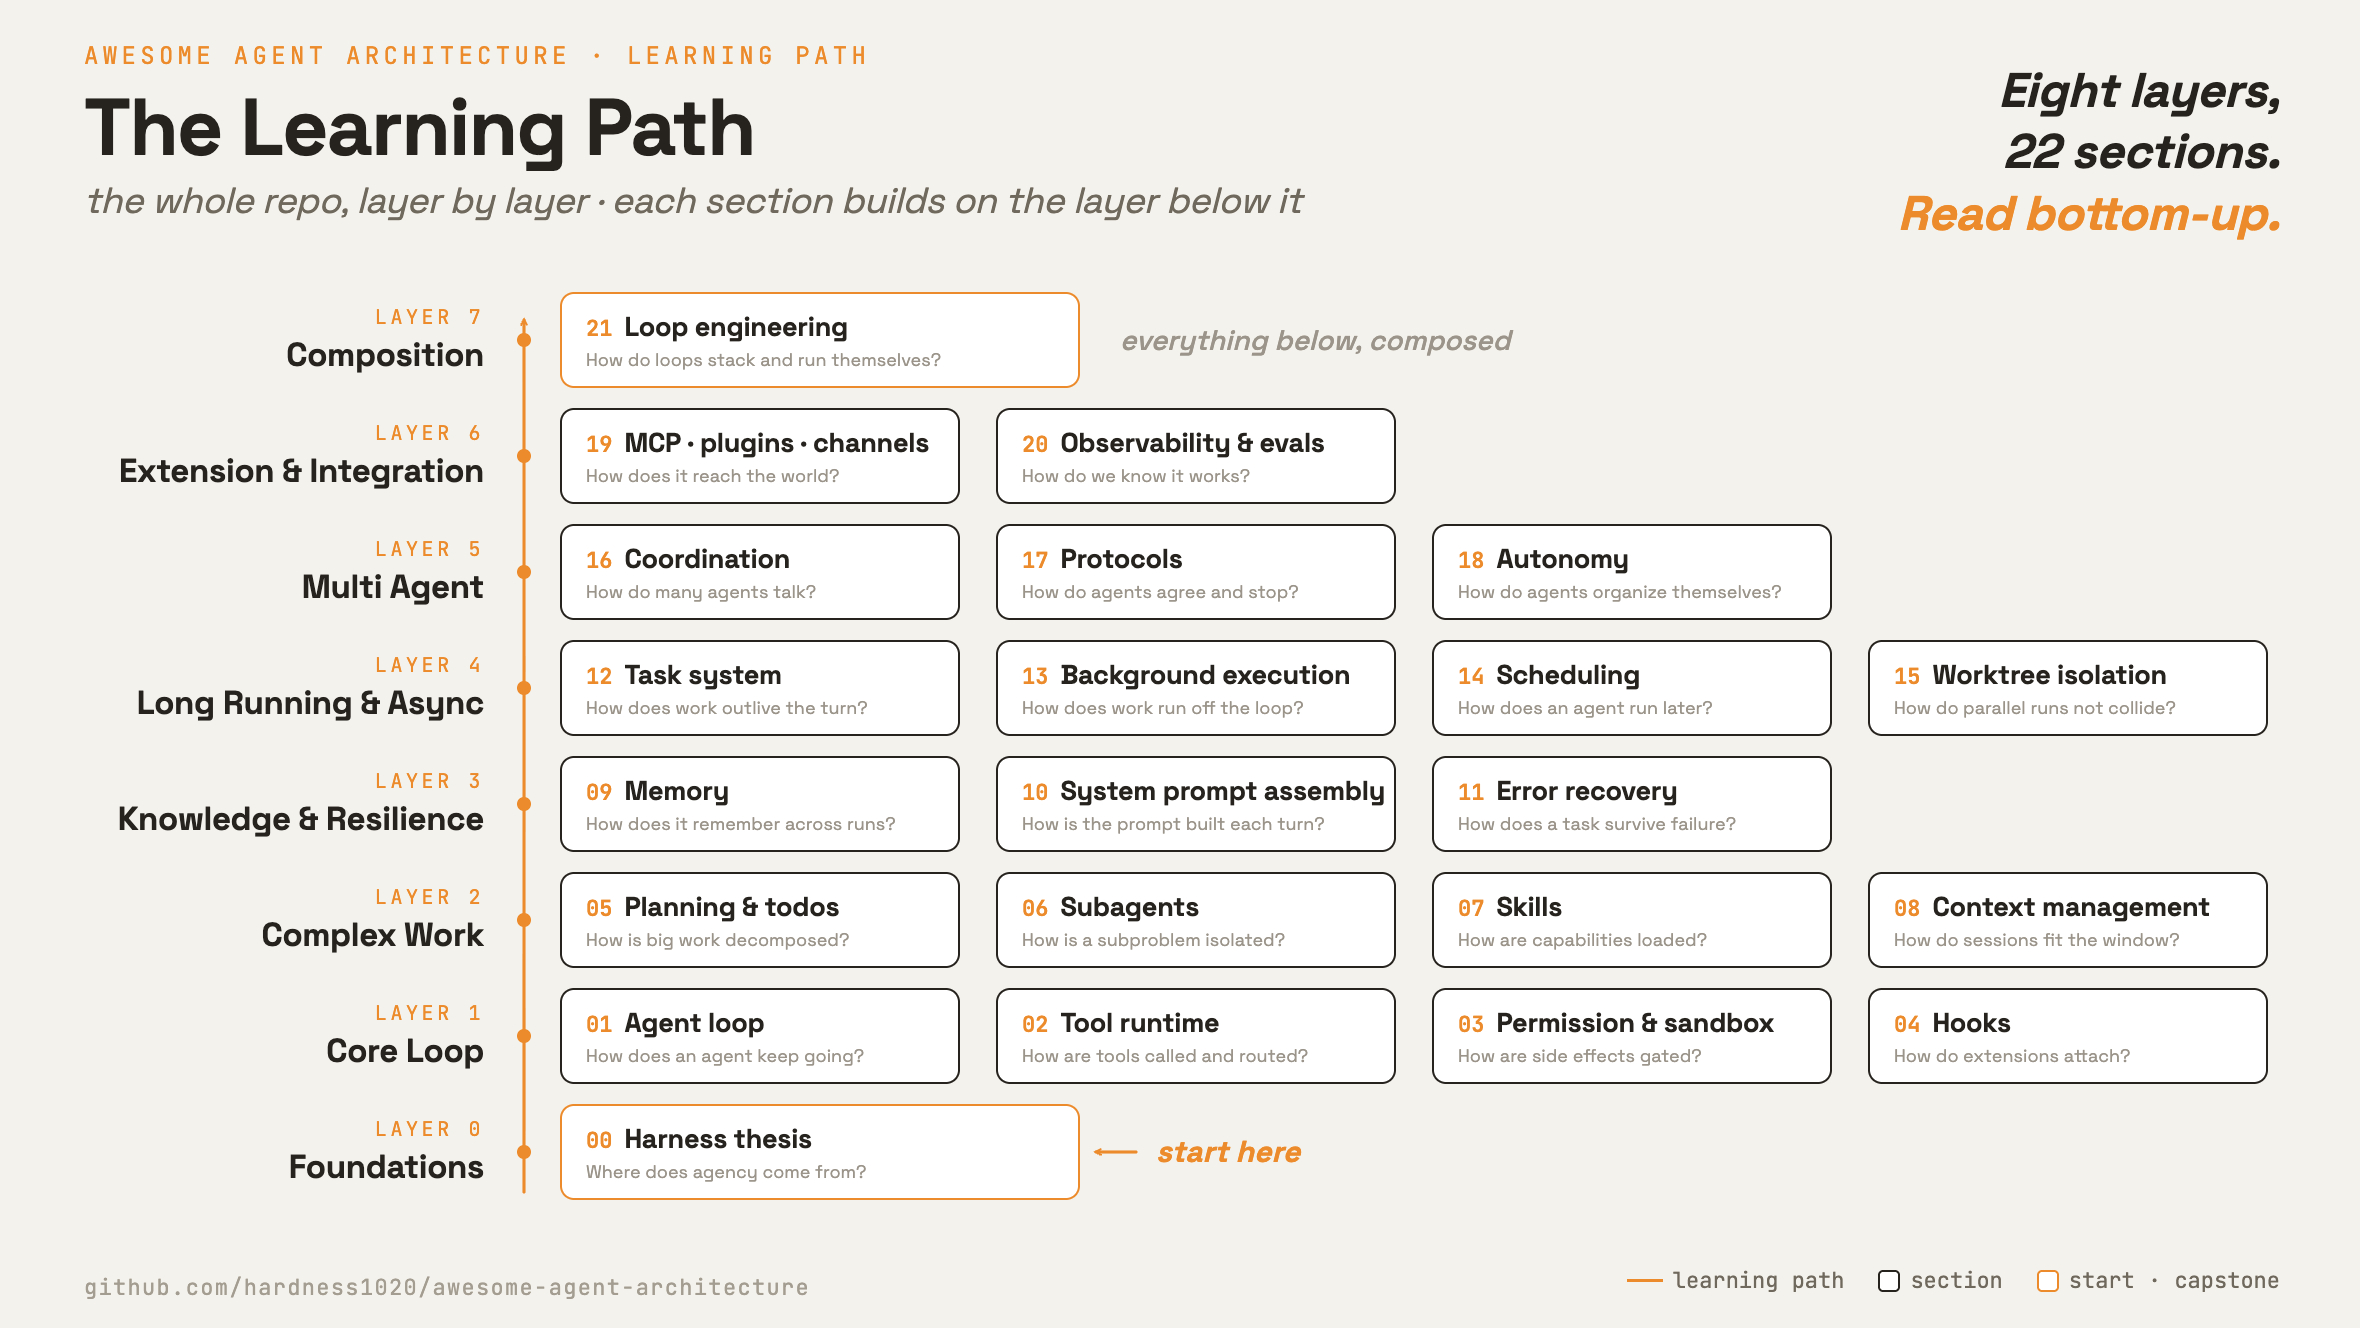
| # | 섹션 | 질문 | 핵심 메커니즘 |
|---|---|---|---|
| Layer 0 · 기초 | |||
| 0 | Harness 주제 | agency는 어디에서 오는가? | 모델 대 harness, 행동, 관측, permission |
| Layer 1 · 핵심 Loop | |||
| 1 | Agent loop | agent는 어떻게 계속 나아가는가? | messages[], loop, stop_reason |
| 2 | Tool runtime | tool은 어떻게 호출되고 라우팅되는가? | registry, schema, dispatch, 지연 탐색 |
| 3 | Permission & sandbox | 부수 효과는 어떻게 통제되는가? | permission mode, 승인, sandbox |
| 4 | Hooks | 확장은 loop에 어떻게 붙는가? | PreToolUse, PostToolUse, 수명 주기 이벤트 |
| Layer 2 · 복잡한 작업 | |||
| 5 | 계획과 todo | 큰 작업은 어떻게 쪼개는가? | plan mode, todo 목록, 편집 전 승인 |
| 6 | Subagents | 하위 문제는 어떻게 격리하는가? | 새 messages[], 위임, child loop |
| 7 | Skills | 기능은 어떻게 필요할 때 로드되는가? | SKILL.md, 목록, 점진적 공개 |
| 8 | Context 관리 | 긴 session은 어떻게 window에 맞추는가? | 예산 배분, stub, compaction, 요약 |
| Layer 3 · 지식과 회복력 | |||
| 9 | Memory | 실행이 바뀌어도 어떻게 기억하는가? | 선별, recall, 추출, 통합 |
| 10 | System prompt 조립 | prompt는 매 turn 어떻게 만들어지는가? | prompt 구획, 실시간 상태, 캐시 경계 |
| 11 | 오류 복구 | 긴 task는 실패를 어떻게 견디는가? | 재시도, 넘침 복구, 대체 모델 |
| Layer 4 · 장기 실행과 비동기 | |||
| 12 | Task 시스템 | 작업은 turn을 넘어 어떻게 지속되는가? | task 기록, 의존 관계, lock |
| 13 | 백그라운드 실행 | 작업은 메인 loop 밖에서 어떻게 도는가? | handle, task 상태, 알림 큐 |
| 14 | Scheduling | agent는 어떻게 나중에 실행되는가? | cron, sleep, 원격 트리거, 큐 |
| 15 | Worktree 격리 | 병렬 작업은 충돌을 어떻게 피하는가? | git worktree, 작업 디렉터리 결속, 안전한 정리 |
| Layer 5 · 다중 Agent | |||
| 16 | 조율 | 여러 agent는 어떻게 대화하는가? | inbox, 브로드캐스트, permission 상향 전달 |
| 17 | Protocols | agent는 어떻게 합의하고 깔끔하게 멈추는가? | 계획 승인, 종료 handshake |
| 18 | 자율성 | agent는 어떻게 스스로를 조직하는가? | 대기 주기, task 선점, 자기 조직화 |
| Layer 6 · 확장과 통합 | |||
| 19 | MCP / plugin / channel | harness는 어떻게 바깥 세계에 닿는가? | 전송 방식, channel, tool 풀 구성 |
| 20 | 관측과 평가 | 잘 동작하는지 어떻게 아는가? | 추적, 지표, eval, 실패 분석 |
| 23 | 평가 | 어떤 변경이 더 나아졌는지 어떻게 아는가? | eval 환경, 초기화, 판정기, Pass^k |
| Layer 7 · 조합 | |||
| 21 | Loop 엔지니어링 | loop는 어떻게 쌓여 스스로 도는 시스템이 되는가? | 검증 loop, 트리거, 예산, 성숙도 단계 |
| 22 | Graph 엔지니어링 | 제어 흐름은 언제 모델에서 코드로 넘어가는가? | 노드, 코드로 짠 엣지, 순환, 노드로서의 agent, 타입이 정해진 판단 엣지 |
리포지토리 구조
00-harness-thesis/부터 23-evaluation/까지 섹션 글 24개가 모두 있습니다.
learn-agent-architecture/
├── README.md                  # top-level map
├── sections/                  # one folder per section
│   ├── 00-harness-thesis/     # README.md per section
│   ├── 01-agent-loop/src/     # runnable chain starts here
│   ├── ...
│   └── 23-evaluation/
└── references/                # primary sources and prior art
각 섹션 폴더는 NN-name/ 형태이고 README.md를 담고 있습니다.
섹션 1부터 23까지는 실행 가능한 src/도 함께 담고 있습니다. 코드는 섹션마다 쌓입니다.
각 섹션은 메커니즘을 하나 더하고 loop.py를 발전시키므로, 이웃한 두 섹션의 diff가 무엇이 바뀌었는지 보여 줍니다.
섹션 하나로 감당이 안 되는 깊은 주제는 각자의 저장소에 있습니다. learn-agent-memory는 섹션 9의 loop를 온전한 memory 서브시스템으로 키웁니다. learn-deepseek-harness는 deepseek-harness를 plugin seam 하나씩 처음부터 익힙니다.
데모 실행
섹션 1부터 23까지는 실행 가능한 데모를 함께 제공합니다. 저장소 루트에서 한 번만 준비하면 됩니다.
uv venv
uv pip install -r requirements.txt
cp .env.example .env        # then add your ANTHROPIC_API_KEY
고정된 의존성은 requirements.txt에 있습니다. .env는 gitignore 대상이며 다음을 담습니다.
ANTHROPIC_API_KEY- 선택 사항인
ANTHROPIC_MODEL - 선택 사항인
ANTHROPIC_BASE_URL
실행 가능한 각 섹션에는 다음이 있습니다.
test.py: 키가 필요 없는 오프라인 검사.demo.py: API를 상대로 하는 라이브 데모.
python sections/01-agent-loop/src/test.py         # offline
uv run python sections/01-agent-loop/src/demo.py  # live
기여
- 시스템 추가. 새 agent를 같은 섹션 구조에 끼워 넣습니다.
- 섹션 심화. 메커니즘, 더 명확한 다이어그램, 더 날카로운 실패 모드를 더합니다.
- 기록 정정. 이 글들은 소스, 문서, 실제 동작을 바탕으로 재구성한 것입니다. 출처가 있는 정정을 환영합니다.
추측보다 이름이 있고 검증 가능한 메커니즘을 씁니다. 출처를 밝힙니다. 전체 PR 체크리스트는 CONTRIBUTING.md를 봅니다.
참고 문헌
- claude-code: 메커니즘 이름과 구현 경로를 확인하는 데 쓴 Claude Code 소스 백업.
- hermes-agent: 두 번째 연구 대상으로 삼은 오픈소스 agent harness(MIT).
- mini-swe-agent: 세 번째 연구 대상으로 삼은 최소 SWE agent(MIT).
- deepseek-harness: 네 번째 연구 대상으로 삼은 plugin 기반 agent harness(MIT).
- learn-claude-code: 코드 우선의 harness 재구성과 섹션 구성.
- EvalGrill: 섹션 23을 실천하는 짝 도구 (Apache-2.0). agent를 실제로 쓴 사례에서 eval 세트를 만듭니다.
- Anthropic Agent Skills best practices: skill의 점진적 공개 단계.
- Anthropic prompt caching: 캐시 분기점, TTL, 가격, 최소 token 수.
- cobusgreyling/loop-engineering: loop 구성 요소와 준비도 단계.
- LangChain · The art of loop engineering: 겹쳐 쌓인 loop 넷.
- Addy Osmani · Loop engineering: agent loop를 위한 조합형 구성 요소.
- MindStudio · What is loop engineering: 자율 workflow의 목표 조건.
- Lilian Weng · Harness engineering for self-improvement: 개선 loop, 그리고 loop 바깥에 두는 gate.
- LangChain · 3 years of graph engineering: 노드, 엣지, 순환, 그리고 노드로서의 agent.
- Anthropic · Building effective agents: workflow와 agent의 대비, 그리고 다섯 가지 workflow 형태.
- Google · Why we built ADK 2.0: 코드로 하는 라우팅과 노드 사이의 context 격리.
- TypeSafe Jev docs: 타입이 정해진 decision model의 요청 계약과 답의 형태.
섹션 22는
decide.py에서 이것을 그래프 엣지에 물립니다. - ai-agent-book: 李博杰의 《深入理解 AI Agent》(Apache-2.0). 6장이 평가 섹션의 근거입니다.
감사의 말
이 프로젝트를 실어 준 다음 컬렉션에 감사드립니다.
관련 프로젝트 살펴보기
affaan-m/ECC
에이전트 실행·제어 프레임워크를 위한 성능 최적화 시스템. Claude Code, Codex, Opencode, Cursor 등을 위한 스킬, 본능, 메모리, 보안, 연구 우선 개발을 제공합니다.
300,313 스타NousResearch/hermes-agent
당신과 함께 성장하는 에이전트
262,134 스타multica-ai/andrej-karpathy-skills
Andrej Karpathy가 관찰한 LLM 코딩의 함정을 바탕으로 Claude Code의 동작을 개선하는 단일 CLAUDE.md 파일입니다.
231,460 스타firecrawl/firecrawl
웹과 그 너머의 데이터로 AI 에이전트를 강화합니다. 초지능을 위한 라이브러리를 구축하고 있습니다. 🔥
200,178 스타