
alexgreensh/token-optimizer
alexgreensh/token-optimizer has 2,957 GitHub stars and 233 forks. GitHot measured +9 stars in 24 hours and +96 in 7 days. Last checked 2026-11-11 08:23 UTC. Last push 2026-11-01.
Find the ghost tokens. Fix them. Survive compaction. Avoid context quality decay.
측정된 스타 증가
- in 24h
- +9
- in 7 days
- +96
- in 15 days
- 업데이트 지연
- in 1 month
- 업데이트 지연
서로 겹치는 기간의 순증가량이며 일별 합계가 아닙니다. 측정값이 없으면 비워 둡니다. 스타는 관심도를 나타내며 품질을 보장하지 않습니다.
README.ko.md
Original








낭비하는 토큰을 줄이세요. 잃을 뻔한 작업은 보존하세요.
백그라운드에서 자동으로 실행됩니다. 평소처럼 계속 작업하시면 됩니다. 전체 현황을 보고 싶을 때 감사를 실행하세요.

30초 요약
Token Optimizer는 AI 코딩 보조 도구가 낭비하는 토큰을 줄이고, 세션과 압축(compaction) 사이에서 작업을 살려두며, 모든 달러가 어디에 쓰였는지 실시간 대시보드로 보여줍니다. 대부분은 자동으로 실행됩니다. 설치하고 감사를 한 번 실행하면, 나머지는 훅(hook)이 처리합니다.
왜 그냥 Headroom이나 RTK를 쓰지 않나요? 둘 다 명령 출력을 압축하는데, 이는 컨텍스트의 15~25%만 다룹니다. Token Optimizer는 그 부분과 나머지 75%까지 다룹니다: 부풀려진 설정, 사용하지 않는 스킬, 오래된 메모리, 압축 손실, 모델 잘못된 라우팅, 행동적 낭비. 모든 절감은 캐시에 안전하고 측정됩니다. 대시보드는 매 세션 후 자동으로 갱신됩니다.

Devin은 로드맵의 다음 순서입니다.
제공되는 기능
매 세션 자동으로 실행되며, 사용자가 할 일은 없습니다:
- 🔄 스마트 압축(Smart Compaction): 자동 압축 전 체크포인트, 이후 복원
- 🗄️ 세션 연속성(Session Continuity): 세션 간 힌트, 콜드 리줌, 체크포인트 점수
- 📦 능동 압축(Active Compression): 9가지 기능, 모두 기본 켜짐 (델타 diff, 스켈레톤, bash/검색 압축, 간결 출력 넛지, 품질 넛지, 루프 감지, 활동 모드, 결정 추출)
- 📊 품질 점수(Quality Scoring): 7개 신호, 실시간, S~F 등급
- 🗃️ 세션 데이터베이스(Session Database): SQLite, 15개 테이블, 전체 감사 추적, 네트워크 없음
- 🔍 점진적 공개(Progressive Disclosure): 큰 출력은 보관되고, 요청 시 펼침
- 🧠 컨텍스트 인텔 요약(Context Intel Digest): 압축 후 재읽기 없는 재정위치
- 🔀 모델 라우팅 넛지(Model Routing Nudges): 작업에 맞는 티어로 안내
요청할 때:
- 🩺
/token-optimizer: 가이드된 수정과 함께 전체 감사 - 📈
/token-coach: 구체적 수정과 함께 30일 추세 분석 - ⚡
quick: 10초 건강 검사 - 🎯
route: 돈을 쓰기 전, 이 작업에 실제로 필요한 모델과 노력 - 🔧
doctor: 설치 검사 - 💰
savings: 달러 절감 보고서 - 📋
report: 컴포넌트별 토큰 분석 - 🌐
dashboard: 전체 대시보드 열기 - 📝
memory-review: MEMORY.md 구조 감사 - 📂
expand: 보관된 도구 결과 검색 - 🔙
resume-lean: 콜드 세션 다시 열기
설치하고 /token-optimizer를 한 번 실행하면, 나머지는 모두 자동으로 실행됩니다.
Claude 데스크톱 앱 안의 상태 표시줄
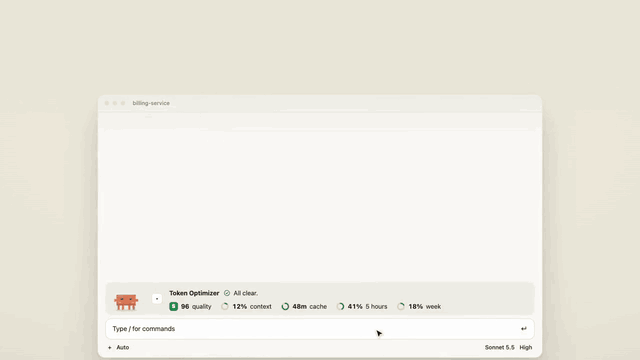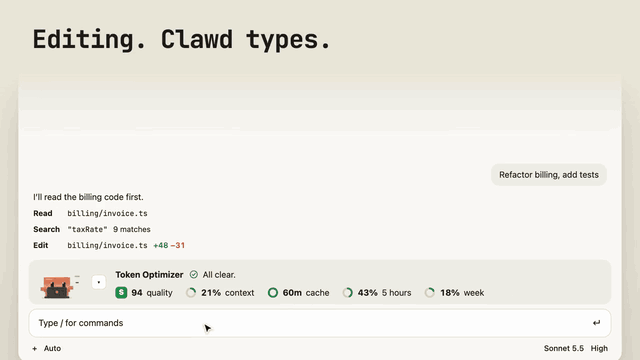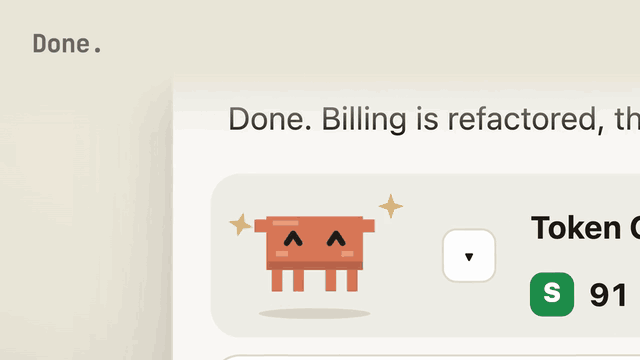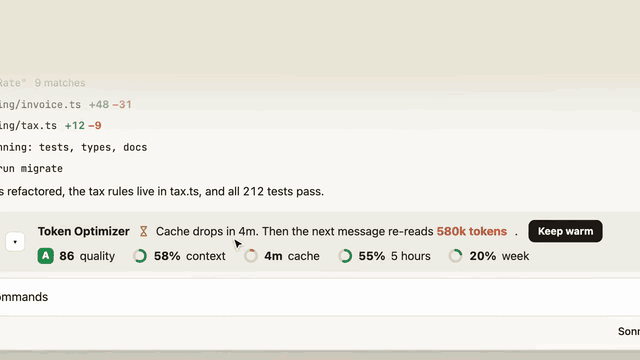
30초 미리보기. 소리와 함께 전체 영상 보기 (50초).
이제 Claude Code에서는 플러그인이 자체 인터페이스 요소를 추가할 수 있으며, 이를 모드(mod)라고 합니다. Token Optimizer는 모드를 사용해 프롬프트 바로 위에 세션 상태를 보여줍니다. 품질 등급, 컨텍스트가 얼마나 찼는지, 캐시가 얼마나 더 유지되는지, 두 가지 사용 한도가 표시됩니다. 지금 주의할 점을 한 문장으로 알려주고, 버튼 하나로 해결합니다. 작은 주황색 마스코트 Clawd가 세션이 하는 일을 그대로 보여주므로, Claude가 읽는 중인지, 편집 중인지, 승인을 기다리는지, 끝났는지 한눈에 알 수 있습니다.
플러그인에 포함되어 있어 따로 설치할 것이 없습니다. 자세히 보기.
설치
Claude Code (권장):
/plugin marketplace add alexgreensh/token-optimizer
/plugin install token-optimizer@alexgreensh-token-optimizer
그런 다음 Claude Code에서: /token-optimizer
설치 후 자동 업데이트를 활성화하세요. Claude Code는 서드파티 마켓플레이스를 기본적으로 자동 업데이트 꺼짐으로 배포합니다.
/plugin→ Marketplaces 탭 →alexgreensh-token-optimizer선택 → Enable auto-update. 일회성, 10초면 됩니다.설치 후,
/token-optimizer를 한 번 실행하여 훅을 설정하세요. 그 이후로는 모든 것이 자동으로 실행됩니다: 압축, 체크포인트, 품질 점수, 대시보드 갱신. 감사를 원하지 않는 한 어떤 명령도 다시 실행할 필요가 없습니다.
다른 플랫폼 및 설치 방법
Codex:
codex plugin marketplace add alexgreensh/token-optimizer
그런 다음 Codex TUI에서: /plugins로 Token Optimizer를 설치하세요. docs/codex.md를 참조하세요.
OpenCode: opencode.json의 plugin 배열에 token-optimizer-opencode를 추가하세요:
{ "$schema": "https://opencode.ai/config.json", "plugin": ["token-optimizer-opencode"] }
opencode/README.md를 참조하세요.
OpenClaw:
openclaw plugins install github:alexgreensh/token-optimizer
openclaw/README.md를 참조하세요.
Hermes:
git clone https://github.com/alexgreensh/token-optimizer.git
token-optimizer/install.sh --hermes
hermes/README.md를 참조하세요.
GitHub Copilot:
git clone --depth 1 https://github.com/alexgreensh/token-optimizer.git
cd token-optimizer
bash install.sh --copilot
docs/copilot.md를 참조하세요.
Cursor:
git clone --depth 1 https://github.com/alexgreensh/token-optimizer.git
cd token-optimizer
bash install.sh --cursor
docs/cursor.md를 참조하세요.
macOS/Linux 스크립트 설치 (플러그인의 대안):
tmp="$(mktemp -d)"
release_json="$(curl -fsSL https://api.github.com/repos/alexgreensh/token-optimizer/releases/latest)"
tag="$(python3 -c 'import json,sys; print(json.load(sys.stdin)["tag_name"])' <<<"$release_json")"
git clone --branch "$tag" --depth 1 https://github.com/alexgreensh/token-optimizer.git ~/.claude/token-optimizer
bash ~/.claude/token-optimizer/install.sh
rm -rf "$tmp"
Windows 사용자: 플러그인 설치만 사용하세요. Windows에서 install.sh를 실행하지 마세요. EBUSY 오류가 발생하면, 모든 Claude Code 및 Git Bash 창을 닫고, 남아있는 git.exe 프로세스를 종료하고, C:\Users\<you>\.claude\token-optimizer와 C:\Users\<you>\.claude\plugins\marketplaces\alexgreensh-token-optimizer를 삭제한 뒤 다시 시도하세요.
install.sh가 $'\r': command not found로 실패하는 경우 (LF 줄바꿈이 적용되기 전에 복제된 저장소가 스크립트를 CRLF로 변환한 경우), 캐리지 리턴을 한 번 제거하고 다시 실행하세요. 저장소는 이제 새 복제에서 이를 방지하는 .gitattributes를 함께 배포합니다:
sed -i 's/\r$//' ~/.claude/token-optimizer/install.sh
# 이미 저장소가 있다면? 줄바꿈을 제자리에서 재정규화하세요:
git -C ~/.claude/token-optimizer add --renormalize . && git -C ~/.claude/token-optimizer checkout -- .
제거
Token Optimizer는 추가적이고 되돌릴 수 있습니다. 모든 런타임은 우리가 설치한 것만 제거하는 깔끔한 제거 방법을 제공하며, 사용자의 훅, 설정, 세션 데이터는 그대로 둡니다. 런타임별 전체 단계는 **docs/uninstall.md**에 있습니다.
가장 빠른 방법 (Claude Code 플러그인 설치):
/plugin uninstall token-optimizer@alexgreensh-token-optimizer
차별성
대부분의 토큰 도구는 명령 출력을 압축합니다. 이는 컨텍스트의 15~25%를 다룹니다. 나머지 75%는 손대지 않습니다.
압축 적용 범위. Headroom, RTK, JFrog Boost는 bash와 명령 출력을 압축합니다. Token Optimizer는 출력 스택의 여덟 표면을 압축합니다. 상태: 🟢 지원됨, 🟡 부분적, 🔴 지원되지 않음.
| 압축 표면 | Token Optimizer | Headroom | RTK | Boost |
|---|---|---|---|---|
| Bash / 명령 출력 (git, 테스트, lint, 빌드, 로그) | 🟢 22개 패턴 패밀리에 걸쳐 111개 명령, 자격증명 안전; pytest 실행 시 564 → 115 토큰 | 🟢 SmartCrusher, CodeCompressor, Kompress-v2 | 🟢 100개 이상 필터 | 🟢 명령 인식 필터 |
| 검색 / grep 출력 | 🟢 상위 적중과 개수; 500줄 → 20 | 🔴 | 🔴 | — |
| 표 형식 / JSON 출력 (jq, yq, csvtool, mlr) | 🟢 값 보존 열 형식 | 🟢 SmartCrusher | 🔴 | — |
| 파일 재읽기, 델타 모드 | 🟢 diff만; 2,000토큰 재읽기 → ~50 | 🔴 | 🔴 | — |
| 파일 재읽기, 구조 맵 | 🟢 서명과 임포트의 스켈레톤; 720KB → 250 토큰 | 🔴 | 🔴 | — |
| 큰 도구 결과 (4K자 이상) | 🟢 디스크에 보관, 요청 시 펼침 가능 | 🔴 | 🔴 | — |
| 모델 출력 장황함 | 🟢 간결 출력 넛지, 캐시 안전 (절감은 추정됨, 측정 아님) | 🔴 | 🔴 | 🔴 |
| 구조적 컨텍스트 (설정, 스킬, MCP, 메모리) | 🟢 컴포넌트별 감사, 각 소스 점수 | 🔴 | 🔴 | 🔴 |
RTK와 Boost는 첫 번째 표면에 도달합니다. Headroom은 첫 번째와 세 번째에 도달합니다. Token Optimizer는 여덟 모두를 다루고, 압축 주변에서 일어나는 일로 계속 나아갍니다:
- 한 가지가 아닌 세 종류의 낭비. 구조적(부풀려진 설정, 사용하지 않는 스킬, 오래된 메모리), 런타임(장황한 출력, 재읽기), 행동적(모델 잘못된 라우팅, 캐시 만료, 재시도 루프). 각각 어떻게 작동하는지 →
- 절감은 압축을 넘겨살립니다. 자동 압축 전 체크포인트, 이후 복원. 이게 없으면 압축 절감은 압축이 발동하는 순간 사라집니다.
- 도움이 되었는지 측정합니다. 이전/이후 토큰 델타, 네 가지 가격 티어에 걸친 달러 절감, 저하를 추적하는 품질 점수. 단순히 "압축했다"가 아닙니다.
- 기준선 오버헤드 없음. 외부 프로세스, 컨텍스트에 항상 켜진 지시 없음, MCP 서버 없음, 의존성 없음, 텔레메트리 없음.

이 열 줄은 Token Optimizer가 행에서 유일한 🟢인 행들입니다: 압축 너머로 살아남는 것, 그리고 어떤 압축기도 찾지 않는 낭비. 압축 메커니즘, 비용과 안전성, 그리고 우리가 지는 두 행은 접힌 부분 뒤에 있습니다.
| Token Optimizer | Headroom | RTK | Boost | context-mode | /context |
|
|---|---|---|---|---|---|---|
| 압축 생존 | 🟢 점진적 체크포인트, 복원, 도구 출력 요약 | 🔴 | 🔴 | — | 🟡 세션 가이드만 | 🔴 |
| 세션 연속성 | 🟢 세션 간 힌트, 콜드 리줌, 체크포인트 점수 | 🔴 | 🔴 | — | 🟡 세션 가이드 | 🔴 |
| 구조적 낭비 감사 | 🟢 컴포넌트별 심층 (CLAUDE.md, 스킬, MCP, 메모리) | 🔴 | 🔴 | 🔴 | 🔴 | 🟡 요약만 |
| CLAUDE.md와 MEMORY.md 건강 | 🟢 8개 감사자 + 주의 곡선 점수 | 🔴 | 🔴 | 🔴 | 🔴 | 🔴 |
| 모델 라우팅 및 행동 코칭 | 🟢 12개 감지기, 서브에이전트 비용 분석, 안티 패턴 | 🔴 | 🔴 | — | 🔴 | 🟡 기본 제안 |
| 과거 추세 분석 | 🟢 30일 추세, 품질/비용/캐시/지속 시간 상관, 모델 전환 감지 | 🔴 | 🔴 | — | 🔴 | 🔴 |
| 컨텍스트 품질 점수 | 🟢 등급이 있는 7신호 품질 점수 | 🔴 | 🔴 | — | 🔴 | 🟡 용량 %만 |
| 루프와 회전 감지 | 🟢 토큰을 태우기 전에 행동 루프 포착 | 🔴 | 🔴 | — | 🔴 | 🔴 |
| 압축이 도움이 되었는지 측정 | 🟢 로컬 텔레메트리, 이전/이후 토큰, 달러 절감 | 🔴 | 🟡 rtk gain (토큰 개수만) |
🟡 boost report, 벤더 측 |
🔴 | 🔴 |
| 플릿 수준 교차 에이전트 분석 | 🟢 | 🔴 | 🔴 | — | 🔴 | 🔴 |
나머지 13행 보기 (압축 메커니즘; 비용, 안전성 및 도달; 튜닝, 증명 및 설치)
| Token Optimizer | Headroom | RTK | Boost | context-mode | /context |
|
|---|---|---|---|---|---|---|
| 명령 재작성 불필요 | 🟢 훅 연결, 자동 발동 | 🟢 투명 프록시 | 🟢 훅 기반 재작성 | 🟢 boost init이 지원 에이전트에 연결; 터미널 사용은 접두사 가능 |
🟡 훅 가능 플랫폼에서 자동 | N/A 네이티브 명령 |
| 전체 원본 복구 가능 | 🟢 압축 전 원본 보관, expand로 검색; 실패는 압축 안 됨 |
🟢 되돌릴 수 있는 검색 | 🟡 명령 실패 시 전체 출력 저장 | 🟢 벤더가 명령 출력 복구 문서화 | — | N/A 압축 안 함 |
| 커스텀 명령 필터 등록 | 🔴 내장 명령 집합; 사용자 필터 API 없음 | — | 🟢 커스텀 TOML 필터 | 🟢 TOML 필터 | — | N/A |
| 사용자 조정 가능한 설정 | 🟢 137개 코드 참조 TOKEN_OPTIMIZER_* 이름, 사용자 대면과 내부 제어로 명시적 분리; 추가적 허용 목록; .contextignore |
🟢 문서화된 설정 | 🟢 config.toml 및 환경 제어 |
🟢 필터 TOML | 🟢 문서화된 설정 | N/A |
| 캐시 안전 | 🟢 기존 컨텍스트 접두사 수정 안 함 | 🟡 프록시 모드가 진행 중 재작성 | 🟢 사전 셸만 | 🟢 사전 셸만 | 🟡 MCP 오버헤드 | 🟢 |
| 기준선 컨텍스트 오버헤드 없음 | 🟢 외부 프로세스, 컨텍스트 주입 없음 | 🔴 지시 주입 | 🟢 셸 수준만 | 🟢 셸 수준만 | 🔴 MCP 서버 오버헤드 | 🟢 네이티브 |
| 런타임 의존성 없음 | 🟢 순수 표준 라이브러리 (Python/TypeScript) | 🟡 Python + Rust + 선택적 모델 | 🟢 단일 Rust 바이너리 | 🟢 단일 바이너리 | 🟡 SQLite 어댑터 필요 | 🟢 N/A |
| 텔레메트리 없음 | 🟢 기계 밖으로 아무것도 나가지 않음 | 🟡 HEADROOM_TELEMETRY 옵트인, 기본 꺼짐 |
🟡 옵트인 | 🔴 호출된 명령, 명령 인자, 종료 코드, 지속 시간, CI 속성, IP 수집 | 🟡 다양함 | 🟢 |
| 멀티 플랫폼 | 🟢 Claude Code, VS Code, Codex, OpenClaw, OpenCode, Hermes, Copilot, Cursor | 🟢 Claude Code, Cursor, Codex, Aider, Copilot | 🟢 15개 통합 | 🟡 Cursor, Claude Code, Copilot, Codex CLI | 🟢 17개 통합 | 🔴 Claude Code만 |
| 작업별 모델 및 노력 조언 | 🟢 route가 돈 쓰기 전에 작업 크기 측정 |
— | — | — | — | — |
| 킵 웜(Keep-Warm) (캐시 TTL 갱신) | 🟢 캐시 만료 전 옵트인 핑, 트립와이어 자동 꺼짐 | 🔴 | 🔴 | — | 🔴 | 🔴 |
| 엔드투엔드 작업 결과 벤치마크 | 🔴 출력 토큰 A/B만 | — | — | 🟢 벤더가 동일한 통과율과 ~12% 낮은 비용으로 Terminal-Bench 2.0 보고 | — | N/A |
| 서명 및 체크섬 검증 설치 | 🟢 릴리스마다 CHECKSUMS.sha256, 설치 시 검증, CI 강제 |
— | — | 🔴 설치 관리자가 체크섬이나 서명 모두 검증 안 함 | — | N/A |

대시보드
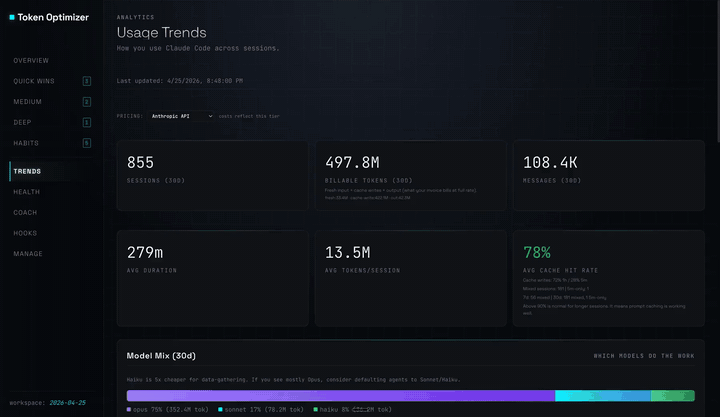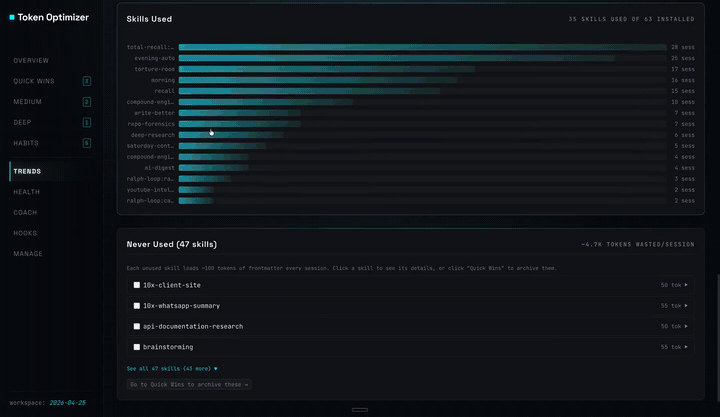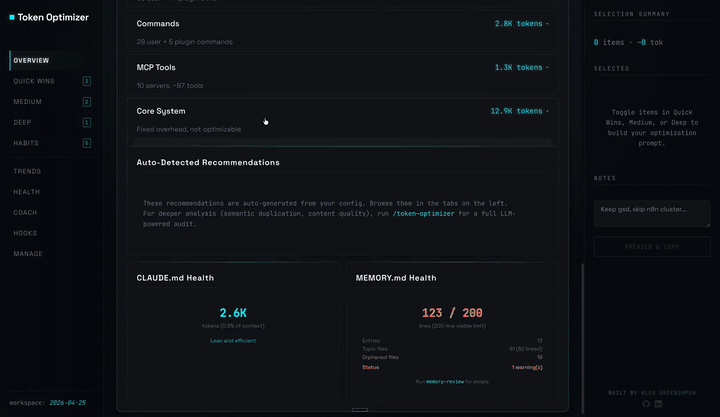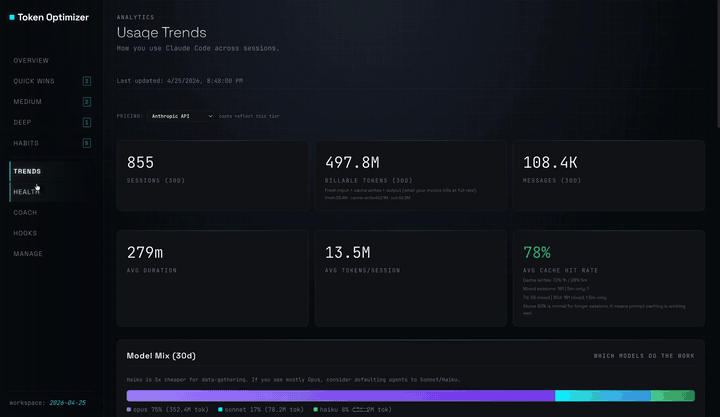
하나의 HTML 페이지, SessionEnd 훅을 통해 매 세션 후 자동 재생, 수동 트리거 불필요. 북마크 가능한 URL http://localhost:24842/token-optimizer는 옵트인입니다: 로컬 서버를 시작하려면 python3 skills/token-optimizer/scripts/measure.py setup-daemon을 실행한 후에만 작동합니다. 그 전에는 measure.py dashboard가 Dashboard: 줄에 출력하는 파일 경로를 여세요.
턴별 토큰 분석, 네 가지 가격 티어에 걸친 비용, TTL 믹스와 적중률이 있는 캐시 분석, 모든 세션에 겹쳐진 품질 점수, 서브에이전트 비용 분석, 측정됨과 추정을 분리해 유지하는 절감 추적기. 설치 후 설정 불필요. 전체 대시보드 문서 →
절감 내역
2026-11-01 기준 30일 스냅샷의 API 요금 환산 합계는 약 $597.72입니다. 가격을 산정할 수 있는 항목의 소계입니다. 각 구성 요소의 근거를 구분합니다.
- 기록된 동작: $78.59. 4,945개 이벤트의 측정된 토큰 변화를 API 요금으로 환산했습니다.
- 모델 라우팅: $422.88. 도입 전 고정 모델 구성과 고정 참조 모델 요금표를 사용하는 추정 비교입니다.
- 회피한 반복 읽기: $60.69. 관측된 턴부터 다음 실제 컴팩션까지 모델링하고, 확인된 턴별 요금으로 환산했습니다.
- 기타 추정: $35.56. 값이 0인 항목을 포함한 8개 추정 범주를 방법론에 모두 표시합니다.
가격 산정 범위는 불완전합니다. 가격을 알 수 없는 반복 읽기의 절감분과 차감분은 제외되어 전체 순금액은 알 수 없습니다. 네 가지 구성 요소의 합은 합계와 정확히 일치합니다.
같은 스냅샷의 토큰 카드는 24,797,356 토큰 절감을 표시합니다. 측정 9,831,072 + 추정 14,966,284이며, 사용 286,218,848 + 절감 24,797,356 = 311,016,204의 **약 8%**입니다. 기록된 토큰과 MCP 상한, 힌트 기반 읽기, 출력 간결화, 간결한 재개의 추정치가 포함됩니다(스냅샷은 v5.13.63 규칙 기준입니다. 체크포인트 복원은 이후 추정 등급으로 이동했습니다). 모델링한 반복 읽기와 라우팅은 이 토큰 합계에 포함되지 않으며, 달러 소계의 범위가 더 넓습니다.

주 작업 세션 1,644개와 위임 세션 3개를 기준으로 합니다. 대시보드는 각자의 기록으로 계산하므로 결과는 달라집니다. 방법론 →

능동 압축
컨텍스트를 능동적으로 줄이는 9가지 기능, 모두 기본 켜짐, 모두 자동, 모두 대시보드나 CLI에서 토글 가능.
내부적으로, PreToolUse 훅이 모든 Read와 Bash 호출이 컨텍스트에 들어가기 전에 가로챕니다. 파일이 이미 읽혔다면, diff만 돌아옵니다. 코드 파일 재읽기라면, 구조적 스켈레톤이 전체 내용을 대체합니다. CLI 명령이라면, 출력이 압축됩니다. PostToolUse 훅은 전체 원본을 디스크에 보관하고 압축 이벤트를 SQLite에 기록합니다. 아무것도 손실되지 않으며, 모든 것이 검색 가능합니다. 사용자가 할 일은 없습니다. 훅이 전부 처리합니다.

| 기능 | 하는 일 | 절감 |
|---|---|---|
| 델타 모드 | 재읽기는 변경된 부분만 반환 | 재읽기 시 ~20% |
| 구조 맵 | 변경 없는 파일 재읽기는 구조적 스켈레톤 반환 | ~30% (파일당 최대 99%) |
| Bash 압축 | CLI 출력을 필수로 요약 | ~10% |
| 검색 압축 | grep/웹 결과를 상위 적중 + 개수로 요약 | ~15% |
| 간결 출력 넛지 | 컨텍스트가 찰 때 모델을 간결 출력으로 안내 | 추정 10-15%; 반사실적 측정 아님 |
| 품질 넛지 | 컨텍스트 품질이 떨어질 때 경고 | 압축 손실 방지 |
| 루프 감지 | 토큰을 태우기 전에 재시도 루프 포착 | 루프별 측정 |
| 활동 모드 | 세션 단계에 맞춰 압축 조정 | 결정 손실 방지 |
| 결정 추출 | 압축 간 결정 보존 | 결정 드리프트 방지 |
대시보드 Manage 탭, CLI(measure.py v5 enable|disable <feature>), 또는 환경 변수에서 토글. v5 동사는 현재 기능을 제어하는 레거시 명령 이름입니다.
기능별 세부 정보
델타 모드
AI가 편집 후 파일을 재읽기하면, Read 호출은 diff만 반환합니다. 실제 세션의 65% 이상 Read 호출이 재읽기입니다. 2,000토큰 파일 재읽기가 50토큰 diff가 됩니다.

비활성화: TOKEN_OPTIMIZER_READ_CACHE_DELTA=0
구조 맵
Claude가 이미 본 코드 파일을 재읽기하면, Read 호출이 차단되고 구조적 요약으로 대체됩니다: 함수 서명, 클래스 계층, 임포트. 720KB Python 파일(180,000 토큰)이 250토큰 스켈레톤이 됩니다.
비활성화: TOKEN_OPTIMIZER_READ_CACHE_MODE=shadow
첫 읽기 스켈레톤
히스토리 검증 코호트에서 큰 코드 파일(Python 또는 TypeScript, 16KB~256KB)의 첫 읽기 시, Read는 전체 파일 대신 구조적 스켈레톤(서명/임포트)을 반환하며, 한 줄 알림과 함께 전체 내용은 항상 한 단계 거리에 있습니다: expand <key>, 범위 Read(offset/limit), 또는 직접 Edit. 원본은 어떤 대체 전에 보관되며, 실패 시 열림(fail-open)합니다. 보관이 불가능하면 전체 파일이 제공됩니다.
이는 코드에만 적용됩니다. Markdown과 다른 산문은 첫 읽기에 스켈레톤화되지 않습니다 (v5.11.27 기준): 제목 전용 개요는 핵심 산문을 떨어뜨리므로, 문서는 항상 완전히 돌아옵니다. 런타임 트립와이어는 라이브 편집률이 오르면 코드 코호트를 측정 전용으로 자동 강등합니다.
제공 비활성화(측정 유지): TOKEN_OPTIMIZER_FIRST_READ_ACTIVE=0. 완전 비활성화: TOKEN_OPTIMIZER_FIRST_READ_SHADOW=0. 둘 다 measure.py v5 status와 대시보드 Manage 탭에서 보이고 토글 가능합니다.
Bash 출력 압축
일반 CLI 명령을 재작성하여 압축된 요약을 반환합니다. lint, 로그 꼬리, tree, docker pull, 긴 목록, 빌드 출력, 테스트 러너를 다룹니다. 564토큰 pytest 출력이 115 토큰이 됩니다.

비활성화: TOKEN_OPTIMIZER_BASH_COMPRESS=0
검색 결과 압축
AI가 grep, rg, 또는 긴 결과 목록을 반환하는 웹 검색을 실행하면, 출력이 상위 적중과 개수로 요약됩니다. 500줄 grep 결과가 20줄과 요약이 됩니다.
비활성화: TOKEN_OPTIMIZER_BASH_COMPRESS=0 (검색 압축은 bash 압축의 일부입니다; 별도 스위치가 없습니다)
간결 출력 넛지
컨텍스트가 25%를 넘어 차면, 짧은 넛지가 모델에게 깊이 추론하되 보이는 출력은 간결하게 유지하라고 알립니다. 채움량이 유일한 조건입니다. 품질은 더 이상 이를 제어하지 않으므로, 보통의 건강한 세션도 넛지를 받습니다, 길게 저하된 세션만이 아닙니다. 절감은 10-15%로 추정되며, 측정되지 않습니다: 반사실적(넛지 없이 모델이 썼을 내용)은 관찰할 수 없으므로, Token Optimizer는 이를 추정 티어에 보고하고 측정된 절감에 절대 포함하지 않습니다. 캐시 안전: additionalContext로 주입, 기존 접두사 수정 안 함.
오늘날 켜기/끄기 스위치 없음(v5 기능 아님). TOKEN_OPTIMIZER_VERBOSITY_MIN_FILL(기본 25)로 트리거 지점을 조정하세요.
품질 넛지
컨텍스트 품질을 실시간으로 감시합니다. 점수가 15점 이상 떨어지거나 60 아래로 내려가면, 인라인 메모가 컨텍스트에 들어갑니다. Claude는 다음 턴에 이를 보고 경고를 표면화하거나 행동을 조정합니다. 5분 쿨다운, 세션당 최대 3회.
비활성화: TOKEN_OPTIMIZER_QUALITY_NUDGES=0
루프 감지
AI가 재시도 루프에 갇히는 것을 포착합니다. 마지막 4개 사용자 메시지와 마지막 5개 도구 결과를 유사성으로 비교합니다. 신뢰도 ≥0.7에서 발동, 세션당 2개 메모 상한. 실제 루프 턴 내용에서 측정된 절감.
비활성화: TOKEN_OPTIMIZER_LOOP_DETECTION=0
활동 모드 감지
마지막 10개 도구 호출을 사용하여 세션을 5가지 모드(코드, 디버그, 리뷰, 인프라, 일반) 중 하나로 분류합니다. 이 모드는 압축 지침에 들어가 PRESERVE/DROP 우선순위가 당신이 하는 일에 적응하게 합니다.
결정 추출
도구 출력에서 결정 문을 실시간으로 감지하여 세션 데이터베이스에 저장합니다. 압축 시, 이 결정들은 압축 요약이 축어로 보존해야 하는 CRITICAL DECISIONS로 주입됩니다. 세션당 10개 상한.
실제 절감 측정
모든 압축 기능은 로컬 SQLite 테이블에 기록됩니다. 기계 밖으로 아무것도 나가지 않습니다.
python3 measure.py compression-stats --days 30
세션 데이터베이스
Token Optimizer가 하는 모든 것은 두 개의 로컬 SQLite 데이터베이스로 뒷받침됩니다. 기계 밖으로 아무것도 나가지 않습니다. 네트워크 호출 없음.

세션별 DB(~/.claude/token-optimizer/snapshots/session-store/<session>.db)는 파일 읽기, 도구 출력, 명령 출력, 캐시된 내용, 컨텍스트 인텔 이벤트, 활동 로그, 결정 로그, 힌트 제공을 추적하는 8개 테이블을 가집니다. 훅 프로세스에서 동시 읽기/쓰기를 위한 WAL 모드. 세션당 50MB 상한.
추세 DB(~/.claude/token-optimizer/snapshots/trends.db)는 세션 히스토리, 일일 집계, 스킬/모델/서브에이전트 사용, 절감 이벤트, 압축 이벤트를 추적하는 7개 테이블을 가집니다. O(log n) 조인을 위해 세션 UUID로 인덱스. 이것이 대시보드, 코치 모드, 30일 추세 분석을 구동합니다.
모든 압축 이벤트, 모든 절감, 모든 품질 측정은 쿼리 가능한 행입니다. 대시보드는 이 데이터의 읽기 전용 뷰입니다. measure.py compression-stats는 SQL 쿼리입니다. 당신의 데이터는 당신의 것입니다.
점진적 공개
큰 도구 결과(>4KB)는 디스크에 보관되고 짧은 미리 보기와 검색 포인터로 대체됩니다. 전체 출력은 압축을 넘겨살립니다. 모델이 필요할 때, 명령 재실행이나 손실된 출력 없이 expand로 원본을 가져옵니다.
이는 단순한 저장이 아닙니다. 시스템은 보관된 결과와 재펼쳐진 결과의 수를 추적하여, 접힌 채로 남은 순 토큰을 볼 수 있습니다. 재펼치기는 절감 총계에서 차감되므로, 실제로 접힌 채로 남은 것만 계산합니다.
python3 measure.py expand --list          # 보관된 도구 결과 목록
python3 measure.py expand <tool-use-id>   # 특정 결과 검색
일부 MCP 도구는 메타데이터 미리 보기가 요점을 무너뜨리는, 큰 축어 페이로드를 반환하도록 문서화되어 있습니다(소스 페처, 문서 검색기). 그 결과가 대체되지 않고 컨텍스트에 도달하도록 허용 목록에 추가하세요(여전히 보관되므로 expand가 작동합니다). 전체 도구 이름에 대해 일치하는 fnmatch 글롭의 쉼표로 구분된 목록을 설정하세요:
TOKEN_OPTIMIZER_ARCHIVE_EXEMPT_TOOLS="mcp__context7__*,*github_repository_file"
기본은 비어 있습니다. 도구를 옵트인하지 않는 한 아무것도 면제되지 않습니다.
세션 연속성
압축도 중요하지만, Token Optimizer가 하는 가장 중요한 일은 세션과 압축 사이에서 작업을 자동으로 살려두는 것입니다.
세션을 끝낼 때, Token Optimizer는 상태를 SQLite에 체크포인트합니다: 활성 작업, 핵심 결정, 수정된 파일, git 브랜치, 최근 읽기. 새 세션을 시작할 때, 프롬프트에 대해 모든 최근 체크포인트를 점수하고 가장 관련 있는 것을 힌트로 표면화합니다. 제로가 아닌 컨텍스트로 재개합니다.
자동으로 일어나는 일:
- 세션 간 힌트: 관련성 점수가 매겨진 체크포인트가 새 세션 시작 시 표면화. 힌트는 이전 세션의 작업, 결정, 파일, 브랜치를 포함. 모두 RECOVERED DATA로 울타리 침, 지시가 아님.
- 콜드 리줌 간결: 전체 전사 비용 없이 오래된 세션 다시 열기. Token Optimizer는 체크포인트에서 간결한 컨텍스트를 재구성. LLM 호출 없음, 전체 전사 콜드 리줌 없음. SQLite에서 토큰 없는 재구성.
- 힌트 팔로우 추정: 연속성 힌트가 파일 경로를 표면화하고 모델이 이후에 그 중 하나를 읽으면, Token Optimizer는 회피된 탐색적 검색을 추정. 힌트→읽기 쌍은 관측되지만, 회피된 검색 규모는 고정 추정치로 추정 등급에 보고되며 측정 합계에는 포함되지 않습니다.
python3 measure.py resume-lean                    # 다시 열 수 있는 콜드 세션 목록
python3 measure.py resume-lean <#|session_id> --print  # 간결 컨텍스트 블록 출력
압축 절감은 세션이 압축을 넘겨살릴 때만 유지됩니다. 세션 연속성이 그것을 가능하게 합니다.
스마트 압축
자동 압축이 발동하면, 대화의 60~70%가 사라집니다. 결정, 오류 수정 시퀀스, 에이전트 상태, 전부 사라집니다.
Token Optimizer는 압축 전에 세션을 체크포인트하고, 훅을 통해 요약이 떨어뜨린 것을 자동으로 복원합니다. 또한 컨텍스트 인텔 요약을 주입합니다: 모델이 이미 처리한 큰 도구 출력의 휴리스틱 요약(접근한 파일 경로, 본 오류, 줄 수). 압축 후, 모델은 모든 것을 재읽기 없이 자신이 본 것을 압니다.
활동 모드 감지는 마지막 10개 도구 호출을 사용하여 세션을 실시간으로 분류합니다(코드, 디버그, 리뷰, 인프라, 일반). 이 모드는 압축 지침에 들어가 PRESERVE/DROP 우선순위가 일반적 휴리스틱이 아닌 지금 당신이 하는 일에 적응하게 합니다.
결정 추출은 결정 문을 도구 출력에서 일어나는 대로 감지하여 세션 DB에 저장합니다. 압축 시, 이들은 요약이 축어로 보존해야 하는 CRITICAL DECISIONS로 주입됩니다. 세션당 10개 상한.
압축 절감은 세션이 압축을 넘겨살릴 때만 유지됩니다. git status에서 토큰을 절약하는 것은 다음 자동 압축이 그것을 실행하게 한 결정을 지워버리면 도움이 되지 않습니다.

스마트 압축 작동 방식
점진적 체크포인트
여러 임계값에서 세션 상태를 포착: 20%, 35%, 50%, 65%, 80% 컨텍스트 채움, 품질 80, 70, 50, 40 아래로 떨어질 때. 에이전트 팬아웃 전과 큰 편집 배치 후에도 스냅샷. 복원 시, 가장 풍부한 자격 체크포인트 선택.
컨텍스트 인텔 요약
압축 후, Token Optimizer는 세션의 가장 큰 도구 출력의 요약을 주입: 접근한 파일 경로, 감지된 오류, 줄 수. <30ms에 휴리스틱하게 생성, LLM 호출 없음. 모델이 모든 것을 재읽기 없이 재정위치.
python3 measure.py setup-smart-compact # 체크포인트 + 복원 훅
출력 토큰: 간결 vs 장황
출력 토큰은 세션에서 가장 비싼 부분입니다. Opus에서 입력 토큰보다 5배 비싸고, 캐시 읽기가 아닌 생성당 청구됩니다. 간단한 질문에 대한 장황한 응답은 결코 쓸 필요 없었던 달러를 태웁니다.
Token Optimizer는 간결 출력 넛지로 이를 자동으로 처리합니다. 컨텍스트가 25%를 넘어 차면, 짧은 넛지가 모델에게 깊이 추론하되 보이는 출력은 간결하게 유지하라고 알립니다. 채움량이 유일한 트리거입니다; 컨텍스트 품질은 조건이 아닙니다. 감소는 10-15%로 추정되며 반사실적으로 측정되지 않으므로, 측정된 절감과 분리되어 추정 티어에 보고됩니다.
작동 방식:
- 넛지는
additionalContext로 주입, 기존 접두사 수정 안 함, 그래서 캐시가 온전히 유지 - 컨텍스트가 차오를 때만 발동, 여유가 많을 때가 아님
- 모델은 여전히 문제를 생각; 더 간결한 보이는 답만 생성
- 오늘날 켜기/끄기 스위치 없음;
TOKEN_OPTIMIZER_VERBOSITY_MIN_FILL(기본25)로 트리거 지점 조정
이는 9개 능동 압축 기능 중 하나이며, 토큰이 가장 비싼 출력 측에서 절감하는 기능입니다.
품질 점수
품질 점수는 두 가지를 추적합니다: 자원 건강(저하 절벽에 얼마나 가까운지)과 세션 효율(토큰이 유용한 일을 하고 있는지). S에서 F까지의 등급이 분류를 즉시 만듭니다.
컨텍스트가 차오르면, 품질이 떨어집니다. MRCR이 256K와 1M 컨텍스트 사이에서 93%에서 76%로 떨어집니다. 창이 차오르면 AI가 측정 가능하게 둔해집니다. 품질 점수는 그것이 언제 일어나는지 정확히 보여줍니다.

상태 표시줄은 품질이 저하됨에 따라 색이 바뀝니다: 녹색, 노랑, 주황, 빨강. 품질이 75 아래로 떨어지면, 세션 지속 시간이 경고로 나타납니다. 실행 중인 서브에이전트는 모델과 경과 시간과 함께 표시.

python3 measure.py setup-quality-bar # 일회성 설치
품질 점수 세부 정보
| 점수 | 신호 | 의미 |
|---|---|---|
| 자원 건강 | 컨텍스트 채움, 압축 깊이, 절대 낭비 토큰 | 저하 절벽에 얼마나 가까운지 |
| 세션 효율 | 오래된 읽기, 부풀려진 결과, 결정 밀도, 에이전트 효율 | 세션이 지금 토큰을 잘 쓰고 있는지 |
| 등급 | 범위 | 의미 |
|---|---|---|
| S | 90-100 | 최고 효율 |
| A | 80-89 | 건강, 소폭 최적화 가능 |
| B | 70-79 | 저하 시작 |
| C | 55-69 | 상당한 낭비 |
| D | 40-54 | 심각한 문제 |
| F | 0-39 | 컨텍스트가 부패 중, 즉시 조치 필요 |
품질 표시줄이 사라졌나요? Claude Code의 /statusline 실행이 Token Optimizer의 항목을 덮어씁니다. SessionStart가 자동 복원. 새 세션을 시작하면 돌아옵니다.
영구히 끄고 싶나요?
python3 measure.py setup-quality-bar --uninstall
코치 모드
> /token-coach
목표를 말하세요. 정확한 토큰 절감과 함께 구체적이고 우선순위가 매겨진 수정을 받으세요. 30일의 세션 데이터를 읽고 단일 세션이 보여줄 수 없는 것을 표면화합니다: 품질이 내려가는 것, 세션이 길어지는 것, 캐시 적중률이 떨어지는 것, 세션당 비용이 오르는 것.
모든 인사이트는 실제 숫자에 근거합니다. "짧은 세션이 68점, 긴 세션이 60점"은 "더 짧은 세션을 고려하세요"와는 다르게 와닿습니다. 코치 모드는 또한 프로젝트 수준 최적화 기회(결코 사용하지 않는 스킬, 열심히 로드하는 MCP 서버, 캐시를 깨는 CLAUDE.md 패턴)를 식별하고 미래 세션이 더 간결하게 시작하도록 고치는 방법을 가르칩니다.
코치 모드 세부 정보
감지된 과거 패턴
| 패턴 | 감지하는 것 |
|---|---|
| 품질 드리프트 | 주 단위로 떨어지는 평균 품질 |
| 세션 지속 크리프 | 세션이 길어지고, 컨텍스트가 더 빨리 참 |
| 캐시 저하 | 캐시 적중률 하락 (및 모델 전환이 원인인지) |
| 등급 분포 | D 등급 세션이 너무 많이 쌓임 |
| 비용 인식 | 세션당 비용 상승, 라우팅 조언과 함께 |
| 지속-품질 상관 | 짧은 세션이 더 높은 점수, 긴 세션을 쪼개라는 제안 |
| 압축 갭 | 섀도 전용 절감이 능동 압축을 크게 초과 |
| 모델 전환 | 빈번한 세션 중 모델 전환이 프롬프트 캐시 무효화 |
낭비 감지기
11개 자동 감지기가 세션 패턴을 분석:
| 감지기 | 잡는 것 |
|---|---|
| PDF/바이너리 섭취 | 컨텍스트를 소비하는 큰 파일 |
| 웹 검색 오버헤드 | 컨텍스트에 너무 많은 웹 결과 덤핑 |
| 재시도 처닝 | 오류와 함께 같은 도구 3회 이상 재시도 |
| 도구 캐스케이드 | 3회 이상 연속 도구 오류 |
| 루핑 | 반복된 유사 메시지 |
| 과잉 모델 | 간단한 편집에 Opus 사용 |
| 약한 모델 | 복잡한 작업에 Haiku |
| 잘못된 분해 | 단일 500자 이상 프롬프트 |
| 낭비적 사고 | 작은 편집에 출력의 2배 이상 확장 사고 |
| 출력 낭비 | 간단한 작업에 장황한 응답 |
| 캐시 불안정 | 프롬프트 캐시를 깨는 CLAUDE.md 패턴 |
킵 웜(Keep-Warm)
API 청구 세션을 위한 옵트인 기능. 프롬프트 캐시 항목이 만료되기 직전에 작은 캐시 읽기 핑을 발행하여 TTL을 갱신. 재개 시 지불할 1.25-2배 재작성 대비 접두사의 ~0.1배 비용. 핑이 비용을 스스로 지불하지 못하면 트립와이어 자동 꺼짐.
python3 measure.py keepwarm-enable          # 옵트인 (API 청구만)
python3 measure.py keepwarm-report            # 순 절감, 지출, 트립와이어 상태
python3 measure.py keepwarm-disable           # 언제든 옵트아웃
플릿 감사자
Claude Code, Codex, 커스텀 전사 설정을 스캔하여 유휴 소모, 모델 잘못된 라우팅, 설정 부풀림을 발견하고 발견별 달러 절감을 보여줍니다.
CLAUDE.md 라우팅 주입
실제 사용 데이터에서 모델 라우팅 지시를 생성하여 CLAUDE.md에 주입. 48시간 부실 가드가 부실한 조언을 자동 제거.
python3 measure.py inject-routing --dry-run   # 미리 보기
python3 measure.py inject-routing              # 주입
FAQ
🔒 컨텍스트 품질을 저하시킬 수 있나요?
아니요. 구조적 최적화는 진정으로 사용하지 않는 컴포넌트만 제거합니다. 능동 압축 제어는 단일 명령이나 환경 변수로 비활성화할 수 있습니다. 품질 점수 시스템이 저하를 실시간으로 추적합니다.
💾 프롬프트 캐시를 깨나요?
아니요. Token Optimizer는 컨텍스트에 이미 있는 내용을 결코 건드리지 않습니다. 창에 들어오는 새 내용과 압축 경계에서 작동합니다. 캐시 접두사가 온전히 유지되어, 두 번 절약합니다: 턴당 더 적은 입력, 그리고 이후 매 턴 더 저렴한 캐시 읽기.
📡 어디론가 데이터를 보내나요?
분석 없음, 텔레메트리 엔드포인트 없음, 제품 데이터가 기계 밖으로 나가지 않음. 측정 이벤트는 사용자가 소유한 로컬 SQLite 행. 네트워크 호출 없음.
⚠️ 세션을 해칠 수 있나요?
아니요. 모든 훅은 실패 시 열림(fail-open) 설계로 비차단입니다. Token Optimizer 스크립트가 오류나면, 명령이 정상적으로 실행됩니다.
📦 런타임 의존성이 있나요?
아니요. Claude Code와 Codex에서 순수 Python 표준 라이브러리. OpenCode와 OpenClaw에서 런타임 의존성 없는 TypeScript.
🔐 install.sh는 파일 무결성을 어떻게 검증하나요?
최신 GitHub Release 태그를 해결하고, 그 태그를 체크아웃하고, 같은 릴리스에서 CHECKSUMS.sha256을 가져와, 모든 스크립트 파일을 검증합니다. 대역 외 검증은 손상된 커밋이 코드와 체크섬을 동시에 바꿀 수 없음을 의미합니다.
모든 명령
모든 명령 보기
| 명령 | 하는 일 | 문서 |
|---|---|---|
/token-optimizer |
6개 병렬 에이전트로 전체 감사, 가이드된 수정 | → |
/token-coach |
30일 추세 분석, 우선순위 수정 | → |
quick |
10초 건강 검사 | → |
doctor |
설치 검사, 10점 만점 점수 | → |
dashboard |
HTML 대시보드 열기 | → |
savings |
달러 절감 보고서 | → |
report |
컴포넌트별 토큰 분석 | → |
quality |
라이브 세션의 컨텍스트 품질 분석 | → |
trends |
스킬 채택, 모델 믹스, 시간에 따른 오버헤드 | → |
compression-stats |
능동 압축의 측정된 절감 | → |
memory-review |
MEMORY.md 구조 감사 | → |
git-context |
현재 diff에 대한 파일 제안 | → |
drift |
마지막 스냅샷과 나란히 비교 | → |
conversation |
메시지별 토큰과 비용 분석 | → |
pricing-tier |
가격 티어 보기 또는 전환 | → |
expand |
보관된 도구 결과 검색 (점진적 공개) | → |
resume-lean |
토큰 없는 재구성으로 콜드 세션 다시 열기 | → |
라이선스
PolyForm Noncommercial 1.0.0, 그리고 서면으로 된 소규모 사업자 허가. 소스 공개.
개인 / 취미 / 연구 / 교육?
하세요. 전체 소스, 로컬 실행, 라이선스 구매 불필요. 개인 오픈소스 사이드 프로젝트도 포함됩니다. 기준은 어디서 실행하느냐가 아니라 누구를 위한 작업이냐입니다. 회사를 위한 작업은 집에서 하더라도 회사의 사용입니다.
소규모 사업자 (5인 미만 그리고 월 매출 $20k 미만)?
무료 상업 라이선스를 서면으로 제공합니다: LICENSE-SMALL-BUSINESS.md. 두 조건 모두 팀이나 사용자 수가 아니라 회사 전체(모회사·계열사 포함)에 적용됩니다. 큰 회사 안의 소규모 팀은 상업 라이선스가 필요합니다.
개인으로 시작했는데, 이제 비즈니스로 변하고 있나요?
과거 사용은 완전히 괜찮습니다. 조건을 벗어난 뒤 32일의 유예 기간 동안 상업 라이선스를 준비하면 됩니다.
더 큰 회사 / 상업적 사용?
Alex Greenshpun 또는 [email protected]에 연락하세요. 조건은 합리적이며 회사 규모에 맞춰 정해집니다.
Alex Greenshpun이 제작.