Changroro/llmux
Changroro/llmux has 26 GitHub stars and 3 forks. GitHot measured 0 stars in 24 hours. Last checked 2026-11-14 09:15 UTC. Last push 2026-09-30.
What you can do
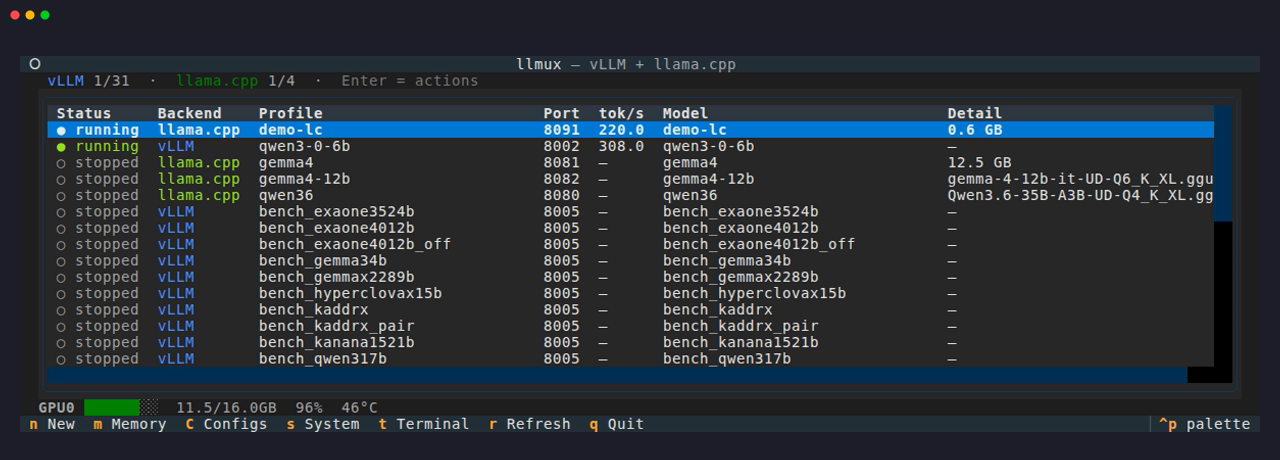
- One dashboard for both engines — Every vLLM and llama.cpp profile side-by-side in a single Textual TUI, with a live tok/s column per running model.
- Build a profile once, spin it up and down — Keep every model you're experimenting with as a named profile in one profiles.yaml. No re-writing config each time — pick one, hit Enter, and it launches the right engine; stop it and start another just as fast.
- Pin any engine image per profile — Run a versioned vLLM release, nightly, the rolling llama.cpp CUDA image, or an image you built from source — pinned per profile via image_tag. llmux refuses the ambiguous :latest; versioned vLLM images are also verified inside the running container.
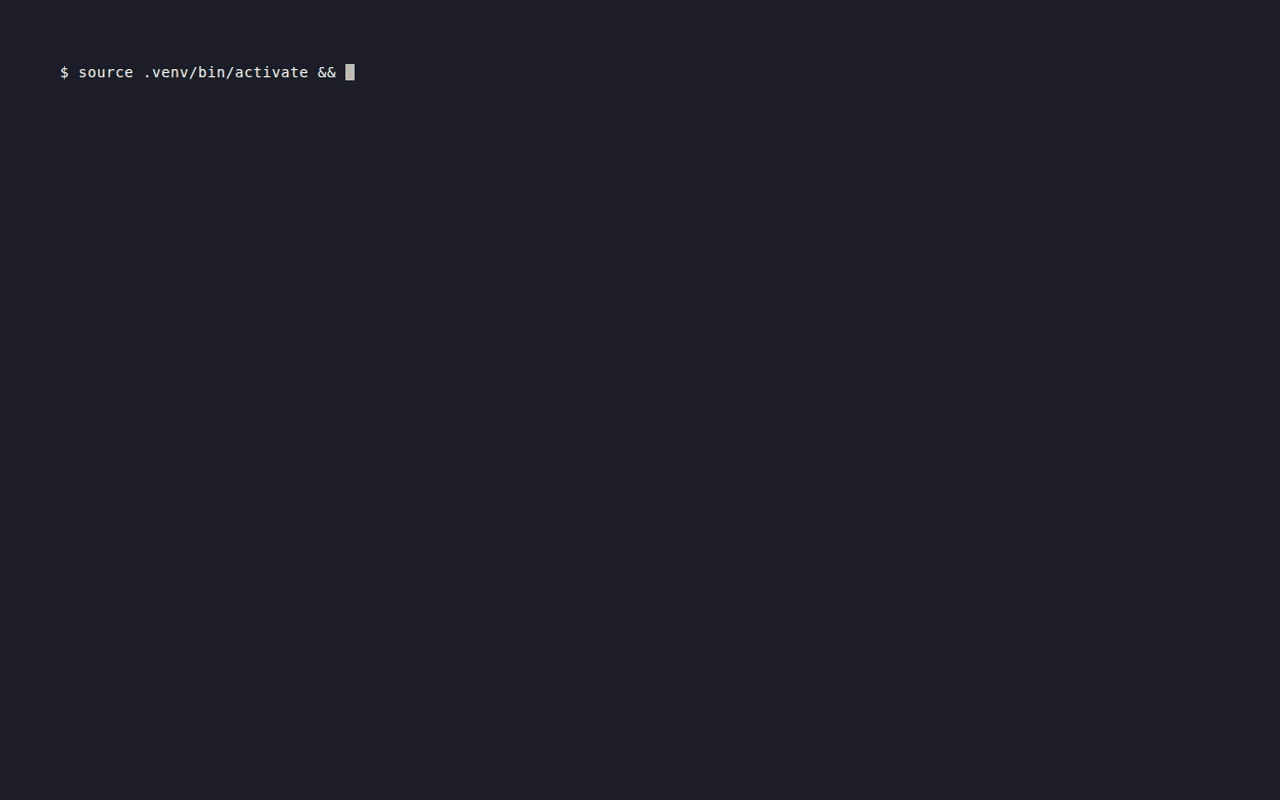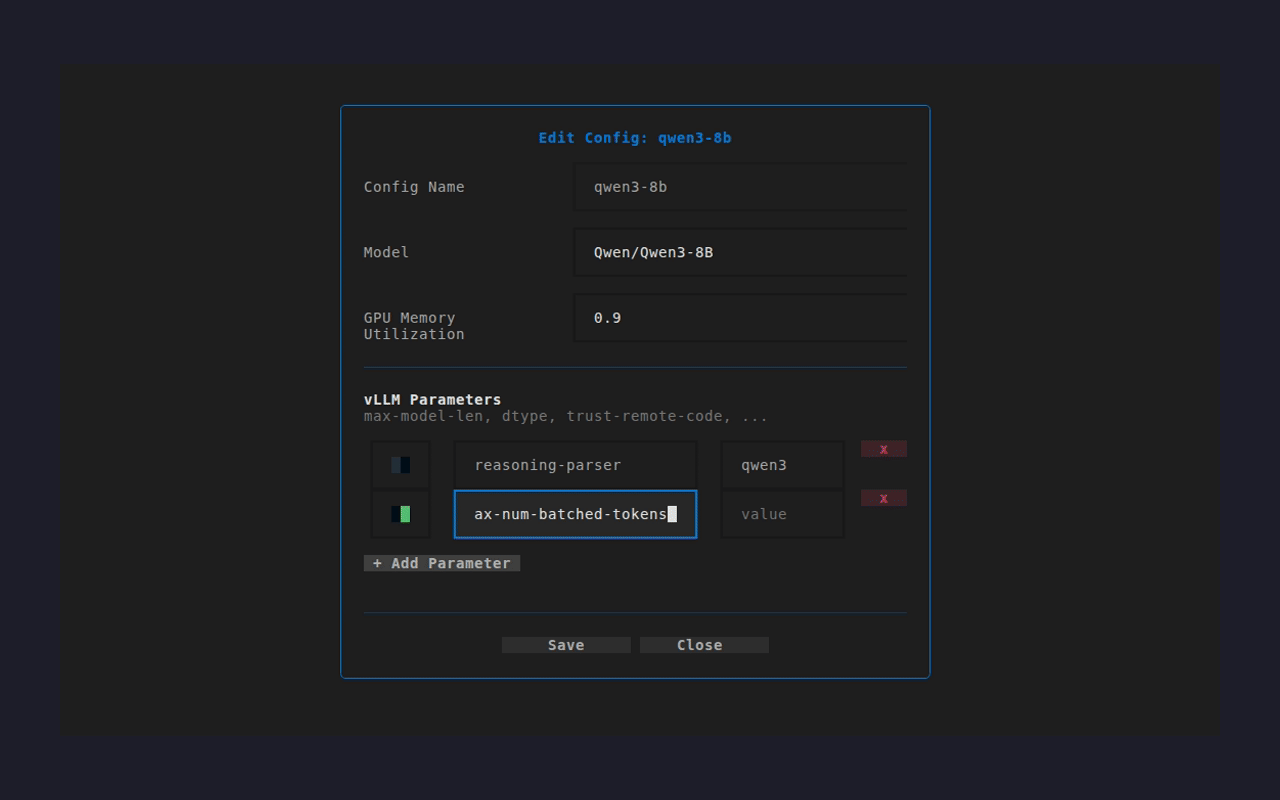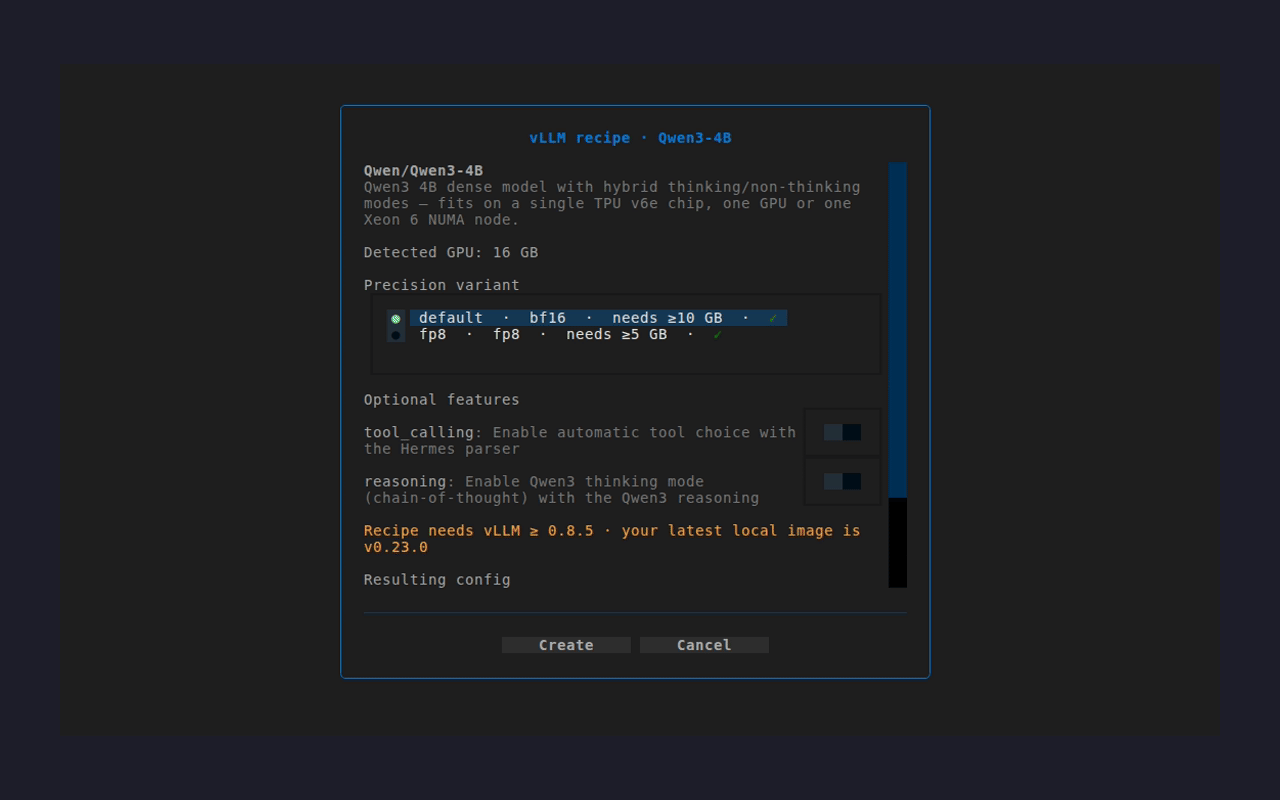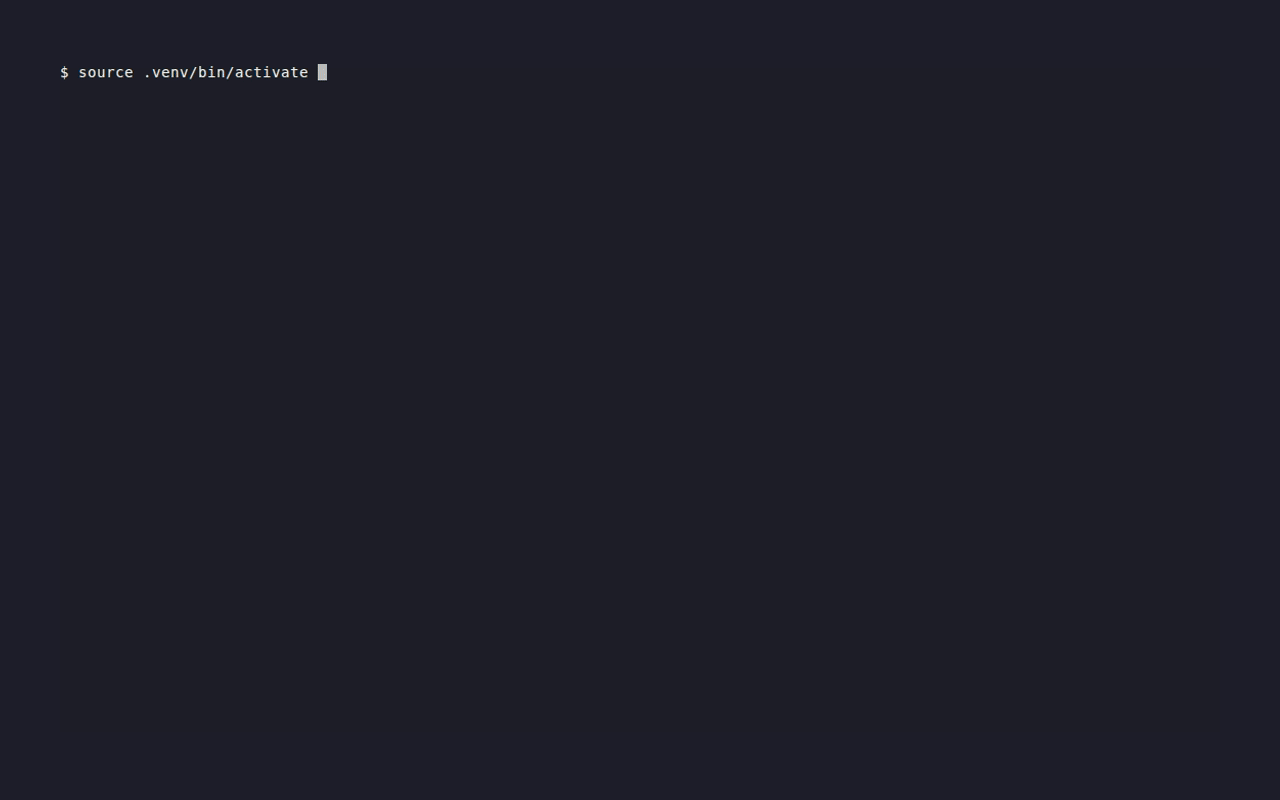
- VRAM-aware vLLM recipe import — Pull a model's official vllm-project/recipes config, then review its precision variants (bf16 / fp8 / awq) against your actual GPU's VRAM before it's written — so a recipe verified on an 80 GB card doesn't silently overshoot a 16 GB one.
측정된 스타 증가
- in 24h
- 0
- in 7 days
- 기록 수집 중
- in 15 days
- 기록 수집 중
- in 1 month
- 기록 수집 중
서로 겹치는 기간의 순증가량이며 일별 합계가 아닙니다. 측정값이 없으면 비워 둡니다. 스타는 관심도를 나타내며 품질을 보장하지 않습니다.
소개
Run and manage both vLLM and llama.cpp model servers from one terminal UI + CLI — shared Docker Compose profiles, live tok/s, and cross-backend port/GPU conflict checks. NVIDIA + Linux.
개발 도구README.ko.md
Original
llmux
vLLM과 llama.cpp 서버를 터미널 하나에서 올리고 관리합니다 — TUI로도, CLI로도.



English | 한국어
vLLM은 HF Transformers, llama.cpp는 GGUF를 다룹니다.
엔진도, config도, 터미널도 따로 노는 두 세계입니다.
llmux는 이 둘을 Docker Compose 위의 Textual 대시보드 하나로 묶습니다.
프로필을 고르고 Enter만 누르면, 그 프로필의 엔진이 알아서 뜹니다.
Linux + NVIDIA GPU + Docker 필요. macOS, AMD/ROCm, CPU 전용은 아직 미지원.
데모
한 GPU에서 두 엔진, 모델별 실시간 tok/s — vLLM 모델과 llama.cpp 모델을 나란히 띄우고, 각각의 처리 속도를 한 대시보드에서 봅니다
vLLM과 llama.cpp를 한 대시보드에서 — config 플래그를 켜고 끄고, 자동완성으로 추가하고, vLLM 공식 recipe에서 모델을 가져와 GPU VRAM에 맞는지 확인
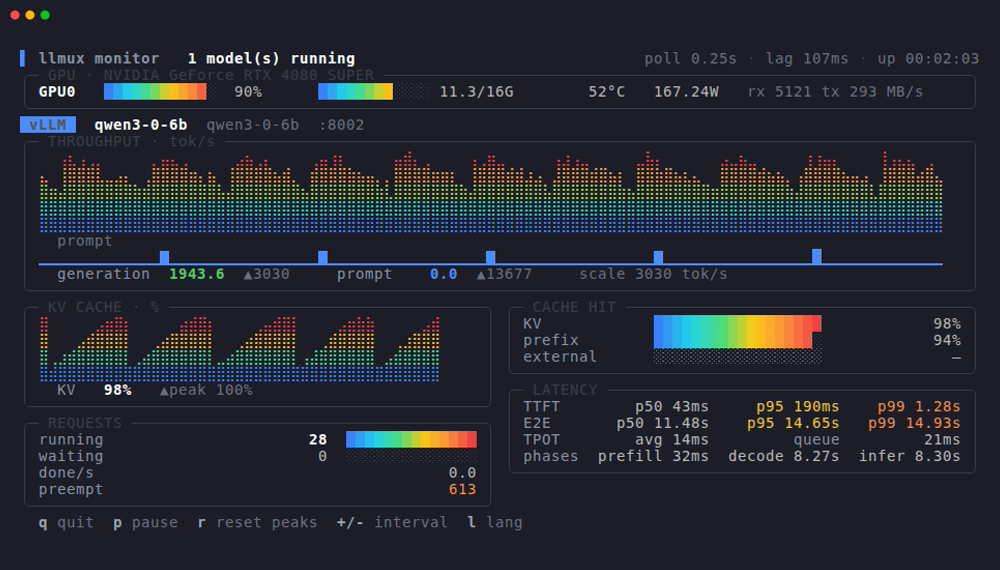
라이브 모니터 — v(또는 llmux top)로 GPU와 실행 중인 모델별 패널을 봅니다. 처리량·KV 캐시 그래프, 캐시 적중률, 엔진의 Prometheus 히스토그램에서 직접 읽은 지연 percentile
Headless CLI — recipe import, 파라미터 on/off, 상태 조회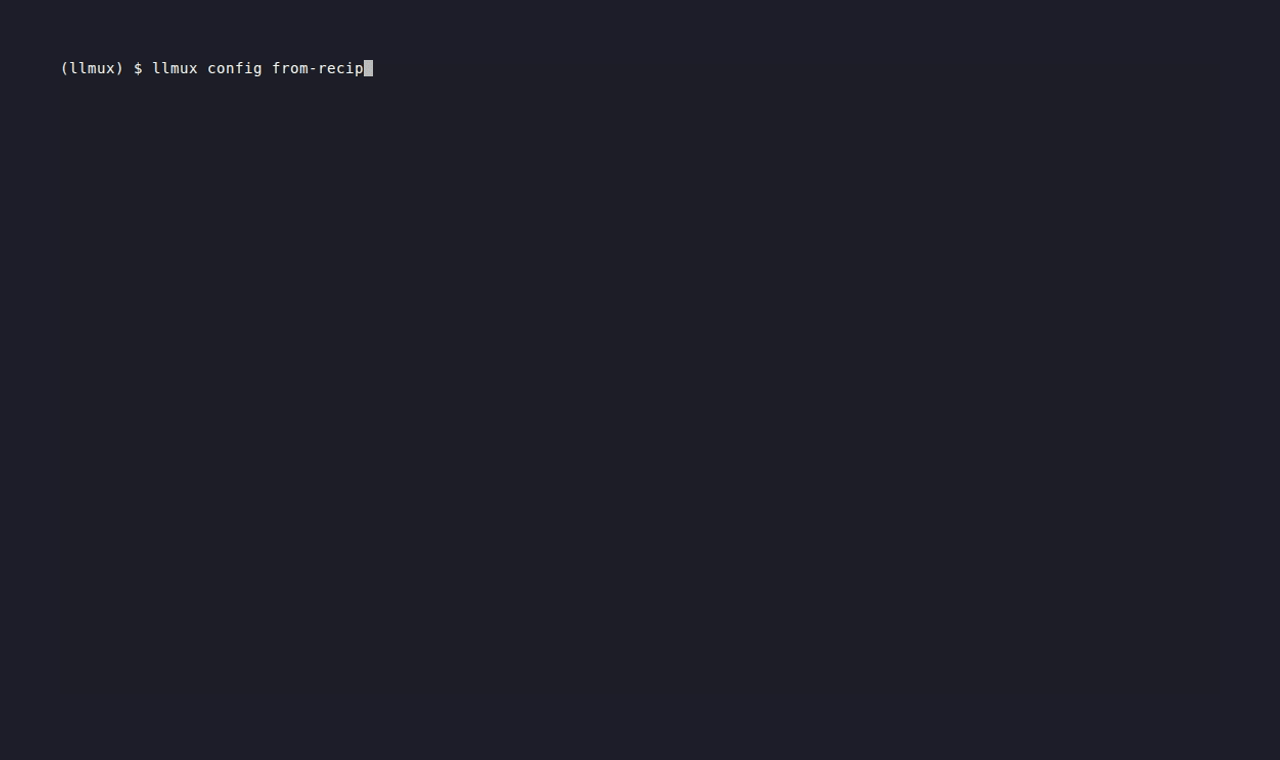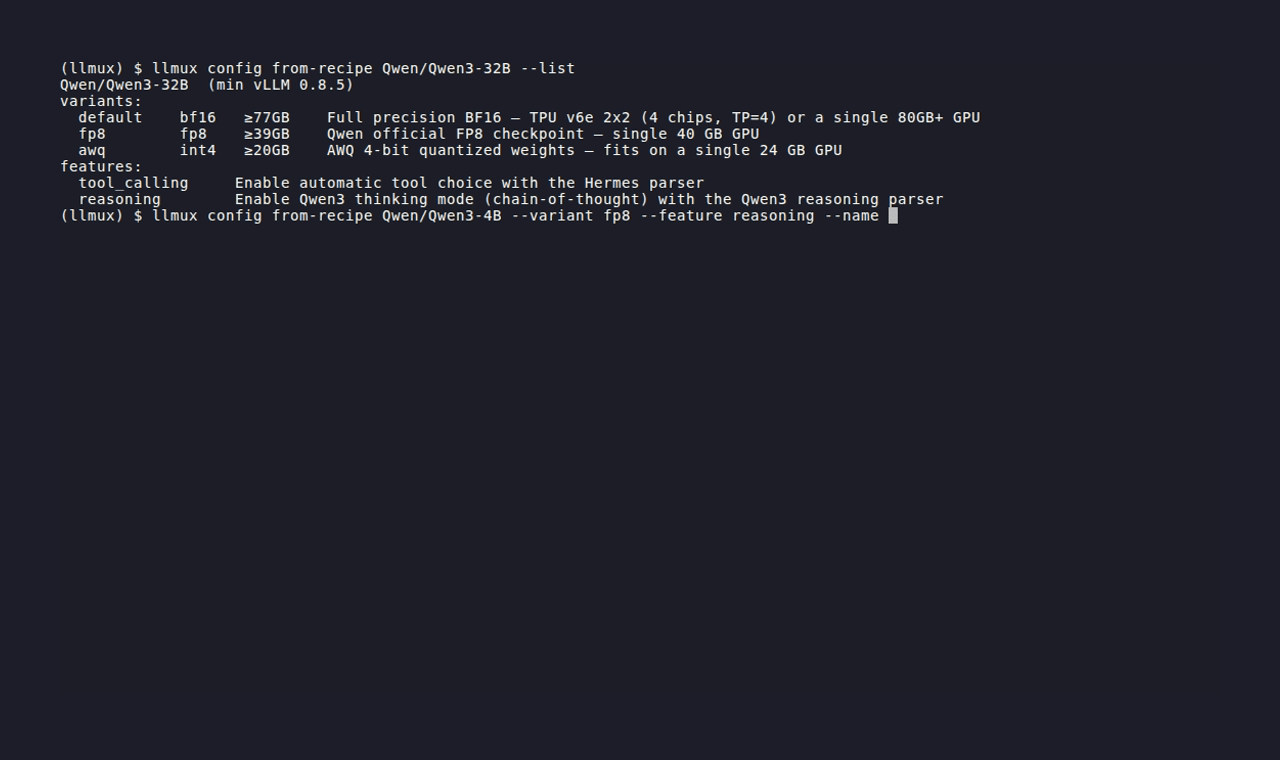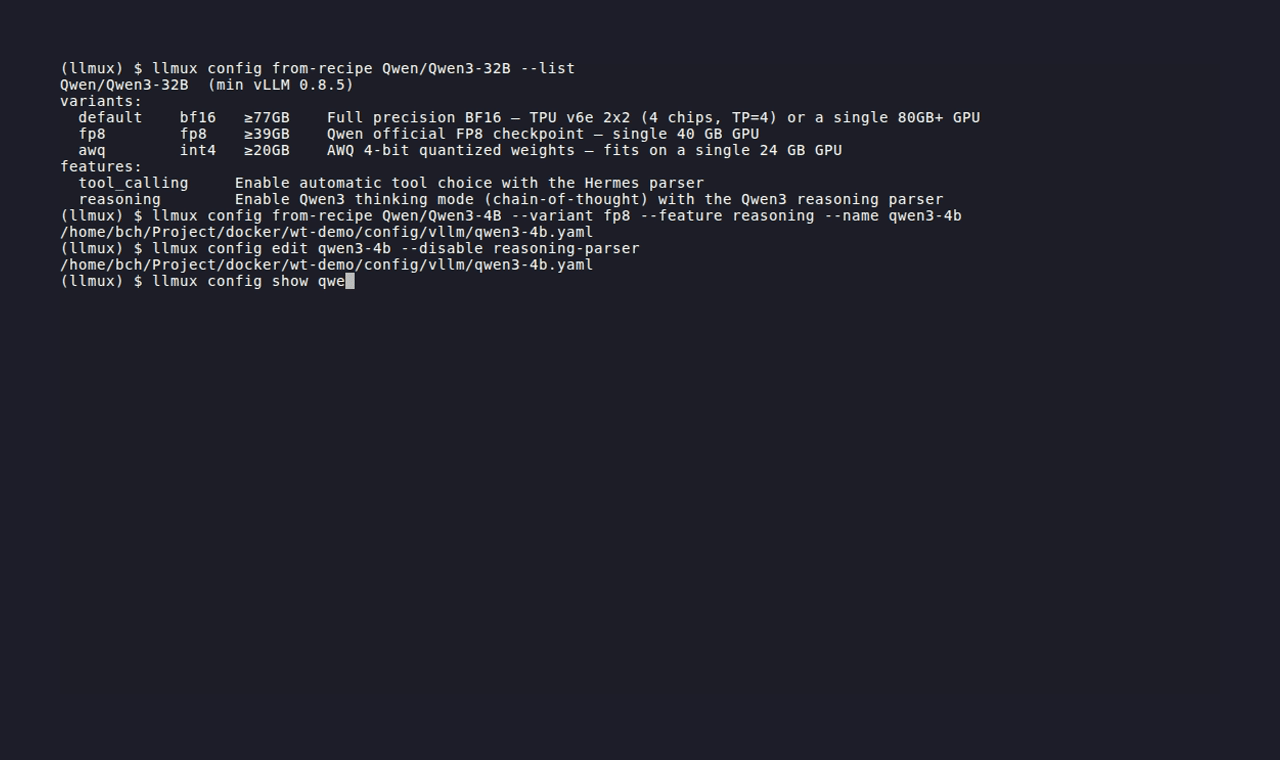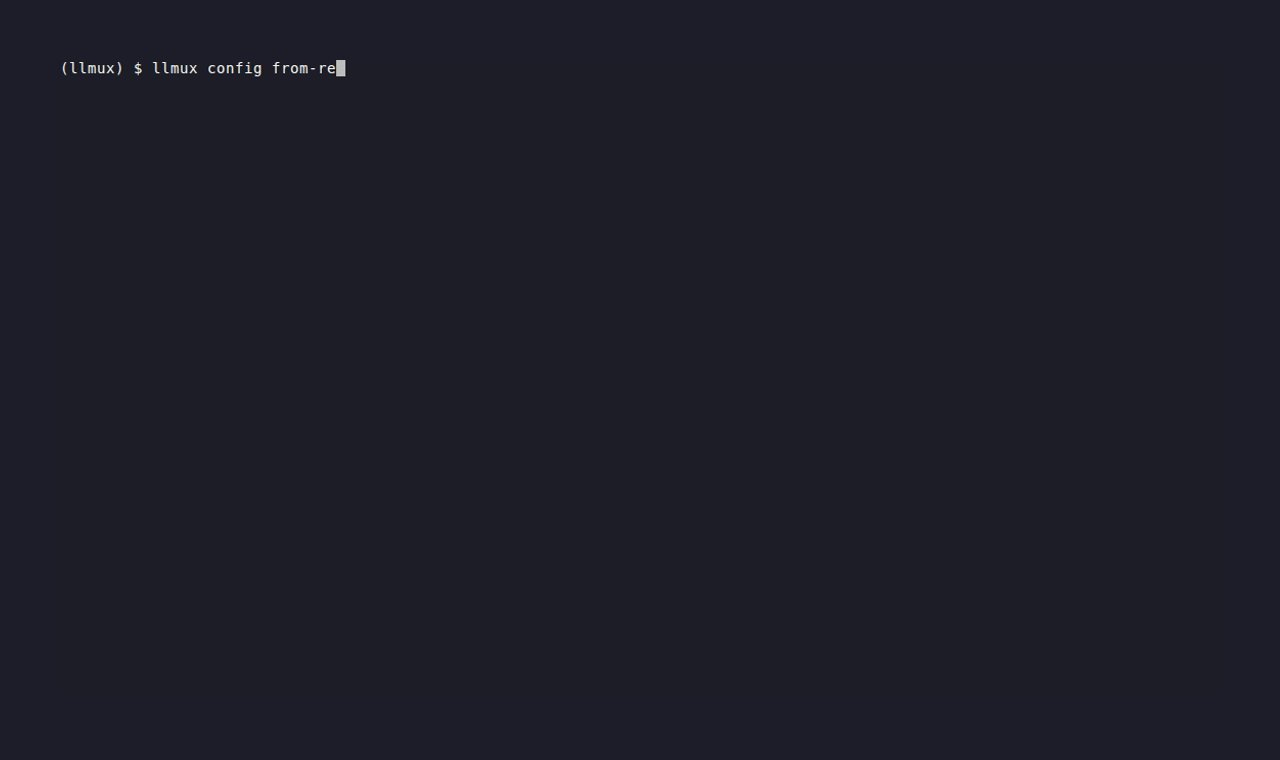
|
GPU 메모리 추정 — 모델별 GPU fit 바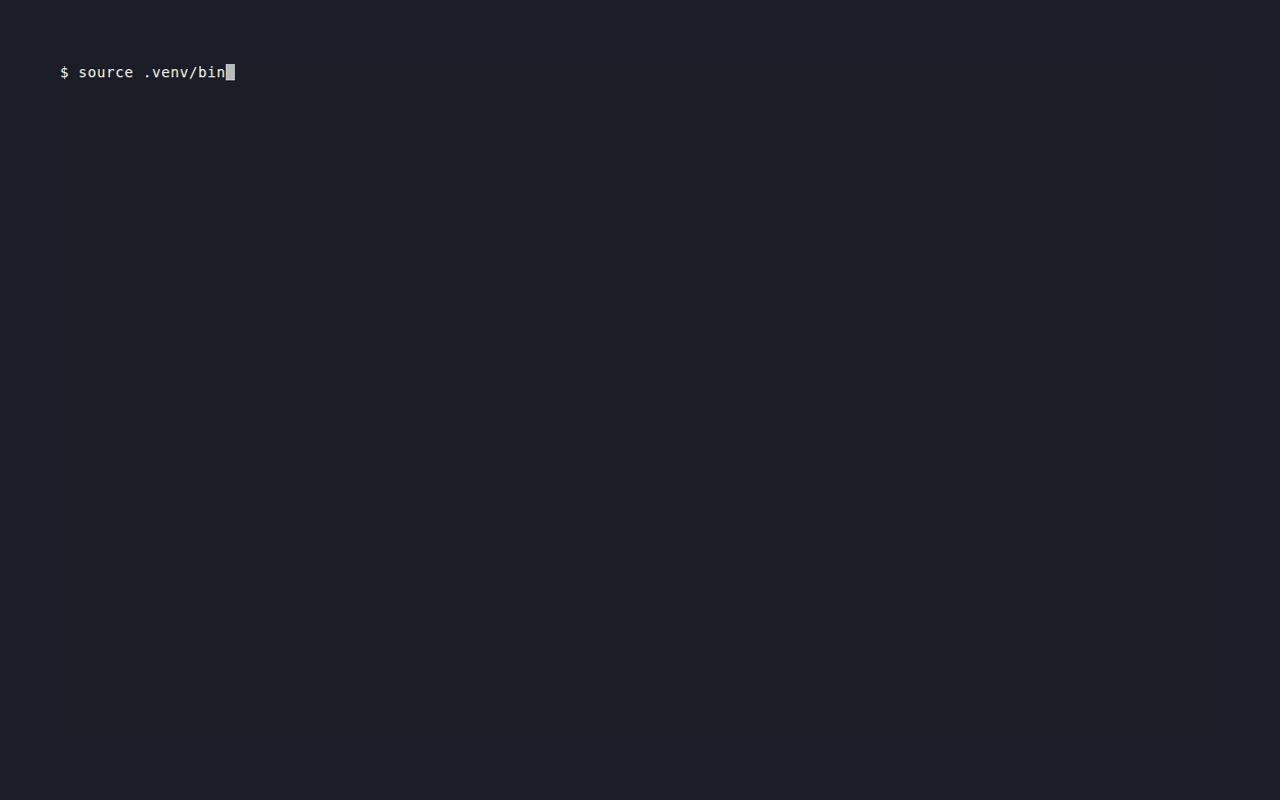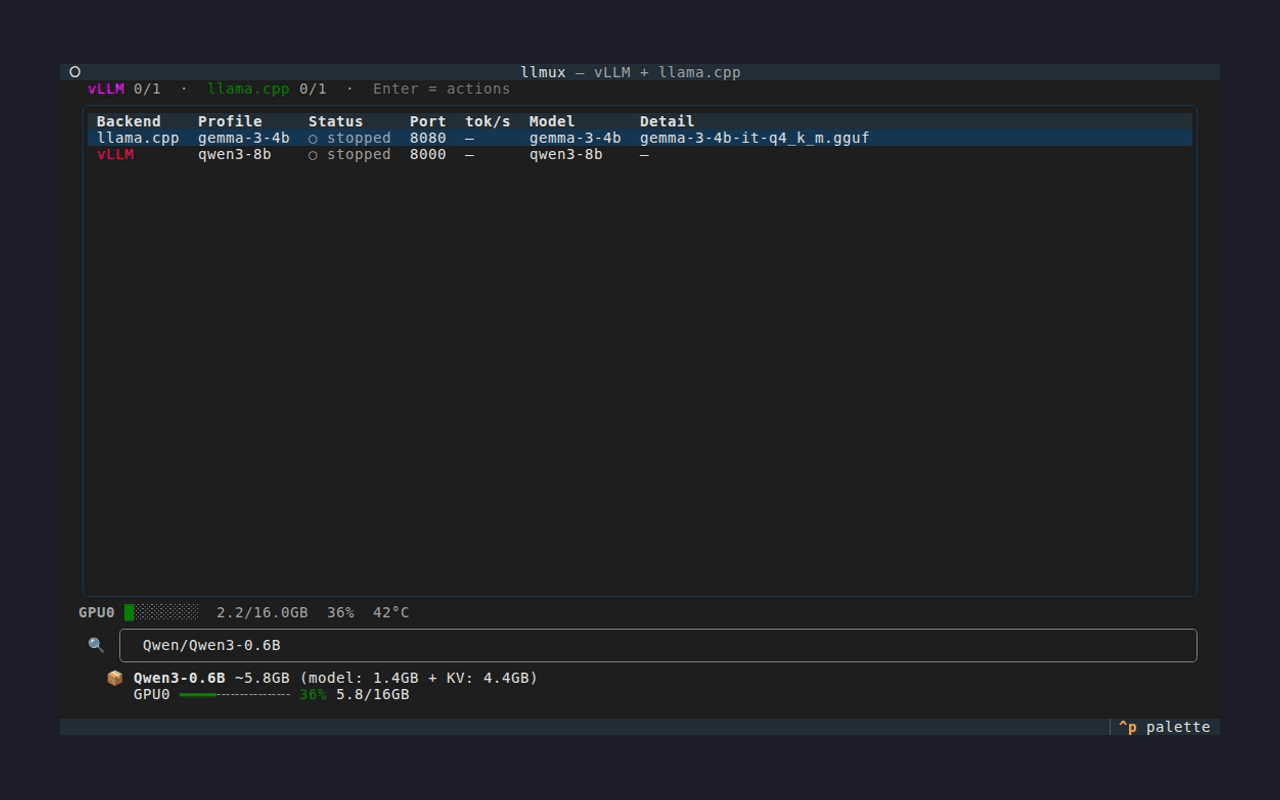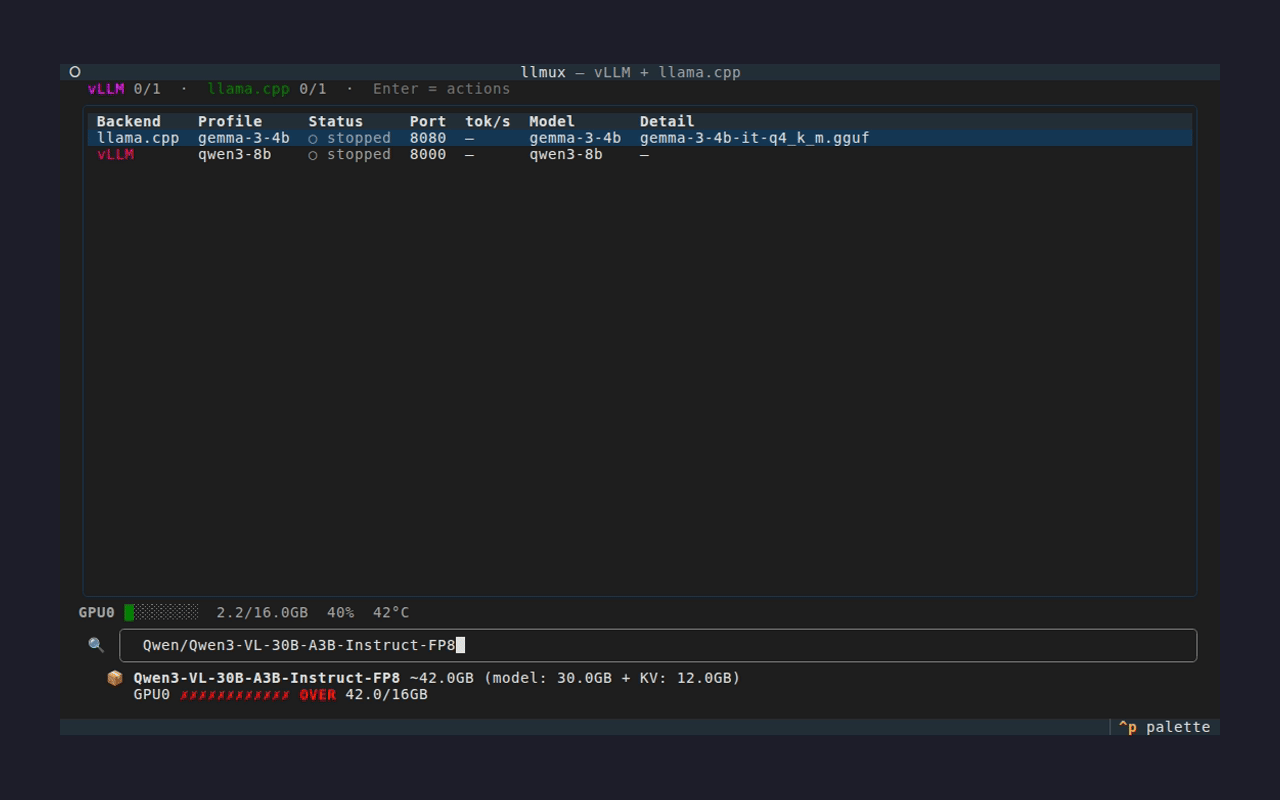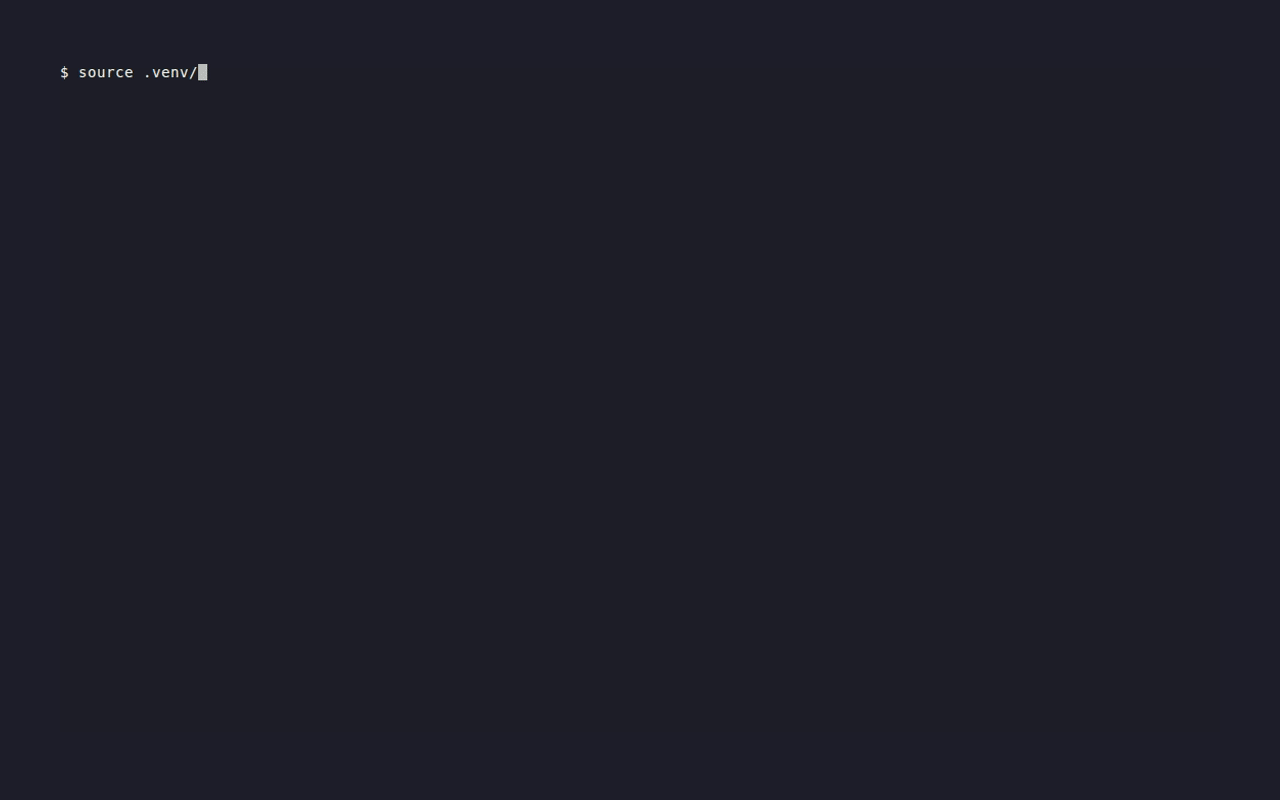
|
기능
- 두 엔진을 한 대시보드에서 — vLLM과 llama.cpp 프로필을 하나의 Textual TUI에 나란히 놓고, 실행 중인 모델마다 tok/s를 실시간으로 표시합니다.
- 프로필은 한 번 만들어두고, 올렸다 내렸다 — 실험하는 모델을 하나의
profiles.yaml에 프로필로 등록해두면, 매번 config를 새로 짤 필요 없이 골라서 실행하고 내립니다. 하나 멈추고 다른 걸 띄우는 것도 그만큼 빠릅니다. - 엔진 버전을 프로필별로 고정 — 공식 릴리스,
nightly, 소스에서 직접 빌드한 이미지를 프로필마다image_tag로 고정합니다. 한 프로필은 vLLMv0.21.0, 다른 프로필은 내가 패치한 빌드를 쓸 수 있습니다. 모호한:latest는 거부하고, 안정 버전은 구체적인 버전으로 해석하며, 컨테이너 안에서 실제로 돌고 있는 버전까지 검증합니다. - VRAM을 아는 vLLM recipe import — 모델의 공식 vllm-project/recipes 설정을 가져와, 정밀도 변형(bf16 / fp8 / awq)이 실제 내 GPU VRAM에 맞는지 확인한 뒤 씁니다. 80GB 카드에서 검증된 recipe가 16GB에서 조용히 넘치는 일을 막습니다.
- 메모리 추정 — HF 모델을 넣으면 다운로드나 실행 전에 GPU별 fit 바를 보여줍니다 (
hf-mem). - 엔진 플래그를 1:1로 —
config/<backend>/<name>.yaml이 엔진 플래그에 그대로 대응합니다. 샘플링, context 길이, KV 캐시 정밀도, MoE CPU offload 등. 플래그는 지우지 않고 켜고 끌 수 있고, 손으로 쓴 주석도 편집 후 그대로 남습니다. - 실행 중인 서버에서 읽는 플래그 자동완성 — 선택한 컨테이너 안의
vllm serve/llama-server에서 직접 인자를 읽으므로 일회성 이미지 선택도 반영합니다. 중지된 프로필은 다음 기동 이미지를 조회하고 이미지 ID별로 캐시합니다. 조회에 실패하면 미검증 목록을 추천하지 않고 자동완성을 중단합니다. - LoRA·speculative/MTP 구성 — LoRA 모듈은 프로필 항목이라 베이스 모델 위에 얹어 서빙되고, speculative decoding 파라미터는 일반 config 파라미터입니다. 그 구성에 필요한 이미지를 프로필에 고정해서 씁니다.
- 벤치마크 —
llmux bench가 warmup + 중앙값으로 돌려, 같은 하드웨어에서 quant A와 B를 비교합니다. - btop 스타일 라이브 모니터 — TUI에서
v, 또는 TUI 없이llmux top. GPU는 항상 전부 보이고(util·mem·temp·power·PCIe heat bar), 실행 중인 모델마다 패널이 붙어 처리량·KV braille 그래프, 캐시 적중, 요청, TTFT·E2E percentile(p50/p95/p99)과 prefill/decode 구간을 보여줍니다. 엔진이 노출하지 않는 지표는 지어내지 않고—로 둡니다. - 소스에서 dev 빌드 — 임의의 fork/branch에서
vllm-dev:/llamacpp-dev:이미지를 빌드하고(GPU arch 자동 감지)image_tag로 프로필에 고정합니다. - 전부 스크립트로도 — TUI의 모든 동작은 headless
llmux서브커맨드로도 제공됩니다. 구조화 출력은--json을 명시한 명령에서만 지원합니다. 라이프사이클·변경 명령은 문서화된 텍스트 또는 스트림 출력과 종료 코드를 사용합니다.
빠른 시작
한 줄로 설치합니다. llmux를 clone하고, 의존성을(그리고 uv가 없으면 uv까지) 설치한 뒤 llmux 명령을 PATH에 올립니다:
curl -fsSL https://raw.githubusercontent.com/Changroro/llmux/main/install.sh | sh
그다음 그냥 실행하면 됩니다. 첫 실행 때 짧은 설정 마법사(HF 캐시 경로, 모델 디렉터리, 선택 사항인 토큰)를 안내하고 .env.common을 대신 써줍니다:
llmux
설치된 폴더는 그대로 git 저장소로 남아 있어서, ~/.llmux에서 git pull만 하면 재설치 없이 업데이트됩니다. llmux는 실행할 때마다 GitHub에서 새 릴리스를 확인하고 받을지 물어봅니다. 지금 바로 확인하려면 llmux update (--check 는 확인만, --yes 는 확인 없이 업데이트), TUI 에서는 U 키. 다른 위치에 설치하려면 스크립트에 LLMUX_DIR을 넘깁니다: curl -fsSL ... | LLMUX_DIR=/path sh.
수동 설치
git clone https://github.com/Changroro/llmux.git && cd llmux
uv tool install --editable .   # editable — 코드 수정이 바로 반영됨
uv tool update-shell           # 최초 1회 — ~/.local/bin 을 PATH에 추가
전역 설치가 싫다면 저장소 안에서
uv run llmux로 실행할 수 있습니다. 다른 위치에서 쓰려면LLMUX_ROOT=/path/to/llmux를 지정하세요.
언어: TUI는 한/영 이중 언어입니다. 기본은 시스템 로케일을 따르고,
LLMUX_LANG=en또는LLMUX_LANG=ko로 강제할 수 있습니다.
전체 과정은 설치 가이드와 빠른 시작 문서를 참고하세요. (문서 사이트는 영어입니다.)
Headless CLI
TUI의 모든 기능은 비대화형 서브커맨드로도 있습니다. 인자 없이 llmux를 실행하면 TUI가 뜨고, 서브커맨드를 붙이면 TUI를 건너뜁니다:
llmux up <profile>                 # 컨테이너 시작
llmux prepare <profile>            # 모델 다운로드 + 세팅만, 실행은 안 함
llmux prepare <profile> -w 2       # 연결 2개로 천천히 (회선 양보)
llmux update --check               # 새 llmux 릴리스가 있나?
llmux logs <profile>               # 로그 follow
llmux ps --json --running          # 기계가 읽는 상태, 양쪽 백엔드
llmux stats --once --json          # 실행 중 컨테이너의 실시간 tok/s
llmux bench <profile> --runs 3     # warmup + 중앙값 tok/s 벤치마크
llmux profile quick-setup Qwen/Qwen3-8B --gpu-id 0,1
llmux config edit <name> --disable trust-remote-code   # 플래그를 끄되 남겨둠
llmux config from-recipe Qwen/Qwen3-32B --variant fp8   # vLLM 공식 recipe
llmux config from-recipe my/Qwen3-32B-AWQ --recipe-from Qwen/Qwen3-32B --merge
llmux profile rename old-name new-name                  # 컨테이너가 멈춰 있어야 함
llmux image build-dev --backend llamacpp --branch master
--json은 모든 list/show/check 명령이 지원합니다. 전체 명령과 플래그는 CLI 레퍼런스에 있습니다.
문서
전체 문서는 Changroro.github.io/llmux 에 있습니다. (영어)
| 섹션 | 내용 |
|---|---|
| Getting Started | 설치, 첫 모델 실행 워크스루 (TUI + CLI) |
| Guide | 프로필, 모델 config, 컨테이너 라이프사이클, TUI 단축키, dev 빌드 |
| Backends | vLLM과 llama.cpp 심화 + 기능 비교표 |
| Reference | 모든 CLI 명령/플래그, .env.common 변수, 내부 아키텍처 |
| Troubleshooting | 흔한 시작/다운로드/GPU 문제 — 증상 → 원인 → 해결 |
왜 llmux인가?
| 수동, 두 툴체인 | llmux | |
|---|---|---|
| 엔진 전환 | 엔진마다 CLI, compose, TUI가 따로 | 둘 다 하나의 Textual 대시보드 |
| 프로필 형식 | 프로필마다 .env, 두 저장소에 흩어짐 |
하나의 profiles.yaml, 실행 때 .env로 렌더 |
| 포트 / GPU 충돌 | 컨테이너가 죽고 나서야 알게 됨 | 시작 전에 양쪽 백엔드에 걸쳐 확인 |
| 이미지 버전 | docker pull latest 하고 기도 |
:latest 거부, semver로 해석 + 컨테이너 내부 버전 검증 |
| dev 빌드 | clone, 빌드, compose 연결을 손으로 | llmux image build-dev로 임의 브랜치에서, 프로필별 고정 |
| 메모리 사이징 | 맞겠지 하고 추측 | hf-mem로 GPU별 fit 바 |
| GGUF 설정 | hf download → compose 편집 → 마운트 |
llama.cpp가 첫 실행 때 받아 호스트에 캐시 |
llmux가 아닌 것. 추론 요청을 프록시하거나 라우팅하지 않습니다. 프로필마다 자기 포트에서 서빙하고, llmux는 그것들을 시작·중지·빌드·벤치마크하는 계층입니다. 하나의 엔드포인트 뒤에서 요청 단위로 모델을 바꾸고 싶다면 그건 llama-swap의 역할입니다. 채팅 UI도 아닙니다. Open WebUI나 OpenAI 호환 클라이언트를 llmux가 띄운 서버에 붙이면 됩니다.
요구 사항
- NVIDIA GPU가 있는 Linux + 최신 드라이버
- Docker Engine + NVIDIA Container Toolkit (GPU 패스스루용)
- Python 3.10+, 그리고 TUI 환경용 uv
첫 실행 전에 GPU 패스스루가 되는지 확인하세요:
docker run --rm --gpus all ubuntu nvidia-smi
macOS, AMD/ROCm, CPU 전용은 아직 지원하지 않습니다. llmux는 CUDA 이미지를 NVIDIA GPU 패스스루로 구동하며, 이는 Linux + NVIDIA GPU를 필요로 합니다.
로드맵
- Recipe 기반 config 추천 — v2.4.0에서
llmux config from-recipe로 출시 - 백엔드 간 프로필 clone — 현재
llmux profile clone은 같은 백엔드 안에서 복제. vLLM 프로필을 llama.cpp GGUF 등가물로 복제하는 건 아직 미구현 - 일괄 작업 — 여러 프로필을 양쪽 백엔드에서 한 번에 시작/중지
- 번들 내보내기/가져오기 — 프로필 + config 세트를 기기 간에 공유
- AMD / ROCm — 대체로 base-image + 디바이스 마운트 교체 수준으로, macOS보다 현실적
- macOS (native Metal) — 검토 중이고 llama.cpp 전용: Docker가 애플 GPU를 Linux 컨테이너에 넘기지 못해, llama.cpp를 컨테이너가 아닌 네이티브 프로세스로 돌려야 함 (vLLM은 CUDA 전용 유지)
- Web UI — 원격 접근용 선택적 브라우저 대시보드
기반
llmux는 컨트롤 계층입니다. 어려운 부분은 업스트림에 있습니다. 공식 이미지를 수정 없이 그대로 구동하며, 다음 위에 서 있습니다:
- vLLM과 llama.cpp — 구동하는 추론 엔진
- vllm-project/recipes — import하는 vLLM 설정의 출처
- hf-mem — 모델 메모리 추정
- Textual과 Typer — TUI와 CLI
MIT License